ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
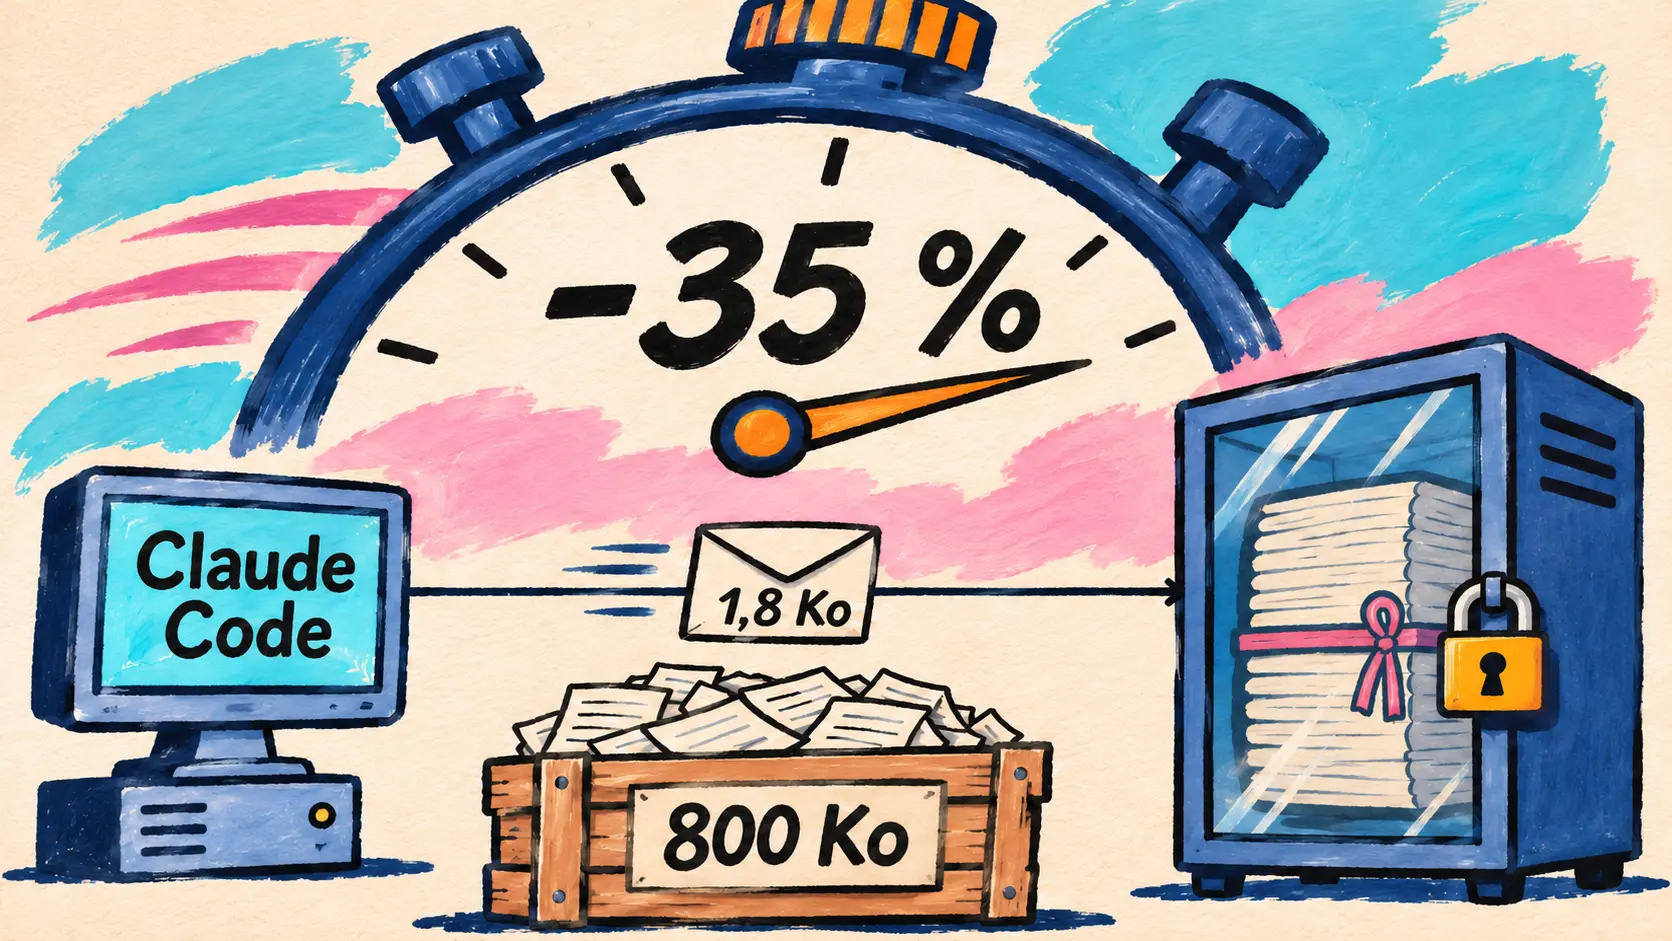
Anthropic abre en beta pública los message threads de la API Messages, ya activos en Claude Code, donde reducen alrededor de un 35 % el tiempo hasta el primer token en las solicitudes más largas. Sakana AI anuncia Sawara, sus primeros modelos preentrenados desde cero, mientras que OpenAI lanza Grid Protectors para que sus campus de cómputo puedan reducir su demanda ante las necesidades de la red eléctrica y publica LifeVal, un banco de pruebas de tareas de la vida cotidiana. Perplexity publica BrowseSafe++ contra la inyección de prompt, NVIDIA aporta herramientas de simulación con Cosmos 3 Nano, y Runway, Synthesia y ElevenLabs incorporan los medios generativos a los asistentes y los agentes.
La API Messages lanza los message threads en beta pública, ya activos en Claude Code
2 de noviembre — Anthropic abre en beta pública los hilos de mensajes (message threads) en la API Messages. Hasta ahora, un agente reenviaba en cada turno toda la conversación, incluidos los resultados de las herramientas. Con un hilo, la primera solicitud envía la conversación completa, con el prompt de sistema y las herramientas; las siguientes solo envían los nuevos mensajes y el identificador de la respuesta anterior, y la API reconstruye el resto antes de llamar al modelo. Basta con añadir el parámetro thread y el encabezado beta message-threads-2026-08-12, que los SDK oficiales gestionan con una función auxiliar específica.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇪🇸 Recientemente hemos integrado los message threads en Claude Code. En las solicitudes de 500 000 a 1 millón de tokens, la mediana del tiempo hasta el primer token es aproximadamente un 35 % menor. En las conversaciones largas, el tamaño mediano de las solicitudes ha pasado de unos 800 Ko a 1,8 Ko. — @ClaudeDevs en X
La mejora afecta a la latencia, no a la factura: Claude relee toda la conversación en cada turno, por lo que los tokens, las tarifas y los límites de tasa no cambian, y el almacenamiento en caché de prompts (prompt caching) sigue debiendo solicitarse explícitamente. El hilo se conserva en la medida de lo posible (best-effort), en memoria cifrada y nunca en disco: caduca 5 minutos después de la última solicitud, y la aplicación mantiene su propia copia para reenviarlo todo si la API responde con un 404. La función no es apta para la retención cero de datos (ZDR) y no funciona con Message Batches, con la compactación bajo demanda ni en organizaciones HIPAA. Está disponible en la API Claude, Claude Platform on AWS, Claude in Microsoft Foundry y Claude Models on Google Cloud (Anthropic managed).
🔗 El artículo de Anthropic sobre los message threads · La documentación de los message threads
Sakana AI anuncia Sawara, sus primeros modelos preentrenados desde cero, con pesos previstos para la primavera de 2027
2 de noviembre — Sakana AI publica el informe de su simposio del 26 de octubre en Tokio (más de 400 participantes, conferencia de Jürgen Schmidhuber), que contiene un anuncio de calado: la start-up japonesa va a preentrenar sus propios modelos de lenguaje. Hasta ahora, trabajaba en agentes y en el postentrenamiento de modelos abiertos existentes con Namazu. Presentada por su director científico (Chief Scientist), Takuya Akiba, la serie Sawara (nombre provisional) se construye desde cero, sin partir de un modelo de terceros, y está concebida para usos de agentes (agent-native): razonamiento con herramientas, código y tareas largas. Debe servir de base para los productos de Sakana AI y las investigaciones del RSI Lab sobre la automejora recursiva.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇪🇸 Ahora estamos preparando el entrenamiento, y comenzaremos el preentrenamiento de Sawara Small (nombre provisional) en diciembre. Si todo va bien, publicaremos los pesos la próxima primavera. — Sakana AI, informe del simposio de 2026
Después debería llegar Sawara Large, también con nombre provisional, sin fecha prevista. Sakana AI no detalla el tamaño del modelo, el volumen de datos ni el presupuesto de cómputo.
🔗 El anuncio de Sakana AI en X
La energía del cómputo: OpenAI lanza Grid Protectors, una TPU de Google responde desde la órbita
OpenAI lanza Grid Protectors, hasta 1 000 MW de reducción de demanda eléctrica para su campus de Effingham
2 de noviembre — OpenAI lanza Grid Protectors, un programa nacional para que sus futuros campus de cómputo reduzcan su consumo cuando la red eléctrica esté bajo presión, durante una ola de frío o de calor. Junto con los proveedores de electricidad, los reguladores y los responsables públicos, la empresa quiere cerrar acuerdos para cada instalación, que establecerán el volumen de demanda reducible, el tiempo de reacción y la duración. Según las necesidades locales, los campus también podrán recurrir a la generación o el almacenamiento en las propias instalaciones, y suavizar su demanda con baterías.
El piloto es el campus previsto en el condado de Effingham, en Georgia, presentado en julio con el nombre de Project Camellia. OpenAI se compromete a pagar allí la totalidad de los costes de infraestructura y del servicio eléctrico.
| Cifra anunciada | Valor anunciado | Fuente de la cifra |
|---|---|---|
| Reducción flexible de demanda prevista en el acuerdo con Georgia Power | hasta 1 000 MW | OpenAI |
| Equivalente en demanda media de hogares | unos 700 000 hogares | OpenAI |
| Ahorro anual para los clientes de Georgia Power a partir de 2029 | unos 950 millones de dólares | Georgia Power |
| Ahorro para un cliente residencial típico que consume 1 000 kWh | al menos 15 dólares al mes | Georgia Power |
La proyección de Georgia Power abarca el conjunto de sus acuerdos con grandes consumidores y el crecimiento previsto, incluido Project Camellia: no es una cifra específica del programa de OpenAI. La empresa reconoce que la flexibilidad no sustituye la inversión en nuevas capacidades de generación y transporte, y no anuncia ninguna otra instalación ni calendario.
🔗 La publicación de OpenAI sobre Grid Protectors
Project Suncatcher: una TPU en órbita envía su primera respuesta, un haiku escrito por Gemma 4
30 de octubre — Repaso: un mes después del lanzamiento de su satélite prototipo, el 1 de octubre, Project Suncatcher, el proyecto de investigación de Google sobre cómputo para IA en el espacio, alcanza su hito «Hello World»: la primera respuesta de IA producida por una TPU de categoría data center en órbita. Durante un paso sobre una estación terrestre, el equipo pidió al modelo abierto Gemma 4, instalado a bordo, un haiku sobre la vida en el espacio; la respuesta llegó a tierra cuando el satélite sobrevolaba Svalbard, en Noruega. Después llegaron limericks y prompts de telemetría, a los que el modelo responde describiendo el estado técnico de la carga útil.
La siguiente etapa se centra en la fiabilidad: pruebas de las TPU bajo estrés térmico y radiación, antes de una pareja de satélites interconectados en 2027. La publicación no ofrece cifras de rendimiento ni de consumo.
🔗 La publicación de Google sobre la primera respuesta del satélite
Vida cotidiana y creatividad de las interfaces: OpenAI publica LifeVal, Kombai publica Design Creativity Bench
LifeVal: 169 tareas de la vida cotidiana, del 49,3 % de GPT-5.2 al 80,6 % de GPT-6 Astra
2 de noviembre — OpenAI publica LifeVal, una evaluación de los modelos en tareas de la vida cotidiana: encontrar a alguien que cuide de los niños, acceder a los servicios públicos, elaborar un presupuesto, adaptar una receta o crear un programa de ejercicio. Las tareas se basan en dos grandes encuestas sobre el uso del tiempo, la American Time Use Survey y la Multinational Time Use Study, complementadas con una encuesta representativa a 3 995 personas sobre los ámbitos en los que más ayuda desearían recibir. OpenAI afirma que lleva un año utilizándola para seguir la evolución de sus modelos.
| Modelo evaluado | Fecha de lanzamiento | Recompensa media en 169 tareas |
|---|---|---|
| GPT-5.2 | diciembre de 2025 | 49,3 % |
| GPT-5.4 | marzo de 2026 | 73,0 % |
| GPT-5.5 | abril de 2026 | 77,4 % |
| GPT-5.6 | julio de 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | septiembre de 2026 | 80,6 % |
Según la descripción del gráfico, se trata de una media no ponderada de las 169 tareas, y solo 0,6 puntos separan a GPT-5.6 de GPT-6 Astra. El gráfico no incluye ni GPT-6.1 Sol o Terra ni ningún modelo de otro proveedor, y OpenAI no menciona la publicación del conjunto de tareas.
🔗 La publicación de OpenAI sobre LifeVal
Design Creativity Bench: los modelos convergen hacia las mismas interfaces
2 de noviembre — Kombai, proveedor de herramientas de IA para el desarrollo front-end, presenta en el blog de Hugging Face Design Creativity Bench, un banco de pruebas que no mide si una interfaz funciona, sino si se parece a las demás. El estudio abarca 15 modelos de vanguardia, 160 instrucciones y 2 400 interfaces HTML, comparadas con maquetas creadas por personas.
| Medida del banco de pruebas | Modelos evaluados | Referencia humana |
|---|---|---|
| Diferenciación media ante una misma instrucción | 0,592 entre modelos | 0,764 entre humanos y modelos |
| Amplitud creativa media | 0,581 | 0,902 |
| Criterios de aceptación satisfechos | más del 90 % en todos (Claude Opus 5.5: 99,2 %) | 98,0 % |
Los modelos, por tanto, cumplen los requisitos, pero se parecen entre sí. GPT-6 Astra tiene el estilo más distintivo del grupo (0,646 de originalidad), aunque varía poco de un contexto a otro (0,472 de amplitud). Kombai publica el artículo (arXiv 2610.11539), una clasificación y un subconjunto para reproducir los resultados, y reconoce sus limitaciones: solo pantallas de escritorio y configuraciones predeterminadas de las API.
🔗 La publicación de Kombai en Hugging Face
Perplexity publica BrowseSafe++ y sus detectores BrowseSafe-Guard contra la inyección de prompt
2 de noviembre — El Perplexity Secure Intelligence Institute publica BrowseSafe++, sucesor de BrowseSafe (diciembre de 2025), un banco de pruebas abierto dedicado a la inyección indirecta de prompt (indirect prompt injection), que apunta a los agentes capaces de navegar por la Web. Reúne 38 675 pares de páginas, una atacada y su gemela limpia, de los cuales 32 187 se construyeron a partir de inyecciones observadas realmente: el detector de Comet señaló 1,15 millones entre septiembre de 2025 y septiembre de 2026. Cada página está disponible en HTML, Markdown, árbol de accesibilidad y captura de pantalla. A partir de ello, Perplexity crea BrowseSafe-Guard, dos detectores de 0,8B ajustados a partir de Qwen3.5-0.8B, uno para texto y otro para capturas.
| Resultado publicado | BrowseSafe-Guard | Modelos comparados |
|---|---|---|
| F1 en las vistas de texto | alrededor del 95 %, primero en cada vista | del 85 al 92 % para los mejores modelos generalistas |
| F1 en las capturas de pantalla | alrededor del 93 % | alrededor del 79 % para el mejor de los demás modelos |
| Páginas limpias señaladas por error | alrededor de 1 de cada 20 | 14,41 % para GPT-6 Astra |
| Coste por 1 000 páginas | 0,18 dólares en un H200 alquilado | de 18,95 a 180,61 dólares por API |
Detectar no es resistir: todos los modelos siguieron inyecciones que ellos mismos habían detectado, desde el 1,64 % de las páginas en el caso de GPT-6 Astra hasta el 24,73 % en el de Llama 3.1 8B. Un atacante persistente también acaba logrando eludir las defensas: en el entorno BrowseSafe-Adapt, que reescribe la inyección después de cada fallo (1 024 tareas, hasta 64 intentos), el éxito pasa de un 4 % como máximo en el primer intento a al menos un 79 % contra cinco de los siete agentes probados. Situado delante de un agente Gemini 3.5 Flash-Lite, Guard bloquea el 94,5 % de las inyecciones originales, pero el atacante sigue teniendo éxito en el 84,2 % de las tareas. Están disponibles el conjunto de datos (con acceso controlado), un SDK con licencia MIT y una clasificación pública; la publicación no enlaza a ningún peso de los detectores.
🔗 La publicación de Perplexity sobre BrowseSafe++
Medios generativos: Runway Dev llega a Claude Code y Cursor, Synthesia a ChatGPT y Claude, ElevenLabs cuantifica la ventaja de la voz
Runway Dev llega a Claude Code y Cursor
2 de noviembre — Después de Codex, presentado el 28 de octubre, Runway amplía sus plugins Runway Dev a Claude Code y Cursor. Una instalación conecta el agente de programación con la cuenta Runway Dev a través del servidor MCP de Runway y le añade las skills de Runway para desarrollar con su API de medios generativos. El agente consulta primero la cuenta (proyectos, modelos accesibles con sus precios y límites, saldo de créditos) y después se apoya en los SDK oficiales: puede crear un Model Router, que elige el modelo adecuado para cada solicitud, o un Character para avatares en tiempo real, y reutilizar las Recipes (pipelines listos para usar) o los Workflows publicados como puntos de acceso API. En caso de fallo, consulta los detalles del error. La conexión con la cuenta se realiza en el primer uso, sin ninguna clave API almacenada en el plugin, y no se indica ninguna tarifa específica.
| Agente de programación | Instalación indicada por Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api en el chat Agent, o la Cursor Marketplace |
Synthesia crea sus vídeos en ChatGPT y Claude
2 de noviembre — Synthesia anuncia que sus vídeos de avatares ya se pueden crear directamente en ChatGPT y Claude: el usuario describe el vídeo que desea, lo ve aparecer en la conversación, solicita ajustes y después lo publica y lo comparte, sin abrir otra aplicación ni otra pestaña. El anuncio se limita a un tuit acompañado de un vídeo de demostración; en el momento de nuestra revisión no aparecía ninguna publicación en el blog ni en la página de inicio de Synthesia. Synthesia no especifica el mecanismo de integración, los planes incluidos ni el precio.
🔗 El anuncio de Synthesia en X
ElevenLabs: la voz tiene éxito un 32 % más a menudo que el chat en conversaciones de más de dos minutos
2 de noviembre — ElevenLabs publica un estudio que compara la voz (teléfono y WhatsApp) y el chat en agentes ElevenAgents en producción, comparando cada agente consigo mismo en sus conversaciones de mayo a julio de 2026. El tweet del anuncio menciona 469 agentes; la publicación, por su parte, habla de «cientos» de agentes.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇪🇸 Cuanto más larga es la conversación, mayor es la tasa de éxito de los agentes de voz. Hemos analizado 469 agentes que funcionan tanto por voz como por chat en producción y hemos observado una tendencia interesante. Cuando la conversación se vuelve compleja, la voz es el camino más rápido hacia la resolución. — @ElevenLabs en X
| Indicador según ElevenLabs | Valor medido |
|---|---|
| Éxito de la voz en conversaciones de más de dos minutos | +10,9 puntos, es decir, +31,7 % |
| Conversaciones de menos de un minuto | el chat lleva una ventaja de unos 9 puntos |
| Duración de las conversaciones largas resueltas con éxito | 4,6 minutos por voz, 7 minutos por chat |
| Cambio a un LLM más rápido (315 conversaciones) | latencia un 16 % menor, éxito un 26 % mayor |
| Preferencia por la voz (98 participantes, vuelo cancelado) | 85 % |
La duración sirve aquí como indicador de complejidad, algo que la publicación reconoce que es imperfecto, y el estudio procede del proveedor, que promociona en él sus agentes de voz.
🔗 La publicación de ElevenLabs
NVIDIA publica recetas de simulación de Cosmos 3 Nano para la conducción, la robótica y la cirugía
2 de noviembre — NVIDIA publica en su blog técnico una guía en dos partes para Cosmos, su plataforma de modelos fundacionales del mundo (world foundation models) destinada a la IA física: recetas de simulación basadas en nuevos puntos de control de Cosmos 3 Nano, anunciados el 22 de octubre y esta vez identificados y descritos, y después instrucciones de uso de los microservicios NIM. El ejemplo destacado: basta con cambiar el prompt para transformar un trayecto diurno en una noche lluviosa, sin modificar el trazado de la carretera ni las trayectorias de los vehículos.
| Punto de control de Cosmos 3 | Uso descrito por NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Clips multicámara con LiDAR para la conducción, hasta 400 imágenes en 480p o 720p |
| Cosmos3-Nano-Sim-Auto | Variante causal destilada que genera en streaming para probar una política de conducción en bucle cerrado |
| Cosmos3-Nano-Sim-Transfer | Vídeo de profundidad convertido en vídeo RGB detallado, para la robótica |
| Cosmos3-Nano-Sim-Bimanual | Siguiente observación de un robot de dos brazos a partir de la escena y de sus acciones |
| Cosmos3-H-Embodied-Nano y Cosmos3-H-Dreams | Simulación quirúrgica a partir de las acciones del robot, en tiempo real para H-Dreams |
En cuanto al despliegue, la imagen NIM cosmos3:2.0.0 ofrece perfiles de latencia o de rendimiento, y la decodificación especulativa acelera la inferencia entre unas 2 y 3 veces de media en H200, según NVIDIA, que anuncia NIM de Cosmos certificados para más de 20 GPU. Para la generación, Cosmos3-Nano requiere 58 Gio de VRAM en BF16 y 31 Gio en FP8 con descarga de memoria. Cosmos Framework incorpora pipelines de aprendizaje por refuerzo (DPO, GRPO, PPO, OPD, DiffusionNFT), y se le dedicará una emisión en directo el jueves 5 de noviembre.
🔗 La publicación técnica de NVIDIA
Copilot CLI 1.0.106-3, en versión preliminar: gestión de sesiones opcional y 145 correcciones
2 de noviembre — GitHub publica la versión preliminar 1.0.106-3 de Copilot CLI, la tercera de la rama 1.0.106. Las notas solo incluyen una incorporación: herramientas de gestión de sesiones que se activan de forma opcional (opt-in), y la posibilidad de mencionar con @ las sesiones locales que hayan activado esta opción, sin más detalles. Para las cuentas administradas, los avisos de actualización de políticas recogen ahora los hallazgos de Policy Helper.
Las 145 correcciones restantes afectan sobre todo a la robustez de la interfaz de terminal, y varias tienen implicaciones de seguridad:
| Corrección de seguridad | Comportamiento anterior a la 1.0.106-3 |
|---|---|
| Filtrado de secuencias de escape | Una respuesta, un nombre de archivo o un título de herramienta MCP podía cambiar el estilo de la timeline u ocultar líneas |
/allow-all off | Seguida de un espacio ideográfico (entrada CJK), la orden activaba Allow All en lugar de desactivarlo |
/session delete | Una opción desconocida situada antes del identificador eliminaba la sesión actual sin pedir confirmación |
copilot -p y copilot workflow run | La salida de texto mostraba los valores de --secret-env-vars, que la salida JSON ya ocultaba |
La última versión estable sigue siendo la 1.0.105 del 28 de octubre, y el SDK Copilot 1.0.29-preview.2, publicado esa misma noche, no contiene ningún cambio en el SDK.
🔗 Las notas de la versión de Copilot CLI 1.0.106-3
Breves
Agentes y herramientas de código
- Qwen Code v0.26.6 — Versión estable del 2 de noviembre, un día después de la v0.26.5: Web Shell incorpora una vista de actividad de las sesiones y muestra, modelo por modelo, la tasa de éxito, la velocidad de salida y la latencia del primer token; los modelos Kimi K3 reciben su ventana de 1 millón de tokens. 🔗 fuente
- Gemini CLI — Una corrección integrada la noche del 2 de noviembre impide que una descarga interrumpida del modelo Whisper se dé por un modelo instalado, lo que bloqueaba el modo de voz local hasta que se eliminaba manualmente el archivo. Todavía no está incluida en ninguna versión, y la nightly del día utiliza el mismo commit que las dos anteriores. 🔗 fuente
- CLI mistral 0.16.0 —
mistral workflows initymistral initsolicitan ahora la clave API de un proyecto Workflow, la verifican con la API Mistral y la guardan en el.envdel proyecto. 🔗 fuente - Plugin Qodo para Codex — En un caso de estudio publicado por OpenAI, Qodo presenta su plugin de la marketplace de Codex: Codex recibe las reglas de la organización y el historial de pull requests antes de escribir, y después la revisión de Qodo en la misma sesión, antes de abrir la pull request. No se ofrecen cifras de resultados. 🔗 fuente
- corgi, difundido por Zed — La noche del 1 de noviembre, Zed comparte el sitio de corgi, la herramienta de build de Rust compatible con Cargo de Conrad Irwin: una sola caché por máquina, build.rs y macros en un entorno aislado, tests almacenados en caché. Según su autor, el código está escrito casi íntegramente por IA. Repositorio con licencia MIT. 🔗 fuente
Plataformas de desarrollo y API
- pull_request_target en GitHub Actions — El bloqueo por defecto de
pull_request_targeten los repositorios públicos se aplaza del 2 de noviembre al 2 de diciembre; dos interrupciones programadas, los días 9 y 16 de noviembre de 16 h a 18 h UTC, permitirán identificar los workflows afectados. 🔗 fuente - Evaluaciones de riesgos de GitHub — Las evaluaciones de riesgos de seguridad del código y de los secretos indican ahora si cada hallazgo se encuentra en un repositorio protegido o no, en GitHub Enterprise Cloud y GitHub Team. 🔗 fuente
- Analytics API de Perplexity — Las respuestas sobre el uso de créditos de Computer omiten por ahora el desglose por origen de los créditos (Credit Source); se siguen proporcionando el total y el desglose por modelo, y Perplexity pide que la ausencia de un desglose no se interprete como un uso nulo. 🔗 fuente
Modelos abiertos y publicaciones de la comunidad
- kniv v7 de Dragonscale — Seis codificadores abiertos de 55M a 538M de parámetros (Apache-2.0, ONNX) que extraen entidades, relaciones y hechos según un esquema descrito en el momento de la llamada, sin LLM, para la memoria de los agentes; en Re-DocRED, 0,749 en una misma frase y 0,732 con dos frases de separación (variante DeBERTa). 🔗 fuente
- Ventana deslizante y capa Bifocal — En una publicación de la comunidad, Lukas destila Qwen3-4B-Instruct en cuatro modelos alumnos con la misma memoria: la ventana deslizante basta para las respuestas cortas, pero en AIME y HMMT su capa Bifocal (ventana pequeña y estado mLSTM) resuelve casi el doble de problemas que la ventana por sí sola, estancada en torno al 14 %. Mediciones del autor. 🔗 fuente
- Puerta trasera bloqueada por ViKernel — VIDRAFT implanta mediante ajuste fino una puerta trasera en Qwen3-0.6B: la palabra «payroll» en una ruta de archivo activa la orden maliciosa en el 98,3 % de los casos con rutas inéditas, sin que ninguno de los 24 controles la detecte; en ViKernel, las 290 cargas se rechazan antes de ejecutarse. Pesos no publicados. 🔗 fuente
- Enrutamiento de Beam y trampas en los tests — Un estudio prerregistrado de Rairo Mukamuri no logra predecir, mediante el enrutamiento de expertos de Beam-1.0-501B-A23B, una falsificación de un test con 500 tokens de antelación: AUROC de 0,580 frente a un umbral fijado en 0,75, por 9,03 dólares de cómputo. 🔗 fuente
- Saturate — Daniel van Strien vuelve a procesar mediante OCR 14 483 páginas de archivos en una sola GPU de Hugging Face Jobs, por 1,47 dólares y a 8,9 páginas por segundo, con Saturate, su biblioteca Apache-2.0 de inferencia por lotes a través de cualquier endpoint compatible con OpenAI. 🔗 fuente
Imagen, vídeo, voz y música
- LTX 2.5 en una RTX PRO 6000 — El proveedor de alquiler de GPU EcoHash renderiza un vídeo 1080p de 10 segundos con sonido en 90 segundos, y en 14,8 segundos en 480p, en una sola tarjeta de 96 Go; mediciones del proveedor en su propio servicio. 🔗 fuente
- Mobiel AI de KPN — ElevenLabs detalla el asistente de llamadas de KPN para las pequeñas empresas neerlandesas (transcripción de mensajes de voz, resúmenes de llamadas, menú de llamadas); el ajuste fino en neerlandés elevó la precisión de verificación de aproximadamente el 50 % al 90 %. No se indica ningún precio. 🔗 fuente
- Suno Studio — Novedad del 29 de octubre, difundida el 2 de noviembre: los ajustes de los clips pasan a una barra lateral, el tono se ajusta en semitonos y cents, el audio importado puede estirarse al tempo del proyecto y las pistas se ocultan con Shift-H. 🔗 fuente
- Kling y los Chroma Awards — Kling se convierte en socio de la temporada 2 del concurso, con más de 450 000 dólares en premios; se aceptan candidaturas hasta el 7 de enero. 🔗 fuente
Programas, demostraciones y publicaciones de los laboratorios
- Anthropic Residency — Anthropic abre hasta el 22 de noviembre las candidaturas a un programa de investigación remunerado de seis semanas a seis meses, para profesores, fundadores técnicos e ingenieros de nivel staff, sin requisitos previos de aprendizaje automático; remuneración equivalente a entre 350 000 y 500 000 dólares al año. 🔗 fuente
- Data Bot de SpaceXSI — Caso de estudio interno: un Team Bot de Grok Bot que actúa como data scientist para toda la empresa, a partir de skills mantenidas por el equipo de datos, y que habría asumido unas 70 horas de trabajo en una semana, según una estimación de SpaceXSI. 🔗 fuente
- Le Chonk y la química cuántica — Mistral muestra en X cómo Mistral Large 4 escribe desde cero un solver SCF y una vista 3D de una molécula que se rompe, sin publicar código ni cifras. 🔗 fuente
- Resumen de octubre de Google — Ningún anuncio nuevo salvo la respuesta del satélite de Project Suncatcher, tratada más arriba. 🔗 fuente
- Memoria de los agentes en Perplexity — Una guía sobre los tipos de memoria y la construcción de un agente con memoria persistente, que remite a Brain, ya disponible en Computer. 🔗 fuente
- The Knowledge Talk — Perplexity publica la transcripción del discurso de Aravind Srinivas del 3 de octubre en la Cambridge Union Society, sin anuncios. 🔗 fuente
Qué significa esto
Los message threads trasladan parte del estado de la conversación al servidor sin modificar la factura: los tokens y las tarifas siguen siendo los mismos, solo se reduce el tiempo de espera, y el efecto es más claro en las sesiones de agentes que acumulan cientos de miles de tokens. La elección de un hilo efímero, conservado 5 minutos en memoria cifrada y sin API para volver a leerlo, deja a la aplicación el control de su historial, a cambio de exclusiones claras: ni ZDR, ni Batches, ni organizaciones HIPAA. En el terminal, la versión preliminar de Copilot CLI recuerda que la propia interfaz es una superficie de ataque, cuando un nombre de archivo o una respuesta del modelo podía cambiar el estilo de la pantalla.
Grid Protectors y Suncatcher responden a la misma limitación, la energía necesaria para el cómputo, en dos horizontes muy distintos. OpenAI propone que el consumo de sus campus pueda reducirse a demanda para lograr la aceptación de una red eléctrica ya sometida a presión, prometiendo pagar sus propios costes; el único ahorro cuantificado para los hogares procede de Georgia Power y abarca al conjunto de sus grandes clientes. Google está en la fase de hacer que una TPU en órbita escriba un haiku: un hito de viabilidad, sin cifras de rendimiento, antes de conectar dos satélites en 2027.
LifeVal, Design Creativity Bench y BrowseSafe++ miden lo que las clasificaciones de código y matemáticas no ven. LifeVal muestra una progresión que se ralentiza, 0,6 puntos entre GPT-5.6 y GPT-6 Astra, pero sigue siendo un banco de pruebas interno, sin competidores ni un conjunto de tareas publicado. Kombai señala una convergencia de las interfaces que la tasa de éxito oculta, y BrowseSafe++ separa la detección de la resistencia: un modelo que detecta una inyección puede aun así seguirla, y un detector de 0,8B, más de cien veces más barato que una llamada a la API, no basta frente a un atacante que vuelve a intentarlo.
Sakana AI opta por controlar toda la cadena con Sawara, desde el preentrenamiento hasta los productos, pero con un calendario condicionado y sin un tamaño anunciado. Runway y Synthesia hacen lo contrario: se instalan donde los usuarios ya trabajan, en el agente de código o en la conversación de ChatGPT y Claude, en lugar de atraerlos a su propia aplicación. ElevenLabs aporta el argumento cuantificado a favor de la voz para las conversaciones largas, con un estudio del proveedor cuya base varía entre el tweet y la publicación, mientras que NVIDIA equipa a quienes simulan la conducción, la robótica o la cirugía con Cosmos 3 Nano.
Fuentes
- El artículo de Anthropic sobre los message threads
- @ClaudeDevs: los message threads en Claude Code
- La documentación de los message threads
- Resumen del simposio 2026 de Sakana AI
- @SakanaAILabs: resumen del simposio
- Presentación del Grid Protectors Program (OpenAI)
- Primera respuesta del satélite prototipo de Project Suncatcher (Google)
- LifeVal (OpenAI)
- Por qué creamos Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- Plugins de Runway Dev para agentes de programación
- @synthesiaIO: vídeos de Synthesia en ChatGPT y Claude
- Por qué la voz es más eficaz en conversaciones complejas y estresantes (ElevenLabs)
- @ElevenLabs: estudio sobre voz frente a chat
- Crea modelos de mundo para la simulación interactiva con NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 de Gemini CLI
- CLI mistral 0.16.0
- Estudio de caso de Qodo y Codex (OpenAI)
- @zeddotdev: corgi
- pull_request_target bloqueado por defecto el 2 de diciembre (GitHub)
- Las evaluaciones de riesgos incluyen el estado de protección de los repositorios (GitHub)
- Registro de cambios de la API de Perplexity
- Entrada de Dragonscale sobre kniv v7
- Entrada sobre la ventana deslizante y Bifocal
- Entrada de VIDRAFT sobre la puerta trasera
- Entrada de Rairo Mukamuri sobre Beam
- @vanstriendaniel: Saturate
- Entrada de EcoHash sobre LTX 2.5
- Mobiel AI de KPN (ElevenLabs)
- Notas de la versión de Suno Studio
- @Kling_ai: temporada 2 de los Chroma Awards
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk y el solucionador SCF
- Los anuncios de IA de Google en octubre de 2026
- Memoria de los agentes de IA (Perplexity)
- The Knowledge Talk (Perplexity)