ai-powered-markdown-translatorgpt-6.1-solを使用してフランス語から日本語に翻訳された記事。
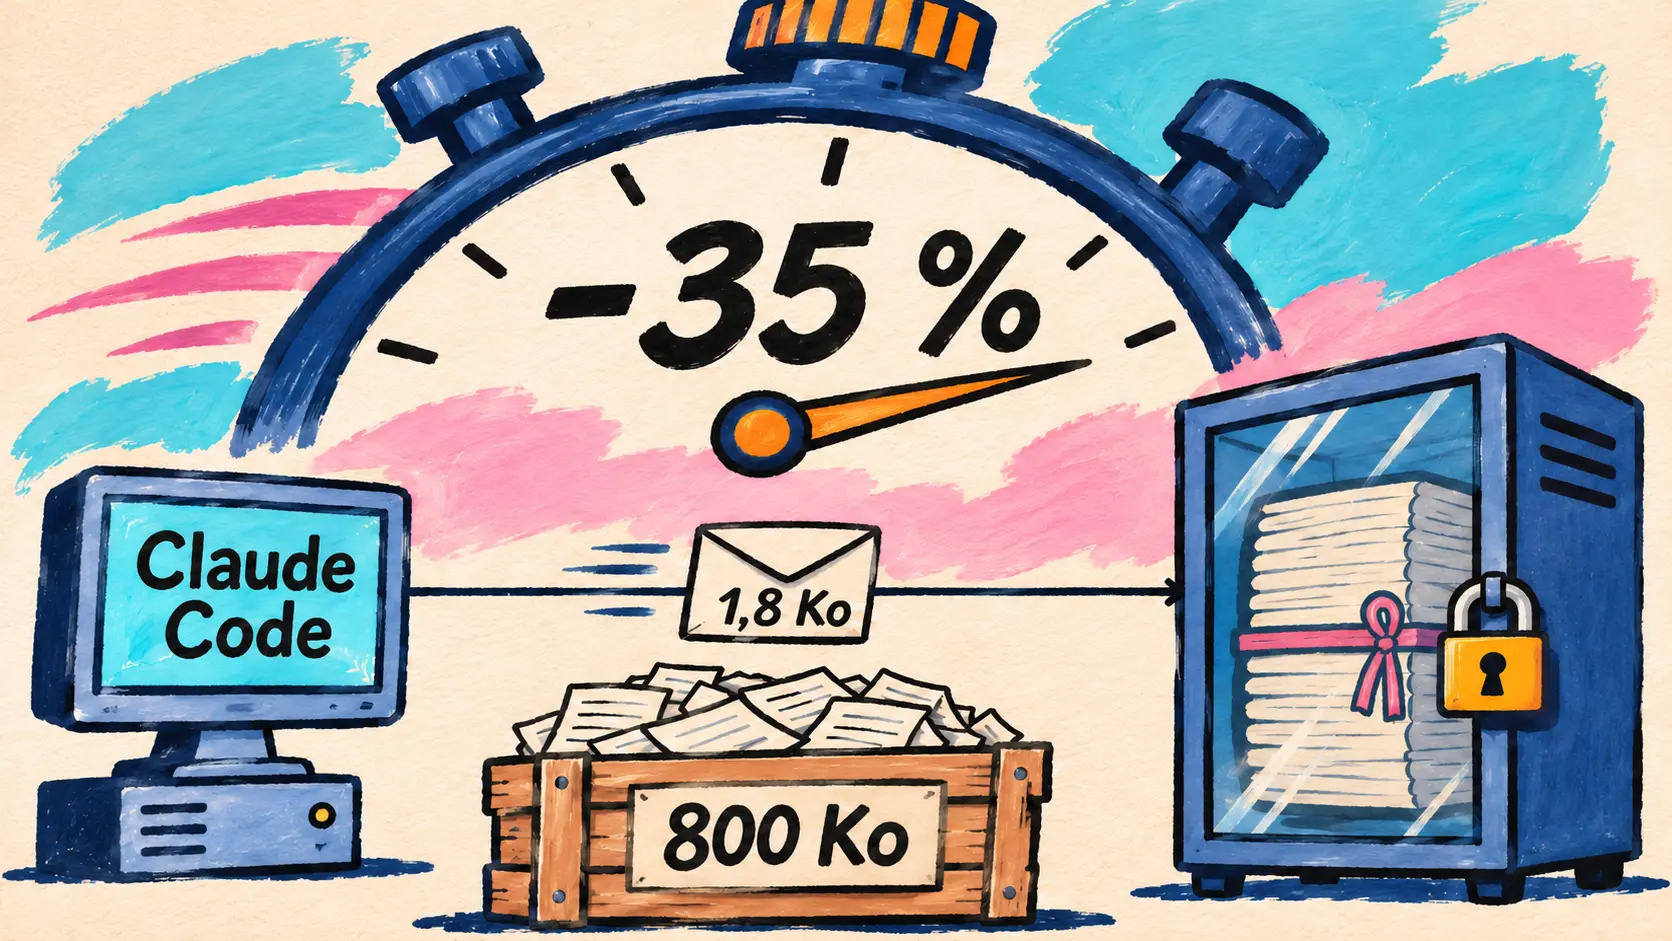
AnthropicがMessages APIのメッセージスレッドを公開ベータ版として提供開始した。すでにClaude Codeで稼働しており、特に長いリクエストでは最初のトークンが返るまでの時間を約35 %短縮している。Sakana AIは、ゼロから事前学習する初のモデル群Sawaraを発表。一方、OpenAIは計算キャンパスの電力需要を電力網の状況に応じて抑制するGrid Protectorsを開始し、日常生活のタスクを評価するベンチマークLifeValを公開した。Perplexityはプロンプトインジェクション対策のBrowseSafe++を公開し、NVIDIAはCosmos 3 Nanoでシミュレーション環境を支援する。Runway、Synthesia、ElevenLabsは、生成メディアをアシスタントやエージェントに組み込んでいる。
Messages APIがメッセージスレッドの公開ベータ版を提供開始、Claude Codeではすでに稼働
11月2日 — AnthropicがMessages APIでメッセージスレッド(message threads)の公開ベータ版を提供開始した。これまでは、エージェントが毎ターン、ツールの実行結果を含む会話全体を再送していた。スレッドを使うと、最初のリクエストでシステムプロンプトとツールを含む会話全体を送り、以降は新しいメッセージと直前の応答の識別子だけを送る。APIが残りの内容を復元してからモデルを呼び出す仕組みだ。パラメーターthreadとベータ版ヘッダーmessage-threads-2026-08-12を追加するだけで利用でき、公式SDKには専用のヘルパー関数が用意されている。
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇯🇵 私たちは最近、Claude Codeにメッセージスレッドを導入しました。500 000〜100万トークンのリクエストでは、最初のトークンが返るまでの時間の中央値が約35 %短くなっています。長い会話では、リクエストサイズの中央値が約800キロバイトから1,8キロバイトに減りました。 — Xの@ClaudeDevs
改善されるのは遅延であり、料金ではない。Claudeは毎ターン会話全体を読み直すため、トークン数、料金、レート制限は変わらず、プロンプトキャッシュ(prompt caching)も引き続き利用者が明示的に要求する必要がある。スレッドの保持はベストエフォート(best-effort)で、暗号化されたメモリー上に保存され、ディスクには書き込まれない。最後のリクエストから5分で期限切れになるため、APIが404を返した場合に全内容を再送できるよう、アプリケーション側でもコピーを保持する。この機能はデータ保持ゼロ(ZDR)の対象外で、Message Batches、オンデマンドのコンパクション、HIPAA対象組織では利用できない。Claude API、Claude Platform on AWS、Claude in Microsoft Foundry、Claude Models on Google Cloud(Anthropic管理)で利用できる。
🔗 メッセージスレッドに関するAnthropicの記事 · メッセージスレッドのドキュメント
Sakana AIがゼロから事前学習する初のモデル群Sawaraを発表、重みは2027年春に公開予定
11月2日 — Sakana AIが、10月26日に東京で開催したシンポジウムの報告を公開した。参加者は400人以上で、ユルゲン・シュミットフーバー氏が講演した。この報告には重要な発表が含まれている。日本の同スタートアップが、独自の言語モデルの事前学習に取り組むというものだ。これまではエージェントと、Namazuによる既存のオープンモデルの事後学習に取り組んできた。最高科学責任者(Chief Scientist)の秋葉拓哉氏が紹介したSawaraシリーズ(仮称)は、他社のモデルを出発点とせずゼロから構築し、ツールを使った推論、コーディング、長時間のタスクなど、エージェントとしての利用を前提に設計される(agent-native)。Sakana AIの製品と、RSI Labによる再帰的自己改善の研究の基盤となる予定だ。
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇯🇵 現在、学習の準備を進めており、12月にSawara Small(仮称)の事前学習を開始します。順調に進めば、来春に重みを公開します。 — Sakana AI、2026年シンポジウム報告
Sawara Largeも仮称で、後に続く予定だが、時期は示されていない。Sakana AIは、モデルの規模、データ量、計算予算のいずれも明らかにしていない。
計算を支える電力:OpenAIがGrid Protectorsを開始、GoogleのTPUが軌道上から応答
OpenAIがGrid Protectorsを開始、エフィンガムのキャンパスで最大1 000 MWの電力需要を抑制
11月2日 — OpenAIがGrid Protectorsを開始した。寒波や猛暑で電力網の需給が逼迫した際、今後建設する計算キャンパスの電力消費を抑えるための全米規模のプログラムだ。同社は電力会社、規制当局、政策担当者とともに、需要を抑制できる電力量、対応までの時間、継続時間を定める契約を拠点ごとに結ぶ方針。地域の必要に応じて、キャンパス内の発電設備や蓄電設備も活用し、蓄電池で電力需要を平準化する。
試験導入先は、7月にProject Camelliaとして発表された、ジョージア州エフィンガム郡に建設予定のキャンパス。OpenAIは、同拠点のインフラと電力供給サービスにかかる費用を全額負担すると約束している。
| 発表された指標 | 発表値 | 数値の出典 |
|---|---|---|
| Georgia Powerとの契約で予定する柔軟な需要抑制 | 最大1 000 MW | OpenAI |
| 一般家庭の平均電力需要に換算 | 約700 000世帯分 | OpenAI |
| 2029年以降のGeorgia Powerの顧客の年間節約額 | 約950百万ドル | Georgia Power |
| 1 000 kWhを消費する標準的な家庭の節約額 | 月額15ドル以上 | Georgia Power |
Georgia Powerの予測は、Project Camelliaを含む大口需要家との契約全体と、見込まれる需要の増加を対象にしている。OpenAIのプログラムだけによる数値ではない。同社は、需要の柔軟な調整が新たな発電・送電能力への投資に代わるものではないと認めており、他の拠点や日程は発表していない。
🔗 Grid Protectorsに関するOpenAIの投稿
Project Suncatcher:軌道上のTPUが初応答、Gemma 4が俳句を作成
10月30日 — 過去の発表を補足する。10月1日の試作衛星打ち上げから1か月後、宇宙空間でのAI計算を研究するGoogleのProject Suncatcherが「Hello World」の節目に到達した。軌道上のデータセンター級TPUが、初めてAIの応答を生成したのだ。衛星が地上局の上空を通過する際、チームは搭載されたオープンモデルGemma 4に、宇宙での生活について俳句を作るよう求めた。その応答は、衛星がノルウェーのスヴァールバル諸島上空を通過した際に地上へ届いた。その後はリメリックやテレメトリーに関するプロンプトも試し、モデルは搭載機器の技術的な状態を説明する応答を返している。
今後の焦点は信頼性だ。2027年に相互接続された2機の衛星を投入する前に、熱ストレスや放射線の下でTPUを試験する。投稿には、性能や消費電力の数値は示されていない。
日常生活とインターフェースの創造性:OpenAIがLifeVal、KombaiがDesign Creativity Benchを公開
LifeVal:日常生活の169タスクで、GPT-5.2の49,3 %からGPT-6 Astraの80,6 %へ
11月2日 — OpenAIがLifeValを公開した。子どもの預け先を探す、公共サービスを利用する、家計を立てる、レシピを調整する、運動プログラムを組むといった日常生活のタスクでモデルを評価するものだ。タスクは、米国生活時間調査と多国間生活時間研究という2つの大規模な生活時間調査を基にしている。さらに、どの分野で最も支援を求めているかを尋ねた、代表性のある3 995人の調査を組み合わせた。OpenAIによると、同社はモデルの進歩を追跡するため、1年前からこの評価を使っている。
| 評価対象モデル | 公開時期 | 169タスクの平均報酬 |
|---|---|---|
| GPT-5.2 | 2025年12月 | 49,3 % |
| GPT-5.4 | 2026年3月 | 73,0 % |
| GPT-5.5 | 2026年4月 | 77,4 % |
| GPT-5.6 | 2026年7月 | 80,0 % |
| GPT-6 Astra (xhigh) | 2026年9月 | 80,6 % |
グラフの説明によると、数値は169タスクの加重なしの平均で、GPT-5.6とGPT-6 Astraの差はわずか0,6ポイント。グラフにはGPT-6.1 SolやTerraも、他社のモデルも含まれておらず、OpenAIはタスクセットの公開にも言及していない。
Design Creativity Bench:モデルが似たインターフェースに収束
11月2日 — フロントエンド開発向けAIツールを提供するKombaiが、Hugging FaceのブログでDesign Creativity Benchを紹介した。インターフェースが機能するかではなく、他のインターフェースにどれだけ似ているかを測るベンチマークだ。調査では、15の最先端モデル、160の指示、2 400のHTMLインターフェースを対象に、人間が作ったデザイン案と比較した。
| ベンチマークの指標 | 評価対象モデル | 人間の基準値 |
|---|---|---|
| 同じ指示に対する平均的な差異 | モデル間で0,592 | 人間とモデルの間で0,764 |
| 創造性の幅の平均 | 0,581 | 0,902 |
| 満たした受け入れ基準 | 全モデルで90 %超(Claude Opus 5.5:99,2 %) | 98,0 % |
つまり、モデルは要件を満たす一方、互いに似たものを作る。GPT-6 Astraは比較対象の中で最も特徴的なスタイルを持つ(独自性0,646)が、状況が変わっても作風の変化は小さい(幅0,472)。Kombaiは論文(arXiv 2610.11539)、ランキング、再現検証用のサブセットを公開し、対象がデスクトップ画面のみで、APIのデフォルト設定を使っているという限界も認めている。
Perplexityがプロンプトインジェクション対策のBrowseSafe++と検出モデルBrowseSafe-Guardを公開
11月2日 — Perplexityのセキュアインテリジェンス研究所が、BrowseSafe(2025年12月)の後継となるBrowseSafe++を公開した。ウェブを閲覧できるエージェントを狙う間接的なプロンプトインジェクション(indirect prompt injection)に特化したオープンなベンチマークだ。攻撃を仕込んだページと、その攻撃を含まない対応ページからなる38 675組を収録し、うち32 187組は実際に観測されたインジェクションを基に作成している。Cometの検出機能は、2025年9月から2026年9月までに115万件を検知した。各ページはHTML、Markdown、アクセシビリティツリー、スクリーンショットの形式で用意される。Perplexityはこれを基に、Qwen3.5-0.8Bをファインチューニングした0,8Bの検出モデル2種、BrowseSafe-Guardを開発した。一方はテキスト用、もう一方はスクリーンショット用だ。
| 公開された結果 | BrowseSafe-Guard | 比較対象モデル |
|---|---|---|
| テキスト形式でのF1 | 約95 %、各形式で首位 | 汎用モデルの上位は85〜92 % |
| スクリーンショットでのF1 | 約93 % | 他のモデルの最高値は約79 % |
| 正常なページの誤検知 | 約20ページに1ページ | GPT-6 Astraは14,41 % |
| 1 000ページ当たりの費用 | レンタルしたH200で0,18ドル | APIでは18,95〜180,61ドル |
検出できることは、攻撃に耐えられることを意味しない。すべてのモデルが、自ら検出したインジェクションに従うケースを示し、その割合はGPT-6 Astraの1,64 %からLlama 3.1 8Bの24,73 %に及んだ。粘り強く攻撃すれば、最終的には突破できる。失敗するたびにインジェクションを書き直すBrowseSafe-Adapt環境(1 024タスク、最大64回の試行)では、初回の成功率は最大でも4 %だったが、試験した7つのエージェントのうち5つでは最終的に79 %以上に達した。Gemini 3.5 Flash-Liteのエージェントの前段にGuardを置くと、元のインジェクションの94,5 %をブロックするが、それでも攻撃者は84,2 %のタスクで成功した。データセット(アクセス制限付き)、MITライセンスのSDK、公開ランキングを利用できるが、投稿には検出モデルの重みへのリンクはない。
🔗 BrowseSafe++に関するPerplexityの投稿
生成メディア:Runway DevがClaude CodeとCursorに、SynthesiaがChatGPTとClaudeに登場、ElevenLabsが音声の優位性を数値化
Runway DevがClaude CodeとCursorに登場
11月2日 — 10月28日に発表したCodex対応に続き、RunwayがRunway DevのプラグインをClaude CodeとCursorにも拡大した。インストールすると、RunwayのMCPサーバーを通じてコーディングエージェントがRunway Devアカウントに接続され、生成メディアAPIを使って開発するためのRunwayのスキルが追加される。エージェントはまずアカウント情報(プロジェクト、利用可能なモデルとその料金・制限、クレジット残高)を確認し、その後、公式SDKを使う。リクエストごとに適切なモデルを選ぶModel Routerや、リアルタイムアバター用のCharacterを作成できるほか、Recipes(すぐに使えるパイプライン)や、APIエンドポイントとして公開されたWorkflowsを再利用できる。失敗した場合はエラーの詳細を確認する。アカウントへの接続は初回利用時に行い、プラグイン内にAPIキーは保存しない。プラグイン固有の料金は示されていない。
| コーディングエージェント | Runwayが示すインストール方法 |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | エージェントチャットで/add-plugin runway-api、またはCursor Marketplaceから |
SynthesiaがChatGPTとClaude内で動画を作成
11月2日 — Synthesiaが、アバター動画をChatGPTとClaudeで直接作成できるようになったと発表した。利用者が作りたい動画を説明すると会話内に動画が表示され、追加の指示で調整し、そのまま公開・共有できる。別のアプリケーションやタブを開く必要はない。発表はデモ動画付きの投稿1件のみで、確認時点ではSynthesiaのブログにもホームページにも記事は掲載されていなかった。Synthesiaはこの投稿で、連携の仕組み、対象プラン、料金のいずれも明らかにしていない。
ElevenLabs:2分を超える会話では音声の成功率がチャットより32 %高い
11月2日 — ElevenLabsが、本番環境のElevenAgentsエージェントで音声(電話とWhatsApp)とチャットを比較した調査を公開した。各エージェントについて、2026年5月から7月の会話を使い、同じエージェントの音声とチャットを比較している。発表の投稿では469のエージェントに言及しているが、記事では「数百」のエージェントとしている。
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇯🇵 会話が長くなるほど、音声エージェントの成功率は高くなります。本番環境で音声とチャットの両方に対応する469のエージェントを分析したところ、興味深い傾向が見られました。会話が複雑になると、音声が解決への最短経路になります。 — Xの@ElevenLabs
| ElevenLabsによる指標 | 測定値 |
|---|---|
| 2分を超える会話での音声の成功率 | +10,9ポイント、すなわち+31,7 % |
| 1分未満の会話 | チャットが約9ポイント上回る |
| 成功した長い会話の所要時間 | 音声で4,6分、チャットで7分 |
| より高速なLLMへの切り替え(315件の会話) | レイテンシが16 %低下、成功率が26 %向上 |
| 音声の選好率(参加者98人、欠航時) | 85 % |
ここでは会話時間を複雑さの指標として用いており、記事もそれが不完全な指標であることを認めている。また、調査を行ったのは提供元で、記事内では自社の音声エージェントを宣伝している。
NVIDIA、運転・ロボティクス・手術向けにCosmos 3 Nanoのシミュレーション手順を公開
11月2日 — NVIDIAが技術ブログで、フィジカルAI向けの世界基盤モデル(ワールドファウンデーションモデル)プラットフォームであるCosmosのガイドを2部構成で公開した。前半は、10月22日に発表され、今回名称と詳細が示された新しいCosmos 3 Nanoチェックポイントを使うシミュレーション手順で、後半はNIMマイクロサービスの使い方を扱う。紹介された例では、プロンプトを変えるだけで、道路の形状や車両の軌跡を変えずに、昼間の走行を雨の夜の走行に変換できる。
| Cosmos 3チェックポイント | NVIDIAが説明する用途 |
|---|---|
| Cosmos3-Nano-Transfer-Auto | 運転向けのLiDAR付きマルチカメラ映像。480pまたは720pで最大400フレーム |
| Cosmos3-Nano-Sim-Auto | 運転方策を閉ループでテストするため、ストリーミング生成を行う蒸留済みの因果モデル派生版 |
| Cosmos3-Nano-Sim-Transfer | ロボティクス向けに、深度動画を詳細なRGB動画に変換 |
| Cosmos3-Nano-Sim-Bimanual | シーンと動作から双腕ロボットの次の観測を生成 |
| Cosmos3-H-Embodied-NanoとCosmos3-H-Dreams | ロボットの動作に基づく手術シミュレーション。H-Dreamsはリアルタイムに対応 |
デプロイ面では、NIMイメージcosmos3:2.0.0がレイテンシ重視とスループット重視のプロファイルを提供する。NVIDIAによると、投機的デコーディングによりH200での推論が平均約2~3倍高速化し、CosmosのNIMは20種類以上のGPUで認定されているという。生成時にCosmos3-Nanoが必要とするVRAMは、BF16で58 Gio、オフロードを使うFP8で31 Gio。Cosmos Frameworkには強化学習パイプライン(DPO、GRPO、PPO、OPD、DiffusionNFT)が加わり、11月5日木曜日には関連するライブ配信が行われる。
Copilot CLI 1.0.106-3プレビュー版:任意で有効化するセッション管理と145件の修正
11月2日 — GitHubが、1.0.106系統で3番目となるCopilot CLIのプレビュー版1.0.106-3を公開した。リリースノートに記載された追加機能は1つだけで、任意で有効化する(オプトイン)セッション管理ツールと、それを有効化したローカルセッションを@でメンションできる機能だ。それ以上の詳細はない。管理対象アカウントでは、ポリシー更新時の警告にPolicy Helperの検出結果が反映されるようになった。
残る145件の修正は主にターミナルインターフェースの堅牢性に関するもので、セキュリティに関わるものも複数ある。
| セキュリティ修正 | 1.0.106-3より前の動作 |
|---|---|
| エスケープシーケンスのフィルタリング | 応答、ファイル名、MCPツールのタイトルによって、タイムラインの表示スタイルを変えたり行を隠したりできた |
/allow-all off | 後ろに表意文字用の全角スペース(CJK入力)があると、コマンドがAllow Allを解除せずに有効化していた |
/session delete | 識別子の前に不明なオプションを置くと、確認なしに現在のセッションを削除していた |
copilot -pとcopilot workflow run | テキスト出力に--secret-env-varsの値が表示されていた。JSON出力ではすでに非表示になっていた |
最新の安定版は引き続き10月28日の1.0.105で、同じ夜に公開されたCopilot SDK 1.0.29-preview.2にはSDK側の変更はない。
🔗 Copilot CLI 1.0.106-3のリリースノート
短報
コーディングエージェントとツール
- Qwen Code v0.26.6 — v0.26.5の翌日となる11月2日の安定版。Web Shellにセッションのアクティビティ表示が加わり、モデルごとの成功率、出力速度、最初のトークンまでのレイテンシを表示する。Kimi K3モデルのコンテキストウィンドウは100万トークンになった。🔗 出典
- Gemini CLI — 11月2日夜にマージされた修正により、Whisperモデルのダウンロードが中断された場合に、インストール済みと誤認されることを防ぐ。従来はこの誤認により、ファイルを手動で削除するまでローカル音声モードが使えなくなっていた。この修正はまだどのリリースにも含まれておらず、当日のナイトリー版も直前の2回と同じコミットを使っている。🔗 出典
- CLI mistral 0.16.0 —
mistral workflows initとmistral initがWorkflowプロジェクトのAPIキーを要求し、Mistral APIで検証したうえで、プロジェクトの.envに保存するようになった。🔗 出典 - Codex向けQodoプラグイン — OpenAIが公開した導入事例で、QodoがCodexのマーケットプレイスにある自社プラグインを紹介している。Codexはコードを書く前に組織のルールとプルリクエストの履歴を受け取り、プルリクエストを開く前に、同じセッションでQodoのレビューを受ける。成果を示す数値はない。🔗 出典
- Zedが紹介したcorgi — 11月1日夜、Zedがコンラッド・アーウィンによるCargo互換のRustビルドツール、corgiのサイトを紹介した。マシンごとに1つのキャッシュを使い、build.rsとマクロをサンドボックス内で実行し、テスト結果もキャッシュする。作者によると、コードのほぼすべてがAIによって書かれている。リポジトリはMITライセンス。🔗 出典
開発プラットフォームとAPI
- GitHub Actionsのpull_request_target — 公開リポジトリで
pull_request_targetをデフォルトでブロックする措置が、11月2日から12月2日に延期された。11月9日と16日の16時から18時UTCに予定されている2回の一時停止で、影響を受けるワークフローが明らかになる。🔗 出典 - GitHubのリスク評価 — GitHub Enterprise CloudとGitHub Teamで、コードとシークレットのセキュリティリスク評価に、各検出結果が保護されたリポジトリ内にあるかどうかが表示されるようになった。🔗 出典
- PerplexityのAnalytics API — Computerのクレジット使用量に関する応答では、現在、クレジットの出所別内訳(Credit Source)が省略されている。合計とモデル別内訳は引き続き提供されており、Perplexityは、内訳がないことを使用量ゼロと解釈しないよう求めている。🔗 出典
オープンモデルとコミュニティ記事
- Dragonscaleのkniv v7 — 55Mから538Mパラメータの6つのオープンなエンコーダー(Apache-2.0、ONNX)。エージェントの記憶向けに、呼び出し時に記述するスキーマに沿って、LLMを使わずにエンティティ、関係、事実を抽出する。Re-DocREDでは、同一文内で0,749、2文離れた場合に0,732を記録した(DeBERTa派生版)。🔗 出典
- スライディングウィンドウとBifocal層 — コミュニティ記事で、ルーカスがQwen3-4B-Instructを同じメモリ容量の4つの生徒モデルに蒸留した。短い回答にはスライディングウィンドウだけで十分だが、AIMEとHMMTでは、小さなウィンドウとmLSTMの状態を組み合わせたBifocal層が、約14 %で頭打ちになるウィンドウ単独の場合に比べ、ほぼ2倍の問題を解いた。測定は著者によるもの。🔗 出典
- ViKernelが阻止したバックドア — VIDRAFTがファインチューニングによってQwen3-0.6Bにバックドアを埋め込んだ。ファイルパス内の「payroll」という語が、未使用のパスで98,3 %の確率で悪意あるコマンドを発動させ、24種類の検査でも検知されなかった。ViKernel上では、290件のペイロードがすべて実行前に拒否された。重みは非公開。🔗 出典
- Beamのルーティングとテストでの不正 — ライロ・ムカムリによる事前登録済みの研究では、Beam-1.0-501B-A23Bのエキスパートルーティングから、500トークン先のテスト改ざんを予測できなかった。AUROCは0,580で、設定したしきい値0,75を下回った。計算費用は9,03ドル。🔗 出典
- Saturate — ダニエル・ファン・ストリーンが、Hugging Face Jobsの単一GPUでアーカイブ14 483ページを再度OCRにかけ、費用1,47ドル、毎秒8,9ページを達成した。使用したのは、任意のOpenAI互換エンドポイントに対してバッチ推論を行う、自作のApache-2.0ライブラリSaturate。🔗 出典
画像、動画、音声、音楽
- RTX PRO 6000で動くLTX 2.5 — GPUレンタル事業者EcoHashが、96 Goのカード1枚で、音声付き10秒の動画を1080pでは90秒、480pでは14,8秒で生成した。測定は提供元が自社サービス上で行ったもの。🔗 出典
- KPNのMobiel AI — ElevenLabsが、オランダの中小企業向けにKPNが提供する通話アシスタントを詳しく紹介した。留守番電話の文字起こし、通話要約、電話メニューに対応する。オランダ語でのファインチューニングにより、検証時の精度が約50 %から90 %に向上した。料金の記載はない。🔗 出典
- Suno Studio — 10月29日分の補足情報で、11月2日に再紹介されたもの。クリップ設定がサイドバーに移り、ピッチを半音とセント単位で調整できるようになった。インポートした音声をプロジェクトのテンポに合わせて伸縮でき、Shift-Hでトラックを非表示にできる。🔗 出典
- KlingとChroma Awards — Klingがコンテストのシーズン2のパートナーになった。賞金総額は450 000ドル超で、応募締め切りは1月7日。🔗 出典
プログラム、デモ、研究機関の記事
- Anthropic Residency — Anthropicが、教授、技術系の創業者、スタッフ級エンジニアを対象とする、6週間から6か月の有給研究プログラムの応募を11月22日まで受け付けている。機械学習の事前知識は不要で、報酬は年額350 000~500 000ドル相当。🔗 出典
- SpaceXSIのData Bot — 社内導入事例。Grok BotのTeam Botが、データチームの管理するスキルを使い、全社向けのデータサイエンティストとして働く。SpaceXSIの推計によると、1週間で約70時間分の業務を引き受けたという。🔗 出典
- Le Chonkと量子化学 — MistralがXで、Mistral Large 4がSCFソルバーと分子の解離を表示する3Dビューをゼロから作る様子を紹介した。コードや数値は公開していない。🔗 出典
- Googleの10月の振り返り — 上で取り上げたProject Suncatcherの衛星からの応答を除き、新たな発表はない。🔗 出典
- Perplexityのエージェント記憶 — 記憶の種類と永続的な記憶を持つエージェントの構築方法を解説するガイド。Computerですでに利用できるBrainを案内している。🔗 出典
- The Knowledge Talk — Perplexityが、10月3日にCambridge Union Societyで行われたアラヴィンド・スリニヴァスの講演の文字起こしを公開した。発表はない。🔗 出典
これが意味すること
メッセージスレッドは、料金を変えずに会話状態の一部をサーバーへ移す。トークン数と料金は同じで、短くなるのは待ち時間だけだ。効果が最も大きいのは、数十万トークンが蓄積するエージェントのセッションである。暗号化されたメモリに5分間保持し、再読み出し用のAPIを備えない一時的なスレッドを採用することで、アプリケーションは履歴の主導権を維持できるが、対象外となる条件も明確だ。ZDR、Batches、HIPAA対象の組織は利用できない。ターミナル側では、ファイル名やモデルの応答によって画面の表示スタイルを変えられたことから、Copilot CLIのプレビュー版が、インターフェース自体も攻撃対象になることを改めて示している。
Grid ProtectorsとSuncatcherは、計算に必要な電力という同じ制約に、まったく異なる時間軸で対応している。OpenAIは、すでに逼迫した電力網に受け入れてもらうため、需要に応じて電力消費を抑制できるキャンパスを提案し、自らの費用は自ら負担すると約束している。家庭向けに数値で示された唯一の節約効果はGeorgia Powerによるもので、同社の大口顧客全体を対象としている。Googleは、軌道上のTPUに俳句を書かせる段階にある。これは実現可能性を示す節目であり、性能の数値はなく、2027年に2基の衛星を接続する計画に先立つものだ。
LifeVal、Design Creativity Bench、BrowseSafe++は、コーディングや数学のランキングでは見えないものを測っている。LifeValは進歩の鈍化を示しており、GPT-5.6からGPT-6 Astraへの向上は0,6ポイントにとどまるが、自社製のベンチマークで、競合モデルとの比較もタスクセットの公開もない。Kombaiは、成功率の数字に隠れてしまうインターフェースの画一化を指摘している。BrowseSafe++は検知と耐性を分けて扱う。インジェクションを見つけたモデルでも、それに従ってしまうことがある。API呼び出しの100分の1未満のコストで動く0,8Bの検出器でも、試行を繰り返す攻撃者には十分ではない。
Sakana AIはSawaraで、事前学習から製品までの全工程を自ら管理する道を選んだが、スケジュールは条件付きで、規模も公表されていない。RunwayとSynthesiaは逆の道を進む。利用者を自社アプリに呼び込むよりも、コーディングエージェント内やChatGPT、Claudeとの会話内など、利用者がすでに作業している場所に進出している。ElevenLabsは、長い会話で音声を使う利点を数値で示しているが、その根拠は提供元自身の調査で、対象数の記述が投稿と記事で異なる。一方、NVIDIAはCosmos 3 Nanoで、運転、ロボティクス、手術のシミュレーションを行う人々にツールを提供している。
出典
- メッセージスレッドに関する Anthropic の記事
- @ClaudeDevs:Claude Code のメッセージスレッド
- メッセージスレッドのドキュメント
- Sakana AI の2026年シンポジウム報告
- @SakanaAILabs:シンポジウム報告
- Grid Protectors Program のご紹介 (OpenAI)
- Project Suncatcher の試作衛星からの最初の応答 (Google)
- LifeVal (OpenAI)
- Design Creativity Bench を開発した理由 (Kombai)
- BrowseSafe++ (Perplexity)
- コーディングエージェント向け Runway Dev プラグイン
- @synthesiaIO:ChatGPT と Claude での Synthesia 動画
- @ElevenLabs:複雑でストレスの多い会話で音声が優れている理由
- @ElevenLabs:音声とチャットの比較研究
- NVIDIA Cosmos でインタラクティブなシミュレーション向けの世界モデルを構築
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- Gemini CLI の PR 30058
- CLI mistral 0.16.0
- Qodo と Codex の導入事例 (OpenAI)
- @zeddotdev:コーギー
- 12月2日からデフォルトでブロックされる pull_request_target (GitHub)
- リスク評価にリポジトリの保護状態を追加 (GitHub)
- Perplexity API の変更履歴
- kniv v7 に関する Dragonscale の記事
- スライディングウィンドウと Bifocal に関する記事
- バックドアに関する VIDRAFT の記事
- Beam に関するライロ・ムカムリの記事
- @vanstriendaniel:Saturate
- LTX 2.5 に関する EcoHash の記事
- KPN の Mobiel AI (ElevenLabs)
- Suno Studio のリリースノート
- @Kling_ai:Chroma Awards シーズン2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI:Le Chonk と SCF ソルバー
- Google による2026年10月の人工知能関連の発表
- 人工知能エージェントのメモリ (Perplexity)
- 知識を語る (Perplexity)