ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
Anthropic deschide în versiune beta publică funcționalitatea message threads din API-ul Messages, deja activă în Claude Code, unde reduce cu aproximativ 35 % timpul până la primul token pentru cele mai lungi cereri. Sakana AI anunță Sawara, primele sale modele preantrenate de la zero, în timp ce OpenAI lansează Grid Protectors pentru a permite campusurilor sale de calcul să își reducă la cerere consumul din rețeaua electrică și publică LifeVal, un benchmark cu sarcini din viața cotidiană. Perplexity publică BrowseSafe++ împotriva injecțiilor de prompt, NVIDIA oferă instrumente pentru simulare cu Cosmos 3 Nano, iar Runway, Synthesia și ElevenLabs integrează conținutul media generativ în asistenți și agenți.
API-ul Messages lansează message threads în versiune beta publică, deja active în Claude Code
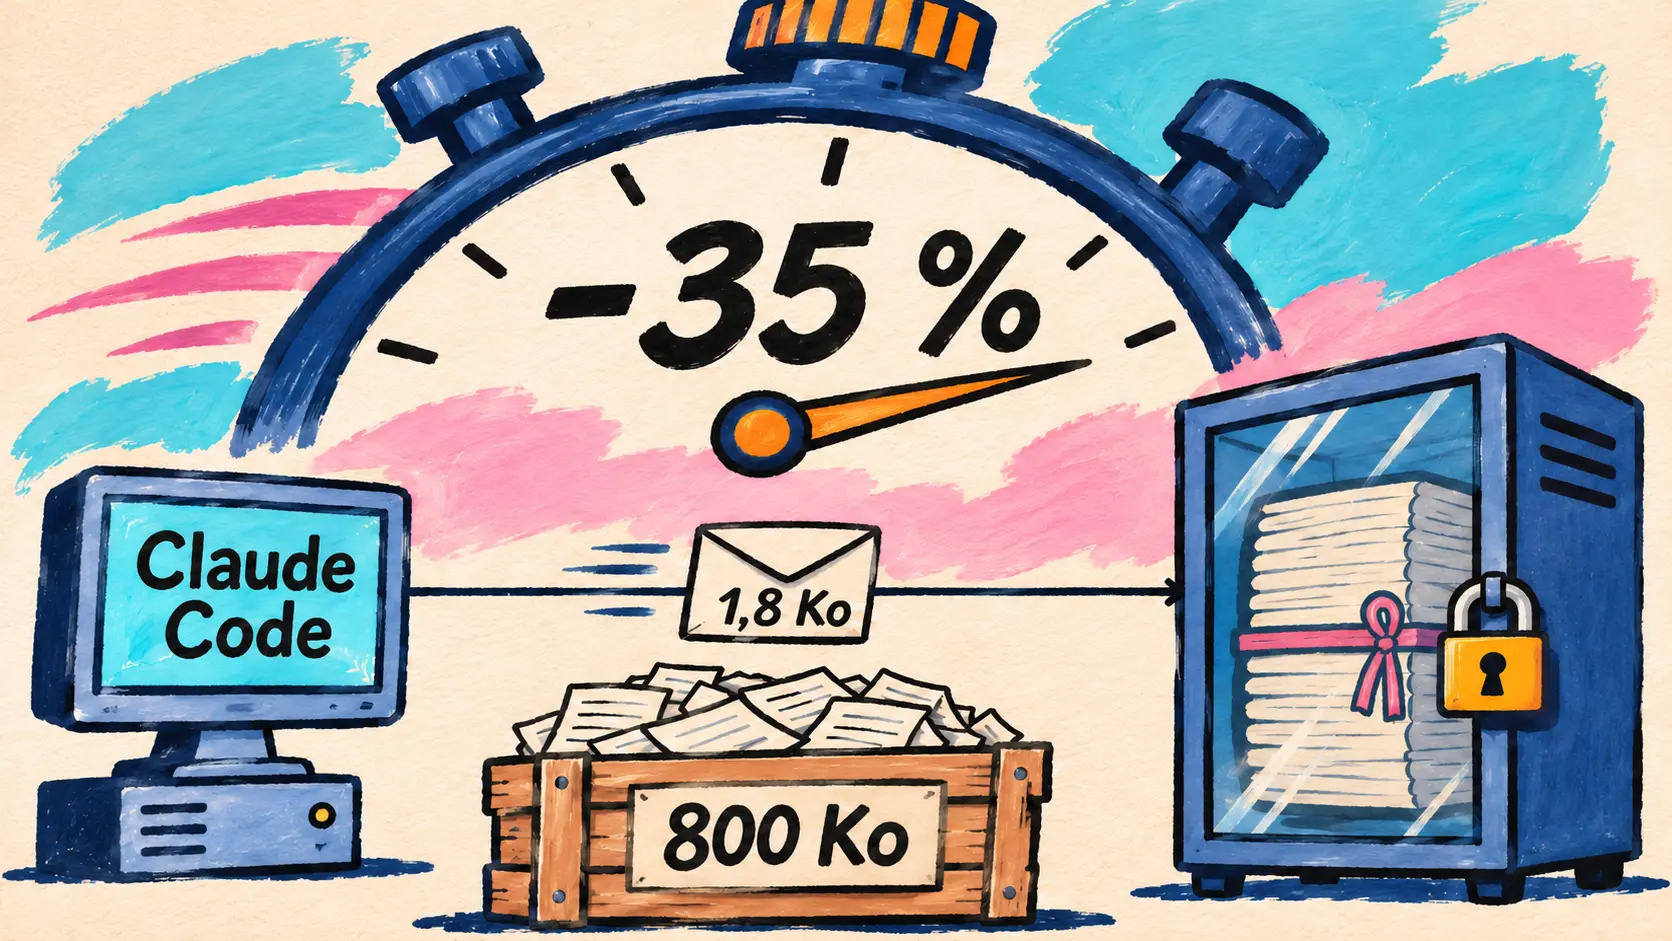
2 noiembrie — Anthropic deschide în versiune beta publică firele de mesaje (message threads) în API-ul Messages. Până acum, un agent retrimitea la fiecare pas întreaga conversație, inclusiv rezultatele instrumentelor. Cu un fir de mesaje, prima cerere trimite conversația completă, cu promptul de sistem și instrumentele; următoarele trimit doar mesajele noi și identificatorul răspunsului precedent, iar API-ul reconstituie restul înainte de a apela modelul. Este suficient să adăugați parametrul thread și antetul beta message-threads-2026-08-12, pe care SDK-urile oficiale le gestionează printr-o funcție ajutătoare dedicată.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇷🇴 Am integrat recent message threads în Claude Code. Pentru cererile de 500 000 până la 1 milion de tokeni, timpul median până la primul token este cu aproximativ 35 % mai mic. În conversațiile lungi, dimensiunea mediană a cererii a scăzut de la aproximativ 800 Ko la 1,8 Ko. — @ClaudeDevs pe X
Câștigul privește latența, nu factura: Claude recitește întreaga conversație la fiecare pas, astfel încât numărul de tokeni, tarifele și limitele de rată nu se schimbă, iar memorarea în cache a prompturilor (prompt caching) trebuie în continuare solicitată explicit. Firul este păstrat în limita posibilităților (best-effort), în memorie criptată și niciodată pe disc: expiră la 5 minute după ultima cerere, iar aplicația își păstrează propria copie pentru a retrimite totul dacă API-ul răspunde cu 404. Funcția nu este eligibilă pentru păstrarea zero a datelor (ZDR) și nu funcționează cu Message Batches, cu compactarea la cerere sau în organizațiile HIPAA. Este disponibilă în API-ul Claude, Claude Platform on AWS, Claude in Microsoft Foundry și Claude Models on Google Cloud (Anthropic managed).
🔗 Articolul Anthropic despre message threads · Documentația pentru message threads
Sakana AI anunță Sawara, primele sale modele preantrenate de la zero, ale căror ponderi sunt prevăzute pentru primăvara anului 2027
2 noiembrie — Sakana AI publică raportul simpozionului său din 26 octombrie de la Tokyo (peste 400 de participanți, conferință susținută de Jürgen Schmidhuber), iar acesta conține un anunț important: start-upul japonez își va preantrena propriile modele lingvistice. Până acum, lucra la agenți și la postantrenarea unor modele deschise existente cu Namazu. Prezentată de directorul său științific (Chief Scientist), Takuya Akiba, seria Sawara (nume provizoriu) este construită de la zero, fără a porni de la un model terț, și concepută pentru utilizarea în agenți (agent-native): raționament cu instrumente, cod și sarcini de lungă durată. Ea urmează să servească drept bază pentru produsele Sakana AI și cercetările RSI Lab privind autoîmbunătățirea recursivă.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇷🇴 Acum pregătim antrenarea și vom începe preantrenarea Sawara Small (nume provizoriu) în decembrie. Dacă totul merge bine, vom publica ponderile în primăvara viitoare. — Sakana AI, raportul simpozionului din 2026
Urmează și un Sawara Large, tot cu nume provizoriu, fără o dată anunțată. Sakana AI nu precizează nici dimensiunea modelului, nici volumul datelor, nici bugetul de calcul.
Energia pentru calcul: OpenAI lansează Grid Protectors, o TPU Google răspunde de pe orbită
OpenAI lansează Grid Protectors, cu o reducere la cerere a consumului de până la 1 000 MW pentru campusul său din Effingham
2 noiembrie — OpenAI lansează Grid Protectors, un program național prin care viitoarele sale campusuri de calcul să își reducă consumul atunci când rețeaua electrică este suprasolicitată, în timpul unui val de frig sau de caniculă. Împreună cu furnizorii de electricitate, autoritățile de reglementare și factorii de decizie publică, compania dorește să încheie acorduri pentru fiecare amplasament, care vor stabili volumul reducerii posibile, timpul de reacție și durata. În funcție de nevoile locale, campusurile vor putea folosi și producția sau stocarea la fața locului și își vor putea uniformiza cererea cu ajutorul bateriilor.
Proiectul-pilot este campusul planificat în comitatul Effingham, Georgia, prezentat în iulie sub numele Project Camellia. OpenAI se angajează să achite integral costurile infrastructurii și ale serviciilor de alimentare cu energie electrică de acolo.
| Cifră anunțată | Valoare anunțată | Sursa cifrei |
|---|---|---|
| Reducere flexibilă a consumului prevăzută în acordul cu Georgia Power | până la 1 000 MW | OpenAI |
| Echivalent în cererea medie a gospodăriilor | aproximativ 700 000 de gospodării | OpenAI |
| Economii anuale pentru clienții Georgia Power începând din 2029 | aproximativ 950 de milioane de dolari | Georgia Power |
| Câștig pentru un client rezidențial tipic care consumă 1 000 kWh | cel puțin 15 dolari pe lună | Georgia Power |
Proiecția Georgia Power privește ansamblul acordurilor sale cu mari consumatori și creșterea anticipată, inclusiv Project Camellia: nu este o cifră specifică programului OpenAI. Compania recunoaște că flexibilitatea nu înlocuiește investițiile în noi capacități de producție și transport și nu anunță niciun alt amplasament și niciun calendar.
🔗 Articolul OpenAI despre Grid Protectors
Project Suncatcher: o TPU aflată pe orbită oferă primul său răspuns, un haiku scris de Gemma 4
30 octombrie — Revenire asupra unei știri: la o lună după lansarea satelitului său prototip, pe 1 octombrie, Project Suncatcher, proiectul de cercetare Google privind calculul pentru AI în spațiu, atinge etapa „Hello World”: primul răspuns AI produs de o TPU de clasă data center aflată pe orbită. În timpul unei treceri deasupra unei stații de la sol, echipa i-a cerut modelului deschis Gemma 4, instalat la bord, un haiku despre viața în spațiu; răspunsul a fost transmis la sol când satelitul survola Svalbard, în Norvegia. Au urmat poezii de tip limerick și prompturi de telemetrie, la care modelul răspunde descriind starea tehnică a încărcăturii utile.
Următoarea etapă vizează fiabilitatea: teste ale TPU-urilor în condiții de stres termic și de expunere la radiații, înaintea unei perechi de sateliți interconectați în 2027. Articolul nu oferă nicio cifră privind performanța sau consumul.
🔗 Articolul Google despre primul răspuns al satelitului
Viața cotidiană și creativitatea interfețelor: OpenAI publică LifeVal, Kombai publică Design Creativity Bench
LifeVal: 169 de sarcini din viața cotidiană, de la 49,3 % pentru GPT-5.2 la 80,6 % pentru GPT-6 Astra
2 noiembrie — OpenAI publică LifeVal, o evaluare a modelelor pe sarcini din viața cotidiană: găsirea unor servicii de îngrijire a copiilor, accesarea serviciilor publice, întocmirea unui buget, adaptarea unei rețete sau construirea unui program sportiv. Sarcinile se bazează pe două mari anchete privind utilizarea timpului, American Time Use Survey și Multinational Time Use Study, completate de un sondaj reprezentativ realizat pe 3 995 de persoane despre domeniile în care și-ar dori cel mai mult ajutor. OpenAI afirmă că îl folosește de un an pentru a urmări evoluția modelelor sale.
| Model evaluat | Data lansării | Recompensă medie pentru 169 de sarcini |
|---|---|---|
| GPT-5.2 | decembrie 2025 | 49,3 % |
| GPT-5.4 | martie 2026 | 73,0 % |
| GPT-5.5 | aprilie 2026 | 77,4 % |
| GPT-5.6 | iulie 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | septembrie 2026 | 80,6 % |
Potrivit descrierii graficului, este vorba despre o medie neponderată a celor 169 de sarcini, iar numai 0,6 puncte separă GPT-5.6 de GPT-6 Astra. Graficul nu include nici GPT-6.1 Sol sau Terra, nici vreun model al altui furnizor, iar OpenAI nu menționează publicarea setului de sarcini.
🔗 Articolul OpenAI despre LifeVal
Design Creativity Bench: modelele converg spre aceleași interfețe
2 noiembrie — Kombai, furnizor de instrumente AI pentru dezvoltare front-end, prezintă pe blogul Hugging Face Design Creativity Bench, un benchmark care nu măsoară dacă o interfață funcționează, ci dacă seamănă cu celelalte. Studiul acoperă 15 modele de vârf, 160 de instrucțiuni și 2 400 de interfețe HTML, comparate cu machete create de oameni.
| Indicator al benchmarkului | Modele evaluate | Referință umană |
|---|---|---|
| Diferențiere medie pentru aceeași instrucțiune | 0,592 între modele | 0,764 între oameni și modele |
| Amplitudine creativă medie | 0,581 | 0,902 |
| Criterii de acceptare îndeplinite | peste 90 % pentru toate (Claude Opus 5.5: 99,2 %) | 98,0 % |
Așadar, modelele îndeplinesc cerințele, dar seamănă între ele. GPT-6 Astra are stilul cel mai distinct din selecție (0,646 la originalitate), deși variază puțin de la un context la altul (0,472 la amplitudine). Kombai publică lucrarea (arXiv 2610.11539), un clasament și un subset pentru reproducerea rezultatelor și își recunoaște limitele: doar ecrane desktop și setările implicite ale API-urilor.
🔗 Articolul Kombai pe Hugging Face
Perplexity publică BrowseSafe++ și detectoarele sale BrowseSafe-Guard împotriva injecțiilor de prompt
2 noiembrie — Perplexity Secure Intelligence Institute publică BrowseSafe++, continuarea BrowseSafe (decembrie 2025), un benchmark deschis dedicat injecțiilor indirecte de prompt (indirect prompt injection), care vizează agenții capabili să navigheze pe Web. Acesta reunește 38 675 de perechi de pagini, o pagină atacată și copia sa curată, dintre care 32 187 sunt construite în jurul unor injecții observate efectiv: detectorul Comet a semnalat 1,15 milioane între septembrie 2025 și septembrie 2026. Fiecare pagină există în HTML, în Markdown, ca arbore de accesibilitate și ca captură de ecran. Din acestea, Perplexity dezvoltă BrowseSafe-Guard, două detectoare de 0,8B ajustate pornind de la Qwen3.5-0.8B, unul pentru text, celălalt pentru capturi.
| Rezultat publicat | BrowseSafe-Guard | Modele comparate |
|---|---|---|
| F1 pentru versiunile text | aproximativ 95 %, primul pentru fiecare versiune | 85 până la 92 % pentru cele mai bune modele generaliste |
| F1 pentru capturile de ecran | aproximativ 93 % | aproximativ 79 % pentru cel mai bun dintre celelalte modele |
| Pagini curate semnalate eronat | aproximativ 1 din 20 | 14,41 % pentru GPT-6 Astra |
| Cost pentru 1 000 de pagini | 0,18 dolari pe un H200 închiriat | între 18,95 și 180,61 dolari prin API |
Detectarea nu înseamnă rezistență: fiecare model a urmat injecții pe care el însuși le identificase, de la 1,64 % dintre pagini pentru GPT-6 Astra până la 24,73 % pentru Llama 3.1 8B. Un atacator perseverent reușește și el, în cele din urmă, să treacă: în mediul BrowseSafe-Adapt, care rescrie injecția după fiecare eșec (1 024 de sarcini, până la 64 de încercări), rata de succes crește de la cel mult 4 % la prima încercare la cel puțin 79 % împotriva a cinci dintre cei șapte agenți testați. Plasat înaintea unui agent Gemini 3.5 Flash-Lite, Guard blochează 94,5 % dintre injecțiile inițiale, dar atacatorul reușește în continuare la 84,2 % dintre sarcini. Sunt disponibile setul de date (cu acces controlat), un SDK sub licență MIT și un clasament public; articolul nu oferă niciun link către ponderile detectoarelor.
🔗 Articolul Perplexity despre BrowseSafe++
Conținut media generativ: Runway Dev ajunge în Claude Code și Cursor, Synthesia în ChatGPT și Claude, ElevenLabs cuantifică avantajul vocii
Runway Dev ajunge în Claude Code și Cursor
2 noiembrie — După Codex, prezentat pe 28 octombrie, Runway își extinde pluginurile Runway Dev la Claude Code și Cursor. Instalarea conectează agentul de programare la contul Runway Dev prin serverul MCP al Runway și îi adaugă skill-urile Runway pentru dezvoltarea cu API-ul său de conținut media generativ. Agentul citește mai întâi informațiile contului (proiecte, modele accesibile cu prețurile și limitele lor, soldul creditelor), apoi se bazează pe SDK-urile oficiale: poate crea un Model Router, care alege modelul potrivit pentru fiecare cerere, sau un Character pentru avatare în timp real și poate reutiliza Recipes (pipeline-uri gata de utilizare) sau Workflows publicate ca puncte de acces API. În caz de eșec, consultă detaliile erorii. Conectarea la cont are loc la prima utilizare, fără o cheie API stocată în plugin, și nu este indicat niciun tarif propriu.
| Agent de programare | Instalare indicată de Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api în chatul Agent sau din Cursor Marketplace |
Synthesia își creează videoclipurile în ChatGPT și Claude
2 noiembrie — Synthesia anunță că videoclipurile sale cu avatare pot fi create acum direct în ChatGPT și Claude: utilizatorul descrie videoclipul dorit, îl vede apărând în conversație, îl ajustează prin cereri, apoi îl publică și îl distribuie, fără să deschidă altă aplicație sau altă filă. Anunțul se rezumă la un tweet însoțit de un videoclip demonstrativ; la momentul verificării noastre, nu apărea niciun articol pe blogul sau pe pagina principală Synthesia. Synthesia nu precizează acolo nici mecanismul integrării, nici planurile vizate, nici tariful.
ElevenLabs: vocea are succes cu 32 % mai des decât chatul după două minute
2 noiembrie — ElevenLabs publică un studiu care compară vocea (telefon și WhatsApp) și chatul pentru agenți ElevenAgents aflați în producție, fiecare agent fiind comparat cu el însuși pe baza conversațiilor sale din mai până în iulie 2026. Tweetul de anunț menționează 469 de agenți; articolul vorbește însă despre „sute” de agenți.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇷🇴 Cu cât conversația este mai lungă, cu atât rata de succes a agenților vocali este mai mare. Am analizat 469 de agenți care funcționează atât prin voce, cât și prin chat în producție și am observat o tendință interesantă. Când conversația devine complexă, vocea este calea cea mai rapidă spre rezolvare. — @ElevenLabs pe X
| Indicator potrivit ElevenLabs | Valoare măsurată |
|---|---|
| Succesul vocii după două minute | +10,9 puncte, adică +31,7 % |
| Conversații de mai puțin de un minut | chatul conduce cu aproximativ 9 puncte |
| Durata conversațiilor lungi reușite | 4,6 minute prin voce, 7 minute prin chat |
| Trecerea la un LLM mai rapid (315 conversații) | latență redusă cu 16 %, succes crescut cu 26 % |
| Preferință pentru voce (98 de participanți, zbor anulat) | 85 % |
Durata servește aici drept indicator al complexității, un criteriu pe care articolul îl recunoaște ca fiind imperfect, iar studiul provine de la furnizor, care își promovează astfel agenții vocali.
NVIDIA publică rețete de simulare Cosmos 3 Nano pentru condus, robotică și chirurgie
2 noiembrie — NVIDIA publică pe blogul său tehnic un ghid în două părți pentru Cosmos, platforma sa de modele fundamentale ale lumii (world foundation models) destinată AI fizice: rețete de simulare bazate pe noi checkpointuri Cosmos 3 Nano, anunțate pe 22 octombrie și de această dată denumite și descrise, apoi instrucțiuni de utilizare a microserviciilor NIM. Exemplul evidențiat: simpla schimbare a promptului transformă o deplasare pe timp de zi într-una pe timp de noapte ploioasă, fără a modifica traseul drumului sau traiectoriile vehiculelor.
| Checkpoint Cosmos 3 | Utilizare descrisă de NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Clipuri cu mai multe camere și LiDAR pentru condus, până la 400 de cadre în 480p sau 720p |
| Cosmos3-Nano-Sim-Auto | Variantă cauzală distilată care generează în flux pentru a testa o politică de condus în buclă închisă |
| Cosmos3-Nano-Sim-Transfer | Video de adâncime convertit în video RGB detaliat, pentru robotică |
| Cosmos3-Nano-Sim-Bimanual | Următoarea observație a unui robot cu două brațe, pornind de la scenă și de la acțiunile sale |
| Cosmos3-H-Embodied-Nano și Cosmos3-H-Dreams | Simulare chirurgicală pornind de la acțiunile robotului, în timp real pentru H-Dreams |
În privința implementării, imaginea NIM cosmos3:2.0.0 oferă profiluri pentru latență sau debit, iar decodarea speculativă accelerează inferența în medie de aproximativ 2 până la 3 ori pe H200, potrivit NVIDIA, care anunță NIM Cosmos certificate pe mai mult de 20 de GPU. La generare, Cosmos3-Nano necesită 58 Gio de VRAM în BF16 și 31 Gio în FP8 cu offloading. Cosmos Framework primește pipeline-uri de învățare prin întărire (DPO, GRPO, PPO, OPD, DiffusionNFT), iar joi, 5 noiembrie, îi este dedicată o transmisiune în direct.
Copilot CLI 1.0.106-3, în versiune preliminară: gestionarea opțională a sesiunilor și 145 de remedieri
2 noiembrie — GitHub publică versiunea preliminară 1.0.106-3 a Copilot CLI, a treia din ramura 1.0.106. Notele enumeră o singură adăugire: instrumente de gestionare a sesiunilor activate opțional (opt-in) și posibilitatea de a menționa cu @ sesiunile locale pentru care această opțiune a fost activată, fără alte detalii. Pentru conturile gestionate, avertismentele privind reîmprospătarea politicii preiau acum constatările Policy Helper.
Celelalte 145 de remedieri vizează mai ales robustețea interfeței din terminal, iar mai multe au implicații de securitate:
| Remediere de securitate | Comportament înainte de 1.0.106-3 |
|---|---|
| Secvențe de escape filtrate | Un răspuns, un nume de fișier sau un titlu de instrument MCP putea modifica aspectul cronologiei sau ascunde linii |
/allow-all off | Urmată de un spațiu ideografic (introducere CJK), comanda activa Allow All în loc să îl dezactiveze |
/session delete | O opțiune necunoscută plasată înaintea identificatorului ștergea sesiunea curentă fără a cere confirmare |
copilot -p și copilot workflow run | Ieșirea text afișa valorile --secret-env-vars, pe care ieșirea JSON le ascundea deja |
Cea mai recentă versiune stabilă rămâne 1.0.105 din 28 octombrie, iar SDK Copilot 1.0.29-preview.2, publicat în aceeași seară, nu conține nicio schimbare la nivel de SDK.
🔗 Notele de versiune pentru Copilot CLI 1.0.106-3
Știri pe scurt
Agenți și instrumente de programare
- Qwen Code v0.26.6 — Versiune stabilă din 2 noiembrie, la o zi după v0.26.5: Web Shell primește o vizualizare a activității sesiunilor și afișează, pentru fiecare model, rata de succes, viteza de ieșire și latența primului token; modelele Kimi K3 primesc fereastra de 1 milion de tokeni. 🔗 sursă
- Gemini CLI — O remediere integrată în seara de 2 noiembrie împiedică o descărcare întreruptă a modelului Whisper să fie considerată un model instalat, ceea ce bloca modul vocal local până la ștergerea manuală a fișierului. Nu este încă inclusă în nicio versiune, iar versiunea nightly a zilei folosește același commit ca precedentele două. 🔗 sursă
- CLI mistral 0.16.0 —
mistral workflows initșimistral initsolicită acum cheia API a unui proiect Workflow, o verifică prin API Mistral și o salvează în.enval proiectului. 🔗 sursă - Plugin Qodo pentru Codex — Într-un studiu de caz publicat de OpenAI, Qodo își prezintă pluginul din marketplace-ul Codex: Codex primește regulile organizației și istoricul pull requesturilor înainte de a scrie, apoi revizuirea Qodo în aceeași sesiune, înainte de deschiderea pull requestului. Nu sunt prezentate rezultate numerice. 🔗 sursă
- corgi, promovat de Zed — În seara de 1 noiembrie, Zed distribuie site-ul corgi, instrumentul de build Rust compatibil Cargo creat de Conrad Irwin: un singur cache pe mașină, build.rs și macro-uri în sandbox, teste păstrate în cache. Potrivit autorului, codul este scris aproape integral de AI. Repository sub licență MIT. 🔗 sursă
Platforme de dezvoltare și API
- pull_request_target în GitHub Actions — Blocarea implicită a
pull_request_targetîn repository-urile publice este amânată de la 2 noiembrie la 2 decembrie; două întreruperi programate, pe 9 și 16 noiembrie, între 16 h și 18 h UTC, vor scoate la iveală workflow-urile afectate. 🔗 sursă - Evaluările de risc GitHub — Evaluările riscurilor de securitate pentru cod și secrete indică acum dacă fiecare constatare se află într-un repository protejat sau neprotejat, pe GitHub Enterprise Cloud și GitHub Team. 🔗 sursă
- Analytics API de la Perplexity — Răspunsurile privind utilizarea creditelor Computer omit deocamdată defalcarea după originea creditelor (Credit Source); totalul și defalcarea pe modele sunt furnizate în continuare, iar Perplexity solicită ca absența unei defalcări să nu fie interpretată drept utilizare zero. 🔗 sursă
Modele deschise și articole ale comunității
- kniv v7 de la Dragonscale — Șase encodere deschise cu 55M până la 538M de parametri (Apache-2.0, ONNX), care extrag entități, relații și fapte conform unei scheme descrise la momentul apelului, fără LLM, pentru memoria agenților; pe Re-DocRED, 0,749 în aceeași propoziție și 0,732 la o distanță de două propoziții (varianta DeBERTa). 🔗 sursă
- Fereastră glisantă și strat Bifocal — Într-un articol al comunității, Lukas distilează Qwen3-4B-Instruct în patru modele elev cu aceeași memorie: fereastra glisantă este suficientă pentru răspunsurile scurte, dar pe AIME și HMMT stratul său Bifocal (fereastră mică și stare mLSTM) rezolvă aproape de două ori mai multe probleme decât fereastra singură, blocată în jurul valorii de 14 %. Măsurători ale autorului. 🔗 sursă
- Backdoor blocat de ViKernel — VIDRAFT implantează prin fine-tuning un backdoor în Qwen3-0.6B: cuvântul „payroll” într-o cale de fișier declanșează comanda malițioasă în 98,3 % dintre cazuri pe căi nemaiîntâlnite, fără ca vreuna dintre cele 24 de verificări să îl detecteze; pe ViKernel, toate cele 290 de payloaduri sunt respinse înainte de execuție. Ponderile nu au fost publicate. 🔗 sursă
- Rutarea Beam și trișarea la teste — Un studiu preînregistrat al lui Rairo Mukamuri nu reușește să prevadă, prin rutarea experților din Beam-1.0-501B-A23B, falsificarea unui test cu 500 de tokeni înainte: AUROC de 0,580 față de un prag stabilit la 0,75, la un cost de calcul de 9,03 dolari. 🔗 sursă
- Saturate — Daniel van Strien procesează din nou prin OCR 14 483 de pagini de arhive pe un singur GPU din Hugging Face Jobs, pentru 1,47 dolari și cu 8,9 pagini pe secundă, folosind Saturate, biblioteca sa Apache-2.0 pentru inferență în loturi către orice endpoint compatibil OpenAI. 🔗 sursă
Imagine, video, voce și muzică
- LTX 2.5 pe un RTX PRO 6000 — Furnizorul de GPU de închiriat EcoHash randează un video 1080p de 10 secunde cu sunet în 90 de secunde și în 14,8 secunde la 480p, pe o singură placă de 96 Go; măsurători ale furnizorului pe propriul serviciu. 🔗 sursă
- Mobiel AI de la KPN — ElevenLabs prezintă în detaliu asistentul de apeluri KPN pentru micile întreprinderi neerlandeze (transcrierea mesajelor vocale, rezumate ale apelurilor, meniu de apel); fine-tuningul pentru neerlandeză a crescut precizia verificării de la aproximativ 50 % la 90 %. Nu este indicat niciun tarif. 🔗 sursă
- Suno Studio — Actualizare din 29 octombrie, distribuită pe 2 noiembrie: setările clipului se mută într-o bară laterală, înălțimea sunetului se reglează în semitonuri și cenți, materialul audio importat poate fi întins pentru a se potrivi tempoului proiectului, iar pistele se ascund cu Shift-H. 🔗 sursă
- Kling și Chroma Awards — Kling devine partener al sezonului 2 al concursului, cu premii de peste 450 000 de dolari; înscrieri până pe 7 ianuarie. 🔗 sursă
Programe, demonstrații și articole ale laboratoarelor
- Anthropic Residency — Anthropic deschide până pe 22 noiembrie înscrierile pentru un program de cercetare remunerat, cu o durată între șase săptămâni și șase luni, destinat profesorilor, fondatorilor tehnici și inginerilor de nivel staff, fără cerințe prealabile de învățare automată; remunerație echivalentă cu 350 000 până la 500 000 de dolari pe an. 🔗 sursă
- Data Bot de la SpaceXSI — Studiu de caz intern: un Team Bot din Grok Bot care îndeplinește rolul de data scientist pentru întreaga companie, pe baza unor skills întreținute de echipa de date, și care ar fi preluat aproximativ 70 de ore de muncă într-o săptămână, conform unei estimări SpaceXSI. 🔗 sursă
- Le Chonk și chimia cuantică — Mistral arată pe X cum Mistral Large 4 scrie de la zero un solver SCF și o vizualizare 3D a unei molecule care se rupe, fără a publica vreun cod sau vreo cifră. 🔗 sursă
- Recapitularea lunii octombrie de la Google — Niciun anunț nou, cu excepția răspunsului satelitului Project Suncatcher, discutat mai sus. 🔗 sursă
- Memoria agenților la Perplexity — Un ghid despre tipurile de memorie și construirea unui agent cu memorie persistentă, care trimite la Brain, deja disponibil în Computer. 🔗 sursă
- The Knowledge Talk — Perplexity publică transcrierea discursului susținut de Aravind Srinivas pe 3 octombrie la Cambridge Union Society, fără vreun anunț. 🔗 sursă
Ce înseamnă toate acestea
Message threads mută o parte din starea conversației pe server fără a modifica factura: tokenii și tarifele rămân aceleași, doar timpul de așteptare scade, iar efectul este cel mai evident în sesiunile agenților care acumulează sute de mii de tokeni. Alegerea unui fir efemer, păstrat 5 minute în memorie criptată și fără API pentru recitire, lasă aplicației controlul asupra istoricului său, cu prețul unor excluderi clare: nici ZDR, nici Batches, nici organizații HIPAA. În terminal, versiunea preliminară Copilot CLI reamintește că interfața însăși este o suprafață de atac, în condițiile în care un nume de fișier sau un răspuns al modelului putea modifica aspectul ecranului.
Grid Protectors și Suncatcher răspund aceleiași constrângeri, energia necesară calculului, la două orizonturi de timp foarte diferite. OpenAI propune să permită reducerea la cerere a consumului campusurilor sale pentru a fi acceptate de o rețea deja suprasolicitată, promițând să își plătească propriile costuri; singura economie cuantificată pentru gospodării provine de la Georgia Power și privește ansamblul clienților săi mari. Google a ajuns la etapa în care o TPU aflată pe orbită scrie un haiku: o etapă de demonstrare a fezabilității, fără cifre de performanță, înainte de doi sateliți interconectați în 2027.
LifeVal, Design Creativity Bench și BrowseSafe++ măsoară ceea ce clasamentele de programare și matematică nu surprind. LifeVal arată un progres care încetinește, 0,6 puncte între GPT-5.6 și GPT-6 Astra, dar rămâne un benchmark intern, fără concurenți și fără un set de sarcini publicat. Kombai evidențiază o convergență a interfețelor pe care rata de succes o ascunde, iar BrowseSafe++ separă detectarea de rezistență: un model care identifică o injecție o poate totuși urma, iar un detector de 0,8B, de peste o sută de ori mai ieftin decât un apel API, nu este suficient în fața unui atacator care încearcă din nou.
Sakana AI alege să controleze întregul lanț cu Sawara, de la preantrenare la produse, dar cu un calendar condiționat și fără o dimensiune anunțată. Runway și Synthesia fac invers: se instalează acolo unde utilizatorii lucrează deja, în agentul de programare sau în conversația din ChatGPT și Claude, în loc să îi atragă spre propria aplicație. ElevenLabs oferă argumentul numeric în favoarea vocii pentru conversațiile lungi, printr-un studiu al furnizorului a cărui bază diferă între tweet și articol, în timp ce NVIDIA îi echipează cu Cosmos 3 Nano pe cei care simulează condusul, robotica sau chirurgia.
Surse
- Articolul Anthropic despre message threads
- @ClaudeDevs: message threads în Claude Code
- Documentația pentru message threads
- Raportul simpozionului Sakana AI din 2026
- @SakanaAILabs: raportul simpozionului
- Prezentarea Grid Protectors Program (OpenAI)
- Primul răspuns al satelitului prototip al Project Suncatcher (Google)
- LifeVal (OpenAI)
- De ce am creat Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- Pluginuri Runway Dev pentru agenți de programare
- @synthesiaIO: videoclipuri Synthesia în ChatGPT și Claude
- De ce vocea este mai eficientă în conversațiile complexe și stresante (ElevenLabs)
- @ElevenLabs: studiu comparativ între voce și chat
- Construiți World Models pentru simulări interactive cu NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 din Gemini CLI
- CLI mistral 0.16.0
- Studiu de caz Qodo și Codex (OpenAI)
- @zeddotdev: corgi
- pull_request_target blocat implicit pe 2 decembrie (GitHub)
- Evaluările de risc includ starea protecției depozitelor (GitHub)
- Changelog pentru API-ul Perplexity
- Articolul Dragonscale despre kniv v7
- Articolul despre fereastra glisantă și Bifocal
- Articolul VIDRAFT despre ușa din spate
- Articolul lui Rairo Mukamuri despre Beam
- @vanstriendaniel: Saturate
- Articolul EcoHash despre LTX 2.5
- Mobiel AI de la KPN (ElevenLabs)
- Notele de lansare pentru Suno Studio
- @Kling_ai: Chroma Awards sezonul 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk și solverul SCF
- Anunțurile Google despre IA din octombrie 2026
- Memoria agenților AI (Perplexity)
- The Knowledge Talk (Perplexity)