ai-powered-markdown-translatorgpt-6.1-sol을 사용하여 프랑스어에서 한국어로 번역한 기사입니다.
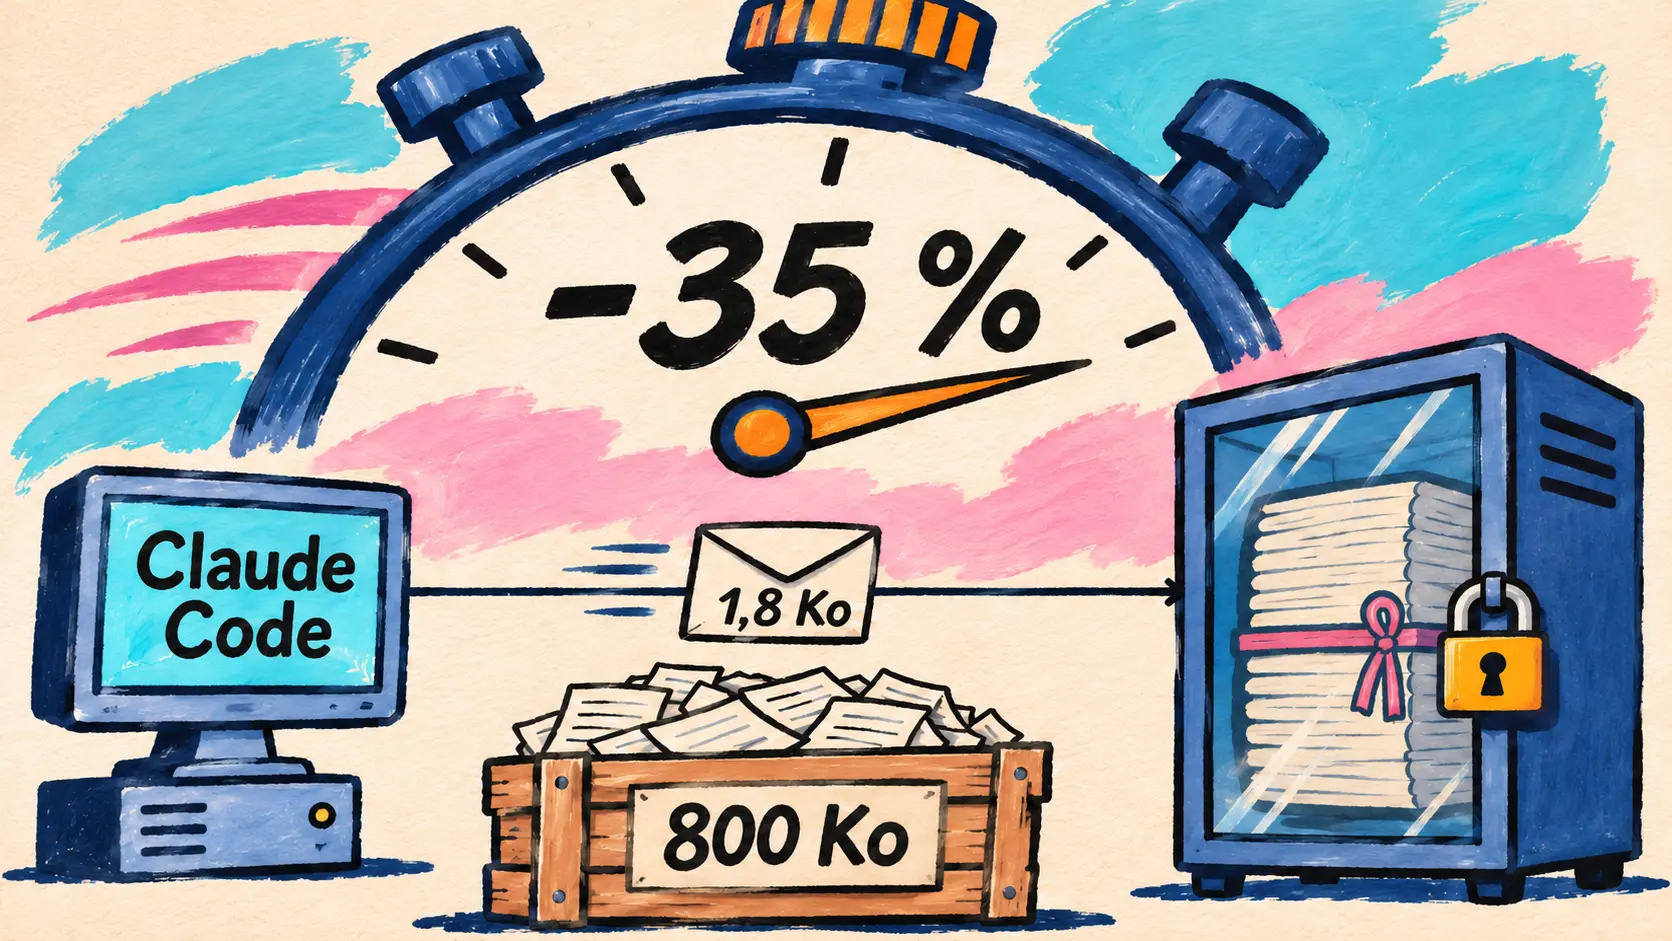
Anthropic이 Messages API의 메시지 스레드를 공개 베타로 제공한다. 이미 Claude Code에 적용된 이 기능은 가장 긴 요청에서 첫 토큰까지 걸리는 시간을 약 35 % 줄인다. Sakana AI는 처음부터 사전 학습하는 첫 모델인 Sawara를 발표했다. OpenAI는 전력망 상황에 따라 컴퓨팅 캠퍼스의 전력 수요를 줄이기 위한 Grid Protectors를 출범시키고, 일상생활 과제 평가 도구인 LifeVal을 공개했다. Perplexity는 프롬프트 주입 공격에 대응하는 BrowseSafe++를 공개했으며, NVIDIA는 Cosmos 3 Nano로 시뮬레이션 도구를 제공한다. Runway, Synthesia, ElevenLabs는 생성형 미디어를 비서와 에이전트에 도입하고 있다.
Messages API의 메시지 스레드 공개 베타 시작, Claude Code에서 이미 사용 중
11월 2일 — Anthropic이 Messages API에서 메시지 스레드(message threads)를 공개 베타로 제공한다. 지금까지 에이전트는 매 차례 도구 실행 결과를 포함한 전체 대화를 다시 전송했다. 스레드를 사용하면 첫 요청에서 시스템 프롬프트와 도구를 포함한 전체 대화를 보내고, 이후 요청에서는 새 메시지와 이전 응답의 식별자만 전송한다. API는 모델을 호출하기 전에 나머지 내용을 재구성한다. thread 매개변수와 message-threads-2026-08-12 베타 헤더만 추가하면 되며, 공식 SDK는 전용 도우미 함수로 이를 처리한다.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇰🇷 최근 Claude Code에 메시지 스레드를 통합했습니다. 50만~100만 토큰의 요청에서 첫 토큰까지 걸리는 시간의 중앙값이 약 35 % 줄었습니다. 긴 대화에서 요청 크기의 중앙값은 약 800 Ko에서 1,8 Ko로 줄었습니다. — X의 @ClaudeDevs
이점은 비용이 아닌 지연 시간에 있다. Claude는 매 차례 전체 대화를 다시 읽으므로 토큰 수, 요금, 처리율 제한은 바뀌지 않으며, 프롬프트 캐싱(prompt caching)도 여전히 직접 요청해야 한다. 스레드는 최선 노력 방식(best-effort)으로 암호화된 메모리에 보관되며 디스크에는 저장되지 않는다. 마지막 요청으로부터 5분 후 만료되므로, 애플리케이션은 API가 404를 반환할 때 전체 내용을 다시 전송할 수 있도록 자체 사본을 보관해야 한다. 이 기능은 데이터 무보존(ZDR) 대상이 아니며, Message Batches, 요청 시 압축 기능, HIPAA 조직에서는 사용할 수 없다. Claude API, Claude Platform on AWS, Claude in Microsoft Foundry, Claude Models on Google Cloud(Anthropic 관리형)에서 이용할 수 있다.
🔗 Anthropic의 메시지 스레드 소개 글 · 메시지 스레드 문서
Sakana AI, 처음부터 사전 학습하는 첫 모델 Sawara 발표… 2027년 봄 가중치 공개 예정
11월 2일 — Sakana AI가 10월 26일 도쿄에서 열린 심포지엄 보고서를 공개했다. 400명 이상이 참석하고 위르겐 슈미트후버가 강연한 이 행사 보고서에는 중요한 발표가 담겼다. 이 일본 스타트업이 자체 언어 모델을 사전 학습한다는 것이다. 지금까지는 에이전트와 Namazu를 활용한 기존 공개 모델의 사후 학습에 주력했다. 최고과학책임자(수석 과학자)인 아키바 다쿠야가 소개한 Sawara 시리즈는 가칭으로, 다른 회사의 모델을 기반으로 삼지 않고 처음부터 구축한다. 에이전트 활용(agent-native)을 염두에 두고 도구를 사용하는 추론, 코드 작성, 장시간 과제를 위해 설계됐다. Sakana AI 제품과 RSI Lab의 재귀적 자기 개선 연구를 뒷받침할 기반이 될 예정이다.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇰🇷 현재 학습을 준비하고 있으며, 12월에 Sawara Small(가칭)의 사전 학습을 시작할 예정입니다. 순조롭게 진행되면 내년 봄에 가중치를 공개하겠습니다. — Sakana AI, 2026년 심포지엄 보고서
역시 가칭인 Sawara Large도 뒤이어 나올 예정이지만 일정은 공개되지 않았다. Sakana AI는 모델 크기, 데이터 규모, 연산 예산을 밝히지 않았다.
연산에 쓰이는 전력: OpenAI는 Grid Protectors 출범, Google의 TPU는 궤도에서 응답
OpenAI, Grid Protectors 출범… 에핑엄 캠퍼스에서 최대 1 000 MW 전력 수요 감축
11월 2일 — OpenAI가 한파나 폭염으로 전력망에 부담이 커질 때 향후 컴퓨팅 캠퍼스의 전력 소비를 줄이기 위한 전국 단위 프로그램 Grid Protectors를 출범시킨다. 전력 공급업체, 규제기관, 정책 결정자와 협력해 부지별 계약을 체결하고, 감축 가능한 전력량과 대응 시간, 지속 시간을 정할 계획이다. 지역별 필요에 따라 캠퍼스는 현장 발전이나 에너지 저장 시설을 활용하고, 배터리로 수요 변동을 완화할 수도 있다.
시범 대상은 지난 7월 Project Camellia라는 이름으로 소개된 조지아주 에핑엄 카운티의 예정 캠퍼스다. OpenAI는 이곳의 전력 인프라와 서비스 비용 전액을 부담하겠다고 약속했다.
| 발표 항목 | 발표 수치 | 수치 출처 |
|---|---|---|
| Georgia Power와의 계약에 예정된 유연한 전력 수요 감축 | 최대 1 000 MW | OpenAI |
| 가구 평균 전력 수요로 환산 | 약 700 000가구 | OpenAI |
| 2029년부터 Georgia Power 고객의 연간 비용 절감액 | 약 950백만 달러 | Georgia Power |
| 1 000 kWh를 소비하는 일반 주거용 고객의 절감액 | 월 최소 15달러 | Georgia Power |
Georgia Power의 전망치는 Project Camellia를 포함한 대규모 전력 소비자들과의 전체 계약 및 예상 성장에 관한 것으로, OpenAI 프로그램만의 수치는 아니다. 회사는 수요 유연성이 새로운 발전 및 송전 설비에 대한 투자를 대체할 수 없다고 인정하며, 다른 부지나 일정은 발표하지 않았다.
🔗 OpenAI의 Grid Protectors 소개 글
Project Suncatcher: 궤도상의 TPU가 보낸 첫 응답은 Gemma 4가 쓴 하이쿠
10월 30일 — 지난 소식: 10월 1일 시제품 위성을 발사한 지 한 달 만에, Google의 우주 인공지능 연산 연구 프로젝트인 Project Suncatcher가 ‘Hello World’ 이정표에 도달했다. 궤도상의 데이터센터급 TPU가 첫 인공지능 응답을 생성한 것이다. 위성이 지상국 상공을 통과하는 동안 연구팀은 탑재된 공개 모델 Gemma 4에 우주에서의 삶을 주제로 하이쿠를 요청했다. 위성이 노르웨이 스발바르 상공을 지날 때 응답이 지상으로 내려왔다. 이후에는 리머릭과 원격 측정 프롬프트가 이어졌으며, 모델은 탑재체의 기술적 상태를 설명하는 응답을 내놓았다.
다음 단계는 신뢰성 검증이다. 2027년 상호 연결된 위성 두 대를 투입하기에 앞서, 열 스트레스와 방사선 환경에서 TPU를 시험한다. 소개 글에는 성능이나 전력 소비 수치가 제시되지 않았다.
일상생활과 인터페이스 창의성: OpenAI는 LifeVal 공개, Kombai는 Design Creativity Bench 공개
LifeVal: 일상생활 과제 169개, GPT-5.2의 49,3 %에서 GPT-6 Astra의 80,6 %까지
11월 2일 — OpenAI가 아이 돌봄 서비스 찾기, 공공 서비스 이용, 예산 수립, 조리법 조정, 운동 계획 작성 등 일상생활 과제에서 모델을 평가하는 LifeVal을 공개했다. 과제는 미국 시간 사용 조사와 다국가 시간 사용 연구라는 두 대규모 시간 사용 조사를 바탕으로 구성했다. 여기에 어떤 분야에서 가장 도움을 받고 싶은지 묻는 3 995명 대상의 대표성 있는 설문조사를 더했다. OpenAI는 지난 1년간 모델의 변화를 추적하는 데 이를 사용해 왔다고 밝혔다.
| 평가 모델 | 출시일 | 169개 과제의 평균 보상 |
|---|---|---|
| GPT-5.2 | 2025년 12월 | 49,3 % |
| GPT-5.4 | 2026년 3월 | 73,0 % |
| GPT-5.5 | 2026년 4월 | 77,4 % |
| GPT-5.6 | 2026년 7월 | 80,0 % |
| GPT-6 Astra (xhigh) | 2026년 9월 | 80,6 % |
그래프 설명에 따르면 이 수치는 169개 과제의 비가중 평균이며, GPT-5.6과 GPT-6 Astra의 차이는 0,6포인트에 불과하다. 그래프에는 GPT-6.1 Sol이나 Terra, 다른 개발사의 모델이 포함되지 않았으며, OpenAI는 과제 집합 공개에 대해서도 언급하지 않았다.
Design Creativity Bench: 모델들이 비슷한 인터페이스로 수렴한다
11월 2일 — 프런트엔드 개발용 인공지능 도구 업체 Kombai가 Hugging Face 블로그에서 Design Creativity Bench를 소개했다. 인터페이스가 작동하는지가 아니라 다른 인터페이스와 얼마나 비슷한지를 측정하는 평가 도구다. 연구에서는 최첨단 모델 15개, 지시문 160개, HTML 인터페이스 2 400개를 살펴보고, 사람이 만든 시안과 비교했다.
| 평가 지표 | 평가 모델 | 사람 기준 |
|---|---|---|
| 동일 지시문에서의 평균 차별성 | 모델 간 0,592 | 사람과 모델 간 0,764 |
| 평균 창의적 변화 범위 | 0,581 | 0,902 |
| 충족한 수용 기준 | 모든 모델에서 90 % 초과 (Claude Opus 5.5 : 99,2 %) | 98,0 % |
즉, 모델들은 요구사항을 충족하지만 서로 비슷한 결과를 낸다. GPT-6 Astra는 비교 대상 중 가장 독특한 스타일을 보였지만(독창성 0,646), 상황이 달라져도 변화 폭은 작았다(변화 범위 0,472). Kombai는 논문(arXiv 2610.11539), 순위표, 재현용 데이터 일부를 공개했으며, 데스크톱 화면만 다루고 API 기본 설정을 사용했다는 한계도 인정했다.
Perplexity, 프롬프트 주입 공격에 대응하는 BrowseSafe++와 BrowseSafe-Guard 탐지기 공개
11월 2일 — Perplexity Secure Intelligence Institute가 BrowseSafe(2025년 12월)의 후속 버전인 BrowseSafe++를 공개했다. 웹을 탐색할 수 있는 에이전트를 겨냥한 간접 프롬프트 주입(indirect prompt injection)을 다루는 공개 평가 도구다. 공격이 삽입된 페이지와 그에 대응하는 공격 없는 페이지를 묶어 38 675쌍을 구성했으며, 이 중 32 187쌍은 실제로 관측된 주입 공격을 바탕으로 만들었다. Comet의 탐지기는 2025년 9월부터 2026년 9월까지 이러한 공격을 115만 건 포착했다. 각 페이지는 HTML, Markdown, 접근성 트리, 스크린샷 형태로 제공된다. Perplexity는 이를 바탕으로 Qwen3.5-0.8B를 미세 조정한 0,8B 규모의 탐지기 두 개, BrowseSafe-Guard를 만들었다. 하나는 텍스트용이고 다른 하나는 스크린샷용이다.
| 공개 결과 | BrowseSafe-Guard | 비교 모델 |
|---|---|---|
| 텍스트 표현별 F1 | 약 95 %, 모든 표현에서 1위 | 최상위 범용 모델은 85~92 % |
| 스크린샷 F1 | 약 93 % | 다른 모델 중 최고 성능은 약 79 % |
| 공격 없는 페이지의 오탐률 | 약 20개 중 1개 | GPT-6 Astra는 14,41 % |
| 1 000페이지당 비용 | 임대한 H200에서 0,18달러 | API 이용 시 18,95~180,61달러 |
탐지가 곧 저항을 뜻하지는 않는다. 모든 모델은 자신이 탐지한 주입 공격에도 따르는 모습을 보였으며, 해당 페이지 비율은 GPT-6 Astra의 1,64 %부터 Llama 3.1 8B의 24,73 %까지였다. 끈질긴 공격자는 결국 방어를 뚫기도 한다. 실패할 때마다 주입 내용을 다시 작성하는 BrowseSafe-Adapt 환경에서는 과제 1 024개에 대해 최대 64회까지 시도했으며, 첫 시도에서 최대 4 %였던 성공률이 평가한 에이전트 7개 중 5개에서는 최소 79 %까지 올랐다. Gemini 3.5 Flash-Lite 에이전트 앞에 Guard를 배치하면 원래 주입 공격의 94,5 %를 차단하지만, 공격자는 여전히 과제의 84,2 %에서 성공했다. 접근이 통제되는 데이터셋, MIT 라이선스 SDK, 공개 순위표를 이용할 수 있으며, 소개 글에는 탐지기 가중치 링크가 없다.
🔗 Perplexity의 BrowseSafe++ 소개 글
생성형 미디어: Claude Code와 Cursor에 도입되는 Runway Dev, ChatGPT와 Claude에 도입되는 Synthesia, 음성의 이점을 수치로 제시한 ElevenLabs
Runway Dev, Claude Code와 Cursor에 도입
11월 2일 — Runway가 10월 28일 소개한 Codex용 플러그인에 이어 Runway Dev 플러그인을 Claude Code와 Cursor로 확대한다. 한 번 설치하면 코딩 에이전트가 Runway의 MCP 서버를 통해 Runway Dev 계정에 연결되고, 생성형 미디어 API로 개발하는 데 쓰는 Runway 스킬이 추가된다. 에이전트는 먼저 계정 정보인 프로젝트, 이용 가능한 모델과 해당 요금 및 제한, 크레딧 잔액을 읽고 공식 SDK를 활용한다. 각 요청에 적합한 모델을 선택하는 Model Router나 실시간 아바타용 Character를 만들 수 있으며, Recipes(바로 사용할 수 있는 파이프라인)나 API 엔드포인트로 공개된 Workflows를 재사용할 수도 있다. 실패하면 오류의 상세 내용을 확인한다. 계정 연결은 처음 사용할 때 이루어지며, 플러그인에 API 키를 저장하지 않는다. 별도 요금은 안내되지 않았다.
| 코딩 에이전트 | Runway가 안내한 설치 방법 |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | Agent 채팅에서 /add-plugin runway-api 사용 또는 Cursor Marketplace 이용 |
Synthesia, ChatGPT와 Claude에서 영상 제작
11월 2일 — Synthesia가 이제 ChatGPT와 Claude에서 아바타 영상을 직접 만들 수 있다고 발표했다. 사용자는 원하는 영상을 설명하고 대화 안에서 결과를 확인한 뒤, 말로 수정을 요청하고 게시하거나 공유할 수 있다. 다른 애플리케이션이나 탭을 열 필요가 없다. 발표는 시연 영상이 첨부된 트윗 하나로 이루어졌으며, 확인 당시 Synthesia 블로그나 홈페이지에는 관련 글이 없었다. Synthesia는 통합 방식, 적용 요금제, 가격을 명시하지 않았다.
ElevenLabs: 2분이 넘는 대화에서 음성의 성공률이 채팅보다 32 % 높아
11월 2일 — ElevenLabs가 실제 운영 중인 ElevenAgents 에이전트의 음성(전화 및 WhatsApp)과 채팅을 비교한 연구를 발표했다. 각 에이전트가 2026년 5월부터 7월까지 나눈 대화를 바탕으로 같은 에이전트 내에서 두 방식을 비교했다. 발표 트윗에는 에이전트 469개가 언급되지만, 블로그 글에는 «수백 개»로 표현돼 있다.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇰🇷 대화가 길어질수록 음성 에이전트의 성공률이 높아집니다. 실제 운영 환경에서 음성과 채팅을 모두 사용하는 에이전트 469개를 분석한 결과, 흥미로운 경향을 관찰했습니다. 대화가 복잡해지면 음성이 문제 해결에 이르는 가장 빠른 길입니다. — X의 @ElevenLabs
| ElevenLabs가 제시한 지표 | 측정값 |
|---|---|
| 2분을 넘는 대화에서 음성의 성공률 | +10,9포인트, 즉 +31,7 % |
| 1분 미만의 대화 | 채팅이 약 9포인트 앞섬 |
| 성공한 긴 대화의 소요 시간 | 음성 4,6분, 채팅 7분 |
| 더 빠른 LLM으로 전환(대화 315건) | 지연 시간 16 % 감소, 성공률 26 % 증가 |
| 음성 선호도(참가자 98명, 항공편 취소 상황) | 85 % |
여기서는 대화 시간을 복잡성의 지표로 사용하며, 블로그 글도 이 지표가 완벽하지 않음을 인정한다. 또한 이 연구는 음성 에이전트를 홍보하는 개발사 자체 연구다.
NVIDIA, 주행·로봇·수술용 Cosmos 3 Nano 시뮬레이션 레시피 공개
11월 2일 — NVIDIA가 물리 AI를 위한 월드 파운데이션 모델(세계 기반 모델) 플랫폼 Cosmos의 2부 구성 가이드를 기술 블로그에 공개했다. 첫 부분은 10월 22일 발표된 뒤 이번에 이름과 설명이 공개된 새로운 Cosmos 3 Nano 체크포인트 기반의 시뮬레이션 레시피를, 두 번째 부분은 NIM 마이크로서비스 사용법을 다룬다. 대표적인 예로, 프롬프트만 바꾸면 도로 형태나 차량 궤적을 건드리지 않고도 낮 시간 주행을 비 오는 밤 주행으로 바꿀 수 있다.
| Cosmos 3 체크포인트 | NVIDIA가 설명한 용도 |
|---|---|
| Cosmos3-Nano-Transfer-Auto | 주행용 LiDAR 포함 다중 카메라 영상, 480p 또는 720p에서 최대 400프레임 |
| Cosmos3-Nano-Sim-Auto | 폐루프 환경에서 주행 정책을 시험하도록 스트리밍 방식으로 생성하는 증류된 인과형 변형 모델 |
| Cosmos3-Nano-Sim-Transfer | 로봇용 깊이 영상을 세밀한 RGB 영상으로 변환 |
| Cosmos3-Nano-Sim-Bimanual | 장면과 동작을 바탕으로 양팔 로봇의 다음 관측 결과 생성 |
| Cosmos3-H-Embodied-Nano 및 Cosmos3-H-Dreams | 로봇 동작을 바탕으로 수술 시뮬레이션, H-Dreams는 실시간 지원 |
배포 측면에서 NIM 이미지 cosmos3:2.0.0는 지연 시간 또는 처리량 중심의 프로필을 제공한다. NVIDIA에 따르면 추측 디코딩은 H200에서 추론 속도를 평균 약 2~3배 높이며, Cosmos NIM은 20종 이상의 GPU에서 인증을 받았다. 생성 시 Cosmos3-Nano에는 BF16 기준 58 Gio의 VRAM이 필요하며, 오프로딩을 사용하는 FP8에서는 31 Gio가 필요하다. Cosmos Framework에는 강화학습 파이프라인(DPO, GRPO, PPO, OPD, DiffusionNFT)이 추가됐으며, 11월 5일 목요일에는 이를 다루는 생방송이 예정돼 있다.
Copilot CLI 1.0.106-3 미리 보기: 선택적 세션 관리와 수정 사항 145건
11월 2일 — GitHub가 1.0.106 계열의 세 번째 미리 보기 버전인 Copilot CLI 1.0.106-3을 공개했다. 릴리스 노트에 기재된 추가 기능은 하나뿐이다. 선택적으로 활성화하는(명시적 활성화) 세션 관리 도구와, 이 기능을 활성화한 로컬 세션을 @로 언급하는 기능이며, 더 자세한 설명은 없다. 관리형 계정에서는 정책 갱신 경고에 이제 Policy Helper의 점검 결과가 반영된다.
나머지 수정 사항 145건은 주로 터미널 인터페이스의 안정성과 관련되며, 그중 여러 건은 보안에 영향을 준다.
| 보안 수정 사항 | 1.0.106-3 이전의 동작 |
|---|---|
| 이스케이프 시퀀스 필터링 | 응답, 파일 이름 또는 MCP 도구 제목이 타임라인의 표시 형식을 바꾸거나 일부 줄을 숨길 수 있었음 |
/allow-all off | 명령 뒤에 전각 공백(CJK 입력)이 오면 Allow All을 끄는 대신 켰음 |
/session delete | 식별자 앞에 알 수 없는 옵션을 넣으면 확인을 요청하지 않고 현재 세션을 삭제했음 |
copilot -p 및 copilot workflow run | JSON 출력에서는 이미 숨기고 있던 --secret-env-vars 값을 텍스트 출력에서는 표시했음 |
최신 안정 버전은 여전히 10월 28일의 1.0.105이며, 같은 날 저녁에 공개된 Copilot SDK 1.0.29-preview.2에는 SDK 측 변경 사항이 없다.
🔗 Copilot CLI 1.0.106-3 릴리스 노트
단신
에이전트와 코딩 도구
- Qwen Code v0.26.6 — v0.26.5가 나온 다음 날인 11월 2일에 공개된 안정 버전이다. Web Shell에 세션 활동 보기가 추가됐으며, 모델별 성공률, 출력 속도, 첫 토큰 지연 시간을 표시한다. Kimi K3 모델에는 100만 토큰 컨텍스트 창이 적용됐다. 🔗 출처
- Gemini CLI — 11월 2일 저녁에 병합된 수정으로, 다운로드가 중단된 Whisper 모델을 설치된 모델로 잘못 인식하는 문제가 해결됐다. 이 문제 때문에 파일을 수동으로 삭제할 때까지 로컬 음성 모드를 사용할 수 없었다. 아직 어떤 릴리스에도 포함되지 않았으며, 당일 야간 빌드도 앞선 두 빌드와 같은 커밋을 사용한다. 🔗 출처
- CLI mistral 0.16.0 —
mistral workflows init와mistral init이 이제 Workflow 프로젝트의 API 키를 요청하고, Mistral API로 검증한 뒤 프로젝트의.env에 저장한다. 🔗 출처 - Codex용 Qodo 플러그인 — OpenAI가 공개한 사례 연구에서 Qodo가 Codex 마켓플레이스의 자사 플러그인을 소개했다. Codex는 코드를 작성하기 전에 조직의 규칙과 풀 리퀘스트 이력을 전달받고, 풀 리퀘스트를 열기 전에 같은 세션에서 Qodo의 검토를 받는다. 성과 수치는 공개되지 않았다. 🔗 출처
- Zed가 소개한 corgi — 11월 1일 저녁, Zed가 콘래드 어윈의 Cargo 호환 Rust 빌드 도구인 corgi의 사이트를 공유했다. 컴퓨터 한 대당 캐시 하나를 사용하며, build.rs와 매크로를 샌드박스에서 실행하고 테스트 결과를 캐시한다. 개발자에 따르면 코드는 거의 전부 AI로 작성됐다. 저장소는 MIT 라이선스로 공개돼 있다. 🔗 출처
개발 플랫폼과 API
- GitHub Actions의 pull_request_target — 공개 저장소에서
pull_request_target을 기본 차단하는 일정이 11월 2일에서 12월 2일로 연기됐다. 관련 워크플로를 확인할 수 있도록 11월 9일과 16일, UTC 16시부터 18시까지 두 차례 일시 차단이 예정돼 있다. 🔗 출처 - GitHub 위험 평가 — GitHub Enterprise Cloud와 GitHub Team의 코드 및 시크릿 보안 위험 평가에 이제 각 발견 사항이 보호된 저장소에 있는지 여부가 표시된다. 🔗 출처
- Perplexity Analytics API — Computer의 크레딧 사용량 응답에서 현재 크레딧 출처별 내역(Credit Source)이 빠져 있다. 총사용량과 모델별 내역은 계속 제공되며, Perplexity는 내역이 없다는 이유로 사용량을 0으로 해석하지 말라고 안내했다. 🔗 출처
공개 모델과 커뮤니티 글
- Dragonscale의 kniv v7 — 호출 시 지정하는 스키마에 따라 개체, 관계, 사실을 추출하는 파라미터 55M~538M 규모의 공개 인코더 6종(Apache-2.0, ONNX)이다. LLM 없이 에이전트 메모리에 활용할 수 있다. Re-DocRED에서 동일 문장 내에서는 0,749, 두 문장 떨어진 경우에는 0,732를 기록했다(DeBERTa 변형 모델). 🔗 출처
- 슬라이딩 윈도와 Bifocal 계층 — 커뮤니티 글에서 루카스는 Qwen3-4B-Instruct를 메모리 용량이 같은 학생 모델 4개로 증류했다. 짧은 응답에는 슬라이딩 윈도만으로 충분하지만, AIME와 HMMT에서는 작은 윈도와 mLSTM 상태를 결합한 Bifocal 계층이 약 14 %에 머무는 윈도 단독 방식보다 거의 두 배 많은 문제를 풀었다. 작성자가 측정한 결과다. 🔗 출처
- ViKernel이 차단한 백도어 — VIDRAFT가 파인튜닝을 통해 Qwen3-0.6B에 백도어를 심었다. 파일 경로에 «payroll»이라는 단어가 있으면 처음 보는 경로에서도 98,3 %의 비율로 악성 명령이 실행됐으며, 24가지 검사에서도 발견되지 않았다. ViKernel에서는 페이로드 290개가 모두 실행 전에 거부됐다. 가중치는 공개되지 않았다. 🔗 출처
- Beam 라우팅과 테스트 조작 — 라이로 무카무리의 사전 등록 연구는 Beam-1.0-501B-A23B의 전문가 라우팅을 통해 500토큰 뒤에 일어날 테스트 조작을 예측하는 데 실패했다. AUROC는 사전에 정한 기준 0,75에 못 미치는 0,580이었으며, 연산 비용은 9,03달러였다. 🔗 출처
- Saturate — 다니엘 판 스트린이 Hugging Face Jobs의 GPU 한 대에서 기록물 14 483페이지를 다시 OCR 처리했다. 비용은 1,47달러, 처리 속도는 초당 8,9페이지였다. 사용한 도구는 OpenAI 호환 엔드포인트로 일괄 추론 요청을 보내는 자신의 Apache-2.0 라이브러리 Saturate다. 🔗 출처
이미지, 영상, 음성, 음악
- RTX PRO 6000에서 실행한 LTX 2.5 — GPU 대여 업체 EcoHash가 96 Go 카드 한 장으로 소리가 포함된 10초짜리 1080p 영상을 90초 만에 렌더링했으며, 480p에서는 14,8초가 걸렸다. 공급업체가 자사 서비스에서 측정한 결과다. 🔗 출처
- KPN의 Mobiel AI — ElevenLabs가 네덜란드 소기업을 위한 KPN의 통화 도우미를 자세히 소개했다. 음성 메시지 전사, 통화 요약, 통화 메뉴를 제공하며, 네덜란드어 파인튜닝으로 검증 정확도가 약 50 %에서 90 %로 높아졌다. 가격은 공개되지 않았다. 🔗 출처
- Suno Studio — 10월 29일 소식이 11월 2일에 다시 공유됐다. 클립 설정이 사이드바로 이동하고, 음높이를 반음과 센트 단위로 조절할 수 있게 됐다. 가져온 오디오는 프로젝트 템포에 맞춰 늘이거나 줄일 수 있으며, Shift-H로 트랙을 숨길 수 있다. 🔗 출처
- Kling과 Chroma Awards — Kling이 상금 총액 450 000달러가 넘는 대회 시즌 2의 파트너로 참여한다. 출품 마감은 1월 7일이다. 🔗 출처
프로그램, 시연, 연구소 글
- Anthropic Residency — Anthropic이 11월 22일까지 6주
6개월간 진행되는 유급 연구 프로그램의 지원자를 모집한다. 교수, 기술 창업자, 스태프급 엔지니어를 대상으로 하며, 머신러닝 경험은 필수가 아니다. 보수는 연간 350 000500 000달러에 해당한다. 🔗 출처 - SpaceXSI의 Data Bot — 내부 사례 연구다. 데이터팀이 관리하는 스킬을 바탕으로 회사 전체의 데이터 과학자 역할을 하는 Grok Bot의 Team Bot이다. SpaceXSI의 추산에 따르면 일주일 동안 약 70시간 분량의 업무를 처리했다고 한다. 🔗 출처
- Le Chonk와 양자화학 — Mistral이 X에서 Mistral Large 4가 SCF 솔버와 결합이 끊어지는 분자의 3D 시각화를 처음부터 작성하는 모습을 공개했다. 코드나 수치는 공개하지 않았다. 🔗 출처
- Google의 10월 소식 정리 — 앞에서 다룬 Project Suncatcher 위성의 응답을 제외하면 새로운 발표는 없다. 🔗 출처
- Perplexity의 에이전트 메모리 — 메모리 유형과 영구 메모리를 갖춘 에이전트 구축을 다루는 가이드다. Computer에서 이미 사용할 수 있는 Brain으로 안내한다. 🔗 출처
- The Knowledge Talk — Perplexity가 10월 3일 케임브리지 유니언 소사이어티에서 진행된 아라빈드 스리니바스의 연설 전문을 공개했다. 새로운 발표는 없다. 🔗 출처
이것이 의미하는 것
메시지 스레드는 요금에 영향을 주지 않으면서 대화 상태의 일부를 서버로 옮긴다. 토큰 수와 요금은 그대로이고 대기 시간만 줄어들며, 수십만 토큰이 쌓이는 에이전트 세션에서 효과가 가장 뚜렷하다. 암호화된 메모리에 5분 동안 보관하고 다시 읽을 API는 제공하지 않는 임시 스레드 방식은 애플리케이션이 자체 대화 이력을 계속 관리하게 한다. 대신 제외 대상은 명확하다. ZDR, Batches, HIPAA 적용 조직은 지원하지 않는다. 터미널 측면에서는 파일 이름이나 모델 응답이 화면 표시 형식을 바꿀 수 있었다는 Copilot CLI 미리 보기 버전의 사례가 인터페이스 자체도 공격 표면임을 상기시킨다.
Grid Protectors와 Suncatcher는 연산에 필요한 에너지라는 같은 제약에 서로 매우 다른 시간 범위로 대응한다. OpenAI는 이미 부담이 큰 전력망이 자사 캠퍼스를 받아들이도록 필요할 때 전력 사용량을 줄일 수 있게 하고, 자체 비용은 직접 부담하겠다고 약속한다. 가계의 절감액으로 수치가 제시된 유일한 자료는 Georgia Power에서 나왔으며, 이 수치는 대형 고객 전체를 대상으로 한다. Google은 궤도에 있는 TPU로 하이쿠를 쓰게 하는 단계다. 2027년에 두 위성을 연결하기에 앞서 실현 가능성을 보여 주는 이정표이며, 성능 수치는 없다.
LifeVal, Design Creativity Bench, BrowseSafe++는 코딩과 수학 순위표가 포착하지 못하는 것을 측정한다. LifeVal에서는 GPT-5.6과 GPT-6 Astra 사이의 상승 폭이 0,6포인트에 그치는 등 진전이 둔화하는 모습이 나타나지만, 경쟁 모델도 공개된 과제 세트도 없는 자체 벤치마크라는 한계가 있다. Kombai는 성공률에 가려진 인터페이스의 획일화를 지적하고, BrowseSafe++는 탐지와 저항을 구분한다. 주입 공격을 알아챈 모델도 그 지시를 따를 수 있으며, API 호출보다 비용이 100배 넘게 저렴한 0,8B 탐지기도 반복해서 시도하는 공격자에게는 충분하지 않다.
Sakana AI는 Sawara를 통해 사전 학습부터 제품까지 전 과정을 직접 관리하는 길을 택했지만, 일정에는 조건이 붙어 있고 모델 규모도 발표되지 않았다. Runway와 Synthesia는 반대로 사용자를 자체 애플리케이션으로 끌어들이기보다 코딩 에이전트나 ChatGPT와 Claude의 대화처럼 사용자가 이미 작업하는 곳에 자리 잡는다. ElevenLabs는 긴 대화에서 음성이 유리하다는 수치 근거를 제시하지만, 이는 개발사 자체 연구이며 트윗과 블로그 글 사이에 분석 대상 규모의 표현이 다르다. 한편 NVIDIA는 Cosmos 3 Nano로 주행, 로봇, 수술을 시뮬레이션하는 이들에게 도구를 제공한다.
출처
- Anthropic의 메시지 스레드 관련 글
- @ClaudeDevs : Claude Code의 메시지 스레드
- 메시지 스레드 문서
- Sakana AI의 2026년 심포지엄 보고서
- @SakanaAILabs : 심포지엄 보고서
- Grid Protectors Program 소개 (OpenAI)
- Project Suncatcher의 시험용 위성이 보낸 첫 응답 (Google)
- LifeVal (OpenAI)
- Design Creativity Bench를 만든 이유 (Kombai)
- BrowseSafe++ (Perplexity)
- 코딩 에이전트용 Runway Dev 플러그인
- @synthesiaIO : ChatGPT와 Claude에서 사용하는 Synthesia 동영상
- 복잡하고 스트레스가 많은 대화에서 음성이 더 효과적인 이유 (ElevenLabs)
- @ElevenLabs : 음성과 채팅 비교 연구
- NVIDIA Cosmos로 대화형 시뮬레이션용 월드 모델 구축하기
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- Gemini CLI의 PR 30058
- mistral CLI 0.16.0
- Qodo와 Codex 사례 연구 (OpenAI)
- @zeddotdev : corgi
- 12월 2일부터 pull_request_target 기본 차단 (GitHub)
- 위험 평가에 저장소 보호 상태 포함 (GitHub)
- Perplexity API 변경 이력
- kniv v7에 관한 Dragonscale의 게시글
- 슬라이딩 윈도와 Bifocal에 관한 게시글
- 백도어에 관한 VIDRAFT의 게시글
- Beam에 관한 Rairo Mukamuri의 게시글
- @vanstriendaniel : Saturate
- LTX 2.5에 관한 EcoHash의 게시글
- KPN의 Mobiel AI (ElevenLabs)
- Suno Studio 릴리스 노트
- @Kling_ai : Chroma Awards 시즌 2
- Anthropic 레지던시
- Data Bot (SpaceXSI)
- @MistralAI : Le Chonk와 SCF 솔버
- Google의 2026년 10월 AI 발표
- AI 에이전트 메모리 (Perplexity)
- 지식에 관한 대화 (Perplexity)