ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
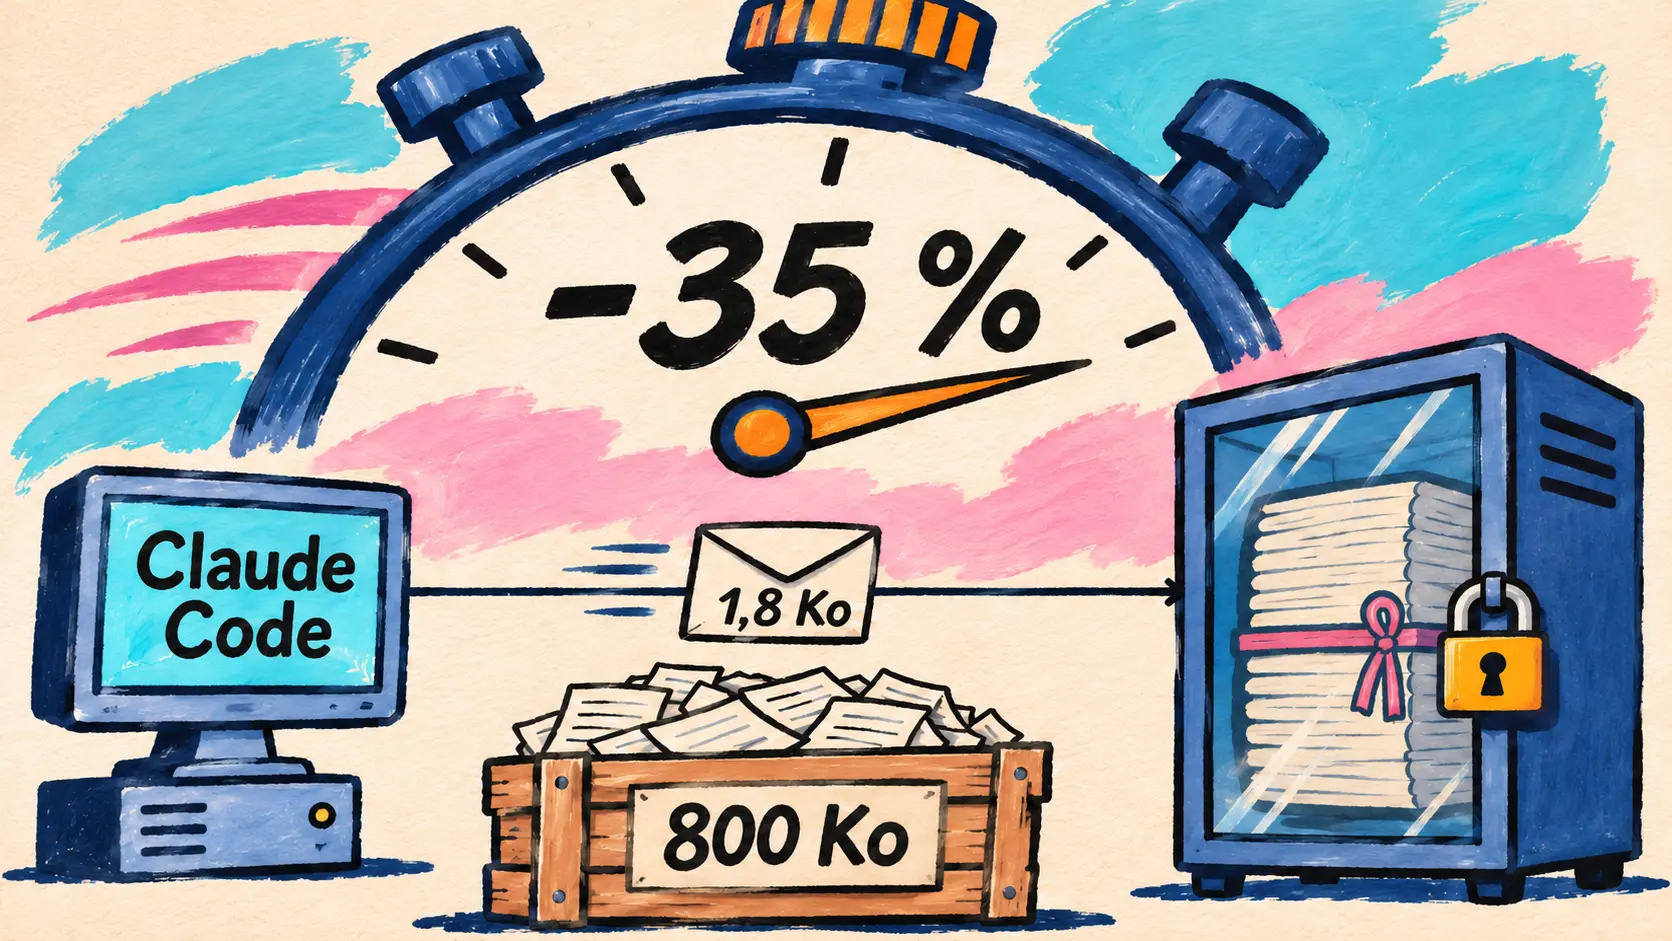
Anthropic öppnar message threads i Messages API i offentlig beta. Funktionen används redan i Claude Code, där den minskar tiden till första token med ungefär 35 % för de längsta anropen. Sakana AI presenterar Sawara, sina första modeller som förtränas från grunden, medan OpenAI lanserar Grid Protectors för att kunna minska elförbrukningen i sina beräkningscampus när elnätet behöver det och publicerar LifeVal, ett benchmark för vardagsuppgifter. Perplexity publicerar BrowseSafe++ mot prompt injection, NVIDIA tillhandahåller simuleringsverktyg med Cosmos 3 Nano, och Runway, Synthesia och ElevenLabs för in generativa medier i assistenter och agenter.
Messages API lanserar message threads i offentlig beta, redan i bruk i Claude Code
2 november — Anthropic öppnar meddelandetrådar (message threads) i Messages API i offentlig beta. Hittills har en agent skickat om hela konversationen vid varje tur, inklusive verktygsresultat. Med en tråd skickar det första anropet hela konversationen, inklusive systemprompt och verktyg. Efterföljande anrop skickar bara de nya meddelandena och det föregående svarets identifierare, och API:et återskapar resten innan modellen anropas. Det räcker att lägga till parametern thread och beta-headern message-threads-2026-08-12, som de officiella SDK:erna hanterar med en särskild hjälpfunktion.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇸🇪 Vi har nyligen integrerat message threads i Claude Code. För anrop på 500 000 till 1 miljon tokens är mediantiden till första token ungefär 35 % kortare. I långa konversationer har medianstorleken på anropen minskat från ungefär 800 kB till 1,8 kB. — @ClaudeDevs på X
Vinsten gäller latensen, inte kostnaden: Claude läser om hela konversationen vid varje tur, så antalet tokens, priserna och anropsgränserna ändras inte, och man måste fortfarande själv begära cachelagring av promptar (prompt caching). Tråden sparas i mån av möjlighet (best-effort), i krypterat minne och aldrig på disk: den löper ut 5 minuter efter det senaste anropet, och applikationen behåller en egen kopia för att kunna skicka om allt om API:et svarar med 404. Funktionen omfattas inte av Zero Data Retention (ZDR) och fungerar varken med Message Batches, komprimering på begäran eller i HIPAA-organisationer. Den är tillgänglig via Claude API, Claude Platform on AWS, Claude in Microsoft Foundry och Claude Models on Google Cloud (Anthropic managed).
🔗 Anthropics artikel om message threads · Dokumentationen för message threads
Sakana AI presenterar Sawara, sina första modeller som förtränas från grunden, med vikter planerade till våren 2027
2 november — Sakana AI publicerar en rapport från sitt symposium den 26 oktober i Tokyo (över 400 deltagare och ett föredrag av Jürgen Schmidhuber), och den innehåller en konkret nyhet: det japanska startupföretaget ska förträna egna språkmodeller. Hittills har företaget arbetat med agenter och efterträning av befintliga öppna modeller genom Namazu. Sawara-serien (arbetsnamn), som presenterades av forskningschefen (Chief Scientist) Takuya Akiba, byggs från grunden utan att utgå från någon annans modell och är utformad för agentanvändning (agent-native): resonemang med verktyg, kod och långvariga uppgifter. Den ska ligga till grund för Sakana AI:s produkter och RSI Labs forskning om rekursiv självförbättring.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇸🇪 Vi förbereder nu träningen och kommer att inleda förträningen av Sawara Small (arbetsnamn) i december. Om allt går bra publicerar vi vikterna nästa vår. — Sakana AI, rapport från symposiet 2026
Sawara Large, även det ett arbetsnamn, ska följa senare, utan angivet datum. Sakana AI anger varken modellstorlek, datamängd eller beräkningsbudget.
🔗 Sakana AI:s tillkännagivande på X
Energi för beräkningar: OpenAI lanserar Grid Protectors, en TPU från Google svarar från omloppsbana
OpenAI lanserar Grid Protectors, upp till 1 000 MW förbrukningsminskning för sitt campus i Effingham
2 november — OpenAI lanserar Grid Protectors, ett nationellt program för att företagets framtida beräkningscampus ska minska sin förbrukning när elnätet är ansträngt, vid en köldknäpp eller värmebölja. Tillsammans med elleverantörer, tillsynsmyndigheter och offentliga beslutsfattare vill företaget ingå avtal för varje anläggning, där mängden förbrukning som kan minskas, reaktionstiden och varaktigheten fastställs. Beroende på lokala behov kan campusen också använda lokal elproduktion eller energilagring och jämna ut sin efterfrågan med batterier.
Pilotanläggningen är det planerade campuset i Effingham County i Georgia, som presenterades i juli under namnet Project Camellia. OpenAI förbinder sig att betala samtliga kostnader för elinfrastruktur och elförsörjning där.
| Angiven uppgift | Angivet värde | Källa till uppgiften |
|---|---|---|
| Flexibel förbrukningsminskning planerad i avtalet med Georgia Power | upp till 1 000 MW | OpenAI |
| Motsvarande genomsnittlig efterfrågan från hushåll | cirka 700 000 hushåll | OpenAI |
| Årliga besparingar för Georgia Powers kunder från 2029 | cirka 950 miljoner dollar | Georgia Power |
| Besparing för en typisk hushållskund som förbrukar 1 000 kWh | minst 15 dollar per månad | Georgia Power |
Georgia Powers prognos gäller samtliga avtal med stora förbrukare och den förväntade tillväxten, inklusive Project Camellia: siffran avser alltså inte enbart OpenAI:s program. Företaget medger att flexibilitet inte ersätter investeringar i ny produktions- och överföringskapacitet och presenterar varken någon ytterligare anläggning eller någon tidsplan.
🔗 OpenAI:s inlägg om Grid Protectors
Project Suncatcher: en TPU i omloppsbana ger sitt första svar, en haiku skriven av Gemma 4
30 oktober — I efterhand: en månad efter uppskjutningen av prototypsatelliten den 1 oktober når Project Suncatcher, Googles forskningsprojekt om AI-beräkningar i rymden, sin ”Hello World”-milstolpe: det första AI-svaret som producerats av en TPU av datacenterklass i omloppsbana. Under en passage över en markstation bad teamet den öppna modellen Gemma 4 ombord att skriva en haiku om livet i rymden. Svaret skickades tillbaka när satelliten flög över Svalbard i Norge. Därefter följde limerickar och telemetripromptar, som modellen besvarar genom att beskriva nyttolastens tekniska tillstånd.
Nästa steg gäller tillförlitligheten: tester av TPU:erna under termisk stress och strålning, inför ett par sammankopplade satelliter 2027. Inlägget innehåller inga uppgifter om prestanda eller förbrukning.
🔗 Googles inlägg om satellitens första svar
Vardagsliv och kreativitet i gränssnitt: OpenAI publicerar LifeVal, Kombai publicerar Design Creativity Bench
LifeVal: 169 vardagsuppgifter, från 49,3 % för GPT-5.2 till 80,6 % för GPT-6 Astra
2 november — OpenAI publicerar LifeVal, en utvärdering av modeller på vardagsuppgifter: att hitta barnomsorg, få tillgång till samhällstjänster, göra en budget, anpassa ett recept eller lägga upp ett träningsprogram. Uppgifterna bygger på två stora tidsanvändningsundersökningar, American Time Use Survey och Multinational Time Use Study, kompletterade med en representativ undersökning bland 3 995 personer om vilka områden de helst skulle vilja ha hjälp med. OpenAI uppger att företaget har använt den i ett år för att följa sina modeller.
| Utvärderad modell | Lanseringsdatum | Genomsnittlig belöning på 169 uppgifter |
|---|---|---|
| GPT-5.2 | december 2025 | 49,3 % |
| GPT-5.4 | mars 2026 | 73,0 % |
| GPT-5.5 | april 2026 | 77,4 % |
| GPT-5.6 | juli 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | september 2026 | 80,6 % |
Enligt diagrammets beskrivning handlar det om ett oviktat genomsnitt av de 169 uppgifterna, och endast 0,6 procentenheter skiljer GPT-5.6 från GPT-6 Astra. Diagrammet innehåller varken GPT-6.1 Sol eller Terra, eller någon modell från en annan leverantör, och OpenAI nämner ingen publicering av uppgiftssamlingen.
Design Creativity Bench: modellerna konvergerar mot samma gränssnitt
2 november — Kombai, som utvecklar AI-verktyg för front-end-utveckling, presenterar Design Creativity Bench på Hugging Face-bloggen. Detta benchmark mäter inte om ett gränssnitt fungerar utan om det liknar andra. Studien omfattar 15 ledande modeller, 160 instruktioner och 2 400 HTML-gränssnitt, som jämförs med designförslag skapade av människor.
| Mått i benchmarken | Utvärderade modeller | Mänsklig referens |
|---|---|---|
| Genomsnittlig särprägel för samma instruktion | 0,592 mellan modeller | 0,764 mellan människor och modeller |
| Genomsnittlig kreativ bredd | 0,581 | 0,902 |
| Uppfyllda acceptanskriterier | över 90 % för alla (Claude Opus 5.5: 99,2 %) | 98,0 % |
Modellerna uppfyller alltså kravspecifikationen, men liknar varandra. GPT-6 Astra har den mest särpräglade stilen i gruppen (0,646 i originalitet), men varierar samtidigt lite mellan olika sammanhang (0,472 i bredd). Kombai publicerar artikeln (arXiv 2610.11539), en rankning och en delmängd för reproducerbarhet och medger begränsningarna: endast datorgränssnitt och API:ernas standardinställningar.
🔗 Kombais inlägg på Hugging Face
Perplexity publicerar BrowseSafe++ och sina BrowseSafe-Guard-detektorer mot prompt injection
2 november — Perplexity Secure Intelligence Institute publicerar BrowseSafe++, uppföljaren till BrowseSafe (december 2025), ett öppet benchmark för indirekt prompt injection (indirect prompt injection) som riktar sig mot agenter som kan navigera på webben. Det innehåller 38 675 sidpar, en angripen sida och dess rena motsvarighet, varav 32 187 bygger på injektioner som faktiskt har observerats: Comets detektor flaggade 1,15 miljoner mellan september 2025 och september 2026. Varje sida finns som HTML, Markdown, tillgänglighetsträd och skärmbild. Utifrån detta tar Perplexity fram BrowseSafe-Guard, två detektorer på 0,8B som finjusterats från Qwen3.5-0.8B, en för text och en för skärmbilder.
| Publicerat resultat | BrowseSafe-Guard | Jämförda modeller |
|---|---|---|
| F1 för textvyer | cirka 95 %, bäst i varje vy | 85 till 92 % för de bästa generella modellerna |
| F1 för skärmbilder | cirka 93 % | cirka 79 % för den bästa övriga modellen |
| Rena sidor som felaktigt flaggas | cirka 1 av 20 | 14,41 % för GPT-6 Astra |
| Kostnad för 1 000 sidor | 0,18 dollar på en hyrd H200 | 18,95 till 180,61 dollar via API |
Att upptäcka är inte detsamma som att stå emot: varje modell följde injektioner som den själv hade upptäckt, från 1,64 % av sidorna för GPT-6 Astra till 24,73 % för Llama 3.1 8B. En ihärdig angripare lyckas också till slut ta sig igenom: i miljön BrowseSafe-Adapt, som skriver om injektionen efter varje misslyckande (1 024 uppgifter, upp till 64 försök), ökar framgångsgraden från högst 4 % vid första försöket till minst 79 % mot fem av de sju testade agenterna. När Guard placeras framför en Gemini 3.5 Flash-Lite-agent blockerar det 94,5 % av de ursprungliga injektionerna, men angriparen lyckas fortfarande med 84,2 % av uppgifterna. Datasetet (med kontrollerad åtkomst), ett SDK under MIT-licens och en offentlig rankning finns tillgängliga. Inlägget länkar inte till några detektorvikter.
🔗 Perplexitys inlägg om BrowseSafe++
Generativa medier: Runway Dev kommer till Claude Code och Cursor, Synthesia till ChatGPT och Claude, ElevenLabs sätter siffror på röstens fördel
Runway Dev kommer till Claude Code och Cursor
2 november — Efter Codex, som presenterades den 28 oktober, utökar Runway sina Runway Dev-plugins till Claude Code och Cursor. En installation kopplar kodningsagenten till Runway Dev-kontot via Runways MCP-server och lägger till Runways skills för utveckling med företagets API för generativa medier. Agenten läser först kontouppgifterna (projekt, tillgängliga modeller med priser och begränsningar samt kreditsaldo) och använder sedan de officiella SDK:erna: den kan skapa en Model Router, som väljer rätt modell för varje anrop, eller en Character för realtidsavatarer, och återanvända Recipes (färdiga pipelines) eller Workflows som publicerats som API-endpoints. Om något misslyckas granskar den feldetaljerna. Anslutningen till kontot sker vid första användningen, utan någon API-nyckel lagrad i pluginen, och inget separat pris anges.
| Kodningsagent | Installation enligt Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api i Agent-chatten, eller Cursor Marketplace |
Synthesia skapar sina videor i ChatGPT och Claude
2 november — Synthesia meddelar att företagets avatarvideor nu kan skapas direkt i ChatGPT och Claude: användaren beskriver den önskade videon, ser den dyka upp i konversationen, ber om justeringar och publicerar och delar den sedan, utan att öppna någon annan applikation eller flik. Tillkännagivandet består av en tweet med en demonstrationsvideo. Vid vår genomgång fanns inget inlägg på Synthesias blogg eller startsida. Synthesia anger varken hur integrationen fungerar, vilka abonnemang som omfattas eller priset.
🔗 Synthesias tillkännagivande på X
ElevenLabs: röst har 32 % högre framgångsfrekvens än chatt i samtal över två minuter
2 november — ElevenLabs publicerar en studie som jämför röst (telefon och WhatsApp) med chatt hos ElevenAgents-agenter i produktion, där varje agent jämförs med sig själv utifrån sina konversationer från maj till juli 2026. Tweeten som presenterar studien nämner 469 agenter; blogginlägget talar däremot om ”hundratals” agenter.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇸🇪 Ju längre samtalet är, desto högre är röstagenternas framgångsfrekvens. Vi har analyserat 469 agenter som används för både röst och chatt i produktion och observerat ett intressant mönster. När samtalet blir komplext är röst den snabbaste vägen till en lösning. — @ElevenLabs på X
| Indikator enligt ElevenLabs | Uppmätt värde |
|---|---|
| Framgång för röst vid samtal över två minuter | +10,9 procentenheter, motsvarande +31,7 % |
| Samtal under en minut | chatt ligger före med cirka 9 procentenheter |
| Längd på framgångsrika långa samtal | 4,6 minuter med röst, 7 minuter med chatt |
| Byte till en snabbare LLM (315 samtal) | 16 % lägre latens, 26 % högre framgångsfrekvens |
| Föredrar röst (98 deltagare, inställt flyg) | 85 % |
Längden används här som en indikator på komplexitet, vilket blogginlägget medger är ett ofullkomligt mått, och studien kommer från leverantören, som samtidigt marknadsför sina röstagenter.
🔗 Blogginlägget från ElevenLabs
NVIDIA publicerar simuleringsrecept för Cosmos 3 Nano för körning, robotik och kirurgi
2 november — NVIDIA publicerar på sin tekniska blogg en guide i två delar för Cosmos, sin plattform med grundmodeller av världen (world foundation models) avsedd för fysisk AI: simuleringsrecept baserade på nya kontrollpunkter för Cosmos 3 Nano, som presenterades den 22 oktober och denna gång namnges och beskrivs, följt av en guide till NIM-mikrotjänster. Ett exempel som lyfts fram: genom att bara ändra prompten kan en färd i dagsljus förvandlas till en regnig natt, utan att vägens sträckning eller fordonens banor ändras.
| Kontrollpunkt för Cosmos 3 | Användning enligt NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Klipp från flera kameror med LiDAR för körning, upp till 400 bilder i 480p eller 720p |
| Cosmos3-Nano-Sim-Auto | Destillerad kausal variant som genererar strömmande för att testa en körpolicy i en sluten slinga |
| Cosmos3-Nano-Sim-Transfer | Djupvideo omvandlad till detaljerad RGB-video, för robotik |
| Cosmos3-Nano-Sim-Bimanual | Nästa observation för en robot med två armar utifrån scenen och dess handlingar |
| Cosmos3-H-Embodied-Nano och Cosmos3-H-Dreams | Kirurgisk simulering utifrån robotens handlingar, i realtid för H-Dreams |
När det gäller driftsättning erbjuder NIM-imagen cosmos3:2.0.0 profiler för latens eller genomströmning, och spekulativ avkodning gör inferensen i genomsnitt cirka 2 till 3 gånger snabbare på H200 enligt NVIDIA, som uppger att Cosmos NIM är certifierade för över 20 GPU:er. Vid generering kräver Cosmos3-Nano 58 Gio VRAM i BF16 och 31 Gio i FP8 med avlastning. Cosmos Framework får pipelines för förstärkningsinlärning (DPO, GRPO, PPO, OPD, DiffusionNFT), och en livesändning om ramverket hålls torsdagen den 5 november.
🔗 NVIDIAs tekniska blogginlägg
Copilot CLI 1.0.106-3 i förhandsversion: sessionshantering som tillval och 145 rättningar
2 november — GitHub släpper förhandsversionen 1.0.106-3 av Copilot CLI, den tredje i grenen 1.0.106. Versionsinformationen innehåller bara ett tillägg: verktyg för sessionshantering som aktiveras efter ett aktivt val (opt-in), och möjlighet att med @ nämna lokala sessioner där funktionen har aktiverats, utan fler detaljer. För hanterade konton återger varningarna om policyuppdateringar nu resultaten från Policy Helper.
De återstående 145 rättningarna rör främst robustheten i terminalgränssnittet, och flera har betydelse för säkerheten:
| Säkerhetsrättning | Beteende före 1.0.106-3 |
|---|---|
| Filtrering av escape-sekvenser | Ett svar, ett filnamn eller en MCP-verktygstitel kunde ändra tidslinjens utseende eller dölja rader i den |
/allow-all off | När kommandot följdes av ett ideografiskt blanksteg (CJK-inmatning) aktiverade det Allow All i stället för att stänga av det |
/session delete | En okänd flagga före identifieraren raderade den aktuella sessionen utan att be om bekräftelse |
copilot -p och copilot workflow run | Textutdata visade värdena för --secret-env-vars, som JSON-utdata redan dolde |
Den senaste stabila versionen är fortfarande 1.0.105 från den 28 oktober, och Copilot SDK 1.0.29-preview.2, som publicerades samma kväll, innehåller inga ändringar på SDK-sidan.
🔗 Versionsinformationen för Copilot CLI 1.0.106-3
Notiser
Agenter och kodverktyg
- Qwen Code v0.26.6 — Stabil version från den 2 november, dagen efter v0.26.5: Web Shell får en aktivitetsvy för sessioner och visar framgångsfrekvens, utdatahastighet och latens till första token för varje modell; Kimi K3-modellerna får sitt kontextfönster på 1 miljon tokens. 🔗 källa
- Gemini CLI — En rättning som mergades på kvällen den 2 november förhindrar att en avbruten nedladdning av Whisper-modellen uppfattas som en installerad modell, vilket tidigare blockerade det lokala röstläget tills filen raderades manuellt. Den ingår ännu inte i någon version, och dagens nightly bygger på samma commit som de två föregående. 🔗 källa
- CLI mistral 0.16.0 —
mistral workflows initochmistral initbegär nu API-nyckeln för ett Workflow-projekt, verifierar den mot Mistrals API och sparar den i projektets.env. 🔗 källa - Qodo-plugin för Codex — I en fallstudie publicerad av OpenAI presenterar Qodo sitt plugin på Codex marketplace: Codex får organisationens regler och historiken för pull requests innan det börjar skriva, och därefter Qodos granskning i samma session, innan en pull request öppnas. Inga resultat redovisas i siffror. 🔗 källa
- corgi, uppmärksammat av Zed — På kvällen den 1 november delar Zed webbplatsen för corgi, Conrad Irwins Cargo-kompatibla buildverktyg för Rust: en enda cache per dator, build.rs och makron i en sandbox samt cachade tester. Enligt skaparen är koden nästan helt skriven av AI. Kodarkivet har MIT-licens. 🔗 källa
Utvecklingsplattformar och API:er
- pull_request_target i GitHub Actions — Standardblockeringen av
pull_request_targeti offentliga kodarkiv skjuts upp från den 2 november till den 2 december; två planerade avbrott, den 9 och 16 november kl. 16 till 18 UTC, kommer att synliggöra de workflows som berörs. 🔗 källa - GitHubs riskbedömningar — Säkerhetsriskbedömningarna för kod och secrets visar nu om varje fynd finns i ett skyddat eller oskyddat kodarkiv, på GitHub Enterprise Cloud och GitHub Team. 🔗 källa
- Perplexitys Analytics API — Svaren om förbrukningen av Computer-krediter saknar för tillfället uppdelningen efter krediternas ursprung (Credit Source); totalsumman och uppdelningen per modell finns kvar, och Perplexity ber användarna att inte tolka en saknad uppdelning som noll förbrukning. 🔗 källa
Öppna modeller och inlägg från communityn
- kniv v7 från Dragonscale — Sex öppna encoders med 55M till 538M parametrar (Apache-2.0, ONNX) som extraherar entiteter, relationer och fakta enligt ett schema som beskrivs vid anropet, utan LLM, för agenters minne; på Re-DocRED, 0,749 inom samma mening och 0,732 med två meningars avstånd (DeBERTa-varianten). 🔗 källa
- Glidande fönster och Bifocal-lager — I ett communityinlägg destillerar Lukas Qwen3-4B-Instruct till fyra elevmodeller med samma minnesbudget: ett glidande fönster räcker för korta svar, men på AIME och HMMT löser hans Bifocal-lager (litet fönster och mLSTM-tillstånd) nästan dubbelt så många problem som enbart fönstret, som fastnar runt 14 %. Författarens egna mätningar. 🔗 källa
- Bakdörr blockerad av ViKernel — VIDRAFT planterar genom finjustering en bakdörr i Qwen3-0.6B: ordet ”payroll” i en filsökväg utlöser det skadliga kommandot i 98,3 % av fallen för tidigare osedda sökvägar, utan att någon av 24 kontroller upptäcker det; på ViKernel nekas alla 290 payloads före körning. Modellvikterna har inte publicerats. 🔗 källa
- Routing i Beam och testfusk — En förregistrerad studie av Rairo Mukamuri lyckas inte förutsäga en manipulering av ett test 500 tokens i förväg utifrån expertroutingen i Beam-1.0-501B-A23B: AUROC på 0,580 jämfört med ett fastställt tröskelvärde på 0,75, för 9,03 dollar i beräkningskostnad. 🔗 källa
- Saturate — Daniel van Strien OCR-behandlar 14 483 arkivsidor på nytt på en enda GPU i Hugging Face Jobs, för 1,47 dollar och med 8,9 sidor per sekund, med Saturate, hans Apache-2.0-bibliotek för batchinferens mot valfri OpenAI-kompatibel endpoint. 🔗 källa
Bild, video, röst och musik
- LTX 2.5 på en RTX PRO 6000 — GPU-uthyraren EcoHash renderar en 10 sekunder lång video i 1080p med ljud på 90 sekunder, och i 480p på 14,8 sekunder, på ett enda kort med 96 Go; leverantörens egna mätningar på sin tjänst. 🔗 källa
- KPN:s Mobiel AI — ElevenLabs beskriver KPN:s samtalsassistent för nederländska småföretag (transkribering av röstmeddelanden, samtalssammanfattningar, samtalsmeny); finjustering för nederländska höjde träffsäkerheten vid verifiering från cirka 50 % till 90 %. Inget pris anges. 🔗 källa
- Suno Studio — Nyhet från den 29 oktober som tas upp i efterhand, uppmärksammad den 2 november: klippinställningarna flyttas till ett sidofält, tonhöjden justeras i halvtoner och cent, importerat ljud kan tidssträckas till projektets tempo och spår döljs med Shift-H. 🔗 källa
- Kling och Chroma Awards — Kling blir partner till tävlingens säsong 2, med över 450 000 dollar i priser; bidrag kan lämnas in till den 7 januari. 🔗 källa
Program, demonstrationer och inlägg från labben
- Anthropic Residency — Anthropic tar fram till den 22 november emot ansökningar till ett avlönat forskningsprogram på sex veckor till sex månader, för professorer, grundare med teknisk bakgrund och ingenjörer på staff-nivå, utan förkunskapskrav i maskininlärning; ersättning motsvarande 350 000 till 500 000 dollar per år. 🔗 källa
- Data Bot från SpaceXSI — Intern fallstudie: en Team Bot från Grok Bot som fungerar som data scientist för hela företaget, utifrån skills som underhålls av datateamet, och som ska ha tagit hand om cirka 70 timmars arbete på en vecka, enligt en uppskattning från SpaceXSI. 🔗 källa
- Le Chonk och kvantkemi — Mistral visar på X hur Mistral Large 4 från grunden skriver en SCF-lösare och en 3D-vy av en molekyl som bryts sönder, utan att publicera kod eller siffror. 🔗 källa
- Googles sammanfattning av oktober — Inga nya tillkännagivanden förutom svaret från satelliten i Project Suncatcher, som behandlats ovan. 🔗 källa
- Agentminne hos Perplexity — En guide om olika typer av minne och hur man bygger en agent med beständigt minne, som hänvisar till Brain, som redan finns i Computer. 🔗 källa
- The Knowledge Talk — Perplexity publicerar transkriptionen av Aravind Srinivas tal den 3 oktober vid Cambridge Union Society, utan några tillkännagivanden. 🔗 källa
Vad det betyder
Message threads flyttar en del av konversationens tillstånd till servern utan att påverka fakturan: tokens och priser förblir desamma, bara väntetiden minskar, och effekten märks tydligast i agentsessioner som samlar på sig hundratusentals tokens. Valet av en tillfällig tråd, som sparas 5 minuter i krypterat minne och saknar API för att läsa den igen, låter applikationen behålla kontrollen över sin historik, men innebär tydliga uteslutningar: varken ZDR, Batches eller HIPAA-organisationer stöds. I terminalen påminner förhandsversionen av Copilot CLI om att själva gränssnittet är en attackyta, när ett filnamn eller ett modellsvar kunde ändra skärmens utseende.
Grid Protectors och Suncatcher tar sig an samma begränsning, energin för beräkningar, men med två mycket olika tidshorisonter. OpenAI föreslår att göra det möjligt att tillfälligt minska elförbrukningen på sina campus för att få dem accepterade i ett redan ansträngt elnät, med löftet att betala sina egna kostnader; den enda kvantifierade besparingen för hushållen kommer från Georgia Power och gäller företagets samtliga stora kunder. Google har nått stadiet där en TPU i omloppsbana får skriva en haiku: en milstolpe som visar genomförbarheten, utan prestandasiffror, inför två sammankopplade satelliter 2027.
LifeVal, Design Creativity Bench och BrowseSafe++ mäter det som rankningar för kod och matematik inte fångar. LifeVal visar framsteg som saktar in, 0,6 poäng mellan GPT-5.6 och GPT-6 Astra, men är fortfarande ett internt benchmark, utan konkurrenter eller publicerad uppgiftsuppsättning. Kombai pekar på en likriktning av gränssnitten som framgångsfrekvensen döljer, och BrowseSafe++ skiljer mellan upptäckt och motståndskraft: en modell som upptäcker en injektion kan ändå följa den, och en detektor på 0,8B, som är över hundra gånger billigare än ett API-anrop, räcker inte mot en angripare som försöker igen.
Sakana AI väljer att kontrollera hela kedjan med Sawara, från förträning till produkter, men med en villkorad tidsplan och utan angiven storlek. Runway och Synthesia gör tvärtom: de etablerar sig där användarna redan arbetar, i kodagenten eller i konversationen med ChatGPT och Claude, i stället för att locka dem till sin egen applikation. ElevenLabs ger ett sifferbaserat argument för röst i långa samtal, med en leverantörsstudie vars underlag skiljer sig mellan tweeten och blogginlägget, medan NVIDIA förser dem som simulerar körning, robotik eller kirurgi med verktyg genom Cosmos 3 Nano.
Källor
- Anthropics artikel om message threads
- @ClaudeDevs: message threads i Claude Code
- Dokumentationen för message threads
- Sammanfattning av Sakana AI:s symposium 2026
- @SakanaAILabs: sammanfattning av symposiet
- Presentation av Grid Protectors Program (OpenAI)
- Första svaret från Project Suncatchers prototypsatellit (Google)
- LifeVal (OpenAI)
- Varför vi byggde Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- Runway Dev-plugins för kodagenter
- @synthesiaIO: Synthesia-videor i ChatGPT och Claude
- Varför röst vinner i komplexa, stressiga samtal (ElevenLabs)
- @ElevenLabs: studie om röst kontra chatt
- Bygg världsmodeller för interaktiv simulering med NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 i Gemini CLI
- CLI mistral 0.16.0
- Fallstudie om Qodo och Codex (OpenAI)
- @zeddotdev: corgi
- pull_request_target blockeras som standard den 2 december (GitHub)
- Riskbedömningarna inkluderar skyddsstatus för repositories (GitHub)
- Changelog för Perplexity API
- Dragonscales inlägg om kniv v7
- Inlägg om det glidande fönstret och Bifocal
- VIDRAFT:s inlägg om bakdörren
- Rairo Mukamuris inlägg om Beam
- @vanstriendaniel: Saturate
- EcoHashs inlägg om LTX 2.5
- Mobiel AI från KPN (ElevenLabs)
- Versionsinformation för Suno Studio
- @Kling_ai: Chroma Awards säsong 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk och SCF-lösaren
- Googles AI-nyheter i oktober 2026
- Minne för AI-agenter (Perplexity)
- Kunskapssamtalet (Perplexity)