ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
Anthropic ने Messages API के message threads की सार्वजनिक बीटा शुरू की है। ये Claude Code में पहले से सक्रिय हैं, जहाँ सबसे लंबे अनुरोधों पर पहले token तक का समय लगभग 35 % घटता है। Sakana AI ने Sawara की घोषणा की है, जो शून्य से पूर्वप्रशिक्षित उसके पहले मॉडल हैं। वहीं OpenAI ने विद्युत ग्रिड की ज़रूरत पर अपने कंप्यूटिंग परिसरों की खपत घटाने के लिए Grid Protectors शुरू किया है और दैनिक जीवन के कार्यों की मूल्यांकन कसौटी LifeVal प्रकाशित की है। Perplexity ने prompt injection के विरुद्ध BrowseSafe++ प्रकाशित किया है, NVIDIA ने Cosmos 3 Nano के साथ सिमुलेशन के लिए साधन उपलब्ध कराए हैं, और Runway, Synthesia तथा ElevenLabs जनरेटिव मीडिया को सहायकों और एजेंटों में शामिल कर रहे हैं।
Messages API में message threads की सार्वजनिक बीटा शुरू, Claude Code में पहले से सक्रिय
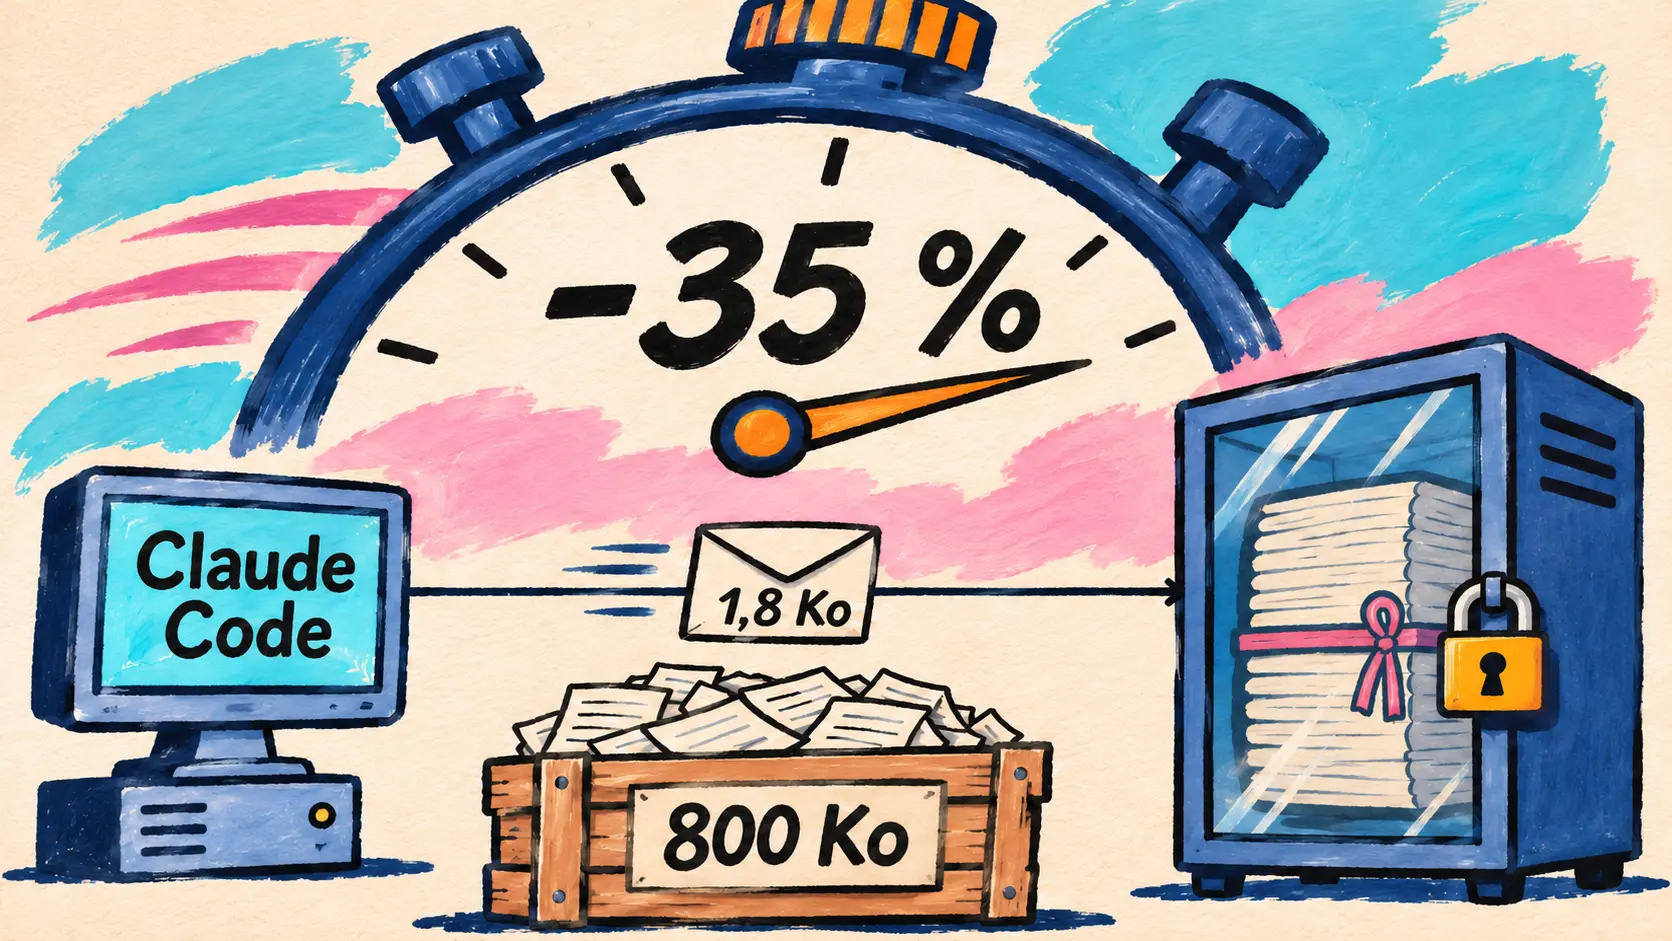
2 नवंबर — Anthropic ने Messages API पर संदेश शृंखलाओं (message threads) की सार्वजनिक बीटा शुरू की है। अब तक कोई एजेंट हर चरण में पूरी बातचीत दोबारा भेजता था, जिसमें टूल के परिणाम भी शामिल होते थे। थ्रेड का इस्तेमाल करने पर पहला अनुरोध सिस्टम prompt और टूल सहित पूरी बातचीत भेजता है; उसके बाद के अनुरोध केवल नए संदेश और पिछले उत्तर का पहचानकर्ता भेजते हैं, और मॉडल को कॉल करने से पहले API बाकी बातचीत फिर से तैयार करती है। इसके लिए केवल thread पैरामीटर और message-threads-2026-08-12 बीटा हेडर जोड़ना होता है, जिन्हें आधिकारिक SDK एक समर्पित सहायक फ़ंक्शन से संभालते हैं।
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇮🇳 हमने हाल ही में Claude Code में message threads को शामिल किया है। 500 000 से 1 मिलियन tokens वाले अनुरोधों पर पहले token तक का माध्यिका समय लगभग 35 % कम है। लंबी बातचीत में अनुरोध का माध्यिका आकार लगभग 800 Ko से घटकर 1,8 Ko हो गया है। — X पर @ClaudeDevs
लाभ विलंब में है, बिल में नहीं: Claude हर चरण में पूरी बातचीत दोबारा पढ़ता है, इसलिए tokens, दरें और अनुरोध दर की सीमाएँ नहीं बदलतीं, और prompt की कैशिंग (prompt caching) का अनुरोध अब भी खुद करना पड़ता है। थ्रेड को यथासंभव (best-effort) एन्क्रिप्टेड मेमोरी में रखा जाता है, कभी डिस्क पर नहीं: अंतिम अनुरोध के 5 मिनट बाद उसकी अवधि समाप्त हो जाती है, और एप्लिकेशन अपनी प्रति रखती है ताकि API के 404 लौटाने पर सब कुछ दोबारा भेज सके। यह सुविधा शून्य डेटा प्रतिधारण (ZDR) के लिए पात्र नहीं है और न Message Batches के साथ, न माँग पर किए जाने वाले compaction के साथ, और न ही HIPAA संगठनों में काम करती है। यह Claude API, Claude Platform on AWS, Claude in Microsoft Foundry और Claude Models on Google Cloud (Anthropic managed) पर उपलब्ध है।
🔗 message threads पर Anthropic का लेख · message threads का दस्तावेज़ीकरण
Sakana AI ने शून्य से पूर्वप्रशिक्षित अपने पहले मॉडल Sawara की घोषणा की, वेट्स वसंत 2027 में जारी करने की योजना
2 नवंबर — Sakana AI ने टोक्यो में 26 अक्टूबर को हुए अपने संगोष्ठी का विवरण प्रकाशित किया है, जिसमें 400 से अधिक प्रतिभागी थे और यूर्गेन श्मिडहुबर का व्याख्यान हुआ। इसमें एक ठोस घोषणा भी है: यह जापानी स्टार्टअप अपने भाषा मॉडलों का पूर्वप्रशिक्षण करेगी। अब तक वह एजेंटों और Namazu के साथ मौजूदा खुले मॉडलों के पश्चप्रशिक्षण पर काम करती थी। उसके वैज्ञानिक निदेशक (मुख्य वैज्ञानिक) ताकुया आकिबा ने Sawara शृंखला (अस्थायी नाम) प्रस्तुत की। इसे किसी तीसरे पक्ष के मॉडल से शुरू किए बिना शून्य से बनाया जा रहा है और एजेंट संबंधी उपयोगों (agent-native) को ध्यान में रखकर तैयार किया जा रहा है: टूल के साथ तर्क करना, कोड और लंबे कार्य। इसे Sakana AI के उत्पादों और पुनरावर्ती स्व-सुधार पर RSI Lab के शोध का आधार बनना है।
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇮🇳 हम अभी प्रशिक्षण की तैयारी कर रहे हैं और दिसंबर में Sawara Small (अस्थायी नाम) का पूर्वप्रशिक्षण शुरू करेंगे। यदि सब कुछ ठीक रहा, तो हम अगले वसंत में वेट्स जारी करेंगे। — Sakana AI, 2026 की संगोष्ठी का विवरण
इसके बाद Sawara Large भी आना है, जिसका नाम भी अस्थायी है, लेकिन कोई तारीख नहीं दी गई है। Sakana AI ने न मॉडल का आकार बताया है, न डेटा की मात्रा और न ही कंप्यूटिंग का बजट।
कंप्यूटिंग की ऊर्जा: OpenAI ने Grid Protectors शुरू किया, Google की एक TPU ने कक्षा से उत्तर दिया
OpenAI ने Grid Protectors शुरू किया, एफिंघम परिसर के लिए बिजली की माँग में 1 000 MW तक की कटौती
2 नवंबर — OpenAI ने Grid Protectors शुरू किया है। यह एक राष्ट्रीय कार्यक्रम है, जिसके तहत उसके भविष्य के कंप्यूटिंग परिसर शीतलहर या लू के दौरान विद्युत ग्रिड पर दबाव पड़ने पर अपनी खपत घटाएँगे। बिजली आपूर्तिकर्ताओं, नियामकों और सार्वजनिक नीति निर्माताओं के साथ कंपनी हर स्थल के लिए अलग समझौते करना चाहती है, जिनमें कटौती की मात्रा, प्रतिक्रिया का समय और अवधि तय होगी। स्थानीय ज़रूरतों के अनुसार, परिसर स्थल पर ही बिजली उत्पादन या भंडारण का सहारा भी ले सकेंगे और बैटरियों से अपनी माँग में उतार-चढ़ाव कम कर सकेंगे।
प्रायोगिक स्थल जॉर्जिया के एफिंघम काउंटी में प्रस्तावित परिसर है, जिसे जुलाई में Project Camellia के नाम से पेश किया गया था। OpenAI ने वहाँ बुनियादी ढाँचे और विद्युत सेवा की पूरी लागत चुकाने की प्रतिबद्धता जताई है।
| घोषित आँकड़ा | घोषित मान | आँकड़े का स्रोत |
|---|---|---|
| Georgia Power के साथ समझौते में प्रस्तावित लचीली माँग कटौती | 1 000 MW तक | OpenAI |
| घरों की औसत माँग के बराबर | लगभग 700 000 घर | OpenAI |
| 2029 से Georgia Power के ग्राहकों की वार्षिक बचत | लगभग 950 मिलियन डॉलर | Georgia Power |
| 1 000 kWh खपत करने वाले एक सामान्य आवासीय ग्राहक का लाभ | कम से कम 15 डॉलर प्रति माह | Georgia Power |
Georgia Power का अनुमान बड़े उपभोक्ताओं के साथ उसके सभी समझौतों और अपेक्षित वृद्धि पर आधारित है, जिसमें Project Camellia भी शामिल है: यह केवल OpenAI के कार्यक्रम का आँकड़ा नहीं है। कंपनी स्वीकार करती है कि लचीलापन बिजली उत्पादन और पारेषण की नई क्षमता में निवेश की जगह नहीं लेता, और उसने किसी अन्य स्थल या समय-सारणी की घोषणा नहीं की है।
🔗 Grid Protectors पर OpenAI का लेख
Project Suncatcher: कक्षा में एक TPU ने अपना पहला उत्तर दिया, Gemma 4 की लिखी हाइकु
30 अक्टूबर — पिछली खबर पर एक नज़र: 1 अक्टूबर को अपना प्रोटोटाइप उपग्रह लॉन्च करने के एक महीने बाद, अंतरिक्ष में एआई कंप्यूटिंग पर Google की शोध परियोजना Project Suncatcher ने अपना « Hello World » पड़ाव पार किया है: कक्षा में मौजूद डेटा सेंटर श्रेणी की TPU द्वारा तैयार किया गया पहला एआई उत्तर। एक भू-स्टेशन के ऊपर से गुज़रते समय टीम ने उपग्रह पर मौजूद खुले मॉडल Gemma 4 से अंतरिक्ष में जीवन पर एक हाइकु माँगी; जब उपग्रह नॉर्वे के स्वालबार्ड के ऊपर था, तो उत्तर पृथ्वी पर प्राप्त हुआ। इसके बाद लिमरिक और टेलीमेट्री prompt आज़माए गए, जिनके उत्तर में मॉडल पेलोड की तकनीकी स्थिति का वर्णन करता है।
अगला चरण विश्वसनीयता पर केंद्रित है: 2027 में आपस में जुड़े दो उपग्रहों से पहले, तापीय दबाव और विकिरण में TPU के परीक्षण होंगे। लेख में प्रदर्शन या बिजली की खपत का कोई आँकड़ा नहीं दिया गया है।
🔗 उपग्रह के पहले उत्तर पर Google का लेख
दैनिक जीवन और इंटरफ़ेस की रचनात्मकता: OpenAI ने LifeVal, Kombai ने Design Creativity Bench प्रकाशित किया
LifeVal: दैनिक जीवन के 169 कार्य, GPT-5.2 के 49,3 % से GPT-6 Astra के 80,6 % तक
2 नवंबर — OpenAI ने दैनिक जीवन के कार्यों पर मॉडलों के मूल्यांकन के लिए LifeVal प्रकाशित किया है: बच्चों की देखभाल की व्यवस्था खोजना, सार्वजनिक सेवाओं तक पहुँच पाना, बजट बनाना, किसी व्यंजन विधि को ज़रूरत के अनुसार बदलना या व्यायाम की योजना तैयार करना। ये कार्य समय के उपयोग पर दो बड़े सर्वेक्षणों, American Time Use Survey और Multinational Time Use Study, पर आधारित हैं। इनके साथ 3 995 लोगों का एक प्रतिनिधि सर्वेक्षण भी लिया गया है, जिसमें पूछा गया था कि उन्हें किन क्षेत्रों में सबसे अधिक मदद चाहिए। OpenAI का कहना है कि वह एक साल से अपने मॉडलों की प्रगति देखने के लिए इसका इस्तेमाल कर रहा है।
| मूल्यांकित मॉडल | जारी होने की तारीख | 169 कार्यों पर औसत रिवॉर्ड |
|---|---|---|
| GPT-5.2 | दिसंबर 2025 | 49,3 % |
| GPT-5.4 | मार्च 2026 | 73,0 % |
| GPT-5.5 | अप्रैल 2026 | 77,4 % |
| GPT-5.6 | जुलाई 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | सितंबर 2026 | 80,6 % |
ग्राफ़ के विवरण के अनुसार, यह 169 कार्यों का अभारित औसत है, और GPT-5.6 तथा GPT-6 Astra के बीच केवल 0,6 अंक का अंतर है। ग्राफ़ में न GPT-6.1 Sol या Terra हैं, न किसी अन्य निर्माता का कोई मॉडल, और OpenAI ने कार्यों का संग्रह प्रकाशित करने का उल्लेख नहीं किया है।
Design Creativity Bench: मॉडल एक जैसे इंटरफ़ेस की ओर बढ़ रहे हैं
2 नवंबर — front-end विकास के लिए एआई टूल बनाने वाली कंपनी Kombai ने Hugging Face के ब्लॉग पर Design Creativity Bench प्रस्तुत किया है। यह मूल्यांकन कसौटी यह नहीं मापती कि कोई इंटरफ़ेस काम करता है या नहीं, बल्कि यह देखती है कि वह दूसरे इंटरफ़ेस से कितना मिलता-जुलता है। अध्ययन में 15 अग्रणी मॉडल, 160 निर्देश और 2 400 HTML इंटरफ़ेस शामिल हैं, जिनकी तुलना मनुष्यों द्वारा बनाए गए डिज़ाइन प्रारूपों से की गई है।
| मूल्यांकन की माप | मूल्यांकित मॉडल | मानवीय संदर्भ |
|---|---|---|
| एक ही निर्देश पर औसत भिन्नता | मॉडलों के बीच 0,592 | मनुष्यों और मॉडलों के बीच 0,764 |
| औसत रचनात्मक विस्तार | 0,581 | 0,902 |
| पूरे किए गए स्वीकृति मानदंड | सभी के लिए 90 % से अधिक (Claude Opus 5.5 : 99,2 %) | 98,0 % |
इस प्रकार मॉडल आवश्यकताएँ पूरी करते हैं, लेकिन एक-दूसरे जैसे दिखते हैं। समूह में GPT-6 Astra की शैली सबसे अलग है (मौलिकता 0,646), हालाँकि एक संदर्भ से दूसरे संदर्भ में वह कम बदलती है (विस्तार 0,472)। Kombai ने शोधपत्र (arXiv 2610.11539), एक रैंकिंग और परिणामों को दोहराने के लिए एक उपसमुच्चय प्रकाशित किया है। उसने अपनी सीमाएँ भी स्वीकार की हैं: केवल डेस्कटॉप स्क्रीन और API की डिफ़ॉल्ट सेटिंग्स।
🔗 Hugging Face पर Kombai का लेख
Perplexity ने prompt injection के विरुद्ध BrowseSafe++ और उसके BrowseSafe-Guard डिटेक्टर प्रकाशित किए
2 नवंबर — Perplexity Secure Intelligence Institute ने BrowseSafe (दिसंबर 2025) का अगला संस्करण BrowseSafe++ प्रकाशित किया है। यह अप्रत्यक्ष prompt injection (indirect prompt injection) पर केंद्रित एक खुली मूल्यांकन कसौटी है, जो वेब पर नेविगेट कर सकने वाले एजेंटों को निशाना बनाता है। इसमें 38 675 पृष्ठ-जोड़े हैं, जिनमें एक हमला किया गया पृष्ठ और उसका साफ़ समकक्ष है। इनमें से 32 187 जोड़े वास्तव में देखे गए इंजेक्शन के आधार पर बनाए गए हैं: Comet के डिटेक्टर ने सितंबर 2025 से सितंबर 2026 के बीच ऐसे 1,15 मिलियन मामले चिह्नित किए। हर पृष्ठ HTML, Markdown, एक्सेसिबिलिटी ट्री और स्क्रीनशॉट के रूप में उपलब्ध है। इसके आधार पर Perplexity ने BrowseSafe-Guard तैयार किया है: Qwen3.5-0.8B से फ़ाइन-ट्यून किए गए 0,8B के दो डिटेक्टर, जिनमें एक टेक्स्ट और दूसरा स्क्रीनशॉट के लिए है।
| प्रकाशित परिणाम | BrowseSafe-Guard | तुलना किए गए मॉडल |
|---|---|---|
| टेक्स्ट रूपों पर F1 | लगभग 95 %, हर रूप में पहले स्थान पर | सर्वश्रेष्ठ सामान्य प्रयोजन मॉडलों के लिए 85 से 92 % |
| स्क्रीनशॉट पर F1 | लगभग 93 % | सर्वश्रेष्ठ अन्य मॉडल के लिए लगभग 79 % |
| गलती से चिह्नित किए गए साफ़ पृष्ठ | लगभग 20 में से 1 | GPT-6 Astra के लिए 14,41 % |
| 1 000 पृष्ठों की लागत | किराए के H200 पर 0,18 डॉलर | API के माध्यम से 18,95 से 180,61 डॉलर |
पता लगाना और प्रतिरोध करना अलग बातें हैं: हर मॉडल ने ऐसे इंजेक्शन के निर्देशों का पालन किया जिन्हें उसने खुद पहचान लिया था। यह GPT-6 Astra के लिए 1,64 % पृष्ठों से लेकर Llama 3.1 8B के लिए 24,73 % तक था। लगातार कोशिश करने वाला हमलावर भी आखिरकार सफल हो जाता है: BrowseSafe-Adapt परिवेश में, जो हर विफलता के बाद इंजेक्शन को दोबारा लिखता है (1 024 कार्य, अधिकतम 64 प्रयास), सफलता पहले प्रयास में अधिकतम 4 % से बढ़कर परीक्षण किए गए सात एजेंटों में से पाँच के विरुद्ध कम से कम 79 % हो जाती है। Gemini 3.5 Flash-Lite एजेंट के सामने लगाए जाने पर Guard मूल इंजेक्शन के 94,5 % को रोकता है, लेकिन हमलावर फिर भी 84,2 % कार्यों में सफल होता है। डेटासेट (नियंत्रित पहुँच के साथ), MIT लाइसेंस के तहत एक SDK और सार्वजनिक रैंकिंग उपलब्ध हैं; लेख में डिटेक्टरों के किसी वेट्स का लिंक नहीं दिया गया है।
🔗 BrowseSafe++ पर Perplexity का लेख
जनरेटिव मीडिया: Runway Dev अब Claude Code और Cursor में, Synthesia अब ChatGPT और Claude में, ElevenLabs ने आवाज़ के लाभ का आँकड़ा दिया
Runway Dev अब Claude Code और Cursor में उपलब्ध
2 नवंबर — 28 अक्टूबर को Codex के लिए पेश किए जाने के बाद, Runway ने अपने Runway Dev प्लगइन Claude Code और Cursor तक विस्तारित किए हैं। इन्हें इंस्टॉल करने से कोडिंग एजेंट Runway के MCP सर्वर के माध्यम से Runway Dev खाते से जुड़ता है और उसमें Runway के skills जुड़ते हैं, ताकि वह उसके जनरेटिव मीडिया API के साथ विकास कर सके। एजेंट पहले खाते की जानकारी पढ़ता है (प्रोजेक्ट, उपलब्ध मॉडल और उनकी कीमतें व सीमाएँ, क्रेडिट शेष), फिर आधिकारिक SDK का इस्तेमाल करता है: वह हर अनुरोध के लिए उपयुक्त मॉडल चुनने वाला Model Router या रीयल-टाइम अवतारों के लिए Character बना सकता है, और Recipes (इस्तेमाल के लिए तैयार पाइपलाइन) या API एंडपॉइंट के रूप में प्रकाशित Workflows का दोबारा उपयोग कर सकता है। विफलता की स्थिति में वह त्रुटि का विवरण देखता है। खाते से कनेक्शन पहले इस्तेमाल पर होता है, प्लगइन में कोई API कुंजी संग्रहीत नहीं की जाती, और कोई अलग शुल्क नहीं बताया गया है।
| कोडिंग एजेंट | Runway द्वारा बताई गई इंस्टॉलेशन विधि |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | Agent चैट में /add-plugin runway-api, या Cursor Marketplace |
Synthesia अब ChatGPT और Claude में अपने वीडियो बनाता है
2 नवंबर — Synthesia ने घोषणा की है कि उसके अवतार वीडियो अब सीधे ChatGPT और Claude में बनाए जा सकते हैं: उपयोगकर्ता मनचाहे वीडियो का वर्णन करता है, उसे बातचीत में दिखाई देता है, अनुरोध करके उसमें सुधार करवाता है, फिर उसे प्रकाशित और साझा करता है। इसके लिए कोई दूसरा एप्लिकेशन या टैब खोलने की ज़रूरत नहीं होती। घोषणा एक ट्वीट तक सीमित है, जिसके साथ प्रदर्शन का एक वीडियो है; हमारी जाँच के समय Synthesia के ब्लॉग या मुखपृष्ठ पर कोई लेख नहीं दिखा। इसमें Synthesia ने न एकीकरण का तरीका स्पष्ट किया है, न शामिल योजनाएँ और न ही कीमत।
ElevenLabs : दो मिनट से लंबी बातचीत में आवाज़ चैट के मुकाबले 32 % अधिक बार सफल होती है
2 नवंबर — ElevenLabs ने एक अध्ययन प्रकाशित किया है, जिसमें प्रोडक्शन में चल रहे ElevenAgents एजेंटों पर आवाज़ (फ़ोन और WhatsApp) और चैट की तुलना की गई है। हर एजेंट की तुलना उसी एजेंट से, मई से जुलाई 2026 तक की उसकी बातचीत के आधार पर की गई है। घोषणा वाले ट्वीट में 469 एजेंटों का उल्लेख है; वहीं लेख में « सैकड़ों » एजेंटों की बात कही गई है।
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇮🇳 बातचीत जितनी लंबी होती है, आवाज़ से काम करने वाले एजेंटों की सफलता दर उतनी ही अधिक होती है। हमने प्रोडक्शन में आवाज़ और चैट, दोनों माध्यमों से काम कर रहे 469 एजेंटों का विश्लेषण किया और एक दिलचस्प रुझान देखा। जब बातचीत जटिल हो जाती है, तो आवाज़ समाधान तक पहुँचने का सबसे तेज़ रास्ता होती है। — X पर @ElevenLabs
| ElevenLabs के अनुसार सूचक | मापा गया मान |
|---|---|
| दो मिनट से लंबी बातचीत में आवाज़ की सफलता | +10,9 अंक, यानी +31,7 % |
| एक मिनट से कम की बातचीत | चैट लगभग 9 अंक आगे |
| लंबी सफल बातचीत की अवधि | आवाज़ में 4,6 मिनट, चैट में 7 मिनट |
| अधिक तेज़ LLM पर जाना (315 बातचीत) | लेटेंसी में 16 % की कमी, सफलता में 26 % की वृद्धि |
| आवाज़ को प्राथमिकता (98 प्रतिभागी, रद्द उड़ान) | 85 % |
यहाँ अवधि को जटिलता के संकेतक के रूप में इस्तेमाल किया गया है, जिसकी सीमाएँ लेख भी स्वीकार करता है। यह अध्ययन उसी कंपनी का है, जो इसमें अपने आवाज़ से काम करने वाले एजेंटों का प्रचार करती है।
NVIDIA ने ड्राइविंग, रोबोटिक्स और सर्जरी के लिए Cosmos 3 Nano सिमुलेशन की विधियाँ जारी कीं
2 नवंबर — NVIDIA ने अपने तकनीकी ब्लॉग पर भौतिक एआई के लिए बनाए गए विश्व आधारभूत मॉडलों (world foundation models) के अपने प्लेटफ़ॉर्म Cosmos के लिए दो भागों वाला मार्गदर्शक प्रकाशित किया है। इसमें पहले नए Cosmos 3 Nano चेकपॉइंट पर आधारित सिमुलेशन की विधियाँ दी गई हैं, जिनकी घोषणा 22 अक्टूबर को हुई थी और जिनके नाम और विवरण इस बार दिए गए हैं; फिर NIM माइक्रोसर्विस इस्तेमाल करने के निर्देश हैं। प्रमुख उदाहरण: केवल प्रॉम्प्ट बदलकर दिन के सफ़र को बारिश वाली रात में बदला जा सकता है, सड़क के नक्शे या वाहनों के रास्तों को छुए बिना।
| Cosmos 3 चेकपॉइंट | NVIDIA द्वारा बताया गया उपयोग |
|---|---|
| Cosmos3-Nano-Transfer-Auto | ड्राइविंग के लिए LiDAR सहित कई कैमरों के क्लिप, 480p या 720p में 400 फ़्रेम तक |
| Cosmos3-Nano-Sim-Auto | डिस्टिल किया गया कारणात्मक संस्करण, जो बंद लूप में ड्राइविंग नीति का परीक्षण करने के लिए स्ट्रीम के रूप में आउटपुट बनाता है |
| Cosmos3-Nano-Sim-Transfer | रोबोटिक्स के लिए गहराई दर्शाने वाले वीडियो को विस्तृत RGB वीडियो में बदलना |
| Cosmos3-Nano-Sim-Bimanual | दृश्य और उसकी क्रियाओं के आधार पर दो भुजाओं वाले रोबोट का अगला अवलोकन |
| Cosmos3-H-Embodied-Nano और Cosmos3-H-Dreams | रोबोट की क्रियाओं के आधार पर सर्जरी का सिमुलेशन, H-Dreams के लिए वास्तविक समय में |
डिप्लॉयमेंट के लिहाज़ से, NIM इमेज cosmos3:2.0.0 लेटेंसी या थ्रूपुट के लिए प्रोफ़ाइल देती है। NVIDIA के अनुसार, स्पेक्युलेटिव डिकोडिंग H200 पर इन्फ़रेंस को औसतन लगभग 2 से 3 गुना तेज़ करती है। कंपनी ने 20 से अधिक GPU पर प्रमाणित Cosmos NIM की भी घोषणा की है। जनरेशन के लिए Cosmos3-Nano को BF16 में 58 Gio VRAM और ऑफ़लोडिंग के साथ FP8 में 31 Gio चाहिए। Cosmos Framework में रीइन्फ़ोर्समेंट लर्निंग की पाइपलाइन (DPO, GRPO, PPO, OPD, DiffusionNFT) जुड़ी हैं, और गुरुवार, 5 नवंबर को इस पर एक सीधा प्रसारण होगा।
Copilot CLI 1.0.106-3, प्रीव्यू में : वैकल्पिक सत्र प्रबंधन और 145 सुधार
2 नवंबर — GitHub ने Copilot CLI का प्रीव्यू 1.0.106-3 जारी किया है, जो 1.0.106 शाखा का तीसरा प्रीव्यू है। रिलीज़ विवरण में केवल एक नई सुविधा है: अपनी इच्छा से सक्रिय किए जाने वाले (opt-in) सत्र प्रबंधन टूल और इसमें शामिल स्थानीय सत्रों का @ के ज़रिए उल्लेख करने की सुविधा। इसके अलावा कोई विवरण नहीं दिया गया है। प्रबंधित खातों के लिए, नीति रीफ़्रेश करने की चेतावनियों में अब Policy Helper के निष्कर्ष शामिल होते हैं।
बाकी 145 सुधार मुख्य रूप से टर्मिनल इंटरफ़ेस की मज़बूती से जुड़े हैं, और कई सुरक्षा को प्रभावित करते हैं:
| सुरक्षा सुधार | 1.0.106-3 से पहले का व्यवहार |
|---|---|
| एस्केप अनुक्रम फ़िल्टर किए गए | कोई उत्तर, फ़ाइल का नाम या MCP टूल का शीर्षक टाइमलाइन का रूप बदल सकता था या उसकी पंक्तियाँ छिपा सकता था |
/allow-all off | इसके बाद आइडियोग्राफ़िक स्पेस (CJK इनपुट) आने पर कमांड Allow All को बंद करने के बजाय चालू कर देती थी |
/session delete | पहचानकर्ता से पहले दिया गया कोई अज्ञात विकल्प बिना पुष्टि माँगे वर्तमान सत्र मिटा देता था |
copilot -p और copilot workflow run | टेक्स्ट आउटपुट में --secret-env-vars के मान दिखते थे, जबकि JSON आउटपुट इन्हें पहले से छिपाता था |
नवीनतम स्थिर संस्करण अब भी 28 अक्टूबर का 1.0.105 है। उसी शाम प्रकाशित Copilot SDK 1.0.29-preview.2 में SDK से जुड़ा कोई बदलाव नहीं है।
🔗 Copilot CLI 1.0.106-3 का रिलीज़ विवरण
संक्षिप्त समाचार
एजेंट और कोडिंग टूल
- Qwen Code v0.26.6 — v0.26.5 के अगले दिन, 2 नवंबर को जारी स्थिर संस्करण: Web Shell में सत्रों की गतिविधि देखने की सुविधा जुड़ी है और अब हर मॉडल के लिए सफलता दर, आउटपुट की गति और पहले टोकन की लेटेंसी दिखाई जाती है; Kimi K3 मॉडलों को 10 लाख टोकन की विंडो मिलती है। 🔗 स्रोत
- Gemini CLI — 2 नवंबर की शाम मर्ज किया गया एक सुधार Whisper मॉडल के अधूरे डाउनलोड को स्थापित मॉडल माने जाने से रोकता है। इस समस्या के कारण फ़ाइल को हाथ से मिटाए जाने तक स्थानीय आवाज़ मोड बंद रहता था। यह सुधार अभी किसी रिलीज़ में शामिल नहीं है, और उस दिन के नाइटली बिल्ड में भी पिछली दो नाइटली के समान कमिट है। 🔗 स्रोत
- CLI mistral 0.16.0 —
mistral workflows initऔरmistral initअब Workflow प्रोजेक्ट की API कुंजी माँगते हैं, Mistral API से उसे सत्यापित करते हैं और प्रोजेक्ट के.envमें सहेजते हैं। 🔗 स्रोत - Codex के लिए Qodo प्लगइन — OpenAI द्वारा प्रकाशित एक अध्ययन में Qodo ने Codex के मार्केटप्लेस पर उपलब्ध अपना प्लगइन प्रस्तुत किया है: लिखना शुरू करने से पहले Codex को संगठन के नियम और पुल रिक्वेस्ट का इतिहास मिलता है, फिर पुल रिक्वेस्ट खोलने से पहले उसी सत्र में Qodo की समीक्षा मिलती है। परिणामों का कोई आँकड़ा नहीं दिया गया है। 🔗 स्रोत
- corgi, जिसे Zed ने साझा किया — 1 नवंबर की शाम Zed ने कॉनराड इरविन के Cargo-संगत Rust बिल्ड टूल corgi की वेबसाइट साझा की: हर मशीन पर एक ही कैश, सैंडबॉक्स में build.rs और मैक्रो, तथा परीक्षणों के परिणाम कैश में। इसके लेखक के अनुसार, लगभग पूरा कोड एआई ने लिखा है। रिपॉज़िटरी MIT लाइसेंस के अंतर्गत है। 🔗 स्रोत
डेवलपमेंट प्लेटफ़ॉर्म और API
- GitHub Actions में pull_request_target — सार्वजनिक रिपॉज़िटरी में
pull_request_targetको डिफ़ॉल्ट रूप से रोकने की तारीख 2 नवंबर से बढ़ाकर 2 दिसंबर कर दी गई है; 9 और 16 नवंबर को 16 से 18 बजे UTC तक दो नियोजित व्यवधानों से प्रभावित वर्कफ़्लो सामने आएँगे। 🔗 स्रोत - GitHub के जोखिम आकलन — GitHub Enterprise Cloud और GitHub Team पर कोड तथा सीक्रेट की सुरक्षा के जोखिम आकलन अब बताते हैं कि हर निष्कर्ष किसी सुरक्षित रिपॉज़िटरी में है या असुरक्षित रिपॉज़िटरी में। 🔗 स्रोत
- Perplexity की Analytics API — Computer के क्रेडिट उपयोग संबंधी उत्तरों में फ़िलहाल क्रेडिट के स्रोत (Credit Source) के अनुसार ब्योरा नहीं दिया जा रहा है; कुल उपयोग और मॉडल के अनुसार ब्योरा अब भी मिलता है। Perplexity ने कहा है कि ब्योरा न होने को शून्य उपयोग न समझें। 🔗 स्रोत
मुक्त मॉडल और समुदाय के लेख
- Dragonscale का kniv v7 — 55M से 538M पैरामीटर वाले छह मुक्त एनकोडर (Apache-2.0, ONNX), जो एजेंटों की मेमोरी के लिए कॉल के समय बताए गए स्कीमा के अनुसार इकाइयाँ, संबंध और तथ्य निकालते हैं, बिना LLM के; Re-DocRED पर एक ही वाक्य में 0,749 और दो वाक्यों के अंतर पर 0,732 (DeBERTa संस्करण)। 🔗 स्रोत
- स्लाइडिंग विंडो और Bifocal परत — समुदाय के एक लेख में लुकास ने Qwen3-4B-Instruct को समान मेमोरी वाले चार छात्र मॉडलों में डिस्टिल किया है: छोटे उत्तरों के लिए स्लाइडिंग विंडो पर्याप्त है, लेकिन AIME और HMMT पर उनकी Bifocal परत (छोटी विंडो और mLSTM स्थिति) अकेली विंडो से लगभग दोगुनी समस्याएँ हल करती है, जबकि अकेली विंडो लगभग 14 % पर अटकी रहती है। ये लेखक के माप हैं। 🔗 स्रोत
- ViKernel ने बैकडोर रोका — VIDRAFT ने फ़ाइन-ट्यूनिंग के ज़रिए Qwen3-0.6B में एक बैकडोर डाला: फ़ाइल पथ में « payroll » शब्द पहले न देखे गए पथों पर 98,3 % मामलों में दुर्भावनापूर्ण कमांड चलवा देता है, और 24 जाँचें भी इसे नहीं पकड़ पातीं; ViKernel पर सभी 290 पेलोड निष्पादन से पहले अस्वीकार कर दिए जाते हैं। मॉडल वेट प्रकाशित नहीं किए गए हैं। 🔗 स्रोत
- Beam की रूटिंग और परीक्षणों में धोखाधड़ी — राइरो मुकामुरी का एक पूर्व-पंजीकृत अध्ययन Beam-1.0-501B-A23B के विशेषज्ञों की रूटिंग के आधार पर 500 टोकन पहले परीक्षण में हेराफेरी का अनुमान नहीं लगा पाता: AUROC 0,580 रहा, जबकि निर्धारित सीमा 0,75 थी; गणना की लागत 9,03 डॉलर थी। 🔗 स्रोत
- Saturate — डैनियल वैन स्ट्रियन ने Hugging Face Jobs के एक ही GPU पर अभिलेखों के 14 483 पृष्ठों को दोबारा OCR से संसाधित किया, 1,47 डॉलर की लागत और 8,9 पृष्ठ प्रति सेकंड की गति से। इसके लिए उन्होंने Saturate का उपयोग किया, जो किसी भी OpenAI-संगत एंडपॉइंट पर बैच इन्फ़रेंस के लिए उनकी Apache-2.0 लाइब्रेरी है। 🔗 स्रोत
छवि, वीडियो, आवाज़ और संगीत
- एक RTX PRO 6000 पर LTX 2.5 — GPU किराए पर देने वाला EcoHash, 96 Go के एक ही कार्ड पर ध्वनि सहित 10 सेकंड का 1080p वीडियो 90 सेकंड में और 480p में 14,8 सेकंड में रेंडर करता है; ये प्रदाता के अपने सेवा संबंधी माप हैं। 🔗 स्रोत
- KPN का Mobiel AI — ElevenLabs ने नीदरलैंड के छोटे कारोबारों के लिए KPN के कॉल सहायक का विवरण दिया है (वॉइसमेल का लिखित रूप, कॉल के सारांश, कॉल मेनू); डच भाषा पर फ़ाइन-ट्यूनिंग से सत्यापन की सटीकता लगभग 50 % से बढ़कर 90 % हो गई। कोई कीमत नहीं बताई गई है। 🔗 स्रोत
- Suno Studio — 29 अक्टूबर की खबर, जिसे 2 नवंबर को साझा किया गया: क्लिप की सेटिंग अब साइडबार में हैं, सुर की ऊँचाई सेमीटोन और सेंट में समायोजित की जा सकती है, आयातित ऑडियो को प्रोजेक्ट की लय के अनुरूप खींचा जा सकता है और Shift-H से ट्रैक छिपाए जा सकते हैं। 🔗 स्रोत
- Kling और Chroma Awards — Kling प्रतियोगिता के दूसरे सीज़न का भागीदार बना है, जिसमें 450 000 डॉलर से अधिक के पुरस्कार हैं; प्रविष्टियाँ 7 जनवरी तक भेजी जा सकती हैं। 🔗 स्रोत
कार्यक्रम, प्रदर्शन और प्रयोगशालाओं के लेख
- Anthropic Residency — Anthropic ने छह सप्ताह से छह महीने के सवेतन शोध कार्यक्रम के लिए 22 नवंबर तक आवेदन खोले हैं। यह प्रोफ़ेसरों, तकनीकी संस्थापकों और स्टाफ़ स्तर के इंजीनियरों के लिए है, और मशीन लर्निंग का पूर्व ज्ञान आवश्यक नहीं है; पारिश्रमिक 350 000 से 500 000 डॉलर वार्षिक के बराबर है। 🔗 स्रोत
- SpaceXSI का Data Bot — आंतरिक अध्ययन: Grok Bot का एक Team Bot, जो डेटा टीम द्वारा बनाए रखे गए कौशलों के आधार पर पूरी कंपनी के लिए डेटा वैज्ञानिक का काम करता है। SpaceXSI के अनुमान के अनुसार, इसने एक सप्ताह में लगभग 70 घंटे का काम सँभाला। 🔗 स्रोत
- Le Chonk और क्वांटम रसायन विज्ञान — Mistral ने X पर दिखाया है कि Mistral Large 4 शुरू से एक SCF सॉल्वर और टूटते हुए अणु का 3D दृश्य लिखता है। कोई कोड या आँकड़ा प्रकाशित नहीं किया गया है। 🔗 स्रोत
- Google का अक्टूबर का पुनरावलोकन — Project Suncatcher के उपग्रह से मिले उत्तर के अलावा कोई नई घोषणा नहीं है; उस उत्तर का उल्लेख ऊपर किया गया है। 🔗 स्रोत
- Perplexity में एजेंटों की मेमोरी — मेमोरी के प्रकारों और स्थायी मेमोरी वाला एजेंट बनाने पर एक मार्गदर्शक, जो Computer में पहले से उपलब्ध Brain का संदर्भ देता है। 🔗 स्रोत
- The Knowledge Talk — Perplexity ने Cambridge Union Society में 3 अक्टूबर को दिए गए अरविंद श्रीनिवास के भाषण का लिखित रूप प्रकाशित किया है, जिसमें कोई घोषणा नहीं है। 🔗 स्रोत
इसका क्या अर्थ है
मैसेज थ्रेड बातचीत की स्थिति का एक हिस्सा सर्वर पर पहुँचा देते हैं, जबकि बिल में कोई बदलाव नहीं आता: टोकन और दरें वही रहती हैं, केवल प्रतीक्षा का समय घटता है। इसका असर उन एजेंट सत्रों पर सबसे स्पष्ट होता है, जिनमें कई लाख टोकन जमा हो जाते हैं। अस्थायी थ्रेड का विकल्प, जिसे 5 मिनट तक एन्क्रिप्टेड मेमोरी में रखा जाता है और जिसे दोबारा पढ़ने के लिए कोई API नहीं है, एप्लिकेशन को अपने इतिहास पर नियंत्रण देता है, लेकिन कुछ स्पष्ट अपवादों के साथ: ZDR, Batches और HIPAA संगठन इसमें शामिल नहीं हैं। टर्मिनल के मामले में Copilot CLI का प्रीव्यू याद दिलाता है कि इंटरफ़ेस स्वयं भी हमले का रास्ता हो सकता है, क्योंकि फ़ाइल का नाम या मॉडल का उत्तर स्क्रीन का रूप बदल सकता था।
Grid Protectors और Suncatcher एक ही बाधा, गणना के लिए ऊर्जा, का समाधान दो बहुत अलग समयसीमाओं पर तलाशते हैं। OpenAI पहले से दबाव में चल रहे बिजली ग्रिड में जगह पाने के लिए ज़रूरत पड़ने पर अपने परिसरों की बिजली खपत घटाने की पेशकश करता है और अपनी लागत खुद चुकाने का वादा करता है; घरों के लिए बचत का एकमात्र संख्यात्मक अनुमान Georgia Power से आता है और उसके सभी बड़े ग्राहकों को मिलाकर लागू होता है। Google अभी कक्षा में मौजूद एक TPU से हाइकु लिखवा रहा है: 2027 में दो उपग्रहों को जोड़ने से पहले व्यवहार्यता का एक पड़ाव, जिसके साथ प्रदर्शन का कोई आँकड़ा नहीं दिया गया है।
LifeVal, Design Creativity Bench और BrowseSafe++ उन चीज़ों को मापते हैं, जिन्हें कोड और गणित की रैंकिंग नहीं देखतीं। LifeVal धीमी पड़ती प्रगति दिखाता है, GPT-5.6 और GPT-6 Astra के बीच 0,6 अंक, लेकिन यह अब भी कंपनी का अपना बेंचमार्क है, जिसमें न कोई प्रतिस्पर्धी मॉडल है और न कार्यों का सेट प्रकाशित किया गया है। Kombai इंटरफ़ेसों के एक जैसे होते जाने की ओर इशारा करता है, जिसे सफलता दर छिपा देती है। BrowseSafe++ पहचान और प्रतिरोध को अलग करता है: कोई मॉडल इंजेक्शन पहचानकर भी उसका पालन कर सकता है, और API कॉल से सौ गुने से भी अधिक सस्ता 0,8B का डिटेक्टर बार-बार कोशिश करने वाले हमलावर के सामने पर्याप्त नहीं है।
Sakana AI ने Sawara के साथ प्रीट्रेनिंग से उत्पादों तक पूरी शृंखला अपने नियंत्रण में रखने का विकल्प चुना है, लेकिन समयसीमा शर्तों पर निर्भर है और आकार की घोषणा नहीं की गई है। Runway और Synthesia इसका उलटा कर रहे हैं: उपयोगकर्ताओं को अपने एप्लिकेशन की ओर लाने के बजाय वे वहीं पहुँच रहे हैं जहाँ उपयोगकर्ता पहले से काम करते हैं, कोडिंग एजेंट में या ChatGPT और Claude की बातचीत में। ElevenLabs लंबी बातचीत में आवाज़ के पक्ष में संख्यात्मक तर्क देता है, लेकिन यह कंपनी का अपना अध्ययन है, जिसके आधार में शामिल एजेंटों की संख्या ट्वीट और लेख में अलग है। वहीं NVIDIA, Cosmos 3 Nano के साथ ड्राइविंग, रोबोटिक्स या सर्जरी का सिमुलेशन करने वालों को टूल दे रहा है।
स्रोत
- संदेश थ्रेड पर Anthropic का लेख
- @ClaudeDevs : Claude Code में संदेश थ्रेड
- संदेश थ्रेड का दस्तावेज़ीकरण
- Sakana AI की 2026 की संगोष्ठी का विवरण
- @SakanaAILabs : संगोष्ठी का विवरण
- Grid Protectors Program का परिचय (OpenAI)
- Project Suncatcher के प्रोटोटाइप उपग्रह की पहली प्रतिक्रिया (Google)
- LifeVal (OpenAI)
- हमने Design Creativity Bench क्यों बनाया (Kombai)
- BrowseSafe++ (Perplexity)
- कोडिंग एजेंटों के लिए Runway Dev प्लगइन
- @synthesiaIO : ChatGPT और Claude में Synthesia वीडियो
- जटिल और तनावपूर्ण बातचीत में आवाज़ अधिक प्रभावी क्यों होती है (ElevenLabs)
- @ElevenLabs : आवाज़ और चैट की तुलना पर अध्ययन
- NVIDIA Cosmos के साथ इंटरैक्टिव सिमुलेशन के लिए वर्ल्ड मॉडल बनाएँ
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- Gemini CLI का PR 30058
- mistral CLI 0.16.0
- Qodo और Codex का केस अध्ययन (OpenAI)
- @zeddotdev : corgi
- 2 दिसंबर से pull_request_target डिफ़ॉल्ट रूप से अवरुद्ध (GitHub)
- जोखिम आकलनों में रिपॉज़िटरी की सुरक्षा स्थिति शामिल है (GitHub)
- Perplexity API का परिवर्तन विवरण
- kniv v7 पर Dragonscale की पोस्ट
- स्लाइडिंग विंडो और Bifocal पर पोस्ट
- बैकडोर पर VIDRAFT की पोस्ट
- Beam पर रायरो मुकामुरी की पोस्ट
- @vanstriendaniel : Saturate
- LTX 2.5 पर EcoHash की पोस्ट
- KPN का Mobiel AI (ElevenLabs)
- Suno Studio की रिलीज़ संबंधी टिप्पणियाँ
- @Kling_ai : Chroma Awards का सीज़न 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI : Le Chonk और SCF सॉल्वर
- अक्टूबर 2026 में Google की एआई संबंधी घोषणाएँ
- एआई एजेंट की स्मृति (Perplexity)
- ज्ञान पर बातचीत (Perplexity)