ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
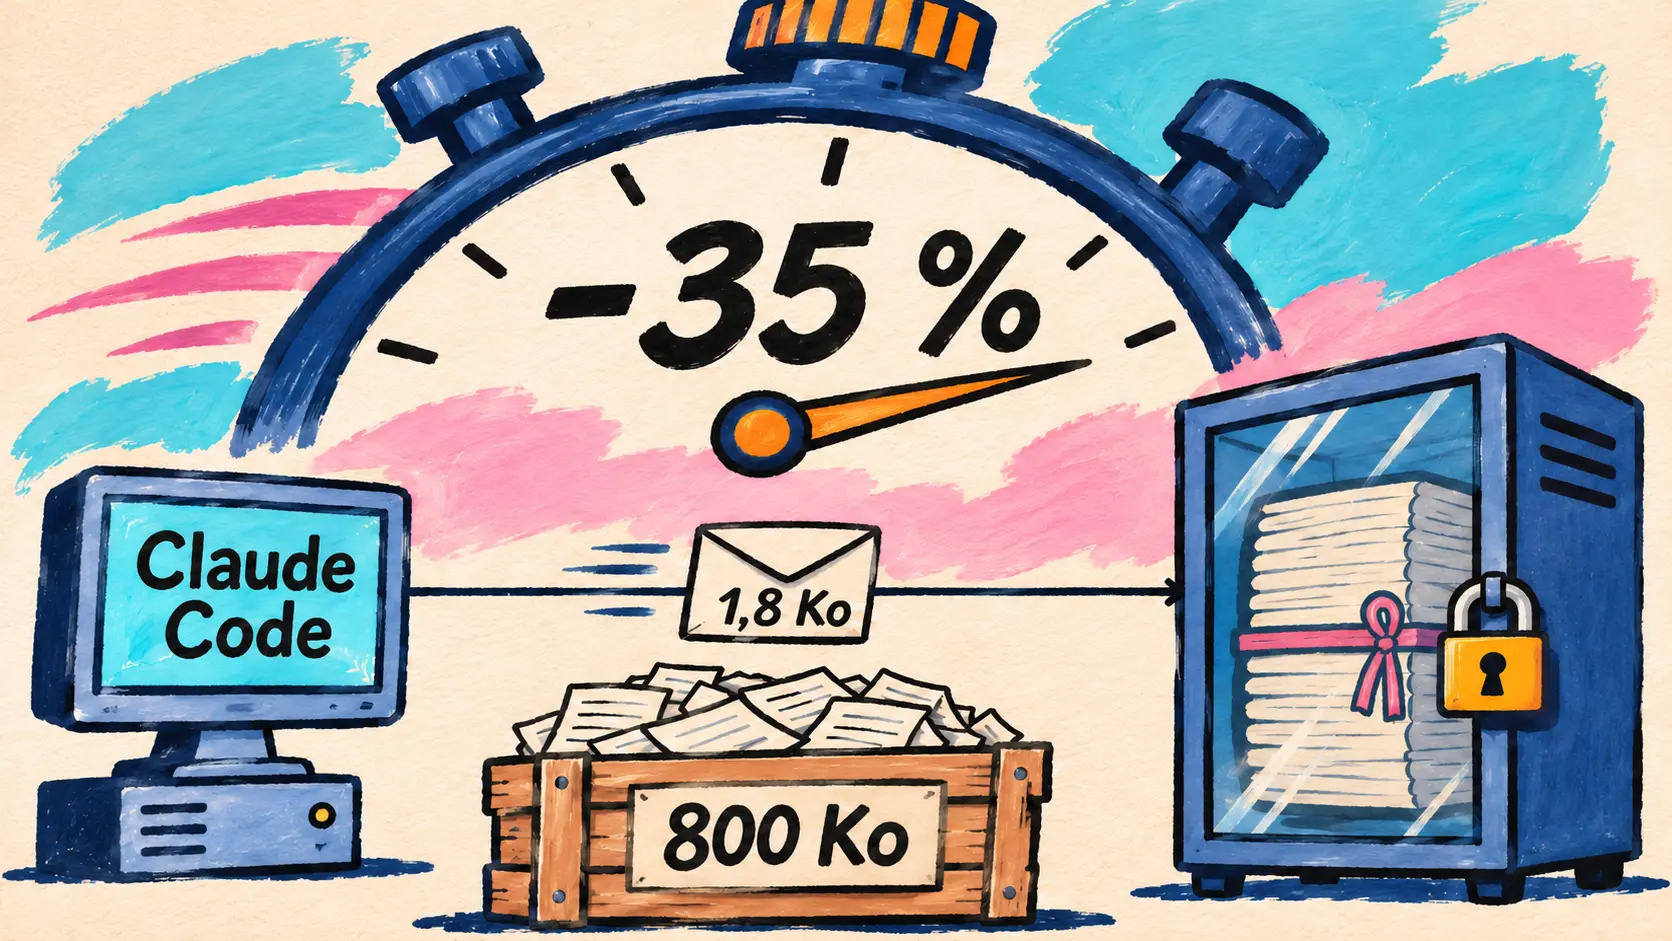
Anthropic rende disponibili in beta pubblica i message threads dell’API Messages, già attivi in Claude Code, dove riducono di circa il 35 % il tempo prima del primo token nelle richieste più lunghe. Sakana AI annuncia Sawara, i suoi primi modelli preaddestrati da zero, mentre OpenAI lancia Grid Protectors per rendere i suoi campus di calcolo capaci di ridurre il carico sulla rete elettrica e pubblica LifeVal, un benchmark di attività della vita quotidiana. Perplexity pubblica BrowseSafe++ contro la prompt injection, NVIDIA fornisce strumenti per la simulazione con Cosmos 3 Nano, e Runway, Synthesia ed ElevenLabs portano i media generativi negli assistenti e negli agenti.
L’API Messages lancia i message threads in beta pubblica, già attivi in Claude Code
2 novembre — Anthropic rende disponibili in beta pubblica i thread di messaggi (message threads) sull’API Messages. Finora, a ogni turno un agente rinviava l’intera conversazione, compresi i risultati degli strumenti. Con un thread, la prima richiesta invia la conversazione completa, con il prompt di sistema e gli strumenti; le successive inviano soltanto i nuovi messaggi e l’identificativo della risposta precedente, e l’API ricostruisce il resto prima di chiamare il modello. Basta aggiungere il parametro thread e l’header beta message-threads-2026-08-12, che gli SDK ufficiali gestiscono con una funzione di supporto dedicata.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇮🇹 Abbiamo recentemente integrato i message threads in Claude Code. Per le richieste da 500 000 a 1 milione di token, il tempo mediano prima del primo token è inferiore di circa il 35 %. Nelle conversazioni lunghe, la richiesta mediana è passata da circa 800 Ko a 1,8 Ko. — @ClaudeDevs su X
Il vantaggio riguarda la latenza, non la fattura: Claude rilegge l’intera conversazione a ogni turno, quindi token, tariffe e limiti di frequenza non cambiano, e la memorizzazione nella cache dei prompt (prompt caching) va sempre richiesta esplicitamente. Il thread viene conservato secondo il principio del massimo sforzo (best-effort), in memoria cifrata e mai su disco: scade 5 minuti dopo l’ultima richiesta, e l’applicazione mantiene una propria copia per rinviare tutto se l’API risponde con un errore 404. La funzione non è idonea alla conservazione zero dei dati (ZDR) e non funziona con Message Batches, con la compattazione su richiesta o nelle organizzazioni HIPAA. È disponibile sull’API Claude, su Claude Platform on AWS, Claude in Microsoft Foundry e Claude Models on Google Cloud (Anthropic managed).
🔗 L’articolo di Anthropic sui message threads · La documentazione dei message threads
Sakana AI annuncia Sawara, i suoi primi modelli preaddestrati da zero, con i pesi previsti per la primavera 2027
2 novembre — Sakana AI pubblica il resoconto del suo simposio del 26 ottobre a Tokyo (oltre 400 partecipanti, conferenza di Jürgen Schmidhuber), che contiene un vero annuncio: la start-up giapponese preaddestrerà i propri modelli linguistici. Finora lavorava sugli agenti e sul post-addestramento di modelli aperti esistenti con Namazu. Presentata dal suo direttore scientifico (Chief Scientist), Takuya Akiba, la serie Sawara (nome provvisorio) è costruita da zero, senza partire da un modello di terzi, e pensata per gli usi degli agenti (agent-native): ragionamento con strumenti, codice e attività lunghe. Dovrà fungere da base per i prodotti di Sakana AI e per le ricerche dell’RSI Lab sull’auto-miglioramento ricorsivo.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇮🇹 Stiamo ora preparando l’addestramento e inizieremo il preaddestramento di Sawara Small (nome provvisorio) a dicembre. Se tutto andrà bene, pubblicheremo i pesi la prossima primavera. — Sakana AI, resoconto del simposio 2026
Dovrebbe seguire un Sawara Large, anch’esso con un nome provvisorio, senza una data. Sakana AI non indica né le dimensioni del modello, né il volume dei dati, né il budget di calcolo.
🔗 L’annuncio di Sakana AI su X
L’energia del calcolo: OpenAI lancia Grid Protectors, una TPU di Google risponde dall’orbita
OpenAI lancia Grid Protectors, fino a 1 000 MW di riduzione del carico elettrico per il suo campus di Effingham
2 novembre — OpenAI lancia Grid Protectors, un programma nazionale affinché i suoi futuri campus di calcolo riducano i consumi quando la rete elettrica è sotto pressione, durante un’ondata di freddo o di caldo. Insieme ai fornitori di elettricità, alle autorità di regolazione e ai decisori pubblici, l’azienda vuole concludere accordi per ciascun sito, che stabiliranno il carico riducibile, il tempo di reazione e la durata. In base alle esigenze locali, i campus potranno anche ricorrere alla produzione o all’accumulo sul posto e rendere più uniforme la domanda con le batterie.
Il progetto pilota è il campus previsto nella contea di Effingham, in Georgia, presentato a luglio con il nome di Project Camellia. OpenAI si impegna a pagare integralmente i costi delle infrastrutture e del servizio elettrico.
| Dato annunciato | Valore annunciato | Fonte del dato |
|---|---|---|
| Riduzione flessibile del carico prevista nell’accordo con Georgia Power | fino a 1 000 MW | OpenAI |
| Equivalente in domanda media delle famiglie | circa 700 000 famiglie | OpenAI |
| Risparmi annuali per i clienti di Georgia Power dal 2029 | circa 950 milioni di dollari | Georgia Power |
| Risparmio per un cliente residenziale tipo che consuma 1 000 kWh | almeno 15 dollari al mese | Georgia Power |
La proiezione di Georgia Power riguarda l’insieme dei suoi accordi con i grandi consumatori e la crescita prevista, incluso Project Camellia: non è un dato specifico del programma di OpenAI. L’azienda riconosce che la flessibilità non sostituisce gli investimenti in nuove capacità di produzione e trasmissione, e non annuncia altri siti né un calendario.
🔗 Il post di OpenAI su Grid Protectors
Project Suncatcher: una TPU in orbita restituisce la sua prima risposta, un haiku scritto da Gemma 4
30 ottobre — Recupero: un mese dopo il lancio del suo satellite prototipo, il 1° ottobre, Project Suncatcher, il progetto di ricerca di Google sul calcolo per l’IA nello spazio, raggiunge il traguardo «Hello World»: la prima risposta di IA prodotta da una TPU di classe data center in orbita. Durante un passaggio sopra una stazione a terra, il team ha chiesto al modello aperto Gemma 4, installato a bordo, un haiku sulla vita nello spazio; la risposta è arrivata a terra mentre il satellite sorvolava le Svalbard, in Norvegia. Sono seguiti limerick e prompt di telemetria, ai quali il modello risponde descrivendo lo stato tecnico del carico utile.
La fase successiva riguarda l’affidabilità: test delle TPU sotto stress termico e radiazioni, prima di una coppia di satelliti interconnessi nel 2027. Il post non fornisce dati sulle prestazioni o sui consumi.
🔗 Il post di Google sulla prima risposta del satellite
Vita quotidiana e creatività delle interfacce: OpenAI pubblica LifeVal, Kombai pubblica Design Creativity Bench
LifeVal: 169 attività della vita quotidiana, dal 49,3 % di GPT-5.2 all’80,6 % di GPT-6 Astra
2 novembre — OpenAI pubblica LifeVal, una valutazione dei modelli su attività della vita quotidiana: trovare qualcuno che si occupi dei bambini, accedere ai servizi pubblici, definire un budget, adattare una ricetta o costruire un programma di allenamento. Le attività si basano su due grandi indagini sull’uso del tempo, l’American Time Use Survey e la Multinational Time Use Study, integrate da un’indagine rappresentativa su 3 995 persone sugli ambiti in cui vorrebbero più aiuto. OpenAI afferma di usarlo da un anno per monitorare i propri modelli.
| Modello valutato | Data di uscita | Ricompensa media su 169 attività |
|---|---|---|
| GPT-5.2 | dicembre 2025 | 49,3 % |
| GPT-5.4 | marzo 2026 | 73,0 % |
| GPT-5.5 | aprile 2026 | 77,4 % |
| GPT-5.6 | luglio 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | settembre 2026 | 80,6 % |
Secondo la descrizione del grafico, si tratta di una media non ponderata delle 169 attività, e soltanto 0,6 punti separano GPT-5.6 da GPT-6 Astra. Il grafico non include né GPT-6.1 Sol o Terra, né modelli di altri produttori, e OpenAI non menziona la pubblicazione del set di attività.
🔗 Il post di OpenAI su LifeVal
Design Creativity Bench: i modelli convergono verso le stesse interfacce
2 novembre — Kombai, produttore di strumenti di IA per lo sviluppo front-end, presenta sul blog di Hugging Face Design Creativity Bench, un benchmark che non misura se un’interfaccia funziona, ma se assomiglia alle altre. Lo studio riguarda 15 modelli di punta, 160 istruzioni e 2 400 interfacce HTML, confrontate con mockup realizzati da persone.
| Misura del benchmark | Modelli valutati | Riferimento umano |
|---|---|---|
| Differenziazione media a parità di istruzione | 0,592 tra modelli | 0,764 tra persone e modelli |
| Ampiezza creativa media | 0,581 | 0,902 |
| Criteri di accettazione soddisfatti | oltre il 90 % per tutti (Claude Opus 5.5: 99,2 %) | 98,0 % |
I modelli rispettano quindi i requisiti, ma si assomigliano. GPT-6 Astra ha lo stile più distinto del gruppo (0,646 di originalità), pur variando poco da un contesto all’altro (0,472 di ampiezza). Kombai pubblica l’articolo (arXiv 2610.11539), una classifica e un sottoinsieme per la riproducibilità, e ne riconosce i limiti: soltanto schermate desktop e impostazioni predefinite delle API.
🔗 Il post di Kombai su Hugging Face
Perplexity pubblica BrowseSafe++ e i suoi rilevatori BrowseSafe-Guard contro la prompt injection
2 novembre — Il Perplexity Secure Intelligence Institute pubblica BrowseSafe++, successore di BrowseSafe (dicembre 2025), un benchmark aperto dedicato alla prompt injection indiretta (indirect prompt injection), che prende di mira gli agenti capaci di navigare sul Web. Riunisce 38 675 coppie di pagine, una pagina attaccata e la sua gemella pulita, di cui 32 187 costruite attorno a injection realmente osservate: il rilevatore di Comet ne ha segnalate 1,15 milioni tra settembre 2025 e settembre 2026. Ogni pagina è disponibile in HTML, in Markdown, come albero di accessibilità e come screenshot. Da questo Perplexity ricava BrowseSafe-Guard, due rilevatori da 0,8B ottenuti tramite fine-tuning di Qwen3.5-0.8B, uno per il testo, l’altro per gli screenshot.
| Risultato pubblicato | BrowseSafe-Guard | Modelli confrontati |
|---|---|---|
| F1 sulle viste testuali | circa il 95 %, primo in ogni vista | dall’85 al 92 % per i migliori modelli generalisti |
| F1 sugli screenshot | circa il 93 % | circa il 79 % per il migliore degli altri modelli |
| Pagine pulite segnalate per errore | circa 1 su 20 | 14,41 % per GPT-6 Astra |
| Costo per 1 000 pagine | 0,18 dollari su un H200 a noleggio | da 18,95 a 180,61 dollari tramite API |
Rilevare non significa resistere: ogni modello ha seguito injection che aveva individuato da sé, dall’1,64 % delle pagine per GPT-6 Astra al 24,73 % per Llama 3.1 8B. Anche un attaccante ostinato finisce per passare: nell’ambiente BrowseSafe-Adapt, che riscrive l’injection dopo ogni fallimento (1 024 attività, fino a 64 tentativi), il successo passa da un massimo del 4 % al primo tentativo ad almeno il 79 % contro cinque dei sette agenti testati. Posto a monte di un agente Gemini 3.5 Flash-Lite, Guard blocca il 94,5 % delle injection originali, ma l’attaccante riesce ancora nell’84,2 % delle attività. Sono disponibili il dataset (ad accesso controllato), un SDK con licenza MIT e una classifica pubblica; il post non rimanda ai pesi dei rilevatori.
🔗 Il post di Perplexity su BrowseSafe++
Media generativi: Runway Dev arriva in Claude Code e Cursor, Synthesia in ChatGPT e Claude, ElevenLabs quantifica il vantaggio della voce
Runway Dev arriva in Claude Code e Cursor
2 novembre — Dopo Codex, presentato il 28 ottobre, Runway estende i suoi plugin Runway Dev a Claude Code e Cursor. L’installazione collega l’agente di coding all’account Runway Dev tramite il server MCP di Runway e aggiunge le skills di Runway per sviluppare con la sua API di media generativi. L’agente legge prima l’account (progetti, modelli accessibili con prezzi e limiti, saldo dei crediti), poi si basa sugli SDK ufficiali: può creare un Model Router, che sceglie il modello adatto a ogni richiesta, oppure un Character per avatar in tempo reale, e riutilizzare le Recipes (pipeline pronte all’uso) o i Workflows pubblicati come endpoint API. In caso di errore, ne consulta i dettagli. La connessione all’account avviene al primo utilizzo, senza una chiave API memorizzata nel plugin, e non viene indicata alcuna tariffa specifica.
| Agente di coding | Installazione indicata da Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api nella chat Agent, oppure il Cursor Marketplace |
Synthesia crea i suoi video in ChatGPT e Claude
2 novembre — Synthesia annuncia che ora è possibile creare i suoi video con avatar direttamente in ChatGPT e Claude: l’utente descrive il video desiderato, lo vede apparire nella conversazione, lo perfeziona chiedendo modifiche, poi lo pubblica e lo condivide, senza aprire altre applicazioni o schede. L’annuncio consiste in un tweet accompagnato da un video dimostrativo; al momento della nostra rilevazione non era presente alcun post sul blog né sulla home page di Synthesia. Synthesia non vi precisa né il meccanismo di integrazione, né i piani interessati, né il prezzo.
🔗 L’annuncio di Synthesia su X
ElevenLabs: la voce ha successo il 32 % più spesso della chat oltre i due minuti
2 novembre — ElevenLabs pubblica uno studio che confronta la voce (telefono e WhatsApp) e la chat sugli agenti ElevenAgents in produzione, confrontando ciascun agente con sé stesso nelle sue conversazioni da maggio a luglio 2026. Il tweet di annuncio cita 469 agenti; il post, invece, parla di «centinaia» di agenti.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇮🇹 Più è lunga la conversazione, più è alto il tasso di successo degli agenti vocali. Abbiamo analizzato 469 agenti operativi sia in voce sia in chat in produzione e osservato una tendenza interessante. Quando la conversazione diventa complessa, la voce è il percorso più rapido verso la risoluzione. — @ElevenLabs su X
| Indicatore secondo ElevenLabs | Valore misurato |
|---|---|
| Successo della voce oltre i due minuti | +10,9 punti, pari a +31,7 % |
| Conversazioni di meno di un minuto | chat in vantaggio di circa 9 punti |
| Durata delle conversazioni lunghe riuscite | 4,6 minuti in voce, 7 minuti in chat |
| Passaggio a un LLM più veloce (315 conversazioni) | latenza in calo del 16 %, successo aumentato del 26 % |
| Preferenza per la voce (98 partecipanti, volo cancellato) | 85 % |
La durata funge qui da indicatore della complessità, che il post riconosce essere imperfetto, e lo studio proviene dal fornitore, che vi promuove i propri agenti vocali.
NVIDIA pubblica ricette di simulazione Cosmos 3 Nano per la guida, la robotica e la chirurgia
2 novembre — NVIDIA pubblica sul proprio blog tecnico una guida in due parti per Cosmos, la sua piattaforma di modelli fondativi del mondo (world foundation models) destinata all’IA fisica: ricette di simulazione basate su nuovi checkpoint Cosmos 3 Nano, annunciati il 22 ottobre e questa volta identificati per nome e descritti, poi istruzioni per l’uso dei microservizi NIM. L’esempio messo in evidenza: basta cambiare il prompt per trasformare un tragitto diurno in una notte piovosa, senza toccare il tracciato della strada né le traiettorie dei veicoli.
| Checkpoint Cosmos 3 | Utilizzo descritto da NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Clip multicamera con LiDAR per la guida, fino a 400 fotogrammi in 480p o 720p |
| Cosmos3-Nano-Sim-Auto | Variante causale distillata che genera in streaming per testare una policy di guida a ciclo chiuso |
| Cosmos3-Nano-Sim-Transfer | Video di profondità convertito in video RGB dettagliato, per la robotica |
| Cosmos3-Nano-Sim-Bimanual | Osservazione successiva di un robot a due bracci a partire dalla scena e dalle sue azioni |
| Cosmos3-H-Embodied-Nano e Cosmos3-H-Dreams | Simulazione chirurgica a partire dalle azioni del robot, in tempo reale per H-Dreams |
Sul fronte del deployment, l’immagine NIM cosmos3:2.0.0 offre profili per la latenza o il throughput, e la decodifica speculativa accelera l’inferenza in media di circa 2–3 volte su H200, secondo NVIDIA, che annuncia NIM Cosmos certificati su oltre 20 GPU. In generazione, Cosmos3-Nano richiede 58 Gio di VRAM in BF16 e 31 Gio in FP8 con offloading. Cosmos Framework acquisisce pipeline di reinforcement learning (DPO, GRPO, PPO, OPD, DiffusionNFT), e gli viene dedicata una diretta giovedì 5 novembre.
Copilot CLI 1.0.106-3, in anteprima: gestione opzionale delle sessioni e 145 correzioni
2 novembre — GitHub pubblica la versione di anteprima 1.0.106-3 di Copilot CLI, la terza del ramo 1.0.106. Le note elencano una sola aggiunta: strumenti di gestione delle sessioni attivabili su richiesta (opt-in) e la possibilità di menzionare con @ le sessioni locali per le quali è stata attivata l’opzione, senza ulteriori dettagli. Per gli account gestiti, gli avvisi di aggiornamento delle policy riportano ora i rilievi del Policy Helper.
Le 145 correzioni restanti riguardano soprattutto la robustezza dell’interfaccia nel terminale, e diverse hanno implicazioni per la sicurezza:
| Correzione di sicurezza | Comportamento prima della 1.0.106-3 |
|---|---|
| Sequenze di escape filtrate | Una risposta, un nome di file o un titolo di strumento MCP poteva cambiare lo stile della timeline o nasconderne alcune righe |
/allow-all off | Se seguito da uno spazio ideografico (input CJK), il comando attivava Allow All anziché disattivarlo |
/session delete | Un’opzione sconosciuta inserita prima dell’identificatore eliminava la sessione corrente senza chiedere conferma |
copilot -p e copilot workflow run | L’output di testo mostrava i valori di --secret-env-vars, che l’output JSON già nascondeva |
L’ultima versione stabile resta la 1.0.105 del 28 ottobre, e lo SDK Copilot 1.0.29-preview.2, pubblicato la stessa sera, non contiene alcuna modifica lato SDK.
🔗 Le note di rilascio di Copilot CLI 1.0.106-3
Notizie in breve
Agenti e strumenti di coding
- Qwen Code v0.26.6 — Versione stabile del 2 novembre, il giorno dopo la v0.26.5: il Web Shell acquisisce una vista dell’attività delle sessioni e mostra, modello per modello, tasso di successo, velocità di output e latenza del primo token; i modelli Kimi K3 ricevono la loro finestra da 1 milione di token. 🔗 fonte
- Gemini CLI — Una correzione integrata la sera del 2 novembre impedisce che un download interrotto del modello Whisper venga considerato un modello installato, cosa che bloccava la modalità vocale locale fino alla rimozione manuale del file. Non è ancora inclusa in alcuna versione, e la nightly del giorno riprende lo stesso commit delle due precedenti. 🔗 fonte
- CLI mistral 0.16.0 —
mistral workflows initemistral initora richiedono la chiave API di un progetto Workflow, la verificano tramite l’API Mistral e la salvano nel.envdel progetto. 🔗 fonte - Plugin Qodo per Codex — In un caso di studio pubblicato da OpenAI, Qodo presenta il proprio plugin del marketplace di Codex: Codex riceve le regole dell’organizzazione e la cronologia delle pull request prima di scrivere, poi la review di Qodo nella stessa sessione, prima dell’apertura della pull request. Nessun dato numerico sui risultati. 🔗 fonte
- corgi, rilanciato da Zed — La sera del 1° novembre, Zed rilancia il sito di corgi, lo strumento di build Rust compatibile con Cargo di Conrad Irwin: una sola cache per macchina, build.rs e macro in sandbox, test memorizzati nella cache. Secondo l’autore, il codice è scritto quasi interamente dall’IA. Repository con licenza MIT. 🔗 fonte
Piattaforme di sviluppo e API
- pull_request_target in GitHub Actions — Il blocco predefinito di
pull_request_targetnei repository pubblici è rinviato dal 2 novembre al 2 dicembre; due interruzioni programmate, il 9 e il 16 novembre dalle 16 alle 18 UTC, faranno emergere i workflow interessati. 🔗 fonte - Valutazioni dei rischi di GitHub — Le valutazioni dei rischi di sicurezza del codice e dei segreti indicano ora se ciascun rilievo si trova in un repository protetto o meno, su GitHub Enterprise Cloud e GitHub Team. 🔗 fonte
- Analytics API di Perplexity — Le risposte sull’utilizzo dei crediti di Computer omettono per ora la ripartizione per origine dei crediti (Credit Source); il totale e la ripartizione per modello continuano a essere forniti, e Perplexity chiede di non interpretare una ripartizione assente come un utilizzo nullo. 🔗 fonte
Modelli aperti e post della community
- kniv v7 di Dragonscale — Sei encoder aperti da 55M a 538M di parametri (Apache-2.0, ONNX) che estraggono entità, relazioni e fatti secondo uno schema descritto al momento della chiamata, senza LLM, per la memoria degli agenti; su Re-DocRED, 0,749 all’interno della stessa frase e 0,732 a due frasi di distanza (variante DeBERTa). 🔗 fonte
- Finestra scorrevole e layer Bifocal — In un post della community, Lukas distilla Qwen3-4B-Instruct in quattro modelli allievi a parità di memoria: la finestra scorrevole basta per le risposte brevi, ma su AIME e HMMT il suo layer Bifocal (piccola finestra e stato mLSTM) risolve quasi il doppio dei problemi rispetto alla sola finestra, ferma intorno al 14 %. Misurazioni dell’autore. 🔗 fonte
- Backdoor bloccata da ViKernel — VIDRAFT impianta tramite fine-tuning una backdoor in Qwen3-0.6B: la parola «payroll» in un percorso di file attiva il comando dannoso nel 98,3 % dei casi su percorsi mai visti, senza essere rilevata da 24 controlli; su ViKernel, i 290 payload vengono rifiutati prima dell’esecuzione. Pesi non pubblicati. 🔗 fonte
- Routing di Beam e manipolazione dei test — Uno studio preregistrato di Rairo Mukamuri non riesce a prevedere, attraverso il routing degli esperti di Beam-1.0-501B-A23B, una falsificazione di test con 500 token di anticipo: AUROC di 0,580 contro una soglia fissata a 0,75, per un costo di calcolo di 9,03 dollari. 🔗 fonte
- Saturate — Daniel van Strien sottopone nuovamente a OCR 14 483 pagine d’archivio su una sola GPU di Hugging Face Jobs, per 1,47 dollari e 8,9 pagine al secondo, con Saturate, la sua libreria Apache-2.0 per l’inferenza in batch verso qualsiasi endpoint compatibile con OpenAI. 🔗 fonte
Immagini, video, voce e musica
- LTX 2.5 su una RTX PRO 6000 — Il fornitore di GPU a noleggio EcoHash esegue il rendering di un video 1080p di 10 secondi con audio in 90 secondi, e in 14,8 secondi in 480p, su una sola scheda da 96 Go; misurazioni del fornitore sul proprio servizio. 🔗 fonte
- Mobiel AI di KPN — ElevenLabs descrive in dettaglio l’assistente telefonico di KPN per le piccole imprese olandesi (trascrizione dei messaggi in segreteria, riepiloghi delle chiamate, menu telefonico); il fine-tuning sull’olandese ha portato l’accuratezza di verifica da circa il 50 % al 90 %. Nessuna tariffa indicata. 🔗 fonte
- Suno Studio — Aggiornamento del 29 ottobre, rilanciato il 2 novembre: le impostazioni delle clip passano in una barra laterale, l’altezza si regola in semitoni e in cents, l’audio importato può essere dilatato per adattarsi al tempo del progetto e le tracce si nascondono con Shift-H. 🔗 fonte
- Kling e i Chroma Awards — Kling diventa partner della stagione 2 del concorso, con oltre 450 000 dollari in premi; candidature fino al 7 gennaio. 🔗 fonte
Programmi, dimostrazioni e post dei laboratori
- Anthropic Residency — Anthropic apre fino al 22 novembre le candidature a un programma di ricerca retribuito da sei settimane a sei mesi, per professori, fondatori con competenze tecniche e ingegneri di livello staff, senza prerequisiti di machine learning; retribuzione equivalente a una somma da 350 000 a 500 000 dollari l’anno. 🔗 fonte
- Data Bot di SpaceXSI — Caso di studio interno: un Team Bot di Grok Bot che svolge il ruolo di data scientist per l’intera azienda, a partire da skills mantenute dal team data, e che avrebbe svolto l’equivalente di circa 70 ore di lavoro in una settimana, secondo una stima di SpaceXSI. 🔗 fonte
- Le Chonk e la chimica quantistica — Mistral mostra su X Mistral Large 4 mentre scrive da zero un solver SCF e una vista 3D di una molecola che si rompe, senza pubblicare codice né dati numerici. 🔗 fonte
- Riepilogo di ottobre di Google — Nessun annuncio inedito tranne la risposta del satellite di Project Suncatcher, trattata più sopra. 🔗 fonte
- Memoria degli agenti in Perplexity — Una guida ai tipi di memoria e alla costruzione di un agente con memoria persistente, che rimanda a Brain, già disponibile in Computer. 🔗 fonte
- The Knowledge Talk — Perplexity pubblica la trascrizione del discorso di Aravind Srinivas del 3 ottobre alla Cambridge Union Society, senza annunci. 🔗 fonte
Che cosa significa
I message threads spostano parte dello stato della conversazione sul server senza incidere sulla fattura: token e tariffe restano gli stessi, diminuisce solo il tempo di attesa, e l’effetto è più evidente nelle sessioni di agenti che accumulano centinaia di migliaia di token. La scelta di un thread effimero, conservato per 5 minuti in memoria cifrata e senza API per rileggerlo, lascia all’applicazione il controllo della propria cronologia, al prezzo di esclusioni nette: niente ZDR, né Batches, né organizzazioni HIPAA. Sul fronte del terminale, la versione di anteprima di Copilot CLI ricorda che l’interfaccia stessa è una superficie di attacco, dato che un nome di file o una risposta del modello poteva cambiare lo stile dello schermo.
Grid Protectors e Suncatcher rispondono allo stesso vincolo, l’energia necessaria al calcolo, su due orizzonti molto diversi. OpenAI propone di rendere i consumi dei propri campus riducibili su richiesta per farsi accettare da una rete già sotto pressione, promettendo di sostenere i propri costi; l’unico risparmio quantificato per le famiglie proviene da Georgia Power e riguarda tutti i suoi grandi clienti. Google è arrivata a far scrivere un haiku a una TPU in orbita: un traguardo di fattibilità, senza dati sulle prestazioni, prima di due satelliti collegati nel 2027.
LifeVal, Design Creativity Bench e BrowseSafe++ misurano ciò che le classifiche di coding e matematica non vedono. LifeVal mostra un progresso che rallenta, 0,6 punti tra GPT-5.6 e GPT-6 Astra, ma resta un benchmark interno, senza concorrenti né un insieme di task pubblicato. Kombai evidenzia una convergenza delle interfacce che il tasso di successo nasconde, e BrowseSafe++ distingue rilevamento e resistenza: un modello che individua un’iniezione può comunque seguirla, e un rilevatore da 0,8B, oltre cento volte meno costoso di una chiamata API, non basta di fronte a un attaccante che riprova.
Sakana AI sceglie di controllare l’intera catena con Sawara, dal pretraining ai prodotti, ma con una tabella di marcia subordinata a condizioni e senza dimensioni annunciate. Runway e Synthesia fanno l’opposto: si inseriscono dove gli utenti lavorano già, nell’agente di coding o nella conversazione di ChatGPT e Claude, anziché attirarli verso la propria applicazione. ElevenLabs fornisce l’argomento quantitativo a favore della voce per le conversazioni lunghe, con uno studio del fornitore la cui base varia tra il tweet e il post, mentre NVIDIA offre strumenti a chi simula la guida, la robotica o la chirurgia con Cosmos 3 Nano.
Fonti
- L’articolo di Anthropic sui message threads
- @ClaudeDevs: i message threads in Claude Code
- La documentazione dei message threads
- Resoconto del simposio 2026 di Sakana AI
- @SakanaAILabs: resoconto del simposio
- Presentazione del Grid Protectors Program (OpenAI)
- Prima risposta dal satellite prototipo di Project Suncatcher (Google)
- LifeVal (OpenAI)
- Perché abbiamo creato Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- Plugin di Runway Dev per coding agent
- @synthesiaIO: video Synthesia in ChatGPT e Claude
- Perché la voce è più efficace nelle conversazioni complesse e stressanti (ElevenLabs)
- @ElevenLabs: studio sul confronto tra voce e chat
- Creare world models per la simulazione interattiva con NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 di Gemini CLI
- CLI mistral 0.16.0
- Caso di studio su Qodo e Codex (OpenAI)
- @zeddotdev: corgi
- pull_request_target bloccato per impostazione predefinita il 2 dicembre (GitHub)
- Le valutazioni dei rischi includono lo stato di protezione dei repository (GitHub)
- Changelog dell’API Perplexity
- Post di Dragonscale su kniv v7
- Post sulla finestra scorrevole e Bifocal
- Post di VIDRAFT sulla backdoor
- Post di Rairo Mukamuri su Beam
- @vanstriendaniel: Saturate
- Post di EcoHash su LTX 2.5
- Mobiel AI di KPN (ElevenLabs)
- Note di rilascio di Suno Studio
- @Kling_ai: Chroma Awards stagione 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk e il solutore SCF
- Gli annunci di Google sull’IA nell’ottobre 2026
- Memoria degli agenti IA (Perplexity)
- La conversazione sulla conoscenza (Perplexity)