ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
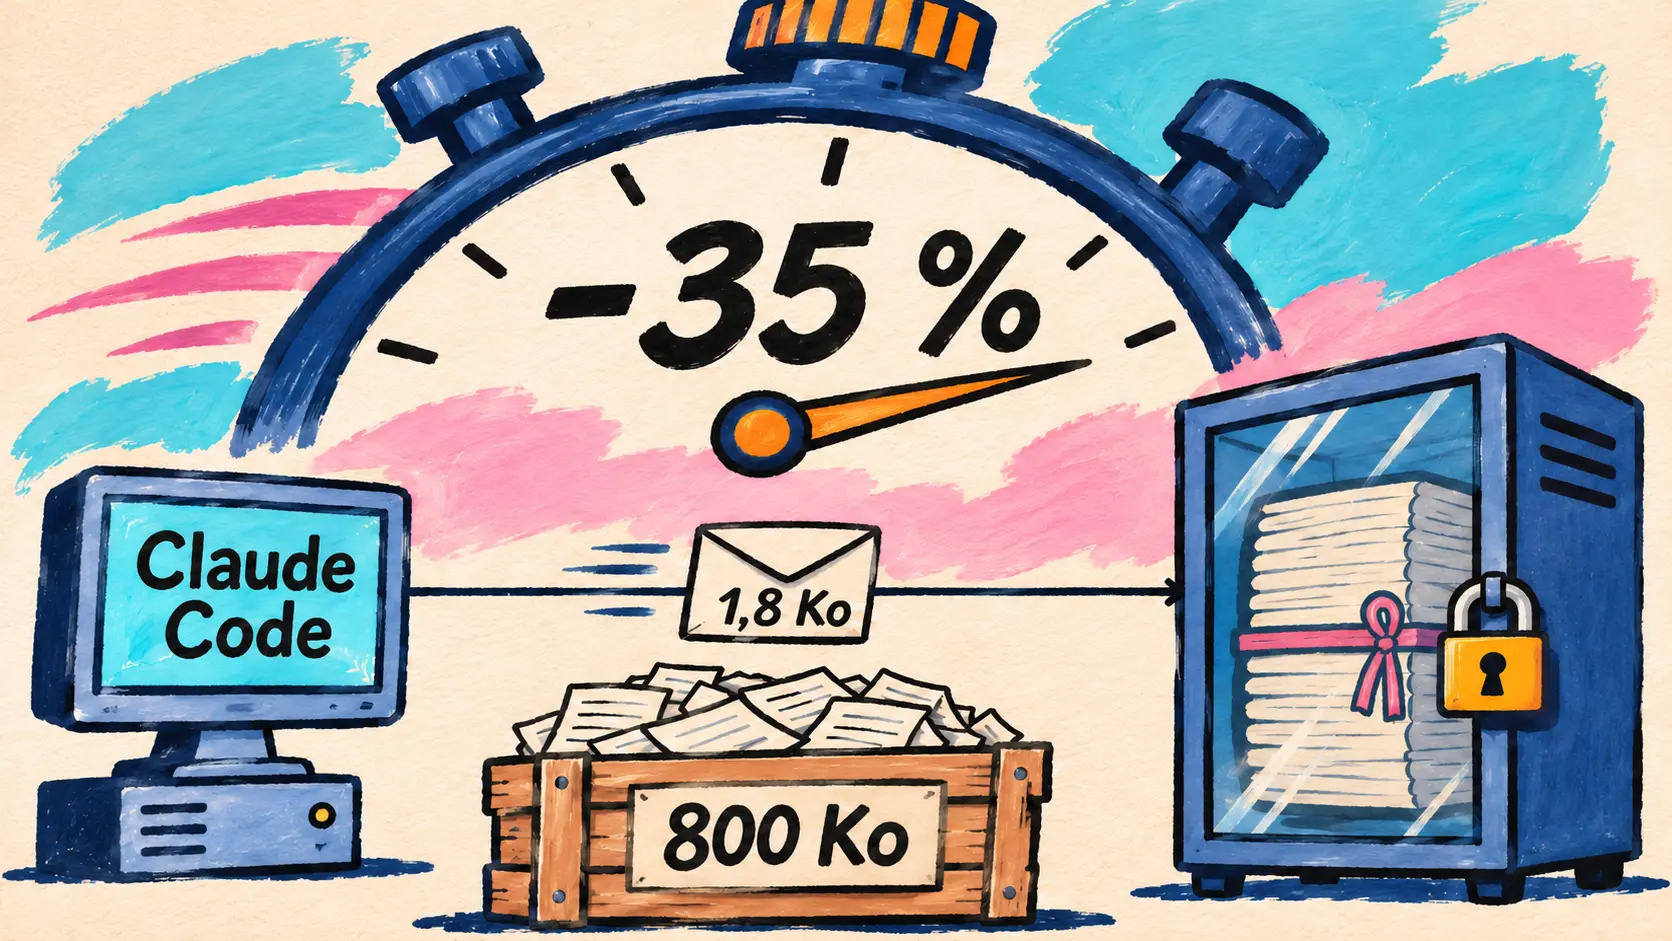
تتيح Anthropic سلاسل الرسائل في API Messages ضمن نسخة تجريبية عامة، وهي مفعّلة بالفعل في Claude Code، حيث تقلّص زمن الانتظار حتى أول رمز بنحو 35 % في أطول الطلبات. وتعلن Sakana AI عن Sawara، أول نماذجها المدرّبة مسبقًا من الصفر، بينما تطلق OpenAI برنامج Grid Protectors لجعل مجمعات الحوسبة التابعة لها قادرة على خفض الأحمال استجابةً لاحتياجات شبكة الكهرباء، وتنشر LifeVal، وهو معيار لاختبار مهام الحياة اليومية. وتنشر Perplexity معيار BrowseSafe++ لمواجهة حقن الموجّهات، وتوفّر NVIDIA أدوات للمحاكاة عبر Cosmos 3 Nano، فيما تُدخل Runway وSynthesia وElevenLabs الوسائط التوليدية إلى المساعدين والوكلاء.
API Messages تتيح سلاسل الرسائل في نسخة تجريبية عامة، وهي مفعّلة بالفعل في Claude Code
2 نوفمبر — تتيح Anthropic سلاسل الرسائل (message threads) في API Messages ضمن نسخة تجريبية عامة. حتى الآن، كان الوكيل يعيد إرسال المحادثة كاملةً في كل جولة، بما فيها نتائج الأدوات. ومع سلسلة الرسائل، يرسل الطلب الأول المحادثة كاملةً، مع موجّه النظام والأدوات؛ ولا ترسل الطلبات التالية سوى الرسائل الجديدة ومعرّف الاستجابة السابقة، ثم تعيد API تجميع بقية المحتوى قبل استدعاء النموذج. ويكفي إضافة المعامل thread وترويسة النسخة التجريبية message-threads-2026-08-12، اللذين تتعامل معهما حزم SDK الرسمية عبر دالة مساعدة مخصّصة.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇸🇦 دمجنا مؤخرًا سلاسل الرسائل في Claude Code. في الطلبات التي تتراوح بين 500 000 ومليون رمز، ينخفض وسيط زمن الانتظار حتى أول رمز بنحو 35 %. وفي المحادثات الطويلة، انخفض وسيط حجم الطلب من نحو 800 Ko إلى 1,8 Ko. — @ClaudeDevs على X
يتعلّق التحسّن بزمن الاستجابة، لا بالفاتورة: يعيد Claude قراءة المحادثة كاملةً في كل جولة، ولذلك لا يتغيّر عدد الرموز ولا الأسعار ولا حدود معدّل الطلبات، ويظل تفعيل التخزين المؤقت للموجّهات (prompt caching) مسؤولية المستخدم. تُحفظ السلسلة وفق مبدأ بذل أفضل جهد (best-effort)، في ذاكرة مشفّرة ولا تُكتب مطلقًا على القرص: تنتهي صلاحيتها بعد 5 دقائق من آخر طلب، ويحتفظ التطبيق بنسخته الخاصة لإعادة إرسال كل المحتوى إذا أعادت API الاستجابة 404. لا تدعم هذه الميزة سياسة عدم الاحتفاظ بالبيانات (ZDR)، ولا تعمل مع Message Batches، أو مع ضغط السياق عند الطلب، أو ضمن المؤسسات الخاضعة لـHIPAA. وهي متاحة عبر API Claude وClaude Platform on AWS وClaude in Microsoft Foundry وClaude Models on Google Cloud (بإدارة Anthropic).
🔗 مقال Anthropic عن سلاسل الرسائل · توثيق سلاسل الرسائل
Sakana AI تعلن عن Sawara، أول نماذجها المدرّبة مسبقًا من الصفر، مع توقّع نشر الأوزان في ربيع 2027
2 نوفمبر — تنشر Sakana AI تقرير ندوتها التي أُقيمت في 26 أكتوبر في طوكيو (بمشاركة أكثر من 400 شخص ومحاضرة ليورغن شميدهوبر)، ويتضمّن إعلانًا فعليًا: ستدرّب الشركة اليابانية الناشئة نماذجها اللغوية الخاصة تدريبًا مسبقًا. حتى الآن، كانت تعمل على الوكلاء وعلى التدريب اللاحق لنماذج مفتوحة موجودة باستخدام Namazu. وقدّم مديرها العلمي (كبير العلماء)، تاكويا أكيبا، سلسلة Sawara (اسم مؤقت)، التي تُبنى من الصفر من دون الانطلاق من نموذج تابع لجهة أخرى، والمصمّمة أصلًا لاستخدامات الوكلاء (agent-native): الاستدلال باستخدام الأدوات، والبرمجة، والمهام الطويلة. ومن المقرّر أن تشكّل أساسًا لمنتجات Sakana AI وأبحاث RSI Lab حول التحسين الذاتي التكراري.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇸🇦 نحضّر الآن للتدريب، وسنبدأ التدريب المسبق لـSawara Small (اسم مؤقت) في ديسمبر. إذا سارت الأمور على ما يرام، فسننشر الأوزان في الربيع المقبل. — Sakana AI، تقرير ندوة 2026
ومن المقرّر أن يتبعه Sawara Large، وهو اسم مؤقت أيضًا، من دون تحديد موعد. ولا تكشف Sakana AI عن حجم النموذج أو حجم البيانات أو ميزانية الحوسبة.
طاقة الحوسبة: OpenAI تطلق Grid Protectors، ووحدة TPU من Google تستجيب من المدار
OpenAI تطلق Grid Protectors، مع خفض أحمال كهربائية يصل إلى 1 000 MW في مجمعها بمقاطعة إفينغهام
2 نوفمبر — تطلق OpenAI برنامج Grid Protectors على مستوى البلاد، لتمكين مجمعات الحوسبة المستقبلية التابعة لها من تقليل استهلاكها عندما تتعرّض شبكة الكهرباء للضغط، أثناء موجات البرد أو الحر. وتريد الشركة إبرام اتفاقيات خاصة بكل موقع مع مورّدي الكهرباء والجهات التنظيمية وصنّاع القرار في القطاع العام، تحدّد حجم الأحمال القابلة للخفض وزمن الاستجابة ومدتها. وبحسب الاحتياجات المحلية، يمكن للمجمعات أيضًا الاعتماد على توليد الطاقة أو تخزينها في الموقع، وتخفيف تقلّبات طلبها باستخدام البطاريات.
يتمثّل المشروع التجريبي في المجمع المزمع إنشاؤه في مقاطعة إفينغهام بولاية جورجيا، والذي كُشف عنه في يوليو باسم Project Camellia. وتلتزم OpenAI بدفع كامل تكاليف البنية التحتية وخدمة الكهرباء فيه.
| المؤشر المعلن | القيمة المعلنة | مصدر الرقم |
|---|---|---|
| خفض الأحمال المرن المقرّر في الاتفاق مع Georgia Power | حتى 1 000 MW | OpenAI |
| ما يعادله من متوسط الطلب المنزلي | نحو 700 000 منزل | OpenAI |
| الوفورات السنوية لعملاء Georgia Power بدءًا من 2029 | نحو 950 مليون دولار | Georgia Power |
| التوفير لعميل سكني نموذجي يستهلك 1 000 kWh | ما لا يقل عن 15 دولارًا شهريًا | Georgia Power |
تشمل تقديرات Georgia Power جميع اتفاقياتها مع كبار المستهلكين والنمو المتوقّع، بما في ذلك Project Camellia: فالرقم لا يخص برنامج OpenAI وحده. وتقرّ الشركة بأن المرونة لا تُغني عن الاستثمار في قدرات جديدة للتوليد ونقل الكهرباء، ولا تعلن عن أي موقع آخر أو جدول زمني.
🔗 تدوينة OpenAI عن Grid Protectors
Project Suncatcher: وحدة TPU في المدار ترسل أول استجابة لها، وهي قصيدة هايكو كتبها Gemma 4
30 أكتوبر — استدراك: بعد شهر من إطلاق قمره الصناعي النموذجي في 1 أكتوبر، يحقّق Project Suncatcher، مشروع Google البحثي للحوسبة المخصّصة للذكاء الاصطناعي في الفضاء، إنجاز «Hello World»: أول استجابة ذكاء اصطناعي تنتجها وحدة TPU من فئة مراكز البيانات في المدار. وأثناء مرور القمر فوق محطة أرضية، طلب الفريق من النموذج المفتوح Gemma 4 الموجود على متنه كتابة قصيدة هايكو عن الحياة في الفضاء؛ وأُرسلت الاستجابة إلى الأرض عندما كان القمر يحلّق فوق سفالبارد في النرويج. وتلت ذلك قصائد ليمريك خماسية وموجّهات تتعلّق بالقياس عن بُعد، يجيب عنها النموذج بوصف الحالة التقنية للحمولة.
تركّز المرحلة التالية على الموثوقية: اختبارات لوحدات TPU تحت الإجهاد الحراري والإشعاعي، قبل إطلاق قمرين صناعيين مترابطين في 2027. ولا تقدّم التدوينة أي أرقام عن الأداء أو استهلاك الطاقة.
🔗 تدوينة Google عن أول استجابة من القمر الصناعي
الحياة اليومية وإبداع الواجهات: OpenAI تنشر LifeVal، وKombai تنشر Design Creativity Bench
LifeVal: عدد المهام اليومية 169، والنتائج من 49,3 % لـGPT-5.2 إلى 80,6 % لـGPT-6 Astra
2 نوفمبر — تنشر OpenAI تقييم LifeVal لقياس أداء النماذج في مهام الحياة اليومية: العثور على خدمة لرعاية الأطفال، أو الوصول إلى الخدمات العامة، أو إعداد ميزانية، أو تعديل وصفة طعام، أو وضع برنامج رياضي. وتستند المهام إلى مسحين كبيرين لاستخدام الوقت، هما المسح الأمريكي لاستخدام الوقت والدراسة متعددة الجنسيات لاستخدام الوقت، مع استكمالهما باستطلاع تمثيلي شمل 3 995 شخصًا حول المجالات التي يرغبون في الحصول على أكبر قدر من المساعدة فيها. وتقول OpenAI إنها تستخدمه منذ عام لمتابعة أداء نماذجها.
| النموذج المُقيَّم | تاريخ الإصدار | متوسط المكافأة في 169 مهمة |
|---|---|---|
| GPT-5.2 | ديسمبر 2025 | 49,3 % |
| GPT-5.4 | مارس 2026 | 73,0 % |
| GPT-5.5 | أبريل 2026 | 77,4 % |
| GPT-5.6 | يوليو 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | سبتمبر 2026 | 80,6 % |
بحسب وصف الرسم البياني، هذه متوسطات غير مرجّحة للمهام البالغ عددها 169، ولا يفصل بين GPT-5.6 وGPT-6 Astra سوى 0,6 نقطة. ولا يتضمّن الرسم GPT-6.1 Sol أو Terra، ولا أي نموذج من شركة أخرى، كما لا تذكر OpenAI أنها ستنشر مجموعة المهام.
Design Creativity Bench: النماذج تتقارب نحو الواجهات نفسها
2 نوفمبر — تعرض Kombai، مطوّرة أدوات الذكاء الاصطناعي لتطوير الواجهات الأمامية، على مدوّنة Hugging Face معيار Design Creativity Bench، الذي لا يقيس ما إذا كانت الواجهة تعمل، بل ما إذا كانت تشبه الواجهات الأخرى. وتشمل الدراسة 15 نموذجًا متقدّمًا و160 تعليمة و2 400 واجهة HTML، قورنت بنماذج تصميم أعدّها بشر.
| مقياس المعيار | النماذج المُقيَّمة | المرجع البشري |
|---|---|---|
| متوسط التمايز عند التعليمة نفسها | 0,592 بين النماذج | 0,764 بين البشر والنماذج |
| متوسط مدى التنوع الإبداعي | 0,581 | 0,902 |
| معايير القبول المستوفاة | أكثر من 90 % للجميع (Claude Opus 5.5 : 99,2 %) | 98,0 % |
إذًا تستوفي النماذج المتطلبات، لكن مخرجاتها تتشابه. ويتميّز GPT-6 Astra بالأسلوب الأكثر اختلافًا بين النماذج المشمولة (0,646 في الأصالة)، مع تنوّع محدود من سياق إلى آخر (0,472 في مدى التنوع). وتنشر Kombai الورقة البحثية (arXiv 2610.11539) وترتيبًا ومجموعة فرعية لإعادة إنتاج النتائج، وتقرّ بحدود الدراسة: شاشات الحواسيب المكتبية فقط، والإعدادات الافتراضية لواجهات API.
🔗 تدوينة Kombai على Hugging Face
Perplexity تنشر BrowseSafe++ وكواشف BrowseSafe-Guard لمواجهة حقن الموجّهات
2 نوفمبر — ينشر Perplexity Secure Intelligence Institute معيار BrowseSafe++، وهو امتداد لـBrowseSafe (ديسمبر 2025)، ومعيار مفتوح مخصّص لحقن الموجّهات غير المباشر (indirect prompt injection) الذي يستهدف الوكلاء القادرين على تصفّح الويب. ويجمع 38 675 زوجًا من الصفحات، تتكوّن كل منها من صفحة تعرّضت للهجوم ونسختها النظيفة، منها 32 187 زوجًا بُنيت حول عمليات حقن رُصدت فعليًا: فقد أبلغ كاشف Comet عن 1,15 مليون منها بين سبتمبر 2025 وسبتمبر 2026. وتتوافر كل صفحة بصيغ HTML وMarkdown وشجرة إتاحة ولقطة شاشة. وتستخلص Perplexity منها BrowseSafe-Guard، وهما كاشفان بحجم 0,8B جرى ضبطهما انطلاقًا من Qwen3.5-0.8B، أحدهما للنصوص والآخر للقطات الشاشة.
| النتيجة المنشورة | BrowseSafe-Guard | النماذج المقارَنة |
|---|---|---|
| F1 في التمثيلات النصية | نحو 95 %، الأول في كل تمثيل | من 85 إلى 92 % لأفضل النماذج العامة |
| F1 في لقطات الشاشة | نحو 93 % | نحو 79 % لأفضل نموذج آخر |
| الصفحات النظيفة التي صُنّفت خطأً على أنها ضارة | نحو 1 من كل 20 | 14,41 % لـGPT-6 Astra |
| تكلفة 1 000 صفحة | 0,18 دولار على H200 مستأجر | من 18,95 إلى 180,61 دولارًا عبر API |
الاكتشاف لا يعني المقاومة: فقد اتّبع كل نموذج عمليات حقن سبق أن رصدها بنفسه، بنسب تراوحت بين 1,64 % من الصفحات لدى GPT-6 Astra و24,73 % لدى Llama 3.1 8B. كما يتمكّن المهاجم المثابر من الاختراق في النهاية: ففي بيئة BrowseSafe-Adapt، التي تعيد كتابة الحقن بعد كل محاولة فاشلة (1 024 مهمة، وما يصل إلى 64 محاولة)، ترتفع نسبة النجاح من 4 % على الأكثر في المحاولة الأولى إلى 79 % على الأقل ضد خمسة من الوكلاء السبعة المختبَرين. وعند وضع Guard أمام وكيل Gemini 3.5 Flash-Lite، يحجب 94,5 % من عمليات الحقن الأصلية، لكن المهاجم يظل قادرًا على النجاح في 84,2 % من المهام. وتتوافر مجموعة البيانات (بوصول خاضع للضبط)، وحزمة SDK بترخيص MIT، وترتيب عام؛ ولا تتضمّن التدوينة أي رابط لأوزان الكواشف.
🔗 تدوينة Perplexity عن BrowseSafe++
الوسائط التوليدية: Runway Dev يصل إلى Claude Code وCursor، وSynthesia إلى ChatGPT وClaude، وElevenLabs تقيس ميزة الصوت بالأرقام
Runway Dev يصل إلى Claude Code وCursor
2 نوفمبر — بعد Codex، الذي قُدّم في 28 أكتوبر، توسّع Runway إتاحة إضافات Runway Dev لتشمل Claude Code وCursor. وتربط عملية التثبيت وكيل البرمجة بحساب Runway Dev عبر خادم MCP التابع لـRunway، وتضيف إليه مهارات Runway للتطوير باستخدام API الوسائط التوليدية الخاصة بها. يطّلع الوكيل أولًا على الحساب (المشروعات، والنماذج المتاحة مع أسعارها وحدودها، ورصيد الاعتمادات)، ثم يعتمد على حزم SDK الرسمية: فيمكنه إنشاء Model Router يختار النموذج المناسب لكل طلب، أو Character للشخصيات الافتراضية الآنية، وإعادة استخدام Recipes (مسارات معالجة جاهزة للاستخدام) أو Workflows المنشورة كنقاط وصول إلى API. وعند الفشل، يراجع تفاصيل الخطأ. ويجري ربط الحساب عند أول استخدام، من دون تخزين مفتاح API في الإضافة، ولم يُذكر أي سعر خاص بها.
| وكيل البرمجة | طريقة التثبيت التي توضحها Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api في محادثة Agent، أو عبر Cursor Marketplace |
Synthesia تنشئ مقاطع الفيديو الخاصة بها داخل ChatGPT وClaude
2 نوفمبر — تعلن Synthesia أنه بات بالإمكان إنشاء مقاطع الفيديو بشخصياتها الافتراضية مباشرةً داخل ChatGPT وClaude: يصف المستخدم الفيديو المطلوب، فيراه يظهر في المحادثة، ثم يطلب تعديله، وبعدها ينشره ويشاركه، من دون فتح تطبيق آخر أو تبويب آخر. ويقتصر الإعلان على تغريدة مرفقة بفيديو توضيحي؛ ولم تكن هناك أي تدوينة على مدوّنة Synthesia أو صفحتها الرئيسية وقت رصدنا. ولا توضّح Synthesia فيه آلية التكامل أو الباقات المعنية أو السعر.
ElevenLabs: الصوت ينجح أكثر من الدردشة بنسبة 32 % في المحادثات التي تتجاوز دقيقتين
2 نوفمبر — تنشر ElevenLabs دراسة تقارن الصوت (الهاتف وWhatsApp) بالدردشة لدى وكلاء ElevenAgents في بيئات الإنتاج، مع مقارنة كل وكيل بنفسه عبر محادثاته من مايو إلى يوليو 2026. تذكر تغريدة الإعلان 469 وكيلًا؛ أما المقال فيتحدث عن «مئات» الوكلاء.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇸🇦 كلما طالت المحادثة، ارتفع معدل نجاح الوكلاء الصوتيين. حلّلنا 469 وكيلًا يعملون بالصوت والدردشة معًا في بيئات الإنتاج، ولاحظنا اتجاهًا مثيرًا للاهتمام. عندما تصبح المحادثة معقدة، يكون الصوت أسرع طريق إلى الحل. — @ElevenLabs على X
| المؤشر بحسب ElevenLabs | القيمة المقاسة |
|---|---|
| نجاح الصوت في المحادثات التي تتجاوز دقيقتين | +10,9 نقطة، أي +31,7 % |
| المحادثات التي تقل عن دقيقة | تتقدم الدردشة بنحو 9 نقاط |
| مدة المحادثات الطويلة الناجحة | 4,6 دقائق بالصوت، و7 دقائق بالدردشة |
| الانتقال إلى LLM أسرع (315 محادثة) | انخفاض زمن الاستجابة بنسبة 16 %، وزيادة النجاح بنسبة 26 % |
| تفضيل الصوت (98 مشاركًا، رحلة ملغاة) | 85 % |
تُستخدم المدة هنا مؤشرًا على التعقيد، وهو مقياس يقرّ المقال بأنه غير مثالي، كما أن الدراسة صادرة عن الشركة المطوّرة التي تروّج فيها لوكلائها الصوتيين.
NVIDIA تنشر وصفات محاكاة باستخدام Cosmos 3 Nano للقيادة والروبوتات والجراحة
2 نوفمبر — تنشر NVIDIA على مدونتها التقنية دليلًا من جزأين حول Cosmos، منصتها لنماذج العالم التأسيسية (world foundation models) المخصصة للذكاء الاصطناعي الفيزيائي: وصفات محاكاة تستند إلى نقاط تحقق جديدة من Cosmos 3 Nano، أُعلن عنها في 22 أكتوبر وتُذكر هذه المرة أسماؤها وأوصافها، ثم إرشادات لاستخدام خدمات NIM المصغّرة. ومن الأمثلة البارزة: يكفي تغيير prompt لتحويل رحلة نهارية إلى ليلة ممطرة، دون المساس بتخطيط الطريق أو مسارات المركبات.
| نقطة تحقق Cosmos 3 | الاستخدام الذي تصفه NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | مقاطع متعددة الكاميرات مع LiDAR للقيادة، حتى 400 إطار بدقة 480p أو 720p |
| Cosmos3-Nano-Sim-Auto | نسخة سببية مقطّرة تولّد بصورة متدفقة لاختبار سياسة قيادة في حلقة مغلقة |
| Cosmos3-Nano-Sim-Transfer | تحويل فيديو العمق إلى فيديو RGB تفصيلي، للروبوتات |
| Cosmos3-Nano-Sim-Bimanual | الملاحظة التالية لروبوت ذي ذراعين انطلاقًا من المشهد وأفعاله |
| Cosmos3-H-Embodied-Nano وCosmos3-H-Dreams | محاكاة جراحية انطلاقًا من أفعال الروبوت، في الزمن الحقيقي بالنسبة إلى H-Dreams |
على صعيد النشر، توفّر صورة NIM cosmos3:2.0.0 ملفات إعداد لزمن الاستجابة أو معدل المعالجة، ويسرّع فك الترميز التخميني الاستدلال بنحو 2 إلى 3 أضعاف في المتوسط على H200، بحسب NVIDIA، التي تعلن اعتماد NIM Cosmos على أكثر من 20 GPU. وعند التوليد، يحتاج Cosmos3-Nano إلى 58 Gio من VRAM بصيغة BF16، وإلى 31 Gio بصيغة FP8 مع تفريغ الذاكرة. ويحصل Cosmos Framework على مسارات للتعلّم المعزّز (DPO، GRPO، PPO، OPD، DiffusionNFT)، ويُخصّص له بث مباشر يوم الخميس 5 نوفمبر.
Copilot CLI 1.0.106-3، إصدار معاينة: إدارة اختيارية للجلسات و145 إصلاحًا
2 نوفمبر — تنشر GitHub إصدار المعاينة 1.0.106-3 من Copilot CLI، وهو الثالث ضمن فرع 1.0.106. لا تتضمن الملاحظات سوى إضافة واحدة: أدوات لإدارة الجلسات تُفعّل اختياريًا (opt-in)، وإمكانية الإشارة باستخدام @ إلى الجلسات المحلية التي فُعّلت لها هذه الميزة، دون مزيد من التفاصيل. وبالنسبة إلى الحسابات المُدارة، تعكس تحذيرات تحديث السياسات الآن النتائج التي يرصدها Policy Helper.
تتناول الإصلاحات الـ145 المتبقية أساسًا متانة واجهة الطرفية، ولعدد منها أثر أمني:
| الإصلاح الأمني | السلوك قبل الإصدار 1.0.106-3 |
|---|---|
| تصفية تسلسلات الهروب | كان بإمكان ردّ أو اسم ملف أو عنوان أداة MCP تغيير تنسيق السجل الزمني أو إخفاء أسطر منه |
/allow-all off | عند إلحاقه بمسافة إيديوغرافية (إدخال CJK)، كان الأمر يفعّل Allow All بدلًا من تعطيله |
/session delete | كان وضع خيار غير معروف قبل المعرّف يؤدي إلى حذف الجلسة الحالية دون طلب تأكيد |
copilot -p وcopilot workflow run | كان الإخراج النصي يعرض قيم --secret-env-vars، التي كان إخراج JSON يخفيها بالفعل |
يبقى أحدث إصدار مستقر هو 1.0.105 الصادر في 28 أكتوبر، ولا يتضمن Copilot SDK 1.0.29-preview.2، المنشور في المساء نفسه، أي تغيير من جانب SDK.
🔗 ملاحظات إصدار Copilot CLI 1.0.106-3
أخبار موجزة
الوكلاء وأدوات البرمجة
- Qwen Code v0.26.6 — إصدار مستقر بتاريخ 2 نوفمبر، غداة v0.26.5: يحصل Web Shell على عرض لنشاط الجلسات، ويعرض لكل نموذج معدل النجاح وسرعة الإخراج وزمن انتظار أول token؛ وتحصل نماذج Kimi K3 على نافذة سياق تبلغ 1 مليون tokens. 🔗 المصدر
- Gemini CLI — يمنع إصلاح دُمج مساء 2 نوفمبر اعتبار تنزيل منقطع لنموذج Whisper نموذجًا مثبتًا، وهو ما كان يعطّل الوضع الصوتي المحلي إلى حين حذف الملف يدويًا. لم يُدرج الإصلاح بعد في أي إصدار، وتعتمد نسخة nightly لليوم على commit نفسه الذي اعتمدته النسختان السابقتان. 🔗 المصدر
- CLI mistral 0.16.0 — أصبح
mistral workflows initوmistral initيطلبان مفتاح API لمشروع Workflow، ويتحققان منه عبر API من Mistral ويحفظانه في.envالخاص بالمشروع. 🔗 المصدر - إضافة Qodo لـ Codex — في دراسة حالة نشرتها OpenAI، تعرض Qodo إضافتها المتاحة في سوق إضافات Codex: يتلقى Codex قواعد المؤسسة وسجل pull requests قبل الكتابة، ثم مراجعة Qodo في الجلسة نفسها، قبل فتح pull request. لم تُذكر أرقام للنتائج. 🔗 المصدر
- corgi، تبرزها Zed — مساء 1 نوفمبر، تبرز Zed موقع corgi، أداة build لـ Rust المتوافقة مع Cargo من تطوير كونراد إروين: ذاكرة تخزين مؤقت واحدة لكل جهاز، وتشغيل build.rs ووحدات الماكرو في بيئة معزولة، وتخزين نتائج الاختبارات مؤقتًا. وبحسب مؤلفها، كُتبت الشيفرة بالكامل تقريبًا بالذكاء الاصطناعي. المستودع مرخّص بموجب MIT. 🔗 المصدر
منصات التطوير وAPI
- pull_request_target في GitHub Actions — تأجيل الحظر الافتراضي لـ
pull_request_targetفي المستودعات العامة من 2 نوفمبر إلى 2 ديسمبر؛ وستكشف فترتا تعطيل مجدولتان، يومَي 9 و16 نوفمبر من الساعة 16 إلى 18 بتوقيت UTC، مسارات العمل المتأثرة. 🔗 المصدر - تقييمات المخاطر من GitHub — تبيّن تقييمات مخاطر أمان الشيفرة والأسرار الآن ما إذا كانت كل ملاحظة موجودة في مستودع محمي أم غير محمي، على GitHub Enterprise Cloud وGitHub Team. 🔗 المصدر
- Analytics API من Perplexity — تغفل الردود بشأن استخدام أرصدة Computer حاليًا التوزيع حسب مصدر الأرصدة (Credit Source)؛ فيما يظل الإجمالي والتوزيع حسب النموذج متاحين، وتطلب Perplexity عدم تفسير غياب هذا التوزيع على أنه انعدام للاستخدام. 🔗 المصدر
النماذج المفتوحة ومنشورات المجتمع
- kniv v7 من Dragonscale — ستة نماذج ترميز مفتوحة تضم من 55M إلى 538M من المعاملات (Apache-2.0، ONNX)، تستخرج الكيانات والعلاقات والحقائق وفق مخطط يُوصف وقت الاستدعاء، دون LLM، لذاكرة الوكلاء؛ وعلى Re-DocRED، تحقق 0,749 ضمن الجملة نفسها و0,732 عند التباعد بمقدار جملتين (نسخة DeBERTa). 🔗 المصدر
- النافذة المنزلقة وطبقة Bifocal — في منشور مجتمعي، يقطّر لوكاس Qwen3-4B-Instruct إلى أربعة نماذج تلميذة بميزانية ذاكرة متساوية: تكفي النافذة المنزلقة للردود القصيرة، لكن على AIME وHMMT تحل طبقته Bifocal (نافذة صغيرة وحالة mLSTM) ما يقارب ضعف عدد المسائل التي تحلّها النافذة وحدها، التي تبقى عند نحو 14 %. القياسات للمؤلف. 🔗 المصدر
- باب خلفي يحجبه ViKernel — تزرع VIDRAFT بابًا خلفيًا في Qwen3-0.6B عبر الضبط الدقيق: تؤدي كلمة «payroll» في مسار ملف إلى تفعيل الأمر الخبيث في 98,3 % من الحالات على مسارات لم تُعرض من قبل، دون أن ترصده أي من 24 آلية فحص؛ وعلى ViKernel، تُرفض الحمولات الـ290 قبل التنفيذ. لم تُنشر الأوزان. 🔗 المصدر
- توجيه Beam والغش في الاختبارات — لا تتمكن دراسة مسجّلة مسبقًا لرايرو موكاموري من التنبؤ، عبر توجيه الخبراء في Beam-1.0-501B-A23B، بتزوير اختبار قبل وقوعه بـ500 tokens: تبلغ AUROC قيمة 0,580 مقابل عتبة محددة عند 0,75، بتكلفة حسابية قدرها 9,03 دولارات. 🔗 المصدر
- Saturate — يعيد دانيال فان سترين معالجة 14 483 صفحة أرشيفية باستخدام OCR على GPU واحدة من Hugging Face Jobs، مقابل 1,47 دولار وبمعدل 8,9 صفحات في الثانية، باستخدام Saturate، مكتبته المرخّصة بموجب Apache-2.0 للاستدلال على دفعات عبر أي نقطة وصول متوافقة مع OpenAI. 🔗 المصدر
الصور والفيديو والصوت والموسيقى
- LTX 2.5 على RTX PRO 6000 — تولّد EcoHash، شركة تأجير GPU، فيديو بدقة 1080p مدته 10 ثوانٍ مع صوت خلال 90 ثانية، وخلال 14,8 ثانية بدقة 480p، على بطاقة واحدة بسعة 96 Go؛ هذه قياسات المزود على خدمته الخاصة. 🔗 المصدر
- Mobiel AI من KPN — تفصّل ElevenLabs مساعد المكالمات من KPN للشركات الهولندية الصغيرة (تفريغ البريد الصوتي، وملخصات المكالمات، وقائمة خيارات الاتصال)؛ وقد رفع الضبط الدقيق على اللغة الهولندية دقة التحقق من نحو 50 % إلى 90 %. لم تُذكر أسعار. 🔗 المصدر
- Suno Studio — استدراك لخبر من 29 أكتوبر، جرى تداوله في 2 نوفمبر: تنتقل إعدادات المقطع إلى شريط جانبي، وتُضبط طبقة الصوت بأنصاف النغمات ووحدات السنت، ويمكن تمديد الصوت المستورَد ليتوافق مع إيقاع المشروع، وإخفاء المسارات باستخدام Shift-H. 🔗 المصدر
- Kling وChroma Awards — تصبح Kling شريكًا للموسم 2 من المسابقة، بجوائز تتجاوز 450 000 دولار؛ ويستمر تقديم المشاركات حتى 7 يناير. 🔗 المصدر
البرامج والعروض التوضيحية ومنشورات المختبرات
- Anthropic Residency — تفتح Anthropic باب الترشح حتى 22 نوفمبر لبرنامج بحثي مدفوع الأجر يمتد من ستة أسابيع إلى ستة أشهر، للأساتذة والمؤسسين ذوي الخبرة التقنية والمهندسين بمستوى staff، دون اشتراط خبرة سابقة في التعلّم الآلي؛ ويعادل الأجر 350 000 إلى 500 000 دولار سنويًا. 🔗 المصدر
- Data Bot من SpaceXSI — دراسة حالة داخلية: Team Bot من Grok Bot يؤدي دور عالم بيانات للشركة كلها، بالاعتماد على skills يديرها فريق البيانات، ويُقال إنه تولّى نحو 70 ساعة عمل في أسبوع واحد، وفق تقدير SpaceXSI. 🔗 المصدر
- Le Chonk والكيمياء الكمومية — تعرض Mistral على X نموذج Mistral Large 4 وهو يكتب من الصفر برنامجًا لحل SCF وعرضًا ثلاثي الأبعاد لجزيء يتفكك، دون نشر شيفرة أو أرقام. 🔗 المصدر
- ملخص أكتوبر من Google — لا إعلانات جديدة باستثناء ردّ القمر الصناعي التابع لـ Project Suncatcher، الذي تناولناه أعلاه. 🔗 المصدر
- ذاكرة الوكلاء لدى Perplexity — دليل لأنواع الذاكرة وبناء وكيل ذي ذاكرة دائمة، يحيل إلى Brain، المتاح بالفعل في Computer. 🔗 المصدر
- The Knowledge Talk — تنشر Perplexity نص خطاب أرافيند سرينيفاس في 3 أكتوبر لدى Cambridge Union Society، دون أي إعلان. 🔗 المصدر
ما الذي يعنيه ذلك
تنقل message threads جزءًا من حالة المحادثة إلى الخادم دون تغيير الفاتورة: تبقى tokens والأسعار كما هي، وينخفض وقت الانتظار وحده، ويظهر الأثر بأوضح صورة في جلسات الوكلاء التي تراكم مئات الآلاف من tokens. ويُبقي اختيارُ سلسلة مؤقتة، تُحفظ 5 دقائق في ذاكرة مشفّرة دون API لإعادة قراءتها، التطبيقَ متحكمًا في سجله، مقابل استثناءات واضحة: لا ZDR، ولا Batches، ولا المؤسسات الخاضعة لـ HIPAA. وفي الطرفية، يذكّر إصدار المعاينة من Copilot CLI بأن الواجهة نفسها تمثل سطح هجوم، إذ كان اسم ملف أو ردّ النموذج قادرًا على تغيير تنسيق الشاشة.
يستجيب Grid Protectors وSuncatcher للقيد نفسه، وهو طاقة الحوسبة، ضمن أفقين زمنيين مختلفين جدًا. تقترح OpenAI إتاحة خفض استهلاك مجمّعاتها عند الطلب كي تحظى بقبول شبكة تعاني أصلًا من الضغط، مع وعد بتحمّل تكاليفها الخاصة؛ والتوفير الوحيد المعلن بالأرقام للأسر صادر عن Georgia Power ويتعلق بجميع عملائها الكبار. أما Google، فهي في مرحلة جعل TPU في المدار تكتب قصيدة هايكو: خطوة لإثبات الجدوى، دون أرقام للأداء، تمهيدًا لقمرين صناعيين مترابطين في 2027.
تقيس LifeVal وDesign Creativity Bench وBrowseSafe++ ما لا ترصده تصنيفات البرمجة والرياضيات. يُظهر LifeVal تقدمًا يتباطأ، بمقدار 0,6 نقطة بين GPT-5.6 وGPT-6 Astra، لكنه يظل معيارًا داخليًا، دون نماذج منافسة أو مجموعة مهام منشورة. وتشير Kombai إلى تقارب الواجهات الذي يخفيه معدل النجاح، ويفصل BrowseSafe++ بين الاكتشاف والمقاومة: فقد يرصد نموذجٌ هجوم حقن ويتبعه رغم ذلك، ولا يكفي كاشف بحجم 0,8B، تقل تكلفته بأكثر من مئة مرة عن استدعاء API، أمام مهاجم يكرر المحاولة.
تختار Sakana AI التحكم في السلسلة بأكملها مع Sawara، من التدريب المسبق إلى المنتجات، لكن وفق جدول زمني مشروط ودون إعلان الحجم. وتسلك Runway وSynthesia النهج المعاكس: فتتموضعان حيث يعمل المستخدمون بالفعل، داخل وكيل البرمجة أو في محادثات ChatGPT وClaude، بدلًا من جذبهم إلى تطبيق كل منهما. وتقدّم ElevenLabs حجة رقمية لصالح الصوت في المحادثات الطويلة، عبر دراسة من الشركة المطوّرة يختلف حجم عينتها بين التغريدة والمقال، بينما تزوّد NVIDIA من يحاكون القيادة أو الروبوتات أو الجراحة بالأدوات عبر Cosmos 3 Nano.
المصادر
- مقال Anthropic حول سلاسل الرسائل
- @ClaudeDevs: سلاسل الرسائل في Claude Code
- توثيق سلاسل الرسائل
- تقرير عن ندوة Sakana AI لعام 2026
- @SakanaAILabs: تقرير عن الندوة
- تقديم برنامج Grid Protectors Program (OpenAI)
- أول استجابة من القمر الصناعي التجريبي لمشروع Project Suncatcher (Google)
- LifeVal (OpenAI)
- لماذا أنشأنا Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- إضافات Runway Dev لوكلاء البرمجة
- @synthesiaIO: مقاطع فيديو Synthesia في ChatGPT وClaude
- لماذا يتفوق الصوت في المحادثات المعقدة والمسببة للتوتر (ElevenLabs)
- @ElevenLabs: دراسة تقارن الصوت بالدردشة
- بناء نماذج العالم للمحاكاة التفاعلية باستخدام NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 في Gemini CLI
- CLI mistral 0.16.0
- دراسة حالة عن Qodo وCodex (OpenAI)
- @zeddotdev: corgi
- حظر pull_request_target افتراضيًا في 2 ديسمبر (GitHub)
- تقييمات المخاطر تشمل حالة حماية المستودعات (GitHub)
- سجل تغييرات API في Perplexity
- تدوينة Dragonscale حول kniv v7
- تدوينة حول النافذة المنزلقة وBifocal
- تدوينة VIDRAFT حول الباب الخلفي
- تدوينة رايرو موكاموري حول Beam
- @vanstriendaniel: Saturate
- تدوينة EcoHash حول LTX 2.5
- Mobiel AI من KPN (ElevenLabs)
- ملاحظات إصدار Suno Studio
- @Kling_ai: الموسم 2 من Chroma Awards
- برنامج الإقامة في Anthropic
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk وحلّال SCF
- إعلانات Google المتعلقة بالذكاء الاصطناعي في أكتوبر 2026
- ذاكرة وكلاء الذكاء الاصطناعي (Perplexity)
- حديث المعرفة (Perplexity)