ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
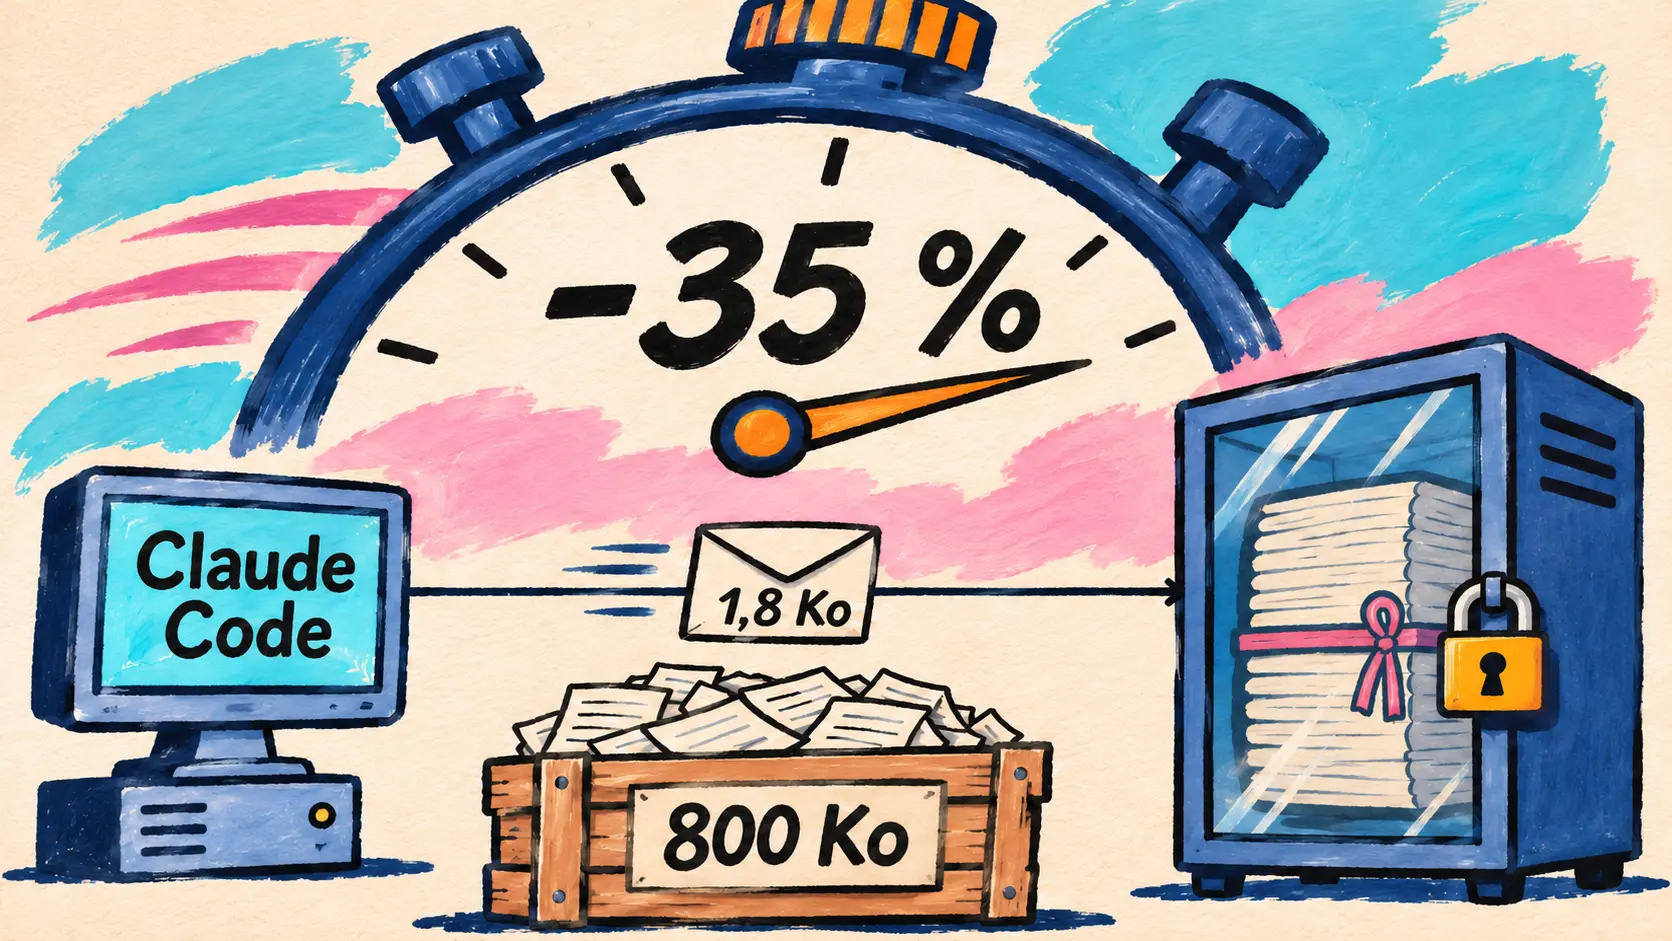
Anthropic udostępnia w publicznej wersji beta message threads w API Messages, już działające w Claude Code, gdzie skracają czas do pierwszego tokena o około 35 % przy najdłuższych zapytaniach. Sakana AI zapowiada Sawara, swoje pierwsze modele trenowane wstępnie od zera, a OpenAI uruchamia Grid Protectors, aby umożliwić redukcję poboru energii przez swoje kampusy obliczeniowe w zależności od potrzeb sieci elektroenergetycznej, i publikuje LifeVal, benchmark zadań z życia codziennego. Perplexity publikuje BrowseSafe++ przeciwko prompt injection, NVIDIA dostarcza narzędzia do symulacji z Cosmos 3 Nano, a Runway, Synthesia i ElevenLabs wprowadzają media generatywne do asystentów i agentów.
API Messages udostępnia message threads w publicznej wersji beta, już działające w Claude Code
2 listopada — Anthropic udostępnia w publicznej wersji beta wątki wiadomości (message threads) w API Messages. Dotychczas agent przy każdej turze ponownie wysyłał całą rozmowę, łącznie z wynikami narzędzi. W przypadku wątku pierwsze zapytanie przesyła pełną rozmowę wraz z promptem systemowym i narzędziami; kolejne wysyłają tylko nowe wiadomości oraz identyfikator poprzedniej odpowiedzi, a API odtwarza resztę przed wywołaniem modelu. Wystarczy dodać parametr thread i nagłówek wersji beta message-threads-2026-08-12, które oficjalne SDK obsługują za pomocą dedykowanej funkcji pomocniczej.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇵🇱 Niedawno wdrożyliśmy message threads w Claude Code. W przypadku zapytań liczących od 500 000 do 1 miliona tokenów mediana czasu do pierwszego tokena jest niższa o około 35 %. W długich rozmowach mediana rozmiaru zapytania spadła z około 800 Ko do 1,8 Ko. — @ClaudeDevs na X
Korzyść dotyczy opóźnienia, a nie rachunku: Claude ponownie odczytuje całą rozmowę przy każdej turze, więc liczba tokenów, stawki i limity przepustowości pozostają bez zmian, a buforowanie promptów (prompt caching) nadal trzeba włączać samodzielnie. Wątek jest przechowywany w miarę możliwości (best-effort), w zaszyfrowanej pamięci i nigdy na dysku: wygasa 5 minut po ostatnim zapytaniu, a aplikacja zachowuje własną kopię, aby wysłać wszystko ponownie, jeśli API zwróci 404. Funkcja nie kwalifikuje się do zerowej retencji danych (ZDR) i nie działa z Message Batches, z kompakcją na żądanie ani w organizacjach HIPAA. Jest dostępna w API Claude, Claude Platform on AWS, Claude in Microsoft Foundry i Claude Models on Google Cloud (Anthropic managed).
🔗 Artykuł Anthropic o message threads · Dokumentacja message threads
Sakana AI zapowiada Sawara, swoje pierwsze modele trenowane wstępnie od zera, z publikacją wag planowaną na wiosnę 2027
2 listopada — Sakana AI publikuje relację ze swojego sympozjum z 26 października w Tokio (ponad 400 uczestników, wykład Jürgena Schmidhubera), która zawiera istotną zapowiedź: japoński startup zamierza przeprowadzić pretraining własnych modeli językowych. Dotychczas pracował nad agentami i post-trainingiem istniejących otwartych modeli z użyciem Namazu. Seria Sawara (nazwa robocza), którą przedstawił dyrektor naukowy (Chief Scientist) Takuya Akiba, powstaje od zera, bez bazowania na modelu innej firmy, i jest projektowana z myślą o zastosowaniach agentowych (agent-native): rozumowaniu z użyciem narzędzi, kodzie i długich zadaniach. Ma stanowić podstawę produktów Sakana AI oraz badań RSI Lab nad rekurencyjnym samodoskonaleniem.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇵🇱 Obecnie przygotowujemy trening, a w grudniu rozpoczniemy pretraining Sawara Small (nazwa robocza). Jeśli wszystko pójdzie dobrze, opublikujemy wagi wiosną przyszłego roku. — Sakana AI, relacja z sympozjum 2026
Później ma pojawić się Sawara Large, również pod nazwą roboczą, bez podanej daty. Sakana AI nie ujawnia rozmiaru modelu, ilości danych ani budżetu obliczeniowego.
Energia dla obliczeń: OpenAI uruchamia Grid Protectors, układ TPU Google odpowiada z orbity
OpenAI uruchamia Grid Protectors, do 1 000 MW redukcji poboru mocy w kampusie w Effingham
2 listopada — OpenAI uruchamia Grid Protectors, ogólnokrajowy program, dzięki któremu przyszłe kampusy obliczeniowe firmy mają ograniczać zużycie energii, gdy sieć elektroenergetyczna jest nadmiernie obciążona, podczas fali mrozów lub upałów. Firma chce zawierać z dostawcami energii, regulatorami i przedstawicielami władz umowy dla poszczególnych lokalizacji, określające wielkość możliwej redukcji poboru mocy, czas reakcji i czas jej trwania. W zależności od lokalnych potrzeb kampusy będą mogły także korzystać z produkcji lub magazynowania energii na miejscu i wygładzać swoje zapotrzebowanie za pomocą baterii.
Pilotażem jest kampus planowany w hrabstwie Effingham w Georgii, zaprezentowany w lipcu pod nazwą Project Camellia. OpenAI zobowiązuje się pokryć tam wszystkie koszty infrastruktury i usług elektroenergetycznych.
| Zapowiedziany wskaźnik | Podana wartość | Źródło danych |
|---|---|---|
| Elastyczna redukcja poboru mocy przewidziana w umowie z Georgia Power | do 1 000 MW | OpenAI |
| Odpowiednik średniego zapotrzebowania gospodarstw domowych | około 700 000 gospodarstw domowych | OpenAI |
| Roczne oszczędności klientów Georgia Power od 2029 | około 950 milionów dolarów | Georgia Power |
| Korzyść dla typowego klienta indywidualnego zużywającego 1 000 kWh | co najmniej 15 dolarów miesięcznie | Georgia Power |
Prognoza Georgia Power dotyczy wszystkich umów firmy z dużymi odbiorcami i oczekiwanego wzrostu, w tym Project Camellia: nie jest to liczba odnosząca się wyłącznie do programu OpenAI. Firma przyznaje, że elastyczność nie zastępuje inwestycji w nowe moce wytwórcze i przesyłowe, i nie ogłasza innych lokalizacji ani harmonogramu.
🔗 Wpis OpenAI o Grid Protectors
Project Suncatcher: TPU na orbicie udziela pierwszej odpowiedzi, haiku napisanego przez Gemma 4
30 października — Uzupełnienie: miesiąc po wystrzeleniu prototypowego satelity, 1 października, Project Suncatcher, projekt badawczy Google dotyczący obliczeń AI w kosmosie, osiąga etap „Hello World”: pierwszą odpowiedź AI wygenerowaną przez układ TPU klasy data center na orbicie. Podczas przelotu nad stacją naziemną zespół poprosił otwarty model Gemma 4, znajdujący się na pokładzie, o haiku o życiu w kosmosie; odpowiedź dotarła na Ziemię, gdy satelita przelatywał nad Svalbardem w Norwegii. Potem pojawiły się limeryki i prompty dotyczące telemetrii, na które model odpowiada opisem stanu technicznego ładunku użytecznego.
Dalsze prace dotyczą niezawodności: testów TPU przy obciążeniu termicznym i pod wpływem promieniowania, przed etapem obejmującym parę połączonych ze sobą satelitów w 2027 roku. Wpis nie podaje żadnych danych o wydajności ani zużyciu energii.
🔗 Wpis Google o pierwszej odpowiedzi satelity
Życie codzienne i kreatywność interfejsów: OpenAI publikuje LifeVal, Kombai publikuje Design Creativity Bench
LifeVal: 169 zadań z życia codziennego, od 49,3 % dla GPT-5.2 do 80,6 % dla GPT-6 Astra
2 listopada — OpenAI publikuje LifeVal, ocenę modeli na zadaniach z życia codziennego: znalezieniu opieki nad dziećmi, uzyskaniu dostępu do usług publicznych, przygotowaniu budżetu, dostosowaniu przepisu czy ułożeniu planu treningowego. Zadania opierają się na dwóch dużych badaniach wykorzystania czasu, American Time Use Survey i Multinational Time Use Study, uzupełnionych reprezentatywnym badaniem 3 995 osób dotyczącym dziedzin, w których najbardziej chciałyby otrzymać pomoc. OpenAI podaje, że od roku korzysta z LifeVal do monitorowania swoich modeli.
| Oceniany model | Data premiery | Średnia nagroda za 169 zadań |
|---|---|---|
| GPT-5.2 | grudzień 2025 | 49,3 % |
| GPT-5.4 | marzec 2026 | 73,0 % |
| GPT-5.5 | kwiecień 2026 | 77,4 % |
| GPT-5.6 | lipiec 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | wrzesień 2026 | 80,6 % |
Według opisu wykresu jest to nieważona średnia ze 169 zadań, a GPT-5.6 i GPT-6 Astra dzieli zaledwie 0,6 punktu. Wykres nie uwzględnia GPT-6.1 Sol ani Terra, ani żadnego modelu innego producenta, a OpenAI nie wspomina o publikacji zestawu zadań.
Design Creativity Bench: modele tworzą podobne do siebie interfejsy
2 listopada — Kombai, producent narzędzi AI do prac nad front-endem, przedstawia na blogu Hugging Face Design Creativity Bench, benchmark, który mierzy nie to, czy interfejs działa, lecz to, czy przypomina inne. Badanie obejmuje 15 czołowych modeli, 160 poleceń i 2 400 interfejsów HTML, porównanych z makietami stworzonymi przez ludzi.
| Miara benchmarku | Oceniane modele | Punkt odniesienia: ludzie |
|---|---|---|
| Średnia odmienność przy tym samym poleceniu | 0,592 między modelami | 0,764 między ludźmi a modelami |
| Średni zakres kreatywności | 0,581 | 0,902 |
| Spełnione kryteria akceptacji | ponad 90 % dla wszystkich (Claude Opus 5.5: 99,2 %) | 98,0 % |
Modele spełniają więc wymagania, ale są do siebie podobne. GPT-6 Astra ma najbardziej odrębny styl w zestawieniu (0,646 oryginalności), choć niewiele zmienia go między kontekstami (0,472 zakresu). Kombai publikuje artykuł (arXiv 2610.11539), ranking i podzbiór umożliwiający odtworzenie wyników, a także przyznaje, że badanie ma ograniczenia: obejmuje wyłącznie ekrany komputerowe i domyślne ustawienia API.
Perplexity publikuje BrowseSafe++ i detektory BrowseSafe-Guard przeciwko prompt injection
2 listopada — Perplexity Secure Intelligence Institute publikuje BrowseSafe++, następcę BrowseSafe (grudzień 2025), otwarty benchmark poświęcony pośredniemu wstrzykiwaniu promptów (indirect prompt injection), które atakuje agentów potrafiących przeglądać sieć. Obejmuje on 38 675 par stron, zaatakowaną stronę i jej czysty odpowiednik, w tym 32 187 par zbudowanych na podstawie rzeczywiście zaobserwowanych ataków: detektor Comet zgłosił ich 1,15 miliona między wrześniem 2025 a wrześniem 2026. Każda strona jest dostępna jako HTML, Markdown, drzewo dostępności i zrzut ekranu. Na tej podstawie Perplexity tworzy BrowseSafe-Guard, dwa detektory o rozmiarze 0,8B dostrojone na bazie Qwen3.5-0.8B, jeden do tekstu, drugi do zrzutów ekranu.
| Opublikowany wynik | BrowseSafe-Guard | Porównywane modele |
|---|---|---|
| F1 dla widoków tekstowych | około 95 %, pierwsze miejsce w każdym widoku | od 85 do 92 % dla najlepszych modeli ogólnego przeznaczenia |
| F1 dla zrzutów ekranu | około 93 % | około 79 % dla najlepszego innego modelu |
| Czyste strony błędnie oznaczone | około 1 na 20 | 14,41 % dla GPT-6 Astra |
| Koszt za 1 000 stron | 0,18 dolara na wynajętym H200 | od 18,95 do 180,61 dolara przez API |
Wykrywanie nie oznacza odporności: każdy model wykonał polecenia z ataków, które sam wcześniej wykrył, od 1,64 % stron w przypadku GPT-6 Astra do 24,73 % w przypadku Llama 3.1 8B. Wytrwały atakujący również w końcu przełamuje zabezpieczenia: w środowisku BrowseSafe-Adapt, które przepisuje wstrzyknięty prompt po każdej porażce (1 024 zadania, do 64 prób), skuteczność rośnie z najwyżej 4 % przy pierwszej próbie do co najmniej 79 % przeciwko pięciu z siedmiu testowanych agentów. Guard zastosowany przed agentem Gemini 3.5 Flash-Lite blokuje 94,5 % pierwotnych ataków, ale atakujący nadal odnosi sukces w 84,2 % zadań. Dostępne są zbiór danych (z kontrolowanym dostępem), SDK na licencji MIT i publiczny ranking; wpis nie zawiera linków do wag detektorów.
🔗 Wpis Perplexity o BrowseSafe++
Media generatywne: Runway Dev trafia do Claude Code i Cursor, Synthesia do ChatGPT i Claude, ElevenLabs mierzy korzyści z głosu
Runway Dev trafia do Claude Code i Cursor
2 listopada — Po Codex, zaprezentowanym 28 października, Runway rozszerza dostępność swoich pluginów Runway Dev na Claude Code i Cursor. Instalacja łączy agenta programistycznego z kontem Runway Dev przez serwer MCP Runway i udostępnia mu skills Runway do pracy z API mediów generatywnych. Agent najpierw odczytuje dane konta (projekty, dostępne modele wraz z ich cenami i limitami, saldo kredytów), a następnie korzysta z oficjalnych SDK: może utworzyć Model Router, który wybiera model odpowiedni do każdego zapytania, lub Character do awatarów działających w czasie rzeczywistym, a także wykorzystywać Recipes (gotowe do użycia pipelines) albo Workflows opublikowane jako punkty dostępu API. W razie niepowodzenia sprawdza szczegóły błędu. Połączenie z kontem następuje przy pierwszym użyciu, bez przechowywania klucza API w pluginie, i nie podano odrębnej ceny.
| Agent programistyczny | Instalacja wskazana przez Runway |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api na czacie Agent lub w Cursor Marketplace |
Synthesia tworzy swoje filmy w ChatGPT i Claude
2 listopada — Synthesia ogłasza, że jej filmy z awatarami można teraz tworzyć bezpośrednio w ChatGPT i Claude: użytkownik opisuje potrzebny film, widzi go w rozmowie, dopracowuje go kolejnymi poleceniami, a następnie publikuje i udostępnia, bez otwierania innej aplikacji ani kolejnej karty. Ogłoszenie ogranicza się do tweeta z filmem demonstracyjnym; w chwili naszego sprawdzenia na blogu ani na stronie głównej Synthesia nie było żadnego wpisu. Synthesia nie podaje w nim mechanizmu integracji, objętych nią planów ani ceny.
ElevenLabs : głos osiąga sukces o 32 % częściej niż chat w rozmowach dłuższych niż dwie minuty
2 listopada — ElevenLabs publikuje badanie porównujące głos (telefon i WhatsApp) z chatem u agentów ElevenAgents działających produkcyjnie, przy czym każdego agenta porównano z nim samym na podstawie jego rozmów od maja do lipca 2026. Tweet z ogłoszeniem wspomina o 469 agentach; sam wpis mówi o „setkach” agentów.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇵🇱 Im dłuższa rozmowa, tym wyższy wskaźnik sukcesu agentów głosowych. Przeanalizowaliśmy 469 agentów działających produkcyjnie zarówno głosowo, jak i na chacie, i zaobserwowaliśmy interesującą tendencję. Gdy rozmowa staje się złożona, głos jest najszybszą drogą do rozwiązania. — @ElevenLabs na X
| Wskaźnik według ElevenLabs | Zmierzona wartość |
|---|---|
| Sukces głosu w rozmowach dłuższych niż dwie minuty | +10,9 punktu, czyli +31,7 % |
| Rozmowy krótsze niż minuta | chat prowadzi o około 9 punktów |
| Czas trwania długich rozmów zakończonych sukcesem | 4,6 minuty głosowo, 7 minut na chacie |
| Przejście na szybszy LLM (315 rozmów) | opóźnienie mniejsze o 16 %, skuteczność większa o 26 % |
| Preferencja dla głosu (98 uczestników, odwołany lot) | 85 % |
Czas trwania służy tutaj jako wskaźnik złożoności, którego niedoskonałość przyznano we wpisie, a badanie pochodzi od dostawcy, który promuje w nim swoich agentów głosowych.
NVIDIA publikuje receptury symulacji Cosmos 3 Nano dla jazdy, robotyki i chirurgii
2 listopada — NVIDIA publikuje na swoim blogu technicznym dwuczęściowy przewodnik po Cosmos, swojej platformie bazowych modeli świata (world foundation models) przeznaczonej dla fizycznej AI: receptury symulacji oparte na nowych checkpointach Cosmos 3 Nano, zapowiedzianych 22 października, a tym razem nazwanych i opisanych, oraz instrukcję korzystania z mikroserwisów NIM. Wyróżniony przykład: wystarczy zmienić prompt, aby przekształcić przejazd za dnia w deszczową noc, bez zmiany przebiegu drogi ani trajektorii pojazdów.
| Checkpoint Cosmos 3 | Zastosowanie opisane przez NVIDIA |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Klipy z wielu kamer z LiDAR do jazdy, do 400 klatek w 480p lub 720p |
| Cosmos3-Nano-Sim-Auto | Wariant przyczynowy poddany destylacji, generujący strumieniowo na potrzeby testowania polityki jazdy w pętli zamkniętej |
| Cosmos3-Nano-Sim-Transfer | Wideo głębi przekształcane w szczegółowe wideo RGB, na potrzeby robotyki |
| Cosmos3-Nano-Sim-Bimanual | Kolejna obserwacja robota z dwoma ramionami na podstawie sceny i jego działań |
| Cosmos3-H-Embodied-Nano i Cosmos3-H-Dreams | Symulacja chirurgiczna na podstawie działań robota, w czasie rzeczywistym dla H-Dreams |
W zakresie wdrażania obraz NIM cosmos3:2.0.0 oferuje profile nastawione na opóźnienie lub przepustowość, a dekodowanie spekulatywne przyspiesza inferencję średnio około 2 do 3 razy na H200, według NVIDIA, która informuje o certyfikacji NIM Cosmos na ponad 20 GPU. Podczas generowania Cosmos3-Nano wymaga 58 Gio VRAM w BF16 oraz 31 Gio w FP8 z offloadingiem. Cosmos Framework zyskuje pipeline’y uczenia ze wzmocnieniem (DPO, GRPO, PPO, OPD, DiffusionNFT), a w czwartek 5 listopada odbędzie się poświęcona mu transmisja na żywo.
Copilot CLI 1.0.106-3 w wersji zapoznawczej: opcjonalne zarządzanie sesjami i 145 poprawek
2 listopada — GitHub publikuje wersję zapoznawczą 1.0.106-3 Copilot CLI, trzecią z gałęzi 1.0.106. Informacje o wydaniu wymieniają tylko jeden dodatek: opcjonalnie włączane narzędzia do zarządzania sesjami (opt-in) oraz możliwość wzmiankowania za pomocą @ lokalnych sesji, w których włączono tę opcję, bez dalszych szczegółów. W przypadku kont zarządzanych ostrzeżenia dotyczące odświeżania polityki uwzględniają teraz ustalenia Policy Helper.
Pozostałe 145 poprawek dotyczy głównie niezawodności interfejsu terminalowego, a kilka z nich ma znaczenie dla bezpieczeństwa:
| Poprawka bezpieczeństwa | Zachowanie przed wersją 1.0.106-3 |
|---|---|
| Filtrowanie sekwencji ucieczki | Odpowiedź, nazwa pliku lub tytuł narzędzia MCP mogły zmienić wygląd osi czasu lub ukryć jej wiersze |
/allow-all off | Gdy po poleceniu następowała spacja ideograficzna (wprowadzanie tekstu CJK), włączało ono Allow All zamiast je wyłączyć |
/session delete | Nieznana opcja umieszczona przed identyfikatorem usuwała bieżącą sesję bez pytania o potwierdzenie |
copilot -p i copilot workflow run | Wynik tekstowy wyświetlał wartości --secret-env-vars, które wynik JSON już ukrywał |
Najnowszą wersją stabilną pozostaje 1.0.105 z 28 października, a SDK Copilot 1.0.29-preview.2, opublikowany tego samego wieczoru, nie zawiera żadnych zmian po stronie SDK.
🔗 Informacje o wydaniu Copilot CLI 1.0.106-3
W skrócie
Agenci i narzędzia do programowania
- Qwen Code v0.26.6 — Wersja stabilna z 2 listopada, dzień po v0.26.5: Web Shell zyskuje widok aktywności sesji i pokazuje dla każdego modelu wskaźnik sukcesu, szybkość generowania oraz opóźnienie pierwszego tokena; modele Kimi K3 otrzymują okno 1 miliona tokenów. 🔗 źródło
- Gemini CLI — Poprawka scalona wieczorem 2 listopada zapobiega uznawaniu modelu Whisper za zainstalowany po przerwanym pobieraniu, co blokowało lokalny tryb głosowy do czasu ręcznego usunięcia pliku. Nie trafiła jeszcze do żadnego wydania, a dzisiejsza wersja nightly korzysta z tego samego commita co dwie poprzednie. 🔗 źródło
- CLI mistral 0.16.0 —
mistral workflows initimistral initproszą teraz o klucz API projektu Workflow, weryfikują go w API Mistral i zapisują w.envprojektu. 🔗 źródło - Plugin Qodo dla Codex — W studium przypadku opublikowanym przez OpenAI Qodo przedstawia swój plugin z marketplace Codex: przed pisaniem kodu Codex otrzymuje reguły organizacji i historię pull requestów, a następnie, w tej samej sesji, recenzję Qodo przed otwarciem pull requesta. Nie podano wyników liczbowych. 🔗 źródło
- corgi, nagłośnione przez Zed — Wieczorem 1 listopada Zed udostępnia stronę corgi, zgodnego z Cargo narzędzia Conrada Irwina do budowania projektów Rust: jeden cache na maszynę, build.rs i makra w sandboxie, wyniki testów w cache. Według autora kod został niemal w całości napisany przez AI. Repozytorium na licencji MIT. 🔗 źródło
Platformy programistyczne i API
- pull_request_target w GitHub Actions — Domyślne blokowanie
pull_request_targetw publicznych repozytoriach zostaje przesunięte z 2 listopada na 2 grudnia; dwie zaplanowane przerwy, 9 i 16 listopada od 16 do 18 UTC, ujawnią workflow, których dotyczy zmiana. 🔗 źródło - Oceny ryzyka na GitHub — Oceny ryzyka związanego z bezpieczeństwem kodu i sekretów wskazują teraz, czy każdy wykryty problem znajduje się w chronionym repozytorium, w GitHub Enterprise Cloud i GitHub Team. 🔗 źródło
- Analytics API Perplexity — Odpowiedzi dotyczące wykorzystania kredytów Computer pomijają obecnie podział według pochodzenia kredytów (Credit Source); nadal podawane są suma i podział według modelu, a Perplexity prosi, by nie interpretować brakującego podziału jako zerowego wykorzystania. 🔗 źródło
Otwarte modele i wpisy społeczności
- kniv v7 od Dragonscale — Sześć otwartych enkoderów mających od 55M do 538M parametrów (Apache-2.0, ONNX), które wyodrębniają encje, relacje i fakty według schematu opisanego w momencie wywołania, bez LLM, na potrzeby pamięci agentów; na Re-DocRED osiągają 0,749 w obrębie jednego zdania i 0,732 przy odstępie dwóch zdań (wariant DeBERTa). 🔗 źródło
- Okno przesuwne i warstwa Bifocal — We wpisie społecznościowym Lukas poddaje Qwen3-4B-Instruct destylacji do czterech modeli uczniowskich o takim samym zużyciu pamięci: okno przesuwne wystarcza do krótkich odpowiedzi, ale na AIME i HMMT jego warstwa Bifocal (małe okno i stan mLSTM) rozwiązuje niemal dwa razy więcej problemów niż samo okno, które zatrzymuje się na około 14 %. Pomiary autora. 🔗 źródło
- Backdoor zablokowany przez ViKernel — VIDRAFT wprowadza poprzez dostrajanie backdoor do Qwen3-0.6B: słowo „payroll” w ścieżce pliku uruchamia złośliwe polecenie w 98,3 % przypadków na wcześniej niewidzianych ścieżkach, a 24 kontrole go nie wykrywają; w ViKernel wszystkie 290 ładunków zostaje odrzuconych przed wykonaniem. Wagi nie zostały opublikowane. 🔗 źródło
- Routing Beam i oszukiwanie w testach — Wcześniej zarejestrowane badanie Rairo Mukamuriego nie pozwala przewidzieć sfałszowania testu z wyprzedzeniem 500 tokenów na podstawie routingu ekspertów Beam-1.0-501B-A23B: AUROC wynosi 0,580 przy ustalonym progu 0,75, a koszt obliczeń to 9,03 dolara. 🔗 źródło
- Saturate — Daniel van Strien ponownie poddaje OCR 14 483 strony archiwów na jednym GPU w Hugging Face Jobs, za 1,47 dolara i z prędkością 8,9 strony na sekundę, korzystając z Saturate, swojej biblioteki na licencji Apache-2.0 do inferencji wsadowej przez dowolny endpoint zgodny z OpenAI. 🔗 źródło
Obraz, wideo, głos i muzyka
- LTX 2.5 na RTX PRO 6000 — Dostawca wynajmu GPU EcoHash renderuje 10-sekundowe wideo 1080p z dźwiękiem w 90 sekund, a w 480p w 14,8 sekundy, na jednej karcie o pojemności 96 Go; pomiary dostawcy we własnej usłudze. 🔗 źródło
- Mobiel AI od KPN — ElevenLabs opisuje asystenta połączeń KPN dla małych firm w Holandii (transkrypcja poczty głosowej, podsumowania rozmów, menu połączeń); dostrajanie pod kątem języka niderlandzkiego zwiększyło dokładność weryfikacji z około 50 % do 90 %. Nie podano cen. 🔗 źródło
- Suno Studio — Informacja z 29 października, przekazana dalej 2 listopada: ustawienia klipu trafiają do paska bocznego, wysokość dźwięku reguluje się w półtonach i centach, importowane audio można rozciągać do tempa projektu, a ścieżki ukrywa się za pomocą Shift-H. 🔗 źródło
- Kling i Chroma Awards — Kling zostaje partnerem sezonu 2 konkursu, w którym pula nagród przekracza 450 000 dolarów; zgłoszenia do 7 stycznia. 🔗 źródło
Programy, demonstracje i wpisy laboratoriów
- Anthropic Residency — Anthropic przyjmuje do 22 listopada zgłoszenia do płatnego programu badawczego trwającego od sześciu tygodni do sześciu miesięcy, przeznaczonego dla profesorów, założycieli firm z zapleczem technicznym i inżynierów na poziomie staff, bez wymogu wcześniejszej wiedzy z uczenia maszynowego; wynagrodzenie odpowiada 350 000 do 500 000 dolarów rocznie. 🔗 źródło
- Data Bot od SpaceXSI — Wewnętrzne studium przypadku: Team Bot w Grok Bot, który pełni funkcję data scientist dla całej firmy, korzystając ze skills utrzymywanych przez zespół data, i który według szacunków SpaceXSI miał wykonać w tydzień pracę zajmującą około 70 godzin. 🔗 źródło
- Le Chonk i chemia kwantowa — Mistral pokazuje na X, jak Mistral Large 4 pisze od zera solver SCF i widok 3D rozpadającej się cząsteczki, bez publikacji kodu ani danych liczbowych. 🔗 źródło
- Październikowe podsumowanie Google — Brak nowych ogłoszeń poza odpowiedzią satelity Project Suncatcher, omówioną wyżej. 🔗 źródło
- Pamięć agentów w Perplexity — Przewodnik po typach pamięci i budowie agenta z pamięcią trwałą, odsyłający do Brain, już dostępnego w Computer. 🔗 źródło
- The Knowledge Talk — Perplexity publikuje transkrypcję przemówienia Aravinda Srinivasa z 3 października w Cambridge Union Society, bez ogłoszeń. 🔗 źródło
Co to oznacza
Message threads przenoszą część stanu rozmowy na serwer bez wpływu na rachunek: tokeny i stawki pozostają takie same, spada jedynie czas oczekiwania, a efekt jest najwyraźniejszy w sesjach agentów gromadzących setki tysięcy tokenów. Wybór nietrwałego wątku, przechowywanego przez 5 minut w zaszyfrowanej pamięci i bez API umożliwiającego jego ponowny odczyt, pozostawia aplikacji kontrolę nad historią, kosztem wyraźnych wykluczeń: brak obsługi ZDR, Batches i organizacji HIPAA. W terminalu wersja zapoznawcza Copilot CLI przypomina, że sam interfejs jest powierzchnią ataku, skoro nazwa pliku lub odpowiedź modelu mogły zmienić wygląd ekranu.
Grid Protectors i Suncatcher odpowiadają na to samo ograniczenie, zapotrzebowanie obliczeń na energię, w dwóch bardzo różnych horyzontach czasowych. OpenAI proponuje możliwość ograniczania poboru energii przez swoje kampusy, aby uzyskać zgodę na ich podłączenie do już obciążonej sieci, obiecując pokrycie własnych kosztów; jedyne liczbowe oszacowanie oszczędności dla gospodarstw domowych pochodzi od Georgia Power i dotyczy wszystkich jej dużych klientów. Google zleciło na razie napisanie haiku układowi TPU na orbicie: to kamień milowy potwierdzający wykonalność, bez danych o wydajności, przed planowanym na 2027 rok połączeniem dwóch satelitów.
LifeVal, Design Creativity Bench i BrowseSafe++ mierzą to, czego nie dostrzegają rankingi programistyczne i matematyczne. LifeVal pokazuje spowalniający postęp, 0,6 punktu między GPT-5.6 a GPT-6 Astra, ale pozostaje wewnętrznym benchmarkiem, bez konkurentów ani opublikowanego zestawu zadań. Kombai wskazuje na upodabnianie się interfejsów, które maskuje wskaźnik sukcesu, a BrowseSafe++ rozdziela wykrywanie od odporności: model, który rozpoznaje atak typu prompt injection, może mimo to wykonać jego instrukcje, a detektor o rozmiarze 0,8B, ponad sto razy tańszy niż wywołanie API, nie wystarcza wobec napastnika podejmującego kolejne próby.
Sakana AI decyduje się kontrolować cały łańcuch dzięki Sawara, od pretrainingu po produkty, ale z warunkowym harmonogramem i bez podania rozmiaru. Runway i Synthesia postępują odwrotnie: pojawiają się tam, gdzie użytkownicy już pracują, w agencie programistycznym lub w rozmowie w ChatGPT i Claude, zamiast przyciągać ich do własnej aplikacji. ElevenLabs dostarcza liczbowego argumentu za głosem w długich rozmowach, na podstawie badania dostawcy, w którym liczba badanych agentów różni się między tweetem a wpisem, podczas gdy NVIDIA wyposaża w narzędzia tych, którzy symulują jazdę, robotykę lub chirurgię za pomocą Cosmos 3 Nano.
Źródła
- Artykuł Anthropic o message threads
- @ClaudeDevs: message threads w Claude Code
- Dokumentacja message threads
- Relacja z sympozjum Sakana AI 2026
- @SakanaAILabs: relacja z sympozjum
- Przedstawiamy Grid Protectors Program (OpenAI)
- Pierwsza odpowiedź prototypowego satelity Project Suncatcher (Google)
- LifeVal (OpenAI)
- Dlaczego stworzyliśmy Design Creativity Bench (Kombai)
- BrowseSafe++ (Perplexity)
- Wtyczki Runway Dev dla agentów programistycznych
- @synthesiaIO: filmy Synthesia w ChatGPT i Claude
- Dlaczego głos sprawdza się najlepiej w złożonych, stresujących rozmowach (ElevenLabs)
- @ElevenLabs: badanie porównujące rozmowy głosowe i czat
- Twórz modele świata do interaktywnej symulacji za pomocą NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 w Gemini CLI
- CLI mistral 0.16.0
- Studium przypadku Qodo i Codex (OpenAI)
- @zeddotdev: corgi
- Domyślna blokada pull_request_target 2 grudnia (GitHub)
- Oceny ryzyka uwzględniają stan ochrony repozytoriów (GitHub)
- Changelog API Perplexity
- Wpis Dragonscale o kniv v7
- Wpis o oknie przesuwnym i Bifocal
- Wpis VIDRAFT o tylnej furtce
- Wpis Rairo Mukamuriego o Beam
- @vanstriendaniel: Saturate
- Wpis EcoHash o LTX 2.5
- Mobiel AI od KPN (ElevenLabs)
- Informacje o wydaniu Suno Studio
- @Kling_ai: sezon 2 Chroma Awards
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk i solver SCF
- Ogłoszenia Google dotyczące AI w październiku 2026
- Pamięć agentów AI (Perplexity)
- Rozmowa o wiedzy (Perplexity)