ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
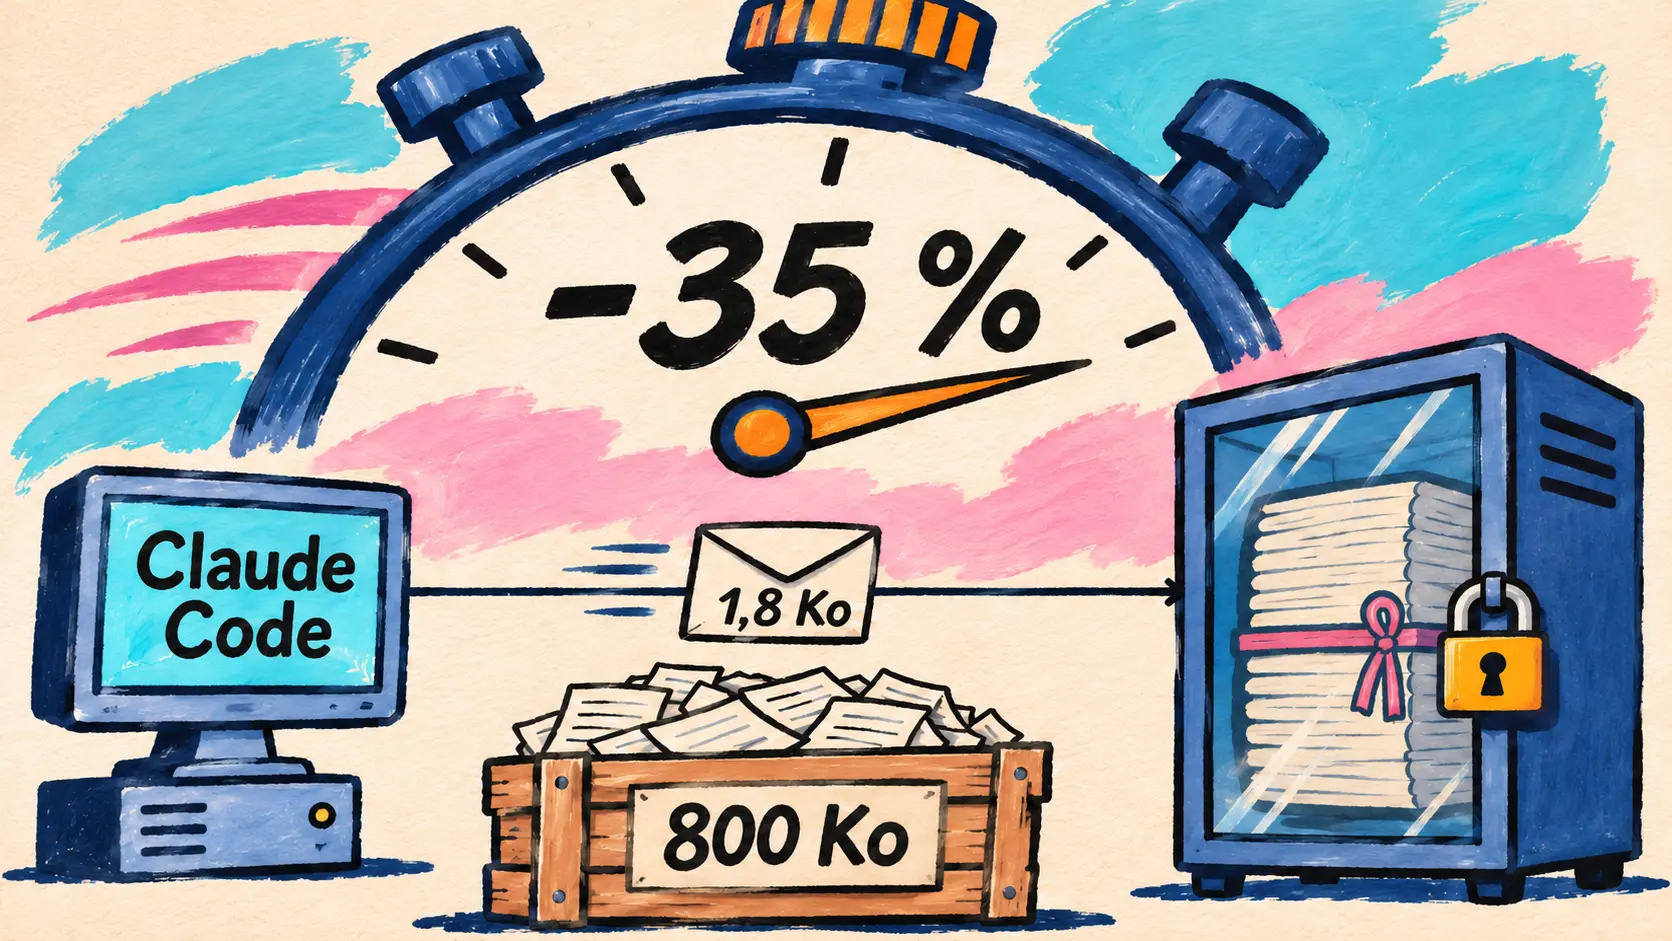
Anthropic startet die öffentliche Beta für die message threads der Messages API, die bereits in Claude Code aktiv sind und dort bei den längsten Anfragen die Zeit bis zum ersten Token um etwa 35 % verkürzen. Sakana AI kündigt Sawara an, seine ersten von Grund auf vortrainierten Modelle, während OpenAI Grid Protectors startet, damit seine Rechenzentrumsstandorte ihren Stromverbrauch zur Entlastung des Stromnetzes senken können, und LifeVal veröffentlicht, einen Benchmark für Alltagsaufgaben. Perplexity veröffentlicht BrowseSafe++ gegen Prompt Injection, NVIDIA stattet die Simulation mit Cosmos 3 Nano aus, und Runway, Synthesia und ElevenLabs bringen generative Medien in Assistenten und Agenten.
Die Messages API startet die öffentliche Beta für message threads, die bereits in Claude Code aktiv sind
2. November — Anthropic startet die öffentliche Beta für Nachrichten-Threads (message threads) in der Messages API. Bisher übermittelte ein Agent bei jedem Durchlauf die gesamte Unterhaltung einschließlich der Tool-Ergebnisse erneut. Mit einem Thread sendet die erste Anfrage die vollständige Unterhaltung mit System-Prompt und Tools; die folgenden senden nur die neuen Nachrichten und die Kennung der vorherigen Antwort, und die API rekonstruiert den Rest vor dem Modellaufruf. Es genügt, den Parameter thread und den Beta-Header message-threads-2026-08-12 hinzuzufügen, die von den offiziellen SDKs über eine eigene Hilfsfunktion verwaltet werden.
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇩🇪 Wir haben message threads kürzlich in Claude Code integriert. Bei Anfragen mit 500 000 bis 1 Million Tokens ist die mediane Zeit bis zum ersten Token um etwa 35 % kürzer. In langen Unterhaltungen sank die mediane Anfragegröße von etwa 800 Ko auf 1,8 Ko. — @ClaudeDevs auf X
Der Vorteil betrifft die Latenz, nicht die Rechnung: Claude liest bei jedem Durchlauf die gesamte Unterhaltung erneut, sodass Tokens, Preise und Rate Limits unverändert bleiben, und Prompt Caching (prompt caching) muss weiterhin selbst angefordert werden. Der Thread wird nach Möglichkeit (best-effort) im verschlüsselten Arbeitsspeicher und niemals auf der Festplatte gespeichert: Er verfällt 5 Minuten nach der letzten Anfrage, und die Anwendung behält ihre eigene Kopie, um alles erneut zu senden, falls die API mit 404 antwortet. Die Funktion ist nicht für Zero Data Retention (ZDR) geeignet und funktioniert weder mit Message Batches noch mit der Kompaktierung auf Abruf oder in HIPAA-Organisationen. Sie ist über die Claude API, Claude Platform on AWS, Claude in Microsoft Foundry und Claude Models on Google Cloud (Anthropic managed) verfügbar.
🔗 Anthropics Artikel zu message threads · Die Dokumentation zu message threads
Sakana AI kündigt Sawara an, seine ersten von Grund auf vortrainierten Modelle, deren Gewichte im Frühjahr 2027 erscheinen sollen
2. November — Sakana AI veröffentlicht den Bericht über sein Symposium vom 26. Oktober in Tokio mit mehr als 400 Teilnehmenden und einem Vortrag von Jürgen Schmidhuber. Er enthält eine handfeste Ankündigung: Das japanische Start-up wird eigene Sprachmodelle vortrainieren. Bisher arbeitete es an Agenten und am Post-Training bestehender offener Modelle mit Namazu. Die von Forschungsleiter (Chief Scientist) Takuya Akiba vorgestellte Sawara-Reihe (vorläufiger Name) wird von Grund auf entwickelt, ohne auf einem Modell eines Drittanbieters aufzubauen, und ist für den Einsatz als Agent (agent-native) konzipiert: Reasoning mit Tools, Code und langwierige Aufgaben. Sie soll als Grundlage für die Produkte von Sakana AI und die Forschung des RSI Lab zur rekursiven Selbstverbesserung dienen.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇩🇪 Wir bereiten jetzt das Training vor und werden im Dezember mit dem Pretraining von Sawara Small (vorläufiger Name) beginnen. Wenn alles gut läuft, werden wir die Gewichte im kommenden Frühjahr veröffentlichen. — Sakana AI, Bericht zum Symposium 2026
Ein Sawara Large, ebenfalls ein vorläufiger Name, soll folgen, allerdings ohne Termin. Sakana AI nennt weder Modellgröße noch Datenvolumen oder Rechenbudget.
🔗 Sakana AIs Ankündigung auf X
Energie für Rechenleistung: OpenAI startet Grid Protectors, eine TPU von Google antwortet aus der Umlaufbahn
OpenAI startet Grid Protectors mit bis zu 1 000 MW Lastreduktion für seinen Campus in Effingham
2. November — OpenAI startet Grid Protectors, ein landesweites Programm, mit dem seine künftigen Rechenzentrumsstandorte ihren Verbrauch reduzieren sollen, wenn das Stromnetz belastet ist, etwa während einer Kälte- oder Hitzewelle. Gemeinsam mit Stromversorgern, Regulierungsbehörden und politischen Entscheidungsträgern will das Unternehmen für jeden Standort Vereinbarungen treffen, die den Umfang der Lastreduktion, die Reaktionszeit und die Dauer festlegen. Je nach örtlichem Bedarf können die Standorte auch auf Stromerzeugung oder Speicherung vor Ort zurückgreifen und ihre Nachfrage mithilfe von Batterien glätten.
Als Pilot dient der geplante Campus im Effingham County in Georgia, der im Juli unter dem Namen Project Camellia vorgestellt wurde. OpenAI verpflichtet sich, dort sämtliche Kosten für die Infrastruktur und die Stromversorgung zu tragen.
| Angekündigte Kennzahl | Angekündigter Wert | Quelle der Kennzahl |
|---|---|---|
| In der Vereinbarung mit Georgia Power vorgesehene flexible Lastreduktion | bis zu 1 000 MW | OpenAI |
| Entsprechende durchschnittliche Stromnachfrage von Haushalten | etwa 700 000 Haushalte | OpenAI |
| Jährliche Einsparungen für Kunden von Georgia Power ab 2029 | etwa 950 Millionen Dollar | Georgia Power |
| Vorteil für einen typischen Privatkunden mit einem Verbrauch von 1 000 kWh | mindestens 15 Dollar pro Monat | Georgia Power |
Die Prognose von Georgia Power bezieht sich auf sämtliche Vereinbarungen mit Großverbrauchern und das erwartete Wachstum einschließlich Project Camellia: Sie ist keine spezifische Kennzahl für das Programm von OpenAI. Das Unternehmen räumt ein, dass Flexibilität Investitionen in neue Erzeugungs- und Übertragungskapazitäten nicht ersetzt, und kündigt weder einen weiteren Standort noch einen Zeitplan an.
🔗 OpenAIs Beitrag zu Grid Protectors
Project Suncatcher: Eine TPU in der Umlaufbahn liefert ihre erste Antwort, ein von Gemma 4 geschriebenes Haiku
30. Oktober — Nachtrag: Einen Monat nach dem Start seines Prototyp-Satelliten am 1. Oktober erreicht Project Suncatcher, Googles Forschungsprojekt zu KI-Rechenleistung im Weltraum, seinen „Hello World“-Meilenstein: die erste KI-Antwort, die von einer TPU der Rechenzentrumsklasse in der Umlaufbahn erzeugt wurde. Während eines Überflugs über eine Bodenstation bat das Team das an Bord befindliche offene Modell Gemma 4 um ein Haiku über das Leben im Weltraum; die Antwort wurde zur Erde übertragen, als der Satellit Spitzbergen in Norwegen überflog. Es folgten Limericks und Telemetrie-Prompts, auf die das Modell mit Beschreibungen des technischen Zustands der Nutzlast antwortet.
Als Nächstes geht es um die Zuverlässigkeit: Die TPU werden unter thermischer Belastung und Strahlung getestet, bevor 2027 ein Paar miteinander verbundener Satelliten folgt. Der Beitrag nennt keine Zahlen zur Leistung oder zum Verbrauch.
🔗 Googles Beitrag zur ersten Antwort des Satelliten
Alltag und Kreativität von Benutzeroberflächen: OpenAI veröffentlicht LifeVal, Kombai veröffentlicht Design Creativity Bench
LifeVal: 169 Alltagsaufgaben, von 49,3 % für GPT-5.2 bis 80,6 % für GPT-6 Astra
2. November — OpenAI veröffentlicht LifeVal, eine Bewertung von Modellen anhand von Alltagsaufgaben: Kinderbetreuung finden, öffentliche Dienstleistungen in Anspruch nehmen, ein Budget aufstellen, ein Rezept anpassen oder einen Trainingsplan erstellen. Die Aufgaben stützen sich auf zwei große Zeitverwendungserhebungen, die American Time Use Survey und die Multinational Time Use Study, ergänzt um eine repräsentative Befragung von 3 995 Personen zu den Bereichen, in denen sie sich am meisten Unterstützung wünschen. OpenAI gibt an, LifeVal seit einem Jahr zur Beobachtung seiner Modelle einzusetzen.
| Bewertetes Modell | Veröffentlichungsdatum | Durchschnittliche Belohnung bei 169 Aufgaben |
|---|---|---|
| GPT-5.2 | Dezember 2025 | 49,3 % |
| GPT-5.4 | März 2026 | 73,0 % |
| GPT-5.5 | April 2026 | 77,4 % |
| GPT-5.6 | Juli 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | September 2026 | 80,6 % |
Laut Beschreibung der Grafik handelt es sich um einen ungewichteten Durchschnitt der 169 Aufgaben, und nur 0,6 Punkte trennen GPT-5.6 von GPT-6 Astra. Die Grafik enthält weder GPT-6.1 Sol oder Terra noch Modelle anderer Anbieter, und OpenAI erwähnt keine Veröffentlichung des Aufgabensatzes.
Design Creativity Bench: Die Modelle nähern sich denselben Benutzeroberflächen an
2. November — Kombai, ein Anbieter von KI-Tools für die Frontend-Entwicklung, stellt im Blog von Hugging Face Design Creativity Bench vor, einen Benchmark, der nicht misst, ob eine Benutzeroberfläche funktioniert, sondern ob sie anderen ähnelt. Die Studie umfasst 15 Spitzenmodelle, 160 Anweisungen und 2 400 HTML-Benutzeroberflächen, die mit von Menschen erstellten Entwürfen verglichen werden.
| Messgröße des Benchmarks | Bewertete Modelle | Menschliche Referenz |
|---|---|---|
| Durchschnittliche Unterscheidbarkeit bei derselben Anweisung | 0,592 zwischen Modellen | 0,764 zwischen Menschen und Modellen |
| Durchschnittliche kreative Bandbreite | 0,581 | 0,902 |
| Erfüllte Akzeptanzkriterien | über 90 % bei allen (Claude Opus 5.5: 99,2 %) | 98,0 % |
Die Modelle erfüllen also die Vorgaben, ähneln einander aber. GPT-6 Astra hat den eigenständigsten Stil im Vergleichsfeld (0,646 Originalität), variiert jedoch wenig zwischen unterschiedlichen Kontexten (0,472 Bandbreite). Kombai veröffentlicht den Artikel (arXiv 2610.11539), eine Rangliste und eine Teilmenge zur Reproduktion der Ergebnisse und benennt die Grenzen der Studie: ausschließlich Desktop-Ansichten und Standardeinstellungen der APIs.
🔗 Kombais Beitrag auf Hugging Face
Perplexity veröffentlicht BrowseSafe++ und seine BrowseSafe-Guard-Detektoren gegen Prompt Injection
2. November — Das Perplexity Secure Intelligence Institute veröffentlicht BrowseSafe++, den Nachfolger von BrowseSafe (Dezember 2025), einen offenen Benchmark für indirekte Prompt Injection (indirect prompt injection), die sich gegen Agenten richtet, die im Web navigieren können. Er umfasst 38 675 Seitenpaare aus jeweils einer angegriffenen Seite und ihrer sauberen Zwillingsseite, darunter 32 187, die auf tatsächlich beobachteten Injections beruhen: Der Detektor von Comet meldete zwischen September 2025 und September 2026 insgesamt 1,15 Millionen davon. Jede Seite liegt als HTML, Markdown, Accessibility Tree und Screenshot vor. Daraus entwickelt Perplexity BrowseSafe-Guard, zwei auf Qwen3.5-0.8B basierende, feinabgestimmte 0,8B-Detektoren, einen für Text und einen für Screenshots.
| Veröffentlichtes Ergebnis | BrowseSafe-Guard | Vergleichsmodelle |
|---|---|---|
| F1 bei Textansichten | etwa 95 %, Erster in jeder Ansicht | 85 bis 92 % bei den besten Allzweckmodellen |
| F1 bei Screenshots | etwa 93 % | etwa 79 % beim besten anderen Modell |
| Fälschlich gemeldete saubere Seiten | etwa 1 von 20 | 14,41 % bei GPT-6 Astra |
| Kosten für 1 000 Seiten | 0,18 Dollar auf einem gemieteten H200 | 18,95 bis 180,61 Dollar per API |
Erkennen bedeutet nicht, widerstehen zu können: Jedes Modell befolgte Injections, die es selbst erkannt hatte, von 1,64 % der Seiten bei GPT-6 Astra bis zu 24,73 % bei Llama 3.1 8B. Auch ein hartnäckiger Angreifer kommt letztlich durch: In der Umgebung BrowseSafe-Adapt, die die Injection nach jedem Fehlschlag umschreibt (1 024 Aufgaben, bis zu 64 Versuche), steigt die Erfolgsquote von höchstens 4 % beim ersten Versuch auf mindestens 79 % gegen fünf der sieben getesteten Agenten. Als vorgeschalteter Filter für einen Agenten mit Gemini 3.5 Flash-Lite blockiert Guard 94,5 % der ursprünglichen Injections, doch der Angreifer ist weiterhin bei 84,2 % der Aufgaben erfolgreich. Der Datensatz mit kontrolliertem Zugang, ein SDK unter MIT-Lizenz und eine öffentliche Rangliste sind verfügbar; der Beitrag verlinkt keine Gewichte der Detektoren.
🔗 Perplexitys Beitrag zu BrowseSafe++
Generative Medien: Runway Dev kommt in Claude Code und Cursor, Synthesia in ChatGPT und Claude, ElevenLabs beziffert den Vorteil der Stimme
Runway Dev kommt in Claude Code und Cursor
2. November — Nach der Vorstellung für Codex am 28. Oktober erweitert Runway seine Runway-Dev-Plugins auf Claude Code und Cursor. Eine Installation verbindet den Coding-Agenten über den MCP-Server von Runway mit dem Runway-Dev-Konto und ergänzt ihn um die Skills von Runway für die Entwicklung mit seiner API für generative Medien. Der Agent liest zunächst die Kontoinformationen aus: Projekte, verfügbare Modelle mit ihren Preisen und Limits sowie das Guthaben. Anschließend greift er auf die offiziellen SDKs zurück: Er kann einen Model Router erstellen, der für jede Anfrage das passende Modell auswählt, oder einen Character für Echtzeit-Avatare und die Recipes (einsatzbereite Pipelines) oder die als API-Endpunkte veröffentlichten Workflows wiederverwenden. Bei einem Fehlschlag ruft er die Fehlerdetails ab. Die Verbindung zum Konto erfolgt bei der ersten Nutzung, ohne dass ein API-Schlüssel im Plugin gespeichert wird; ein gesonderter Preis wird nicht genannt.
| Coding-Agent | Von Runway angegebene Installation |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api im Agent-Chat oder über den Cursor Marketplace |
Synthesia erstellt seine Videos in ChatGPT und Claude
2. November — Synthesia kündigt an, dass sich seine Avatar-Videos nun direkt in ChatGPT und Claude erstellen lassen: Der Nutzer beschreibt das gewünschte Video, sieht es in der Unterhaltung erscheinen, passt es durch weitere Anweisungen an und veröffentlicht und teilt es anschließend, ohne eine weitere Anwendung oder einen weiteren Tab zu öffnen. Die Ankündigung besteht aus einem Tweet mit einem Demo-Video; zum Zeitpunkt unserer Erhebung war weder im Blog noch auf der Startseite von Synthesia ein Beitrag dazu zu finden. Synthesia nennt darin weder den Integrationsmechanismus noch die betreffenden Tarife oder den Preis.
🔗 Synthesias Ankündigung auf X
ElevenLabs: Sprache ist bei Gesprächen über zwei Minuten 32 % häufiger erfolgreich als Chat
2. November — ElevenLabs veröffentlicht eine Studie, die Sprachkommunikation (Telefon und WhatsApp) und Chat bei ElevenAgents-Agenten im Produktivbetrieb vergleicht. Dabei wird jeder Agent anhand seiner Gespräche von Mai bis Juli 2026 mit sich selbst verglichen. Der Ankündigungstweet nennt 469 Agenten; der Blogbeitrag spricht dagegen von „Hunderten“ Agenten.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇩🇪 Je länger das Gespräch, desto höher die Erfolgsquote von Sprachagenten. Wir haben 469 Agenten analysiert, die im Produktivbetrieb sowohl per Sprache als auch per Chat arbeiten, und einen interessanten Trend beobachtet. Wenn das Gespräch komplex wird, ist Sprache der schnellste Weg zur Lösung. — @ElevenLabs auf X
| Kennzahl laut ElevenLabs | Gemessener Wert |
|---|---|
| Erfolg der Sprachkommunikation bei über zwei Minuten | +10,9 Punkte, also +31,7 % |
| Gespräche unter einer Minute | Chat liegt um etwa 9 Punkte vorn |
| Dauer erfolgreicher langer Gespräche | 4,6 Minuten per Sprache, 7 Minuten per Chat |
| Wechsel zu einem schnelleren LLM (315 Gespräche) | Latenz um 16 % gesunken, Erfolg um 26 % gestiegen |
| Präferenz für Sprache (98 Teilnehmer, annullierter Flug) | 85 % |
Die Dauer dient hier als Indikator für Komplexität, was der Blogbeitrag selbst als unvollkommen einräumt. Zudem stammt die Studie vom Anbieter, der darin seine Sprachagenten bewirbt.
🔗 Der Blogbeitrag von ElevenLabs
NVIDIA veröffentlicht Simulationsrezepte mit Cosmos 3 Nano für Fahren, Robotik und Chirurgie
2. November — NVIDIA veröffentlicht auf seinem technischen Blog eine zweiteilige Anleitung für Cosmos, seine Plattform für Weltmodelle (world foundation models) für physische KI: Simulationsrezepte auf Basis neuer Cosmos 3 Nano-Checkpoints, die am 22. Oktober angekündigt und nun benannt und beschrieben werden, gefolgt von einer Anleitung für die NIM-Microservices. Das hervorgehobene Beispiel: Eine Änderung des Prompts genügt, um eine Fahrt bei Tag in eine regnerische Nacht zu verwandeln, ohne den Straßenverlauf oder die Fahrzeugtrajektorien zu verändern.
| Cosmos 3-Checkpoint | Von NVIDIA beschriebener Einsatz |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Multi-Kamera-Clips mit LiDAR für das Fahren, bis zu 400 Bilder in 480p oder 720p |
| Cosmos3-Nano-Sim-Auto | Destillierte kausale Variante, die im Stream generiert, um eine Fahrstrategie im geschlossenen Regelkreis zu testen |
| Cosmos3-Nano-Sim-Transfer | Tiefenvideo wird für die Robotik in detailliertes RGB-Video umgewandelt |
| Cosmos3-Nano-Sim-Bimanual | Nächste Beobachtung eines zweiarmigen Roboters anhand der Szene und seiner Aktionen |
| Cosmos3-H-Embodied-Nano und Cosmos3-H-Dreams | Chirurgische Simulation anhand der Roboteraktionen, bei H-Dreams in Echtzeit |
Für das Deployment bietet das NIM-Image cosmos3:2.0.0 Profile für Latenz oder Durchsatz. Spekulatives Decoding beschleunigt die Inferenz auf H200 laut NVIDIA im Durchschnitt um etwa den Faktor 2 bis 3; das Unternehmen kündigt außerdem Cosmos-NIMs an, die auf mehr als 20 GPU zertifiziert sind. Bei der Generierung benötigt Cosmos3-Nano 58 Gio VRAM in BF16 und 31 Gio in FP8 mit Offloading. Cosmos Framework erhält Pipelines für Reinforcement Learning (DPO, GRPO, PPO, OPD, DiffusionNFT), und am Donnerstag, dem 5. November, ist ihm ein Livestream gewidmet.
🔗 Der technische Blogbeitrag von NVIDIA
Copilot CLI 1.0.106-3 als Vorabversion: optionale Sitzungsverwaltung und 145 Korrekturen
2. November — GitHub veröffentlicht die Vorabversion 1.0.106-3 von Copilot CLI, die dritte im Zweig 1.0.106. Die Versionshinweise nennen nur eine Neuerung: optional aktivierbare Tools zur Sitzungsverwaltung (opt-in) und die Möglichkeit, lokale Sitzungen, für die diese aktiviert wurden, mit @ zu erwähnen. Weitere Details fehlen. Bei verwalteten Konten übernehmen die Warnungen zur Aktualisierung von Richtlinien nun die Befunde des Policy Helper.
Die übrigen 145 Korrekturen betreffen vor allem die Robustheit der Terminaloberfläche, mehrere davon sind sicherheitsrelevant:
| Sicherheitskorrektur | Verhalten vor 1.0.106-3 |
|---|---|
| Gefilterte Escape-Sequenzen | Eine Antwort, ein Dateiname oder ein MCP-Tool-Titel konnte die Darstellung der Timeline verändern oder Zeilen ausblenden |
/allow-all off | Folgte ein ideografisches Leerzeichen (CJK-Eingabe), aktivierte der Befehl Allow All, anstatt es abzuschalten |
/session delete | Eine unbekannte Option vor der Kennung löschte die aktuelle Sitzung, ohne eine Bestätigung anzufordern |
copilot -p und copilot workflow run | Die Textausgabe zeigte die Werte von --secret-env-vars an, die in der JSON-Ausgabe bereits verborgen waren |
Die neueste stabile Version bleibt 1.0.105 vom 28. Oktober. Das am selben Abend veröffentlichte Copilot SDK 1.0.29-preview.2 enthält keine Änderungen am SDK.
🔗 Die Versionshinweise zu Copilot CLI 1.0.106-3
Kurzmeldungen
Agenten und Coding-Tools
- Qwen Code v0.26.6 — Stabile Version vom 2. November, einen Tag nach v0.26.5: Die Web Shell erhält eine Aktivitätsansicht für Sitzungen und zeigt für jedes Modell Erfolgsquote, Ausgabegeschwindigkeit und Latenz bis zum ersten Token an; die Kimi K3-Modelle erhalten ihr Kontextfenster von 1 Million Tokens. 🔗 Quelle
- Gemini CLI — Ein am Abend des 2. November zusammengeführter Fix verhindert, dass ein abgebrochener Download des Whisper-Modells als installiertes Modell gilt. Dies hatte den lokalen Sprachmodus bis zur manuellen Löschung der Datei blockiert. Der Fix ist noch in keiner Version enthalten, und die heutige Nightly verwendet denselben Commit wie die beiden vorherigen. 🔗 Quelle
- CLI mistral 0.16.0 —
mistral workflows initundmistral initfragen nun nach dem API-Schlüssel eines Workflow-Projekts, überprüfen ihn über die Mistral-API und speichern ihn in.envdes Projekts. 🔗 Quelle - Qodo-Plugin für Codex — In einer von OpenAI veröffentlichten Fallstudie stellt Qodo sein Plugin aus dem Codex-Marketplace vor: Codex erhält vor dem Schreiben die Regeln der Organisation und die Historie der Pull Requests, anschließend das Review von Qodo in derselben Sitzung, bevor der Pull Request eröffnet wird. Keine Ergebniszahlen. 🔗 Quelle
- corgi, von Zed geteilt — Am Abend des 1. November teilt Zed die Website von corgi, Conrad Irwins Cargo-kompatiblem Build-Tool für Rust: ein einziger Cache pro Rechner, build.rs und Makros in einer Sandbox, gecachte Tests. Laut seinem Autor wurde der Code fast vollständig von KI geschrieben. Repository unter MIT-Lizenz. 🔗 Quelle
Entwicklungsplattformen und APIs
- pull_request_target in GitHub Actions — Die standardmäßige Sperrung von
pull_request_targetin öffentlichen Repositorys wird vom 2. November auf den 2. Dezember verschoben; zwei geplante Abschaltungen am 9. und 16. November von 16 h bis 18 h UTC zeigen, welche Workflows betroffen sind. 🔗 Quelle - Risikobewertungen von GitHub — Die Risikobewertungen zur Sicherheit von Code und Secrets zeigen auf GitHub Enterprise Cloud und GitHub Team nun für jeden Befund an, ob er sich in einem geschützten Repository befindet oder nicht. 🔗 Quelle
- Analytics API von Perplexity — Die Antworten zur Nutzung von Computer-Credits enthalten vorerst keine Aufschlüsselung nach Herkunft der Credits (Credit Source); die Gesamtsumme und die Aufschlüsselung nach Modell werden weiterhin geliefert. Perplexity bittet darum, eine fehlende Aufschlüsselung nicht als fehlende Nutzung zu deuten. 🔗 Quelle
Offene Modelle und Community-Beiträge
- kniv v7 von Dragonscale — Sechs offene Encoder mit 55M bis 538M Parametern (Apache-2.0, ONNX), die anhand eines beim Aufruf beschriebenen Schemas ohne LLM Entitäten, Beziehungen und Fakten für das Gedächtnis von Agenten extrahieren; auf Re-DocRED 0,749 innerhalb desselben Satzes und 0,732 bei einem Abstand von zwei Sätzen (DeBERTa-Variante). 🔗 Quelle
- Gleitendes Fenster und Bifocal-Schicht — In einem Community-Beitrag destilliert Lukas Qwen3-4B-Instruct in vier Schülermodelle mit gleichem Speicherbudget: Das gleitende Fenster reicht für kurze Antworten aus, doch auf AIME und HMMT löst seine Bifocal-Schicht (kleines Fenster und mLSTM-Zustand) fast doppelt so viele Aufgaben wie das Fenster allein, das bei etwa 14 % stagniert. Messungen des Autors. 🔗 Quelle
- Durch ViKernel blockierte Backdoor — VIDRAFT schleust durch Fine-Tuning eine Backdoor in Qwen3-0.6B ein: Das Wort „payroll“ in einem Dateipfad löst bei zuvor unbekannten Pfaden in 98,3 % der Fälle den schädlichen Befehl aus, ohne dass eine der 24 Prüfungen ihn erkennt; unter ViKernel werden die 290 Payloads vor der Ausführung abgewiesen. Modellgewichte nicht veröffentlicht. 🔗 Quelle
- Routing von Beam und Testmanipulationen — Einer vorab registrierten Studie von Rairo Mukamuri gelingt es nicht, anhand des Experten-Routings von Beam-1.0-501B-A23B eine Testmanipulation 500 Tokens im Voraus vorherzusagen: AUROC von 0,580 gegenüber einem festgelegten Schwellenwert von 0,75, bei Rechenkosten von 9,03 Dollar. 🔗 Quelle
- Saturate — Daniel van Strien verarbeitet 14 483 Archivseiten erneut per OCR auf einer einzigen GPU von Hugging Face Jobs, für 1,47 Dollar und mit 8,9 Seiten pro Sekunde. Dafür nutzt er Saturate, seine Apache-2.0-Bibliothek für Batch-Inferenz über beliebige OpenAI-kompatible Endpunkte. 🔗 Quelle
Bild, Video, Sprache und Musik
- LTX 2.5 auf einer RTX PRO 6000 — Der GPU-Vermieter EcoHash rendert ein 10 Sekunden langes 1080p-Video mit Ton in 90 Sekunden und in 480p in 14,8 Sekunden, auf einer einzigen Karte mit 96 Go; Messungen des Anbieters auf seinem eigenen Dienst. 🔗 Quelle
- Mobiel AI von KPN — ElevenLabs beschreibt den Anrufassistenten von KPN für niederländische Kleinunternehmen (Voicemail-Transkription, Anrufzusammenfassungen, Anrufmenü); durch Fine-Tuning für Niederländisch stieg die Genauigkeit bei der Überprüfung von etwa 50 % auf 90 %. Keine Preisangabe. 🔗 Quelle
- Suno Studio — Nachtrag vom 29. Oktober, am 2. November geteilt: Die Clip-Einstellungen wandern in eine Seitenleiste, die Tonhöhe lässt sich in Halbtönen und Cents einstellen, importiertes Audio lässt sich auf das Projekttempo stretchen und Spuren lassen sich mit Shift-H ausblenden. 🔗 Quelle
- Kling und die Chroma Awards — Kling wird Partner der Saison 2 des Wettbewerbs mit mehr als 450 000 Dollar Preisgeld; Einreichungen bis zum 7. Januar. 🔗 Quelle
Programme, Demos und Beiträge der Labore
- Anthropic Residency — Anthropic nimmt bis zum 22. November Bewerbungen für ein bezahltes Forschungsprogramm von sechs Wochen bis sechs Monaten entgegen. Es richtet sich an Professoren, technische Gründer und Ingenieure auf Staff-Level, ohne vorausgesetzte Kenntnisse in Machine Learning; die Vergütung entspricht 350 000 bis 500 000 Dollar pro Jahr. 🔗 Quelle
- Data Bot von SpaceXSI — Interne Fallstudie: ein Team Bot von Grok Bot, der auf Grundlage von Skills, die das Datenteam pflegt, als Data Scientist für das gesamte Unternehmen agiert und laut einer Schätzung von SpaceXSI in einer Woche rund 70 Arbeitsstunden übernommen haben soll. 🔗 Quelle
- Le Chonk und Quantenchemie — Mistral zeigt auf X, wie Mistral Large 4 von Grund auf einen SCF-Solver und eine 3D-Ansicht eines auseinanderbrechenden Moleküls schreibt, ohne Code oder Zahlen zu veröffentlichen. 🔗 Quelle
- Googles Oktober-Rückblick — Keine neue Ankündigung außer der weiter oben behandelten Antwort des Satelliten von Project Suncatcher. 🔗 Quelle
- Gedächtnis von Agenten bei Perplexity — Ein Leitfaden zu Gedächtnistypen und zum Aufbau eines Agenten mit dauerhaftem Gedächtnis, der auf Brain verweist, das bereits in Computer verfügbar ist. 🔗 Quelle
- The Knowledge Talk — Perplexity veröffentlicht das Transkript von Aravind Srinivas’ Rede vom 3. Oktober bei der Cambridge Union Society, ohne Ankündigung. 🔗 Quelle
Was das bedeutet
Die message threads verlagern einen Teil des Gesprächszustands auf den Server, ohne die Rechnung zu verändern: Tokens und Preise bleiben gleich, nur die Wartezeit sinkt. Am deutlichsten zeigt sich der Effekt bei Agentensitzungen, in denen sich Hunderttausende Tokens ansammeln. Die Entscheidung für einen flüchtigen Thread, der 5 Minuten im verschlüsselten Arbeitsspeicher bleibt und für den es keine API zum erneuten Lesen gibt, belässt die Kontrolle über den Verlauf bei der Anwendung, geht aber mit klaren Ausschlüssen einher: weder ZDR noch Batches noch HIPAA-Organisationen. Im Terminal erinnert die Vorabversion von Copilot CLI daran, dass die Benutzeroberfläche selbst eine Angriffsfläche ist, weil ein Dateiname oder eine Modellantwort die Bildschirmdarstellung verändern konnte.
Grid Protectors und Suncatcher reagieren auf denselben begrenzenden Faktor, den Energiebedarf für Rechenleistung, mit zwei sehr unterschiedlichen Zeithorizonten. OpenAI schlägt vor, den Stromverbrauch seiner Campus bei Bedarf zu drosseln, um in einem bereits angespannten Stromnetz akzeptiert zu werden, und verspricht, seine eigenen Kosten zu tragen; die einzige bezifferte Ersparnis für Haushalte stammt von Georgia Power und bezieht sich auf alle Großkunden des Unternehmens. Google lässt derzeit eine TPU im Orbit ein Haiku schreiben: ein Meilenstein für die Machbarkeit, ohne Leistungszahlen, bevor 2027 zwei miteinander verbundene Satelliten folgen.
LifeVal, Design Creativity Bench und BrowseSafe++ messen, was Ranglisten für Code und Mathematik nicht erfassen. LifeVal zeigt einen sich verlangsamenden Fortschritt, 0,6 Punkte zwischen GPT-5.6 und GPT-6 Astra, bleibt aber ein interner Benchmark, ohne Wettbewerber oder veröffentlichten Aufgabensatz. Kombai weist auf eine Konvergenz der Benutzeroberflächen hin, die von der Erfolgsquote verdeckt wird, und BrowseSafe++ trennt Erkennung und Widerstandsfähigkeit: Ein Modell, das eine Injection erkennt, kann ihr trotzdem folgen, und ein 0,8B-Detektor, der mehr als hundertmal günstiger ist als ein API-Aufruf, reicht gegen einen Angreifer, der es wiederholt versucht, nicht aus.
Sakana AI entscheidet sich dafür, mit Sawara die gesamte Kette vom Pretraining bis zu den Produkten zu kontrollieren, allerdings mit einem an Bedingungen geknüpften Zeitplan und ohne Angabe der Modellgröße. Runway und Synthesia gehen den umgekehrten Weg: Sie integrieren sich dort, wo die Nutzer bereits arbeiten, im Coding-Agenten oder im Gespräch mit ChatGPT und Claude, statt sie in die eigene Anwendung zu locken. ElevenLabs liefert das Zahlenargument für Sprache bei langen Gesprächen, mit einer Studie des Anbieters, deren Datengrundlage zwischen Tweet und Blogbeitrag variiert, während NVIDIA mit Cosmos 3 Nano Werkzeuge für diejenigen bereitstellt, die Fahren, Robotik oder Chirurgie simulieren.
Quellen
- Der Artikel von Anthropic über message threads
- @ClaudeDevs: message threads in Claude Code
- Die Dokumentation zu message threads
- Bericht zum Symposium 2026 von Sakana AI
- @SakanaAILabs: Bericht zum Symposium
- Vorstellung des Grid Protectors Program (OpenAI)
- Erste Antwort des Prototypsatelliten von Project Suncatcher (Google)
- LifeVal (OpenAI)
- Warum wir Design Creativity Bench entwickelt haben (Kombai)
- BrowseSafe++ (Perplexity)
- Plugins von Runway Dev für Coding Agents
- @synthesiaIO: Synthesia-Videos in ChatGPT und Claude
- Warum Sprachkommunikation bei komplexen, stressigen Gesprächen besser abschneidet (ElevenLabs)
- @ElevenLabs: Studie zu Sprachkommunikation im Vergleich zum Chat
- World Models für interaktive Simulationen mit NVIDIA Cosmos erstellen
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 von Gemini CLI
- mistral CLI 0.16.0
- Fallstudie zu Qodo und Codex (OpenAI)
- @zeddotdev: Corgi
- pull_request_target ab dem 2. Dezember standardmäßig blockiert (GitHub)
- Risikobewertungen berücksichtigen den Schutzstatus der Repositories (GitHub)
- Changelog der Perplexity API
- Beitrag von Dragonscale zu kniv v7
- Beitrag zum Sliding Window und zu Bifocal
- Beitrag von VIDRAFT zur Backdoor
- Beitrag von Rairo Mukamuri zu Beam
- @vanstriendaniel: Saturate
- Beitrag von EcoHash zu LTX 2.5
- Mobiel AI von KPN (ElevenLabs)
- Versionshinweise zu Suno Studio
- @Kling_ai: Chroma Awards Saison 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk und der SCF-Solver
- Googles KI-Ankündigungen im Oktober 2026
- Gedächtnis von KI-Agenten (Perplexity)
- Das Wissensgespräch (Perplexity)