ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
二十四小时内发布了五十一项公告,横跨九个领域:8 月 25 日是本周最繁忙的一天。其中有四项动向尤为突出。OpenAI 公布了自研推理芯片 Jalapeño 的首批实测结果,紧接着又与 Chrome、Cloudflare、Shopify、Vercel、Render 和 Netlify 联合启动了一场围绕 WebMCP 的十天黑客松。Perplexity 将其 Computer 智能体完整迁移至用户设备本地运行。IBM 开源了 Granite 4.2,这是其首个推理模型家族。Anthropic 则统一了 Claude 在聊天与 Cowork 之间的记忆,并允许用户逐个文件查看和修改。其余动态——WeatherNext Cyclones 在 National Hurricane Center 投入使用、Stability AI 完成 B 轮融资,以及约二十项工具更新——详见下文。
WebMCP:一项标准、相应的产品支持、内部应用,以及推动其起步的竞赛
8 月 25 日——OpenAI 启动 WebMCP Challenge,这是一场为期十天的黑客松,聚焦于一项仍处于实验阶段、旨在改变智能体与 Web 交互方式的开放标准。它所针对的问题十分具体:如今,当智能体需要在网站上完成任务时,必须猜测如何在一个为眼睛和鼠标设计的界面中导航。WebMCP 则反转了这一逻辑,由网站主动公开结构化工具,供智能体直接调用。
竞赛本身并不是这则公告中最值得关注的部分。真正重要的是它所揭示的行业协同:Chrome(Google)、Cloudflare、Shopify、Vercel、Render 和 Netlify 全都围绕同一标准与 OpenAI 展开合作。评审阵容也体现了这一点,包括 Sarah Drasner(Chrome 杰出工程师)、Andrew Galloni(Cloudflare 研究与创新副总裁)、Jude Gao(Vercel Next.js Core 团队)、Ilya Grigorik(Shopify 杰出工程师)、Sean Roberts(Netlify 应用 AI 副总裁)、Justin Rushing(OpenAI 浏览器智能体负责人),以及 MCP-B 创建者 Alex Nahas。
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇨🇳 WebMCP Challenge 已正式启动。我们与 @ChromiumDev、@CloudflareDev、@ShopifyDevs、@vercel、@render 和 @Netlify 携手举办一场为期十天的黑客松。奖品包括 35,000 美元现金、Codex Micro、ChatGPT Pro 订阅,以及合作伙伴提供的其他奖品。 — @OpenAIDevs 在 X 上
赛程紧凑,评审标准也十分明确:实用性、原创性、执行质量、对 WebMCP 的审慎运用,以及人类与智能体的交互体验质量。报名和作品提交均通过 Devpost 进行。OpenAI 还发布了一批智能体原生演示应用,为参赛项目提供起点——由智能体操控的 3D 建模、智能体以自身身份发表评论的协作写作、个性化填字游戏生成器、将旅行笔记转换为行程的 Wandernote,以及通过浏览器中的 DuckDB-Wasm 探索数据。参赛者也可以从现有应用出发,为其添加 WebMCP。
| 竞赛项目 | 公布的详情 |
|---|---|
| 公布的持续时间 | 10 天 |
| 开放提交时间 | 2026 年 8 月 25 日,太平洋时间 12 时 |
| 提交截止时间 | 2026 年 9 月 3 日,太平洋时间 13 时 |
| 获奖者公布时间 | 2026 年 9 月 23 日(暂定日期) |
| 奖金总额 | 35,000 美元 |
| 每位获奖者奖品(前 10 名) | 3,000 美元、一年 ChatGPT Pro、一个 Codex Micro 键盘及周边礼品 |
| 提交平台 | Devpost |
让这项标准能够用于日常工作的产品组件也于同一天上线:ChatGPT 桌面应用的内置浏览器和 ChatGPT Sites 现已能够使用 WebMCP。当 ChatGPT 或 Codex 访问兼容网站时,智能体会检测页面公开的工具并自动使用,而不再需要在界面中反复摸索——用户必须将桌面应用更新至最新版本。闭环的另一端位于生产侧:现在可以要求 Codex 创建兼容 WebMCP 的应用,然后直接部署到 Sites。值得注意的是,它与 Chrome 的支持方式并不对称:在 Chrome 中,WebMCP 仍需通过实验性标志或源试用(origin trial)启用,而 ChatGPT 浏览器则提供原生支持。
第三部分也是最具启发性的一环:OpenAI 记录了自身的内部使用方式。该公司一名工程师讲述了自己如何不再为每项任务单独编写自动化程序,转而构建 Runme——一款旨在与 Codex 协作的开源 Notebook Web 应用。他会在其中写下简短目标和明确指令——查阅此前一次执行、拟定详细计划、在开始前等待批准、记录执行过的命令及其解释——随后 Codex 会在工作过程中读取并持续更新 Notebook。其中有两个架构选择值得关注。首先是持久化:Notebook 保存在 Google Drive 中,Runme 同时生成一个配套的 Markdown 索引 *.index.md,Drive 可以对其建立索引,使智能体能够找回过去的执行记录并将其作为操作上下文。其次是能力公开方式:Runme 是一款以静态方式提供的客户端应用,如果仅为公开传统 MCP 接入点而额外添加服务器,不仅会引入基础设施,还会改变 Notebook 数据的处理位置。WebMCP 允许应用直接从浏览器注册其工具。
🔗 WebMCP Challenge · ChatGPT 桌面版和 Sites 中的支持 · OpenAI 内部的 Codex、Runme 与 WebMCP
Jalapeño:OpenAI 公布其推理芯片的首批数据,并明确其算力战略
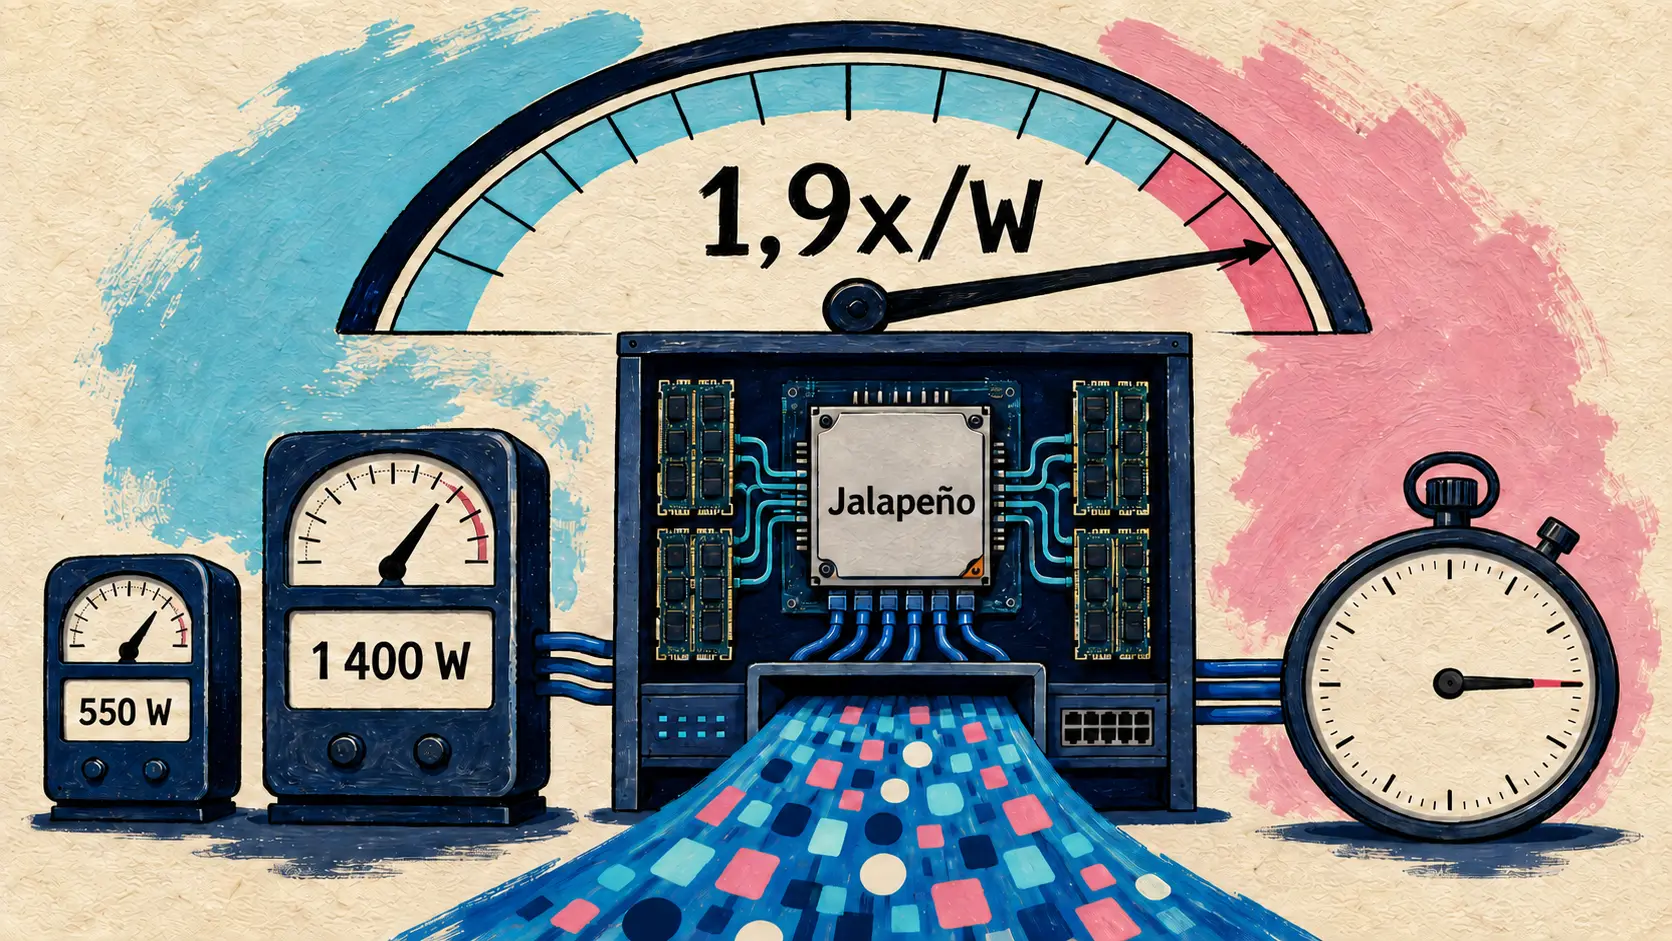
8 月 25 日——OpenAI 公布了 Jalapeño 的首批实测结果,这是该公司首款自行设计的推理芯片。这则公告的意义不仅在于原始性能提升,还在于它声称解决了一项长期存在的权衡:现有推理系统通常必须在吞吐量与延迟之间取舍,而 Jalapeño 宣称能够通过单一架构兼顾二者。
测量基于 InferenceX,这是由 SemiAnalysis 提供的一项公共基准测试,用于模拟一次请求的完整处理过程。测试涵盖三个开放模型——GPT-OSS 120B、DeepSeek R1 670B 和 Kimi K2.5 1T——并与商用系统进行比较。选择按瓦特而非按芯片进行标准化是明确且有利的:Jalapeño 的功耗仅为对比系统的一半。Jalapeño 的标称功耗为 700 W,在受测负载下测得的持续功耗始终不超过 550 W,而 GB200 为 1 200 W,GB300 为 1 400 W。
| 评估模型(对比系统) | 每 kW 峰值吞吐量 | 端到端延迟 | 最低 TBT |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
在全部三个模型上,OpenAI 宣称 Jalapeño 在峰值吞吐量下每瓦可完成的 AI 工作量提高了 1.5 至 1.9 倍,端到端延迟比对比系统低 1.7 至 3.6 倍,在高度交互式负载上的性能最高可提高 2.1 至 4.1 倍。从技术角度看,这些提升源于芯片、内存、网络、软件以及机架级系统的协同设计。推理过程分为两个瓶颈不同的阶段:预填充(prefill)阶段负责处理提示词,会耗尽计算资源;生成(decode)阶段逐个生成 token,主要依赖内存带宽。Jalapeño 力求减少数据移动;模型状态——包括 KV cache——可以被明确放置并保留在本地,同时系统会根据所处阶段启用合适的计算、内存与网络组合。
对开发者而言,最有趣的部分是 AI 在芯片本身设计过程中扮演的角色。OpenAI 表示,通过缩短设计、测量和验证循环,团队从初始设计到流片(tapeout)仅用了九个月。该芯片被设计为一个对 AI 和人类都具有可预测性的编程目标:通过局部张量描述工作、显式通信,并采用可预测的同步机制。借助 Codex 和 GPT-Astra,团队在两个月内移植了三个未被列入最初生产计划的开放权重模型;在从 GPT-OSS 中选定的注意力模块和 mixture-of-experts 模块上,由 AI 生成的内核运行速度比人类专家编写的实现快 1.5 至 1.8 倍。这里需要保留一个重要限定:这些数字针对的是选定模块,而不是完整模型。时间表仍较为谨慎——生产资格认证正在进行,软件仍需成熟,计划于年底部署到 OpenAI 基础设施中;Gen 2 已进入高级开发阶段,Gen 3 也已开始成形。
同一天,Sarah Friar 发布了一篇阐释其背后经济逻辑的文章。她主张建立广泛的算力供应组合——以 Microsoft 和 NVIDIA 为基础,并由 AWS、AMD、Broadcom、Cerebras、CoreWeave、Oracle、SB Energy 和 SoftBank 补充——其理由兼具商业与技术考量:在供应商之间保留可信的选择空间,可以将每项工作负载分配给性价比最高的方案,同时维持定价纪律。文章还给出了一项具体数据:在 Artificial Analysis Coding Agent Index 中,以最高推理强度运行的 GPT-5.6 Sol 创下新纪录,同时比另一款领先模型少消耗 54% 的输出 token。文章最后坦然承认了 Jevons 悖论——让智能变得更便宜并不会降低其消耗,反而会扩大具备经济效益的应用范围。在基础设施方面,位于佐治亚州的 Project Camellia 被描述为采用闭环水系统,并作出每年接受独立公共审计的承诺。OpenAI 明确表示,将继续广泛部署 NVIDIA 及其他合作伙伴的加速器,用于训练和推理。
🔗 Jalapeño——首批结果 · 支撑充裕智能的全栈体系
Perplexity Portable Computer:全程在本机运行,并有基准测试佐证
8 月 25 日 — Perplexity 推出 Portable Computer,这是其 Computer 智能体完全在用户本机运行的版本。这次转变更多是架构层面的,而非表面上的变化:不只模型在本地运行,整个编排链路也都如此——包括编排器、规划器、工具路由器、调度器、持久化任务队列和本地搜索索引。
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇨🇳 今天,我们在 @NVIDIA DGX Spark 上推出 Portable Computer。Portable Computer 是 Perplexity Computer 的完全本地化版本,整个运行环境——编排 LLM、子智能体 LLM、智能体框架——都在您的本地硬件上运行。完全不依赖云端。 — @perplexity_ai 在 X 上
该产品由 Perplexity 与 NVIDIA 联合发布,首批面向 DGX Spark——搭载 Grace Blackwell GB10 平台、20 核 Arm CPU、NVIDIA GPU 和 128 GB 统一内存——并计划扩展至配备 RTX GPU 的 PC。用户可在两个模型中选择:Qwen 3.8 27B,或由 Perplexity 对 Qwen 进行后训练得到的 PPLX 27B;此外,开放式 30B 模型 NVIDIA Nemotron 3.5 Lightning 也将加入模型选择器。本地处理的工作不消耗任何额度。任务仍可升级至云端——以获取最新信息、使用浏览器、连接应用,或调用 15 种以上的 frontier 模型之一——但必须获得用户明确授权。Google Drive、Gmail、Slack 和 GitHub 连接器均可在设备端运行;听写通过 NVIDIA Nemotron 3.5 ASR Model 在本地完成,音频不会离开设备;代码则在隔离的沙箱(sandbox)中执行。Portable Computer 仅面向拥有 DGX Spark 的 Pro 和 Max 订阅用户,首先支持 Linux,随后支持 Windows,并可通过应用程序一键安装。
同一天,工程团队发布了用于说明此次发布的测试数据。其核心观点是模型与框架(harness)必须协同设计:通用框架通常假设 frontier 模型能够处理超长上下文并进行长周期规划,而本地模型难以可靠地做到这一点。
| 实测基准 | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench(53 项任务) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp(1 266 项任务) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100(多模态文档) | 65,1 % | 13,9 % | 34,6 % | — |
在 BrowseComp 上,Computer 比 Hermes 少耗时 61%、少使用 16% 的 tokens;与 Pi 相比,则少耗时 51%、少使用 70% 的 tokens。这一差距源于四项设计选择:精简的系统 prompt;将能力模块化为可随执行轨迹动态加载和卸载的 skills;把常用连接器(Gmail、GitHub、Outlook、Google Calendar)转换为紧凑的命令行工具,而非作为 MCP 服务器公开,因为其定义会大量占用上下文;以及始终启用且不可配置的沙箱——如果沙箱不可用,框架会在调用任何工具之前停用,而不会转为非隔离执行。Perplexity 还指出了一项实用发现:Qwen 3.8 27B 宣称拥有 260K tokens 的上下文窗口,但实际在超过 100K 后便开始表现吃力。
| Terminal Bench 2.1(89 项任务) | 得分 | 每次运行的 API 成本 |
|---|---|---|
| Qwen 3.8 27B,100% 本地运行 | 59,6 % | 约为 0 |
| Qwen 3.8 27B + Claude Opus 5 顾问 | 73,0 % | 0,415 USD |
| 仅 Claude Opus 5 | 82,4 % | 0,65 USD |
升级至顾问模型(advisor)的机制是报告中最值得关注的部分:它以约三分之二的成本弥补了与 frontier 模型之间约五分之三的差距,且决策权仍掌握在用户手中。每次调用之前,框架都会选择相关上下文,应用个人数据分类器,并向用户展示哪些内容将离开设备;顾问模型仅返回文本,无法直接访问文件或工具。最后,PPLX 27B 的后训练结合了拒绝微调(rejection fine-tuning)和强化学习;后者在 Docker 容器中运行的合成环境里完成,完全不使用真实用户数据。Perplexity 还宣布将发布技术报告,并以 open source 形式开放评估基准。
🔗 本地框架基准测试 · Portable Computer——Perplexity 博文
Claude:聊天与 Cowork 共用一套记忆,并可逐个文件查看
8 月 25 日 — Anthropic 取消了此前并存的两套记忆之间的界限。Claude 从聊天对话中记住的内容,现在与 Claude Cowork 可使用的内容完全一致,反之亦然。具体而言,当 Cowork 在云端执行任务时,会从数月以来累积的上下文开始:本季度的优先事项、项目进展,以及某位交流对象的写作偏好。Anthropic 给出了一些刻意贴近日常工作的例子——例如要求生成一份给主管的进度汇报,而无需说明主管是谁,也无需解释对方偏好以何种方式接收信息。
第二项变化更为低调,却改变了日常使用方式:记忆会随着对话实时更新,而不再通过事后生成的摘要更新。只需提到某项截止日期推迟至 9 月,下一次对话就会将其纳入考虑。“记住这一点”这一表述仍可用于强制保存某条具体信息,记忆功能也可以随时暂停或重置。
在透明度方面,Anthropic 选择了可读的呈现方式,而不是黑箱:Claude 记住的所有内容都会以按主题分类的短文件形式显示在“设置”的“记忆”页面中。每个文件都可单独阅读、修改或删除。实际好处立竿见影——只需在一个文件中更正公司的旧名称,之后的所有对话就会使用正确名称。
敏感主题的处理方式是产品设计选择中最值得关注的一点。默认情况下,Claude 不会记忆与健康、出身、族裔、宗教信仰、政治观点或性别认同有关的内容。不过,Anthropic 承认这条界线因人而异,因此提供了可选设置,允许纳入这些主题——例如让 Claude 在推荐食谱时记住用户对麸质不耐受。该设置不具有追溯效力,并可随时关闭。无论如何设置,仍有一类信息始终不会被记忆:身份识别号码、司法记录、移民身份,以及更广泛意义上违反《可接受使用政策》的任何内容。当 Claude 无法保存此类信息时,会明确告知用户;这一设计选择更倾向于让拒绝清晰可见,而不是静默过滤。
| 记忆维度 | 所述行为 |
|---|---|
| 范围 | 聊天与 Claude Cowork 共享同一套记忆 |
| 更新时间 | 在对话期间更新;此前是在对话结束后生成摘要 |
| 存储格式 | 按主题分类的短文件,可逐个阅读和修改 |
| 敏感主题 | 默认不记忆,可通过设置启用,且不具有追溯效力 |
| 永久排除项 | 身份识别号码、司法记录、移民身份 |
| Free、Pro 和 Max 方案 | 在网页端、桌面端和移动端默认启用记忆 |
| Team 和 Enterprise 方案 | 由管理员开放,但在用户主动启用前保持关闭 |
🔗 Claude 的记忆可在各处使用 · @claudeai 公告
IBM 开放 Granite 4.2——其首个推理模型家族——以及两款 470M ASR 模型
8 月 25 日 — IBM 发布 Granite 4.2,并将其称为首个专为推理明确设计的稠密、纯解码器语言模型家族。此前几代产品侧重效率和传统企业任务,而这一版本将推理置于核心位置,并使其可调节:每个模型都提供三种模式——thinking、non-thinking 和 low-effort——应用程序可根据可接受的延迟和 tokens 预算进行选择。三种规模(3B、8B、30B)共享相同的架构与 pipeline,因此在集成层面可以顺畅地从一种规模切换到另一种。
其架构依然经典:采用 40 个查询头和 8 个 KV 头的 GQA attention;RoPE 的 θ 为 1 000 万,以支持 131 072 tokens 的上下文;使用 SwiGLU MLP 和 RMSNorm;以 bfloat16 在 CoreWeave 托管的 NVIDIA GB200 NVL72 集群上训练。预训练从零开始,使用约 15 万亿 tokens,分为五个阶段。Granite 4.2 真正与众不同之处在于后训练:它采用由多个专业步骤串联组成的强化学习 pipeline,而非单次训练;通过异步 GRPO 和截断重要性采样,使循环中的生成与训练两部分永不相互阻塞。其 curriculum 依次包括三轮采用可验证奖励的 RLVR、针对指令遵循与代码能力的专项增强、两个 128K 上下文的 software engineering 阶段、一个终端阶段、一个搜索阶段,最后进行 RLHF 对齐。智能体强化模块仅应用于 8B 和 30B 模型,这也解释了 3B 与两个更大模型在智能体编程性能上的差距。
| IBM 发布的基准 | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
此次发布并不限于 bfloat16 权重:还为 vLLM 同时推出了四种量化变体——无需校准的逐通道动态 FP8,以及通过 GPTQ 在 2 000 个 SFT 样本上校准的 NVFP4 和 MXFP4——并为 llama.cpp 提供从 Q2_K 到 Q8_0 的十四种 GGUF 格式。模型支持包括法语在内的十二种语言,并从发布首日便提供三种智能体编程框架的文档:OpenCode、Pi 和 OpenHands。在数据质量方面,IBM 详细介绍了一条处理链:先由 GPT-OSS-120B 和 Gemma 4 担任评审,为 SFT 样本评分,再通过 SHA-256 哈希进行局部与全局去重。
同一天,IBM 发布 Granite Speech 5.0 Turbo CTC,这是两款拥有 4.7 亿参数的英语语音识别模型;两者的差异仅在于训练数据和许可证——标准版本采用 Apache 2.0,使用额外数据训练的变体采用 CC-BY-NC-SA-4.0。架构变化十分显著:此前的 Granite Speech 由声学编码器、投影器和 LLM 组成,而这两款模型仅使用编码器。整个 stack 叠加了 16 个 Conformer 模块,在第八个模块的输出端应用自条件化,将点积 attention 替换为分块(chunkwise)attention,以避免计算量随规模呈二次增长,并直接优化 CTC loss。真正的新意在于 tokens 速率:下采样操作将 log-Mel 频谱图输出的每秒 100 帧降至每秒 12.5 帧,这也解释了名称中的“Turbo”。测试结果发布在 OpenASR Leaderboard 以及用于远场场景的 FFASR Leaderboard 上,采用速度与准确率的 Pareto 图表,而非孤立分数;同时还提供了通过 WebGPU 在浏览器中运行的连续语音识别演示,但仅支持 Chrome 和 Edge。
🔗 Granite 4.2——技术解析 · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones:首个被美国国家飓风中心用于实时业务的 AI 模型
8 月 25 日 — Google AI 详细介绍了 WeatherNext Cyclones,这是 Google DeepMind 和 Google Research 开发的热带气旋预测模型。此次发布的意义,与其说在于单纯的性能提升,不如说在于它展现了 AI 气象技术如何从实验室走向实际业务。
它所解决的是一个结构性难题。此前,追踪气旋意味着必须做出取舍:运行在超级计算机上的物理模型能够很好地捕捉席卷全球的大尺度大气结构,但要理解决定风暴强度的局地剧烈物理过程,就不得不切换到完全不同的区域模型。WeatherNext Cyclones 消除了这种来回切换,可以一次性预测路径、强度和规模。
据称,其预测提前量较以往系统增加了整整一天。Google 用一个直观的方式说明了这一提升:如今三天期预测的准确度已达到过去两天期预测的水平,而从历史上看,实现这样的进步通常需要十年的方法创新。第二项贡献在于概率预测:该模型速度足够快,每场风暴最多可生成 1,000 次模拟,从而用一系列可能情景取代单一的“最可能”路径。这使快速增强现象变得更容易理解;快速增强指最大持续风速在 24 小时内至少上升 30 节。今年,预报员可通过 WeatherLab 获得每场风暴的 1,000 份概率预测。
最重要的仍是实际部署。在 2025 年飓风季期间,WeatherNext Cyclones 在美国国家飓风中心接受了实战检验——这是该机构首次在实时业务中使用 AI 模型。气象学家利用它预测了飓风 Melissa 将以 5 级强度登陆牙买加,为当地政府争取了更多准备时间。相关论文已发表于 Nature,Google 还宣布将在 GitHub 上以开源方式发布代码和模型权重。
| 模型方面 | WeatherNext Cyclones 的贡献 |
|---|---|
| 预测变量 | 一次性预测路径、强度和规模 |
| 提前量提升 | 增加一天;三天期预测的准确度等于过去两天期预测 |
| 每场风暴的模拟次数 | 最多 1,000 次 |
| 业务部署 | 美国国家飓风中心,2025 年飓风季 |
| 已记录的应用案例 | 飓风 Melissa 以 5 级强度登陆牙买加 |
| 快速增强阈值 | 最大持续风速在 24 小时内上升超过 30 节 |
| 提供方式 | WeatherLab;代码和权重在 GitHub 上开源 |
🔗 @GoogleAI 公告 · Google DeepMind 博文
Stability AI 完成 7,600 万美元 B 轮融资,EA、Sony Music、Universal 和 Warner 参投
8 月 25 日 — Stability AI 宣布完成 B 轮融资:获得 7,600 万美元新资金。自 Prem Akkaraju 于 2024 年 6 月接管公司以来,其融资总额已达到 2.32 亿美元,其中包括两轮股权融资和可转换债券。以整个行业的规模来看,这笔金额仍不算大,但投资者阵容才是真正的焦点。
四家娱乐业巨头成为股东:电子游戏领域的 Electronic Arts,以及音乐领域的 Sony Music Group、Universal Music Group 和 Warner Music Group。三大唱片公司如今都成为了同一家实验室的股东。AMD Ventures 和 Pacific Alliance Ventures 也参与其中。这些投资者并非突然出现:自 2025 年秋季以来,EA、Universal 和 Warner 就已经是 Stability AI 的战略合作伙伴。因此,本轮融资相当于将现有商业合作转化为股权投资。
另一个信号来自财务投资者的持续支持。Coatue、Greycroft、Kadmos Capital、Sean Parker 和 Eric Schmidt 在新管理层上任后连续第二轮追加投资——考虑到 Stability AI 在 2023 年和 2024 年经历的动荡时期,这无疑是一种认可。Coatue 联合创始人 Thomas Laffont 加入董事会,与 James Cameron、Sean Parker、Dana Settle 和 Prem Akkaraju 共同任职。
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇨🇳 这一无与伦比的投资者阵容印证了我们的愿景:让生成式 AI 为每一位制作人、音乐人和故事创作者赋能。Stability 在 AI 领域独树一帜,因为我们本身就是创作者,正在为创作者打造工具。 — Stability AI 首席执行官 Prem Akkaraju,8 月 25 日新闻稿
公司明确采取的是专注细分领域的实验室战略:不开发通用模型,而是与权利持有人合作,而非与之对抗,为创意专业人士打造工具。这正是 Stable Audio 3.0 所遵循的路线。该开放权重模型系列完全使用获得许可的数据训练,并于 8 月 18 日新增了用于数字音频工作站的插件。新资金将用于后续产品开发、应用研究和专业服务部门。
ChatGPT 企业端:Admin 插件、多浏览器扩展及 100 美元 Premium 席位
8 月 25 日 — OpenAI 的三项公告都面向同一类受众:大规模部署 ChatGPT 和 Codex 的组织。
其中最重要的是面向 ChatGPT Work 和 Codex 的 Admin 插件。它把过去需要在分析仪表板、设置页面和报告之间切换才能完成的工作集中到一次对话中。其覆盖范围包括日常任务:了解采用情况和额度消耗,识别即将达到限额的成员或群组,管理人员加入与离开,检查实际生效的权限并诊断访问问题,调整使用限额,以及结合实际用量审核支出申请。最值得关注的是无需编写代码即可实现自动化:待处理的用量申请可以转发至 Slack 或 Microsoft Teams,让审批人在已经使用的工具中完成批准;功能访问申请如果符合预设条件,也可以自动获批,例外情况则转交人工处理。安全方面的关键点是,该插件在用户现有的角色和权限范围内运行,不会扩大任何访问权限;每条指令都会映射为受支持的读取或写入操作,并返回结构化结果。OpenAI 还介绍了自身的使用情况——Slack 中的一个 ChatGPT Work 智能体负责处理内部 IT 请求,已部署的工作流可解决约 45% 的工单量;尽管支持请求量大约翻了一番,积压仍被清零。
第二项公告是,ChatGPT 浏览器扩展不再局限于 Chrome,现已支持 Microsoft Edge、Brave、Opera 和 Vivaldi。对于出于隐私偏好或企业要求而使用其他浏览器的人来说,这项变化十分重要。公告重点介绍了两种用途:在 ChatGPT Desktop 中通过提及 @ tab,把已打开标签页的上下文带入任务,让 Codex 能基于当前显示的文档或工单开展工作;以及让智能体操控浏览器完成具体的网页任务,官方给出的例子包括取消订阅。
第三项公告更为简短:ChatGPT Business 新增一个定价 100 美元的 Premium 席位,面向小型企业和初创公司,并将其描述为可根据团队规模灵活调整和扩展的方案。该消息仅在 X 上发布,没有详细的博客文章,公告中也未说明该席位的具体组成。
🔗 Admin 插件 · 多浏览器扩展 · ChatGPT Business Premium 席位
NVIDIA:借 Gamescom 扩展 RTX Spark,并以 SANA 将 MiniMax H3 延迟降低至原来的 1/27
8 月 25 日 — NVIDIA 借本周在科隆举行的 Gamescom 扩充其 RTX Spark 产品阵容。这款 Windows PC 平台预计于今年秋季推出。Electronic Arts、Embark Studios 和 Ubisoft 加入了 KRAFTON、NetEase、Riot Games 与 XBOX 的行列,后四家公司早在 5 月的 COMPUTEX 上就已承诺提供支持。公布的游戏涵盖了不同的技术需求:EA 旗下的 EA SPORTS F1 25 和 Apex Legends、Ubisoft 的 Anno 117: Pax Romana,以及 Embark Studios 的 ARC Raiders 和 THE FINALS。
最具体的进展涉及反作弊。仅仅让游戏能够运行还不够:大型在线游戏依赖反作弊系统,而这些系统必须针对每个平台进行移植,否则游戏的多人模式将无法使用。NVIDIA 宣布正与 EA 合作,将 EA Javelin Anticheat 原生引入 RTX Spark——正是这种基础设施细节决定了一个新 PC 平台能否真正普及。渲染方面,DLSS 4.5 Ray Reconstruction 已立即开放使用,其第二代 transformer 模型以在超级计算机上训练的网络取代传统降噪器。CONTROL Resonant 和 007 First Light 将引入 path tracing,Gears of War: E-Day 集成 RTX Mega Geometry,而 Aniimo 则宣布将在 2027 年初采用 NVIDIA ACE 技术。
同一家公司的另一项进展发布于8 月 24 日,内容更加技术化。MiniMax 转发了 NVIDIA SANA 团队将 Sol Engine 应用于其 H3 视频模型后取得的结果:在单个 GB200 上生成 10 秒 768p 视频的时间从 414 秒缩短至 14.93 秒,提速 27.7 倍。该方法并非依靠内核优化,而是把生成过程拆分为两个阶段——先由 H3 用 4 个步骤生成低分辨率草稿,再由 LTX 配合 Sol-Attn,用 3 个步骤将其细化至目标分辨率,总计 7 个步骤。第二项手段是使用轻量级解码器 TAEH3 和 TAEHV 替代成本高昂的 VAE 解码,同时保持潜变量稳定,以供细化阶段使用。
| MiniMax H3 测量项目 | 测量值 |
|---|---|
| 测量负载 | 10 秒 768p 视频,单个 GB200 |
| 优化前延迟 | 414 秒 |
| 优化后延迟 | 14.93 秒 |
| 加速倍数 | 27.7x |
| 生成步骤 | 4 步(H3 低分辨率草稿)+ 3 步(LTX) |
| 替代解码器 | 使用 TAEH3 和 TAEHV 替代 VAE 解码 |
| 每节点预计吞吐量 | 每月 378,000 个视频,GPU 利润率超过 97% |
预计吞吐量是 MiniMax 的估算,并非实际生产环境的测量结果,因此应当据此理解。不过方向已经十分明确:当生成 10 秒高保真视频只需 15 秒时,视频生成正从异步批处理渲染迈向接近实时交互的基础设施。
🔗 NVIDIA 亮相 Gamescom · SANA 与 H3 上的 Sol Engine
中国开放模型成为研究基准,Qwen3.8-27B 跻身 Code Arena 前十
8 月 25 日 — Qwen 在同一天上午转发了两项结果,而第二项揭示了第一项背后的深层含义。
第一项是一份排行榜。Qwen3.8-27B 登上评估模型网页界面生成能力的 Code Arena: WebDev 排行榜,以 1595 分位列总榜第 9。它是前十名中唯一处于该参数规模级别的模型,与规模大得多的 Qwen3.8-Max 也仅相差六个名次。Arena 指出,它重塑了排行榜的 Pareto 前沿,并给出了一个直观参照:规模相近、但于 4 月发布的 Gemma 4-31B 位列第 80。
| 参评模型 | Code Arena: WebDev 排名 | 得分 | 排行榜备注 |
|---|---|---|---|
| GLM-5.3 (Max) | 总榜第 8 | 1597 | 8 月 20 日记录,开放模型中排名第 2 |
| Qwen3.8-27B | 总榜第 9 | 1595 | 前十名中唯一处于该规模级别的模型 |
| Qwen3.8-Max | 比 27B 高六个名次 | 暂无数据 | 同系列中规模大得多的模型 |
| Gemma 4-31B | 总榜第 80 | 暂无数据 | 2026 年 4 月发布 |
第二项结果衡量的是实际使用情况。曾共同领导 Ai2 的 Olmo 项目的 Nathan Lambert 让 Codex 分析了 ChatGPT 发布以来发表的 500,000 篇 AI 和机器学习 arXiv 论文,以识别研究中实际使用的开放模型。变化可以用两组数字概括:2024 年,约 30% 的论文提及美国开放模型,而提及中国模型的只有 10%;如今,约 40% 的论文引用中国开放 LLM,而引用美国开放 LLM 的比例仅为 25% 至 30%。
| 模型系列 | 引用某种 LLM 的论文占比 |
|---|---|
| OpenAI(闭源模型) | 约 37% |
| Qwen | 约 33% |
| Gemini、Claude | 10% 至 15% |
| Gemma、Mistral | 5% 至 10% |
| Olmo | 约 1% |
具体来看,在所有引用任意 LLM 的论文中,有三分之一提及 Qwen。Llama 的占比在 2025 年 4 月左右达到 30% 的峰值,恰逢 Llama 4 发布,之后便持续下降。Lambert 本人指出了一个重要限制:由于研究需要时间,论文发表会滞后于模型发布——因此,这些数字反映的是当前正在开展的研究,而不是当下即时的偏好。与此同时,还可以看到一项独立于开放与闭源之争的长期趋势:提及 LLM 的 AI 论文比例已从 2023 年 1 月的 10.43% 上升到 2026 年的 50% 以上。
🔗 Code Arena 上的 Qwen3.8-27B · Qwen 转发的 arXiv 分析 · @natolambert 的分析
Claude Code 升级至 2.1.245,Claude 网页版渲染流畅度提升至 4 倍
在这一时间窗口内发布了两个 Claude Code 版本,其内容显然面向组织部署。CHANGELOG 没有标注日期,但 Git 历史记录给出了时间:2.1.243 对应 8 月 24 日 23:40 UTC 的 commit,2.1.245 对应 8 月 25 日 05:13 UTC 的 commit。
| 新增设置 | 相关版本 | 实际用途 |
|---|---|---|
modelPricing | 2.1.243 | 在 /cost、状态栏和遥测中使用合同价格 |
modelPicker | 2.1.243 | 为 /model 提供有序且带标签的模型列表 |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | 对话的 prompt 缓存为一小时,subagent 为 5 分钟 |
/usage 中的 Loops 明细 | 2.1.243 | 识别失控的 /loop 任务 |
| 通过 Console 无密钥连接 | 2.1.243 | 适用于禁止使用 API 密钥的组织 |
| glibc 2.44 修复 | 2.1.245 | 修复 Arch Linux、CachyOS 和 Fedora Rawhide 上的启动崩溃 |
最具结构性影响的设置是 modelPricing:此前显示的成本按公开价格计算,如今组织可以按模型注入合同价格及折扣系数,使这些数字可以直接用于内部成本分摊。promptCacheTtl 和 subagentPromptCacheTtl 的组合解决了 API 密钥用户面临的一项实际经济权衡:主对话的上下文较为稳定,因此保留一小时缓存;subagent 的上下文更加易变,因此仍采用五分钟缓存。修复方面,非交互模式下的远程 MCP 服务器在连接中断后不再卡死,/resume 不再仅限于最近五十个会话,而静默超过十分钟的会话如今会在约三分钟后超时,随后重试并显示明确错误。
此外,8 月 24 日,Anthropic 宣布重写了 Claude 网页版和桌面版中显示生成中回复的引擎。其原理是界面渲染中的经典做法:只更新仍在变化的部分,而不是每收到一个新片段就重新绘制整条回复。对于长回复,这会带来结构性差异——渲染成本不再随已显示文本的长度增长。公布的提升数据彼此吻合:流畅度约提升至 4 倍,低性能笔记本电脑上的卡顿减少至九分之一,界面最严重冻结的持续时间缩短至四分之一点五,并且在 120 Hz MacBook 上从头到尾维持每秒 120 帧。值得注意的是其目标受众:配置较低的设备受益最大。
🔗 Claude Code CHANGELOG · 渲染流畅度提升至 4 倍,@ClaudeDevs
编码 agent 走向工业化:Warp 公布其 factory 格式,Rohlik 让 agent 编写 90% 的代码
8 月 24 日傍晚——Warp 展示了 Warp Factories 的内部机制。这一云端 agent 平台于 8 月 18 日发布,此次公布了所采用的配置格式,并开放早期访问。其出发点非常明确——出于质量和成本方面的考虑,Warp 正在将自己的 agent 从本地计算机迁出,因此需要用版本化代码来描述环境、harness 和安全权限。
| 配置元素 | 采用的值 |
|---|---|
| 定义文件 | factory.yaml、schemaVersion: v1alpha1 |
| 主要键 | name、repositories(owner / name)、agentDefaults.model |
| agent 定义 | agents/<nom>/agent.md,包含 agentType(FOREMAN、REVIEW……)和 model |
| 触发器 | automations/<nom>/automation.md:agent、triggers(提供商、事件) |
| 可用接口 | CLI(warp agent run-cloud)、REST API、TypeScript SDK、MCP 服务器 |
| 早期访问 | 符合条件的客户可获赠最高 10,000 USD 的使用额度 |
这种分离方式颇有意思:agent 并非在单个 YAML 文件中描述,而是分别置于专用 Markdown 文件中,因此 agent 定义成为易读且可进行 diff 比较的文档。Warp 也将这套方法用于自身——其名为“wilson”的内部 factory 覆盖 warp-server 或 warp-terraform 等代码仓库,声明所需 secret 和 MCP 服务器,并仅用 34 行按角色组织 agent(code-review、foreman、implementation、spec、triage)。访问申请页面给出的数字属于无法从外部验证的营销论据:每天运行 200,000 次 agent,超过 30% 的 pull request 无需修改即可合并,每个 pull request 的成本降低 20%。
8 月 25 日,Cognition 则发布了一份比前述内容详实得多的案例研究。Rohlik Group 是一家诞生于捷克共和国的在线食品零售商,业务遍及五个国家,已实现盈利,去年营收超过 13 亿美元;它可在不到一小时内或十五分钟的时间窗口中配送包含 17,000 种商品的一周所需采购品。文章的核心数字是:如今约 90% 的代码由 agent 生成,其工程组织自称“以 agent 为主”。
这一成果并非接入一个工具便能获得。Rohlik 表示,他们于一年前开始尝试,首次使用 Devin 的体验被认为存在许多 bug。真正改变局面的是客户端打下的基础:超过五十项内部和外部 MCP 集成,并遵循所有新工具从第一天起就必须可供 agent 使用的原则;在 Snowflake 数据仓库之上构建语义层;以及建立知识库,为 agent 提供如同向新同事传授的上下文。工作从产生之处直接进入 Devin,无论是 Slack 中关于 bug 的对话,还是一路推进至 pull request 的 Linear 规范文档。其宣称的成果——自 11 月以来工程吞吐量翻倍;AutoStore 机器人集成在八个月内交付,而行业通常需要两到三年;原型开发时间从一个月缩短至一天——仍然出自供应商发布的客户案例页面。更能说明问题的影响体现在其他方面:顶尖工程师如今将 80% 的时间用于代码审查,而 Rohlik 对 Devin 的使用中约有 30% 是业务用户进行的数据分析。
🔗 factory.yaml 格式,@warpdotdev · Rohlik 案例研究,@cognition · Devin 客户页面
GitHub:四项 agent 工作流练习与全面开放的 Customize 标签页
8 月 25 日——GitHub 在其 GitHub Skills 学习平台上线了四项新练习。其思路非常明确:GitHub 并未仅以文档形式介绍今年的 agent 新功能,而是让用户在演示代码仓库中动手实践,并通过一系列 pull request 逐步接收指引。
| 已发布练习 | 练习内容 |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Copilot CLI 中的自定义 agent:规划、设计、构建、验证、交接 |
| Agentic Workflows that Read the Room | gh aw 扩展、Markdown 格式的 agent 工作流、通过 pull request 提交更改 |
| Idea to Merge with the Copilot App | 从会话到合并后的 pull request,全程在 GitHub Copilot 应用内完成 |
| Ship with Quality | 自动化质量信号、测试覆盖率、对 pull request 强制执行检查 |
四项练习中最值得关注的是第一项:这是 GitHub 首次在其 CLI 中提供多 agent 编排的引导式教程,此前该主题仅以文字文档形式说明。第二项引入了 gh aw 扩展,其中有一个重要的安全设计——工作流提出的修改会通过 pull request 流转,而非直接应用,从而保留人工审查环节。
同一天,GitHub Copilot 应用的 Customize 标签页全面开放。它的作用是将近几个月分别推出的四种扩展机制汇集到同一界面:MCP 服务器、plugin、skill 和 canvas。Featured 视图展示从各类别中选出的编辑精选内容,面向那些知道自己想做什么、但不知道应使用哪类扩展的用户;MCP 服务器则拥有独立浏览界面,其中会根据受欢迎程度重点展示选项,并提供按类别浏览的路径。changelog 通过一个具体案例展示了 canvas 的价值:使用 Azure DevOps canvas 对 issue 进行分类、确定 backlog 的优先级、分配后续任务,然后将任务交给 Copilot,让其调查、实现或准备审查。
🔗 四项 GitHub Skills 练习 · Customize 标签页全面开放
Google 开发者工具:Gemini CLI 0.57.0 与 Antigravity 2.10.0
8 月 25 日——Google 发布 Gemini CLI 0.57.0 稳定版,而 0.58.0 preview 版早在十五分钟前发布。与其说此版本内容展示了新功能,不如说它揭示了 Google 维护该工具的方式:changelog 的 24 个条目中,13 个以 [SSR Agent] Issue Fix 为前缀,并指向通常较早的 issue 编号,从 19239 到 28518。这些修复解决了 backlog 中积累的问题——为终端界面无限期卡死的情况加入超时机制;修复个人账户看到误导性管理错误消息的问题;补上自动补全建议后的空格;修复退出外部编辑器后终端渲染不刷新的问题。换言之,Google 让 agent 处理自身的技术债务,并将成果直接纳入稳定版。
| 发布版本 | 日期和时间(UTC) | 发布渠道 | 主要亮点 |
|---|---|---|---|
| v0.57.0 | 8 月 25 日,18:37:14 | 稳定版 | 13 项 [SSR Agent] 修复、eval 验证、上下文感知 retry |
| v0.58.0-preview.0 | 8 月 25 日,18:22:01 | Preview | macOS Seatbelt 配置中的 Docker 隔离、安全检查器 |
功能方面的重点是评估,包括一条 eval 验证命令,以及一个整合失败摘要的工具调用格式化器。可靠性也有所提升:容量错误会触发考虑上下文的静默 retry,而取消多轮请求会执行完整 rollback,不再留下部分状态。对于查找发行说明的人来说,需要注意的是,代码仓库中的 docs/changelogs/index.md 文件自 8 月 6 日的 v0.54.0 后便未再更新。
在 2.9.1 及其 Remote Control 发布四天后,Google Antigravity 于 8 月 24 日升级至 2.10.0,补上了两个此前迫使用户离开工具的缺失功能:集成终端和原生 Git 版本控制,二者均直接置于侧边栏中。这种整合符合产品的发展路线——Antigravity 将自身定位为一个用于操控 agent、而非逐行编辑代码的环境,但用户仍然需要在不切换窗口的情况下运行命令和检查 diff。该版本的其他改进扩大了可提交给 agent 的内容范围,也让其工作过程更加透明:支持将音频文件作为附件;可通过图片上的交互式评论标注视觉内容,从而指导 agent;更丰富的 MCP 工具执行预览则让用户能够看清工具服务器实际执行了哪些操作。Google 表示此版本包含 13 项改进和 8 项修复,并将逐步推出。
🔗 Gemini CLI v0.57.0 · Antigravity changelog
Anthropic 出资 500 万美元支持独立的福祉评估
8 月 25 日——Anthropic 推出一项 500 万美元的资助计划,用于资助关于 AI 对用户福祉影响的独立研究。获选者将获得直接资金、模型访问权限和技术支持,但完全独立开展工作:其评估将以 open source 形式发布,并可供整个行业重复使用。申请开放至 9 月 21 日,获选提交完整提案的申请人将在 10 月 5 日前收到通知。
技术论述解释了为何该领域难以采用常规评估方法。对于模型的大多数行为,只需检查一条孤立回复,便可判断其是否准确且恰当。福祉评估则需要上下文:处于痛苦中的用户不一定一开始就会提及自我伤害的念头;在某种情况下合理的均衡饮食建议,如果当事人曾表现出饮食失调史,就可能变得危险。Safeguards 团队同时发布了五项严谨性标准:明确说明测量对象;让临床医生和领域专家参与设计;同时测试防范措施与伤害——也就是说,既评估过度迎合的风险,也评估过度拒绝的风险;通过多轮场景反映真实使用情况;并以真正的专家为基准验证自动评分器。第三项标准,即过度顺从与过度拒绝之间的对称性,是这套方法区别于单纯强化防护措施的关键。
🔗 福祉研究资助
Quantization-Aware Healing:一个超越原始全精度版本的 4 位模型
8 月 25 日 — 让大模型具备部署条件的标准流水线依次包含三个步骤:压缩架构、量化结果,然后修复质量损失。最后一步的主流方案是 QAT(量化感知训练),它会插入伪量化操作并重新训练;另一种方案 QAD 则从全精度压缩模型中进行蒸馏。无论采用哪种方案,学生模型最多只能追平其压缩后的教师模型,因此也会继承压缩所设定的性能上限。
Multiverse Computing 提出了一项只需改动一行的方案:直接从压缩前的原始模型进行蒸馏。这样一来,量化不再是有损的后处理,而是成为完整学习过程中的一个环节。结果有悖直觉——将该方法应用于先压缩至 60B、再量化为 MXFP4 的 GPT-OSS 120B 后,得到的 4 位模型在九项基准测试中的七项上追平或超越了自身的 bfloat16 源模型;而且压缩造成损害越大的任务,提升越显著:长上下文推理的 AA-LCR 提升 7.4 分,AIME 2025 提升 5.6 分。仅有的两项退步出现在 MMLU-Pro 和 SciCode 上,降幅均不到 1.5 分。
在相同流水线下与 QAT 进行直接比较,或许是实践中最有价值的结果。在量化为 MXFP4 的 GPT-OSS 9B 上,两种方法达到的峰值相近,分别为 54.9 和 54.6,但付出的代价并不相同:QAH 约用一百个步骤便达到峰值并保持稳定,而 QAT 需要约 700 个步骤才能达到,之后性能还会下降。其实际后果是部署风险不同——QAT 检查点需要密切监控提前停止时机,而 QAH 检查点对此的要求低得多。
Gradio 集成 gr.Workflow,一款基于图的 AI 流水线构建器
8 月 25 日 — Hugging Face 发布了一份介绍 gr.Workflow 的指南,这是如今已集成到 Gradio 中的一项基础功能。其出发点很简单:大多数有意思的 AI 应用并非单次模型调用,而是一连串操作——生成图像、抠除背景、制作旁白,再让 LLM 拟定标题。此前,要连接这些步骤并以完善的形式呈现出来,既要编写逻辑,也要开发界面。gr.Workflow 将两者合而为一:把各个步骤描述成由类型化节点组成的图,而这张图本身就会成为界面。
它对开发者的价值不止于可视化演示。图中的每个输出都会自动获得各自的 REST 端点:示例中的媒体工作室依次执行 FLUX 生成、背景抠除、语音合成和 LLM 调用,并公开三个独立路由(/sticker、/voiceover、/episode_title),无需经过界面即可通过代码调用。节点能够与四类资源交互——通过 Hugging Face Inference Providers 托管的模型、作为构建模块复用的其他公共 Gradio Spaces、Hub 数据集中的一行数据,以及任意 Python 代码。最后一点提供了最广阔的可能性:使用 @spaces.GPU 装饰的运算节点会在执行期间预留一块 ZeroGPU,从而能够运行自己的权重。指南还附带五个已实际部署到 Spaces 的应用,其中包括数据集分析器,以及使用 Lightricks/LTX-Video 为静态图像制作动画的演示。
ElevenLabs 推出 Composer,一款可逐段编辑歌曲的工具
8 月 25 日 — ElevenLabs 宣布推出 Composer,这是一款按段落处理歌曲的编辑器。其理念不同于音乐模型的主流生成方式:它不会一次性生成完整歌曲,并在某个片段不合适时全部重新生成,而是允许单独修改主歌、副歌或桥段。它提供四种起点——用户自己的歌词、自行提供的现有音轨、空白项目或简单的 prompt——随后通过反复调整逐步完成整首歌曲。
这是 ElevenLabs 继 Eleven Music 之后向音乐领域迈出的第二步,而且恰逢该公司动作频繁的一周,CLI v1 刚在前一天发布。这一定位与音频行业的整体趋势一致:Suno 于 8 月 13 日推出 Studio 2.0,Pika 于 8 月 18 日发布 Pika Music 产品系列,Stability AI 也在同一天交付了面向数字音频工作站的插件。相较于单纯的生成质量,对歌曲结构进行精细控制已经成为新的竞争焦点。不过仍需注意:此次公告没有配套的博客文章,目前也没有关于哪些套餐可使用 Composer、支持哪些导出格式以及是否提供 API 访问的信息。
LiveAvatar 取消所有并发限制,价格降至每分钟 0.01 USD
8 月 25 日 — HeyGen 宣布取消其实时虚拟人产品 LiveAvatar 的并发限制。公告措辞特别强调了这一变化的性质:不是提高限制,而是彻底取消限制。无论一个会话还是一万个会话,都能通过同一个 API 运行,无需事先协商配额。公告还给出了两个参数——依然支持 1080p 全身渲染,规模化使用时价格可降至每分钟 0.01 USD。
这一价格水平改变了可行应用的范围:每分钟仅需一美分,实时虚拟人便可用于大规模客户支持、培训或交互式信息亭,而这些场景此前往往由单位成本决定是否可行。取消并发限制是技术上值得关注的重点。实时虚拟人平台通常会限制同时运行的会话数量,因为每个会话都要持续占用 GPU;取消这一上限,意味着平台要么拥有大量富余容量,要么提升了模型效率。HeyGen 发布了一篇文章解释其方案,但扫描时尚无法获取其中的技术细节。
Grok 4.6 登陆 OpenCode Go
8 月 25 日 — Grok 4.6 加入 OpenCode Go,即开源代码智能体 OpenCode 的订阅方案。该消息由 OpenCode 于当天晚些时候宣布,半小时后由 @grok 账号转发。对开发者而言,最具体的信息是配额:Go 方案用户每 5 小时可发出 169 次请求。这是滚动上限,而非按月计数,因此适合辅助编程会话中典型的突发式用法。
此次集成延续了 Grok 4.6 向第三方工具开放的趋势:该模型于 8 月 14 日登陆 GitHub Copilot,8 月 19 日登陆 Amazon Bedrock,随后于 8 月 21 日加入 Google 的 Gemini Enterprise Agent Platform。此外,xAI 早在 2026 年 5 月便已通过 SuperGrok 和 X Premium 订阅接入 OpenCode——因此本次更新的重点并不是提供 OpenCode 访问权限,而是让 Go 方案纳入 4.6 模型及其配套配额,无需用户自行提供 xAI 订阅。
🔗 @grok 转发 · @opencode 公告
Cohere 发布 IDC 关于 2026 年主权 AI 应用情况的研究
8 月 25 日 — Cohere 发布了一份委托 IDC 编制的 InfoBrief,介绍受监管行业采用主权 AI 的情况。该研究于 2026 年 4 月至 5 月期间,调查了加拿大、美国、英国和德国逾 500 名来自年营收超过 10 亿美元企业的高级决策者。
最值得关注的结果与其说是应用程度,不如说是概念上的混淆。三分之一的高管难以用自己的话描述主权 AI,只有 13% 的人表示自己对该主题有非常广泛的了解。在能够给出定义的人中,52% 从地方或国家控制的角度进行表述,35% 提到了数字独立。这一差距也贯穿组织架构:IT 负责人的认知水平是业务负责人的两倍。
| 受访行业 | 将数据泄露与合规视为首要关切 | 将竞争优势视为驱动力 |
|---|---|---|
| 金融服务 | 82 % | 21 % |
| 制造业 | 77 % | 32 % |
| 电信 | 75 % | 37 % |
| 医疗健康 | 74 % | 28 % |
| 能源 | 70 % | 21 % |
在推动因素方面,各行业的共识清晰且一致:数据泄露、隐私和合规在所有受访行业中均位居首位。竞争优势是次要但不断增强的驱动力,加拿大(35%)和美国(28%)对此的重视程度高于德国(23%)和英国(18%)。这项研究显然有助于强化 Cohere 的市场定位,其智能体平台 North 可在客户选择的基础设施和司法管辖区内运行;不过这些数据确实来自明确标注的来源。IDC 还预测,到 2028 年,跨国企业的首席信息官将把对模块化主权云环境和数据本地化的投资提高 65%。
简讯
- Bain & Company 加入 Claude Partner Network — 这家咨询公司成为 Global Premier 合作伙伴,并在其 19,000 名员工中部署 Claude;试点阶段活跃用户便已超过 7,000 人,且超过三分之二的参与者采用了 Claude for Excel。🔗 Anthropic 博文
- Amp 解释什么是 orbs — Thorsten Ball 针对这一名称引发的困惑发布说明:orb 是一种远程智能体,可通过网页、手机或 CLI 进行操控。关于成本还有两点实用说明:无限期休眠不收费,同时运行的 orbs 数量也没有上限。🔗 Amp 说明
- Together AI 开放 Qwen3.8 27B 微调及专用推理 — 该模型现已同时支持基于自有数据的微调,以及在预留硬件上运行的 Dedicated Model Inference。🔗 @togethercompute 推文
- FINAL-Bench 推出 FINCHAL,一项面向智能体的金融预测竞赛 — 比赛奖金为 2,000 美元,要求提交头寸而非预测,并公布了运气上限(luck ceiling),以区分能力与偶然因素。🔗 FINAL-Bench 博文
- Au-Zone 发布 EdgeFirst Model Zoo — 其中包含四个用于检测和分割的 YOLO 系列,并在真实嵌入式芯片上进行测量;每项公布的数据都可追溯至产生该数据的验证会话,与制造商公布的含糊 TOPS 指标形成对比。🔗 EdgeFirst 博文
- Gemini 面向 macOS 推出智能听写 — 可在桌面上的任意窗口中进行听写,自动删除犹豫停顿,并识别句中途作出的修正;还可以通过语音总结文件和改写文本。🔗 blog.google 指南
- push rules 支持路径例外 — 在公开预览中,Restrict file paths 和 Restrict file size 规则可以豁免特定路径,例如在除
**/gradle/wrapper/*.jar之外的所有位置禁止 JAR。🔗 GitHub 更新日志 - 可从安全公告中屏蔽用户 — 在公共仓库中,可通过描述或评论的三点菜单执行该操作,无需返回设置页面;公告内容会保持不变。🔗 GitHub 更新日志
- Manus 表示数据恢复需求旺盛 — 未能成功完成的恢复操作需要在当天晚些时候重新发起;官方明确要求保持备份包完整且不作任何改动。🔗 @ManusAI 推文
- Kling 发布三篇 MCP 服务器指南 — 可将 Kling 连接到兼容 MCP 的助手,以复用经过验证的创作配置并批量生成变体;三篇教程中有两篇将 Claude Code 列为客户端。🔗 Kling 博客
- Wan 3.0 登陆 Runway 和 Replicate — Runway 于 8 月 24 日完成集成,支持图像、视频和音频的多项参考输入;Replicate 于 25 日跟进,重点宣传其单次即可原生生成带同步音频的 30 秒内容。🔗 @runwayml 推文
- Runway 宣布 AI Summit 新增演讲嘉宾 — 这场将于 9 月在旧金山举办的活动扩展了议程,涵盖机器人、自动驾驶汽车、营销和基础设施。🔗 @runwayml 推文
- MiniMax 发布 H3 集成索引 — Awesome MiniMax H3 Integrations 汇总了围绕该开放视频模型构建的项目,其中包括可在 24 GB VRAM 上运行的配置。🔗 @MiniMax_AI 推文
- Luma 推出 Dream Lab Weekly — 这是一个聚焦 Luma 创意专业人士及其每周产品工作的视频系列,现已发布第一期。🔗 @LumaLabsAI 推文
- NVIDIA 播出关于开放模型路由的 Nemotron Labs 专场 — 这场时长 55 分钟的直播题为 Get Started with Open Model Routing,是 Nemotron 3.5 Lightning 和 NeMo Switchyard 相关工作的延伸。🔗 @NVIDIAAI 推文
- Grok Imagine 奥德赛竞赛仅剩一周 — 参赛者需要创作一个取材自《奥德赛》的场景,以展现该工具的视频与语音能力;奖金分别为 100,000、50,000 和 25,000 美元。🔗 @grok 推文
- Plus 和 Pro 订阅用户可储备限额重置次数 — 用户无需等待重置时间窗口,可以消耗预先储备的一次重置机会;上线时免费赠送一次,之后可通过推荐获得更多,Business 方案还可共享 workspace 额度。🔗 ChatGPT 和 Codex 更新日志
这意味着什么
硅再次成为模型实验室的核心议题。 OpenAI 在同一天公布了其自研推理芯片的首批实测数据,以及阐述其 compute 战略的文章。这并非日程上的巧合:一家模型供应商亲自设计硅芯片,在第三方公开 benchmark 上进行测量,并公开宣示由十家合作伙伴组成的组合,这改变了竞争的性质。问题不再是“哪个模型最好”,而变成“每项成功任务的成本是多少”,答案既取决于机架,也取决于权重。最值得关注的细节或许还在别处:AI 被用于设计芯片和编写内核,从设计到投产仅用了九个月,而且生成的实现方案在选定模块上超过了人类专家的实现。闭环由此形成——模型正在设计未来运行自身的硬件。
AI 正在回归设备端,数据也开始印证这一趋势。 同一天出现的三个信号都指向同一个方向。Perplexity 在一台 DGX Spark 上完全本地运行其 agent,不消耗 credits,是否升级到 cloud 仍由用户决定。Multiverse Computing 发布了一种方法,使 4-bit 模型能够达到或超过其全精度源模型,从而消除了反对激进 quantization 的惯常理由。Au-Zone 按嵌入式硅平台发布了视觉性能测量,并指出厂商宣传的 TOPS 无法说明某个具体模型究竟能达到怎样的实际表现。这三项工作都没有声称能够媲美 frontier:Perplexity 坦诚公布的数据是,在 Terminal Bench 2.1 上,本地运行得分为 59.6%,而 Claude Opus 5 单独运行时为 82.4%。但升级到顾问模型能以三分之二的成本弥合五分之三的差距;正是这种权衡,而非性能持平,让本地执行变得合理可行。
开放权重正在成为基准立场。 Qwen 转发的一项针对 500,000 篇 arXiv 论文的分析记录了一个已经能够感受到的逆转:中国开放模型的提及占比从 10% 上升至约 40%,而美国开放模型则停滞在 25% 至 30% 之间。Qwen3.8-27B 作为唯一具有这一规模的模型进入 Code Arena 前十;GLM-5.3 在多次试验中以低 2.1 至 5.4 倍的成本,在 DeepSWE 上超过 GPT-5.6 Sol 和 Claude Fable 5;IBM 在首日便开放 Granite 4.2,同时提供四种 quantized 变体和十四种 GGUF 格式——相同的逻辑不断重现。开放权重不再是一种追赶姿态,而是成为他人默认基础设施的一种方式;不过,正如 Nathan Lambert 本人所指出的,还需注意一点:论文发表滞后于模型发布,因此这些曲线反映的是正在进行的工作,而非当下的偏好。
与此同时,Web 正在为由 agent 而非人眼读取做好准备。 WebMCP Challenge 是一项奖金为 35,000 美元的竞赛,这个数额并不高;但它所揭示的意义要大得多。Chrome、Cloudflare、Shopify、Vercel、Render 和 Netlify 与 OpenAI 一道支持一项标准,要求网站公开结构化工具,而不是让 agent 猜测如何操作界面。同一天,ChatGPT desktop 已能原生使用 WebMCP,Codex 已能创建并部署兼容应用,而 OpenAI 也记录了其在一款 notebooks 工具中对该协议的内部应用。这种趋同与 Rohlik 所描述的情况不谋而合:其拥有五十多项 MCP 集成,并坚持所有新工具都必须从第一天起可供 agent 使用。面向 agent 的接口层正从研究课题转变为工程要求。
来源
- OpenAI — WebMCP Challenge
- OpenAI — 在 X 上宣布 WebMCP Challenge
- OpenAI — ChatGPT desktop 和 Sites 中的 WebMCP
- OpenAI — 使用 Codex、Runme 和 WebMCP 自动化重复性工作
- OpenAI — Jalapeño 首批结果
- OpenAI — 丰裕智能背后的完整技术栈
- OpenAI — 面向 ChatGPT Work 和 Codex 的 Admin plugin
- OpenAI — 浏览器扩展现已支持 Edge、Brave、Opera 和 Vivaldi
- OpenAI — ChatGPT Business Premium 席位
- ChatGPT 与 Codex — 更新日志
- Perplexity — 发布 Portable Computer
- Perplexity — Portable Computer 文章
- Perplexity — 本地 harness 的 benchmark
- Anthropic — Claude 的记忆功能可在任何地方使用
- Anthropic — 在 X 上发布记忆功能公告
- Anthropic — Claude Code 更新日志
- Anthropic — streaming 渲染流畅度提升 4 倍
- Anthropic — 福祉研究资助
- Anthropic — Bain & Company 加入 Claude Partner Network
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — gr.Workflow 指南
- FINAL-Bench — FINCHAL 竞赛
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B 的 fine-tuning 与专用 inference
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — Antigravity 更新日志
- Google — 面向 macOS 的 Gemini 智能听写
- Stability AI — 7,600 万美元 B 轮融资
- Stability AI — 在 X 上发布公告
- NVIDIA — Gamescom 与 RTX Spark
- MiniMax — H3 上的 SANA 与 Sol Engine
- MiniMax — H3 集成索引
- NVIDIA — 关于开放模型路由的 Nemotron Labs 专场
- Qwen — Code Arena WebDev 上的 Qwen3.8-27B
- Qwen — 转发 arXiv 分析
- Nathan Lambert — 深入分析 500,000 篇 arXiv 论文
- Warp — factory.yaml 格式与抢先体验
- Cognition — Rohlik Group 案例研究
- Devin — Rohlik Group 客户页面
- Amp — orbs 详解
- GitHub — 四项全新 GitHub Skills 练习
- GitHub — Customize 标签页正式发布
- GitHub — push rules 中的路径例外
- GitHub — 从安全公告中进行阻止
- Manus — 数据恢复进展
- ElevenLabs — Composer
- HeyGen — LiveAvatar 的无限并发
- Kling — MCP server 指南
- Runway — Wan 3.0 已在平台上线
- Runway — AI Summit 新增演讲嘉宾
- Luma — Dream Lab Weekly
- xAI — OpenCode Go 中的 Grok 4.6
- OpenCode — Go 套餐中的 Grok 4.6
- xAI — 以《奥德赛》为主题的 Grok Imagine 竞赛
- Cohere — 2026 年主权 AI 应用现状