ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Eenenvijftig aankondigingen in vierentwintig uur, verspreid over negen domeinen: 25 augustus is de drukste dag van de week. Vier ontwikkelingen springen eruit. OpenAI publiceert de eerste gemeten resultaten van Jalapeño, zijn eigen inferencechip, en lanceert meteen daarna samen met Chrome, Cloudflare, Shopify, Vercel, Render en Netlify een tiendaagse hackathon rond WebMCP. Perplexity verplaatst zijn volledige Computer-agent naar de machine van de gebruiker. IBM stelt Granite 4.2 open, zijn eerste familie van reasoningmodellen. En Anthropic brengt het geheugen van Claude in chat en Cowork samen en maakt het per bestand leesbaar en bewerkbaar. De rest — WeatherNext Cyclones in gebruik bij het National Hurricane Center, de Series B-financieringsronde van Stability AI en een twintigtal toolupdates — volgt hieronder.
WebMCP: een standaard, productondersteuning, intern gebruik en een wedstrijd om hem op gang te brengen
25 augustus — OpenAI lanceert de WebMCP Challenge, een tiendaagse hackathon rond een nog experimentele open standaard die verandert hoe agents met het web omgaan. Het beoogde probleem is concreet: wanneer een agent tegenwoordig een taak op een website moet uitvoeren, moet hij raden hoe hij door een voor ogen en een muis ontworpen interface moet navigeren. WebMCP draait die logica om: de site biedt zelf gestructureerde tools aan die de agent rechtstreeks aanroept.
De wedstrijd is niet het opmerkelijkste aspect van de aankondiging. Dat is de afstemming die eruit blijkt: Chrome (Google), Cloudflare, Shopify, Vercel, Render en Netlify werken allemaal met OpenAI aan dezelfde standaard. De jury weerspiegelt dit, met Sarah Drasner (Distinguished Engineer, Chrome), Andrew Galloni (VP Research & Innovation, Cloudflare), Jude Gao (Next.js Core-team, Vercel), Ilya Grigorik (Distinguished Engineer, Shopify), Sean Roberts (VP of Applied AI, Netlify), Justin Rushing (Browser Agent Lead, OpenAI) en Alex Nahas, de maker van MCP-B.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇳🇱 De WebMCP Challenge is van start gegaan. We hebben de handen ineengeslagen met @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render en @Netlify voor een tiendaagse hackathon. Er valt 35.000 dollar aan geldprijzen te winnen, naast Codex Micro’s, ChatGPT Pro-abonnementen en andere prijzen van onze partners. — @OpenAIDevs op X
Het tijdschema is strak en de beoordelingscriteria zijn expliciet: nut, originaliteit, uitvoering, doordacht gebruik van WebMCP en de kwaliteit van de ervaring tussen mens en agent. Inschrijvingen en inzendingen verlopen via Devpost. OpenAI publiceert ook agent-native demoapplicaties om projecten op gang te helpen — door de agent aangestuurde 3D-modellering, gezamenlijk schrijven waarbij de agent onder zijn eigen identiteit commentaar geeft, een generator voor gepersonaliseerde kruiswoordraadsels, Wandernote om reisnotities om te zetten in een reisroute, en gegevensverkenning via DuckDB-Wasm in de browser. Het is toegestaan om van een bestaande applicatie uit te gaan en daar WebMCP aan toe te voegen.
| Onderdeel van de wedstrijd | Aangekondigde details |
|---|---|
| Aangekondigde duur | 10 dagen |
| Opening van de inzendingen | 25 augustus 2026, 12.00 uur PT |
| Uiterste inzenddatum | 3 september 2026, 13.00 uur PT |
| Bekendmaking winnaars | 23 september 2026 (voorlopige datum) |
| Totale prijzenpot | 35.000 dollar |
| Prijs per winnaar (top 10) | 3.000 dollar, één jaar ChatGPT Pro, een Codex Micro-toetsenbord, goodies |
| Inzendplatform | Devpost |
De productcomponent die de standaard dagelijks bruikbaar maakt, verschijnt dezelfde dag: de ingebouwde browser van de ChatGPT-desktopapp en ChatGPT Sites kunnen nu WebMCP gebruiken. Wanneer ChatGPT of Codex een compatibele site bezoekt, detecteert de agent de tools die de pagina aanbiedt en gebruikt hij die automatisch in plaats van zijn weg door de interface te zoeken — een update naar de nieuwste versie van de desktopapp is vereist. De andere helft van de cyclus bevindt zich aan de productiekant: het wordt mogelijk om Codex te vragen een WebMCP-compatibele applicatie te maken en deze vervolgens rechtstreeks op Sites te implementeren. Opmerkelijk is de asymmetrie in ondersteuning met Chrome, waar WebMCP achter een experimentele flag of een origin trial blijft, terwijl de browser van ChatGPT het native ondersteunt.
Dan blijft het derde en leerzaamste deel over: OpenAI documenteert zijn eigen interne gebruik. Een engineer van het bedrijf vertelt hoe hij stopte met het schrijven van één automatisering per taak en in plaats daarvan Runme bouwde, een open-source webapplicatie voor notebooks die is ontworpen om met Codex samen te werken. Daarin schrijft hij een kort doel met expliciete instructies — een eerdere uitvoering raadplegen, een gedetailleerd plan opstellen, vóór aanvang op goedkeuring wachten, en de uitgevoerde commando’s en hun interpretatie documenteren — waarna Codex het notebook tijdens het werk leest en bijwerkt. Twee architectuurkeuzes verdienen aandacht. Ten eerste persistentie: de notebooks worden opgeslagen in Google Drive en Runme genereert daarnaast een bijbehorende Markdown-index *.index.md die Drive kan indexeren, zodat een agent een eerdere uitvoering als operationele context kan terugvinden. Ten tweede het beschikbaar stellen van functionaliteit: Runme is een statisch aangeboden clientapplicatie, en het toevoegen van een server uitsluitend om een klassiek MCP-endpoint beschikbaar te stellen, zou infrastructuur hebben toegevoegd en de verwerking van notebookgegevens hebben verplaatst. Met WebMCP kan de applicatie haar tools rechtstreeks vanuit de browser registreren.
🔗 WebMCP Challenge · Ondersteuning in ChatGPT desktop en Sites · Codex, Runme en WebMCP bij OpenAI
Jalapeño: OpenAI publiceert de eerste cijfers van zijn inferencechip en staat achter zijn computestrategie
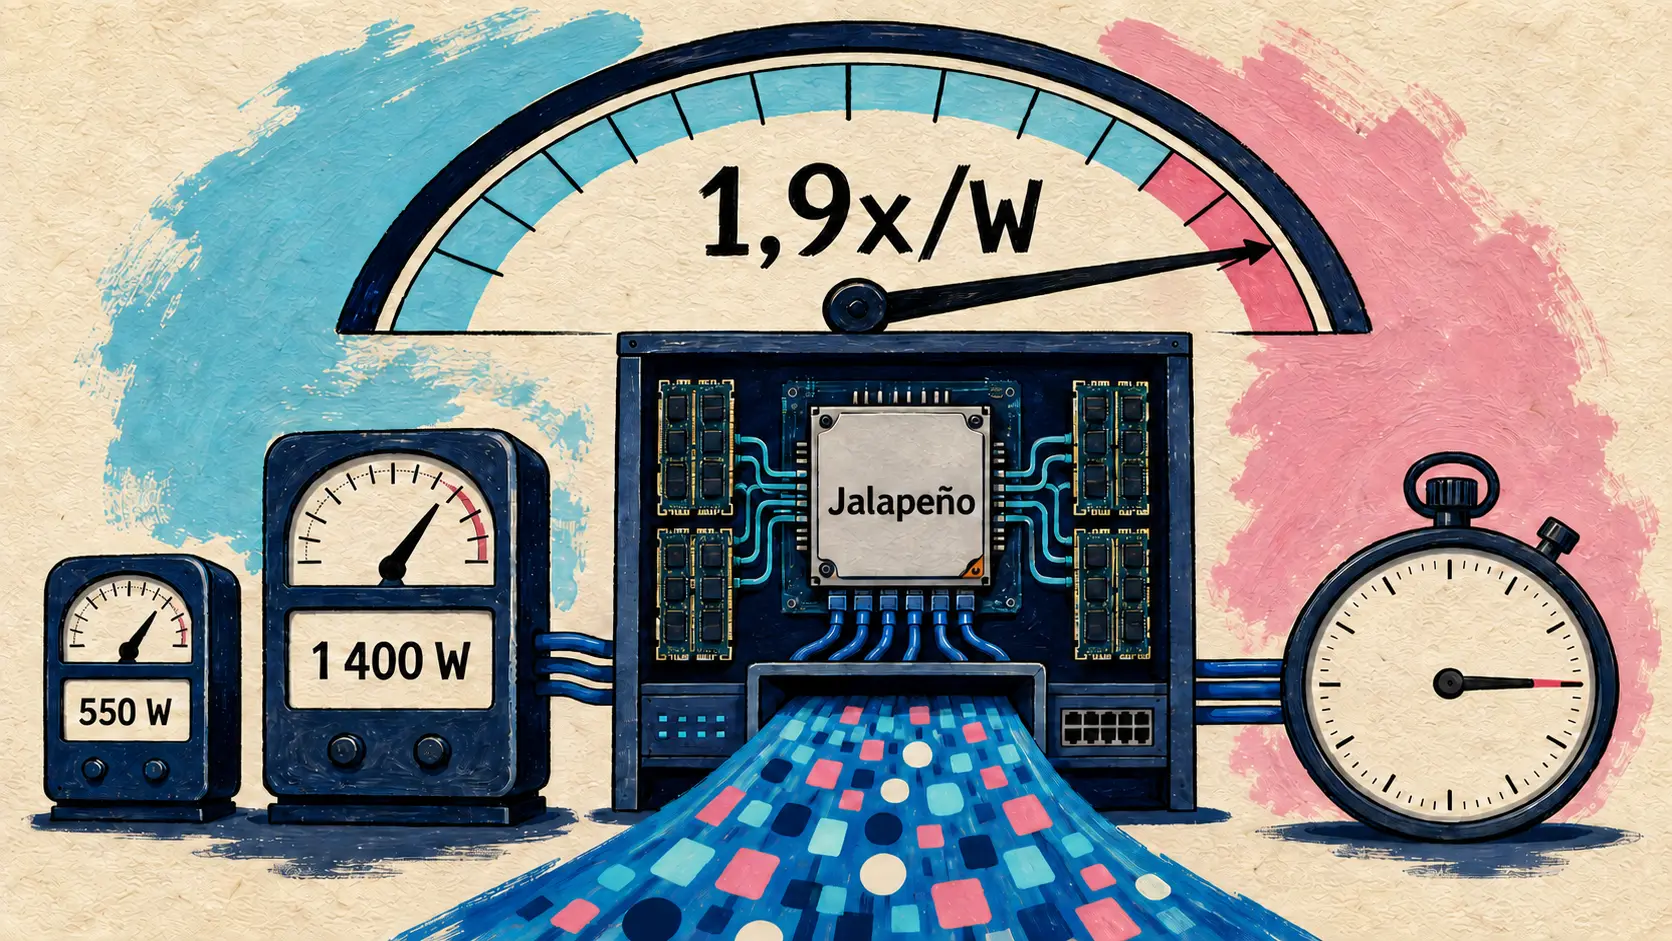
25 augustus — OpenAI publiceert de eerste gemeten resultaten van Jalapeño, de eerste inferencechip die het bedrijf zelf heeft ontworpen. Het belang van de aankondiging schuilt niet alleen in de ruwe winst, maar ook in de aard van het compromis dat de chip naar eigen zeggen opheft: bestaande inferencesystemen moeten doorgaans kiezen tussen doorvoer en latency, terwijl Jalapeño beide binnen één architectuur claimt.
De metingen zijn gebaseerd op InferenceX, een openbare benchmark van SemiAnalysis die de volledige verwerking van een verzoek simuleert. Drie open modellen werden getest — GPT-OSS 120B, DeepSeek R1 670B en Kimi K2.5 1T — tegenover commerciële systemen. De keuze om per watt in plaats van per chip te normaliseren is expliciet en handig: Jalapeño verbruikt de helft van het vermogen van de systemen waarmee de chip wordt vergeleken. Jalapeño heeft een opgegeven vermogen van 700 W en het gemeten continue verbruik bleef bij de geteste workloads 550 W of lager, tegenover 1.200 W voor de GB200 en 1.400 W voor de GB300.
| Geëvalueerd model (vergeleken systeem) | Piekdoorvoer per kW | End-to-end latency | Minimale TBT |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
Over alle drie de modellen meldt OpenAI bij piekdoorvoer 1,5 tot 1,9 keer meer AI-werk per watt en een 1,7 tot 3,6 keer lagere end-to-end latency dan de vergelijkingssystemen, en tot 2,1 tot 4,1 keer betere prestaties bij zeer interactieve workloads. Technisch gezien komen de verbeteringen voort uit een gezamenlijk ontwerp van chip, geheugen, netwerk, software en systeem op rackschaal. Inference doorloopt twee fasen met verschillende knelpunten: prefill, waarbij de prompt wordt verwerkt en de rekencapaciteit verzadigd raakt, en decode, waarbij tokens één voor één worden geproduceerd en die vooral afhankelijk is van de geheugenbandbreedte. Jalapeño probeert gegevensverplaatsingen tot een minimum te beperken; de toestand van het model — inclusief de KV-cache — kan expliciet worden geplaatst en lokaal worden gehouden, terwijl het systeem afhankelijk van de fase de juiste combinatie van rekenkracht, geheugen en netwerk activeert.
Voor een ontwikkelaar betreft het interessantste onderdeel de rol van AI bij het ontwerp van de chip zelf. OpenAI geeft aan in negen maanden van het eerste ontwerp naar tapeout te zijn gegaan door de cycli voor ontwerp, meting en verificatie te verkorten. De chip is ontworpen als een voorspelbaar programmeerdoel voor zowel AI als mensen: werk wordt beschreven via lokale tensors, met expliciete communicatie en voorspelbare synchronisatie. Met Codex en GPT-Astra bracht het team in twee maanden drie modellen met open gewichten over die niet in het oorspronkelijke productieplan stonden, en op geselecteerde attention- en mixture-of-experts-blokken van GPT-OSS draaien door AI gegenereerde kernels 1,5 tot 1,8 keer sneller dan implementaties die door menselijke experts zijn geschreven. De nuance moet behouden blijven: deze cijfers gelden voor de geselecteerde blokken, niet voor het volledige model. De planning blijft voorzichtig — productiekwalificatie loopt, de software moet verder rijpen, implementatie in de infrastructuur van OpenAI is aangekondigd voor het einde van het jaar, Gen 2 bevindt zich in een vergevorderd ontwikkelingsstadium en Gen 3 begint vorm te krijgen.
Diezelfde dag publiceert Sarah Friar het bericht waarin ze de economische logica hierachter uiteenzet. Daarin bepleit ze een breed computeportfolio — met Microsoft en NVIDIA als fundament, aangevuld door AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy en SoftBank — met een argument dat zowel commercieel als technisch is: een geloofwaardige keuze tussen leveranciers behouden maakt het mogelijk elke workload naar de beste prijs-prestatieverhouding te leiden en prijsdiscipline te handhaven. De boodschap gaat vergezeld van een concreet cijfer: op de Artificial Analysis Coding Agent Index vestigt GPT-5.6 Sol met maximale reasoning een nieuw record, terwijl het 54% minder outputtokens verbruikt dan een ander toonaangevend model. De tekst omarmt ten slotte de paradox van Jevons — intelligentie goedkoper maken vermindert het verbruik ervan niet, maar vergroot het bereik van rendabele toepassingen. Wat de infrastructuur betreft, wordt Project Camellia in Georgia gepresenteerd met een gesloten watercircuit en toezeggingen die jaarlijks aan een onafhankelijke openbare audit worden onderworpen. OpenAI benadrukt dat het de accelerators van NVIDIA en zijn andere partners op grote schaal zal blijven inzetten, zowel voor training als voor inference.
🔗 Jalapeño — eerste resultaten · De volledige stack achter overvloedige intelligentie
Perplexity Portable Computer: alles draait op het apparaat, ondersteund door benchmarks
25 augustus — Perplexity lanceert Portable Computer, een variant van zijn Computer-agent die volledig op het apparaat van de gebruiker draait. De omschakeling is eerder architectonisch dan cosmetisch: niet alleen het model draait lokaal, maar de volledige orchestration-keten — orchestrator, planner, tool-router, scheduler, persistente taakwachtrij en lokale zoekindex.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇳🇱 Vandaag lanceren we Portable Computer op de @NVIDIA DGX Spark. Portable Computer is een volledig lokale versie van Perplexity Computer, waarbij de volledige runtimeomgeving — de orchestrator-LLM, de LLM van de subagents en de agent harness — op uw lokale hardware draait. Geen afhankelijkheid van de cloud. — @perplexity_ai op X
De aankondiging gebeurt samen met NVIDIA en richt zich in eerste instantie op de DGX Spark — Grace Blackwell GB10-platform, 20-core Arm-CPU, NVIDIA-GPU, 128 GB unified memory — met een aangekondigde uitbreiding naar pc’s met RTX-GPU’s. Er kan worden gekozen uit twee modellen, Qwen 3.8 27B of PPLX 27B, Perplexity’s post-getrainde versie van het Qwen-model, en NVIDIA Nemotron 3.5 Lightning, een open 30B-model, zal aan de modelkiezer worden toegevoegd. Lokaal verwerkt werk verbruikt geen credits. Escalatie naar de cloud blijft mogelijk — voor actuele informatie, de browser, gekoppelde applicaties of een van de meer dan 15 frontier-modellen — maar vereist expliciete toestemming van de gebruiker. De connectors voor Google Drive, Gmail, Slack en GitHub werken vanaf het apparaat, dicteren wordt lokaal uitgevoerd via het NVIDIA Nemotron 3.5 ASR Model zonder dat de audio het apparaat verlaat, en code wordt uitgevoerd in een geïsoleerde sandbox. Portable Computer is voorbehouden aan Pro- en Max-abonnees met een DGX Spark, eerst op Linux en later op Windows, met installatie in één klik vanuit de applicatie.
Diezelfde dag publiceert het engineeringteam de cijfers die deze lancering onderbouwen. De stelling is dat model en harness samen moeten worden ontworpen: generieke harnesses gaan uit van een frontier-model dat lange contexten kan verwerken en over een lange horizon kan plannen, iets waar lokale modellen moeite mee hebben.
| Gemeten benchmark | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench (53 taken) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp (1 266 taken) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100 (multimodale documenten) | 65,1 % | 13,9 % | 34,6 % | — |
Op BrowseComp gebruikt Computer bovendien 61 % minder tijd en 16 % minder tokens dan Hermes, en 51 % minder tijd en 70 % minder tokens dan Pi. Vier ontwerpkeuzes verklaren het verschil: een minimale systeemprompt, in skills gemodulariseerde mogelijkheden die tijdens het traject worden geladen en ontladen, veelgebruikte connectors (Gmail, GitHub, Outlook, Google Calendar) die zijn omgezet in compacte command-line tools in plaats van te worden aangeboden als MCP-servers waarvan de definities de context opslokken, en een altijd actieve, niet-configureerbare sandbox — als die niet beschikbaar is, schakelt de harness zichzelf vóór elke tool-aanroep uit in plaats van over te schakelen op niet-geïsoleerde uitvoering. Perplexity vermeldt ook een nuttige praktische bevinding: Qwen 3.8 27B claimt een contextvenster van 260K tokens, maar begint empirisch boven 100K moeite te krijgen.
| Terminal Bench 2.1 (89 taken) | Score | API-kosten per uitvoering |
|---|---|---|
| Qwen 3.8 27B, 100 % lokaal | 59,6 % | ongeveer 0 |
| Qwen 3.8 27B + advies Claude Opus 5 | 73,0 % | 0,415 USD |
| Alleen Claude Opus 5 | 82,4 % | 0,65 USD |
Het escalatiemechanisme naar een adviserend model (advisor) is het interessantste punt van het rapport: het overbrugt ongeveer drie vijfde van de achterstand op frontier-modellen voor ruwweg twee derde van de kosten, terwijl de gebruiker de beslissing in handen houdt. Voor elke aanroep selecteert de harness de relevante context, past hij een classifier voor persoonsgegevens toe en toont hij de gebruiker wat het apparaat zou verlaten; het adviserend model stuurt uitsluitend tekst terug en heeft geen rechtstreekse toegang tot bestanden of tools. De post-training van PPLX 27B combineert ten slotte rejection fine-tuning met reinforcement learning in synthetische omgevingen die in Docker-containers worden uitgevoerd, zonder enige echte gebruikersgegevens. Een technisch rapport en de open-sourcerelease van de evaluatiebenchmark zijn aangekondigd.
🔗 Benchmarks van de lokale harness · Portable Computer — Perplexity-blogbericht
Claude: één geheugen voor chat en Cowork, bestand voor bestand leesbaar
25 augustus — Anthropic heft de grens op tussen twee geheugens die tot nu toe naast elkaar bestonden. Wat Claude uit uw gesprekken in de chat onthoudt, is voortaan precies wat het in Claude Cowork tot zijn beschikking heeft, en omgekeerd. Wanneer Cowork een taak in de cloud uitvoert, begint het concreet met de context die in de loop van maanden is opgebouwd: de prioriteiten van het kwartaal, de voortgang van projecten en de schrijfvoorkeuren van een gesprekspartner. Anthropic geeft bewust alledaagse voorbeelden — vragen om een voortgangsrapport voor uw leidinggevende zonder te hoeven verduidelijken wie dat is of hoe die persoon de informatie het liefst ontvangt.
De tweede verandering is subtieler, maar verandert het dagelijkse gedrag: het geheugen wordt tijdens het gesprek bijgewerkt in plaats van via een achteraf gemaakte samenvatting. Vermelden dat een deadline naar september is verschoven, volstaat om daar in het volgende gesprek rekening mee te houden. De formulering ‘onthoud dit’ blijft beschikbaar om het opslaan van een specifiek gegeven af te dwingen, en het geheugen kan op elk moment worden gepauzeerd of gereset.
Wat transparantie betreft, heeft Anthropic gekozen voor een leesbare weergave in plaats van een black box: alles wat Claude onthoudt, verschijnt als korte, op onderwerp gerangschikte bestanden onder Instellingen en vervolgens Geheugen. Elk bestand kan afzonderlijk worden gelezen, gecorrigeerd of verwijderd. Het praktische voordeel is direct duidelijk — de oude naam van uw bedrijf in één bestand corrigeren volstaat om in alle volgende gesprekken de juiste naam te gebruiken.
De omgang met gevoelige onderwerpen is vanuit productperspectief het interessantste punt. Standaard onthoudt Claude niets over gezondheid, afkomst, etniciteit, religieuze overtuigingen, politieke opvattingen of genderidentiteit. Anthropic erkent echter dat deze grens persoonlijk is en biedt een optionele instelling om deze onderwerpen op te nemen — zodat Claude bijvoorbeeld een glutenintolerantie kan onthouden wanneer het recepten voorstelt. Deze instelling werkt niet met terugwerkende kracht en kan op elk moment worden uitgeschakeld. Eén categorie blijft ongeacht de instelling uitgesloten: identificatienummers, strafrechtelijk verleden, migratiestatus en meer in het algemeen alles wat in strijd is met het Beleid voor aanvaardbaar gebruik. Claude meldt expliciet wanneer het dergelijke informatie niet kan opslaan, een ontwerpkeuze die de voorkeur geeft aan een zichtbare weigering boven stille filtering.
| Geheugenaspect | Beschreven gedrag |
|---|---|
| Bereik | Eén geheugen dat wordt gedeeld tussen chat en Claude Cowork |
| Moment van bijwerken | Tijdens het gesprek, voorheen via een samenvatting na afloop |
| Opslagformaat | Korte, op onderwerp gerangschikte bestanden, afzonderlijk leesbaar en bewerkbaar |
| Gevoelige onderwerpen | Standaard niet opgeslagen, via een instelling activeerbaar, zonder terugwerkende kracht |
| Permanente uitsluitingen | Identificatienummers, strafrechtelijk verleden, migratiestatus |
| Free-, Pro- en Max-plannen | Geheugen standaard actief op het web, desktop en mobiel |
| Team- en Enterprise-plannen | Door de beheerder beschikbaar gesteld, per gebruiker uitgeschakeld tot activering |
🔗 Het geheugen van Claude werkt overal · Aankondiging van @claudeai
IBM maakt Granite 4.2 open, zijn eerste reasoning-familie, en twee ASR-modellen van 470M
25 augustus — IBM publiceert Granite 4.2, gepresenteerd als zijn eerste familie van dense, decoder-only taalmodellen die expliciet zijn ontworpen voor reasoning. Waar eerdere generaties zich richtten op efficiëntie en klassieke bedrijfstaken, stelt deze versie reasoning centraal en maakt ze dit instelbaar: elk model biedt drie modi — thinking, non-thinking en low-effort — waaruit de applicatie kiest op basis van het latency- en tokenbudget dat ze bereid is te besteden. De drie formaten (3B, 8B, 30B) delen dezelfde architectuur en pipeline, waardoor de overstap van het ene naar het andere model aan de integratiekant probleemloos verloopt.
De architectuur blijft klassiek: GQA-attention met 40 heads en 8 KV-heads, RoPE met een θ van 10 miljoen om een context van 131 072 tokens te ondersteunen, SwiGLU-MLP, RMSNorm-normalisatie en training in bfloat16 op een door CoreWeave gehost NVIDIA GB200 NVL72-cluster. De pre-training begint vanaf nul met ongeveer 15 biljoen tokens, verdeeld over vijf fasen. Wat Granite 4.2 echt onderscheidt, is de post-training: een reinforcement-pipeline met een reeks gespecialiseerde stappen in plaats van één enkele pass, met asynchrone GRPO en truncated importance sampling, zodat de generatie- en trainingshelften van de loop elkaar nooit blokkeren. Het curriculum omvat achtereenvolgens drie RLVR-passes met verifieerbare beloningen, gerichte boosters voor instruction following en code, twee stappen voor software engineering met een 128K-context, een terminalstap, een onderzoeksstap en vervolgens RLHF-alignment. Het blok voor agentic reinforcement wordt alleen toegepast op de 8B- en 30B-modellen, wat het prestatieverschil bij agentic coding tussen het 3B-model en zijn grotere broers verklaart.
| Door IBM gepubliceerde benchmark | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
De release beperkt zich niet tot bfloat16-weights: vier gekwantiseerde varianten voor vLLM worden meegeleverd — dynamische FP8 per kanaal zonder calibratie, NVFP4 en MXFP4 via GPTQ, gecalibreerd op 2 000 SFT-samples — evenals veertien GGUF-formaten voor llama.cpp, van Q2_K tot Q8_0. Twaalf talen worden ondersteund, waaronder Frans, en vanaf de eerste dag zijn drie harnesses voor agentic coding gedocumenteerd: OpenCode, Pi en OpenHands. Wat de datakwaliteit betreft, beschrijft IBM een keten waarin GPT-OSS-120B en Gemma 4 als beoordelaars dienen om de SFT-samples te scoren, vóór lokale en globale deduplicatie met SHA-256-hashing.
Diezelfde dag publiceert IBM Granite Speech 5.0 Turbo CTC, twee Engelstalige spraakherkenningsmodellen met 470 miljoen parameters die alleen verschillen in hun trainingsdata en licentie — Apache 2.0 voor de standaardvariant en CC-BY-NC-SA-4.0 voor de variant die met aanvullende data is getraind. De architectuurwijziging is opmerkelijk: eerdere Granite Speech-modellen combineerden een akoestische encoder, een projector en een LLM; deze modellen bestaan uitsluitend uit een encoder. De stack bestaat uit 16 Conformer-blokken, past self-conditioning toe op de uitvoer van het achtste blok, vervangt scaled dot-product attention door chunkwise attention om kwadratische schaling te vermijden en optimaliseert rechtstreeks de CTC-loss. De echte vernieuwing is de tokensnelheid: downsampling-bewerkingen brengen de stroom van 100 frames per seconde aan de uitvoer van het log-Mel-spectrogram terug naar 12,5 per seconde, wat ‘Turbo’ in de naam verklaart. De resultaten worden gerapporteerd op het OpenASR Leaderboard en het FFASR Leaderboard voor far-field-spraak, met Pareto-grafieken voor snelheid en nauwkeurigheid in plaats van afzonderlijke scores, en een demonstratie van continue herkenning die via WebGPU in de browser wordt uitgevoerd en beperkt is tot Chrome en Edge.
🔗 Granite 4.2 — technisch overzicht · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, eerste AI-model dat in realtime wordt gebruikt door het National Hurricane Center
25 augustus — Google AI geeft details over WeatherNext Cyclones, een model voor de voorspelling van tropische cyclonen van Google DeepMind en Google Research. De aankondiging is minder opmerkelijk vanwege de pure prestaties dan vanwege wat ze vertelt over de overgang van AI voor weersvoorspellingen van het laboratorium naar de operationele praktijk.
Het aangepakte probleem is structureel. Tot nu toe vergde het volgen van een cycloon een afweging: fysieke modellen die op supercomputers draaien, brengen de grote atmosferische structuren die over de planeet trekken goed in kaart, maar om de lokale en intense fysica te begrijpen die de kracht van een storm bepaalt, moest worden overgeschakeld op volledig andere regionale modellen. WeatherNext Cyclones maakt een einde aan dit heen-en-weer schakelen door het traject, de intensiteit en de omvang in één keer te voorspellen.
De aangekondigde winst bedraagt een volledige dag extra voorspellingstijd ten opzichte van eerdere systemen. Google formuleert de vergelijking treffend: driedaagse voorspellingen halen nu de nauwkeurigheid van de vroegere tweedaagse voorspellingen, een vooruitgang waarvoor historisch gezien een decennium aan methodologische ontwikkelingen nodig was. De tweede bijdrage is probabilistisch: het model is snel genoeg om tot 1.000 simulaties per storm te produceren, waardoor het ene „waarschijnlijkste” traject wordt vervangen door een reeks scenario’s. Hierdoor wordt snelle intensivering inzichtelijker, gedefinieerd als een toename van de maximale aanhoudende wind met minstens 30 knopen in 24 uur. Dit jaar worden via WeatherLab 1.000 probabilistische voorspellingen per storm aan voorspellers geleverd.
Het belangrijkste element blijft de daadwerkelijke implementatie. Tijdens het orkaanseizoen van 2025 werd WeatherNext Cyclones getest binnen het Amerikaanse National Hurricane Center — de eerste keer dat deze instelling AI-modellen gebruikt voor realtime-operaties. Meteorologen gebruikten het om de voorspelling op te stellen van de landing van orkaan Melissa als categorie 5 op Jamaica, waardoor lokale autoriteiten extra voorbereidingstijd kregen. Er is een artikel verschenen in Nature en Google kondigt aan de code en modelgewichten als open source op GitHub te publiceren.
| Aspect van het model | Bijdrage van WeatherNext Cyclones |
|---|---|
| Voorspelde grootheden | Traject, intensiteit en omvang in één enkele doorgang |
| Winst in voorspellingstijd | Eén dag; 3-daagse voorspelling = nauwkeurigheid oude 2-daagse |
| Simulaties per storm | Tot 1.000 |
| Operationele implementatie | U.S. National Hurricane Center, orkaanseizoen 2025 |
| Gedocumenteerde toepassing | Landing van orkaan Melissa als categorie 5 op Jamaica |
| Intensiveringsdrempel | Meer dan 30 knopen maximale aanhoudende wind in 24 uur |
| Beschikbaarstelling | WeatherLab; code en gewichten als open source op GitHub |
🔗 Aankondiging van @GoogleAI · Blogbericht van Google DeepMind
Stability AI rondt een Serie B van 76 miljoen dollar af met EA, Sony Music, Universal en Warner
25 augustus — Stability AI kondigt de afronding van zijn Serie B aan: 76 miljoen dollar aan nieuw kapitaal, waarmee de totale financiering sinds Prem Akkaraju in juni 2024 de leiding over het bedrijf overnam op 232 miljoen dollar komt, inclusief twee aandelenrondes en converteerbare obligaties. Het bedrag blijft bescheiden op sectorniveau, maar de samenstelling van de investeringsronde is het echte onderwerp.
Vier zwaargewichten uit de entertainmentsector nemen een belang: Electronic Arts voor videogames en Sony Music Group, Universal Music Group en Warner Music Group voor muziek. De drie grote platenmaatschappijen zijn nu aandeelhouder van hetzelfde laboratorium. Ook AMD Ventures en Pacific Alliance Ventures sluiten zich aan. Deze investeerders komen niet uit het niets: EA, Universal en Warner waren sinds het najaar van 2025 al strategische partners van Stability AI. De ronde zet bestaande commerciële overeenkomsten dus om in aandelenbelangen.
Een ander signaal is de trouw van de financiële investeerders. Coatue, Greycroft, Kadmos Capital, Sean Parker en Eric Schmidt investeren voor de tweede opeenvolgende ronde onder de nieuwe leiding opnieuw — wat na de turbulente periode die Stability AI in 2023 en 2024 doormaakte als bevestiging geldt. Thomas Laffont, medeoprichter van Coatue, treedt toe tot de raad van bestuur, waarin James Cameron, Sean Parker, Dana Settle en Prem Akkaraju al zitting hebben.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇳🇱 Deze ongeëvenaarde groep investeerders bevestigt onze visie op generatieve AI die iedere producent, muzikant en verhalenverteller meer mogelijkheden geeft. Stability is uniek op het gebied van AI, omdat wij creatievelingen zijn die hulpmiddelen voor creatievelingen maken. — Prem Akkaraju, CEO van Stability AI, persbericht van 25 augustus
De gekozen strategie is die van een nichelaboratorium: geen generalistisch model, maar hulpmiddelen voor creatieve professionals, ontwikkeld met rechthebbenden in plaats van tegen hen. Dat is precies de koers van Stable Audio 3.0, een familie van modellen met open gewichten die is getraind op volledig gelicentieerde gegevens en op 18 augustus is uitgebreid met een plugin voor audio workstations. Het geld moet de verdere productontwikkeling, toegepast onderzoek en de afdeling professionele dienstverlening financieren.
🔗 Aankondiging van @StabilityAI
ChatGPT voor bedrijven: Admin-plugin, extensie voor meerdere browsers en Premium-licentie van 100 dollar
25 augustus — Drie aankondigingen van OpenAI richten zich op hetzelfde publiek: organisaties die ChatGPT en Codex op grote schaal implementeren.
De meest inhoudelijke is de Admin-plugin voor ChatGPT Work en Codex, die in één gesprek samenbrengt waarvoor tot nu toe tussen analyticsdashboards, instellingenschermen en rapporten moest worden genavigeerd. Het toepassingsgebied omvat dagelijkse taken: inzicht krijgen in de adoptie en het kredietverbruik, leden of groepen opsporen die hun limieten naderen, in- en uitdiensttredingen beheren, de daadwerkelijk geldende machtigingen controleren en toegangsproblemen diagnosticeren, gebruikslimieten aanpassen en uitgavenverzoeken beoordelen aan de hand van het werkelijke verbruik. Het interessantste onderdeel is automatisering zonder code te schrijven: openstaande gebruiksverzoeken kunnen ter goedkeuring naar Slack of Microsoft Teams worden doorgestuurd, zodat beoordelaars ze kunnen behandelen in de tool die ze al gebruiken, en verzoeken om toegang tot een functie kunnen automatisch worden goedgekeurd wanneer ze aan vooraf vastgelegde criteria voldoen, terwijl uitzonderingen naar een mens worden doorgestuurd. Een belangrijk beveiligingsaspect is dat de plugin binnen de bestaande rol en machtigingen van de gebruiker werkt en geen enkele toegang uitbreidt; iedere instructie wordt gekoppeld aan een ondersteunde lees- of schrijfactie met een gestructureerd resultaat. OpenAI verwijst naar het eigen gebruik: een ChatGPT Work-agent in Slack behandelt interne IT-verzoeken en de geïmplementeerde workflows lossen ongeveer 45% van het ticketvolume op, waardoor de achterstand is weggewerkt terwijl het supportvolume ongeveer was verdubbeld.
De tweede aankondiging: de ChatGPT-browserextensie wordt buiten Chrome beschikbaar en ondersteunt voortaan Microsoft Edge, Brave, Opera en Vivaldi. De verandering is relevant voor wie uit privacyoverwegingen of vanwege bedrijfsvereisten in een alternatieve browser werkt. Twee toepassingen worden uitgelicht: de context van geopende tabbladen via de vermelding @ tab in ChatGPT Desktop aan een taak toevoegen, zodat Codex werkt op basis van de documentatie of het ticket dat al wordt weergegeven; en de agent de browser laten bedienen om concrete webtaken uit te voeren, waarbij het opzeggen van abonnementen als een van de voorbeelden wordt genoemd.
De derde aankondiging is beknopter: een Premium-licentie van 100 dollar wordt toegevoegd aan het ChatGPT Business-aanbod en is gericht op kleine bedrijven en startups, met een abonnement dat als flexibel en schaalbaar op basis van de teamgrootte wordt gepresenteerd. De aankondiging werd op X gedaan zonder uitgebreid blogbericht, en de exacte inhoud van de licentie wordt in het bericht niet gespecificeerd.
🔗 Admin-plugin · Extensie voor meerdere browsers · Premium-licentie voor ChatGPT Business
NVIDIA: Gamescom voor RTX Spark en SANA dat de latentie van MiniMax H3 met een factor 27 verlaagt
25 augustus — NVIDIA grijpt de Gamescom, die deze week in Keulen plaatsvindt, aan om de catalogus van RTX Spark, zijn Windows-pc-platform dat dit najaar wordt verwacht, uit te breiden. Electronic Arts, Embark Studios en Ubisoft voegen zich bij KRAFTON, NetEase, Riot Games en XBOX, die zich al tijdens COMPUTEX in mei hadden aangesloten. De genoemde titels bestrijken uiteenlopende technische vereisten: EA SPORTS F1 25 en Apex Legends van EA, Anno 117: Pax Romana van Ubisoft en ARC Raiders en THE FINALS van Embark Studios.
Het concreetste punt betreft anti-cheat. Een game kunnen draaien is niet genoeg: grote onlinetitels zijn afhankelijk van anti-cheatsystemen die naar elk platform moeten worden geporteerd, anders blijft de game in multiplayer onspeelbaar. NVIDIA kondigt aan met EA samen te werken om EA Javelin Anticheat native naar RTX Spark te brengen — het soort infrastructuurdetail dat de daadwerkelijke adoptie van een nieuw pc-platform bepaalt. Wat rendering betreft, is DLSS 4.5 Ray Reconstruction onmiddellijk beschikbaar, met een transformermodel van de tweede generatie dat klassieke denoisers vervangt door een netwerk dat op een supercomputer is getraind. Path tracing komt naar CONTROL Resonant en 007 First Light, Gears of War: E-Day integreert RTX Mega Geometry en NVIDIA ACE-technologieën zijn aangekondigd voor Aniimo, begin 2027.
De andere kant van dezelfde speler, op 24 augustus, is technischer. MiniMax deelt de resultaten die het SANA-team van NVIDIA behaalde met Sol Engine, toegepast op zijn videomodel H3: tien seconden video in 768p, gegenereerd op één GB200, gaat van 414 seconden naar 14,93 seconden, een versnelling met een factor 27,7. De methode berust niet op kerneloptimalisatie, maar op het opsplitsen van de generatie in twee doorgangen: een concept in lage resolutie dat H3 in 4 stappen produceert, gevolgd door een verfijningsdoorgang op de doelresolutie door LTX in 3 stappen met Sol-Attn. In totaal zeven stappen. Als tweede ingreep worden de kostbare VAE-decoderingsprocessen vervangen door TAEH3 en TAEHV, lichtere decoders, terwijl de latents stabiel blijven voor de verfijningsdoorgang.
| Meting op MiniMax H3 | Gemeten waarde |
|---|---|
| Gemeten werklast | 10 s video in 768p, één GB200 |
| Latentie vóór | 414 s |
| Latentie na | 14,93 s |
| Versnellingsfactor | 27,7x |
| Generatiestappen | 4 (H3-concept in lage resolutie) + 3 (LTX) |
| Vervangen decoders | TAEH3 en TAEHV ter vervanging van VAE-decoderingen |
| Verwachte doorvoer per node | 378.000 video’s per maand, meer dan 97% GPU-marge |
De verwachte doorvoer is een schatting van MiniMax, geen productiemeting, en moet ook zo worden gelezen. Maar de richting is duidelijk: met vijftien seconden voor tien seconden video verschuift high-fidelity-videogeneratie van asynchrone batchrendering naar een vrijwel interactieve infrastructuur.
🔗 NVIDIA op Gamescom · SANA en Sol Engine op H3
Open Chinese modellen worden de standaard voor onderzoek en Qwen3.8-27B komt in de top 10 van Code Arena
25 augustus — Qwen deelt op dezelfde ochtend twee resultaten, waarbij het tweede betekenis geeft aan het eerste.
Het eerste is een ranglijst. Qwen3.8-27B komt binnen in de ranglijst Code Arena: WebDev, die modellen beoordeelt op het genereren van webinterfaces, op de 9e plaats algemeen met 1595 punten. Het is het enige model in zijn grootteklasse in de top 10 en staat slechts zes plaatsen achter de veel grotere Qwen3.8-Max. Arena benadrukt dat het de Pareto-grens van de ranglijst opnieuw definieert en geeft een veelzeggend referentiepunt: Gemma 4-31B, van vergelijkbare grootte maar uitgebracht in april, staat op de 80e plaats.
| Beoordeeld model | Positie Code Arena: WebDev | Behaalde punten | Opmerking bij de ranglijst |
|---|---|---|---|
| GLM-5.3 (Max) | 8e algemeen | 1597 | Stand van 20 augustus, 2e onder de open modellen |
| Qwen3.8-27B | 9e algemeen | 1595 | Enige model van zijn grootte in de top 10 |
| Qwen3.8-Max | Zes plaatsen vóór de 27B | n.v.t. | Veel groter model uit dezelfde familie |
| Gemma 4-31B | 80e algemeen | n.v.t. | Uitgebracht in april 2026 |
Het tweede resultaat is een gebruiksmeting. Nathan Lambert, die het Olmo-project bij Ai2 mede leidde, liet Codex 500.000 arXiv-artikelen over AI en machine learning analyseren die sinds de lancering van ChatGPT zijn gepubliceerd, om vast te stellen welke open modellen daadwerkelijk in onderzoek worden gebruikt. De ommekeer is in twee cijfers samen te vatten: in 2024 vermeldde ongeveer 30% van de artikelen een Amerikaans open model, tegenover 10% een Chinees model; tegenwoordig citeert ongeveer 40% een Chinese open LLM en slechts 25 tot 30% een Amerikaanse.
| Modelfamilie | Aandeel artikelen dat een LLM citeert |
|---|---|
| OpenAI (gesloten modellen) | ongeveer 37% |
| Qwen | ongeveer 33% |
| Gemini, Claude | 10 tot 15% |
| Gemma, Mistral | 5 tot 10% |
| Olmo | ongeveer 1% |
In detail wordt Qwen vermeld in een derde van de artikelen die een LLM citeren, ongeacht welke. Llama bereikte rond april 2025 een piek van 30%, precies toen Llama 4 werd uitgebracht, en neemt sindsdien af. Lambert wijst zelf op een belangrijke beperking: publicaties lopen achter op modelreleases, omdat onderzoek tijd kost — deze cijfers beschrijven de stand van lopend onderzoek en niet de voorkeuren van het moment. Tegelijkertijd is er een onderliggende trend zichtbaar die losstaat van de strijd tussen open en gesloten modellen: het aandeel AI-artikelen waarin een LLM wordt vermeld, is gestegen van 10,43% in januari 2023 tot meer dan 50% in 2026.
🔗 Qwen3.8-27B op Code Arena · Qwens verwijzing naar de arXiv-analyse · Analyse van @natolambert
Claude Code gaat naar 2.1.245 en de weergave van Claude op het web wordt 4 keer vloeiender
Binnen deze periode verschenen twee versies van Claude Code, waarvan de inhoud duidelijk gericht is op implementaties binnen organisaties. De CHANGELOG bevat geen datums, maar de Git-geschiedenis maakt ze duidelijk: 2.1.243 verschijnt in de commit van 24 augustus om 23:40 UTC en 2.1.245 in die van 25 augustus om 05:13 UTC.
| Toegevoegde instelling | Betrokken versie | Praktisch nut |
|---|---|---|
modelPricing | 2.1.243 | Contractuele tarieven in /cost, de statusbalk en telemetrie |
modelPicker | 2.1.243 | Geordende en gelabelde modellenlijst voor /model |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | Promptcache van één uur voor het gesprek, 5 min voor subagents |
Uitsplitsing van Loops in /usage | 2.1.243 | Ontsporende /loop-taken opsporen |
| Sleutelloos aanmelden via Console | 2.1.243 | Organisaties die API-sleutels verbieden |
| Oplossing voor glibc 2.44 | 2.1.245 | Crash bij het opstarten op Arch Linux, CachyOS en Fedora Rawhide |
De meest ingrijpende instelling is modelPricing: tot nu toe werden de weergegeven kosten berekend op basis van het openbare tarief, maar een organisatie kan er voortaan haar contractuele tarieven per model en haar kortingsfactor in invoeren, waardoor de cijfers rechtstreeks bruikbaar worden voor interne doorbelasting. Het duo promptCacheTtl en subagentPromptCacheTtl behandelt een concreet economisch compromis voor gebruikers met een API-sleutel: een cache van één uur aanhouden voor het hoofdgesprek, waar de context stabiel blijft, terwijl subagents op vijf minuten blijven omdat hun context vluchtiger is. Wat de oplossingen betreft, blijven externe MCP-servers in niet-interactieve modus niet langer hangen na een verbroken verbinding, is /resume niet meer beperkt tot de vijftig meest recente sessies en verlopen sessies die langer dan tien minuten stil zijn nu na ongeveer drie minuten, waarna een nieuwe poging en een expliciete foutmelding volgen.
Op 24 augustus kondigt Anthropic bovendien aan dat het de engine heeft herschreven die antwoorden tijdens het genereren weergeeft in Claude op het web en op desktop. Het principe is klassiek voor interfaceweergave: alleen bijwerken wat nog verandert, in plaats van het volledige antwoord bij elk nieuw fragment opnieuw te tekenen. Bij een lang antwoord is het verschil structureel: de weergavekosten groeien niet langer mee met de lengte van de al weergegeven tekst. De aangekondigde verbeteringen zijn coherent: ongeveer 4 keer vloeiender, 9 keer minder vastlopers op een minder krachtige laptop, een ergste vastloper van de interface die 4,5 keer korter duurt en van begin tot eind 120 beelden per seconde op een MacBook van 120 Hz. Het interessante detail is de doelgroep: bescheiden configuraties profiteren het meest.
🔗 CHANGELOG van Claude Code · 4x vloeiendere weergave, @ClaudeDevs
Code-agents worden geïndustrialiseerd: Warp publiceert het formaat van zijn factories, Rohlik laat 90% van zijn code door agents schrijven
24 augustus aan het einde van de dag — Warp toont de interne werking van Warp Factories, zijn op 18 augustus aangekondigde platform voor cloudagents: het gekozen configuratieformaat en de opening van vervroegde toegang. Het uitgangspunt wordt openlijk erkend: Warp verplaatst zijn eigen agents van lokale machines vanwege kwaliteit en kosten, en moest omgevingen, harnassen en beveiligingsrechten kunnen beschrijven als code onder versiebeheer.
| Configuratie-element | Gekozen waarde |
|---|---|
| Definitiebestand | factory.yaml, schemaVersion: v1alpha1 |
| Hoofdsleutels | name, repositories (owner / name), agentDefaults.model |
| Definitie van een agent | agents/<nom>/agent.md met agentType (FOREMAN, REVIEW…) en model |
| Triggers | automations/<nom>/automation.md: agent, triggers (provider, gebeurtenis) |
| Beschikbare interfaces | CLI (warp agent run-cloud), REST API, TypeScript SDK, MCP-server |
| Vervroegde toegang | Tot 10.000 USD gratis gebruik voor gekwalificeerde klanten |
De scheiding is interessant: de agents worden niet beschreven in één YAML-bestand, maar in afzonderlijke Markdown-bestanden, waardoor de definitie van een agent een leesbaar en vergelijkbaar document wordt. Warp past het recept op zichzelf toe: zijn interne factory, met de naam ‘wilson’, omvat repositories zoals warp-server en warp-terraform, declareert zijn secrets en MCP-servers en ordent zijn agents per rol (code-review, foreman, implementation, spec, triage) in 34 regels. De cijfers op de pagina voor het aanvragen van toegang zijn commerciële beweringen die niet extern te verifiëren zijn: 200.000 agentuitvoeringen per dag, meer dan 30% van de pull requests zonder aanpassingen gemerged en 20% lagere kosten per pull request.
Op 25 augustus publiceert Cognition van zijn kant een aanzienlijk beter gedocumenteerde casestudy dan de vorige. Rohlik Group is een online levensmiddelenverkoper die in Tsjechië is ontstaan, actief is in vijf landen en winstgevend is, met vorig jaar een omzet van meer dan 1,3 miljard dollar; het bezorgt een volledige wekelijkse boodschappenmand met 17.000 producten binnen een uur of in tijdvakken van vijftien minuten. Het kerncijfer van het artikel: ongeveer 90% van de code wordt er tegenwoordig door agents gegenereerd en de engineeringorganisatie omschrijft zichzelf als ‘agent-mostly’.
Dit resultaat werd niet bereikt door simpelweg een tool aan te sluiten. Rohlik zegt een jaar geleden te zijn begonnen, met een eerste ervaring met Devin die als buggy werd beschouwd. Wat het verschil maakte, waren de fundamenten die aan klantzijde werden gelegd: meer dan vijftig interne en externe MCP-integraties, met als uitgangspunt dat elke nieuwe tool vanaf de eerste dag toegankelijk moet zijn voor agents, een semantische laag boven het Snowflake-datawarehouse en een kennisbank die agents de context geeft die men aan een nieuwe collega zou overdragen. Werk komt bij Devin terecht vanaf de plek waar het ontstaat, zoals een Slack-gesprek over een bug of een Linear-specificatiedocument dat wordt uitgewerkt tot aan de pull request. De geclaimde resultaten — een verdubbelde engineeringoutput sinds november, een integratie van AutoStore-robotica die in acht maanden werd opgeleverd terwijl de sector daar twee tot drie jaar over doet, en prototyping die van een maand naar één dag is teruggebracht — blijven afkomstig van een door de leverancier gepubliceerde klantenpagina. Het meest veelzeggende effect ligt elders: de beste engineers besteden nu 80% van hun tijd aan code-review en ongeveer 30% van het gebruik van Devin bij Rohlik bestaat uit data-analyse door zakelijke gebruikers.
🔗 Formaat van factory.yaml, @warpdotdev · Casestudy van Rohlik, @cognition · Klantenpagina van Devin
GitHub: vier oefeningen over agentic workflows en het tabblad Customize algemeen beschikbaar
25 augustus — GitHub publiceert vier nieuwe oefeningen op zijn leerplatform GitHub Skills. De insteek is duidelijk: in plaats van de agentic vernieuwingen van het jaar te documenteren, stelt GitHub voor ze te oefenen in een demonstratierepository, met instructies die gaandeweg via pull requests worden aangeleverd.
| Gepubliceerde oefening | Doel van de oefening |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Aangepaste agents in Copilot CLI: plannen, ontwerpen, bouwen, valideren, overdragen |
| Agentic Workflows that Read the Room | Extensie gh aw, agentic workflow in Markdown, wijzigingen ingediend via pull requests |
| Idea to Merge with the Copilot App | Van een sessie naar een gemergede pull request, volledig in de GitHub Copilot-app |
| Ship with Quality | Geautomatiseerde kwaliteitssignalen, testdekking, verplichte controles op pull requests |
Het opvallendste van de vier is het eerste: dit is de eerste keer dat GitHub in zijn CLI een begeleid traject aanbiedt over multi-agentorkestratie, een onderwerp dat tot nu toe alleen in proza was gedocumenteerd. Het tweede introduceert de extensie gh aw, met een belangrijk beveiligingsaspect: de door de workflow voorgestelde wijzigingen lopen via pull requests in plaats van rechtstreeks te worden toegepast, waardoor een menselijk beoordelingsmoment behouden blijft.
Diezelfde dag wordt een tabblad Customize in de GitHub Copilot-app algemeen beschikbaar. Het brengt in één omgeving de vier uitbreidingsmechanismen samen die de afgelopen maanden afzonderlijk zijn geïntroduceerd: MCP-servers, plugins, skills en canvases. Een Featured-weergave toont een redactionele selectie uit elke categorie, voor gebruikers die weten wat ze willen doen maar niet welk type extensie daarvoor geschikt is. MCP-servers krijgen bovendien een eigen navigatie, met opties die op basis van populariteit worden uitgelicht en een indeling per categorie. De changelog illustreert het nut van canvases met een concreet voorbeeld: een Azure DevOps-canvas om issues te triëren, een backlog te prioriteren, opvolging toe te wijzen en vervolgens een taak aan Copilot toe te vertrouwen zodat die onderzoek doet, implementeert of de review voorbereidt.
🔗 Vier GitHub Skills-oefeningen · Tabblad Customize algemeen beschikbaar
Googles tooling voor ontwikkelaars: Gemini CLI 0.57.0 en Antigravity 2.10.0
25 augustus — Google publiceert de stabiele versie 0.57.0 van Gemini CLI, een kwartier eerder gevolgd door preview 0.58.0. De inhoud van deze versie zegt minder over nieuwe functies dan over de manier waarop Google zijn tool onderhoudt: van de 24 vermeldingen in de changelog zijn er 13 voorzien van het voorvoegsel [SSR Agent] Issue Fix en verwijzen ze naar vaak oudere issuenummers, van 19239 tot 28518. Deze oplossingen pakken ergernissen aan die zich in de backlog hebben opgehoopt: een terminalinterface die onbeperkt kon vastlopen en waaraan time-outs zijn toegevoegd, een misleidende beheerdersfoutmelding voor persoonlijke accounts, het ontbreken van een spatie na suggesties voor automatisch aanvullen en de terminalweergave die niet werd vernieuwd na het afsluiten van een externe editor. Met andere woorden: Google zet een agent in op zijn eigen technische schuld en het resultaat belandt rechtstreeks in de stabiele versie.
| Gepubliceerde versie | Datum en tijd (UTC) | Publicatiekanaal | Belangrijkste punten |
|---|---|---|---|
| v0.57.0 | 25 augustus, 18:37:14 | Stable | 13 [SSR Agent]-oplossingen, validatie van evals, contextuele retries |
| v0.58.0-preview.0 | 25 augustus, 18:22:01 | Preview | Docker-isolatie in het macOS Seatbelt-profiel, veiligheidscontroles |
Wat functionaliteit betreft, ligt de nadruk op evaluatie, met een opdracht om evals te valideren en een formatter voor toolaanroepen die samenvattingen van fouten bevat. Ook de betrouwbaarheid verbetert: capaciteitsfouten leiden tot stille, contextbewuste retries en het annuleren van een multi-turnverzoek veroorzaakt een volledige rollback in plaats van een gedeeltelijke toestand. Voor wie naar de release notes zoekt: het bestand docs/changelogs/index.md in de repository is niet bijgewerkt voorbij v0.54.0 van 6 augustus.
Vier dagen na 2.9.1 en de bijbehorende Remote Control gaat Google Antigravity op 24 augustus naar 2.10.0 en vult het twee hiaten op waarvoor gebruikers de tool moesten verlaten: een geïntegreerde terminal en native Git-versiebeheer, beide rechtstreeks in de zijbalk ondergebracht. Die bundeling past bij de koers van het product: Antigravity positioneert zich als een omgeving waarin men agents aanstuurt in plaats van code regel voor regel te bewerken, maar dan moet het wel mogelijk zijn om een opdracht uit te voeren en een diff te inspecteren zonder van venster te wisselen. De rest van de versie breidt uit wat men aan een agent kan doorgeven en wat men van zijn werk kan zien: audiobestanden worden toegevoegd aan de geaccepteerde bijlagen, met interactieve opmerkingen op afbeeldingen kan een visueel element worden geannoteerd om de agent aan te sturen en uitgebreide voorbeelden van MCP-tooluitvoeringen maken inzichtelijk wat een toolserver daadwerkelijk heeft gedaan. Google telt 13 verbeteringen en 8 oplossingen in deze versie, met een gefaseerde uitrol.
🔗 Gemini CLI v0.57.0 · Changelog van Antigravity
Anthropic financiert voor 5 miljoen dollar aan onafhankelijke evaluaties van welzijn
25 augustus — Anthropic opent een subsidieprogramma van 5 miljoen dollar om onafhankelijk onderzoek naar het effect van AI op het welzijn van gebruikers te financieren. De geselecteerden ontvangen directe financiering, toegang tot modellen en technische ondersteuning, maar werken volledig onafhankelijk: hun evaluaties worden open source gepubliceerd en zijn herbruikbaar voor de hele sector. Aanvragen zijn mogelijk tot 21 september en kandidaten die worden geselecteerd om een volledig voorstel in te dienen, krijgen vóór 5 oktober bericht.
De technische onderbouwing legt uit waarom dit domein zich moeilijk laat beoordelen met de gebruikelijke evaluatiemethoden. Voor de meeste gedragingen van een model volstaat het een afzonderlijk antwoord te bekijken om te bepalen of het correct en passend is. Welzijn vereist context: een gebruiker in nood noemt niet noodzakelijk meteen gedachten aan zelfbeschadiging, en advies over een evenwichtig voedingspatroon dat in het ene geval redelijk is, kan gevaarlijk worden als de persoon een voorgeschiedenis van eetstoornissen heeft getoond. Het Safeguards-team publiceert tegelijkertijd vijf criteria voor grondigheid: duidelijk omschrijven wat wordt gemeten, clinici en domeinspecialisten bij het ontwerp betrekken, zowel voorzorgsmaatregelen als schade testen — dus zowel het risico van overmatige toegeeflijkheid als dat van overmatige weigering beoordelen —, het werkelijke gebruik weerspiegelen met multi-turnscenario’s en automatische beoordelaars valideren aan de hand van echte experts. Dit derde criterium, de symmetrie tussen overmatige instemming en overmatige weigering, onderscheidt deze aanpak van het simpelweg aanscherpen van de vangrails.
🔗 Onderzoekssubsidies voor welzijn
Quantization-Aware Healing: een 4-bitsmodel dat zijn origineel in volledige precisie overtreft
25 augustus — De standaardpipeline om een groot model geschikt te maken voor implementatie bestaat uit drie stappen: de architectuur comprimeren, het resultaat quantiseren en vervolgens het kwaliteitsverlies herstellen. Het meest gebruikte recept voor die laatste stap is QAT (quantization-aware training), waarbij nepquantisatiebewerkingen worden ingevoegd en het model opnieuw wordt getraind; een alternatief, QAD, distilleert vanuit het gecomprimeerde model in volledige precisie. In beide gevallen kan de leerling hooguit zijn gecomprimeerde leraar evenaren en erft hij dus de door de compressie opgelegde bovengrens.
Multiverse Computing stelt een wijziging van één regel voor: rechtstreeks distilleren vanuit het oorspronkelijke model, van vóór de compressie. Quantisatie is dan niet langer een verliesgevende nabewerking, maar wordt een volwaardige leerfase. Het resultaat is contra-intuïtief: toegepast op GPT-OSS 120B, gecomprimeerd tot 60B en vervolgens gequantiseerd in MXFP4, levert de methode een 4-bitsmodel op dat zijn eigen bfloat16-bron op zeven van de negen benchmarks evenaart of overtreft. De grootste verbeteringen treden op waar compressie de meeste schade aanricht: +7,4 punten op AA-LCR voor redeneren met een lange context en +5,6 op AIME 2025. De enige twee achteruitgangen, op MMLU-Pro en SciCode, blijven onder de anderhalve punt.
De directe vergelijking met QAT bij een identieke pipeline is wellicht het praktisch bruikbaarste resultaat. Op GPT-OSS 9B, gequantiseerd in MXFP4, bereiken beide methoden een vergelijkbare piek, 54,9 tegenover 54,6, maar niet tegen dezelfde prijs: QAH bereikt die na ongeveer honderd stappen en handhaaft dat niveau, terwijl QAT ongeveer 700 stappen nodig heeft en daarna verslechtert. Het concrete gevolg is een ander implementatierisico: een QAT-checkpoint vereist nauwlettend toezicht op vroegtijdig stoppen, een QAH-checkpoint veel minder.
Gradio integreert gr.Workflow, een grafische bouwer voor AI-pipelines
25 augustus — Hugging Face publiceert een gids over gr.Workflow, een primitive die nu in Gradio is geïntegreerd. Het uitgangspunt is eenvoudig: de meeste interessante AI-toepassingen zijn geen enkele modelaanroep, maar een keten van stappen — een afbeelding genereren, de achtergrond verwijderen, er een voice-over van maken en een LLM om een titel vragen. Tot nu toe moest zowel de logica als de interface worden geschreven om zo’n keten op te zetten en netjes beschikbaar te maken. gr.Workflow voegt beide samen: de stappen worden beschreven als een grafiek van getypeerde nodes en de grafiek wordt zelf de interface.
Voor ontwikkelaars gaat het nut verder dan de visuele demonstratie. Elke uitvoer van de grafiek krijgt automatisch een eigen REST-endpoint: de mediasstudio uit het voorbeeld, die FLUX-generatie, achtergrondverwijdering, spraaksynthese en een LLM combineert, biedt drie afzonderlijke routes (/sticker, /voiceover, /episode_title) die vanuit code kunnen worden aangeroepen zonder de interface te gebruiken. De nodes kunnen met vier werelden communiceren: modellen die via de Inference Providers van Hugging Face worden gehost, andere openbare Gradio Spaces die als bouwstenen worden hergebruikt, een rij uit een dataset op de Hub en willekeurige Python-code. Dat laatste biedt de meeste mogelijkheden: een operatornode die met @spaces.GPU is gedecoreerd, reserveert tijdens de uitvoering een ZeroGPU-GPU, zodat eigen gewichten kunnen worden uitgevoerd. De gids bevat vijf daadwerkelijk als Spaces geïmplementeerde toepassingen, waaronder een datasetprofiler en een demonstratie die met Lightricks/LTX-Video een stilstaand beeld animeert.
ElevenLabs lanceert Composer, een songeditor per sectie
25 augustus — ElevenLabs kondigt Composer aan, een songeditor die sectie voor sectie werkt. Het principe wijkt af van de dominante generatiemethode van muziekmodellen: in plaats van een volledig nummer in één keer te produceren en alles opnieuw te genereren wanneer een passage niet bevalt, maakt Composer het mogelijk om afzonderlijk een couplet, refrein of bridge te herwerken. Er zijn vier mogelijke vertrekpunten: eigen songteksten, een bestaande track die je aanlevert, een leeg canvas of een eenvoudige prompt. Vervolgens wordt het nummer opgebouwd via opeenvolgende aanpassingen.
Dit is de tweede stap van ElevenLabs richting muziek na Eleven Music en hij komt in een drukke week voor het bedrijf, nadat CLI v1 een dag eerder verscheen. De positionering sluit aan bij de rest van de audiosector: Suno lanceerde Studio 2.0 op 13 augustus, Pika bracht zijn Pika Music-reeks uit op 18 augustus en Stability AI leverde diezelfde dag zijn plugin voor digitale audiowerkstations. Nauwkeurige controle over de structuur van het nummer, in plaats van de pure generatiekwaliteit, is het nieuwe concurrentieterrein geworden. Er is echter één voorbehoud: de aankondiging gaat niet vergezeld van een blogbericht en er is niets bekend over de abonnementen die toegang geven tot Composer, de exportformaten of API-toegang.
🔗 Aankondiging van Composer, @ElevenLabs
LiveAvatar schrapt alle gelijktijdigheidslimieten en verlaagt de prijs tot 0,01 USD per minuut
25 augustus — HeyGen kondigt aan dat de gelijktijdigheidslimieten voor LiveAvatar, zijn product voor realtime avatars, worden afgeschaft. De formulering benadrukt de aard van de wijziging: de limieten worden niet verhoogd, maar verdwijnen volledig. Eén sessie of tienduizend sessies draaien via dezelfde API, zonder vooraf over quota te hoeven onderhandelen. De aankondiging gaat vergezeld van twee parameters: de weergave blijft 1080p voor het volledige lichaam en de prijs daalt bij schaalvergroting tot 0,01 USD per minuut.
Dit prijsniveau verandert welke toepassingen denkbaar zijn: voor één cent per minuut wordt een realtime avatar haalbaar voor grootschalige klantenondersteuning, opleidingen of interactieve kiosken, toepassingen waarbij de kosten per eenheid tot nu toe bepaalden of ze uitvoerbaar waren. Het afschaffen van de gelijktijdigheidslimiet is technisch het interessantste punt. Platforms voor realtime avatars beperken gewoonlijk het aantal gelijktijdige sessies omdat elke sessie continu GPU-capaciteit gebruikt; het opheffen van die grens veronderstelt een aanzienlijke capaciteitsmarge of een efficiënter model. HeyGen publiceert een artikel waarin het zijn aanpak toelicht, maar de technische details daarvan waren tijdens de scan niet toegankelijk.
🔗 Onbeperkte gelijktijdigheid op LiveAvatar
Grok 4.6 komt naar OpenCode Go
25 augustus — Grok 4.6 wordt toegevoegd aan OpenCode Go, het abonnementsplan van de opensource-codeagent OpenCode. De aankondiging kwam aan het eind van de dag van OpenCode en werd een halfuur later door het account @grok gedeeld. Voor ontwikkelaars is vooral het quotum concreet: 169 verzoeken per periode van 5 uur voor gebruikers van het Go-abonnement. Het is een voortschrijdende limiet, geen maandelijkse telling, wat aansluit bij het typische gebruik in pieken tijdens ondersteunde codeersessies.
Deze integratie maakt deel uit van een reeks uitbreidingen van Grok 4.6 naar tools van derden: het model kwam op 14 augustus naar GitHub Copilot, op 19 augustus naar Amazon Bedrock en vervolgens op 21 augustus naar Googles Gemini Enterprise Agent Platform. xAI had OpenCode in mei 2026 bovendien al gekoppeld aan zijn SuperGrok- en X Premium-abonnementen. Het nieuws van vandaag is dus niet de toegang tot OpenCode zelf, maar de beschikbaarheid van model 4.6 binnen het Go-abonnement, met een inbegrepen quotum in plaats van een zelf aan te leveren xAI-abonnement.
🔗 Bericht van @grok · Aankondiging van @opencode
Cohere publiceert IDC-onderzoek naar de invoering van soevereine AI in 2026
25 augustus — Cohere publiceert de resultaten van een bij IDC besteld InfoBrief over de invoering van soevereine AI in gereguleerde sectoren. Voor het onderzoek werden tussen april en mei 2026 meer dan 500 senior besluitvormers ondervraagd bij bedrijven met een omzet van meer dan één miljard dollar in Canada, de Verenigde Staten, het Verenigd Koninkrijk en Duitsland.
Het opvallendste resultaat gaat minder over de invoering dan over de conceptuele verwarring. Eén op de drie leidinggevenden vindt het moeilijk om soevereine AI in eigen woorden te omschrijven en slechts 13% zegt zeer goed bekend te zijn met het onderwerp. Van degenen die een definitie kunnen geven, formuleert 52% die in termen van lokale of nationale controle en noemt 35% digitale onafhankelijkheid. De kloof loopt ook door de organisatiestructuur: IT-verantwoordelijken zijn twee keer zo goed op de hoogte als zakelijke verantwoordelijken.
| Ondervraagde sector | Datalekken en compliance als voornaamste zorg | Concurrentievoordeel als drijfveer |
|---|---|---|
| Financiële diensten | 82 % | 21 % |
| Industrie | 77 % | 32 % |
| Telecommunicatie | 75 % | 37 % |
| Gezondheidszorg | 74 % | 28 % |
| Energie | 70 % | 21 % |
Over de beweegredenen bestaat een duidelijke, sectoroverschrijdende consensus: datalekken, vertrouwelijkheid en compliance staan in alle ondervraagde sectoren bovenaan. Concurrentievoordeel geldt als een secundaire maar groeiende drijfveer en wordt vaker benadrukt in Canada (35%) en de Verenigde Staten (28%) dan in Duitsland (23%) of het Verenigd Koninkrijk (18%). Het onderzoek ondersteunt uiteraard de positionering van Cohere, waarvan het agentplatform North draait binnen de infrastructuur en jurisdictie die de klant kiest; de cijfers zijn niettemin aan een geïdentificeerde bron toegeschreven. IDC voorspelt bovendien dat CIO’s van multinationals hun investeringen in modulaire soevereine cloudomgevingen en datalokalisatie tegen 2028 met 65% zullen verhogen.
🔗 State of Sovereign AI Adoption 2026
Kort nieuws
- Bain & Company treedt toe tot het Claude Partner Network — Het adviesbureau wordt Global Premier-partner, gekoppeld aan een uitrol van Claude onder zijn 19.000 medewerkers; al tijdens de pilotfase waren er meer dan 7.000 actieve gebruikers en ruim twee derde van de deelnemers nam Claude for Excel in gebruik. 🔗 Anthropic-blogbericht
- Amp legt uit wat orbs zijn — Een toelichting van Thorsten Ball naar aanleiding van verwarring over de naam: een orb is een externe agent die via het web, de telefoon of de CLI kan worden aangestuurd. Twee nuttige details over de kosten: onbeperkte slaapstand wordt niet in rekening gebracht en het aantal gelijktijdige orbs is niet begrensd. 🔗 Toelichting van Amp
- Together AI stelt Qwen3.8 27B open voor fine-tuning en dedicated inference — Het model is nu beschikbaar voor zowel fine-tuning met eigen gegevens als Dedicated Model Inference op gereserveerde hardware. 🔗 Tweet van @togethercompute
- FINAL-Bench opent FINCHAL, een wedstrijd voor financiële voorspellingen door agents — De wedstrijd heeft een prijzenpot van 2.000 dollar, vraagt om posities in plaats van voorspellingen en publiceert een kansplafond (luck ceiling) om vaardigheid van toeval te onderscheiden. 🔗 FINAL-Bench-blogbericht
- Au-Zone publiceert de EdgeFirst Model Zoo — Vier YOLO-families voor detectie en segmentatie, gemeten op echte embedded hardware, waarbij elk gepubliceerd cijfer verwijst naar de validatiesessie waarin het werd verkregen, in tegenstelling tot de ondoorzichtige TOPS-cijfers die fabrikanten aankondigen. 🔗 EdgeFirst-blogbericht
- Slim dicteren van Gemini voor macOS — Dicteren in elk venster op het bureaublad, met automatische verwijdering van aarzelingen en verwerking van correcties midden in een zin; spraak kan ook worden gebruikt om bestanden samen te vatten en tekst te herschrijven. 🔗 Gids op blog.google
- Push rules ondersteunen uitzonderingen voor paden — In openbare preview kunnen de regels Restrict file paths en Restrict file size specifieke paden uitzonderen, bijvoorbeeld om JAR-bestanden overal te blokkeren behalve in
**/gradle/wrapper/*.jar. 🔗 GitHub-changelog - Een gebruiker blokkeren vanuit een beveiligingsadvies — De actie is beschikbaar via het menu met drie stippen in de beschrijving of bij een opmerking in openbare repositories, zonder opnieuw via de instellingen te hoeven gaan; het advies blijft intact. 🔗 GitHub-changelog
- Manus meldt grote vraag naar gegevensherstel — Herstelpogingen die niet slagen, moeten later op de dag opnieuw worden gestart; de expliciete instructie is om back-uppakketten intact en ongewijzigd te bewaren. 🔗 Tweet van @ManusAI
- Kling publiceert drie gidsen over zijn MCP-server — Kling verbinden met een MCP-compatibele assistent om een gevalideerde creatieve configuratie opnieuw uit te voeren en varianten in batches te genereren; twee van de drie tutorials noemen Claude Code als client. 🔗 Kling-blog
- Wan 3.0 komt naar Runway en Replicate — Runway integreert het op 24 augustus met meerdere referentie-invoeren voor afbeeldingen, video en audio; Replicate volgt op 25 augustus en benadrukt de native duur van 30 seconden in één opname met gesynchroniseerde audio. 🔗 Tweet van @runwayml
- Runway kondigt nieuwe sprekers aan voor zijn AI Summit — Het programma voor het evenement in september in San Francisco wordt uitgebreid met robotica, autonome voertuigen, marketing en infrastructuur. 🔗 Tweet van @runwayml
- MiniMax publiceert een index van H3-integraties — Awesome MiniMax H3 Integrations brengt in kaart wat er rond het open videomodel wordt gebouwd, waaronder configuraties die op 24 GB VRAM draaien. 🔗 Tweet van @MiniMax_AI
- Luma lanceert Dream Lab Weekly — De eerste aflevering van een videoserie over de creatieve professionals van Luma en hun wekelijkse werk aan het product. 🔗 Tweet van @LumaLabsAI
- NVIDIA zendt een Nemotron Labs-sessie over routering van open modellen uit — Een live-uitzending van 55 minuten met de titel Get Started with Open Model Routing, als vervolg op het werk aan Nemotron 3.5 Lightning en NeMo Switchyard. 🔗 Tweet van @NVIDIAAI
- Nog één week voor de Grok Imagine-wedstrijd over de Odyssee — De opdracht is een scène uit de Odyssee te maken die de video- en spraakmogelijkheden van de tool benadrukt; de prijzen bedragen 100.000, 50.000 en 25.000 dollar. 🔗 Tweet van @grok
- Voorraad limietresets voor Plus- en Pro-abonnees — In plaats van te wachten op het resetvenster gebruikt de gebruiker een gereserveerde reset; één gratis bij de lancering en meer via doorverwijzingen, met gedeelde workspace-credits voor Business. 🔗 Changelog van ChatGPT en Codex
Wat dit betekent
Silicium wordt opnieuw een onderwerp voor modellaboratoria. OpenAI publiceert op dezelfde dag de eerste gemeten cijfers van zijn eigen inferencechip en het artikel waarin het zijn computestrategie uiteenzet. Dat is geen toevallige samenloop: een modelleverancier die zijn eigen silicium ontwerpt, het meet met een openbare benchmark van een derde partij en openlijk een portfolio van tien partners hanteert, verandert de aard van de concurrentie. De vraag is niet langer „welk model is het beste”, maar „tegen welke kosten per succesvol uitgevoerde taak”, en het antwoord ligt evenzeer in het rack als in de gewichten. Het belangrijkste detail ligt misschien elders: AI werd gebruikt om de chip te ontwerpen en de kernels ervoor te schrijven, met een productiestart binnen negen maanden en gegenereerde implementaties die op de geselecteerde blokken beter presteren dan die van menselijke experts. De cirkel is rond — de modellen ontwerpen de hardware waarop ze zullen draaien.
AI keert terug naar het apparaat, en de cijfers beginnen dat te ondersteunen. Drie signalen op dezelfde dag wijzen in dezelfde richting. Perplexity voert zijn volledige agent lokaal uit op een DGX Spark, zonder credits te verbruiken, waarbij opschaling naar de cloud een beslissing van de gebruiker blijft. Multiverse Computing publiceert een methode waarbij een 4-bitsmodel zijn bronmodel op volledige precisie evenaart of overtreft, waardoor het gebruikelijke argument tegen agressieve kwantisatie vervalt. Au-Zone publiceert metingen van visionprestaties per type embedded silicium en verwijt de geadverteerde TOPS niets te zeggen over wat een bepaald model daadwerkelijk zal doen. Geen van deze drie projecten beweert het frontier-niveau te evenaren: het eerlijke cijfer van Perplexity is lokaal 59,6% tegenover 82,4% voor Claude Opus 5 alleen op Terminal Bench 2.1. Maar opschaling naar een adviserend model overbrugt drie vijfde van de kloof tegen twee derde van de kosten, en het is deze afweging, meer dan pariteit, die lokale uitvoering verdedigbaar maakt.
Open gewichten worden de standaardpositie. De door Qwen aangehaalde analyse van 500.000 arXiv-artikelen documenteert een omslag die al merkbaar was: Chinese open modellen gingen van 10% naar ongeveer 40% van de vermeldingen, terwijl Amerikaanse open modellen tussen 25 en 30% blijven steken. Qwen3.8-27B dat als enige van zijn omvang de top 10 van Code Arena binnenkomt, GLM-5.3 dat GPT-5.6 Sol en Claude Fable 5 bij tests met meerdere pogingen op DeepSWE overtrof tegen 2,1 tot 5,4 keer lagere kosten, IBM dat Granite 4.2 vanaf de eerste dag openstelt met vier gekwantiseerde varianten en veertien GGUF-formaten — steeds keert dezelfde logica terug. Gewichten openstellen is niet langer een inhaalmanoeuvre, maar een manier om de standaardinfrastructuur van anderen te worden, met de nuance die Nathan Lambert zelf aanbrengt: publicaties lopen achter op releases, en deze curven beschrijven het lopende werk in plaats van de voorkeuren van dit moment.
En het web bereidt zich erop voor om door agents te worden gelezen in plaats van door ogen. De WebMCP Challenge is een wedstrijd met 35.000 dollar aan prijzengeld, wat weinig is; wat hij onthult, is meer waard. Chrome, Cloudflare, Shopify, Vercel, Render en Netlify sluiten zich aan bij OpenAI rond een standaard die websites vraagt gestructureerde tools beschikbaar te stellen, in plaats van agents een interface te laten raden. Diezelfde dag kan ChatGPT desktop WebMCP native gebruiken, kan Codex een compatibele applicatie bouwen en implementeren, en documenteert OpenAI zijn interne gebruik van het protocol in een notebooktool. Deze convergentie sluit aan bij wat Rohlik van zijn kant beschrijft met meer dan vijftig MCP-integraties en het principe dat elke nieuwe tool vanaf de eerste dag toegankelijk moet zijn voor agents. De interfacelaag voor agents is niet langer een onderzoeksonderwerp, maar wordt een technische vereiste.
Bronnen
- OpenAI — WebMCP Challenge
- OpenAI — aankondiging van de WebMCP Challenge op X
- OpenAI — WebMCP in ChatGPT desktop en Sites
- OpenAI — repetitief werk automatiseren met Codex, Runme en WebMCP
- OpenAI — Jalapeño, eerste resultaten
- OpenAI — The full stack behind abundant intelligence
- OpenAI — Admin-plugin voor ChatGPT Work en Codex
- OpenAI — browserextensie uitgebreid naar Edge, Brave, Opera en Vivaldi
- OpenAI — Premium-seat voor ChatGPT Business
- ChatGPT en Codex — changelog
- Perplexity — lancering van Portable Computer
- Perplexity — artikel over Portable Computer
- Perplexity — benchmarks van de lokale harness
- Anthropic — het geheugen van Claude werkt overal
- Anthropic — aankondiging van geheugen op X
- Anthropic — CHANGELOG van Claude Code
- Anthropic — 4x vloeiendere streamingweergave
- Anthropic — onderzoeksbeurzen voor welzijn
- Anthropic — Bain & Company sluit zich aan bij het Claude Partner Network
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — handleiding voor gr.Workflow
- FINAL-Bench — FINCHAL-wedstrijd
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B voor fine-tuning en dedicated inference
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — changelog van Antigravity
- Google — slim dicteren van Gemini voor macOS
- Stability AI — Serie B-financieringsronde van 76 miljoen dollar
- Stability AI — aankondiging op X
- NVIDIA — Gamescom en RTX Spark
- MiniMax — SANA en Sol Engine op H3
- MiniMax — overzicht van H3-integraties
- NVIDIA — Nemotron Labs-sessie over routering van open modellen
- Qwen — Qwen3.8-27B op Code Arena WebDev
- Qwen — verwijzing naar de arXiv-analyse
- Nathan Lambert — 500.000 arXiv-artikelen doorgelicht
- Warp — factory.yaml-formaat en vroege toegang
- Cognition — casestudy van Rohlik Group
- Devin — klantenpagina van Rohlik Group
- Amp — uitleg over de orbs
- GitHub — vier nieuwe GitHub Skills-oefeningen
- GitHub — tabblad Customize algemeen beschikbaar
- GitHub — paduitzonderingen in push rules
- GitHub — blokkeren vanuit een beveiligingsadvies
- Manus — update over het gegevensherstel
- ElevenLabs — Composer
- HeyGen — onbeperkte concurrency op LiveAvatar
- Kling — handleidingen voor de MCP-server
- Runway — Wan 3.0 beschikbaar op het platform
- Runway — nieuwe sprekers voor de AI Summit
- Luma — Dream Lab Weekly
- xAI — Grok 4.6 in OpenCode Go
- OpenCode — Grok 4.6 in het Go-abonnement
- xAI — Grok Imagine-wedstrijd over de Odyssee
- Cohere — State of Sovereign AI Adoption 2026