ai-powered-markdown-translatorArtikel, der mit gpt-5.6-sol aus dem Französischen ins Deutsche übersetzt wurde.
Einundfünfzig Ankündigungen in vierundzwanzig Stunden, verteilt auf neun Bereiche: Der 25. August ist der ereignisreichste Tag der Woche. Vier Entwicklungen stechen hervor. OpenAI veröffentlicht die ersten Messwerte von Jalapeño, seinem selbst entwickelten Inference-Chip, und startet unmittelbar danach gemeinsam mit Chrome, Cloudflare, Shopify, Vercel, Render und Netlify einen zehntägigen Hackathon rund um WebMCP. Perplexity verlagert seinen gesamten Computer-Agenten auf das Gerät des Nutzers. IBM stellt Granite 4.2 als seine erste Familie von Reasoning-Modellen als Open Source bereit. Und Anthropic vereinheitlicht den Speicher von Claude über Chat und Cowork hinweg und macht ihn Datei für Datei einsehbar und bearbeitbar. Der Rest – WeatherNext Cyclones im Einsatz beim National Hurricane Center, die Series-B-Finanzierungsrunde von Stability AI und rund zwanzig Tool-Updates – folgt weiter unten.
WebMCP: ein Standard, seine Produktunterstützung, seine interne Nutzung und ein Wettbewerb als Starthilfe
25. August – OpenAI startet die WebMCP Challenge, einen zehntägigen Hackathon zu einem noch experimentellen offenen Standard, der verändert, wie Agenten mit dem Web interagieren. Das zugrunde liegende Problem ist konkret: Wenn ein Agent heute eine Aufgabe auf einer Website erledigen soll, muss er erraten, wie er durch eine für Augen und Maus entwickelte Benutzeroberfläche navigiert. WebMCP kehrt diese Logik um: Die Website stellt selbst strukturierte Tools bereit, die der Agent direkt aufruft.
Der Wettbewerb ist nicht der bemerkenswerteste Aspekt der Ankündigung. Entscheidend ist die darin sichtbare Abstimmung: Chrome (Google), Cloudflare, Shopify, Vercel, Render und Netlify arbeiten alle gemeinsam mit OpenAI am selben Standard. Das spiegelt sich in der Jury wider, der Sarah Drasner (Distinguished Engineer, Chrome), Andrew Galloni (VP Research & Innovation, Cloudflare), Jude Gao (Next.js-Core-Team, Vercel), Ilya Grigorik (Distinguished Engineer, Shopify), Sean Roberts (VP of Applied AI, Netlify), Justin Rushing (Browser Agent Lead, OpenAI) und Alex Nahas, der Entwickler von MCP-B, angehören.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇩🇪 Die WebMCP Challenge ist gestartet. Wir haben uns mit @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render und @Netlify für einen zehntägigen Hackathon zusammengeschlossen. Zu gewinnen gibt es 35.000 Dollar an Geldpreisen, Codex Micros, ChatGPT-Pro-Abonnements und weitere von unseren Partnern bereitgestellte Preise. — @OpenAIDevs auf X
Der Zeitplan ist straff und die Bewertungskriterien sind klar benannt: Nutzen, Originalität, Umsetzung, durchdachter Einsatz von WebMCP und Qualität der Mensch-Agent-Erfahrung. Anmeldung und Einreichung erfolgen über Devpost. OpenAI veröffentlicht außerdem Agent-native Demo-Anwendungen als Ausgangspunkt für Projekte – eine vom Agenten gesteuerte 3D-Modellierung, kollaboratives Schreiben, bei dem der Agent unter seiner eigenen Identität kommentiert, einen Generator für personalisierte Kreuzworträtsel, Wandernote zur Umwandlung von Reisenotizen in eine Reiseroute sowie Datenexploration über DuckDB-Wasm im Browser. Es ist zulässig, von einer bestehenden Anwendung auszugehen und WebMCP hinzuzufügen.
| Wettbewerbselement | Angekündigte Einzelheiten |
|---|---|
| Angekündigte Dauer | 10 Tage |
| Beginn der Einreichungen | 25. August 2026, 12 Uhr PT |
| Einreichungsfrist | 3. September 2026, 13 Uhr PT |
| Bekanntgabe der Gewinner | 23. September 2026 (vorläufiges Datum) |
| Gesamtes Preisgeld | 35.000 Dollar |
| Preis je Gewinner (Top 10) | 3.000 Dollar, ein Jahr ChatGPT Pro, eine Codex-Micro-Tastatur, Werbeartikel |
| Einreichungsplattform | Devpost |
Die Produktkomponente, die den Standard im Alltag nutzbar macht, erscheint am selben Tag: Der integrierte Browser der ChatGPT-Desktop-App und ChatGPT Sites können nun WebMCP verwenden. Wenn ChatGPT oder Codex eine kompatible Website besucht, erkennt der Agent die von der Seite bereitgestellten Tools und verwendet sie automatisch, statt sich durch die Benutzeroberfläche vorzutasten – dafür ist ein Update auf die neueste Version der Desktop-App erforderlich. Die andere Hälfte des Kreislaufs betrifft die Produktion: Codex kann nun angewiesen werden, eine WebMCP-kompatible Anwendung zu erstellen und sie anschließend direkt auf Sites bereitzustellen. Bemerkenswert ist die asymmetrische Unterstützung gegenüber Chrome, wo WebMCP weiterhin hinter einem experimentellen Flag oder einem Origin Trial verborgen ist, während der Browser von ChatGPT den Standard nativ unterstützt.
Bleibt der dritte und aufschlussreichste Teil: OpenAI dokumentiert seinen eigenen internen Einsatz. Ein Ingenieur des Unternehmens schildert, wie er aufgehört hat, für jede Aufgabe eine eigene Automatisierung zu schreiben, und stattdessen Runme entwickelte, eine Open-Source-Webanwendung für Notebooks, die auf die Zusammenarbeit mit Codex ausgelegt ist. Darin formuliert er ein kurzes Ziel mit ausdrücklichen Anweisungen – einen vorherigen Durchlauf prüfen, einen detaillierten Plan erstellen, vor Beginn auf die Freigabe warten sowie ausgeführte Befehle und deren Interpretation dokumentieren – und Codex liest und aktualisiert das Notebook im Verlauf der Arbeit. Zwei Architekturentscheidungen verdienen Aufmerksamkeit. Zunächst die Persistenz: Die Notebooks werden in Google Drive gespeichert, und Runme erzeugt parallel dazu einen begleitenden Markdown-Index *.index.md, den Drive indexieren kann. Dadurch kann ein Agent einen früheren Durchlauf als operativen Kontext wiederfinden. Dann die Bereitstellung der Funktionen: Runme ist eine statisch bereitgestellte Client-Anwendung, und einen Server nur zur Bereitstellung eines klassischen MCP-Endpunkts hinzuzufügen, hätte zusätzliche Infrastruktur eingeführt und die Verarbeitung der Notebook-Daten verlagert. Mit WebMCP kann die Anwendung ihre Tools direkt aus dem Browser heraus registrieren.
🔗 WebMCP Challenge · Unterstützung in ChatGPT Desktop und Sites · Codex, Runme und WebMCP bei OpenAI
Jalapeño: OpenAI veröffentlicht die ersten Messwerte seines Inference-Chips und bekennt sich zu seiner Compute-Strategie
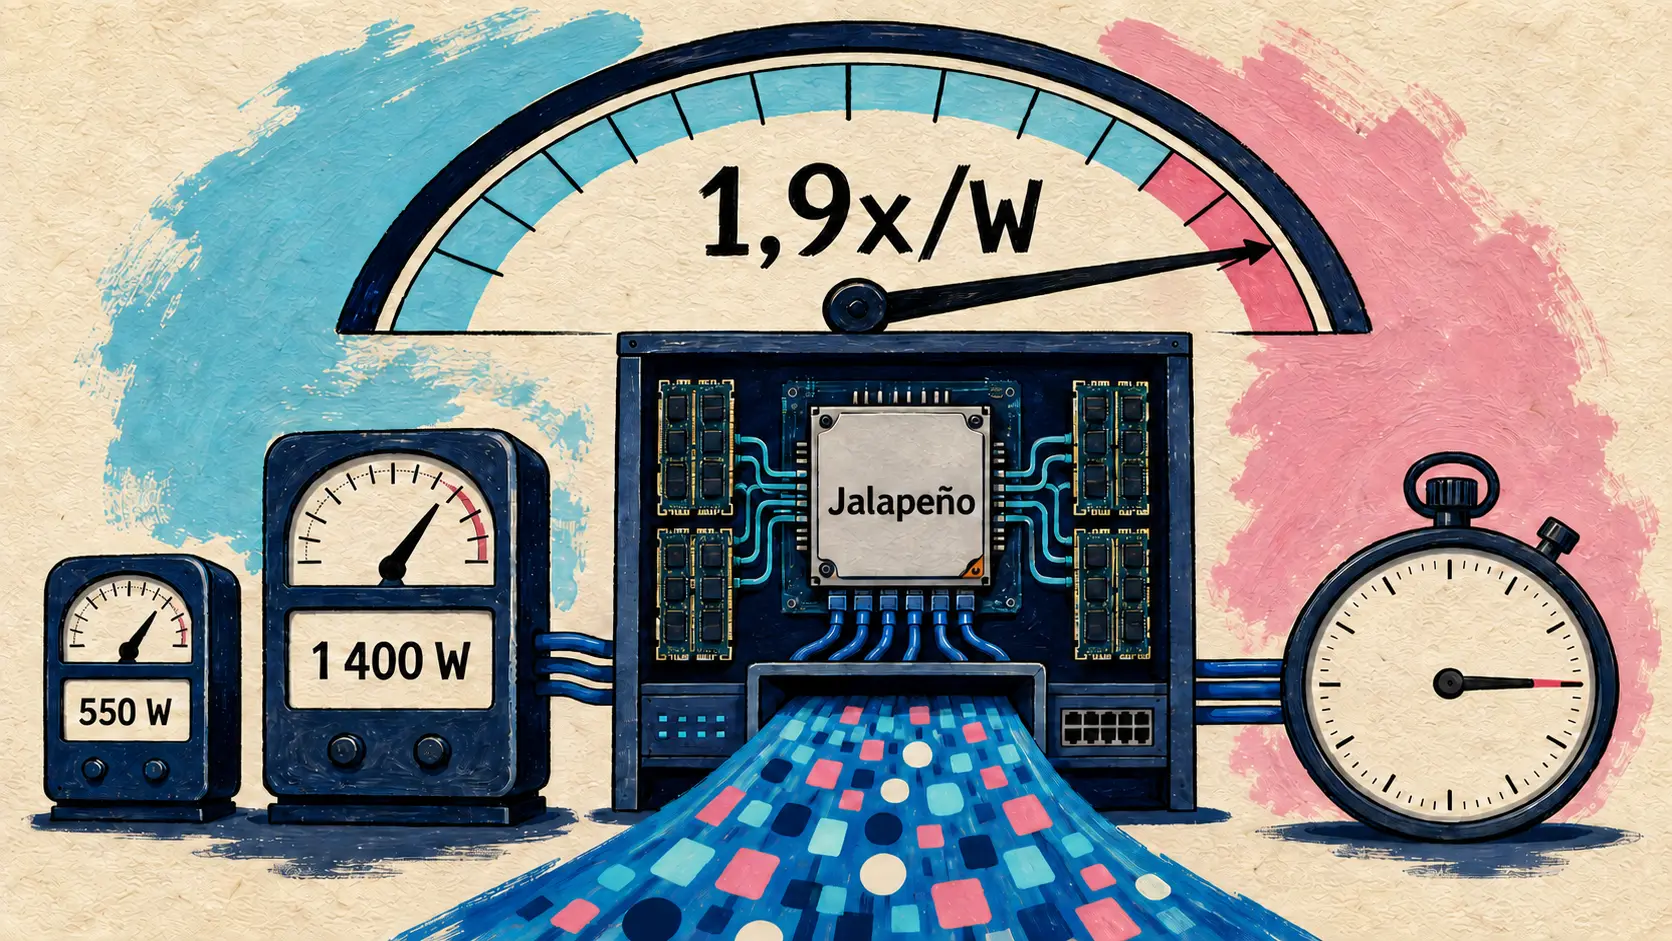
25. August – OpenAI veröffentlicht die ersten Messwerte von Jalapeño, dem ersten selbst entwickelten Inference-Chip des Unternehmens. Das Interesse an der Ankündigung beruht nicht nur auf den reinen Leistungssteigerungen, sondern auch auf der Art des Zielkonflikts, den die Architektur nach eigenen Angaben auflöst: Bestehende Inference-Systeme müssen üblicherweise zwischen Durchsatz und Latenz abwägen, während Jalapeño beides in einer einzigen Architektur bieten soll.
Die Messungen basieren auf InferenceX, einem öffentlichen Benchmark von SemiAnalysis, der die vollständige Verarbeitung einer Anfrage simuliert. Drei offene Modelle wurden getestet – GPT-OSS 120B, DeepSeek R1 670B und Kimi K2.5 1T – und mit kommerziellen Systemen verglichen. Die Entscheidung, pro Watt statt pro Chip zu normieren, wird ausdrücklich genannt und ist vorteilhaft: Jalapeño verbraucht nur halb so viel Energie wie die Vergleichssysteme. Jalapeño ist mit 700 W angegeben, und die gemessene Dauerleistungsaufnahme lag bei den getesteten Workloads bei höchstens 550 W, gegenüber 1.200 W beim GB200 und 1.400 W beim GB300.
| Bewertetes Modell (Vergleichssystem) | Spitzendurchsatz pro kW | Ende-zu-Ende-Latenz | Minimale TBT |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
Über alle drei Modelle hinweg gibt OpenAI beim Spitzendurchsatz eine 1,5- bis 1,9-fach höhere KI-Rechenleistung pro Watt und eine 1,7- bis 3,6-fach geringere Ende-zu-Ende-Latenz als bei den Vergleichssystemen an; bei hochgradig interaktiven Workloads soll die Leistung sogar 2,1- bis 4,1-mal höher sein. Technisch beruhen die Zugewinne auf einem gemeinsamen Design von Chip, Speicher, Netzwerk, Software und System auf Rack-Ebene. Die Inference durchläuft zwei Phasen mit unterschiedlichen Engpässen: das Prefill, das den Prompt verarbeitet und die Recheneinheiten auslastet, und das Decode, das die Tokens einzeln erzeugt und vor allem von der Speicherbandbreite abhängt. Jalapeño soll Datenbewegungen minimieren: Der Modellzustand – einschließlich KV-Cache – kann explizit platziert und lokal vorgehalten werden, während das System je nach Phase die passende Kombination aus Rechenleistung, Speicher und Netzwerk aktiviert.
Der für Entwickler interessanteste Aspekt betrifft die Rolle der KI bei der Entwicklung des Chips selbst. OpenAI gibt an, innerhalb von neun Monaten vom ursprünglichen Entwurf bis zum Tapeout gelangt zu sein, indem die Schleifen aus Entwurf, Messung und Verifizierung verkürzt wurden. Der Chip wurde als vorhersehbares Programmierziel sowohl für KI als auch für Menschen konzipiert: Die Arbeit wird über lokale Tensoren, explizite Kommunikation und vorhersehbare Synchronisierung beschrieben. Mit Codex und GPT-Astra portierte das Team innerhalb von zwei Monaten drei Open-Weight-Modelle, die nicht im ursprünglichen Produktionsplan vorgesehen waren. Bei ausgewählten Attention- und Mixture-of-Experts-Blöcken von GPT-OSS laufen die von KI erzeugten Kernel 1,5- bis 1,8-mal schneller als die von menschlichen Experten geschriebenen Implementierungen. Die Einschränkung sollte erhalten bleiben: Diese Zahlen beziehen sich auf die ausgewählten Blöcke, nicht auf das vollständige Modell. Der Zeitplan bleibt vorsichtig – die Produktionsqualifizierung läuft, die Software muss weiter reifen, die Bereitstellung in der OpenAI-Infrastruktur ist für das Jahresende angekündigt, Gen 2 befindet sich in fortgeschrittener Entwicklung und Gen 3 nimmt Gestalt an.
Am selben Tag veröffentlicht Sarah Friar den Beitrag, der die wirtschaftliche Logik dahinter erläutert. Darin bekennt sie sich zu einem breiten Compute-Portfolio – Microsoft und NVIDIA als Fundament, ergänzt durch AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy und SoftBank – und begründet dies sowohl geschäftlich als auch technisch: Eine glaubwürdige Auswahl zwischen Anbietern zu erhalten, ermöglicht es, jede Workload zum besten Preis-Leistungs-Verhältnis auszuführen und Preisdisziplin zu wahren. Eine konkrete Zahl begleitet diese Aussage: Im Artificial Analysis Coding Agent Index erreicht GPT-5.6 Sol bei maximalem Reasoning einen neuen Rekord und verbraucht dabei 54 % weniger Output-Tokens als ein anderes führendes Modell. Der Text greift schließlich ausdrücklich das Jevons-Paradoxon auf – wenn Intelligenz günstiger wird, sinkt ihr Verbrauch nicht; vielmehr erweitert sich das Spektrum wirtschaftlich lohnender Anwendungen. Auf der Infrastrukturseite wird Project Camellia in Georgia mit einem geschlossenen Wasserkreislauf und Verpflichtungen vorgestellt, die einer jährlichen unabhängigen öffentlichen Prüfung unterliegen. OpenAI stellt klar, dass das Unternehmen die Beschleuniger von NVIDIA und seinen anderen Partnern weiterhin umfassend einsetzen wird, sowohl für Training als auch für Inference.
🔗 Jalapeño – erste Ergebnisse · Der vollständige Stack hinter reichlich verfügbarer Intelligenz
Perplexity Portable Computer: Alles läuft auf dem Gerät – Benchmarks inklusive
25. August — Perplexity veröffentlicht Portable Computer, eine Variante seines Computer-Agenten, die vollständig auf dem Gerät des Nutzers läuft. Die Umstellung ist eher architektonischer als kosmetischer Natur: Nicht nur das Modell läuft lokal, sondern die gesamte Orchestrierungskette – Orchestrator, Planer, Tool-Router, Scheduler, persistente Aufgabenwarteschlange und lokaler Suchindex.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇩🇪 Heute veröffentlichen wir Portable Computer auf dem @NVIDIA DGX Spark. Portable Computer ist eine vollständig lokale Version von Perplexity Computer, bei der die gesamte Laufzeitumgebung – das Orchestrator-LLM, das Subagenten-LLM und das Agent-Harness – auf Ihrer lokalen Hardware läuft. Keine Abhängigkeit von der Cloud. — @perplexity_ai auf X
Die Ankündigung erfolgt gemeinsam mit NVIDIA und richtet sich zunächst an den DGX Spark – eine Plattform mit Grace Blackwell GB10, einer Arm-CPU mit 20 Kernen, einer NVIDIA-GPU und 128 GB Unified Memory –, wobei eine Erweiterung auf PCs mit RTX-GPUs angekündigt ist. Zwei Modelle stehen zur Auswahl: Qwen 3.8 27B oder PPLX 27B, die von Perplexity nachtrainierte Version des Qwen-Modells. NVIDIA Nemotron 3.5 Lightning, ein offenes 30B-Modell, soll ebenfalls in die Modellauswahl aufgenommen werden. Lokal verarbeitete Aufgaben verbrauchen keine Credits. Eine Eskalation in die Cloud bleibt möglich – für aktuelle Informationen, Browser, verbundene Anwendungen oder eines von mehr als 15 Frontier-Modellen –, bedarf jedoch der ausdrücklichen Genehmigung des Nutzers. Die Konnektoren für Google Drive, Gmail, Slack und GitHub funktionieren direkt vom Gerät aus, die Spracherkennung läuft lokal über das NVIDIA Nemotron 3.5 ASR Model, ohne dass Audiodaten das Gerät verlassen, und Code wird in einer isolierten Sandbox ausgeführt. Portable Computer ist Pro- und Max-Abonnenten mit einem DGX Spark vorbehalten, zunächst unter Linux und später unter Windows, und lässt sich mit einem Klick aus der Anwendung installieren.
Am selben Tag veröffentlicht das Entwicklungsteam die Zahlen, die diese Einführung untermauern. Die These lautet, dass Modell und Harness gemeinsam entwickelt werden müssen: Generische Harnesses setzen ein Frontier-Modell voraus, das lange Kontexte bewältigen und über einen längeren Horizont planen kann, womit lokale Modelle Schwierigkeiten haben.
| Gemessener Benchmark | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench (53 Aufgaben) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp (1 266 Aufgaben) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100 (multimodale Dokumente) | 65,1 % | 13,9 % | 34,6 % | — |
Bei BrowseComp benötigt Computer außerdem 61 % weniger Zeit und 16 % weniger Tokens als Hermes sowie 51 % weniger Zeit und 70 % weniger Tokens als Pi. Vier Designentscheidungen erklären den Unterschied: ein minimaler System-Prompt, in Skills modularisierte Fähigkeiten, die im Verlauf geladen und entladen werden, häufig genutzte Konnektoren (Gmail, GitHub, Outlook, Google Calendar), die in kompakte Kommandozeilen-Tools umgewandelt wurden, statt sie als MCP-Server bereitzustellen, deren Definitionen den Kontext aufzehren, sowie eine stets aktive, nicht konfigurierbare Sandbox – ist sie nicht verfügbar, deaktiviert sich das Harness vor jedem Tool-Aufruf, anstatt auf eine nicht isolierte Ausführung umzuschalten. Perplexity weist zudem auf eine nützliche praktische Erkenntnis hin: Qwen 3.8 27B gibt ein Kontextfenster von 260K Tokens an, gerät empirisch jedoch ab mehr als 100K ins Stocken.
| Terminal Bench 2.1 (89 Aufgaben) | Punktzahl | API-Kosten pro Ausführung |
|---|---|---|
| Qwen 3.8 27B, 100 % lokal | 59,6 % | ungefähr 0 |
| Qwen 3.8 27B + Beratung durch Claude Opus 5 | 73,0 % | 0,415 USD |
| Claude Opus 5 allein | 82,4 % | 0,65 USD |
Der Eskalationsmechanismus zu einem Beratungsmodell (Advisor) ist der interessanteste Punkt des Berichts: Er schließt etwa drei Fünftel der Lücke zu Frontier-Modellen für ungefähr zwei Drittel ihrer Kosten, wobei die Entscheidung weiterhin beim Nutzer liegt. Vor jedem Aufruf wählt das Harness den relevanten Kontext aus, wendet einen Klassifikator für personenbezogene Daten an und zeigt dem Nutzer, was das Gerät verlassen würde; das Beratungsmodell gibt ausschließlich Text zurück und hat weder direkten Zugriff auf Dateien noch auf Tools. Das Nachtraining von PPLX 27B kombiniert schließlich Rejection Fine-Tuning mit Reinforcement Learning in synthetischen Umgebungen, die in Docker-Containern ausgeführt werden, ganz ohne echte Nutzerdaten. Ein technischer Bericht und die Veröffentlichung des Evaluierungs-Benchmarks als Open Source sind angekündigt.
🔗 Benchmarks des lokalen Harnesses · Portable Computer – Perplexity-Blogbeitrag
Claude: ein gemeinsamer Speicher für Chat und Cowork, Datei für Datei lesbar
25. August — Anthropic hebt die Grenze zwischen zwei bisher parallel bestehenden Speichern auf. Was Claude aus Ihren Unterhaltungen im Chat behält, entspricht nun genau dem, was ihm in Claude Cowork zur Verfügung steht, und umgekehrt. Konkret startet Cowork bei der Ausführung einer Aufgabe in der Cloud mit dem über Monate angesammelten Kontext: den Prioritäten des Quartals, dem Fortschritt von Projekten und den Schreibpräferenzen eines Gesprächspartners. Anthropic nennt bewusst alltägliche Beispiele – etwa einen Fortschrittsbericht für die eigene Führungskraft anzufordern, ohne angeben zu müssen, wer damit gemeint ist oder wie diese Person Informationen bevorzugt erhält.
Die zweite Änderung ist unauffälliger, verändert aber das tägliche Verhalten: Der Speicher wird während der Unterhaltung aktualisiert, statt erst im Nachhinein durch eine Zusammenfassung. Die Erwähnung, dass eine Frist auf September verschoben wurde, genügt, damit die nächste Unterhaltung dies berücksichtigt. Die Formulierung „Merke dir das“ bleibt verfügbar, um das Speichern eines bestimmten Elements zu erzwingen, und der Speicher kann jederzeit pausiert oder zurückgesetzt werden.
Bei der Transparenz hat sich Anthropic für eine lesbare Darstellung statt einer Blackbox entschieden: Alles, was Claude behält, erscheint in Form kurzer, nach Themen geordneter Dateien unter Einstellungen und anschließend Speicher. Jede Datei kann gelesen, korrigiert oder gelöscht werden. Der praktische Nutzen liegt auf der Hand – es genügt, den früheren Namen des eigenen Unternehmens in einer einzigen Datei zu korrigieren, damit alle folgenden Unterhaltungen den richtigen verwenden.
Der Umgang mit sensiblen Themen ist hinsichtlich der Produktentscheidungen der interessanteste Punkt. Standardmäßig speichert Claude nichts, was Gesundheit, Herkunft, ethnische Zugehörigkeit, religiöse Überzeugungen, politische Meinungen oder Geschlechtsidentität betrifft. Anthropic räumt jedoch ein, dass diese Grenze individuell ist, und bietet eine optionale Einstellung an, um solche Themen einzubeziehen – sodass Claude sich etwa beim Vorschlagen von Rezepten an eine Glutenunverträglichkeit erinnern kann. Diese Einstellung gilt nicht rückwirkend und kann jederzeit deaktiviert werden. Eine Kategorie bleibt unabhängig von der Einstellung ausgeschlossen: Identifikationsnummern, Vorstrafen, Einwanderungsstatus und allgemeiner alles, was gegen die Richtlinie zur akzeptablen Nutzung verstößt. Claude weist ausdrücklich darauf hin, wenn Informationen dieser Art nicht gespeichert werden können – eine Designentscheidung, die eine sichtbare Ablehnung einer stillen Filterung vorzieht.
| Aspekt des Speichers | Beschriebenes Verhalten |
|---|---|
| Umfang | Gemeinsamer Speicher für Chat und Claude Cowork |
| Zeitpunkt der Aktualisierung | Während der Unterhaltung, zuvor durch eine Zusammenfassung nach deren Ende |
| Speicherformat | Kurze, nach Themen geordnete Dateien, die einzeln lesbar und bearbeitbar sind |
| Sensible Themen | Standardmäßig nicht gespeichert, per Einstellung aktivierbar, nicht rückwirkend |
| Dauerhafte Ausschlüsse | Identifikationsnummern, Vorstrafen, Einwanderungsstatus |
| Free-, Pro- und Max-Tarife | Speicher standardmäßig im Web, auf dem Desktop und auf Mobilgeräten aktiviert |
| Team- und Enterprise-Tarife | Vom Administrator freigegeben, für Nutzer bis zur Aktivierung deaktiviert |
🔗 Claudes Speicher funktioniert überall · Ankündigung von @claudeai
IBM veröffentlicht Granite 4.2, seine erste Reasoning-Familie, und zwei ASR-Modelle mit 470M Parametern
25. August — IBM veröffentlicht Granite 4.2, das als erste Familie dichter, reiner Decoder-Sprachmodelle des Unternehmens vorgestellt wird, die ausdrücklich für Reasoning entwickelt wurden. Während frühere Generationen auf Effizienz und klassische Unternehmensaufgaben ausgerichtet waren, stellt diese Version Reasoning in den Mittelpunkt und macht es konfigurierbar: Jedes Modell bietet drei Modi – thinking, non-thinking und low-effort –, zwischen denen die Anwendung entsprechend dem akzeptierten Latenz- und Token-Budget wählt. Die drei Größen (3B, 8B, 30B) teilen sich dieselbe Architektur und dieselbe Pipeline, wodurch der Wechsel zwischen ihnen auf Integrationsseite reibungslos erfolgt.
Die Architektur bleibt klassisch: GQA-Attention mit 40 Heads für 8 KV-Heads, RoPE mit einem θ von 10 Millionen zur Bewältigung eines Kontexts von 131 072 Tokens, SwiGLU-MLP, RMSNorm-Normalisierung und Training in bfloat16 auf einem von CoreWeave betriebenen NVIDIA-GB200-NVL72-Cluster. Das Pretraining beginnt bei null und umfasst etwa 15 Billionen Tokens in fünf Phasen. Was Granite 4.2 wirklich auszeichnet, ist das Nachtraining: eine Reinforcement-Learning-Pipeline aus aufeinanderfolgenden spezialisierten Schritten statt eines einzigen Durchlaufs, mit asynchronem GRPO und gekürztem Importance Sampling, sodass sich die Generierungs- und Trainingshälften der Schleife nie gegenseitig blockieren. Das Curriculum umfasst nacheinander drei RLVR-Durchläufe mit überprüfbaren Belohnungen, gezielte Verstärker für das Befolgen von Anweisungen und für Code, zwei Software-Engineering-Schritte mit 128K-Kontext, einen Terminal-Schritt, einen Recherche-Schritt und schließlich RLHF-Alignment. Der Block für agentisches Reinforcement Learning wird nur auf die 8B- und 30B-Modelle angewendet, was den Leistungsunterschied beim agentischen Programmieren zwischen dem 3B-Modell und seinen größeren Geschwistern erklärt.
| Von IBM veröffentlichter Benchmark | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
Die Veröffentlichung beschränkt sich nicht auf die bfloat16-Gewichte: Vier quantisierte Varianten für vLLM begleiten die Veröffentlichung – dynamisches FP8 pro Kanal ohne Kalibrierung sowie NVFP4 und MXFP4 mittels GPTQ, kalibriert anhand von 2 000 SFT-Beispielen – ebenso wie vierzehn GGUF-Formate für llama.cpp, von Q2_K bis Q8_0. Zwölf Sprachen werden unterstützt, darunter Französisch, und drei Harnesses für agentisches Programmieren sind vom ersten Tag an dokumentiert: OpenCode, Pi und OpenHands. Zur Datenqualität beschreibt IBM eine Pipeline, in der GPT-OSS-120B und Gemma 4 als Bewerter für SFT-Beispiele dienen, bevor eine lokale und globale Deduplizierung mittels SHA-256-Hashing erfolgt.
Am selben Tag veröffentlicht IBM Granite Speech 5.0 Turbo CTC, zwei englischsprachige Spracherkennungsmodelle mit 470 Millionen Parametern, die sich lediglich durch ihre Trainingsdaten und ihre Lizenz unterscheiden – Apache 2.0 für die Standardvariante und CC-BY-NC-SA-4.0 für die mit zusätzlichen Daten trainierte Variante. Der Architekturwechsel ist bemerkenswert: Frühere Granite-Speech-Modelle kombinierten einen akustischen Encoder, einen Projektor und ein LLM; diese Modelle bestehen ausschließlich aus einem Encoder. Der Stack umfasst 16 Conformer-Blöcke, wendet am Ausgang des achten Blocks Selbstkonditionierung an, ersetzt die Skalarprodukt-Attention durch blockweise Attention (chunkwise), um eine quadratische Skalierung zu vermeiden, und optimiert direkt den CTC-Loss. Die eigentliche Neuerung ist die Token-Rate: Durch Subsampling wird der Datenstrom von 100 Frames pro Sekunde am Ausgang des Log-Mel-Spektrogramms auf 12,5 pro Sekunde reduziert, was das „Turbo“ im Namen erklärt. Die Ergebnisse werden im OpenASR Leaderboard und im FFASR Leaderboard für Fernfeldaufnahmen dargestellt, mit Pareto-Diagrammen für Geschwindigkeit und Genauigkeit statt einzelner Punktzahlen. Hinzu kommt eine Demonstration kontinuierlicher Spracherkennung, die über WebGPU im Browser läuft und auf Chrome und Edge beschränkt ist.
🔗 Granite 4.2 – technischer Überblick · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, erstes KI-Modell, das vom National Hurricane Center in Echtzeit eingesetzt wird
25. August — Google AI stellt WeatherNext Cyclones ausführlich vor, ein Modell zur Vorhersage tropischer Wirbelstürme von Google DeepMind und Google Research. Bemerkenswert ist die Ankündigung weniger wegen der reinen Leistung als vielmehr wegen dessen, was sie über den Übergang der Wetter-KI vom Labor in den operativen Einsatz aussagt.
Das angegangene Problem ist struktureller Natur. Bisher erforderte die Verfolgung eines Wirbelsturms einen Kompromiss: Physikalische Modelle, die auf Supercomputern laufen, erfassen die großen atmosphärischen Strukturen, die über den Planeten ziehen, gut. Um jedoch die lokale und intensive Physik zu verstehen, welche die Stärke eines Sturms bestimmt, musste auf völlig andere regionale Modelle umgeschaltet werden. WeatherNext Cyclones beseitigt dieses Hin und Her, indem es Zugbahn, Intensität und Größe in einem einzigen Durchlauf vorhersagt.
Der angekündigte Gewinn beträgt einen vollständigen Tag Vorlauf gegenüber bisherigen Systemen. Google formuliert den Vergleich anschaulich: Dreitagesvorhersagen erreichen nun die Genauigkeit früherer Zweitagesvorhersagen – ein Fortschritt, für den historisch ein Jahrzehnt methodischer Entwicklungen nötig war. Der zweite Beitrag ist probabilistischer Natur: Das Modell ist schnell genug, um bis zu 1.000 Simulationen pro Sturm zu erzeugen, wodurch die einzelne „wahrscheinlichste“ Zugbahn durch eine Bandbreite von Szenarien ersetzt wird. Dadurch lässt sich eine schnelle Intensivierung besser erfassen, definiert als ein Anstieg der maximalen anhaltenden Windgeschwindigkeit um mindestens 30 Knoten innerhalb von 24 Stunden. In diesem Jahr werden den Meteorologen über WeatherLab 1.000 probabilistische Vorhersagen pro Sturm bereitgestellt.
Das bedeutendste Element bleibt der reale Einsatz. Während der Hurrikansaison 2025 wurde WeatherNext Cyclones im US-amerikanischen National Hurricane Center erprobt – erstmals setzte diese Institution KI-Modelle im Echtzeitbetrieb ein. Die Meteorologen nutzten es, um die Vorhersage für das Auftreffen des Hurrikans Melissa als Kategorie-5-Sturm auf Jamaika zu erstellen, wodurch die örtlichen Behörden zusätzliche Vorbereitungszeit erhielten. Ein Artikel erschien in Nature, und Google kündigt an, den Code und die Modellgewichte als Open Source auf GitHub zu veröffentlichen.
| Aspekt des Modells | Beitrag von WeatherNext Cyclones |
|---|---|
| Vorhergesagte Größen | Zugbahn, Intensität und Größe in einem einzigen Durchlauf |
| Gewonnener Vorlauf | Ein Tag; 3-Tages-Prognose = Genauigkeit der früheren 2-Tages-Prognose |
| Simulationen pro Sturm | Bis zu 1.000 |
| Operativer Einsatz | U.S. National Hurricane Center, Hurrikansaison 2025 |
| Dokumentierter Anwendungsfall | Auftreffen des Hurrikans Melissa als Kategorie 5 auf Jamaika |
| Intensivierungsschwelle | Mehr als 30 Knoten maximale anhaltende Windgeschwindigkeit in 24 Stunden |
| Bereitstellung | WeatherLab; Code und Gewichte als Open Source auf GitHub |
🔗 Ankündigung von @GoogleAI · Beitrag von Google DeepMind
Stability AI schließt Serie-B-Finanzierungsrunde über 76 Millionen Dollar mit EA, Sony Music, Universal und Warner ab
25. August — Stability AI gibt den Abschluss seiner Serie-B-Finanzierungsrunde bekannt: 76 Millionen Dollar frisches Kapital, womit sich die Gesamtfinanzierung seit der Übernahme der Unternehmensführung durch Prem Akkaraju im Juni 2024 auf 232 Millionen Dollar beläuft, einschließlich zweier Eigenkapitalrunden und Wandelanleihen. Gemessen an der Branche bleibt der Betrag bescheiden, doch die Zusammensetzung der Investorenrunde ist das eigentliche Thema.
Vier Schwergewichte der Unterhaltungsbranche beteiligen sich am Unternehmen: Electronic Arts aus der Videospielbranche sowie Sony Music Group, Universal Music Group und Warner Music Group aus der Musikbranche. Die drei großen Musikkonzerne sind nun Anteilseigner desselben Labors. Hinzu kommen AMD Ventures und Pacific Alliance Ventures. Diese Investoren kommen nicht aus dem Nichts: EA, Universal und Warner waren bereits seit Herbst 2025 strategische Partner von Stability AI. Die Runde verwandelt somit bestehende Geschäftsvereinbarungen in Kapitalbeteiligungen.
Ein weiteres Signal ist die Treue der Finanzinvestoren. Coatue, Greycroft, Kadmos Capital, Sean Parker und Eric Schmidt investieren unter der neuen Führung zum zweiten Mal in Folge – was nach der turbulenten Phase, die Stability AI 2023 und 2024 durchlief, einer Bestätigung gleichkommt. Thomas Laffont, Mitgründer von Coatue, tritt dem Verwaltungsrat bei, dem bereits James Cameron, Sean Parker, Dana Settle und Prem Akkaraju angehören.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇩🇪 Diese einzigartige Investorengruppe bestätigt unsere Vision einer generativen KI, die jedem Produzenten, Musiker und Geschichtenerzähler neue Möglichkeiten eröffnet. Stability ist im Bereich der KI einzigartig, weil wir Kreative sind, die Werkzeuge für Kreative entwickeln. — Prem Akkaraju, CEO von Stability AI, Mitteilung vom 25. August
Die erklärte Strategie ist die eines spezialisierten Labors: kein universelles Modell, sondern Werkzeuge für Kreativprofis, die gemeinsam mit den Rechteinhabern und nicht gegen sie entwickelt werden. Genau diesem Ansatz folgt Stable Audio 3.0, eine Familie von Modellen mit offenen Gewichten, die vollständig mit lizenzierten Daten trainiert wurde und am 18. August um ein Plugin für Audio-Workstations erweitert wurde. Das Geld soll die weitere Produktentwicklung, die angewandte Forschung und den Bereich professioneller Dienstleistungen finanzieren.
🔗 Ankündigung von @StabilityAI
ChatGPT für Unternehmen: Admin-Plugin, browserübergreifende Erweiterung und Premium-Lizenz für 100 Dollar
25. August — Drei Ankündigungen von OpenAI richten sich an dasselbe Publikum: Organisationen, die ChatGPT und Codex in großem Maßstab einsetzen.
Die substanziellste Neuerung ist das Admin-Plugin für ChatGPT Work und Codex, das in einer Unterhaltung zusammenführt, wofür bisher zwischen Analytics-Dashboards, Einstellungsseiten und Berichten gewechselt werden musste. Der Funktionsumfang deckt alltägliche Aufgaben ab: Akzeptanz und Guthabenverbrauch verstehen, Mitglieder oder Gruppen nahe ihren Limits erkennen, Ein- und Austritte verwalten, effektive Berechtigungen prüfen und Zugriffsprobleme diagnostizieren, Nutzungslimits anpassen sowie Ausgabenanträge anhand des tatsächlichen Verbrauchs beurteilen. Am interessantesten ist die Automatisierung ohne Programmierung: Ausstehende Nutzungsanträge können zur Genehmigung an Slack oder Microsoft Teams weitergeleitet werden, also an das Werkzeug, das die Genehmigenden bereits verwenden. Anträge auf Zugriff auf eine Funktion können automatisch bewilligt werden, wenn sie vordefinierte Kriterien erfüllen; Ausnahmen werden an einen Menschen weitergeleitet. Ein zentraler Sicherheitsaspekt: Das Plugin arbeitet innerhalb der bestehenden Rolle und Berechtigungen des Benutzers und erweitert keinerlei Zugriffe. Jede Anweisung wird einer unterstützten Lese- oder Schreibaktion mit einem strukturierten Ergebnis zugeordnet. OpenAI verweist auf den eigenen Einsatz: Ein ChatGPT-Work-Agent in Slack bearbeitet interne IT-Anfragen, und die eingesetzten Workflows lösen rund 45 % des Ticketaufkommens; der Rückstand wurde beseitigt, obwohl sich das Supportvolumen ungefähr verdoppelt hatte.
Die zweite Ankündigung: Die ChatGPT-Browsererweiterung ist nicht mehr auf Chrome beschränkt und unterstützt nun Microsoft Edge, Brave, Opera und Vivaldi. Die Änderung ist für alle relevant, die aus Datenschutzgründen oder aufgrund betrieblicher Vorgaben mit einem alternativen Browser arbeiten. Zwei Anwendungsfälle werden hervorgehoben: Über die Erwähnung @ tab in ChatGPT Desktop kann der Kontext geöffneter Tabs in eine Aufgabe übernommen werden, sodass Codex auf Grundlage der bereits angezeigten Dokumentation oder des Tickets arbeitet. Außerdem kann der Agent den Browser steuern, um konkrete Webaufgaben auszuführen; die Kündigung von Abonnements wird als eines der Beispiele genannt.
Die dritte Ankündigung fällt knapper aus: Das Angebot ChatGPT Business wird um eine Premium-Lizenz für 100 Dollar ergänzt, die sich an kleine Unternehmen und Start-ups richtet und als flexibler, entsprechend der Teamgröße skalierbarer Tarif präsentiert wird. Die Ankündigung erfolgte auf X ohne ausführlichen Blogbeitrag, und der genaue Leistungsumfang der Lizenz wird in der Nachricht nicht erläutert.
🔗 Admin-Plugin · Browserübergreifende Erweiterung · Premium-Lizenz für ChatGPT Business
NVIDIA: Gamescom für RTX Spark und SANA senkt die Latenz von MiniMax H3 um den Faktor 27
25. August — NVIDIA nutzt die diese Woche in Köln stattfindende Gamescom, um den Katalog von RTX Spark, seiner für diesen Herbst erwarteten Windows-PC-Plattform, zu erweitern. Electronic Arts, Embark Studios und Ubisoft schließen sich KRAFTON, NetEase, Riot Games und XBOX an, die sich bereits beim COMPUTEX im Mai verpflichtet hatten. Die genannten Titel decken unterschiedliche technische Anforderungen ab: EA SPORTS F1 25 und Apex Legends von EA, Anno 117: Pax Romana von Ubisoft sowie ARC Raiders und THE FINALS von Embark Studios.
Der konkreteste Punkt betrifft den Schutz vor Cheating. Es reicht nicht aus, ein Spiel zum Laufen zu bringen: Große Online-Titel sind auf Anti-Cheat-Systeme angewiesen, die auf jede Plattform portiert werden müssen, da das Spiel sonst im Mehrspielermodus unspielbar bleibt. NVIDIA gibt bekannt, gemeinsam mit EA daran zu arbeiten, EA Javelin Anticheat nativ auf RTX Spark zu bringen – genau jene Art von Infrastrukturdetail, die über die tatsächliche Akzeptanz einer neuen PC-Plattform entscheidet. Beim Rendering ist DLSS 4.5 Ray Reconstruction ab sofort verfügbar. Dabei ersetzt ein Transformer-Modell der zweiten Generation klassische Rauschunterdrücker durch ein auf einem Supercomputer trainiertes Netzwerk. Path Tracing kommt in CONTROL Resonant und 007 First Light zum Einsatz, Gears of War: E-Day integriert RTX Mega Geometry, und NVIDIA-ACE-Technologien wurden für Anfang 2027 in Aniimo angekündigt.
Die andere Seite desselben Akteurs ist am 24. August technischer. MiniMax berichtet über die Ergebnisse, die das SANA-Team von NVIDIA mit Sol Engine beim Einsatz für sein Videomodell H3 erzielt hat: Die Erzeugung von zehn Sekunden Video in 768p auf einem einzigen GB200 sinkt von 414 Sekunden auf 14,93 Sekunden, was einer Beschleunigung um den Faktor 27,7 entspricht. Die Methode beruht nicht auf einer Kernel-Optimierung, sondern auf der Aufteilung der Generierung in zwei Durchläufe: Zunächst erstellt H3 in 4 Schritten einen Entwurf mit niedriger Auflösung, anschließend übernimmt LTX in 3 Schritten mit Sol-Attn einen Verfeinerungsdurchlauf in der Zielauflösung. Insgesamt sind es sieben Schritte. Als zweiter Hebel werden die rechenintensiven VAE-Decodierungen durch TAEH3 und TAEHV, zwei schlankere Decoder, ersetzt, wobei die Latents für den Verfeinerungsdurchlauf stabil gehalten werden.
| Messwert für MiniMax H3 | Gemessener Wert |
|---|---|
| Gemessene Arbeitslast | 10 s Video in 768p, ein einziger GB200 |
| Latenz vorher | 414 s |
| Latenz nachher | 14,93 s |
| Beschleunigungsfaktor | 27,7x |
| Generierungsschritte | 4 (H3-Entwurf mit niedriger Auflösung) + 3 (LTX) |
| Ersetzte Decoder | TAEH3 und TAEHV anstelle der VAE-Decodierungen |
| Prognostizierter Durchsatz pro Knoten | 378.000 Videos pro Monat, mehr als 97 % GPU-Marge |
Der prognostizierte Durchsatz ist eine Schätzung von MiniMax und kein Produktionsmesswert und sollte auch entsprechend verstanden werden. Die Richtung ist jedoch klar: Mit fünfzehn Sekunden Rechenzeit für zehn Sekunden Video entwickelt sich die hochauflösende Videogenerierung vom asynchronen Batch-Rendering zu einer nahezu interaktiven Infrastruktur.
🔗 NVIDIA auf der Gamescom · SANA und Sol Engine auf H3
Offene chinesische Modelle werden zum Maßstab der Forschung, und Qwen3.8-27B erreicht die Top 10 der Code Arena
25. August — Qwen verbreitet am selben Morgen zwei Ergebnisse, wobei das zweite dem ersten seine Bedeutung verleiht.
Beim ersten handelt es sich um eine Rangliste. Qwen3.8-27B steigt in die Rangliste Code Arena: WebDev ein, die Modelle bei der Erstellung von Weboberflächen bewertet, und belegt mit 1595 Punkten den 9. Gesamtrang. Es ist das einzige Modell seiner Größenklasse in den Top 10 und liegt nur sechs Plätze hinter dem deutlich größeren Qwen3.8-Max. Arena hebt hervor, dass es die Pareto-Grenze der Rangliste neu definiert, und liefert einen anschaulichen Vergleichspunkt: Das ähnlich große, aber im April veröffentlichte Gemma 4-31B belegt Platz 80.
| Bewertetes Modell | Rang in Code Arena: WebDev | Erreichte Punkte | Anmerkung zur Rangliste |
|---|---|---|---|
| GLM-5.3 (Max) | 8. Gesamtrang | 1597 | Stand vom 20. August, Platz 2 unter den offenen Modellen |
| Qwen3.8-27B | 9. Gesamtrang | 1595 | Einziges Modell seiner Größe in den Top 10 |
| Qwen3.8-Max | Sechs Plätze vor dem 27B | k. A. | Deutlich größeres Modell derselben Familie |
| Gemma 4-31B | 80. Gesamtrang | k. A. | Veröffentlicht im April 2026 |
Das zweite Ergebnis ist eine Nutzungsmessung. Nathan Lambert, der das Olmo-Projekt bei Ai2 mitgeleitet hat, ließ Codex 500.000 seit der Veröffentlichung von ChatGPT erschienene arXiv-Artikel zu KI und maschinellem Lernen auswerten, um die offenen Modelle zu identifizieren, die tatsächlich in der Forschung eingesetzt werden. Die Umkehr lässt sich in zwei Zahlen zusammenfassen: 2024 erwähnten etwa 30 % der Artikel ein offenes US-amerikanisches Modell und 10 % ein chinesisches Modell; heute zitieren rund 40 % ein offenes chinesisches LLM und nur noch 25 bis 30 % ein US-amerikanisches.
| Modellfamilie | Anteil der Artikel, die ein LLM zitieren |
|---|---|
| OpenAI (geschlossene Modelle) | etwa 37 % |
| Qwen | etwa 33 % |
| Gemini, Claude | 10 bis 15 % |
| Gemma, Mistral | 5 bis 10 % |
| Olmo | etwa 1 % |
Im Einzelnen wird Qwen in einem Drittel aller Artikel erwähnt, die irgendein LLM zitieren. Llama erreichte seinen Höchststand um April 2025 mit 30 %, genau zum Zeitpunkt der Veröffentlichung von Llama 4, und verliert seither an Boden. Lambert weist selbst auf eine wichtige Einschränkung hin: Veröffentlichungen hinken den Modellveröffentlichungen hinterher, weil Forschung Zeit braucht – diese Zahlen beschreiben daher eher den Stand der laufenden Arbeiten als die aktuellen Präferenzen. Parallel lässt sich ein grundlegender Trend erkennen, der vom Gegensatz zwischen offen und geschlossen unabhängig ist: Der Anteil der KI-Artikel, die ein LLM erwähnen, stieg von 10,43 % im Januar 2023 auf mehr als 50 % im Jahr 2026.
🔗 Qwen3.8-27B in der Code Arena · Qwens Verweis auf die arXiv-Analyse · Analyse von @natolambert
Claude Code wird auf 2.1.245 aktualisiert, und Claudes Darstellung im Web wird viermal flüssiger
Im betrachteten Zeitraum sind zwei Versionen von Claude Code erschienen, deren Inhalte klar auf Bereitstellungen in Organisationen ausgerichtet sind. Das CHANGELOG enthält keine Datumsangaben, doch die Git-Historie ordnet sie zeitlich ein: 2.1.243 erscheint im Commit vom 24. August um 23:40 UTC, 2.1.245 in jenem vom 25. August um 05:13 UTC.
| Hinzugefügte Einstellung | Betroffene Version | Praktischer Nutzen |
|---|---|---|
modelPricing | 2.1.243 | Vertragspreise in /cost, der Statusleiste und der Telemetrie |
modelPicker | 2.1.243 | Geordnete und beschriftete Modellliste für /model |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | Einstündiger Prompt-Cache für die Unterhaltung, 5 Min. für Subagents |
Aufschlüsselung der Loops in /usage | 2.1.243 | Aus dem Ruder laufende /loop-Aufgaben erkennen |
| Schlüssellose Anmeldung über Console | 2.1.243 | Organisationen, die API-Schlüssel verbieten |
| Fehlerbehebung für glibc 2.44 | 2.1.245 | Absturz beim Start unter Arch Linux, CachyOS und Fedora Rawhide |
Die strukturell wichtigste Einstellung ist modelPricing: Bisher wurden die angezeigten Kosten anhand des öffentlichen Tarifs berechnet; nun kann eine Organisation ihre Vertragspreise pro Modell und ihren Rabattfaktor eintragen, sodass die Zahlen direkt für die interne Weiterverrechnung nutzbar sind. Das Zusammenspiel von promptCacheTtl und subagentPromptCacheTtl löst einen konkreten wirtschaftlichen Zielkonflikt für Nutzer mit API-Schlüssel: Für die Hauptunterhaltung, deren Kontext stabil bleibt, wird ein einstündiger Cache beibehalten, während Subagents bei fünf Minuten bleiben, da ihre Kontexte volatiler sind. Bei den Fehlerbehebungen bleiben entfernte MCP-Server im nicht interaktiven Modus nach einer Unterbrechung nicht mehr hängen, /resume ist nicht mehr auf die fünfzig neuesten Sitzungen beschränkt, und Sitzungen, die länger als zehn Minuten stumm bleiben, laufen nun nach etwa drei Minuten ab, bevor ein erneuter Versuch und eine ausdrückliche Fehlermeldung folgen.
Am 24. August gab Anthropic außerdem bekannt, die Engine neu geschrieben zu haben, die gerade generierte Antworten in Claude im Web und auf dem Desktop darstellt. Das Prinzip ist aus dem Interface-Rendering bekannt: Nur das wird aktualisiert, was sich noch verändert, statt bei jedem neuen Fragment die gesamte Antwort neu zu zeichnen. Bei einer langen Antwort ist der Unterschied grundlegend — der Rendering-Aufwand wächst nicht länger mit der Länge des bereits angezeigten Textes. Die angekündigten Verbesserungen sind entsprechend: ungefähr viermal flüssigere Darstellung, neunmal weniger Blockierungen auf einem leistungsschwachen Laptop, ein 4,5-mal kürzeres schlimmstes Einfrieren der Oberfläche und durchgehend 120 Bilder pro Sekunde auf einem MacBook mit 120 Hz. Interessant ist insbesondere die Zielgruppe: Bescheidene Konfigurationen profitieren am meisten.
🔗 Claude Code CHANGELOG · Viermal flüssigere Darstellung, @ClaudeDevs
Code-Agents werden industrialisiert: Warp veröffentlicht das Format seiner Factories, Rohlik lässt 90 % seines Codes von Agents schreiben
24. August am späten Nachmittag — Warp gewährt Einblick in die interne Funktionsweise von Warp Factories, seiner am 18. August angekündigten Plattform für Cloud-Agents: das gewählte Konfigurationsformat und die Öffnung eines Early Access. Der Ausgangspunkt wird offen benannt — Warp verlagert seine eigenen Agents aus Qualitäts- und Kostengründen von lokalen Rechnern und musste Umgebungen, Harnesses und Sicherheitsberechtigungen als versionierten Code beschreiben.
| Konfigurationselement | Gewählter Wert |
|---|---|
| Definitionsdatei | factory.yaml, schemaVersion: v1alpha1 |
| Hauptschlüssel | name, repositories (owner / name), agentDefaults.model |
| Definition eines Agents | agents/<nom>/agent.md mit agentType (FOREMAN, REVIEW …) und model |
| Auslöser | automations/<nom>/automation.md: agent, triggers (Anbieter, Ereignis) |
| Verfügbare Schnittstellen | CLI (warp agent run-cloud), REST API, TypeScript SDK, MCP-Server |
| Early Access | Bis zu 10.000 USD kostenlose Nutzung für qualifizierte Kunden |
Die Trennung ist bemerkenswert: Die Agents werden nicht in einer einzigen YAML-Datei beschrieben, sondern in eigenen Markdown-Dateien, sodass die Definition eines Agents zu einem lesbaren und vergleichbaren Dokument wird. Warp wendet das Konzept auf sich selbst an — seine interne Factory namens „wilson“ deckt Repositorys wie warp-server oder warp-terraform ab, deklariert ihre Secrets und MCP-Server und ordnet ihre Agents in 34 Zeilen nach Rollen (code-review, foreman, implementation, spec, triage). Die auf der Seite zur Beantragung des Zugangs genannten Zahlen sind von außen nicht überprüfbare Werbeaussagen: 200.000 Agent-Ausführungen pro Tag, mehr als 30 % der Pull Requests ohne Nacharbeit zusammengeführt, 20 % niedrigere Kosten pro Pull Request.
Am 25. August veröffentlichte Cognition seinerseits eine deutlich besser dokumentierte Fallstudie als die vorherige. Die Rohlik Group ist ein in der Tschechischen Republik gegründeter Online-Lebensmittelhändler, der in fünf Ländern tätig und profitabel ist und im vergangenen Jahr mehr als 1,3 Milliarden Dollar Umsatz erzielte; das Unternehmen liefert einen vollständigen Wocheneinkauf aus 17.000 Produkten in weniger als einer Stunde oder in Zeitfenstern von fünfzehn Minuten. Die zentrale Zahl des Artikels: Rund 90 % des Codes werden dort heute von Agents generiert, und die Engineering-Organisation bezeichnet sich als „agent-mostly“.
Dieses Ergebnis wurde nicht einfach durch das Anschließen eines Tools erreicht. Rohlik gibt an, vor einem Jahr mit einem ersten, als fehlerhaft bewerteten Versuch mit Devin begonnen zu haben. Den Ausschlag gaben die auf Kundenseite geschaffenen Grundlagen: mehr als fünfzig interne und externe MCP-Integrationen nach dem Grundsatz, dass jedes neue Tool den Agents vom ersten Tag an zugänglich sein muss, eine semantische Schicht über dem Snowflake Data Warehouse und eine Wissensbasis, die den Agents denselben Kontext vermittelt wie einem neuen Kollegen. Die Arbeit gelangt von dort zu Devin, wo sie entsteht: aus einer Slack-Unterhaltung über einen Bug oder einem Linear-Spezifikationsdokument, das bis zum Pull Request weitergeführt wird. Die beanspruchten Ergebnisse — seit November verdoppelter Engineering-Durchsatz, eine in acht Monaten gelieferte AutoStore-Robotikintegration, für die die Branche zwei bis drei Jahre benötigt, und eine Verkürzung des Prototypings von einem Monat auf einen Tag — stammen weiterhin von einer vom Anbieter veröffentlichten Kundenseite. Der aussagekräftigste Effekt liegt woanders: Die besten Engineers verbringen inzwischen 80 % ihrer Zeit mit Code-Reviews, und rund 30 % der Devin-Nutzung bei Rohlik entfallen auf Datenanalysen durch Fachanwender.
🔗 factory.yaml-Format, @warpdotdev · Rohlik-Fallstudie, @cognition · Devin-Kundenseite
GitHub: vier Übungen zu agentischen Workflows und allgemeine Verfügbarkeit des Customize-Tabs
25. August — GitHub stellt vier neue Übungen auf seiner Lernplattform GitHub Skills bereit. Der Ansatz ist eindeutig: Statt die agentischen Neuerungen des Jahres lediglich zu dokumentieren, bietet GitHub die Möglichkeit, sie in einem Demo-Repository praktisch anzuwenden, wobei die Anweisungen schrittweise über Pull Requests bereitgestellt werden.
| Veröffentlichte Übung | Gegenstand der Übung |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Benutzerdefinierte Agents in Copilot CLI: planen, entwerfen, erstellen, validieren, übergeben |
| Agentic Workflows that Read the Room | Erweiterung gh aw, agentischer Workflow in Markdown, Änderungen über Pull Requests eingereicht |
| Idea to Merge with the Copilot App | Von einer Sitzung bis zu einem zusammengeführten Pull Request, vollständig in der GitHub-Copilot-App |
| Ship with Quality | Automatisierte Qualitätssignale, Testabdeckung, vorgeschriebene Prüfungen für Pull Requests |
Am bemerkenswertesten ist die erste der vier Übungen: GitHub bietet erstmals einen geführten Kurs zur Multi-Agent-Orchestrierung in seiner CLI an, einem Thema, das bislang nur in Textform dokumentiert war. Die zweite führt die Erweiterung gh aw ein, mit einem wichtigen Sicherheitsaspekt — die vom Workflow vorgeschlagenen Änderungen werden über Pull Requests geleitet, statt direkt angewendet zu werden, sodass eine menschliche Prüfstelle erhalten bleibt.
Am selben Tag erhält die GitHub-Copilot-App einen allgemein verfügbaren Customize-Tab. Seine Aufgabe besteht darin, die vier in den vergangenen Monaten separat eingeführten Erweiterungsmechanismen auf einer einzigen Oberfläche zu bündeln: MCP-Server, Plugins, Skills und Canvases. Eine Featured-Ansicht zeigt eine redaktionelle Auswahl aus jeder Kategorie für Nutzer, die wissen, was sie tun möchten, aber nicht, welcher Erweiterungstyp dafür geeignet ist. MCP-Server erhalten zudem eine eigene Navigation mit nach Beliebtheit hervorgehobenen Optionen und einer Aufschlüsselung nach Kategorien. Das Changelog veranschaulicht den Nutzen von Canvases anhand eines konkreten Falls: ein Azure-DevOps-Canvas, um Issues zu sortieren, ein Backlog zu priorisieren, Folgemaßnahmen zuzuweisen und anschließend Copilot mit einer Aufgabe zu betrauen, damit er sie untersucht, implementiert oder das Review vorbereitet.
🔗 Vier GitHub-Skills-Übungen · Allgemeine Verfügbarkeit des Customize-Tabs
Googles Entwicklerwerkzeuge: Gemini CLI 0.57.0 und Antigravity 2.10.0
25. August — Google veröffentlicht die stabile Version 0.57.0 von Gemini CLI, der eine Viertelstunde zuvor die Preview 0.58.0 vorausging. Der Inhalt dieser Version sagt weniger über neue Funktionen aus als darüber, wie Google sein Tool pflegt: Von den 24 Einträgen im Changelog sind 13 mit [SSR Agent] Issue Fix versehen und verweisen auf häufig ältere Issue-Nummern von 19239 bis 28518. Diese Korrekturen beheben im Backlog angesammelte Ärgernisse — ein unbegrenztes Hängenbleiben der Terminaloberfläche, für das nun Timeouts hinzugefügt werden, eine irreführende Administrationsfehlermeldung bei persönlichen Konten, ein fehlendes Leerzeichen nach Autovervollständigungsvorschlägen und eine Terminaldarstellung, die nach dem Beenden eines externen Editors nicht aktualisiert wurde. Anders gesagt: Google setzt einen Agent auf seine eigenen technischen Schulden an, und das Ergebnis fließt direkt in die stabile Version ein.
| Veröffentlichte Version | Datum und Uhrzeit (UTC) | Veröffentlichungskanal | Wichtigste Punkte |
|---|---|---|---|
| v0.57.0 | 25. August, 18:37:14 | Stable | 13 [SSR Agent]-Korrekturen, Validierung der Evals, kontextbezogene Retries |
| v0.58.0-preview.0 | 25. August, 18:22:01 | Preview | Docker-Isolierung im Seatbelt-macOS-Profil, Sicherheitsprüfer |
Bei den Funktionen liegt der Schwerpunkt auf der Evaluation, mit einem Befehl zur Validierung der Evals und einem Formatierer für Tool-Aufrufe, der Fehlerzusammenfassungen einbezieht. Auch die Zuverlässigkeit verbessert sich: Kapazitätsfehler lösen stille, kontextabhängige Retries aus, und das Abbrechen einer mehrstufigen Anfrage führt zu einem vollständigen Rollback statt zu einem Teilzustand. Für alle, die nach den Versionshinweisen suchen, ist anzumerken, dass die Datei docs/changelogs/index.md des Repositorys über v0.54.0 vom 6. August hinaus nicht aktualisiert wurde.
Vier Tage nach 2.9.1 und dessen Remote Control wird Google Antigravity am 24. August auf 2.10.0 aktualisiert und schließt zwei Lücken, die bislang das Verlassen des Tools erforderlich machten: ein integriertes Terminal und eine native Git-Versionskontrolle, beide direkt in der Seitenleiste untergebracht. Die Bündelung entspricht der Entwicklung des Produkts — Antigravity positioniert sich als Umgebung, in der Agents gesteuert werden, statt Code Zeile für Zeile zu bearbeiten; dennoch muss es möglich sein, einen Befehl auszuführen und ein Diff zu prüfen, ohne das Fenster zu wechseln. Der Rest der Version erweitert sowohl das, was einem Agent übergeben werden kann, als auch die Sichtbarkeit seiner Arbeit: Audiodateien gehören nun zu den unterstützten Anhängen, interaktive Kommentare auf Bildern ermöglichen die Annotation einer visuellen Darstellung zur Steuerung des Agents, und erweiterte Vorschauen der Ausführung von MCP-Tools machen nachvollziehbar, was ein Tool-Server tatsächlich getan hat. Google beziffert die Version auf 13 Verbesserungen und 8 Fehlerbehebungen, die schrittweise ausgerollt werden.
🔗 Gemini CLI v0.57.0 · Antigravity-Changelog
Anthropic finanziert unabhängige Evaluationen zum Wohlbefinden mit 5 Millionen Dollar
25. August — Anthropic startet ein Stipendienprogramm in Höhe von 5 Millionen Dollar zur Finanzierung unabhängiger Forschung über die Auswirkungen von KI auf das Wohlbefinden ihrer Nutzer. Die Empfänger erhalten direkte Finanzierung, Zugang zu Modellen und technische Unterstützung, arbeiten jedoch vollkommen unabhängig: Ihre Evaluationen werden als Open Source veröffentlicht und können von der gesamten Branche wiederverwendet werden. Bewerbungen sind bis zum 21. September möglich, und Kandidaten, die zur Einreichung eines vollständigen Vorschlags ausgewählt werden, erhalten vor dem 5. Oktober Bescheid.
Die technische Begründung erläutert, warum sich dieser Bereich üblichen Evaluationsmethoden entzieht. Bei den meisten Verhaltensweisen eines Modells genügt es, eine einzelne Antwort zu prüfen, um ihre Richtigkeit und Angemessenheit zu beurteilen. Wohlbefinden erfordert Kontext: Ein Nutzer in einer Krisensituation erwähnt selbstverletzende Gedanken nicht zwangsläufig sofort, und Ratschläge zu einer ausgewogenen Ernährung, die in einem Fall vernünftig sind, können potenziell gefährlich werden, wenn die Person zuvor Anzeichen einer Essstörung gezeigt hat. Das Safeguards-Team veröffentlicht parallel fünf Kriterien für methodische Strenge: klar benennen, was gemessen wird; Kliniker und Fachleute des jeweiligen Gebiets an der Konzeption beteiligen; sowohl Schutzmaßnahmen als auch Schäden testen — also das Risiko übermäßiger Gefälligkeit ebenso bewerten wie das übermäßiger Ablehnung —; die tatsächliche Nutzung durch mehrstufige Szenarien abbilden; und automatische Bewerter anhand echter Experten validieren. Dieses dritte Kriterium, die Symmetrie zwischen übermäßiger Zustimmung und übermäßiger Ablehnung, unterscheidet diesen Ansatz von einer bloßen Verschärfung der Schutzmechanismen.
🔗 Forschungsstipendien zum Wohlbefinden
Quantization-Aware Healing: ein 4-Bit-Modell, das sein ursprüngliches Vollpräzisionsmodell übertrifft
25. August — Die Standardpipeline, um ein großes Modell einsatzfähig zu machen, besteht aus drei Schritten: Architektur komprimieren, das Ergebnis quantisieren und anschließend den Qualitätsverlust beheben. Das vorherrschende Verfahren für diesen letzten Schritt ist QAT (quantization-aware training), das Operationen zur simulierten Quantisierung einfügt und das Modell erneut trainiert; eine Alternative, QAD, destilliert aus dem komprimierten Vollpräzisionsmodell. In beiden Fällen kann das Schülermodell bestenfalls zu seinem komprimierten Lehrermodell aufschließen und übernimmt damit die durch die Komprimierung gesetzte Obergrenze.
Multiverse Computing schlägt eine Änderung an nur einer Zeile vor: direkt aus dem ursprünglichen Modell destillieren, also aus dem Modell vor der Komprimierung. Damit ist die Quantisierung keine verlustbehaftete Nachbearbeitung mehr, sondern wird zu einem vollwertigen Lernschritt. Das Ergebnis ist kontraintuitiv: Auf GPT-OSS 120B angewandt, das auf 60B komprimiert und anschließend in MXFP4 quantisiert wurde, erzeugt die Methode ein 4-Bit-Modell, das seine eigene bfloat16-Quelle in sieben von neun Benchmarks erreicht oder übertrifft. Die größten Zugewinne zeigen sich dort, wo die Komprimierung am meisten schadet: +7,4 Punkte bei AA-LCR für Schlussfolgerungen mit langem Kontext und +5,6 bei AIME 2025. Die einzigen beiden Rückgänge, bei MMLU-Pro und SciCode, bleiben unter anderthalb Punkten.
Der direkte Vergleich mit QAT bei identischer Pipeline ist möglicherweise das praktisch nützlichste Ergebnis. Bei GPT-OSS 9B, quantisiert in MXFP4, erreichen beide Methoden einen vergleichbaren Höchstwert von 54,9 beziehungsweise 54,6, allerdings nicht zum gleichen Preis: QAH erreicht ihn nach etwa hundert Schritten und hält dieses Niveau, während QAT rund 700 Schritte benötigt und sich danach verschlechtert. Daraus ergibt sich ein konkreter Unterschied beim Bereitstellungsrisiko: Ein QAT-Checkpoint erfordert eine sorgfältige Überwachung des vorzeitigen Abbruchs, ein QAH-Checkpoint deutlich weniger.
Gradio integriert gr.Workflow, einen graphbasierten Konstruktor für KI-Pipelines
25. August — Hugging Face veröffentlicht einen Leitfaden zu gr.Workflow, einem nun in Gradio integrierten Grundbaustein. Die Ausgangsbeobachtung ist einfach: Die meisten interessanten KI-Anwendungen bestehen nicht aus einem einzelnen Modellaufruf, sondern aus einer Abfolge von Schritten — ein Bild wird erzeugt, sein Hintergrund freigestellt, daraus ein Voice-over erstellt und ein LLM um einen Titel gebeten. Bislang musste man sowohl die Logik als auch die Benutzeroberfläche programmieren, um diese Abfolge zu verknüpfen und sauber bereitzustellen. gr.Workflow führt beides zusammen: Die Schritte werden als Graph typisierter Knoten beschrieben, und der Graph selbst wird zur Benutzeroberfläche.
Der Nutzen für Entwickler geht über die visuelle Demonstration hinaus. Jede Ausgabe des Graphen erhält automatisch einen eigenen REST-Endpunkt: Das als Beispiel vorgestellte Medienstudio, das FLUX-Bilderzeugung, Freistellung, Sprachsynthese und ein LLM miteinander verknüpft, stellt drei separate Routen (/sticker, /voiceover, /episode_title) bereit, die sich ohne die Benutzeroberfläche aus Code aufrufen lassen. Die Knoten können mit vier Welten kommunizieren — über die Inference Providers von Hugging Face gehostete Modelle, andere öffentliche Gradio Spaces, die als Bausteine wiederverwendet werden, eine Zeile aus einem Datensatz im Hub sowie beliebigen Python-Code. Der letzte Punkt eröffnet die meisten Möglichkeiten: Ein mit @spaces.GPU dekorierter Operatorknoten reserviert für die Dauer seiner Ausführung eine ZeroGPU-GPU, sodass sich eigene Gewichte ausführen lassen. Der Leitfaden enthält fünf tatsächlich als Spaces bereitgestellte Anwendungen, darunter einen Datensatz-Profiler und eine Demonstration, die mit Lightricks/LTX-Video ein Standbild animiert.
ElevenLabs führt Composer ein, einen Editor zur abschnittsweisen Songbearbeitung
25. August — ElevenLabs kündigt Composer an, einen Songeditor, der Abschnitt für Abschnitt arbeitet. Das Prinzip bricht mit dem vorherrschenden Generierungsmodus von Musikmodellen: Statt einen vollständigen Titel in einem Durchgang zu erzeugen und alles neu zu starten, wenn eine Passage nicht gefällt, ermöglicht Composer die separate Überarbeitung einer Strophe, eines Refrains oder einer Bridge. Vier Ausgangspunkte stehen zur Wahl — eigene Liedtexte, ein vorhandener mitgebrachter Titel, eine leere Seite oder ein einfacher Prompt — und das Stück entsteht anschließend durch schrittweise Überarbeitungen.
Es ist nach Eleven Music der zweite Vorstoß von ElevenLabs in den Musikbereich und erfolgt in einer ereignisreichen Woche für das Unternehmen, nachdem am Vortag CLI v1 veröffentlicht wurde. Die Positionierung entspricht der Entwicklung im übrigen Audiosektor: Suno führte Studio 2.0 am 13. August ein, Pika veröffentlichte seine Pika-Music-Reihe am 18. August und Stability AI lieferte am selben Tag sein Plugin für Digital Audio Workstations aus. Die präzise Kontrolle über die Struktur eines Stücks ist anstelle der reinen Generierungsqualität zum Wettbewerbsfeld geworden. Es gibt allerdings einen Vorbehalt: Die Ankündigung wird von keinem Blogbeitrag begleitet, und es liegen keine Informationen dazu vor, welche Tarife Zugriff auf Composer bieten, welche Exportformate unterstützt werden oder ob ein API-Zugriff verfügbar ist.
🔗 Composer-Ankündigung von @ElevenLabs
LiveAvatar hebt sämtliche Parallelitätsbeschränkungen auf und senkt den Preis auf 0,01 USD pro Minute
25. August — HeyGen kündigt die Aufhebung der Parallelitätsbeschränkungen für LiveAvatar, sein Produkt für Echtzeit-Avatare, an. Die Formulierung betont die Art der Änderung: Die Limits werden nicht angehoben, sondern vollständig abgeschafft. Eine oder zehntausend Sitzungen laufen über dieselbe API, ohne dass zuvor ein Kontingent ausgehandelt werden muss. Zwei weitere Angaben begleiten die Ankündigung — die Darstellung bleibt in 1080p und zeigt den ganzen Körper, während der Preis bei entsprechender Skalierung auf bis zu 0,01 USD pro Minute sinkt.
Dieses Preisniveau verändert die Art der denkbaren Anwendungsfälle: Bei einem Cent pro Minute wird ein Echtzeit-Avatar für massenhaften Kundensupport, Schulungen oder interaktive Kioske wirtschaftlich, also für Bereiche, in denen die Stückkosten bislang über die Machbarkeit entschieden. Technisch interessant ist die Aufhebung der Parallelitätsbeschränkung. Plattformen für Echtzeit-Avatare begrenzen üblicherweise die Zahl gleichzeitiger Sitzungen, weil jede Sitzung fortlaufend GPU-Ressourcen beansprucht; diese Obergrenze aufzuheben setzt entweder erhebliche Kapazitätsreserven oder Effizienzsteigerungen beim Modell voraus. HeyGen hat einen Artikel veröffentlicht, in dem das Unternehmen seinen Ansatz erläutert; die technischen Details waren zum Zeitpunkt der Sichtung nicht zugänglich.
🔗 Unbegrenzte Parallelität bei LiveAvatar
Grok 4.6 kommt zu OpenCode Go
25. August — Grok 4.6 wird in OpenCode Go aufgenommen, das Abonnement des Open-Source-Coding-Agenten OpenCode. Die Ankündigung kam am späten Nachmittag von OpenCode und wurde eine halbe Stunde später vom Konto @grok weiterverbreitet. Für Entwickler ist vor allem das Kontingent relevant: 169 Anfragen pro 5-Stunden-Zeitraum für Nutzer des Go-Tarifs. Dabei handelt es sich um ein gleitendes Limit und nicht um eine monatliche Zählung, was gut zur typischen schubweisen Nutzung bei Sitzungen mit assistiertem Coding passt.
Diese Integration reiht sich in eine Serie von Öffnungen von Grok 4.6 für Drittanbieter-Tools ein: Das Modell kam am 14. August zu GitHub Copilot, am 19. August zu Amazon Bedrock und am 21. August zur Gemini Enterprise Agent Platform von Google. xAI hatte OpenCode zudem bereits im Mai 2026 mit seinen Abonnements SuperGrok und X Premium verbunden — die heutige Neuerung ist daher nicht der Zugang zu OpenCode an sich, sondern die Verfügbarkeit des Modells 4.6 im Go-Tarif mit einem enthaltenen Kontingent, statt dass Nutzer selbst ein xAI-Abonnement bereitstellen müssen.
🔗 Weiterverbreitung durch @grok · Ankündigung von @opencode
Cohere veröffentlicht eine IDC-Studie zur Einführung souveräner KI im Jahr 2026
25. August — Cohere veröffentlicht die Ergebnisse eines bei IDC in Auftrag gegebenen InfoBrief zur Einführung souveräner KI in regulierten Branchen. Für die Studie wurden zwischen April und Mai 2026 mehr als 500 hochrangige Entscheidungsträger aus Unternehmen mit einem Umsatz von über einer Milliarde Dollar in Kanada, den Vereinigten Staaten, dem Vereinigten Königreich und Deutschland befragt.
Das bemerkenswerteste Ergebnis betrifft weniger die Einführung als die begriffliche Verwirrung. Jeder dritte Manager hat Schwierigkeiten, souveräne KI mit eigenen Worten zu beschreiben, und nur 13 % geben an, sehr umfassend über das Thema informiert zu sein. Von denjenigen, die eine Definition formulieren können, beschreiben 52 % sie als lokale oder nationale Kontrolle, während 35 % die digitale Unabhängigkeit anführen. Die Kluft zieht sich auch durch die Organisationsstruktur: IT-Verantwortliche weisen einen doppelt so hohen Informationsstand auf wie Fachbereichsverantwortliche.
| Befragte Branche | Datenlecks und Compliance als Hauptanliegen | Wettbewerbsvorteil als Treiber |
|---|---|---|
| Finanzdienstleistungen | 82 % | 21 % |
| Industrie | 77 % | 32 % |
| Telekommunikation | 75 % | 37 % |
| Gesundheitswesen | 74 % | 28 % |
| Energie | 70 % | 21 % |
Bei den Beweggründen besteht ein klarer und branchenübergreifender Konsens: Datenlecks, Datenschutz und Compliance stehen in allen befragten Branchen an erster Stelle. Wettbewerbsvorteile erscheinen als zweitrangiger, aber wachsender Treiber und werden in Kanada (35 %) und den Vereinigten Staaten (28 %) stärker hervorgehoben als in Deutschland (23 %) oder im Vereinigten Königreich (18 %). Die Studie dient offenkundig der Positionierung von Cohere, dessen agentische Plattform North in der vom Kunden gewählten Infrastruktur und Rechtsordnung ausgeführt wird; dennoch stammen die Zahlen aus einer eindeutig benannten Quelle. IDC prognostiziert außerdem, dass die CIOs multinationaler Unternehmen ihre Investitionen in modulare souveräne Cloud-Umgebungen und Datenlokalisierung bis 2028 um 65 % erhöhen werden.
🔗 Stand der Einführung souveräner KI 2026
Kurzmeldungen
- Bain & Company tritt dem Claude Partner Network bei — Das Beratungsunternehmen wird Global-Premier-Partner, gestützt durch die Einführung von Claude für seine 19.000 Beschäftigten; bereits in der Pilotphase gab es mehr als 7.000 aktive Nutzer, und mehr als zwei Drittel der Teilnehmer führten Claude for Excel ein. 🔗 Anthropic-Blogbeitrag
- Amp erklärt, was Orbs sind — Eine Notiz von Thorsten Ball als Reaktion auf die Verwirrung um die Bezeichnung: Ein Orb ist ein entfernter Agent, der über das Web, das Smartphone oder die CLI gesteuert werden kann. Zwei nützliche Hinweise zu den Kosten: Unbegrenzter Ruhezustand wird nicht berechnet und die Anzahl gleichzeitig ausgeführter Orbs ist nicht begrenzt. 🔗 Amp-Notiz
- Together AI öffnet Qwen3.8 27B für Fine-Tuning und dedizierte Inferenz — Das Modell steht nun sowohl für die Feinabstimmung mit eigenen Daten als auch für Dedicated Model Inference auf reservierter Hardware zur Verfügung. 🔗 Tweet von @togethercompute
- FINAL-Bench startet FINCHAL, einen Finanzprognose-Wettbewerb für Agenten — Der mit 2.000 Dollar dotierte Wettbewerb verlangt Positionen statt Vorhersagen und veröffentlicht eine Zufallsobergrenze (luck ceiling), um Können von Zufall zu unterscheiden. 🔗 FINAL-Bench-Blogbeitrag
- Au-Zone veröffentlicht den EdgeFirst Model Zoo — Vier YOLO-Familien für Erkennung und Segmentierung, gemessen auf realer Embedded-Hardware; jede veröffentlichte Zahl verweist auf die Validierungssitzung, aus der sie stammt, im Gegensatz zur Intransparenz der von Herstellern angegebenen TOPS-Werte. 🔗 EdgeFirst-Blogbeitrag
- Die intelligente Diktierfunktion von Gemini für macOS — In jedes Desktopfenster diktieren, wobei Zögern automatisch entfernt und Korrekturen mitten im Satz berücksichtigt werden; per Sprache lassen sich außerdem Dateien zusammenfassen und Texte umschreiben. 🔗 Leitfaden auf blog.google
- Push Rules unterstützen Pfadausnahmen — In der öffentlichen Vorschau können die Regeln Restrict file paths und Restrict file size bestimmte Pfade ausnehmen, um beispielsweise JAR-Dateien überall außer unter
**/gradle/wrapper/*.jarzu sperren. 🔗 GitHub-Changelog - Nutzer über einen Sicherheitshinweis sperren — Die Aktion ist in öffentlichen Repositories über das Drei-Punkte-Menü der Beschreibung oder eines Kommentars verfügbar, ohne erneut die Einstellungen aufzurufen; der Hinweis bleibt unverändert bestehen. 🔗 GitHub-Changelog
- Manus meldet eine hohe Nachfrage nach Datenwiederherstellungen — Fehlgeschlagene Wiederherstellungen sollen später am Tag erneut gestartet werden; die ausdrückliche Anweisung lautet, die Sicherungspakete vollständig und unverändert aufzubewahren. 🔗 Tweet von @ManusAI
- Kling veröffentlicht drei Leitfäden zu seinem MCP-Server — Kling mit einem MCP-kompatiblen Assistenten verbinden, um eine validierte kreative Konfiguration erneut auszuführen und Varianten stapelweise zu erzeugen; zwei der drei Tutorials nennen Claude Code als Client. 🔗 Kling-Blog
- Wan 3.0 kommt zu Runway und Replicate — Runway integriert es am 24. August mit mehreren Referenzeingaben für Bild, Video und Audio; Replicate folgt am 25. August und hebt native 30 Sekunden in einer einzigen Einstellung mit synchronisiertem Audio hervor. 🔗 Tweet von @runwayml
- Runway kündigt neue Redner für seinen AI Summit an — Das Programm für die Veranstaltung im September in San Francisco wird um Robotik, autonome Fahrzeuge, Marketing und Infrastruktur erweitert. 🔗 Tweet von @runwayml
- MiniMax veröffentlicht einen Index der H3-Integrationen — Awesome MiniMax H3 Integrations führt auf, was rund um das offene Videomodell entwickelt wird, darunter Konfigurationen, die mit 24 GB VRAM laufen. 🔗 Tweet von @MiniMax_AI
- Luma startet Dream Lab Weekly — Die erste Folge einer Videoserie über die Kreativprofis von Luma und ihre wöchentliche Arbeit am Produkt. 🔗 Tweet von @LumaLabsAI
- NVIDIA überträgt eine Nemotron-Labs-Sitzung zum Routing offener Modelle — Eine 55-minütige Liveübertragung mit dem Titel Get Started with Open Model Routing als Fortsetzung der Arbeit an Nemotron 3.5 Lightning und NeMo Switchyard. 🔗 Tweet von @NVIDIAAI
- Noch eine Woche für den Grok-Imagine-Wettbewerb zur Odyssee — Gefordert ist eine Szene aus der Odyssee, welche die Video- und Sprachfähigkeiten des Tools hervorhebt; die Preisgelder betragen 100.000, 50.000 und 25.000 Dollar. 🔗 Tweet von @grok
- Vorrat an Limit-Zurücksetzungen für Plus- und Pro-Abonnenten — Statt auf das Zeitfenster zur Zurücksetzung zu warten, nutzt der Anwender eine bevorratete Zurücksetzung; eine ist zum Start kostenlos, weitere gibt es über Empfehlungen, während im Business-Tarif Workspace-Credits gemeinsam genutzt werden. 🔗 ChatGPT- und Codex-Changelog
Was das bedeutet
Silizium wird wieder zum Thema für Modelllabore. OpenAI veröffentlicht am selben Tag die ersten Messwerte seines eigenen Inferenzchips und den Beitrag, der seine Compute-Strategie darlegt. Das ist kein Zufall im Zeitplan: Ein Modellanbieter, der sein eigenes Silizium entwickelt, es anhand eines öffentlichen Benchmarks eines Drittanbieters misst und sich öffentlich zu einem Portfolio von zehn Partnern bekennt, verändert die Art des Wettbewerbs. Die Frage lautet nicht mehr „Welches Modell ist das beste?“, sondern „Zu welchen Kosten pro erfolgreich erledigter Aufgabe?“, und die Antwort entscheidet sich ebenso sehr im Rack wie in den Gewichten. Das bedeutendste Detail liegt vielleicht woanders: KI wurde eingesetzt, um den Chip zu entwerfen und seine Kernel zu schreiben, mit einer Fertigungsreife innerhalb von neun Monaten und generierten Implementierungen, die auf ausgewählten Blöcken jene menschlicher Experten übertreffen. Der Kreis schließt sich – die Modelle entwickeln die Hardware, auf der sie laufen werden.
Die KI kehrt auf das Gerät zurück, und die Zahlen beginnen, dies zu untermauern. Drei Signale am selben Tag weisen in dieselbe Richtung. Perplexity führt seinen gesamten Agenten lokal auf einem DGX Spark aus, ohne Credits zu verbrauchen, wobei eine Eskalation in die Cloud weiterhin eine Entscheidung des Nutzers bleibt. Multiverse Computing veröffentlicht eine Methode, bei der ein 4-Bit-Modell seine Quelle mit voller Präzision erreicht oder übertrifft, womit das übliche Argument gegen aggressive Quantisierung entfällt. Au-Zone veröffentlicht Vision-Messwerte nach eingebettetem Silizium und kritisiert, dass die beworbenen TOPS nichts darüber aussagen, was ein bestimmtes Modell tatsächlich leisten wird. Keine dieser drei Arbeiten behauptet, mit dem Frontier gleichzuziehen: Perplexitys ehrlicher Wert liegt lokal bei 59,6 % gegenüber 82,4 % für Claude Opus 5 allein auf Terminal Bench 2.1. Doch die Eskalation zu einem beratenden Modell gleicht drei Fünftel der Differenz zu zwei Dritteln der Kosten aus, und genau diese Abwägung macht die lokale Ausführung vertretbar – nicht die Parität.
Offene Gewichte etablieren sich als Referenzposition. Die von Qwen verbreitete Analyse von 500.000 arXiv-Artikeln dokumentiert eine bereits erkennbare Umkehr: Chinesische offene Modelle stiegen von 10 % auf rund 40 % der Erwähnungen, während offene amerikanische Modelle zwischen 25 und 30 % stagnieren. Qwen3.8-27B schafft es als einziges Modell seiner Größe in die Top 10 der Code Arena, GLM-5.3 übertraf GPT-5.6 Sol und Claude Fable 5 bei mehreren Versuchen auf DeepSWE zu 2,1- bis 5,4-mal niedrigeren Kosten, und IBM veröffentlicht Granite 4.2 vom ersten Tag an mit vier quantisierten Varianten und vierzehn GGUF-Formaten – dieselbe Logik wiederholt sich. Die Gewichte zu öffnen, ist kein Aufholmanöver mehr, sondern eine Möglichkeit, zur Standardinfrastruktur für andere zu werden, mit der Einschränkung, die Nathan Lambert selbst anführt: Veröffentlichungen hinken Releases hinterher, und diese Kurven beschreiben die laufenden Arbeiten und nicht die aktuellen Präferenzen.
Und das Web bereitet sich darauf vor, von Agenten statt von Menschen gelesen zu werden. Die WebMCP Challenge ist ein Wettbewerb mit einem Preisgeld von 35.000 Dollar, was wenig ist; was sie offenbart, ist mehr wert. Chrome, Cloudflare, Shopify, Vercel, Render und Netlify schließen sich OpenAI bei einem Standard an, der Websites dazu auffordert, strukturierte Tools bereitzustellen, statt Agenten eine Benutzeroberfläche erraten zu lassen. Am selben Tag kann ChatGPT desktop WebMCP nativ nutzen, Codex kann eine kompatible Anwendung erstellen und bereitstellen, und OpenAI dokumentiert seine interne Nutzung des Protokolls in einem Notebook-Tool. Diese Konvergenz deckt sich mit dem, was Rohlik seinerseits mit mehr als fünfzig MCP-Integrationen und dem Grundsatz beschreibt, dass jedes neue Tool den Agenten vom ersten Tag an zugänglich sein muss. Die Schnittstellenschicht für Agenten ist kein Forschungsthema mehr, sondern wird zu einer technischen Anforderung.
Quellen
- OpenAI — WebMCP Challenge
- OpenAI — Ankündigung der WebMCP Challenge auf X
- OpenAI — WebMCP in ChatGPT desktop und Sites
- OpenAI — repetitive Arbeit mit Codex, Runme und WebMCP automatisieren
- OpenAI — Jalapeño, erste Ergebnisse
- OpenAI — Der vollständige Stack hinter reichlich verfügbarer Intelligenz
- OpenAI — Admin-Plugin für ChatGPT Work und Codex
- OpenAI — Browsererweiterung auf Edge, Brave, Opera und Vivaldi ausgeweitet
- OpenAI — Premium-Arbeitsplatz für ChatGPT Business
- ChatGPT und Codex — Änderungsprotokoll
- Perplexity — Einführung von Portable Computer
- Perplexity — Beitrag zu Portable Computer
- Perplexity — Benchmarks des lokalen Harness
- Anthropic — Claudes Gedächtnis funktioniert überall
- Anthropic — Ankündigung der Gedächtnisfunktion auf X
- Anthropic — CHANGELOG von Claude Code
- Anthropic — viermal flüssigeres Streaming-Rendering
- Anthropic — Forschungsstipendien zum Wohlbefinden
- Anthropic — Bain & Company tritt dem Claude Partner Network bei
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — Leitfaden zu gr.Workflow
- FINAL-Bench — FINCHAL-Wettbewerb
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B für Fine-Tuning und dedizierte Inferenz
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — Änderungsprotokoll von Antigravity
- Google — intelligente Diktierfunktion von Gemini für macOS
- Stability AI — Serie-B-Finanzierungsrunde über 76 Millionen Dollar
- Stability AI — Ankündigung auf X
- NVIDIA — Gamescom und RTX Spark
- MiniMax — SANA und Sol Engine auf H3
- MiniMax — Verzeichnis der H3-Integrationen
- NVIDIA — Nemotron-Labs-Sitzung zum Routing offener Modelle
- Qwen — Qwen3.8-27B auf Code Arena WebDev
- Qwen — Weitergabe der arXiv-Analyse
- Nathan Lambert — 500.000 arXiv-Artikel unter die Lupe genommen
- Warp — factory.yaml-Format und frühzeitiger Zugang
- Cognition — Fallstudie zur Rohlik Group
- Devin — Kundenseite der Rohlik Group
- Amp — die Orbs erklärt
- GitHub — vier neue GitHub-Skills-Übungen
- GitHub — Registerkarte Customize allgemein verfügbar
- GitHub — Pfadausnahmen in Push-Regeln
- GitHub — Blockierung ausgehend von einem Sicherheitshinweis
- Manus — aktueller Stand der Datenwiederherstellung
- ElevenLabs — Composer
- HeyGen — unbegrenzte Gleichzeitigkeit auf LiveAvatar
- Kling — Leitfäden zum MCP-Server
- Runway — Wan 3.0 auf der Plattform verfügbar
- Runway — neue Vortragende beim AI Summit
- Luma — Dream Lab Weekly
- xAI — Grok 4.6 in OpenCode Go
- OpenCode — Grok 4.6 im Go-Tarif
- xAI — Grok-Imagine-Wettbewerb zur Odyssee
- Cohere — Stand der Einführung souveräner KI 2026