ai-powered-markdown-translatorgpt-5.6-sol을 사용하여 프랑스어에서 한국어로 번역된 기사.
24시간 동안 9개 분야에 걸쳐 51건의 발표가 쏟아진 8월 25일은 이번 주 들어 가장 분주한 날이었다. 그중 네 가지 움직임이 두드러진다. OpenAI는 자체 추론 칩 Jalapeño의 첫 실측 결과를 공개하고, 곧이어 Chrome, Cloudflare, Shopify, Vercel, Render, Netlify와 함께 WebMCP를 주제로 한 10일간의 해커톤을 시작했다. Perplexity는 Computer 에이전트 전체를 사용자의 기기에서 실행하도록 전환했다. IBM은 자사의 첫 추론 모델 제품군인 Granite 4.2를 공개했다. Anthropic은 채팅과 Cowork 사이에서 Claude의 메모리를 통합하고, 파일별로 열람하고 수정할 수 있게 했다. 그 밖에 National Hurricane Center에서 운영에 들어간 WeatherNext Cyclones, Stability AI의 시리즈 B 투자 유치, 약 20건의 도구 업데이트는 아래에서 다룬다.
WebMCP: 표준과 제품 지원, 내부 활용, 그리고 도입을 촉진하기 위한 대회
8월 25일 — OpenAI가 아직 실험 단계인 개방형 표준을 주제로 한 10일간의 해커톤 WebMCP Challenge를 시작했다. 이 표준은 에이전트가 웹과 상호작용하는 방식을 바꾼다. 해결하려는 문제는 구체적이다. 현재 에이전트가 웹사이트에서 작업을 수행하려면 눈과 마우스를 위해 설계된 인터페이스를 어떻게 탐색해야 할지 추측해야 한다. WebMCP는 이 논리를 뒤집어, 웹사이트 자체가 에이전트가 직접 호출할 수 있는 구조화된 도구를 노출하게 한다.
이번 발표에서 가장 주목할 점은 대회 자체가 아니다. 그 배후에서 드러난 공동 행보다. Chrome(Google), Cloudflare, Shopify, Vercel, Render, Netlify가 모두 같은 표준을 중심으로 OpenAI와 협력한다. 심사위원 명단에도 이러한 구성이 반영됐다. Sarah Drasner(Chrome 수석 엔지니어), Andrew Galloni(Cloudflare 연구·혁신 부문 부사장), Jude Gao(Vercel Next.js Core 팀), Ilya Grigorik(Shopify 수석 엔지니어), Sean Roberts(Netlify 응용 AI 부문 부사장), Justin Rushing(OpenAI 브라우저 에이전트 책임자), 그리고 MCP-B를 만든 Alex Nahas가 참여한다.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇰🇷 WebMCP Challenge가 시작됐습니다. 저희는 @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, @Netlify와 협력해 10일간의 해커톤을 개최합니다. 상금으로 현금 35,000달러, Codex Micro, ChatGPT Pro 구독권과 파트너들이 제공하는 다양한 상품이 마련돼 있습니다. — @OpenAIDevs의 X 게시물
일정은 빠듯하고 평가 기준은 명확하다. 유용성, 독창성, 구현 완성도, WebMCP의 사려 깊은 활용, 인간과 에이전트 간 경험의 품질을 평가한다. 참가 등록과 출품은 Devpost를 통해 진행된다. OpenAI는 프로젝트의 출발점으로 활용할 수 있도록 에이전트 네이티브 데모 애플리케이션도 공개했다. 에이전트가 제어하는 3D 모델링, 에이전트가 자신의 정체성으로 의견을 남기는 협업형 글쓰기, 맞춤형 십자말풀이 생성기, 여행 메모를 일정으로 바꾸는 Wandernote, 브라우저에서 DuckDB-Wasm을 활용하는 데이터 탐색 등이 포함된다. 기존 애플리케이션에 WebMCP를 추가하는 방식도 허용된다.
| 대회 항목 | 발표된 세부 내용 |
|---|---|
| 발표된 기간 | 10일 |
| 출품 접수 시작 | 2026년 8월 25일, 오후 12시 PT |
| 출품 마감 | 2026년 9월 3일, 오후 1시 PT |
| 수상자 발표 | 2026년 9월 23일(예정일) |
| 총상금 | 35,000달러 |
| 수상자별 상품(상위 10명) | 3,000달러, ChatGPT Pro 1년 이용권, Codex Micro 키보드, 기념품 |
| 출품 플랫폼 | Devpost |
이 표준을 일상적으로 활용할 수 있게 해 주는 제품 기능도 같은 날 출시됐다. 이제 ChatGPT 데스크톱 애플리케이션의 내장 브라우저와 ChatGPT Sites가 WebMCP를 사용할 수 있다. ChatGPT나 Codex가 호환되는 사이트를 방문하면 에이전트는 인터페이스를 더듬는 대신 페이지가 노출한 도구를 감지해 자동으로 사용한다. 이를 위해서는 데스크톱 애플리케이션을 최신 버전으로 업데이트해야 한다. 생산 측면에서는 Codex에 WebMCP 호환 애플리케이션을 만들어 달라고 요청한 뒤 Sites에 바로 배포할 수 있게 됐다. Chrome과의 지원 차이도 눈여겨볼 만하다. Chrome에서는 WebMCP가 여전히 실험용 플래그나 오리진 트라이얼(origin trial) 뒤에 있지만, ChatGPT 브라우저는 이를 기본 지원한다.
가장 시사적인 세 번째 부분은 OpenAI가 자체적인 내부 활용법을 문서화했다는 점이다. 한 OpenAI 엔지니어는 작업마다 자동화 기능을 하나씩 작성하는 방식을 중단하고, Codex와 협업하도록 설계된 오픈 소스 노트북 웹 애플리케이션 Runme를 구축한 과정을 설명한다. 그는 이전 실행 내용을 확인하고, 상세한 계획을 작성하며, 시작 전에 승인을 기다리고, 실행한 명령과 그 해석을 기록하라는 명시적인 지침과 함께 짧은 목표를 작성한다. 그러면 Codex가 작업을 진행하면서 노트북을 읽고 업데이트한다. 두 가지 아키텍처 선택에 주목할 필요가 있다. 첫째는 지속성이다. 노트북은 Google Drive에 저장되며, Runme는 Drive가 색인할 수 있는 동반 Markdown 색인 *.index.md도 동시에 생성한다. 덕분에 에이전트는 이전 실행을 찾아 작업 맥락으로 활용할 수 있다. 둘째는 기능 노출 방식이다. Runme는 정적으로 제공되는 클라이언트 애플리케이션이며, 기존 MCP 엔드포인트를 노출하기 위해서만 서버를 추가했다면 인프라가 늘어나고 노트북 데이터 처리 위치도 달라졌을 것이다. WebMCP를 사용하면 애플리케이션이 브라우저에서 직접 도구를 등록할 수 있다.
🔗 WebMCP Challenge · ChatGPT 데스크톱 및 Sites 지원 · OpenAI의 Codex, Runme, WebMCP 활용
Jalapeño: OpenAI가 추론 칩의 첫 수치를 공개하고 컴퓨팅 전략을 분명히 하다
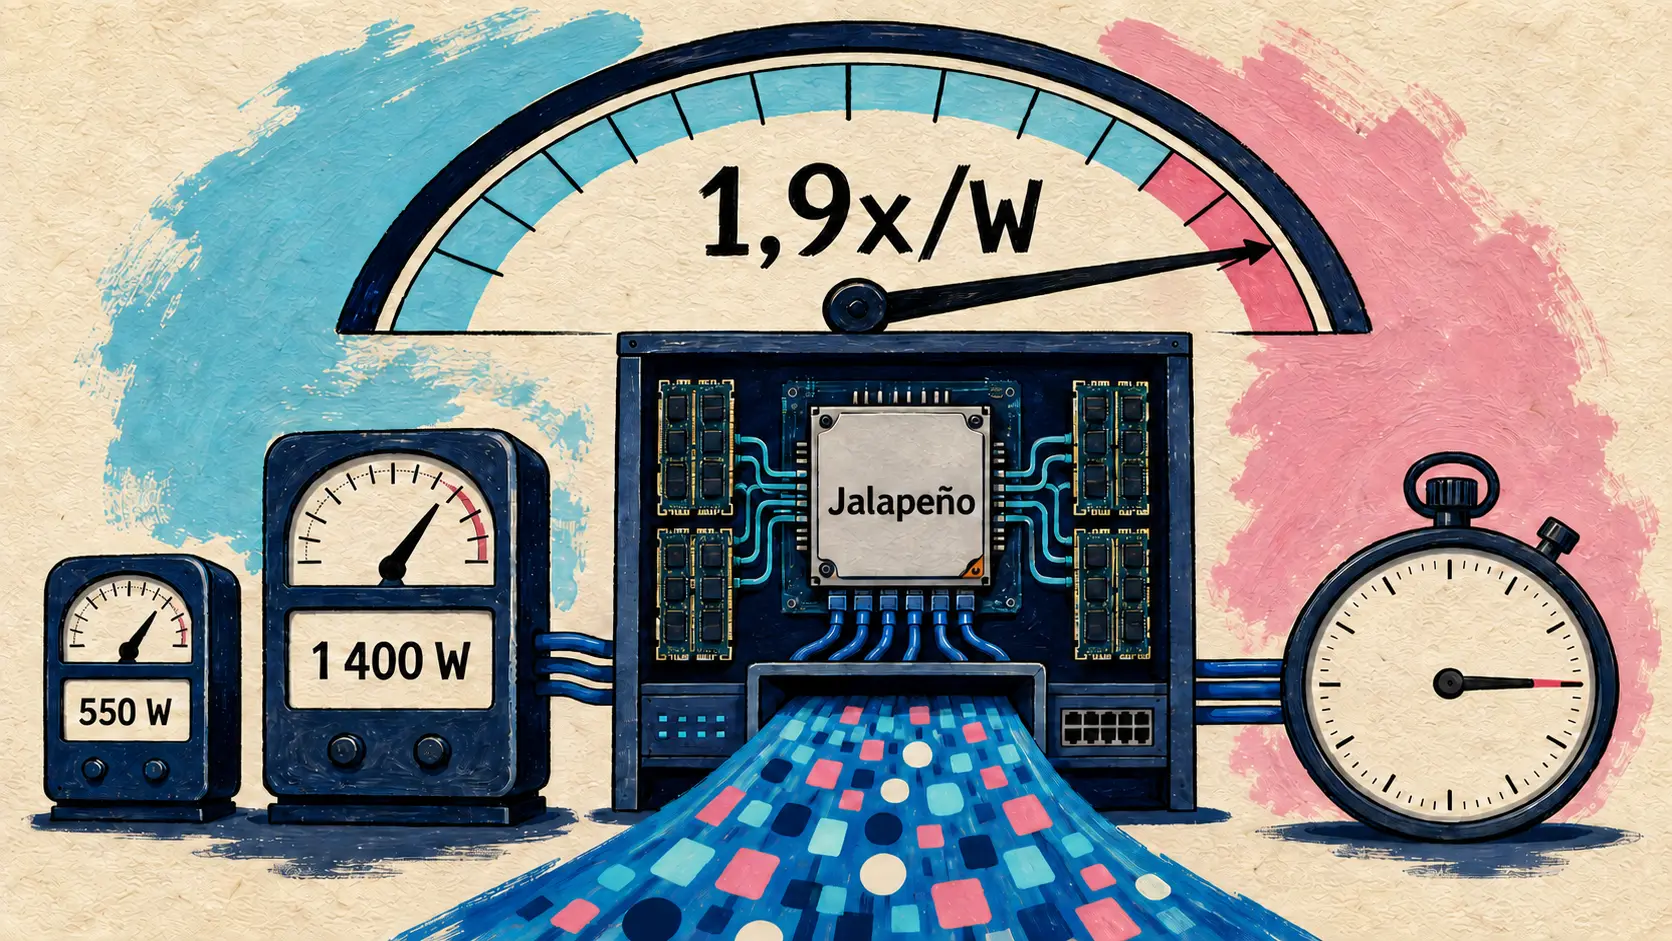
8월 25일 — OpenAI가 자체 설계한 첫 추론 칩 Jalapeño의 실측 결과를 처음으로 공개했다. 이번 발표의 의미는 단순히 성능 향상 수치에만 있지 않다. 기존 추론 시스템은 일반적으로 처리량과 지연 시간 사이에서 절충해야 하지만, Jalapeño는 단일 아키텍처에서 두 가지를 모두 달성한다고 주장한다.
측정에는 SemiAnalysis가 공개한 벤치마크인 InferenceX가 사용됐다. 이 벤치마크는 요청의 전체 처리 과정을 시뮬레이션한다. GPT-OSS 120B, DeepSeek R1 670B, Kimi K2.5 1T 등 세 가지 개방형 모델을 상용 시스템과 비교했다. 칩당 성능이 아닌 와트당 성능으로 정규화한 것은 명시적인 선택이자 편리한 선택이다. Jalapeño의 소비 전력은 비교 대상 시스템의 절반 수준이기 때문이다. Jalapeño의 정격 전력은 700 W이며, 시험한 부하에서 측정된 지속 소비 전력은 550 W 이하로 유지됐다. 반면 GB200은 1 200 W, GB300은 1 400 W였다.
| 평가 모델(비교 시스템) | kW당 최대 처리량 | 종단 간 지연 시간 | 최소 TBT |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
OpenAI에 따르면 세 모델 전체에서 Jalapeño는 최대 처리량 기준 와트당 AI 작업량이 비교 시스템보다 1.51.9배 많고, 종단 간 지연 시간은 1.73.6배 짧으며, 상호작용성이 매우 높은 부하에서는 성능이 최대 2.1~4.1배 높다. 기술적으로 이러한 성능 향상은 랙 규모에서 칩, 메모리, 네트워크, 소프트웨어, 시스템을 공동 설계한 결과다. 추론은 병목이 서로 다른 두 단계를 거친다. 프롬프트를 처리하며 연산 자원을 포화시키는 사전 채우기(prefill)와 토큰을 하나씩 생성하며 주로 메모리 대역폭에 좌우되는 생성(decode)이다. Jalapeño는 데이터 이동을 최소화하도록 설계됐다. KV 캐시를 포함한 모델 상태를 명시적으로 배치하고 로컬에 유지하면서, 단계에 따라 적절한 연산·메모리·네트워크 조합을 활성화할 수 있다.
개발자에게 가장 흥미로운 부분은 칩 자체의 설계에서 AI가 맡은 역할이다. OpenAI는 설계·측정·검증의 반복 주기를 단축해 초기 설계에서 테이프아웃(tapeout)까지 9개월 만에 진행했다고 밝혔다. 이 칩은 인간뿐 아니라 AI에도 예측 가능한 프로그래밍 대상으로 설계됐다. 작업은 로컬 텐서로 기술되고, 통신은 명시적이며, 동기화는 예측 가능하다. Codex와 GPT-Astra를 활용해 팀은 최초 생산 계획에 없던 세 가지 오픈 웨이트 모델을 2개월 만에 이식했다. 또한 GPT-OSS에서 선별한 어텐션 및 mixture-of-experts 블록에서는 AI가 생성한 커널이 인간 전문가가 작성한 구현보다 1.5~1.8배 빠르게 실행된다. 다만 이 수치는 전체 모델이 아니라 선별된 블록에 관한 것이라는 점을 유념해야 한다. 일정은 여전히 신중하게 잡혀 있다. 생산 적격성 평가가 진행 중이고 소프트웨어는 더 성숙해야 하며, OpenAI 인프라 배포는 연말로 예정돼 있다. Gen 2는 개발이 상당히 진척됐고 Gen 3도 구체화되고 있다.
같은 날 Sarah Friar는 이 모든 것의 경제적 논리를 설명하는 글을 공개했다. 그는 Microsoft와 NVIDIA를 기반으로 하고 AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy, SoftBank가 보완하는 폭넓은 컴퓨팅 포트폴리오를 내세웠다. 그 근거는 기술적이면서 동시에 상업적이다. 공급업체 사이에서 실질적인 선택권을 유지하면 각 작업 부하를 최고의 가격 대비 성능을 제공하는 곳으로 배정하고 가격 규율도 유지할 수 있다. 이를 뒷받침하는 구체적인 수치도 제시됐다. Artificial Analysis Coding Agent Index에서 최대 추론을 사용하는 GPT-5.6 Sol은 다른 선도 모델보다 출력 토큰을 54% 적게 소비하면서 새로운 기록을 세웠다. 이 글은 마지막으로 제번스의 역설도 인정한다. 지능을 더 저렴하게 만든다고 소비가 감소하는 것이 아니라, 수익성 있는 활용 범위가 넓어진다는 것이다. 인프라 측면에서는 미국 조지아주의 Project Camellia가 폐쇄형 물 순환 시스템과 매년 독립적인 공개 감사를 받는 약속을 갖춘 프로젝트로 소개됐다. OpenAI는 훈련과 추론 모두에서 NVIDIA와 다른 파트너사의 가속기를 계속 폭넓게 배치할 것이라고 밝혔다.
🔗 Jalapeño — 첫 결과 · 풍부한 지능을 뒷받침하는 전체 스택
Perplexity Portable Computer: 모든 작업을 기기에서 실행, 벤치마크로 입증
8월 25일 — Perplexity가 Computer 에이전트의 모든 기능을 사용자 기기에서 실행하는 버전인 Portable Computer를 출시한다. 이번 변화는 외관보다 아키텍처에 집중되어 있다. 로컬에서 실행되는 것은 모델뿐만 아니라 오케스트레이터, 플래너, 도구 라우터, 스케줄러, 영구 작업 대기열, 로컬 검색 인덱스를 포함한 전체 오케스트레이션 체인이다.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇰🇷 오늘 @NVIDIA DGX Spark에서 Portable Computer를 출시합니다. Portable Computer는 Perplexity Computer의 완전한 로컬 버전으로, 오케스트레이터 LLM, 하위 에이전트 LLM, 에이전트 하네스를 포함한 전체 실행 환경이 사용자의 로컬 하드웨어에서 작동합니다. 클라우드 의존성은 전혀 없습니다. — @perplexity_ai의 X 게시물
이번 발표는 NVIDIA와 공동으로 이루어졌으며, 우선 Grace Blackwell GB10 플랫폼, 20코어 Arm CPU, NVIDIA GPU, 128GB 통합 메모리를 갖춘 DGX Spark를 대상으로 한다. 향후 RTX GPU가 탑재된 PC로도 확장될 예정이다. 사용자는 Qwen 3.8 27B 또는 Perplexity가 Qwen 모델을 후속 학습한 버전인 PPLX 27B 중 하나를 선택할 수 있으며, 30B 오픈 모델인 NVIDIA Nemotron 3.5 Lightning도 선택 목록에 추가될 예정이다. 로컬에서 처리되는 작업에는 크레딧이 전혀 소모되지 않는다. 최신 정보, 브라우저, 연결된 애플리케이션 또는 15개 이상의 frontier 모델 중 하나를 이용하기 위해 클라우드로 에스컬레이션할 수도 있지만, 사용자의 명시적인 승인이 필요하다. Google Drive, Gmail, Slack, GitHub 커넥터는 기기에서 작동하며, 음성 받아쓰기는 NVIDIA Nemotron 3.5 ASR Model을 통해 오디오가 기기 밖으로 나가지 않은 채 로컬에서 실행된다. 코드도 격리된 샌드박스(sandbox)에서 실행된다. Portable Computer는 DGX Spark를 보유한 Pro 및 Max 구독자에게만 제공되며, Linux를 먼저 지원하고 이후 Windows를 지원한다. 애플리케이션에서 클릭 한 번으로 설치할 수 있다.
같은 날 엔지니어링 팀은 이번 출시를 뒷받침하는 수치를 공개했다. 핵심 주장은 모델과 하네스(harness)를 함께 설계해야 한다는 것이다. 범용 하네스는 긴 컨텍스트를 처리하고 장기적인 계획을 수립할 수 있는 frontier 모델을 전제로 하지만, 로컬 모델은 이를 제대로 수행하기 어렵다.
| 측정된 벤치마크 | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench(53개 작업) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp(1 266개 작업) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100(멀티모달 문서) | 65,1 % | 13,9 % | 34,6 % | — |
BrowseComp에서 Computer는 Hermes보다 시간은 61%, 토큰은 16% 적게 사용하고, Pi보다 시간은 51%, 토큰은 70% 적게 사용한다. 이러한 차이를 설명하는 설계 선택은 네 가지다. 최소한의 시스템 프롬프트, 실행 경로에 따라 불러오거나 해제되는 skill로 모듈화된 기능, 컨텍스트를 대량으로 소비하는 정의를 가진 MCP 서버로 노출하는 대신 간결한 명령줄 도구로 변환한 자주 사용되는 커넥터(Gmail, GitHub, Outlook, Google Calendar), 그리고 항상 활성화되고 설정을 변경할 수 없는 샌드박스다. 샌드박스를 사용할 수 없으면 하네스는 격리되지 않은 실행으로 전환하는 대신 도구를 호출하기 전에 비활성화된다. Perplexity는 실무적으로 유용한 사실도 언급한다. Qwen 3.8 27B는 260K 토큰 컨텍스트 창을 표방하지만, 실제로는 100K를 넘으면 처리에 어려움을 겪기 시작한다.
| Terminal Bench 2.1(89개 작업) | 점수 | 실행당 API 비용 |
|---|---|---|
| Qwen 3.8 27B, 100% 로컬 | 59,6 % | 약 0 |
| Qwen 3.8 27B + Claude Opus 5 조언 | 73,0 % | 0,415 USD |
| Claude Opus 5 단독 | 82,4 % | 0,65 USD |
조언 모델(advisor)로 에스컬레이션하는 메커니즘은 보고서에서 가장 흥미로운 부분이다. frontier 모델과의 성능 격차 중 약 5분의 3을 대략 3분의 2 수준의 비용으로 만회하며, 최종 결정권은 사용자에게 남아 있다. 하네스는 호출할 때마다 관련 컨텍스트를 선별하고 개인정보 분류기를 적용한 뒤, 기기 밖으로 전송될 내용을 사용자에게 보여준다. 조언 모델은 텍스트만 반환하며 파일이나 도구에 직접 접근할 수 없다. 마지막으로 PPLX 27B의 후속 학습은 거부 미세 조정(rejection fine-tuning)과 Docker 컨테이너에서 실행되는 합성 환경 기반 강화 학습을 결합하며, 실제 사용자 데이터는 전혀 사용하지 않는다. 기술 보고서 공개와 평가 벤치마크의 오픈 소스화도 예고되었다.
🔗 로컬 하네스 벤치마크 · Portable Computer — Perplexity 게시물
Claude: 채팅과 Cowork가 하나의 메모리를 공유하고 파일별로 열람 가능
8월 25일 — Anthropic이 지금까지 공존해 온 두 메모리 사이의 경계를 없앤다. 이제 Claude가 채팅 대화에서 기억한 내용은 Claude Cowork에서도 그대로 사용할 수 있으며, 그 반대도 마찬가지다. 구체적으로 Cowork가 클라우드에서 작업을 실행하면 분기별 우선순위, 프로젝트 진행 상황, 상대방의 글쓰기 선호도 등 수개월 동안 축적된 컨텍스트를 바탕으로 시작한다. Anthropic은 일부러 일상적인 사례를 제시한다. 관리자에게 전달할 진행 상황을 요청할 때 그 관리자가 누구인지, 어떤 방식으로 정보를 받는 것을 선호하는지 다시 설명할 필요가 없다는 것이다.
두 번째 변화는 눈에 덜 띄지만 일상적인 동작 방식을 바꾼다. 이제 메모리는 대화가 끝난 후 생성된 요약을 통해 갱신되는 대신 대화 도중 계속 갱신된다. 마감일이 9월로 연기되었다고 언급하기만 해도 다음 대화에서 이를 반영한다. 특정 내용을 확실히 저장하려면 여전히 “이것을 기억해”라고 말할 수 있으며, 메모리는 언제든지 일시 중지하거나 초기화할 수 있다.
투명성 측면에서 Anthropic은 블랙박스 대신 사람이 읽을 수 있는 표현 방식을 선택했다. Claude가 기억하는 모든 내용은 설정의 메모리 메뉴에서 주제별로 분류된 짧은 파일 형태로 표시된다. 각 파일을 읽거나 수정하거나 삭제할 수 있다. 실용적인 이점은 즉각적이다. 한 파일에서 회사의 이전 이름을 수정하기만 하면 이후 모든 대화에서 올바른 이름을 사용한다.
민감한 주제의 처리는 제품 설계 측면에서 가장 흥미로운 부분이다. 기본적으로 Claude는 건강, 출신, 민족, 종교적 신념, 정치적 견해 또는 성 정체성과 관련된 내용을 기억하지 않는다. 다만 Anthropic은 그 경계가 개인마다 다르다는 점을 인정하고 이러한 주제를 포함할 수 있는 선택적 설정을 제공한다. 이를 활성화하면 레시피를 제안할 때 Claude가 글루텐 불내증을 기억할 수 있다. 이 설정은 소급 적용되지 않으며 언제든지 비활성화할 수 있다. 설정과 관계없이 제외되는 범주도 있다. 식별 번호, 범죄 전력, 이민 신분을 비롯해 허용 가능한 사용 정책을 위반하는 모든 내용이다. Claude는 이러한 유형의 정보를 저장할 수 없을 때 이를 명시적으로 알린다. 이는 조용히 필터링하는 대신 거부 사실을 드러내는 설계 선택이다.
| 메모리 측면 | 설명된 동작 |
|---|---|
| 범위 | 채팅과 Claude Cowork가 공유하는 단일 메모리 |
| 갱신 시점 | 이전에는 종료 후 요약을 통해 갱신했지만 이제는 대화 도중 갱신 |
| 저장 형식 | 주제별로 분류되어 개별적으로 읽고 수정할 수 있는 짧은 파일 |
| 민감한 주제 | 기본적으로 기억하지 않으며 설정으로 활성화할 수 있지만 소급 적용되지 않음 |
| 영구 제외 항목 | 식별 번호, 범죄 전력, 이민 신분 |
| Free, Pro 및 Max 요금제 | 웹, 데스크톱, 모바일에서 메모리가 기본적으로 활성화됨 |
| Team 및 Enterprise 요금제 | 관리자가 개방하며 사용자가 활성화하기 전까지는 비활성화됨 |
🔗 어디서나 작동하는 Claude 메모리 · @claudeai 발표
IBM, 최초의 추론 모델군 Granite 4.2와 두 가지 470M ASR 모델 공개
8월 25일 — IBM이 명시적으로 추론을 위해 설계한 최초의 dense decoder-only 언어 모델군으로 소개되는 Granite 4.2를 공개한다. 이전 세대가 효율성과 전통적인 기업 업무에 초점을 맞췄다면, 이번 버전은 추론을 중심에 두고 이를 조정할 수 있도록 했다. 각 모델은 thinking, non-thinking, low-effort의 세 가지 모드를 제공하며, 애플리케이션이 허용 가능한 지연 시간과 토큰 예산에 따라 모드를 선택한다. 세 가지 크기(3B, 8B, 30B)는 동일한 아키텍처와 파이프라인을 공유하므로 통합 측면에서 모델 간 전환이 원활하다.
아키텍처는 전통적인 구성을 유지한다. 8개 KV 헤드에 40개 헤드를 사용하는 GQA attention, 131 072개 컨텍스트 토큰을 지원하기 위해 θ 값 1천만을 적용한 RoPE, SwiGLU MLP, RMSNorm 정규화로 구성되며, CoreWeave가 호스팅하는 NVIDIA GB200 NVL72 클러스터에서 bfloat16으로 학습되었다. 사전 학습은 약 15조 개의 토큰을 사용해 처음부터 시작되며 다섯 단계로 진행된다. Granite 4.2를 진정으로 차별화하는 요소는 후속 학습이다. 단일 패스 대신 특화된 여러 단계로 이어지는 강화 학습 파이프라인을 사용하며, 절단된 중요도 샘플링을 적용한 비동기식 GRPO를 통해 루프의 생성 부분과 학습 부분이 서로를 차단하지 않도록 한다. 커리큘럼은 검증 가능한 보상을 사용하는 세 차례의 RLVR, 명령어 준수와 코드에 초점을 맞춘 강화 단계, 128K 컨텍스트에서 수행되는 두 단계의 software engineering, terminal 단계, research 단계, RLHF 정렬 순으로 진행된다. 에이전트형 강화 학습 블록은 8B와 30B 모델에만 적용되며, 이 때문에 에이전트형 코딩 성능에서 3B와 더 큰 두 모델 사이에 격차가 발생한다.
| IBM이 공개한 벤치마크 | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
이번 공개는 bfloat16 가중치에만 그치지 않는다. vLLM을 위한 네 가지 양자화 버전도 함께 제공된다. 보정 없이 채널별로 동적 적용되는 FP8, 그리고 2 000개의 SFT 샘플로 보정된 GPTQ 기반 NVFP4와 MXFP4가 포함된다. 또한 llama.cpp용으로 Q2_K부터 Q8_0까지 14가지 GGUF 형식이 제공된다. 프랑스어를 포함한 12개 언어를 지원하며, 출시 첫날부터 OpenCode, Pi, OpenHands 등 세 가지 에이전트형 코딩 하네스가 문서화되어 있다. 데이터 품질과 관련해서 IBM은 GPT-OSS-120B와 Gemma 4를 심사 모델로 사용해 SFT 샘플을 평가한 후 SHA-256 해싱으로 로컬 및 전역 중복 제거를 수행하는 과정을 상세히 설명한다.
같은 날 IBM은 Granite Speech 5.0 Turbo CTC도 공개한다. 영어 음성 인식용 4억 7천만 매개변수 모델 두 가지로, 학습 데이터와 라이선스만 다르다. 표준 버전은 Apache 2.0이고 추가 데이터로 학습된 버전은 CC-BY-NC-SA-4.0이다. 아키텍처 변화도 주목할 만하다. 이전 Granite Speech는 음향 인코더, 프로젝터, LLM을 결합했지만 이번 모델은 encoder-only 구조다. 스택은 16개의 Conformer 블록을 쌓고 여덟 번째 블록의 출력에 자기 조건화를 적용하며, 이차적으로 증가하는 연산량을 피하기 위해 dot-product attention을 블록 단위 attention(chunkwise)으로 대체하고 CTC 손실을 직접 최적화한다. 진정한 신기술은 토큰 처리율에 있다. 서브샘플링 연산을 통해 log-Mel 스펙트로그램 출력의 초당 100프레임 흐름을 초당 12.5프레임으로 줄이며, 이것이 이름에 “Turbo”가 붙은 이유다. 결과는 OpenASR Leaderboard와 원거리 음성 인식용 FFASR Leaderboard에 보고되며, 개별 점수 대신 속도와 정확도의 Pareto 그래프로 제시된다. WebGPU를 통해 브라우저에서 실행되는 연속 음성 인식 데모도 제공되지만 Chrome과 Edge에서만 사용할 수 있다.
🔗 Granite 4.2 — 기술 개요 · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, National Hurricane Center가 실시간으로 사용한 최초의 AI 모델
8월 25일 — Google AI가 Google DeepMind와 Google Research에서 개발한 열대성 저기압 예측 모델 WeatherNext Cyclones를 자세히 소개했다. 이번 발표에서 주목할 점은 단순한 성능보다 기상 AI가 연구실을 벗어나 실제 운영 단계로 전환됐다는 사실이다.
이 모델이 해결하려는 문제는 구조적이다. 지금까지 사이클론을 추적하려면 절충이 필요했다. 슈퍼컴퓨터에서 실행되는 물리 모델은 지구 전체를 휩쓰는 대규모 대기 구조를 잘 포착하지만, 폭풍의 위력을 결정하는 국지적이고 강렬한 물리 현상을 이해하려면 완전히 다른 지역 모델로 전환해야 했다. WeatherNext Cyclones는 경로, 강도, 크기를 한 번에 예측함으로써 이러한 전환을 없앴다.
기존 시스템보다 하루 더 일찍 예측할 수 있다는 것이 발표된 성과다. Google은 이를 이해하기 쉽게 비교했다. 이제 3일 전 예측이 과거 2일 전 예측과 같은 정확도에 도달했으며, 역사적으로 이러한 진전을 이루려면 10년간의 방법론적 발전이 필요했다. 두 번째 기여는 확률론적 접근이다. 모델은 폭풍 하나당 최대 1,000개의 시뮬레이션을 생성할 만큼 빨라, 하나의 ‘가장 가능성 높은’ 경로 대신 다양한 시나리오를 제시한다. 이에 따라 24시간 동안 최대 지속풍속이 최소 30노트 증가하는 것으로 정의되는 급격한 강도 증가를 더 명확하게 파악할 수 있다. 올해는 WeatherLab을 통해 폭풍 하나당 1,000개의 확률 예측이 예보관들에게 제공된다.
가장 중요한 요소는 실제 배치다. 2025년 허리케인 시즌 동안 WeatherNext Cyclones는 미국 National Hurricane Center에서 시험 운영됐으며, 이 기관이 실시간 운영에 AI 모델을 사용한 것은 이번이 처음이다. 기상학자들은 이를 활용해 허리케인 Melissa가 5등급으로 자메이카에 상륙할 것을 예측했고, 현지 당국은 추가 준비 시간을 확보할 수 있었다. 관련 논문은 Nature에 게재됐으며, Google은 코드와 모델 가중치를 GitHub에 오픈 소스로 공개한다고 발표했다.
| 모델 측면 | WeatherNext Cyclones의 기여 |
|---|---|
| 예측 항목 | 경로, 강도, 크기를 한 번에 예측 |
| 예측 시간 향상 | 하루; 3일 전 예측 = 과거 2일 전 예측의 정확도 |
| 폭풍당 시뮬레이션 | 최대 1,000 |
| 운영 배치 | 미국 National Hurricane Center, 2025년 허리케인 시즌 |
| 문서화된 활용 사례 | 허리케인 Melissa의 자메이카 5등급 상륙 |
| 강도 증가 기준 | 24시간 동안 최대 지속풍속 30노트 이상 증가 |
| 제공 방식 | WeatherLab; 코드와 가중치를 GitHub에 오픈 소스로 공개 |
🔗 @GoogleAI 발표 · Google DeepMind 게시물
Stability AI, EA·Sony Music·Universal·Warner와 함께 7,600만 달러 규모 시리즈 B 마감
8월 25일 — Stability AI가 시리즈 B 투자 라운드 마감을 발표했다. 신규 자금은 7,600만 달러이며, Prem Akkaraju가 2024년 6월 회사를 맡은 이후 두 차례의 지분 투자와 전환사채를 포함한 총조달액은 2억 3,200만 달러가 됐다. 업계 규모를 고려하면 금액은 크지 않지만, 이번 투자 라운드의 핵심은 투자자 구성이다.
엔터테인먼트 업계의 거물 네 곳이 주주로 합류했다. 비디오 게임 분야에서는 Electronic Arts가, 음악 분야에서는 Sony Music Group, Universal Music Group, Warner Music Group이 참여했다. 이제 3대 음반사가 모두 같은 연구소의 주주가 됐다. AMD Ventures와 Pacific Alliance Ventures도 합류했다. 이 투자자들의 참여는 갑작스러운 일이 아니다. EA, Universal, Warner는 2025년 가을부터 이미 Stability AI의 전략적 파트너였다. 따라서 이번 투자 라운드는 기존 상업적 제휴를 지분 참여로 전환한 셈이다.
또 다른 신호는 재무적 투자자들의 지속적인 지지다. Coatue, Greycroft, Kadmos Capital, Sean Parker, Eric Schmidt는 새 경영진 체제에서 두 번째 라운드 연속으로 재투자했다. Stability AI가 2023년과 2024년에 겪은 혼란기를 고려하면 이는 신뢰를 재확인한 것으로 볼 수 있다. Coatue 공동 창업자 Thomas Laffont는 James Cameron, Sean Parker, Dana Settle, Prem Akkaraju가 이미 참여하고 있는 이사회에 합류한다.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇰🇷 비할 데 없는 이 투자자 그룹은 모든 프로듀서, 음악가, 이야기꾼에게 역량을 부여하는 생성형 AI라는 우리의 비전을 확인해 줍니다. Stability는 창작자를 위한 도구를 만드는 창작자들로 이루어져 있다는 점에서 AI 분야에서 독보적입니다. — Stability AI CEO Prem Akkaraju, 8월 25일 보도자료
회사가 내세우는 전략은 틈새 연구소를 지향하는 것이다. 범용 모델이 아니라 창작 전문가를 위한 도구를 만들며, 권리자들과 대립하는 대신 협력해 이를 개발한다. 이는 전부 정식 라이선스를 받은 데이터로 학습한 개방형 가중치 모델 제품군 Stable Audio 3.0의 방향과 정확히 일치한다. 이 제품군은 8월 18일 오디오 워크스테이션용 플러그인을 통해 확장됐다. 조달한 자금은 후속 제품, 응용 연구, 전문 서비스 부문에 투입될 예정이다.
기업용 ChatGPT: Admin 플러그인, 다중 브라우저 확장 프로그램, 100달러 Premium 좌석
8월 25일 — OpenAI의 세 가지 발표는 모두 ChatGPT와 Codex를 대규모로 배포하는 조직을 겨냥한다.
가장 실질적인 발표는 ChatGPT Work와 Codex용 Admin 플러그인이다. 지금까지 분석 대시보드, 설정 화면, 보고서를 오가며 처리해야 했던 업무를 하나의 대화 안에 모아준다. 적용 범위에는 일상적인 업무가 포함된다. 도입 현황과 크레딧 소비량 파악, 한도에 근접한 구성원이나 그룹 식별, 입사자와 퇴사자 관리, 실제 적용되는 권한 검토와 접근 문제 진단, 사용 한도 조정, 실제 사용량을 바탕으로 한 지출 요청 판단 등이다. 가장 흥미로운 부분은 코드를 작성하지 않는 자동화다. 대기 중인 사용 요청을 Slack이나 Microsoft Teams로 전달해 승인 담당자가 이미 사용하는 도구에서 처리하게 할 수 있으며, 기능 접근 요청이 미리 정의된 기준을 충족하면 자동으로 승인하고 예외만 사람에게 넘길 수 있다. 보안 측면에서 중요한 점은 플러그인이 사용자의 기존 역할과 권한 내에서 작동하며 접근 범위를 확장하지 않는다는 것이다. 각 명령은 지원되는 읽기 또는 쓰기 작업으로 매핑되고 구조화된 결과를 반환한다. OpenAI는 자사의 활용 사례도 소개했다. Slack의 ChatGPT Work 에이전트가 내부 IT 요청을 처리하며, 배포된 워크플로가 티켓 물량의 약 45%를 해결해 지원 요청이 거의 두 배로 늘었는데도 적체를 없앴다.
두 번째 발표는 ChatGPT 브라우저 확장 프로그램이 Chrome의 범위를 넘어 Microsoft Edge, Brave, Opera, Vivaldi를 지원한다는 내용이다. 개인정보 보호를 위해 대체 브라우저를 선택했거나 기업 정책상 이를 사용해야 하는 사람들에게 중요한 변화다. 두 가지 활용법이 강조됐다. 첫째, ChatGPT Desktop에서 @ tab 멘션을 사용해 열린 탭의 맥락을 작업으로 가져오면 Codex가 이미 표시된 문서나 티켓을 바탕으로 작업할 수 있다. 둘째, 에이전트가 브라우저를 제어해 구독 해지 같은 구체적인 웹 작업을 수행하게 할 수 있다.
세 번째 발표는 더 간략하다. 100달러 Premium 좌석이 ChatGPT Business 상품에 추가됐다. 팀 규모에 따라 유연하게 확장할 수 있는 요금제로 소개됐으며, 소기업과 스타트업을 겨냥한다. 발표는 상세한 블로그 게시물 없이 X에서 이루어졌고, 해당 좌석의 정확한 구성은 메시지에 명시되지 않았다.
🔗 Admin 플러그인 · 다중 브라우저 확장 프로그램 · ChatGPT Business Premium 좌석
NVIDIA: RTX Spark를 위한 Gamescom과 MiniMax H3 지연 시간을 27분의 1로 줄인 SANA
8월 25일 — NVIDIA는 이번 주 쾰른에서 열리는 Gamescom을 계기로 올가을 출시 예정인 Windows PC 플랫폼 RTX Spark의 카탈로그를 확충한다. Electronic Arts, Embark Studios, Ubisoft가 지난 5월 COMPUTEX에서 이미 참여를 약속한 KRAFTON, NetEase, Riot Games, XBOX에 합류한다. 공개된 타이틀은 다양한 기술적 요구 사항을 포괄한다. EA에서는 EA SPORTS F1 25와 Apex Legends, Ubisoft에서는 Anno 117: Pax Romana, Embark Studios에서는 ARC Raiders와 THE FINALS가 포함된다.
가장 구체적인 내용은 치트 방지 시스템과 관련돼 있다. 게임을 실행하는 것만으로는 충분하지 않다. 주요 온라인 게임은 플랫폼마다 이식해야 하는 치트 방지 시스템에 의존하며, 그렇지 않으면 멀티플레이를 이용할 수 없다. NVIDIA는 EA Javelin Anticheat를 RTX Spark에서 네이티브로 지원하기 위해 EA와 협력 중이라고 발표했다. 이는 새로운 PC 플랫폼의 실제 도입 여부를 좌우하는 인프라의 세부 사항이다. 렌더링 측면에서는 DLSS 4.5 Ray Reconstruction을 즉시 이용할 수 있다. 기존 노이즈 제거기를 슈퍼컴퓨터에서 학습한 2세대 transformer 네트워크로 대체한 기술이다. Path tracing은 CONTROL Resonant와 007 First Light에 도입되며, Gears of War: E-Day에는 RTX Mega Geometry가 통합된다. NVIDIA ACE 기술은 2027년 초 Aniimo에 적용될 예정이다.
같은 기업이 보여준 또 다른 면은 8월 24일 공개된 더욱 기술적인 내용이다. MiniMax는 NVIDIA SANA 팀이 자사의 H3 비디오 모델에 Sol Engine을 적용해 얻은 결과를 공유했다. 단일 GB200에서 768p 비디오 10초 분량을 생성하는 시간이 414초에서 14.93초로 줄어 27.7배 빨라졌다. 이 방법은 커널 최적화가 아니라 생성을 두 단계로 나누는 방식에 기반한다. 먼저 H3가 4단계로 저해상도 초안을 생성하고, 이어 LTX가 Sol-Attn을 사용해 3단계로 목표 해상도까지 정교화한다. 총 7단계다. 두 번째 개선 요소로는 비용이 많이 드는 VAE 디코딩을 경량 디코더인 TAEH3와 TAEHV로 대체하면서 정교화 단계에 사용할 latent를 안정적으로 유지했다.
| MiniMax H3 측정 항목 | 측정값 |
|---|---|
| 측정 작업 | 단일 GB200에서 768p 비디오 10초 |
| 이전 지연 시간 | 414초 |
| 이후 지연 시간 | 14.93초 |
| 가속 배율 | 27.7x |
| 생성 단계 | 4단계(H3 저해상도 초안) + 3단계(LTX) |
| 대체된 디코더 | VAE 디코딩을 TAEH3와 TAEHV로 대체 |
| 노드당 예상 처리량 | 월 378,000개 비디오, GPU 마진 97% 이상 |
예상 처리량은 실제 운영 측정값이 아니라 MiniMax의 추정치이므로 그 점을 고려해 해석해야 한다. 하지만 방향은 분명하다. 10초 분량의 비디오를 15초 만에 생성하게 되면서 고충실도 비디오 생성은 비동기 일괄 렌더링을 벗어나 준실시간 인프라로 이동하고 있다.
🔗 Gamescom의 NVIDIA · H3의 SANA와 Sol Engine
중국 개방형 모델이 연구의 기준으로 부상하고 Qwen3.8-27B가 Code Arena 상위 10위에 진입
8월 25일 — Qwen은 같은 날 아침 두 가지 결과를 공유했으며, 두 번째 결과가 첫 번째 결과의 의미를 보여준다.
첫 번째는 순위다. 웹 인터페이스 생성 능력을 평가하는 Code Arena: WebDev 순위에서 Qwen3.8-27B가 1,595점으로 종합 9위에 올랐다. 같은 규모 범주에서 상위 10위에 든 유일한 모델이며, 훨씬 큰 Qwen3.8-Max와의 순위 차이는 불과 여섯 계단이다. Arena는 이 모델이 순위의 Pareto 경계를 새롭게 그렸다고 강조하며 이해하기 쉬운 비교 기준도 제시했다. 규모가 비슷하지만 4월에 출시된 Gemma 4-31B는 80위다.
| 평가 모델 | Code Arena: WebDev 순위 | 획득 점수 | 순위 관련 설명 |
|---|---|---|---|
| GLM-5.3 (Max) | 종합 8위 | 1597 | 8월 20일 기준, 개방형 모델 중 2위 |
| Qwen3.8-27B | 종합 9위 | 1595 | 같은 규모에서 상위 10위에 든 유일한 모델 |
| Qwen3.8-Max | 27B보다 여섯 계단 앞섬 | 해당 없음 | 같은 제품군의 훨씬 큰 모델 |
| Gemma 4-31B | 종합 80위 | 해당 없음 | 2026년 4월 출시 |
두 번째 결과는 사용 현황을 측정한 것이다. Ai2의 Olmo 프로젝트를 공동으로 이끈 Nathan Lambert는 ChatGPT 출시 이후 공개된 AI 및 머신러닝 분야 arXiv 논문 500,000편을 Codex로 분석해 연구에 실제로 사용된 개방형 모델을 파악했다. 변화는 두 수치로 요약된다. 2024년에는 논문의 약 30%가 미국 개방형 모델을 언급한 반면 중국 모델을 언급한 비율은 10%였다. 현재는 약 40%가 중국 개방형 LLM을 인용하고 미국 모델을 인용하는 비율은 25~30%에 불과하다.
| 모델 제품군 | LLM을 인용한 논문 비율 |
|---|---|
| OpenAI(폐쇄형 모델) | 약 37% |
| Qwen | 약 33% |
| Gemini, Claude | 10~15% |
| Gemma, Mistral | 5~10% |
| Olmo | 약 1% |
세부적으로 보면 Qwen은 종류와 관계없이 LLM을 인용한 논문의 3분의 1에서 언급됐다. Llama는 Llama 4가 출시된 바로 그 시점인 2025년 4월경 30%로 정점을 찍은 뒤 계속 하락하고 있다. Lambert 자신도 중요한 한계를 지적한다. 연구에는 시간이 걸리므로 논문은 모델 출시보다 늦게 나온다. 따라서 이 수치는 현재의 선호보다 진행 중인 연구의 상태를 보여준다. 개방형과 폐쇄형의 대결과는 별개로 또 하나의 장기 추세도 나타난다. LLM을 언급한 AI 논문의 비율은 2023년 1월 10.43%에서 2026년 50% 이상으로 증가했다.
🔗 Code Arena의 Qwen3.8-27B · Qwen이 공유한 arXiv 분석 · @natolambert 분석
Claude Code가 2.1.245로 업데이트되고, 웹에서 Claude의 렌더링이 4배 더 부드러워지다
해당 기간에 Claude Code 두 버전이 출시되었으며, 그 내용은 조직 배포를 분명히 겨냥하고 있다. CHANGELOG에는 날짜가 없지만 Git 기록을 보면 2.1.243은 8월 24일 23:40 UTC 커밋에, 2.1.245는 8월 25일 05:13 UTC 커밋에 등장한다.
| 추가된 설정 | 해당 버전 | 실용적 이점 |
|---|---|---|
modelPricing | 2.1.243 | /cost, 상태 표시줄 및 텔레메트리에 계약 요금 반영 |
modelPicker | 2.1.243 | /model용으로 정렬되고 레이블이 지정된 모델 목록 |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | 대화에는 1시간 prompt cache, subagent에는 5분 적용 |
/usage의 Loops 분류 | 2.1.243 | 통제에서 벗어나는 /loop 작업 식별 |
| Console을 통한 키 없는 연결 | 2.1.243 | API 키를 금지하는 조직 |
| glibc 2.44 수정 | 2.1.245 | Arch Linux, CachyOS 및 Fedora Rawhide에서 시작 시 발생하는 충돌 |
가장 구조적인 설정은 modelPricing이다. 지금까지 표시 비용은 공개 요금을 기준으로 계산했지만, 이제 조직은 모델별 계약 요금과 할인 계수를 입력할 수 있어 수치를 내부 비용 청구에 바로 활용할 수 있다. promptCacheTtl과 subagentPromptCacheTtl의 조합은 API 키 사용자에게 구체적인 경제적 절충안을 제공한다. context가 안정적으로 유지되는 기본 대화에는 1시간 cache를 유지하면서, context의 변동성이 더 큰 subagent에는 5분을 적용한다. 수정 사항으로는 비대화형 모드의 원격 MCP 서버가 연결 중단 후 더 이상 멈춰 있지 않고, /resume이 더 이상 가장 최근 50개 session으로 제한되지 않으며, 10분 넘게 응답이 없는 session은 이제 재시도와 명시적 오류가 발생하기 전 약 3분 후 만료된다.
또한 8월 24일, Anthropic은 Claude 웹 및 데스크톱에서 생성 중인 응답을 표시하는 engine을 재작성했다고 발표했다. 원리는 인터페이스 렌더링에서 흔히 쓰이는 방식으로, 새 fragment가 들어올 때마다 전체 응답을 다시 그리는 대신 아직 변경 중인 부분만 갱신한다. 긴 응답에서는 근본적인 차이가 생긴다. 이미 표시된 텍스트 길이에 따라 렌더링 비용이 증가하지 않게 된다. 발표된 개선 수치는 일관성이 있다. 약 4배 더 부드러운 동작, 저사양 노트북에서 9배 적은 멈춤, 최악의 인터페이스 정지 시간 4.5배 단축, 그리고 120Hz MacBook에서 처음부터 끝까지 초당 120 frame 유지다. 흥미로운 점은 대상 사용자다. 사양이 낮은 환경에서 가장 큰 이점을 얻는다.
🔗 Claude Code CHANGELOG · 4배 더 부드러운 렌더링, @ClaudeDevs
코드 agent의 산업화: Warp가 factory 형식을 공개하고, Rohlik은 코드의 90%를 agent로 작성하다
8월 24일 늦은 시간 — Warp는 8월 18일 발표한 cloud agent 플랫폼 Warp Factories의 내부 작동 방식을 공개했다. 채택한 구성 형식과 조기 접근 프로그램이 그 내용이다. 출발점은 명확하다. Warp는 품질과 비용을 이유로 자체 agent를 로컬 machine 밖으로 옮기고 있으며, 환경과 harness, 보안 권한을 버전 관리되는 코드로 기술할 필요가 있었다.
| 구성 요소 | 채택된 값 |
|---|---|
| 정의 파일 | factory.yaml, schemaVersion: v1alpha1 |
| 주요 키 | name, repositories (owner / name), agentDefaults.model |
| agent 정의 | agentType(FOREMAN, REVIEW…)와 model를 포함하는 agents/<nom>/agent.md |
| trigger | automations/<nom>/automation.md: agent, triggers(provider, event) |
| 사용 가능한 interface | CLI(warp agent run-cloud), REST API, TypeScript SDK, MCP 서버 |
| 조기 접근 | 자격을 갖춘 고객에게 최대 10,000 USD 상당의 사용량 무료 제공 |
이러한 분리는 주목할 만하다. agent가 하나의 YAML에 기술되는 것이 아니라 전용 Markdown 파일에 각각 기술되므로, agent 정의 자체가 읽고 diff를 비교할 수 있는 문서가 된다. Warp는 이 방식을 자체적으로 적용한다. « wilson »이라는 내부 factory는 warp-server이나 warp-terraform 같은 repository를 포괄하고, secret과 MCP 서버를 선언하며, agent를 역할별(code-review, foreman, implementation, spec, triage)로 34줄 안에 정리한다. 접근 신청 페이지에 제시된 수치는 외부에서 검증할 수 없는 마케팅 주장이다. 하루 200,000회의 agent 실행, 수정 없이 merge되는 pull request 30% 이상, pull request당 비용 20% 절감이다.
8월 25일, Cognition은 이전 사례보다 훨씬 자세히 문서화된 사례 연구를 공개했다. Rohlik Group은 체코에서 시작해 5개국에서 사업을 운영하는 수익성 있는 온라인 식료품 유통업체로, 지난해 매출은 13억 달러가 넘는다. 17,000개 제품으로 구성된 일주일치 장보기를 1시간 이내 또는 15분 단위 시간대에 배송한다. 이 글의 핵심 수치는 현재 코드의 약 90%가 agent에 의해 생성되며, engineering 조직은 스스로를 « agent-mostly »라고 설명한다는 것이다.
이는 도구 하나를 연결해 얻은 결과가 아니다. Rohlik은 1년 전 시작했으며, Devin을 처음 사용한 경험은 bug가 많았다고 밝혔다. 상황을 바꾼 것은 고객 측에서 구축한 기반이었다. 50개가 넘는 내부 및 외부 MCP integration, 모든 새 도구를 첫날부터 agent가 이용할 수 있어야 한다는 원칙, Snowflake data warehouse 위의 semantic layer, 그리고 새 동료에게 전달할 만한 context를 agent에 제공하는 knowledge base다. 작업은 bug에 관한 Slack 대화든 pull request까지 이어지는 Linear 명세 문서든, 발생한 바로 그곳에서 Devin으로 전달된다. 주장된 결과인 11월 이후 두 배가 된 engineering 처리량, 업계에서 2~3년이 걸리는 AutoStore robotics integration을 8개월 만에 제공한 사례, 한 달에서 하루로 줄어든 prototyping 기간은 여전히 공급업체가 게시한 고객 사례 페이지의 주장이다. 더 인상적인 효과는 다른 데 있다. 최고의 engineer들이 이제 시간의 80%를 code review에 쓰고 있으며, Rohlik에서 Devin 사용량의 약 30%는 현업 사용자의 data analysis다.
🔗 factory.yaml 형식, @warpdotdev · Rohlik 사례 연구, @cognition · Devin 고객 페이지
GitHub: agent workflow 실습 4개와 Customize 탭의 정식 출시
8월 25일 — GitHub는 학습 플랫폼 GitHub Skills에 새로운 실습 4개를 공개했다. 방향은 명확하다. 올해의 agent 관련 신기능을 문서로 설명하는 대신, pull request를 통해 단계별로 제공되는 지침에 따라 demo repository에서 직접 연습하도록 한다.
| 공개된 실습 | 실습 내용 |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Copilot CLI의 custom agent: 계획, 설계, 구축, 검증, 인계 |
| Agentic Workflows that Read the Room | gh aw extension, Markdown 기반 agent workflow, pull request를 통한 변경 사항 제출 |
| Idea to Merge with the Copilot App | session에서 merge된 pull request까지 전 과정을 GitHub Copilot app에서 수행 |
| Ship with Quality | 자동화된 품질 signal, test coverage, pull request 필수 검사 |
네 가지 중 가장 주목할 만한 것은 첫 번째다. 지금까지 산문 문서로만 설명되던 CLI의 multi-agent orchestration을 GitHub가 안내형 과정으로 제공하는 것은 이번이 처음이다. 두 번째는 gh aw extension을 도입하며, 보안 측면에서 중요한 점이 있다. workflow가 제안한 수정 사항은 직접 적용되지 않고 pull request를 거치므로 사람의 review 지점을 유지한다.
같은 날 GitHub Copilot app의 Customize 탭이 정식 출시되었다. 이 기능은 최근 몇 달 동안 각각 도입된 네 가지 extension 방식인 MCP 서버, plugin, skill, canvas를 하나의 화면에 모은다. Featured view는 무엇을 하고 싶은지는 알지만 어떤 종류의 extension이 적합한지는 모르는 사용자를 위해 각 범주에서 편집자가 고른 항목을 보여준다. MCP 서버에는 인기도에 따른 추천 옵션과 범주별 탐색 경로를 포함한 별도 navigation이 제공된다. changelog는 canvas의 효용을 구체적인 사례로 설명한다. Azure DevOps canvas를 사용해 issue를 분류하고 backlog의 우선순위를 정하며 후속 작업을 할당한 뒤, Copilot에 작업을 맡겨 조사하거나 구현하거나 review를 준비하도록 하는 것이다.
🔗 GitHub Skills 실습 4개 · Customize 탭 정식 출시
개발자를 위한 Google 도구: Gemini CLI 0.57.0과 Antigravity 2.10.0
8월 25일 — Google은 Gemini CLI 0.57.0 안정 버전을 공개했으며, 그보다 15분 앞서 preview 0.58.0을 출시했다. 이 버전의 내용은 새로운 기능보다 Google이 도구를 유지 관리하는 방식을 더 잘 보여준다. changelog 24개 항목 중 13개에 [SSR Agent] Issue Fix 접두사가 붙어 있으며, 흔히 오래된 19239부터 28518까지의 issue 번호를 참조한다. 이 수정 사항들은 backlog에 쌓인 불편을 처리한다. 무한정 멈추던 terminal interface에 timeout을 추가하고, 개인 계정에 잘못 표시되던 admin 오류 메시지를 고치며, 자동 완성 제안 뒤의 공백 누락을 해결하고, 외부 editor 종료 후 갱신되지 않던 terminal 렌더링을 수정했다. 다시 말해 Google은 agent를 자체 technical debt에 투입했고, 그 결과가 곧바로 안정 버전에 반영됐다.
| 공개된 버전 | 날짜 및 시간(UTC) | 출시 channel | 주요 내용 |
|---|---|---|---|
| v0.57.0 | 8월 25일, 18:37:14 | Stable | [SSR Agent] 수정 13건, eval 검증, context 기반 retry |
| v0.58.0-preview.0 | 8월 25일, 18:22:01 | Preview | macOS Seatbelt profile의 Docker isolation, safety verifier |
기능 면에서는 eval 검증 명령과 실패 요약을 포함하는 tool call formatter 등 평가에 중점을 뒀다. 안정성도 개선됐다. 용량 오류가 발생하면 context를 고려한 조용한 retry가 실행되며, multi-turn 요청을 취소하면 부분 상태 대신 전체 rollback이 수행된다. release note를 찾는 사람이라면 repository의 docs/changelogs/index.md 파일이 8월 6일 v0.54.0 이후 갱신되지 않았다는 점에 유의해야 한다.
2.9.1과 Remote Control 출시 4일 후인 8월 24일, Google Antigravity가 2.10.0으로 업데이트되며 도구 밖으로 나가게 만들던 두 가지 공백을 메웠다. 통합 terminal과 native Git version control이 모두 sidebar에 직접 배치됐다. 이러한 통합은 제품의 방향성과 일치한다. Antigravity는 코드를 한 줄씩 편집하기보다 agent를 지휘하는 환경을 표방하지만, 창을 바꾸지 않고 명령을 실행하고 diff를 검사할 수 있어야 한다. 이번 버전의 나머지 변경 사항은 agent에 제출할 수 있는 대상과 agent의 작업을 확인할 수 있는 범위를 넓힌다. audio 파일이 허용되는 attachment에 추가되고, 이미지에 대한 interactive comment를 통해 시각 자료에 주석을 달아 agent를 안내할 수 있으며, MCP 도구 실행의 강화된 preview를 통해 도구 서버가 실제로 수행한 작업을 파악할 수 있다. Google에 따르면 이번 버전에는 13개의 개선 사항과 8개의 수정 사항이 포함됐으며 점진적으로 배포된다.
🔗 Gemini CLI v0.57.0 · Antigravity changelog
Anthropic, 웰빙에 관한 독립 평가에 500만 달러 지원
8월 25일 — Anthropic은 AI가 사용자 웰빙에 미치는 영향에 관한 독립 연구를 지원하기 위해 500만 달러 규모의 연구 지원 프로그램을 시작한다. 선정된 연구자는 직접 자금 지원, 모델 접근 권한 및 기술 지원을 받지만 완전히 독립적으로 연구한다. 평가는 open source로 공개되며 업계 전체에서 재사용할 수 있다. 신청은 9월 21일까지 가능하며, 전체 제안서 제출 대상으로 선정된 지원자는 10월 5일 이전에 통보받는다.
기술적 설명은 이 분야가 일반적인 평가 방법으로 다루기 어려운 이유를 보여준다. 대부분의 모델 행동은 단일 응답만 검토해도 정확하고 적절한지 판단할 수 있다. 그러나 웰빙에는 context가 필요하다. 고통에 처한 사용자가 처음부터 자해 사고를 언급하지 않을 수도 있으며, 한 사례에서는 합리적인 균형 잡힌 식사 조언이 섭식 장애 병력을 보인 사람에게는 잠재적으로 위험해질 수 있다. Safeguards 팀은 동시에 다섯 가지 엄격성 기준을 공개했다. 측정 대상을 명확히 밝히고, 설계에 임상의와 해당 분야 전문가를 참여시키며, 예방 조치와 피해를 모두 시험해야 한다. 즉, 과도한 동조의 위험과 과도한 거절의 위험을 함께 평가해야 한다. 또한 multi-turn scenario를 통해 실제 사용을 반영하고, 실제 전문가를 기준으로 자동 평가기를 검증해야 한다. 이 가운데 세 번째 기준인 과잉 순응과 과잉 거절 사이의 대칭성이 단순한 guardrail 강화와 이 접근 방식을 구분한다.
Quantization-Aware Healing: 원본 완전 정밀도 모델을 능가하는 4비트 모델
8월 25일 — 대규모 모델을 배포 가능한 형태로 만드는 표준 파이프라인은 아키텍처 압축, 결과 양자화, 품질 손실 복구라는 세 단계를 차례로 거친다. 마지막 단계의 주된 방식은 가짜 양자화 연산을 삽입하고 재훈련하는 QAT(quantization-aware training)이며, 대안인 QAD는 완전 정밀도 압축 모델로부터 지식을 증류한다. 두 경우 모두 학생 모델은 기껏해야 압축된 교사 모델의 성능을 따라잡을 수 있을 뿐이므로 압축으로 정해진 성능 상한을 그대로 물려받는다.
Multiverse Computing은 단 한 줄만 바꾸는 방식을 제안한다. 압축 전 원본 모델에서 직접 지식을 증류하는 것이다. 그러면 양자화는 손실을 수반하는 후처리가 아니라 완전한 학습 단계가 된다. 결과는 직관에 어긋난다. 120B에서 60B로 압축한 뒤 MXFP4로 양자화한 GPT-OSS 120B에 이 방법을 적용하면 9개 벤치마크 중 7개에서 자체 bfloat16 원본과 동등하거나 더 뛰어난 4비트 모델이 만들어진다. 특히 압축으로 인한 손실이 가장 큰 영역에서 개선 폭이 두드러져, 장문 맥락 추론의 AA-LCR에서는 7.4점, AIME 2025에서는 5.6점 상승했다. 성능이 하락한 MMLU-Pro와 SciCode에서도 감소 폭은 1.5점 미만이었다.
동일한 파이프라인에서 QAT와 직접 비교한 결과가 실무적으로는 가장 유용할 수 있다. MXFP4로 양자화한 GPT-OSS 9B에서 두 방법은 각각 54.9와 54.6으로 비슷한 최고점에 도달하지만, 그 비용은 같지 않다. QAH는 약 100단계 만에 해당 수준에 도달해 이를 유지하는 반면, QAT는 약 700단계가 걸리고 이후 성능이 저하된다. 이에 따라 배포 위험도 달라진다. QAT 체크포인트는 조기 종료 시점을 세심하게 관찰해야 하지만, QAH 체크포인트는 그 필요성이 훨씬 적다.
Gradio, 그래프 기반 AI 파이프라인 빌더 gr.Workflow 통합
8월 25일 — Hugging Face가 이제 Gradio에 통합된 기본 구성 요소인 gr.Workflow을 소개하는 가이드를 공개했다. 출발점은 단순하다. 흥미로운 AI 애플리케이션 대부분은 단일 모델 호출이 아니라 일련의 작업으로 구성된다. 이미지를 생성하고, 배경을 제거하고, 내레이션을 만든 다음, LLM에 제목을 요청하는 식이다. 지금까지 이 과정을 연결하고 깔끔하게 노출하려면 로직과 인터페이스를 모두 작성해야 했다. gr.Workflow은 이 둘을 결합한다. 단계를 형식이 지정된 노드의 그래프로 기술하면 그래프 자체가 인터페이스가 된다.
개발자에게 주는 이점은 시각적 시연을 넘어선다. 그래프의 각 출력에는 자체 REST 엔드포인트가 자동으로 생성된다. 예시로 제시된 미디어 스튜디오는 FLUX 생성, 배경 제거, 음성 합성, LLM을 차례로 연결하며, 인터페이스를 거치지 않고 코드에서 호출할 수 있는 세 개의 개별 경로(/sticker, /voiceover, /episode_title)를 제공한다. 노드는 네 가지 환경과 연동할 수 있다. Hugging Face Inference Providers를 통해 호스팅되는 모델, 구성 요소로 재사용되는 다른 공개 Gradio Spaces, Hub 데이터 세트의 한 행, 그리고 임의의 Python 코드다. 마지막 항목이 가장 많은 가능성을 열어 준다. @spaces.GPU으로 장식된 연산자 노드는 실행되는 동안 ZeroGPU의 GPU를 할당받아 자체 가중치를 실행할 수 있다. 실제로 Spaces에 배포된 애플리케이션 다섯 개도 가이드와 함께 제공되며, 여기에는 데이터 세트 프로파일러와 Lightricks/LTX-Video을 사용해 정지 이미지를 움직이게 만드는 데모가 포함된다.
ElevenLabs, 구간별 노래 편집기 Composer 출시
8월 25일 — ElevenLabs가 구간별로 작업하는 노래 편집기 Composer를 발표했다. 이 방식은 음악 모델의 주된 생성 방식과 다르다. 한 번에 곡 전체를 생성하고 마음에 들지 않는 부분이 있으면 전부 다시 만드는 대신, Composer에서는 특정 절이나 후렴구, 브리지만 따로 수정할 수 있다. 시작 방법은 네 가지다. 직접 쓴 가사, 사용자가 가져온 기존 트랙, 빈 화면, 또는 간단한 프롬프트에서 시작해 연속적인 수정을 거쳐 곡을 완성한다.
이는 Eleven Music에 이어 ElevenLabs가 음악 분야에서 내디딘 두 번째 행보이며, CLI v1이 전날 출시된 바쁜 한 주에 공개됐다. 이러한 방향은 오디오 업계 전반의 흐름과도 일치한다. Suno는 8월 13일 Studio 2.0을 출시했고, Pika는 8월 18일 Pika Music 제품군을 공개했으며, Stability AI도 같은 날 디지털 오디오 워크스테이션용 플러그인을 출시했다. 이제 경쟁의 장은 순수한 생성 품질보다 곡 구조에 대한 세밀한 제어로 옮겨가고 있다. 다만 유보할 점도 있다. 발표와 함께 공개된 블로그 게시물이 없으며, Composer를 이용할 수 있는 요금제나 내보내기 형식, API 접근에 관한 정보도 제공되지 않았다.
LiveAvatar, 동시 실행 제한 전면 폐지하고 분당 0.01 USD까지 인하
8월 25일 — HeyGen이 실시간 아바타 제품 LiveAvatar의 동시 실행 제한을 없앤다고 발표했다. 발표문은 변화의 성격을 분명히 강조한다. 제한을 완화하는 것이 아니라 완전히 없애는 것이다. 사전 할당량 협상 없이 하나의 API에서 세션 하나든 만 개든 실행할 수 있다. 발표에는 두 가지 조건도 함께 제시됐다. 렌더링은 전신 1080p를 유지하며, 대규모 이용 시 요금은 분당 0.01 USD까지 내려간다.
이 가격대는 고려할 수 있는 활용 방식 자체를 바꾼다. 분당 1센트라면 실시간 아바타를 대규모 고객 지원, 교육, 대화형 키오스크에 활용할 수 있다. 지금까지는 단위 비용이 이러한 활용 사례의 실현 가능성을 좌우했다. 기술적으로 흥미로운 부분은 동시 실행 제한의 폐지다. 실시간 아바타 플랫폼은 각 세션이 GPU를 계속 점유하기 때문에 일반적으로 동시 세션 수를 제한한다. 이 상한을 없애려면 상당한 여유 용량을 확보했거나 모델 효율성을 개선해야 한다. HeyGen은 접근 방식을 설명하는 글을 게시했지만, 조사 당시에는 기술적 세부 내용을 확인할 수 없었다.
Grok 4.6, OpenCode Go에 합류
8월 25일 — Grok 4.6이 오픈 소스 코딩 에이전트 OpenCode의 구독 요금제인 OpenCode Go에 추가됐다. OpenCode가 이날 늦게 발표했고, @grok 계정이 30분 뒤 이를 공유했다. 개발자에게 중요한 구체적 사항은 할당량이다. Go 요금제 사용자는 5시간마다 169개의 요청을 사용할 수 있다. 월간 요청 수가 아니라 이동식 시간 창에 따른 상한이므로 보조 코딩 세션에서 흔히 나타나는 집중적인 사용 패턴에 적합하다.
이번 통합은 Grok 4.6이 타사 도구로 확장되는 흐름의 일부다. 이 모델은 8월 14일 GitHub Copilot, 8월 19일 Amazon Bedrock, 8월 21일 Google의 Gemini Enterprise Agent Platform에 차례로 도입됐다. 또한 xAI는 이미 2026년 5월 OpenCode를 SuperGrok 및 X Premium 구독과 연동했다. 따라서 이번 발표의 핵심은 OpenCode 접근 자체가 아니라, 별도의 xAI 구독을 사용자가 직접 준비하지 않아도 포함된 할당량으로 Go 요금제에서 4.6 모델을 사용할 수 있다는 점이다.
🔗 @grok 공유 · @opencode 발표
Cohere, 2026년 주권형 AI 도입에 관한 IDC 연구 공개
8월 25일 — Cohere가 규제 산업의 주권형 AI 도입에 관해 IDC에 의뢰한 InfoBrief의 결과를 공개했다. 이 연구는 2026년 4월부터 5월까지 캐나다, 미국, 영국, 독일에서 매출 10억 달러가 넘는 기업의 고위 의사결정권자 500명 이상을 조사했다.
가장 주목할 만한 결과는 도입 자체보다 개념적 혼란에 관한 것이다. 경영진 세 명 중 한 명은 주권형 AI를 자신의 말로 설명하는 데 어려움을 겪었고, 이 주제를 매우 잘 알고 있다고 답한 비율은 13%에 불과했다. 정의를 제시할 수 있었던 응답자 가운데 52%는 지역 또는 국가 차원의 통제라는 관점으로 설명했고, 35%는 디지털 독립성을 언급했다. 이러한 격차는 조직 내 직무 간에도 나타났다. IT 책임자의 인지도는 현업 책임자의 두 배였다.
| 조사 대상 산업 | 데이터 유출 및 규정 준수가 주요 우려 사항 | 경쟁 우위가 도입 동력 |
|---|---|---|
| 금융 서비스 | 82 % | 21 % |
| 제조업 | 77 % | 32 % |
| 통신 | 75 % | 37 % |
| 의료 | 74 % | 28 % |
| 에너지 | 70 % | 21 % |
도입 동기에서는 모든 조사 대상 산업에 걸쳐 명확한 합의가 나타났다. 데이터 유출, 개인정보 보호, 규정 준수가 모두 최우선이었다. 경쟁 우위는 부차적이지만 중요성이 커지는 동력으로 나타났으며, 독일(23%)이나 영국(18%)보다 캐나다(35%)와 미국(28%)에서 더 많이 강조됐다. 이 연구는 고객이 선택한 인프라와 관할권 안에서 에이전트 플랫폼 North를 실행하는 Cohere의 시장 입지를 뒷받침하는 목적이 분명하지만, 수치에는 식별 가능한 출처가 제시돼 있다. IDC는 또한 2028년까지 다국적 기업의 CIO들이 모듈식 주권형 클라우드 환경과 데이터 현지화에 대한 투자를 65% 늘릴 것으로 전망한다.
단신
- Bain & Company, Claude Partner Network 합류 — 이 컨설팅 회사는 직원 19,000명을 대상으로 Claude를 배포하며 Global Premier 파트너가 됐다. 시범 단계부터 활성 사용자 수가 7,000명을 넘었고, 참가자의 3분의 2 이상이 Claude for Excel을 도입했다. 🔗 Anthropic 게시물
- Amp, orb의 개념 설명 — 명칭을 둘러싼 혼란에 답하는 Thorsten Ball의 글이다. orb는 웹, 휴대전화 또는 CLI에서 제어할 수 있는 원격 에이전트다. 비용과 관련된 유용한 세부 사항도 두 가지 있다. 무제한 절전 상태에는 요금이 부과되지 않으며, 동시에 사용할 수 있는 orb 수도 제한되지 않는다. 🔗 Amp 설명
- Together AI, Qwen3.8 27B를 fine-tuning과 전용 추론에 개방 — 자체 데이터를 이용한 미세 조정과 예약 하드웨어에서 실행하는 Dedicated Model Inference에 모두 모델을 사용할 수 있게 됐다. 🔗 @togethercompute 게시물
- FINAL-Bench, 에이전트 대상 금융 예측 대회 FINCHAL 개최 — 상금 2,000달러가 걸린 이 대회는 예측값이 아닌 포지션을 요구하며, 실력과 우연을 구분하기 위한 행운 상한선(luck ceiling)을 공개한다. 🔗 FINAL-Bench 게시물
- Au-Zone, EdgeFirst Model Zoo 공개 — 실제 임베디드 실리콘에서 측정한 객체 탐지 및 세분화용 YOLO 제품군 네 가지를 제공하며, 공개된 각 수치가 이를 생성한 검증 세션으로 연결된다. 이는 제조업체가 발표하는 불투명한 TOPS 수치와 대조된다. 🔗 EdgeFirst 게시물
- macOS용 Gemini 스마트 받아쓰기 — 데스크톱의 어느 창에서나 받아쓸 수 있으며, 머뭇거림을 자동으로 제거하고 문장 중간의 수정도 반영한다. 음성으로 파일을 요약하거나 텍스트를 다시 쓸 수도 있다. 🔗 blog.google 가이드
- push rules, 경로 예외 지원 — 공개 미리보기에서 Restrict file paths와 Restrict file size 규칙에 특정 경로를 예외로 지정할 수 있다. 예를 들어
**/gradle/wrapper/*.jar을 제외한 모든 위치에서 JAR을 차단할 수 있다. 🔗 GitHub 변경 기록 - 보안 권고에서 사용자 차단 — 공개 저장소에서 설정 화면을 거치지 않고 설명이나 댓글의 점 세 개 메뉴를 통해 사용자를 차단할 수 있으며, 권고 내용은 그대로 유지된다. 🔗 GitHub 변경 기록
- Manus, 데이터 복원 요청 급증 안내 — 완료되지 않은 복원 작업은 당일 늦게 다시 시도해야 하며, 백업 패키지를 온전하고 변경되지 않은 상태로 보관하라는 명시적인 지침이 제시됐다. 🔗 @ManusAI 게시물
- Kling, MCP 서버 관련 가이드 세 편 공개 — Kling을 MCP 호환 어시스턴트에 연결해 검증된 창작 설정을 재현하고 변형본을 일괄 생성하는 방법을 다룬다. 세 튜토리얼 중 두 편은 Claude Code를 클라이언트로 소개한다. 🔗 Kling 블로그
- Wan 3.0, Runway와 Replicate에 도입 — Runway는 8월 24일 이미지, 동영상, 오디오의 다중 참조 입력 기능과 함께 이를 통합했다. Replicate는 25일 뒤이어 도입하며 동기화된 오디오와 함께 한 번에 기본 30초 분량을 생성하는 기능을 강조했다. 🔗 @runwayml 게시물
- Runway, AI Summit의 새로운 연사 발표 — 9월 San Francisco에서 열리는 행사의 프로그램이 로봇공학, 자율주행차, 마케팅, 인프라 분야로 확대됐다. 🔗 @runwayml 게시물
- MiniMax, H3 통합 목록 공개 — Awesome MiniMax H3 Integrations는 24GB VRAM에서 실행되는 구성을 비롯해 개방형 동영상 모델을 중심으로 개발되는 프로젝트를 정리한다. 🔗 @MiniMax_AI 게시물
- Luma, Dream Lab Weekly 시작 — Luma의 창작 전문가들과 이들이 매주 제품에서 수행하는 작업을 다루는 동영상 시리즈의 첫 번째 에피소드다. 🔗 @LumaLabsAI 게시물
- NVIDIA, 개방형 모델 라우팅에 관한 Nemotron Labs 세션 방송 — Get Started with Open Model Routing이라는 제목의 55분 분량 생방송으로, Nemotron 3.5 Lightning과 NeMo Switchyard 관련 작업을 이어간다. 🔗 @NVIDIAAI 게시물
- 오디세이를 주제로 한 Grok Imagine 대회 마감까지 1주일 — 도구의 동영상 및 음성 기능을 돋보이게 하는 오디세이의 한 장면을 만들어야 하며, 상금은 각각 100,000달러, 50,000달러, 25,000달러다. 🔗 @grok 게시물
- Plus 및 Pro 구독자를 위한 한도 초기화 적립 제도 — 초기화 시간대를 기다리는 대신 미리 적립된 초기화권을 사용한다. 출시 시 하나가 무료로 제공되고 추천을 통해 추가로 받을 수 있으며, Business에서는 workspace 크레딧을 공유한다. 🔗 ChatGPT 및 Codex 변경 기록
이것이 의미하는 바
실리콘이 다시 모델 연구실의 핵심 주제로 떠오르고 있다. OpenAI는 자체 추론 칩의 최초 실측 수치와 컴퓨팅 전략을 설명하는 글을 같은 날 공개했다. 이는 단순히 일정이 우연히 겹친 것이 아니다. 자체 실리콘을 설계하고, 제3자의 공개 벤치마크로 이를 측정하며, 열 곳의 파트너로 구성된 포트폴리오를 공개적으로 내세우는 모델 공급자는 경쟁의 성격을 바꾼다. 이제 질문은 “어떤 모델이 최고인가”가 아니라 “성공한 작업 하나당 비용이 얼마인가”로 바뀌며, 그 답은 가중치만큼이나 랙에서도 결정된다. 가장 의미 있는 세부 사항은 어쩌면 다른 곳에 있다. 칩을 설계하고 커널을 작성하는 데 AI가 활용되었고, 9개월 만에 제조 단계에 들어갔으며, 선택된 블록에서는 생성된 구현이 인간 전문가의 구현을 능가했다. 순환 고리가 완성되고 있다. 모델이 자신을 구동할 하드웨어를 설계하는 것이다.
AI가 다시 기기 위로 내려오고 있으며, 수치도 이를 뒷받침하기 시작했다. 같은 날 나타난 세 가지 신호가 모두 같은 방향을 가리킨다. Perplexity는 크레딧을 소모하지 않고 DGX Spark에서 에이전트 전체를 로컬로 실행하며, 클라우드로의 전환 여부는 사용자가 결정하도록 한다. Multiverse Computing은 4비트 모델이 원본 완전 정밀도 모델과 동등하거나 이를 능가하는 방법을 공개해, 공격적인 양자화에 흔히 제기되던 반론을 무력화했다. Au-Zone은 발표된 TOPS 수치만으로는 특정 모델이 실제로 무엇을 할 수 있는지 전혀 알 수 없다고 지적하며 임베디드 실리콘별 비전 성능 측정치를 공개했다. 이 세 연구 중 어느 것도 frontier 수준과 동등하다고 주장하지 않는다. Perplexity가 공개한 정직한 수치는 Terminal Bench 2.1에서 로컬 실행이 59.6%인 반면 Claude Opus 5 단독 실행은 82.4%라는 것이다. 그러나 자문 모델로 전환하면 비용은 3분의 2만 들이면서 격차의 5분의 3을 만회할 수 있다. 로컬 실행을 설득력 있는 선택으로 만드는 것은 동등한 성능보다 바로 이 절충점이다.
가중치 공개가 기준점으로 자리 잡고 있다. Qwen이 공유한 arXiv 논문 50만 편 분석은 이미 감지되고 있던 역전을 수치로 보여준다. 중국의 오픈 모델은 언급 비중이 10%에서 약 40%로 상승한 반면, 미국의 오픈 모델은 2530%에서 정체되어 있다. 같은 규모의 모델 중 유일하게 Code Arena 상위 10위에 진입한 Qwen3.8-27B, 다회 실험에서 2.15.4배 낮은 비용으로 DeepSWE에서 GPT-5.6 Sol과 Claude Fable 5를 능가한 GLM-5.3, 출시 첫날부터 네 가지 양자화 변형과 열네 가지 GGUF 형식으로 Granite 4.2를 공개한 IBM까지, 같은 논리가 반복된다. 가중치 공개는 더 이상 뒤처진 기술을 따라잡기 위한 행보가 아니라 다른 이들의 기본 인프라가 되는 방식이다. 다만 Nathan Lambert가 직접 덧붙인 단서가 있다. 논문 게재는 출시보다 늦기 때문에, 이 곡선들은 현재의 선호가 아니라 진행 중인 연구를 보여준다는 점이다.
그리고 웹은 사람의 눈보다 에이전트가 읽는 환경에 대비하고 있다. WebMCP Challenge의 상금은 35,000달러로 크지 않지만, 이 대회가 드러내는 의미는 그보다 훨씬 크다. Chrome, Cloudflare, Shopify, Vercel, Render, Netlify는 에이전트가 인터페이스를 추측하도록 두는 대신 사이트가 구조화된 도구를 노출하도록 요구하는 표준을 중심으로 OpenAI와 뜻을 모으고 있다. 같은 날 ChatGPT desktop은 WebMCP를 기본적으로 사용할 수 있게 되었고, Codex는 호환 애플리케이션을 제작하고 배포할 수 있게 되었으며, OpenAI는 노트북 도구에서 이 프로토콜을 내부적으로 사용하는 방법을 문서화했다. 이러한 흐름은 Rohlik이 50개가 넘는 MCP 통합과 모든 새 도구를 출시 첫날부터 에이전트가 사용할 수 있어야 한다는 원칙으로 설명한 방향과 맞닿아 있다. 에이전트용 인터페이스 계층은 연구 주제에서 벗어나 엔지니어링 요구사항으로 자리 잡고 있다.
출처
- OpenAI — WebMCP Challenge
- OpenAI — X의 WebMCP Challenge 발표
- OpenAI — ChatGPT desktop 및 Sites의 WebMCP
- OpenAI — Codex, Runme 및 WebMCP로 반복 작업 자동화하기
- OpenAI — Jalapeño 최초 결과
- OpenAI — 풍부한 지능을 뒷받침하는 전체 스택
- OpenAI — ChatGPT Work 및 Codex용 Admin 플러그인
- OpenAI — 브라우저 확장을 Edge, Brave, Opera 및 Vivaldi로 확대
- OpenAI — ChatGPT Business Premium 라이선스
- ChatGPT 및 Codex — 변경 기록
- Perplexity — Portable Computer 출시
- Perplexity — Portable Computer 게시글
- Perplexity — 로컬 하니스 벤치마크
- Anthropic — 어디서나 작동하는 Claude 메모리
- Anthropic — X의 메모리 기능 발표
- Anthropic — Claude Code 변경 기록
- Anthropic — 4배 더 부드러운 스트리밍 렌더링
- Anthropic — 웰빙 연구 지원금
- Anthropic — Bain & Company의 Claude Partner Network 합류
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — gr.Workflow 가이드
- FINAL-Bench — FINCHAL 대회
- Au-Zone — EdgeFirst Model Zoo
- Together AI — 미세 조정 및 전용 추론용 Qwen3.8 27B
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — Antigravity 변경 기록
- Google — macOS용 Gemini 스마트 받아쓰기
- Stability AI — 7,600만 달러 규모의 시리즈 B
- Stability AI — X 발표
- NVIDIA — Gamescom 및 RTX Spark
- MiniMax — H3의 SANA 및 Sol Engine
- MiniMax — H3 통합 목록
- NVIDIA — 오픈 모델 라우팅에 관한 Nemotron Labs 세션
- Qwen — Code Arena WebDev의 Qwen3.8-27B
- Qwen — arXiv 분석 공유
- Nathan Lambert — arXiv 논문 50만 편 정밀 분석
- Warp — factory.yaml 형식 및 사전 이용
- Cognition — Rohlik Group 사례 연구
- Devin — Rohlik Group 고객 페이지
- Amp — 오브 설명
- GitHub — 새로운 GitHub Skills 연습 과제 네 가지
- GitHub — Customize 탭 정식 출시
- GitHub — 푸시 규칙의 경로 예외
- GitHub — 보안 권고에서 바로 차단하기
- Manus — 데이터 복원 현황
- ElevenLabs — Composer
- HeyGen — LiveAvatar의 무제한 동시 실행
- Kling — MCP 서버 가이드
- Runway — 플랫폼에서 이용 가능한 Wan 3.0
- Runway — AI Summit의 새로운 연사
- Luma — Dream Lab Weekly
- xAI — OpenCode Go의 Grok 4.6
- OpenCode — Go 요금제의 Grok 4.6
- xAI — 오디세이를 주제로 한 Grok Imagine 대회
- Cohere — 2026년 주권형 AI 도입 현황