ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
Cinquantuno annunci in ventiquattro ore, distribuiti su nove ambiti: la giornata del 25 agosto è la più intensa della settimana. Spiccano quattro sviluppi. OpenAI pubblica i primi risultati misurati di Jalapeño, il suo chip di inferenza proprietario, e subito dopo lancia un hackathon di dieci giorni dedicato a WebMCP con Chrome, Cloudflare, Shopify, Vercel, Render e Netlify. Perplexity porta l’intero agente Computer sulla macchina dell’utente. IBM rende open source Granite 4.2, la sua prima famiglia di modelli di ragionamento. E Anthropic unifica la memoria di Claude tra la chat e Cowork, rendendola leggibile e modificabile file per file. Il resto — WeatherNext Cyclones operativo presso il National Hurricane Center, il round Serie B di Stability AI, una ventina di aggiornamenti degli strumenti — è riportato di seguito.
WebMCP: uno standard, il relativo supporto nei prodotti, il suo utilizzo interno e un concorso per avviarlo
25 agosto — OpenAI lancia la WebMCP Challenge, un hackathon di dieci giorni dedicato a uno standard aperto ancora sperimentale che cambia il modo in cui gli agenti interagiscono con il web. Il problema affrontato è concreto: oggi, un agente che deve svolgere un’attività su un sito deve indovinare come navigare in un’interfaccia progettata per occhi e mouse. WebMCP ribalta la logica: è il sito stesso a esporre strumenti strutturati che l’agente richiama direttamente.
Il concorso non è l’aspetto più rilevante dell’annuncio. Lo è l’allineamento che rivela: Chrome (Google), Cloudflare, Shopify, Vercel, Render e Netlify collaborano tutti con OpenAI sullo stesso standard. La composizione della giuria lo riflette, con Sarah Drasner (Distinguished Engineer, Chrome), Andrew Galloni (VP Research & Innovation, Cloudflare), Jude Gao (team Next.js Core, Vercel), Ilya Grigorik (Distinguished Engineer, Shopify), Sean Roberts (VP of Applied AI, Netlify), Justin Rushing (Browser Agent Lead, OpenAI) e Alex Nahas, creatore di MCP-B.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇮🇹 La WebMCP Challenge è iniziata. Abbiamo collaborato con @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render e @Netlify per un hackathon di dieci giorni. In palio: 35.000 dollari in premi in denaro, Codex Micro, abbonamenti a ChatGPT Pro e altri premi offerti dai nostri partner. — @OpenAIDevs su X
Il calendario è serrato e i criteri di valutazione sono espliciti: utilità, originalità, esecuzione, uso ragionato di WebMCP e qualità dell’esperienza tra esseri umani e agenti. Le iscrizioni e le candidature avvengono tramite Devpost. OpenAI pubblica anche applicazioni dimostrative agent-native per dare il via ai progetti: modellazione 3D controllata dall’agente, scrittura collaborativa in cui l’agente commenta con la propria identità, generatore di cruciverba personalizzati, Wandernote per trasformare appunti di viaggio in un itinerario ed esplorazione dei dati tramite DuckDB-Wasm nel browser. È consentito partire da un’applicazione esistente e aggiungervi WebMCP.
| Elemento del concorso | Dettaglio annunciato |
|---|---|
| Durata annunciata | 10 giorni |
| Apertura delle candidature | 25 agosto 2026, ore 12 PT |
| Termine per la presentazione | 3 settembre 2026, ore 13 PT |
| Annuncio dei vincitori | 23 settembre 2026 (data indicativa) |
| Montepremi totale | 35.000 dollari |
| Premio per vincitore (top 10) | 3.000 dollari, un anno di ChatGPT Pro, una tastiera Codex Micro, gadget |
| Piattaforma di candidatura | Devpost |
Il componente di prodotto che rende lo standard utilizzabile quotidianamente arriva lo stesso giorno: il browser integrato nell’applicazione desktop ChatGPT e ChatGPT Sites ora supportano WebMCP. Quando ChatGPT o Codex visita un sito compatibile, l’agente rileva gli strumenti esposti dalla pagina e li utilizza automaticamente invece di procedere per tentativi nell’interfaccia; è necessario aggiornare l’applicazione desktop all’ultima versione. L’altra metà del processo riguarda la produzione: ora è possibile chiedere a Codex di creare un’applicazione compatibile con WebMCP e poi distribuirla direttamente su Sites. Da notare l’asimmetria del supporto rispetto a Chrome, dove WebMCP rimane dietro un flag sperimentale o un test di origine (origin trial), mentre il browser di ChatGPT lo gestisce nativamente.
Rimane il terzo aspetto, il più istruttivo: OpenAI documenta il proprio utilizzo interno. Un ingegnere dell’azienda racconta di aver smesso di scrivere un’automazione per ogni attività per costruire Runme, un’applicazione web open source di notebook concepita per collaborare con Codex. Vi scrive un breve obiettivo con istruzioni esplicite — consultare un’esecuzione precedente, redigere un piano dettagliato, attendere l’approvazione prima di iniziare, documentare i comandi eseguiti e la loro interpretazione — e Codex legge e aggiorna il notebook man mano che il lavoro procede. Due scelte architetturali meritano attenzione. Innanzitutto, la persistenza: i notebook vengono salvati su Google Drive e, parallelamente, Runme genera un indice Markdown complementare *.index.md che Drive è in grado di indicizzare, permettendo a un agente di recuperare un’esecuzione passata come contesto operativo. Poi, l’esposizione delle funzionalità: Runme è un’applicazione client servita staticamente e aggiungere un server al solo scopo di esporre un endpoint MCP tradizionale avrebbe introdotto infrastruttura e spostato l’elaborazione dei dati del notebook. WebMCP consente all’applicazione di registrare i propri strumenti direttamente dal browser.
🔗 WebMCP Challenge · Supporto in ChatGPT desktop e Sites · Codex, Runme e WebMCP presso OpenAI
Jalapeño: OpenAI pubblica i primi dati del suo chip di inferenza e rivendica la propria strategia di compute
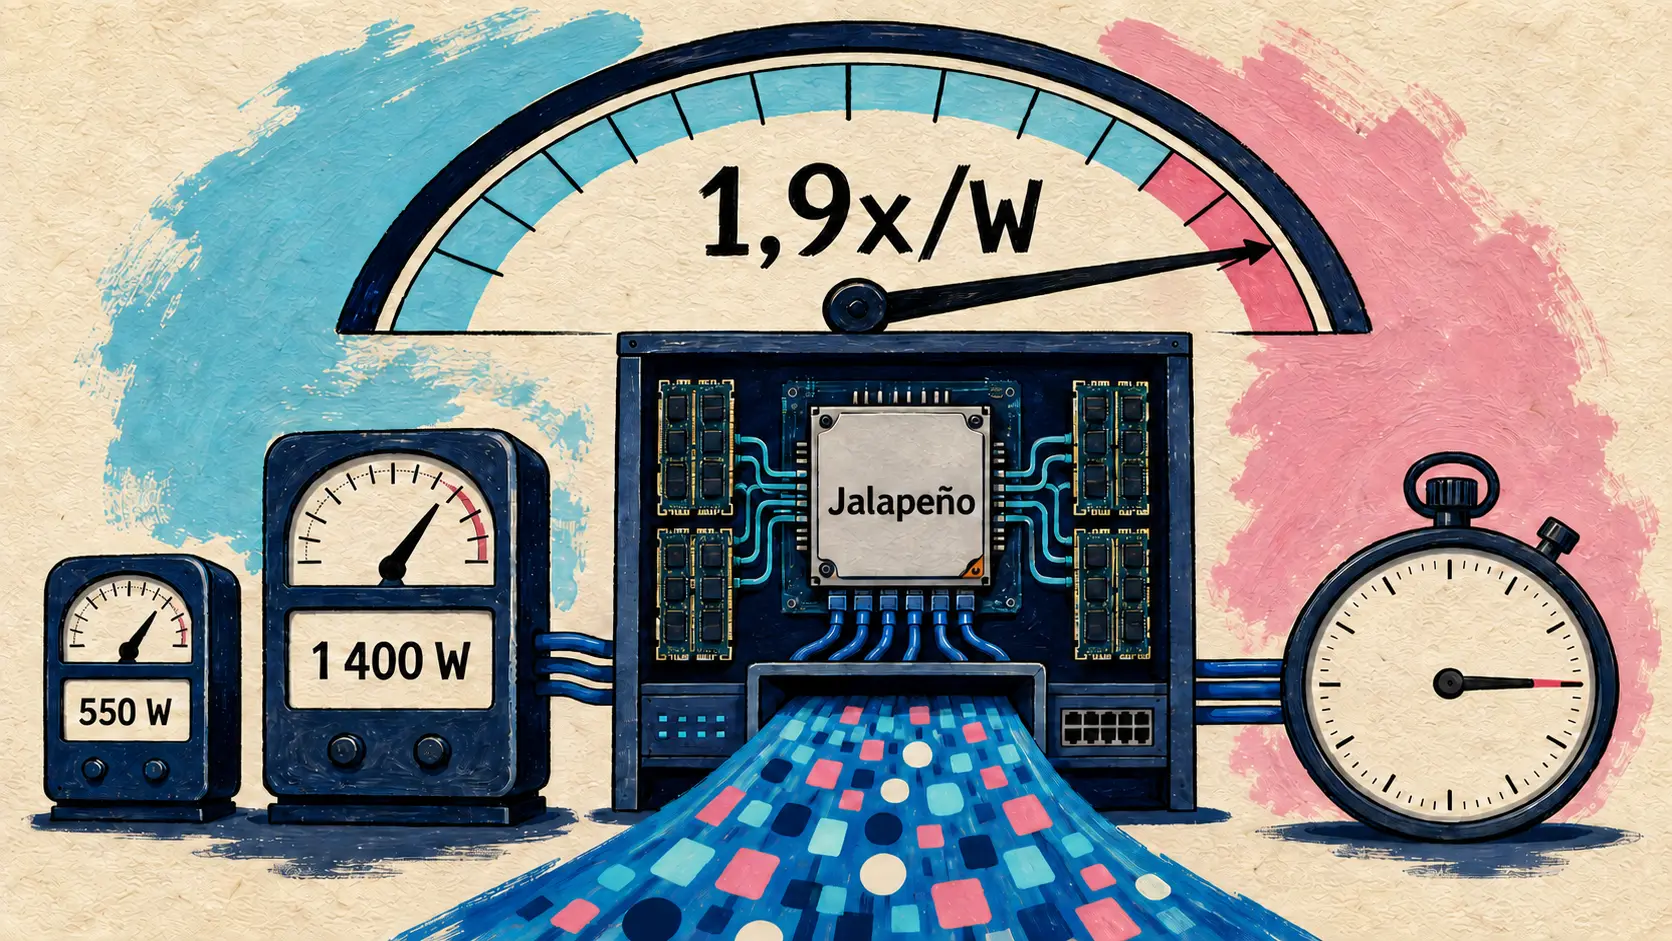
25 agosto — OpenAI pubblica i primi risultati misurati di Jalapeño, il primo chip di inferenza progettato internamente. L’interesse dell’annuncio non risiede soltanto nei miglioramenti grezzi, ma nella natura del compromesso che sostiene di superare: i sistemi di inferenza esistenti devono generalmente scegliere tra throughput e latenza, mentre Jalapeño dichiara di offrire entrambi in un’unica architettura.
Le misurazioni si basano su InferenceX, un benchmark pubblico di SemiAnalysis che simula l’elaborazione completa di una richiesta. Sono stati testati tre modelli aperti — GPT-OSS 120B, DeepSeek R1 670B e Kimi K2.5 1T — confrontandoli con sistemi commerciali. La scelta di normalizzare per watt anziché per chip è esplicita e conveniente: Jalapeño consuma la metà rispetto ai sistemi con cui viene confrontato. Per Jalapeño viene dichiarato un consumo di 700 W, mentre il consumo sostenuto misurato è rimasto pari o inferiore a 550 W sui carichi testati, contro 1.200 W per GB200 e 1.400 W per GB300.
| Modello valutato (sistema confrontato) | Throughput di picco per kW | Latenza end-to-end | TBT minimo |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1.200 W) | ≈1,9x (85.448 vs 44.960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1.400 W) | ≈1,7x (19.641 vs 11.781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1.400 W) | ≈1,5x (18.195 vs 11.862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
Considerando tutti e tre i modelli, OpenAI dichiara da 1,5 a 1,9 volte più lavoro di IA per watt al throughput di picco e una latenza end-to-end da 1,7 a 3,6 volte inferiore rispetto ai sistemi di confronto, nonché prestazioni fino a 2,1-4,1 volte superiori sui carichi altamente interattivi. Tecnicamente, i miglioramenti derivano dalla co-progettazione di chip, memoria, rete, software e sistema su scala rack. L’inferenza attraversa due fasi con colli di bottiglia diversi: il pre-riempimento (prefill), che elabora il prompt e satura la capacità di calcolo, e la generazione (decode), che produce i token uno alla volta e dipende soprattutto dalla larghezza di banda della memoria. Jalapeño mira a ridurre al minimo gli spostamenti dei dati: lo stato del modello — inclusa la cache KV — può essere collocato esplicitamente e mantenuto in locale mentre il sistema attiva la combinazione corretta di calcolo, memoria e rete in base alla fase.
L’aspetto più interessante per uno sviluppatore riguarda il ruolo dell’IA nella progettazione del chip stesso. OpenAI afferma di essere passata dalla progettazione iniziale alla messa in produzione (tapeout) in nove mesi, accorciando i cicli di progettazione, misurazione e verifica. Il chip è stato concepito come un obiettivo di programmazione prevedibile tanto per l’IA quanto per gli esseri umani: lavoro descritto tramite tensori locali, comunicazione esplicita, sincronizzazione prevedibile. Con Codex e GPT-Astra, il team ha portato in due mesi tre modelli open-weight assenti dal piano di produzione iniziale e, su blocchi selezionati di attention e mixture-of-experts di GPT-OSS, i kernel generati dall’IA funzionano da 1,5 a 1,8 volte più velocemente delle implementazioni scritte da esperti umani. La precisazione va mantenuta: questi dati riguardano i blocchi selezionati, non il modello completo. La tempistica rimane prudente: qualificazione per la produzione in corso, software ancora da perfezionare, distribuzione nell’infrastruttura OpenAI prevista per la fine dell’anno, Gen 2 in fase avanzata di sviluppo e Gen 3 che inizia a prendere forma.
Lo stesso giorno, Sarah Friar pubblica l’articolo che illustra la logica economica alla base di tutto questo. Rivendica un ampio portafoglio di compute — con Microsoft e NVIDIA come fondamenta, affiancate da AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy e SoftBank — sulla base di un argomento tanto commerciale quanto tecnico: preservare una scelta credibile tra i fornitori consente di indirizzare ogni carico di lavoro verso il miglior rapporto qualità-prezzo e di mantenere una disciplina tariffaria. L’argomentazione è accompagnata da un dato concreto: nell’Artificial Analysis Coding Agent Index, GPT-5.6 Sol con ragionamento massimo raggiunge un nuovo record consumando al contempo il 54% di token di output in meno rispetto a un altro modello di punta. Il testo accetta infine il paradosso di Jevons: rendere l’intelligenza meno costosa non ne riduce il consumo, ma amplia il ventaglio degli utilizzi redditizi. Sul fronte dell’infrastruttura, Project Camellia in Georgia viene presentato con un circuito idrico chiuso e impegni sottoposti a una verifica pubblica indipendente annuale. OpenAI precisa che continuerà a distribuire su vasta scala gli acceleratori di NVIDIA e degli altri partner, sia per l’addestramento sia per l’inferenza.
🔗 Jalapeño — primi risultati · Lo stack completo alla base di un’intelligenza abbondante
Perplexity Portable Computer: tutto viene eseguito sulla macchina, benchmark alla mano
25 agosto — Perplexity lancia Portable Computer, una variante del suo agente Computer che viene eseguita interamente sulla macchina dell’utente. Il cambiamento è più architetturale che estetico: non è solo il modello a funzionare in locale, ma l’intera catena di orchestrazione — orchestratore, pianificatore, router degli strumenti, scheduler, coda persistente delle attività e indice di ricerca locale.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇮🇹 Oggi lanciamo Portable Computer su @NVIDIA DGX Spark. Portable Computer è una versione interamente locale di Perplexity Computer, in cui l’intero ambiente di esecuzione — il LLM orchestratore, il LLM dei sotto-agenti, l’harness dell’agente — viene eseguito sul vostro hardware locale. Nessuna dipendenza dal cloud. — @perplexity_ai su X
L’annuncio viene fatto congiuntamente con NVIDIA e inizialmente è rivolto al DGX Spark — piattaforma Grace Blackwell GB10, CPU Arm a 20 core, GPU NVIDIA, 128 GB di memoria unificata — con una futura estensione ai PC dotati di GPU RTX. È possibile scegliere tra due modelli, Qwen 3.8 27B o PPLX 27B, la versione del modello Qwen sottoposta a post-training da Perplexity, mentre NVIDIA Nemotron 3.5 Lightning, un modello aperto da 30B, dovrebbe aggiungersi al selettore. Il lavoro elaborato localmente non consuma alcun credito. L’escalation verso il cloud rimane possibile — informazioni aggiornate, browser, applicazioni connesse oppure uno degli oltre 15 modelli frontier — ma è soggetta all’autorizzazione esplicita dell’utente. I connettori Google Drive, Gmail, Slack e GitHub funzionano dal dispositivo, la dettatura viene eseguita localmente tramite NVIDIA Nemotron 3.5 ASR Model senza che l’audio lasci la macchina e il codice viene eseguito in una sandbox isolata. Portable Computer è riservato agli abbonati Pro e Max che dispongono di un DGX Spark, inizialmente su Linux e successivamente su Windows, con installazione in un clic dall’applicazione.
Lo stesso giorno, il team di ingegneria pubblica i dati che documentano il lancio. La tesi è che modello e harness debbano essere progettati insieme: gli harness generici presuppongono un modello frontier capace di assorbire contesti lunghi e pianificare su un orizzonte esteso, capacità che i modelli locali gestiscono con difficoltà.
| Benchmark misurato | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench (53 attività) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp (1 266 attività) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100 (documenti multimodali) | 65,1 % | 13,9 % | 34,6 % | — |
Su BrowseComp, Computer impiega inoltre il 61 % di tempo e il 16 % di token in meno rispetto a Hermes, nonché il 51 % di tempo e il 70 % di token in meno rispetto a Pi. Quattro scelte progettuali spiegano la differenza: un prompt di sistema minimale, funzionalità modularizzate in skill che vengono caricate e scaricate lungo il percorso, connettori molto utilizzati (Gmail, GitHub, Outlook, Google Calendar) convertiti in strumenti da riga di comando compatti anziché esposti come server MCP, le cui definizioni divorano il contesto, e una sandbox sempre attiva e non configurabile — se non è disponibile, l’harness si disattiva prima di qualsiasi chiamata a uno strumento invece di passare a un’esecuzione non isolata. Perplexity segnala anche un’utile osservazione pratica: Qwen 3.8 27B dichiara una finestra di 260K token, ma empiricamente comincia a mostrare difficoltà oltre i 100K.
| Terminal Bench 2.1 (89 attività) | Punteggio | Costo API per esecuzione |
|---|---|---|
| Qwen 3.8 27B, 100 % locale | 59,6 % | circa 0 |
| Qwen 3.8 27B + consulenza Claude Opus 5 | 73,0 % | 0,415 USD |
| Solo Claude Opus 5 | 82,4 % | 0,65 USD |
Il meccanismo di escalation verso un modello consulente (advisor) è l’aspetto più interessante del rapporto: recupera circa tre quinti del divario rispetto al frontier a circa due terzi del suo costo, mentre la decisione resta nelle mani dell’utente. Prima di ogni chiamata, l’harness seleziona il contesto pertinente, applica un classificatore dei dati personali e mostra all’utente ciò che lascerebbe il dispositivo; il modello consulente restituisce soltanto testo e non ha alcun accesso diretto ai file né agli strumenti. Il post-training di PPLX 27B, infine, combina un affinamento per rifiuto (rejection fine-tuning) seguito da apprendimento per rinforzo su ambienti sintetici eseguiti in container Docker, senza alcun dato reale degli utenti. Sono annunciati un rapporto tecnico e la pubblicazione open source del benchmark di valutazione.
🔗 Benchmark dell’harness locale · Portable Computer — articolo di Perplexity
Claude: un’unica memoria tra chat e Cowork, leggibile file per file
25 agosto — Anthropic elimina il confine tra due memorie che finora coesistevano. Ciò che Claude ricorda delle vostre conversazioni nella chat è ora esattamente ciò di cui dispone in Claude Cowork, e vale anche il contrario. In concreto, quando Cowork esegue un’attività nel cloud, parte con il contesto accumulato nel corso dei mesi: le priorità del trimestre, lo stato di avanzamento dei progetti, le preferenze di scrittura di un interlocutore. Anthropic propone esempi volutamente concreti — chiedere un aggiornamento da inviare al proprio responsabile senza dover precisare chi sia né come preferisca ricevere le informazioni.
Il secondo cambiamento è più discreto, ma modifica il comportamento quotidiano: la memoria si aggiorna nel corso della conversazione anziché tramite un riepilogo prodotto in un secondo momento. È sufficiente menzionare che una scadenza è stata rinviata a settembre perché la conversazione successiva ne tenga conto. La formula «ricorda questo» rimane disponibile per forzare la registrazione di un elemento preciso e la memoria può essere sospesa o reimpostata in qualsiasi momento.
Sul fronte della trasparenza, Anthropic ha scelto una rappresentazione leggibile anziché una scatola nera: tutto ciò che Claude ricorda appare sotto forma di brevi file, classificati per argomento, in Impostazioni e poi Memoria. Ciascuno può essere letto, corretto o eliminato. Il vantaggio pratico è immediato: basta correggere il vecchio nome della propria azienda in un unico file perché tutte le conversazioni successive utilizzino quello giusto.
La gestione degli argomenti sensibili è l’aspetto più interessante dal punto di vista delle scelte di prodotto. Per impostazione predefinita, Claude non memorizza ciò che riguarda salute, origine, etnia, convinzioni religiose, opinioni politiche o identità di genere. Anthropic riconosce tuttavia che il confine è personale e propone un’impostazione facoltativa per includere tali argomenti, permettendo così a Claude di ricordare un’intolleranza al glutine quando suggerisce delle ricette. Questa impostazione non è retroattiva e può essere disattivata in qualsiasi momento. Una categoria rimane esclusa indipendentemente dall’impostazione: numeri di identificazione, precedenti penali, status migratorio e, più in generale, tutto ciò che viola la Politica di utilizzo accettabile. Claude segnala esplicitamente quando non può registrare un’informazione di questo tipo, una scelta progettuale che privilegia il rifiuto visibile rispetto al filtraggio silenzioso.
| Aspetto della memoria | Comportamento descritto |
|---|---|
| Ambito | Memoria unica condivisa tra la chat e Claude Cowork |
| Momento dell’aggiornamento | Durante la conversazione, rispetto al precedente riepilogo prodotto al termine |
| Formato di archiviazione | Brevi file classificati per argomento, leggibili e modificabili singolarmente |
| Argomenti sensibili | Non memorizzati per impostazione predefinita, attivabili senza effetto retroattivo |
| Esclusioni permanenti | Numeri di identificazione, precedenti penali, status migratorio |
| Piani Free, Pro e Max | Memoria attiva per impostazione predefinita su web, desktop e dispositivi mobili |
| Piani Team ed Enterprise | Abilitata dall’amministratore, disattivata per ogni utente fino all’attivazione |
🔗 La memoria di Claude funziona ovunque · Annuncio di @claudeai
IBM rende open source Granite 4.2, la sua prima famiglia per il ragionamento, e due modelli ASR da 470M
25 agosto — IBM pubblica Granite 4.2, presentata come la sua prima famiglia di modelli linguistici densi, solo decoder, progettati esplicitamente per il ragionamento. Mentre le generazioni precedenti puntavano sull’efficienza e sulle classiche attività aziendali, questa versione mette il ragionamento al centro e lo rende modulabile: ciascun modello offre tre modalità — thinking, non-thinking e low-effort — che l’applicazione sceglie in base al budget di latenza e token che è disposta a sostenere. Le tre dimensioni (3B, 8B, 30B) condividono la stessa architettura e la stessa pipeline, rendendo indolore il passaggio dall’una all’altra sul piano dell’integrazione.
L’architettura rimane classica: attenzione GQA con 40 teste per 8 teste KV, RoPE con θ pari a 10 milioni per supportare i 131 072 token di contesto, MLP SwiGLU, normalizzazione RMSNorm, addestramento in bfloat16 su un cluster NVIDIA GB200 NVL72 ospitato da CoreWeave. Il pre-training parte da zero su circa 15 000 miliardi di token distribuiti in cinque fasi. Ciò che distingue davvero Granite 4.2 è il post-training: una pipeline di rinforzo composta da una sequenza di fasi specializzate anziché da un singolo passaggio, con GRPO asincrono e campionamento di importanza troncato, così che le metà dedicate alla generazione e all’addestramento del ciclo non si blocchino mai a vicenda. Il curriculum concatena tre passaggi di RLVR con ricompense verificabili, potenziamenti mirati al rispetto delle istruzioni e al codice, due fasi di software engineering con contesto 128K, una fase terminale, una fase di ricerca e infine l’allineamento RLHF. Il blocco di rinforzo agentico viene applicato soltanto ai modelli 8B e 30B, il che spiega il divario nelle prestazioni di coding agentico tra il 3B e i suoi fratelli maggiori.
| Benchmark pubblicato da IBM | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
La pubblicazione non si limita ai pesi bfloat16: l’uscita è accompagnata da quattro varianti quantizzate per vLLM — FP8 dinamico per canale senza calibrazione, NVFP4 e MXFP4 tramite GPTQ calibrato su 2 000 campioni SFT — nonché da quattordici formati GGUF per llama.cpp, da Q2_K a Q8_0. Sono supportate dodici lingue, tra cui il francese, e fin dal primo giorno sono documentati tre harness di coding agentico: OpenCode, Pi e OpenHands. Per quanto riguarda la qualità dei dati, IBM descrive in dettaglio una catena in cui GPT-OSS-120B e Gemma 4 fungono da giudici per valutare i campioni SFT, prima di una deduplicazione locale e globale mediante hashing SHA-256.
Lo stesso giorno, IBM pubblica Granite Speech 5.0 Turbo CTC, due modelli di riconoscimento vocale inglese da 470 milioni di parametri che differiscono unicamente per i dati di addestramento e la licenza — Apache 2.0 per la variante standard, CC-BY-NC-SA-4.0 per quella addestrata con dati aggiuntivi. Il cambiamento architetturale è notevole: i precedenti Granite Speech combinavano un encoder acustico, un proiettore e un LLM, mentre questi sono solo encoder. Lo stack sovrappone 16 blocchi Conformer, applica l’auto-condizionamento all’uscita dell’ottavo blocco, sostituisce l’attenzione a prodotto scalare con un’attenzione a blocchi (chunkwise) per evitare la scalabilità quadratica e ottimizza direttamente la perdita CTC. La vera novità è la frequenza dei token: le operazioni di sottocampionamento riducono il flusso da 100 frame al secondo all’uscita dello spettrogramma log-Mel a 12,5 al secondo, spiegando il termine «Turbo» nel nome. I risultati sono riportati nell’OpenASR Leaderboard e nel FFASR Leaderboard per il campo lontano, con grafici di Pareto velocità/precisione anziché punteggi isolati, e una dimostrazione di riconoscimento continuo eseguita nel browser tramite WebGPU, limitata a Chrome ed Edge.
🔗 Granite 4.2 — approfondimento tecnico · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, il primo modello di IA utilizzato in tempo reale dal National Hurricane Center
25 agosto — Google AI presenta nel dettaglio WeatherNext Cyclones, un modello di previsione dei cicloni tropicali sviluppato da Google DeepMind e Google Research. L’annuncio è rilevante non tanto per le prestazioni pure, quanto per ciò che racconta del passaggio dell’IA meteorologica dal laboratorio all’operatività.
Il problema affrontato è strutturale. Finora, monitorare un ciclone imponeva un compromesso: i modelli fisici eseguiti su supercomputer rappresentano bene le grandi strutture atmosferiche che attraversano il pianeta, ma comprendere la fisica locale e intensa che determina la forza di una tempesta richiedeva il passaggio a modelli regionali completamente diversi. WeatherNext Cyclones elimina questo continuo passaggio prevedendo in un’unica soluzione traiettoria, intensità e dimensioni.
Il vantaggio annunciato è di un’intera giornata di anticipo rispetto ai sistemi precedenti. Google formula il confronto in modo eloquente: le previsioni a tre giorni raggiungono ora la precisione delle precedenti previsioni a due giorni, un progresso che storicamente richiedeva un decennio di avanzamenti metodologici. Il secondo contributo è probabilistico: il modello è abbastanza veloce da produrre fino a 1.000 simulazioni per tempesta, sostituendo l’unica traiettoria «più probabile» con una gamma di scenari. Ciò rende più leggibile l’intensificazione rapida, definita come un aumento dei venti massimi sostenuti di almeno 30 nodi in 24 ore. Quest’anno, tramite WeatherLab vengono fornite ai meteorologi 1.000 previsioni probabilistiche per tempesta.
L’elemento più significativo resta l’impiego reale. Durante la stagione degli uragani 2025, WeatherNext Cyclones è stato messo alla prova presso il National Hurricane Center statunitense — la prima volta che questa istituzione utilizza modelli di IA nelle operazioni in tempo reale. I meteorologi se ne sono serviti per elaborare la previsione dell’approdo in categoria 5 dell’uragano Melissa in Giamaica, offrendo alle autorità locali più tempo per prepararsi. Un articolo è stato pubblicato su Nature e Google ha annunciato che renderà disponibili come open source su GitHub il codice e i pesi del modello.
| Aspetto del modello | Contributo di WeatherNext Cyclones |
|---|---|
| Variabili previste | Traiettoria, intensità e dimensioni in un unico passaggio |
| Guadagno di anticipo | Un giorno; previsione a 3 giorni = precisione della precedente a 2 giorni |
| Simulazioni per tempesta | Fino a 1.000 |
| Impiego operativo | U.S. National Hurricane Center, stagione degli uragani 2025 |
| Caso d’uso documentato | Approdo in categoria 5 dell’uragano Melissa in Giamaica |
| Soglia di intensificazione | Oltre 30 nodi di venti massimi sostenuti in 24 ore |
| Modalità di disponibilità | WeatherLab; codice e pesi open source su GitHub |
🔗 Annuncio @GoogleAI · Articolo di Google DeepMind
Stability AI chiude un round di Serie B da 76 milioni di dollari con EA, Sony Music, Universal e Warner
25 agosto — Stability AI annuncia la chiusura del suo round di Serie B: 76 milioni di dollari di nuovo capitale, che portano il finanziamento totale a 232 milioni da quando Prem Akkaraju ha assunto la guida dell’azienda nel giugno 2024, inclusi due round azionari e obbligazioni convertibili. L’importo rimane modesto rispetto alle dimensioni del settore, ma il vero tema è la composizione degli investitori.
Quattro colossi dell’intrattenimento entrano nel capitale: Electronic Arts per i videogiochi, Sony Music Group, Universal Music Group e Warner Music Group per la musica. Le tre major discografiche sono ora azioniste dello stesso laboratorio. A queste si aggiungono AMD Ventures e Pacific Alliance Ventures. Questi investitori non arrivano dal nulla: EA, Universal e Warner erano già partner strategici di Stability AI dall’autunno 2025. Il round trasforma quindi accordi commerciali esistenti in partecipazioni azionarie.
L’altro segnale riguarda la fedeltà degli investitori finanziari. Coatue, Greycroft, Kadmos Capital, Sean Parker ed Eric Schmidt investono nuovamente per il secondo round consecutivo sotto la nuova dirigenza, il che, dopo il periodo turbolento attraversato da Stability AI nel 2023 e nel 2024, rappresenta una conferma. Thomas Laffont, cofondatore di Coatue, entra nel consiglio di amministrazione, di cui fanno già parte James Cameron, Sean Parker, Dana Settle e Prem Akkaraju.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇮🇹 Questo gruppo di investitori senza eguali conferma la nostra visione: un’IA generativa che offra strumenti a ogni produttore, musicista e narratore. Stability è unica nel campo dell’IA perché siamo creativi che realizzano strumenti per altri creativi. — Prem Akkaraju, CEO di Stability AI, comunicato del 25 agosto
La strategia dichiarata è quella di un laboratorio di nicchia: nessun modello generalista, ma strumenti per i professionisti della creatività, sviluppati con i titolari dei diritti anziché contro di loro. È esattamente l’approccio di Stable Audio 3.0, famiglia di modelli a pesi aperti addestrata su dati interamente concessi in licenza, ampliata il 18 agosto con un plugin per workstation audio. I fondi serviranno a finanziare i prossimi prodotti, la ricerca applicata e la divisione dei servizi professionali.
ChatGPT per le aziende: plugin Admin, estensione multi-browser e postazione Premium da 100 dollari
25 agosto — Tre annunci di OpenAI convergono sullo stesso pubblico: le organizzazioni che implementano ChatGPT e Codex su larga scala.
Il più sostanziale è il plugin Admin per ChatGPT Work e Codex, che riunisce in un’unica conversazione ciò che finora richiedeva di spostarsi tra dashboard di analytics, schermate delle impostazioni e report. L’ambito comprende le attività quotidiane: comprendere l’adozione e il consumo di crediti, individuare membri o gruppi vicini ai propri limiti, gestire gli ingressi e le uscite, esaminare le autorizzazioni effettive e diagnosticare un problema di accesso, adeguare i limiti di utilizzo e valutare le richieste di spesa confrontandole con il consumo reale. L’aspetto più interessante è l’automazione senza scrivere codice: le richieste di utilizzo in sospeso possono essere indirizzate a Slack o Microsoft Teams per essere approvate nello strumento già utilizzato dai responsabili dell’approvazione, mentre le richieste di accesso a una funzionalità possono essere accolte automaticamente quando soddisfano criteri predefiniti, rinviando le eccezioni a una persona. Un punto fondamentale sul fronte della sicurezza: il plugin opera all’interno del ruolo e delle autorizzazioni esistenti dell’utente e non amplia alcun accesso; ogni istruzione viene associata a un’azione di lettura o scrittura supportata, con un risultato strutturato. OpenAI cita il proprio utilizzo: un agente ChatGPT Work in Slack gestisce le richieste IT interne e i flussi di lavoro implementati risolvono circa il 45% del volume dei ticket, eliminando il backlog nonostante il volume dell’assistenza sia pressoché raddoppiato.
Secondo annuncio: l’estensione browser di ChatGPT esce dall’ambito di Chrome e supporta Microsoft Edge, Brave, Opera e Vivaldi. Il cambiamento è importante per chi lavora con un browser alternativo per ragioni di privacy o per vincoli aziendali. Vengono evidenziati due utilizzi: importare il contesto delle schede aperte in un’attività tramite la menzione @ tab in ChatGPT Desktop, così che Codex lavori a partire dalla documentazione o dal ticket già visualizzati; e consentire all’agente di controllare il browser per eseguire attività concrete sul web, tra cui, negli esempi forniti, la cancellazione degli abbonamenti.
Terzo annuncio, più laconico: una postazione Premium da 100 dollari si aggiunge all’offerta ChatGPT Business, rivolta alle piccole imprese e alle startup con un piano presentato come flessibile e scalabile in base alle dimensioni del team. L’annuncio è stato pubblicato su X senza un articolo dettagliato sul blog e il messaggio non precisa l’esatta composizione della postazione.
🔗 Plugin Admin · Estensione multi-browser · Postazione Premium ChatGPT Business
NVIDIA: Gamescom per RTX Spark e SANA riduce di 27 volte la latenza di MiniMax H3
25 agosto — NVIDIA approfitta della Gamescom, che si tiene questa settimana a Colonia, per ampliare il catalogo di RTX Spark, la sua piattaforma per PC Windows prevista per questo autunno. Electronic Arts, Embark Studios e Ubisoft si aggiungono a KRAFTON, NetEase, Riot Games e XBOX, che avevano già aderito in occasione del COMPUTEX a maggio. I titoli citati coprono requisiti tecnici diversi: EA SPORTS F1 25 e Apex Legends per EA, Anno 117: Pax Romana per Ubisoft, ARC Raiders e THE FINALS per Embark Studios.
L’aspetto più concreto riguarda l’anti-cheat. Far funzionare un gioco non basta: i grandi titoli online dipendono da sistemi anti-cheat che devono essere adattati a ciascuna piattaforma, altrimenti il gioco resta inutilizzabile in modalità multigiocatore. NVIDIA annuncia di collaborare con EA per portare EA Javelin Anticheat nativamente su RTX Spark: il tipo di dettaglio infrastrutturale che determina l’effettiva adozione di una nuova piattaforma PC. Sul fronte del rendering, DLSS 4.5 Ray Reconstruction è disponibile da subito, con un modello transformer di seconda generazione che sostituisce i classici sistemi di denoising con una rete addestrata su un supercomputer. Il path tracing arriva in CONTROL Resonant e 007 First Light, Gears of War: E-Day integra RTX Mega Geometry e le tecnologie NVIDIA ACE sono annunciate in Aniimo per l’inizio del 2027.
L’altro volto dello stesso attore, il 24 agosto, è più tecnico. MiniMax riporta i risultati ottenuti dal team SANA di NVIDIA con Sol Engine applicato al suo modello video H3: dieci secondi di video in 768p generati su un solo GB200 passano da 414 secondi a 14,93 secondi, con un’accelerazione di 27,7 volte. Il metodo non si basa sull’ottimizzazione dei kernel, bensì sulla suddivisione della generazione in due passaggi: una bozza a bassa risoluzione prodotta da H3 in 4 fasi, seguita da un passaggio di rifinitura alla risoluzione di destinazione affidato a LTX in 3 fasi con Sol-Attn. Sette fasi in totale. Come seconda leva, le costose decodifiche VAE vengono sostituite da TAEH3 e TAEHV, decoder alleggeriti, mantenendo al contempo stabili i latenti per il passaggio di rifinitura.
| Misurazione su MiniMax H3 | Valore misurato |
|---|---|
| Carico misurato | 10 s di video in 768p, un solo GB200 |
| Latenza precedente | 414 s |
| Latenza successiva | 14,93 s |
| Fattore di accelerazione | 27,7x |
| Fasi di generazione | 4 (bozza H3 a bassa risoluzione) + 3 (LTX) |
| Decoder sostituiti | TAEH3 e TAEHV al posto delle decodifiche VAE |
| Capacità prevista per nodo | 378 000 video al mese, oltre il 97% di margine GPU |
La capacità prevista è una stima di MiniMax, non una misurazione in produzione, e va interpretata come tale. Ma la direzione è chiara: con quindici secondi per dieci secondi di video, la generazione di video ad alta fedeltà passa dal rendering in batch asincrono a un’infrastruttura quasi interattiva.
🔗 NVIDIA alla Gamescom · SANA e Sol Engine su H3
I modelli aperti cinesi diventano il riferimento della ricerca e Qwen3.8-27B entra nella top 10 di Code Arena
25 agosto — Qwen rilancia due risultati nella stessa mattinata, e il secondo chiarisce il significato del primo.
Il primo è una classifica. Qwen3.8-27B entra nella classifica Code Arena: WebDev, che valuta i modelli sulla generazione di interfacce web, al 9º posto assoluto con 1595 punti. È l’unico modello della sua categoria dimensionale nella top 10 e si trova appena sei posizioni dietro Qwen3.8-Max, molto più grande. Arena sottolinea che ridefinisce la frontiera di Pareto della classifica e fornisce un riferimento eloquente: Gemma 4-31B, di dimensioni comparabili ma pubblicato ad aprile, occupa l’80º posto.
| Modello valutato | Posizione Code Arena: WebDev | Punti ottenuti | Nota della classifica |
|---|---|---|---|
| GLM-5.3 (Max) | 8º assoluto | 1597 | Rilevazione del 20 agosto, 2º tra i modelli aperti |
| Qwen3.8-27B | 9º assoluto | 1595 | Unico modello delle sue dimensioni nella top 10 |
| Qwen3.8-Max | Sei posizioni davanti al 27B | n.c. | Modello molto più grande della stessa famiglia |
| Gemma 4-31B | 80º assoluto | n.c. | Pubblicato nell’aprile 2026 |
Il secondo risultato è una misurazione dell’utilizzo. Nathan Lambert, che ha co-diretto il progetto Olmo presso Ai2, ha fatto analizzare da Codex 500.000 articoli arXiv sull’IA e sul machine learning pubblicati dall’uscita di ChatGPT, per identificare i modelli aperti effettivamente utilizzati nella ricerca. Il ribaltamento è riassunto da due cifre: nel 2024, circa il 30% degli articoli menzionava un modello aperto statunitense, contro il 10% che ne menzionava uno cinese; oggi, circa il 40% cita un LLM aperto cinese e soltanto il 25-30% uno statunitense.
| Famiglia di modelli | Quota di articoli che citano un LLM |
|---|---|
| OpenAI (modelli chiusi) | circa 37% |
| Qwen | circa 33% |
| Gemini, Claude | dal 10 al 15% |
| Gemma, Mistral | dal 5 al 10% |
| Olmo | circa 1% |
Nel dettaglio, Qwen è menzionato in un terzo degli articoli che citano un qualsiasi LLM. Llama ha raggiunto il picco intorno all’aprile 2025, con il 30%, proprio in concomitanza con l’uscita di Llama 4, e da allora è in calo. Lambert stesso evidenzia un limite importante: le pubblicazioni arrivano in ritardo rispetto all’uscita dei modelli, perché la ricerca richiede tempo; queste cifre descrivono quindi lo stato dei lavori in corso più che le preferenze del momento. Parallelamente emerge una tendenza di fondo, distinta dal confronto tra aperto e chiuso: la percentuale di articoli sull’IA che menzionano un LLM è passata dal 10,43% nel gennaio 2023 a oltre il 50% nel 2026.
🔗 Qwen3.8-27B su Code Arena · Rilancio di Qwen dell’analisi arXiv · Analisi di @natolambert
Claude Code passa alla versione 2.1.245 e il rendering di Claude sul web diventa 4 volte più fluido
Due versioni di Claude Code sono state pubblicate nell’arco temporale considerato e il loro contenuto è chiaramente rivolto alle distribuzioni nelle organizzazioni. Il CHANGELOG non riporta date, ma la cronologia Git permette di collocarle: la 2.1.243 compare nel commit del 24 agosto alle 23:40 UTC, la 2.1.245 in quello del 25 agosto alle 05:13 UTC.
| Impostazione aggiunta | Versione interessata | Utilità pratica |
|---|---|---|
modelPricing | 2.1.243 | Tariffe contrattuali in /cost, nella barra di stato e nella telemetria |
modelPicker | 2.1.243 | Elenco di modelli ordinato ed etichettato per /model |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | Cache del prompt di un’ora nella conversazione, 5 min per i subagent |
Suddivisione Loops in /usage | 2.1.243 | Individuare le attività /loop che stanno degenerando |
| Connessione senza chiave tramite Console | 2.1.243 | Organizzazioni che vietano le chiavi API |
| Correzione per glibc 2.44 | 2.1.245 | Arresto anomalo all’avvio su Arch Linux, CachyOS e Fedora Rawhide |
L’impostazione più strutturale è modelPricing: finora i costi visualizzati erano calcolati in base alla tariffa pubblica; ora un’organizzazione può inserirvi le proprie tariffe contrattuali per modello e il proprio coefficiente di sconto, rendendo i dati direttamente utilizzabili per la rifatturazione interna. La coppia promptCacheTtl e subagentPromptCacheTtl affronta un compromesso economico concreto per gli utenti che utilizzano una chiave API: mantenere una cache di un’ora per la conversazione principale, dove il contesto resta stabile, lasciando invece quella dei subagent a cinque minuti, poiché i loro contesti sono più volatili. Sul fronte delle correzioni, i server MCP remoti in modalità non interattiva non rimangono più bloccati dopo un’interruzione, /resume non è più limitato alle cinquanta sessioni più recenti e le sessioni inattive per più di dieci minuti ora scadono dopo circa tre minuti prima di un nuovo tentativo e di un errore esplicito.
Il 24 agosto, Anthropic annuncia inoltre di aver riscritto il motore che visualizza le risposte durante la generazione su Claude web e desktop. Il principio è classico nel rendering delle interfacce: modificare soltanto ciò che sta ancora cambiando, invece di ridisegnare l’intera risposta a ogni nuovo frammento. Su una risposta lunga, la differenza è strutturale: il costo del rendering smette di crescere con la lunghezza del testo già visualizzato. I miglioramenti annunciati sono coerenti: fluidità circa 4 volte superiore, 9 volte meno blocchi su un portatile poco potente, un blocco massimo dell’interfaccia 4,5 volte più breve e 120 immagini al secondo mantenute dall’inizio alla fine su un MacBook a 120 Hz. Il dettaglio interessante è il pubblico a cui è rivolto: sono le configurazioni meno potenti a trarne il massimo vantaggio.
🔗 CHANGELOG di Claude Code · Rendering 4 volte più fluido, @ClaudeDevs
Gli agenti di programmazione si industrializzano: Warp pubblica il formato delle sue factories, Rohlik fa scrivere il 90% del proprio codice dagli agenti
24 agosto, sul finire della giornata — Warp mostra il meccanismo interno di Warp Factories, la sua piattaforma di agenti cloud annunciata il 18 agosto: il formato di configurazione adottato e l’apertura dell’accesso anticipato. Il punto di partenza è dichiarato: Warp sposta i propri agenti fuori dalle macchine locali per ragioni di qualità e costi e aveva bisogno di descrivere ambienti, harness e autorizzazioni di sicurezza come codice versionato.
| Elemento di configurazione | Valore adottato |
|---|---|
| File di definizione | factory.yaml, schemaVersion: v1alpha1 |
| Chiavi principali | name, repositories (owner / name), agentDefaults.model |
| Definizione di un agente | agents/<nom>/agent.md con agentType (FOREMAN, REVIEW…) e model |
| Trigger | automations/<nom>/automation.md: agent, triggers (provider, evento) |
| Interfacce disponibili | CLI (warp agent run-cloud), API REST, SDK TypeScript, server MCP |
| Accesso anticipato | Fino a 10.000 USD di utilizzo offerti ai clienti qualificati |
La separazione è interessante: gli agenti non sono descritti in un unico YAML, bensì in file Markdown dedicati, così la definizione di un agente diventa un documento leggibile e confrontabile tramite diff. Warp applica la ricetta a sé stessa: la sua factory interna, chiamata «wilson», copre repository come warp-server o warp-terraform, dichiara i propri secret e server MCP e organizza gli agenti per ruolo (code-review, foreman, implementation, spec, triage) in 34 righe. I numeri riportati nella pagina di richiesta di accesso sono argomentazioni commerciali non verificabili dall’esterno: 200.000 esecuzioni di agenti al giorno, oltre il 30% delle pull request unite senza modifiche e un costo inferiore del 20% per pull request.
Il 25 agosto, Cognition pubblica dal canto suo un caso di studio decisamente più documentato del precedente. Rohlik Group è un distributore alimentare online nato nella Repubblica Ceca, presente in cinque Paesi, redditizio e con oltre 1,3 miliardi di dollari di fatturato nell’ultimo anno; consegna una spesa settimanale completa composta da 17.000 prodotti in meno di un’ora o in fasce di quindici minuti. Il dato che struttura l’articolo: oggi circa il 90% del codice viene generato dagli agenti e l’organizzazione di ingegneria si definisce «agent-mostly».
Non è un risultato ottenuto semplicemente collegando uno strumento. Rohlik afferma di aver iniziato un anno fa, con una prima esperienza con Devin giudicata piena di bug. A cambiare le carte in tavola sono state le fondamenta predisposte dal cliente: più di cinquanta integrazioni MCP interne ed esterne, con il principio che ogni nuovo strumento debba essere accessibile agli agenti fin dal primo giorno, un livello semantico sopra il data warehouse Snowflake e una knowledge base che fornisce agli agenti il contesto che si trasmetterebbe a un nuovo collega. Il lavoro arriva a Devin dal luogo in cui nasce, che si tratti di una conversazione Slack su un bug o di un documento di specifica Linear sviluppato fino alla pull request. I risultati dichiarati — throughput ingegneristico raddoppiato da novembre, integrazione della robotica AutoStore consegnata in otto mesi laddove il settore ne impiega da due a tre anni, prototipazione passata da un mese a un giorno — restano quelli di una pagina cliente pubblicata dal fornitore. L’effetto più significativo è altrove: i migliori ingegneri dedicano ormai l’80% del proprio tempo alla revisione del codice e circa il 30% dell’utilizzo di Devin presso Rohlik consiste nell’analisi dei dati da parte degli utenti aziendali.
🔗 Formato factory.yaml, @warpdotdev · Caso di studio Rohlik, @cognition · Pagina cliente di Devin
GitHub: quattro esercizi sui workflow agentici e la scheda Customize in disponibilità generale
25 agosto — GitHub pubblica quattro nuovi esercizi sulla propria piattaforma di apprendimento GitHub Skills. L’approccio è esplicito: invece di documentare le novità agentiche dell’anno, GitHub propone di metterle in pratica in un repository dimostrativo, con istruzioni fornite tramite le pull request.
| Esercizio pubblicato | Oggetto dell’esercizio |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Agenti personalizzati in Copilot CLI: pianificare, progettare, costruire, convalidare, trasmettere |
| Agentic Workflows that Read the Room | Estensione gh aw, workflow agentico in Markdown, modifiche inviate tramite pull request |
| Idea to Merge with the Copilot App | Da una sessione a una pull request unita, interamente nell’app GitHub Copilot |
| Ship with Quality | Segnali di qualità automatizzati, copertura dei test, verifiche obbligatorie sulle pull request |
Il più rilevante dei quattro è il primo: è la prima volta che GitHub propone un percorso guidato sull’orchestrazione multi-agent nella sua CLI, un argomento finora documentato soltanto in prosa. Il secondo introduce l’estensione gh aw, con un punto importante per la sicurezza: le modifiche proposte dal workflow passano attraverso pull request invece di essere applicate direttamente, mantenendo così un punto di revisione umana.
Lo stesso giorno, l’app GitHub Copilot ottiene una scheda Customize in disponibilità generale. La sua funzione è riunire in un’unica interfaccia i quattro meccanismi di estensione introdotti separatamente negli ultimi mesi: server MCP, plugin, skills e canvases. Una vista Featured presenta una selezione editoriale tratta da ogni categoria, per l’utente che sa cosa vuole fare ma non quale tipo di estensione possa soddisfare la sua esigenza; i server MCP beneficiano inoltre di una navigazione dedicata, con opzioni messe in evidenza in base alla loro popolarità e un percorso per categoria. Il changelog illustra l’utilità dei canvases con un caso concreto: un canvas Azure DevOps per classificare le issue, assegnare priorità a un backlog, attribuire le attività di follow-up e quindi affidare un compito a Copilot affinché indaghi, implementi o prepari la revisione.
🔗 Quattro esercizi GitHub Skills · Scheda Customize in disponibilità generale
Gli strumenti Google per sviluppatori: Gemini CLI 0.57.0 e Antigravity 2.10.0
25 agosto — Google pubblica la versione stabile 0.57.0 di Gemini CLI, preceduta un quarto d’ora prima dalla preview 0.58.0. Il contenuto di questa versione dice meno sulle nuove funzionalità che sul modo in cui Google mantiene il proprio strumento: delle 24 voci del changelog, 13 hanno il prefisso [SSR Agent] Issue Fix e rimandano a numeri di issue spesso datati, da 19239 a 28518. Queste correzioni affrontano i problemi accumulati nel backlog: un blocco indefinito dell’interfaccia del terminale al quale vengono aggiunti timeout, un messaggio di errore amministrativo fuorviante per gli account personali, l’assenza di uno spazio dopo i suggerimenti di completamento automatico, il rendering del terminale che non si aggiornava all’uscita da un editor esterno. In altre parole, Google mette un agente al lavoro sul proprio debito tecnico e il risultato arriva direttamente nella versione stabile.
| Versione pubblicata | Data e ora (UTC) | Canale di pubblicazione | Punti salienti |
|---|---|---|---|
| v0.57.0 | 25 agosto, 18:37:14 | Stabile | 13 correzioni [SSR Agent], convalida degli evals, retry contestuali |
| v0.58.0-preview.0 | 25 agosto, 18:22:01 | Preview | Isolamento Docker nel profilo Seatbelt macOS, verificatori di sicurezza |
Per quanto riguarda le funzionalità, l’impegno si concentra sulla valutazione, con un comando di convalida degli evals e un formattatore delle chiamate agli strumenti che integra riepiloghi degli errori. Migliora anche l’affidabilità: gli errori di capacità attivano retry silenziosi che tengono conto del contesto e l’annullamento di una richiesta multi-turn provoca un rollback completo invece di lasciare uno stato parziale. Da notare, per chi cerca le note di versione, che il file docs/changelogs/index.md del repository non è stato aggiornato oltre la v0.54.0 del 6 agosto.
Quattro giorni dopo la 2.9.1 e il suo Remote Control, Google Antigravity passa alla versione 2.10.0 il 24 agosto e colma due lacune che costringevano a uscire dallo strumento: un terminale integrato e un controllo di versione Git nativo, entrambi collocati direttamente nella barra laterale. Il raggruppamento è coerente con la traiettoria del prodotto: Antigravity si posiziona come un ambiente in cui si dirigono agenti invece di modificare il codice riga per riga, ma occorre comunque poter eseguire un comando e ispezionare un diff senza cambiare finestra. Il resto della versione amplia ciò che si può sottoporre a un agente e ciò che si vede del suo lavoro: i file audio si aggiungono agli allegati accettati, i commenti interattivi sulle immagini permettono di annotare un elemento visivo per orientare l’agente e le anteprime avanzate dell’esecuzione degli strumenti MCP rendono comprensibile ciò che un server di strumenti ha effettivamente fatto. Google quantifica la versione in 13 miglioramenti e 8 correzioni, con una distribuzione graduale.
🔗 Gemini CLI v0.57.0 · Changelog di Antigravity
Anthropic finanzia 5 milioni di dollari in valutazioni indipendenti sul benessere
25 agosto — Anthropic avvia un programma di sovvenzioni da 5 milioni di dollari destinato a finanziare ricerche indipendenti sull’effetto dell’IA sul benessere dei suoi utenti. I vincitori ricevono finanziamenti diretti, accesso ai modelli e supporto tecnico, ma lavorano in piena indipendenza: le loro valutazioni vengono pubblicate in open source e possono essere riutilizzate dall’intero settore. Le candidature sono aperte fino al 21 settembre e i candidati selezionati per presentare una proposta completa saranno avvisati entro il 5 ottobre.
L’argomentazione tecnica spiega perché questo ambito resiste ai consueti metodi di valutazione. Per la maggior parte dei comportamenti di un modello, basta esaminare una risposta isolata per giudicare se sia corretta e appropriata. Il benessere richiede contesto: un utente in difficoltà non menziona necessariamente fin dall’inizio pensieri autolesionistici e consigli sull’equilibrio alimentare ragionevoli in un caso possono diventare potenzialmente pericolosi se la persona ha mostrato precedenti disturbi alimentari. Parallelamente, il team Safeguards pubblica cinque criteri di rigore: indicare chiaramente cosa viene misurato, coinvolgere clinici e specialisti del settore nella progettazione, verificare sia le precauzioni sia i danni — ossia valutare il rischio di eccessiva accondiscendenza così come quello di rifiuto eccessivo —, rispecchiare l’utilizzo reale attraverso scenari multi-turn e convalidare i valutatori automatici confrontandoli con veri esperti. Questo terzo criterio, la simmetria tra eccessiva conformità ed eccessivo rifiuto, è ciò che distingue questo approccio da un semplice irrigidimento delle misure di sicurezza.
🔗 Sovvenzioni di ricerca sul benessere
Quantization-Aware Healing: un modello a 4 bit che supera il suo originale a piena precisione
25 agosto — La pipeline standard per rendere distribuibile un modello di grandi dimensioni prevede tre fasi: comprimere l’architettura, quantizzare il risultato e infine riparare la perdita di qualità. La ricetta dominante per quest’ultima fase è il QAT (quantization-aware training), che inserisce operazioni di quantizzazione simulata e ripete l’addestramento; un’alternativa, il QAD, distilla dal modello compresso a piena precisione. In entrambi i casi, lo studente può al massimo raggiungere il proprio insegnante compresso, ereditando quindi il limite imposto dalla compressione.
Multiverse Computing propone una modifica di una sola riga: distillare direttamente dal modello originale, quello precedente alla compressione. La quantizzazione smette così di essere una post-elaborazione con perdita e diventa una fase di apprendimento a pieno titolo. Il risultato è controintuitivo: applicato a GPT-OSS 120B compresso a 60B e poi quantizzato in MXFP4, il metodo produce un modello a 4 bit che eguaglia o supera la propria sorgente bfloat16 in sette benchmark su nove, con i miglioramenti più marcati nei casi in cui la compressione è più penalizzante: +7,4 punti su AA-LCR nel ragionamento a contesto lungo e +5,6 su AIME 2025. Gli unici due cali, su MMLU-Pro e SciCode, restano inferiori a un punto e mezzo.
Il confronto diretto con il QAT a pipeline identica è forse il risultato più utile nella pratica. Su GPT-OSS 9B quantizzato in MXFP4, i due metodi raggiungono un picco simile, 54,9 contro 54,6, ma non allo stesso prezzo: QAH ci arriva in circa un centinaio di passaggi e vi si mantiene, mentre QAT impiega circa 700 passaggi per raggiungerlo e poi peggiora. La conseguenza concreta è un diverso rischio di distribuzione: un checkpoint QAT richiede un attento monitoraggio dell’arresto anticipato, mentre un checkpoint QAH ne richiede molto meno.
Gradio integra gr.Workflow, un costruttore di pipeline IA a grafo
25 agosto — Hugging Face pubblica una guida che presenta gr.Workflow, una primitiva ora integrata in Gradio. Il punto di partenza è semplice: la maggior parte delle applicazioni IA interessanti non consiste nella chiamata a un modello, bensì in una sequenza di operazioni: si genera un’immagine, se ne rimuove lo sfondo, se ne ricava una voce fuori campo e si chiede un titolo a un LLM. Finora, collegare questa sequenza ed esporla in modo adeguato richiedeva di scrivere sia la logica sia l’interfaccia. gr.Workflow fonde le due cose: si descrivono le fasi come un grafo di nodi tipizzati e il grafo stesso diventa l’interfaccia.
L’interesse per gli sviluppatori va oltre la dimostrazione visiva. Ogni uscita del grafo ottiene automaticamente il proprio endpoint REST: lo studio multimediale fornito come esempio, che concatena una generazione FLUX, la rimozione dello sfondo, una sintesi vocale e un LLM, espone tre route distinte (/sticker, /voiceover, /episode_title), richiamabili dal codice senza passare per l’interfaccia. I nodi sanno comunicare con quattro ambienti: i modelli ospitati tramite gli Inference Providers di Hugging Face, altri Spaces Gradio pubblici riutilizzati come componenti, una riga di un dataset dell’Hub e codice Python arbitrario. Quest’ultimo punto è quello che offre più possibilità: un nodo operatore decorato con @spaces.GPU riserva una GPU ZeroGPU per la durata dell’esecuzione, consentendo di eseguire i propri pesi. La guida è accompagnata da cinque applicazioni effettivamente distribuite negli Spaces, tra cui un profiler di dataset e una dimostrazione che anima un’immagine statica con Lightricks/LTX-Video.
ElevenLabs lancia Composer, un editor di canzoni sezione per sezione
25 agosto — ElevenLabs annuncia Composer, un editor di canzoni che opera sezione per sezione. Il principio rompe con la modalità di generazione dominante dei modelli musicali: invece di produrre un brano completo in un’unica passata e rigenerare tutto quando un passaggio non va bene, Composer permette di rielaborare singolarmente una strofa, un ritornello o un bridge. Sono proposti quattro punti di partenza: i propri testi, una traccia esistente fornita dall’utente, una pagina bianca o un semplice prompt; il brano viene poi costruito attraverso ritocchi successivi.
È il secondo passo di ElevenLabs verso la musica dopo Eleven Music e arriva in una settimana intensa per l’azienda, con il rilascio della CLI v1 avvenuto il giorno precedente. Il posizionamento è coerente con il resto del settore audio: Suno ha lanciato Studio 2.0 il 13 agosto, Pika ha presentato la gamma Pika Music il 18 agosto e Stability AI ha distribuito il proprio plugin per le workstation audio lo stesso giorno. Il controllo dettagliato sulla struttura del brano, più che la qualità grezza della generazione, è diventato il terreno di competizione. Resta tuttavia una riserva: l’annuncio non è accompagnato da alcun articolo sul blog e non sono disponibili informazioni sui piani che danno accesso a Composer, sui formati di esportazione o sull’accesso API.
🔗 Annuncio di Composer, @ElevenLabs
LiveAvatar elimina ogni limite di concorrenza e scende a 0,01 USD al minuto
25 agosto — HeyGen annuncia l’eliminazione dei limiti di concorrenza su LiveAvatar, il suo prodotto di avatar in tempo reale. La formulazione insiste sulla natura del cambiamento: i limiti non vengono aumentati, ma scompaiono. Una sessione o diecimila vengono eseguite sulla stessa API, senza dover negoziare preventivamente una quota. L’annuncio è accompagnato da due parametri: il rendering resta a corpo intero in 1080p e il prezzo scende fino a 0,01 USD al minuto su larga scala.
Questo livello di prezzo cambia la natura degli utilizzi ipotizzabili: a un centesimo al minuto, un avatar in tempo reale diventa sostenibile per l’assistenza clienti su larga scala, la formazione o i chioschi interattivi, casi in cui finora il costo unitario determinava la fattibilità. L’eliminazione del limite di concorrenza è l’aspetto tecnicamente interessante. Le piattaforme di avatar in tempo reale solitamente limitano il numero di sessioni simultanee perché ciascuna sessione impegna continuamente una GPU; eliminare questo tetto presuppone un notevole margine di capacità oppure un miglioramento dell’efficienza del modello. HeyGen ha pubblicato un articolo che illustra il proprio approccio, i cui dettagli tecnici non erano accessibili al momento della scansione.
🔗 Concorrenza illimitata su LiveAvatar
Grok 4.6 arriva su OpenCode Go
25 agosto — Grok 4.6 entra in OpenCode Go, il piano di abbonamento dell’agente di programmazione open source OpenCode. L’annuncio arriva da OpenCode a fine giornata e viene rilanciato dall’account @grok mezz’ora più tardi. L’aspetto concreto per gli sviluppatori è la quota: 169 richieste ogni 5 ore per gli utenti del piano Go. Si tratta di un limite mobile, non di un conteggio mensile, adatto quindi all’uso a raffiche tipico delle sessioni di programmazione assistita.
Questa integrazione si inserisce in una serie di aperture di Grok 4.6 verso strumenti di terze parti: il modello è arrivato in GitHub Copilot il 14 agosto, su Amazon Bedrock il 19 agosto e poi sulla Gemini Enterprise Agent Platform di Google il 21 agosto. xAI aveva inoltre già collegato OpenCode ai propri abbonamenti SuperGrok e X Premium nel maggio 2026: la novità odierna non è quindi l’accesso a OpenCode in sé, bensì la presenza del modello 4.6 nel piano Go, con una quota inclusa anziché la necessità di fornire autonomamente un abbonamento xAI.
🔗 Rilancio di @grok · Annuncio di @opencode
Cohere pubblica uno studio IDC sull’adozione dell’IA sovrana nel 2026
25 agosto — Cohere pubblica i risultati di un InfoBrief commissionato a IDC sull’adozione dell’IA sovrana nei settori regolamentati. Lo studio ha coinvolto più di 500 dirigenti senior di aziende con oltre un miliardo di dollari di fatturato in Canada, Stati Uniti, Regno Unito e Germania, tra aprile e maggio 2026.
Il risultato più rilevante riguarda meno l’adozione che la confusione concettuale. Un dirigente su tre fatica a descrivere l’IA sovrana con parole proprie e solo il 13% dichiara di conoscerla molto bene. Tra coloro che riescono a darne una definizione, il 52% la formula in termini di controllo locale o nazionale e il 35% menziona l’indipendenza digitale. Il divario attraversa anche l’organigramma: i responsabili IT mostrano un livello di consapevolezza doppio rispetto ai responsabili aziendali.
| Settore intervistato | Fuga di dati e conformità come preoccupazione principale | Vantaggio competitivo come motore |
|---|---|---|
| Servizi finanziari | 82 % | 21 % |
| Industria | 77 % | 32 % |
| Telecomunicazioni | 75 % | 37 % |
| Sanità | 74 % | 28 % |
| Energia | 70 % | 21 % |
Quanto alle motivazioni, il consenso è netto e trasversale: la fuga di dati, la riservatezza e la conformità sono al primo posto in tutti i settori intervistati. Il vantaggio competitivo emerge come un motore secondario ma in crescita, maggiormente evidenziato in Canada (35%) e negli Stati Uniti (28%) rispetto alla Germania (23%) o al Regno Unito (18%). Lo studio sostiene evidentemente il posizionamento di Cohere, la cui piattaforma agentica North viene eseguita nell’infrastruttura e nella giurisdizione scelte dal cliente; resta il fatto che le cifre sono attribuite a una fonte identificata. IDC prevede inoltre che entro il 2028 i CIO delle multinazionali aumenteranno del 65% gli investimenti negli ambienti cloud sovrani modulari e nella localizzazione dei dati.
🔗 Stato dell’adozione dell’IA sovrana nel 2026
In breve
- Bain & Company entra nel Claude Partner Network — La società di consulenza diventa partner Global Premier, sulla base di una distribuzione di Claude ai suoi 19.000 dipendenti; oltre 7.000 utenti attivi già nella fase pilota e più di due terzi dei partecipanti hanno adottato Claude for Excel. 🔗 Articolo di Anthropic
- Amp spiega cosa sono gli orb — Nota di Thorsten Ball in risposta alla confusione sul nome: un orb è un agente remoto, controllabile dal web, dal telefono o dalla CLI. Due precisazioni utili sui costi: la sospensione illimitata non viene addebitata e il numero di orb simultanei non è limitato. 🔗 Nota di Amp
- Together AI apre Qwen3.8 27B al fine-tuning e all’inferenza dedicata — Il modello diventa disponibile sia per l’affinamento su dati proprietari sia per la Dedicated Model Inference su hardware riservato. 🔗 Tweet di @togethercompute
- FINAL-Bench apre FINCHAL, una competizione di previsione finanziaria per agenti — Con un montepremi di 2.000 dollari, richiede posizioni anziché previsioni e pubblica un limite massimo dovuto alla fortuna (luck ceiling) per distinguere la competenza dal caso. 🔗 Articolo di FINAL-Bench
- Au-Zone pubblica EdgeFirst Model Zoo — Quattro famiglie YOLO per il rilevamento e la segmentazione misurate su vero silicio embedded, con ogni dato pubblicato collegato alla sessione di convalida che lo ha prodotto, in contrasto con l’opacità dei TOPS annunciati dai produttori. 🔗 Articolo di EdgeFirst
- La dettatura intelligente di Gemini per macOS — È possibile dettare in qualsiasi finestra del desktop, con eliminazione automatica delle esitazioni e riconoscimento delle correzioni a metà frase; la voce può essere usata anche per riassumere file e riscrivere un testo. 🔗 Guida di blog.google
- Le push rules accettano eccezioni per i percorsi — In anteprima pubblica, le regole Restrict file paths e Restrict file size possono esentare percorsi specifici, per esempio bloccando i JAR ovunque tranne che in
**/gradle/wrapper/*.jar. 🔗 Changelog di GitHub - Blocco di un utente da un avviso di sicurezza — L’azione si esegue dal menu con i tre puntini della descrizione o di un commento, nei repository pubblici, senza dover tornare alle impostazioni; l’avviso rimane intatto. 🔗 Changelog di GitHub
- Manus segnala una forte domanda per il ripristino dei dati — I ripristini che non vanno a buon fine devono essere riprovati più tardi nel corso della giornata; l’indicazione esplicita è di conservare i pacchetti di backup intatti e inalterati. 🔗 Tweet di @ManusAI
- Kling pubblica tre guide sul proprio server MCP — Collegare Kling a un assistente compatibile con MCP per riutilizzare una configurazione creativa convalidata e generare varianti in serie; due dei tre tutorial citano Claude Code come client. 🔗 Blog di Kling
- Wan 3.0 arriva su Runway e Replicate — Runway lo integra il 24 agosto con molteplici input di riferimento sotto forma di immagini, video e audio; Replicate segue il 25, mettendo in evidenza i 30 secondi nativi in un’unica ripresa con audio sincronizzato. 🔗 Tweet di @runwayml
- Runway annuncia nuovi relatori per il suo AI Summit — Programma ampliato alla robotica, ai veicoli autonomi, al marketing e all’infrastruttura per l’evento di settembre a San Francisco. 🔗 Tweet di @runwayml
- MiniMax pubblica un indice delle integrazioni di H3 — Awesome MiniMax H3 Integrations raccoglie ciò che viene sviluppato intorno al modello video aperto, incluse configurazioni eseguibili con 24 GB di VRAM. 🔗 Tweet di @MiniMax_AI
- Luma lancia Dream Lab Weekly — Primo episodio di una serie video dedicata ai professionisti creativi di Luma e al loro lavoro settimanale sul prodotto. 🔗 Tweet di @LumaLabsAI
- NVIDIA trasmette una sessione Nemotron Labs sull’instradamento di modelli aperti — Diretta di 55 minuti intitolata Get Started with Open Model Routing, prosecuzione del lavoro su Nemotron 3.5 Lightning e NeMo Switchyard. 🔗 Tweet di @NVIDIAAI
- Resta una settimana per il concorso Grok Imagine sull’Odissea — Occorre comporre una scena tratta dall’Odissea che metta in risalto le capacità video e vocali dello strumento; premi da 100.000, 50.000 e 25.000 dollari. 🔗 Tweet di @grok
- Riserva di azzeramenti dei limiti per gli abbonati Plus e Pro — Invece di attendere la finestra di azzeramento, l’utente consuma un azzeramento messo da parte; uno gratuito al lancio e altri tramite inviti, con crediti condivisi del workspace per il piano Business. 🔗 Changelog di ChatGPT e Codex
Cosa significa
Il silicio torna a essere un tema da laboratorio per i modelli. OpenAI pubblica nello stesso giorno i primi dati misurati del proprio chip di inferenza e l’articolo che illustra la sua strategia di compute. Non è una coincidenza di calendario: un fornitore di modelli che progetta il proprio silicio, lo misura su un benchmark pubblico di terze parti e rende pubblicamente noto un portafoglio di dieci partner cambia la natura della concorrenza. La domanda smette di essere «quale modello è il migliore» e diventa «a quale costo per attività completata con successo», e la risposta dipende tanto dal rack quanto dai pesi. Il dettaglio più significativo è forse altrove: l’IA è stata utilizzata per progettare il chip e scriverne i kernel, con l’avvio della produzione in nove mesi e implementazioni generate che superano quelle di esperti umani sui blocchi selezionati. Il cerchio si chiude: i modelli progettano l’hardware che li farà funzionare.
L’IA torna sul dispositivo e i numeri cominciano a confermarlo. Tre segnali nello stesso giorno vanno nella stessa direzione. Perplexity esegue l’intero agente in locale su un DGX Spark, senza consumare crediti, con un’escalation al cloud che resta una decisione dell’utente. Multiverse Computing pubblica un metodo con cui un modello a 4 bit eguaglia o supera la propria sorgente a precisione piena, eliminando la consueta obiezione alla quantizzazione aggressiva. Au-Zone pubblica misurazioni della visione per il silicio embedded, contestando il fatto che i TOPS dichiarati non dicano nulla su ciò che un determinato modello farà realmente. Nessuno di questi tre lavori sostiene di eguagliare il frontier: il dato onesto di Perplexity è il 59,6% in locale contro l’82,4% ottenuto dal solo Claude Opus 5 su Terminal Bench 2.1. Ma l’escalation verso un modello di consulenza recupera tre quinti del divario a due terzi del costo, ed è questo compromesso, più della parità, a rendere difendibile l’esecuzione locale.
L’apertura dei pesi si afferma come posizione di riferimento. L’analisi di 500.000 articoli arXiv ripresa da Qwen documenta un’inversione già percepibile: i modelli aperti cinesi sono passati dal 10% a circa il 40% delle menzioni, mentre i modelli aperti statunitensi ristagnano tra il 25 e il 30%. Qwen3.8-27B che entra nella top 10 di Code Arena come unico modello delle sue dimensioni, GLM-5.3 che superava GPT-5.6 Sol e Claude Fable 5 su DeepSWE in prove multiple a un costo da 2,1 a 5,4 volte inferiore, IBM che rende aperto Granite 4.2 con quattro varianti quantizzate e quattordici formati GGUF fin dal primo giorno: si ripete la stessa logica. Aprire i pesi non è più un tentativo di recuperare terreno, ma un modo per diventare l’infrastruttura predefinita degli altri, con la precisazione formulata dallo stesso Nathan Lambert: le pubblicazioni arrivano in ritardo rispetto ai rilasci e queste curve descrivono i lavori in corso più che le preferenze del momento.
E il web si prepara a essere letto dagli agenti anziché dagli occhi. Il WebMCP Challenge è un concorso con un montepremi di 35.000 dollari, una cifra modesta; ciò che rivela vale di più. Chrome, Cloudflare, Shopify, Vercel, Render e Netlify si allineano con OpenAI su uno standard che richiede ai siti di esporre strumenti strutturati anziché lasciare che gli agenti debbano interpretare un’interfaccia. Nello stesso giorno, ChatGPT desktop è in grado di utilizzare WebMCP in modo nativo, Codex sa produrre e distribuire un’applicazione compatibile e OpenAI documenta il proprio uso interno del protocollo in uno strumento per notebook. Questa convergenza coincide con quanto Rohlik descrive dal canto suo, con oltre cinquanta integrazioni MCP e il principio secondo cui ogni nuovo strumento deve essere accessibile agli agenti fin dal primo giorno. Il livello di interfaccia per gli agenti smette di essere un tema di ricerca e diventa un requisito ingegneristico.
Fonti
- OpenAI — WebMCP Challenge
- OpenAI — annuncio del WebMCP Challenge su X
- OpenAI — WebMCP in ChatGPT desktop e Sites
- OpenAI — automatizzare il lavoro ripetitivo con Codex, Runme e WebMCP
- OpenAI — Jalapeño, primi risultati
- OpenAI — Lo stack completo alla base di un’intelligenza abbondante
- OpenAI — plugin Admin per ChatGPT Work e Codex
- OpenAI — estensione del browser ampliata a Edge, Brave, Opera e Vivaldi
- OpenAI — postazione Premium ChatGPT Business
- ChatGPT e Codex — registro delle modifiche
- Perplexity — lancio di Portable Computer
- Perplexity — articolo su Portable Computer
- Perplexity — benchmark dell’harness locale
- Anthropic — la memoria di Claude funziona ovunque
- Anthropic — annuncio della memoria su X
- Anthropic — CHANGELOG di Claude Code
- Anthropic — rendering in streaming 4 volte più fluido
- Anthropic — borse di ricerca sul benessere
- Anthropic — Bain & Company entra nel Claude Partner Network
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — guida a gr.Workflow
- FINAL-Bench — concorso FINCHAL
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B per il fine-tuning e l’inferenza dedicata
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — registro delle modifiche di Antigravity
- Google — dettatura intelligente di Gemini per macOS
- Stability AI — Serie B da 76 milioni di dollari
- Stability AI — annuncio su X
- NVIDIA — Gamescom e RTX Spark
- MiniMax — SANA e Sol Engine su H3
- MiniMax — indice delle integrazioni di H3
- NVIDIA — sessione Nemotron Labs sull’instradamento dei modelli aperti
- Qwen — Qwen3.8-27B su Code Arena WebDev
- Qwen — rilancio dell’analisi di arXiv
- Nathan Lambert — 500.000 articoli arXiv passati al setaccio
- Warp — formato factory.yaml e accesso anticipato
- Cognition — caso di studio Rohlik Group
- Devin — pagina cliente di Rohlik Group
- Amp — spiegazione degli orb
- GitHub — quattro nuovi esercizi GitHub Skills
- GitHub — scheda Customize disponibile per tutti
- GitHub — eccezioni di percorso nelle push rules
- GitHub — blocco da un avviso di sicurezza
- Manus — aggiornamento sul ripristino dei dati
- ElevenLabs — Composer
- HeyGen — concorrenza illimitata su LiveAvatar
- Kling — guide sul server MCP
- Runway — Wan 3.0 disponibile sulla piattaforma
- Runway — nuovi relatori dell’AI Summit
- Luma — Dream Lab Weekly
- xAI — Grok 4.6 in OpenCode Go
- OpenCode — Grok 4.6 nel piano Go
- xAI — concorso Grok Imagine sull’Odissea
- Cohere — Stato dell’adozione dell’IA sovrana nel 2026