ai-powered-markdown-translatorArtigo traduzido do fr para o pt com o gpt-5.6-sol.
Cinquenta e um anúncios em vinte e quatro horas, distribuídos por nove áreas: o dia 25 de agosto é o mais movimentado da semana. Quatro movimentos destacam-se. A OpenAI publica os primeiros resultados medidos do Jalapeño, o seu chip de inferência desenvolvido internamente, e lança logo de seguida um hackathon de dez dias em torno do WebMCP com Chrome, Cloudflare, Shopify, Vercel, Render e Netlify. A Perplexity transfere a totalidade do seu agente Computer para a máquina do utilizador. A IBM abre o Granite 4.2, a sua primeira família de modelos de raciocínio. E a Anthropic unifica a memória do Claude entre o chat e o Cowork, tornando-a legível e modificável ficheiro a ficheiro. O restante — WeatherNext Cyclones em funcionamento no National Hurricane Center, a Série B da Stability AI, cerca de vinte atualizações de ferramentas — segue abaixo.
WebMCP: um padrão, o seu suporte em produtos, a sua utilização interna e um concurso para o impulsionar
25 de agosto — A OpenAI lança o WebMCP Challenge, um hackathon de dez dias dedicado a um padrão aberto ainda experimental que muda a forma como os agentes interagem com a web. O problema visado é concreto: atualmente, um agente que precisa de executar uma tarefa num site tem de adivinhar como navegar numa interface concebida para olhos e um rato. O WebMCP inverte a lógica: o próprio site disponibiliza ferramentas estruturadas que o agente invoca diretamente.
O concurso não é o aspeto mais notável do anúncio. É o alinhamento que revela: Chrome (Google), Cloudflare, Shopify, Vercel, Render e Netlify associam-se todos à OpenAI em torno do mesmo padrão. A composição do júri reflete-o, com Sarah Drasner (Distinguished Engineer, Chrome), Andrew Galloni (VP Research & Innovation, Cloudflare), Jude Gao (equipa Next.js Core, Vercel), Ilya Grigorik (Distinguished Engineer, Shopify), Sean Roberts (VP of Applied AI, Netlify), Justin Rushing (Browser Agent Lead, OpenAI) e Alex Nahas, criador do MCP-B.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇵🇹 O WebMCP Challenge foi lançado. Associámo-nos a @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render e @Netlify para um hackathon de dez dias. Em jogo: 35 000 dólares em prémios monetários, Codex Micro, subscrições ChatGPT Pro e outros prémios oferecidos pelos nossos parceiros. — @OpenAIDevs no X
O calendário é apertado e os critérios de avaliação são explícitos: utilidade, originalidade, execução, utilização ponderada do WebMCP e qualidade da experiência entre humanos e agentes. As inscrições e submissões são feitas através do Devpost. A OpenAI também publica aplicações de demonstração nativas para agentes, destinadas a dar o impulso inicial aos projetos — modelação 3D controlada pelo agente, escrita colaborativa na qual o agente comenta sob a sua própria identidade, gerador de palavras cruzadas personalizadas, Wandernote para transformar notas de viagem num itinerário e exploração de dados através do DuckDB-Wasm no navegador. É permitido partir de uma aplicação existente e adicionar-lhe o WebMCP.
| Elemento do concurso | Detalhe anunciado |
|---|---|
| Duração anunciada | 10 dias |
| Abertura das submissões | 25 de agosto de 2026, 12 h PT |
| Prazo de submissão | 3 de setembro de 2026, 13 h PT |
| Anúncio dos vencedores | 23 de setembro de 2026 (data indicativa) |
| Dotação total | 35 000 dólares |
| Prémio por vencedor (top 10) | 3 000 dólares, um ano de ChatGPT Pro, um teclado Codex Micro, brindes |
| Plataforma de submissão | Devpost |
O componente de produto que torna o padrão utilizável diariamente chega no mesmo dia: o navegador integrado na aplicação desktop ChatGPT e o ChatGPT Sites conseguem agora utilizar o WebMCP. Quando o ChatGPT ou o Codex visita um site compatível, o agente deteta as ferramentas disponibilizadas pela página e utiliza-as automaticamente, em vez de avançar por tentativa e erro na interface — é necessário atualizar para a versão mais recente da aplicação desktop. A outra metade do ciclo está do lado da produção: passa a ser possível pedir ao Codex que crie uma aplicação compatível com WebMCP e depois a implemente diretamente no Sites. Importa assinalar a assimetria do suporte em relação ao Chrome, onde o WebMCP permanece sujeito a uma flag experimental ou a um teste de origem (origin trial), enquanto o navegador do ChatGPT o suporta nativamente.
Resta a terceira vertente, a mais elucidativa: a OpenAI documenta a sua própria utilização interna. Um engenheiro da empresa conta como deixou de escrever uma automatização por tarefa para criar o Runme, uma aplicação web open source de notebooks concebida para colaborar com o Codex. Nela, escreve um objetivo curto com instruções explícitas — consultar uma execução anterior, elaborar um plano detalhado, aguardar validação antes de começar, documentar os comandos executados e a respetiva interpretação — e o Codex lê e atualiza o notebook à medida que o trabalho avança. Duas opções de arquitetura merecem atenção. Primeiro, a persistência: os notebooks são guardados no Google Drive e, em paralelo, o Runme gera um índice Markdown complementar *.index.md que o Drive consegue indexar, permitindo que um agente encontre uma execução anterior como contexto operacional. Depois, a disponibilização das capacidades: o Runme é uma aplicação cliente servida estaticamente, e adicionar um servidor apenas para disponibilizar um endpoint MCP clássico teria introduzido infraestrutura e deslocado o processamento dos dados do notebook. O WebMCP permite que a aplicação registe as suas ferramentas diretamente a partir do navegador.
🔗 WebMCP Challenge · Suporte no ChatGPT desktop e no Sites · Codex, Runme e WebMCP na OpenAI
Jalapeño: a OpenAI publica os primeiros resultados do seu chip de inferência e assume a sua estratégia de compute
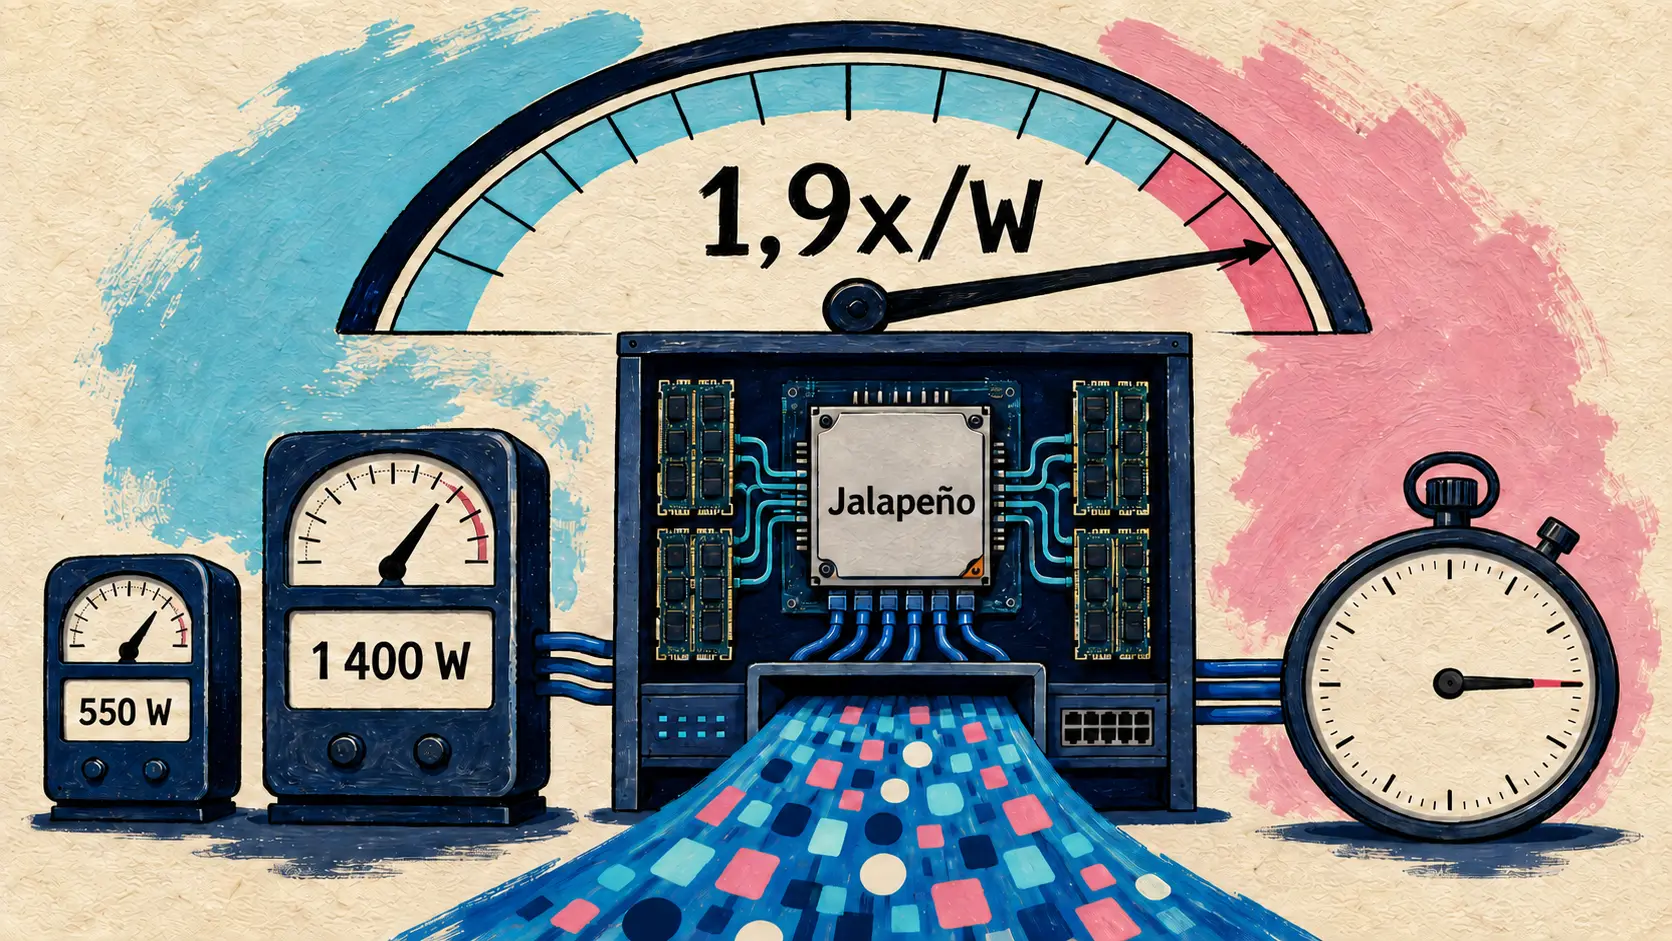
25 de agosto — A OpenAI publica os primeiros resultados medidos do Jalapeño, o primeiro chip de inferência concebido pela própria empresa. O interesse do anúncio não reside apenas nos ganhos brutos, mas também na natureza do compromisso que afirma superar: os sistemas de inferência existentes têm geralmente de escolher entre throughput e latência, enquanto o Jalapeño reivindica ambos numa única arquitetura.
As medições baseiam-se no InferenceX, um benchmark público da SemiAnalysis que simula o processamento completo de um pedido. Foram testados três modelos abertos — GPT-OSS 120B, DeepSeek R1 670B e Kimi K2.5 1T — face a sistemas comerciais. A opção de normalizar por watt, em vez de por chip, é explícita e conveniente: o Jalapeño consome metade da energia dos sistemas com os quais é comparado. O Jalapeño é anunciado com 700 W, e o consumo sustentado medido manteve-se em 550 W ou menos nas cargas testadas, contra 1 200 W para o GB200 e 1 400 W para o GB300.
| Modelo avaliado (sistema comparado) | Throughput máximo por kW | Latência de ponta a ponta | TBT mínimo |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
No conjunto dos três modelos, a OpenAI anuncia entre 1,5 e 1,9 vezes mais trabalho de IA por watt no throughput máximo e entre 1,7 e 3,6 vezes menos latência de ponta a ponta do que os sistemas comparativos, bem como um desempenho até 2,1 a 4,1 vezes superior em cargas altamente interativas. Tecnicamente, os ganhos resultam de uma conceção conjunta do chip, da memória, da rede, do software e do sistema à escala do rack. A inferência atravessa duas fases com estrangulamentos diferentes: o pré-preenchimento (prefill), que processa o prompt e satura a capacidade de computação, e a geração (decode), que produz os tokens um a um e depende sobretudo da largura de banda da memória. O Jalapeño procura minimizar a movimentação de dados, podendo o estado do modelo — incluindo a cache KV — ser colocado explicitamente e mantido localmente enquanto o sistema ativa a combinação adequada de computação, memória e rede consoante a fase.
A vertente mais interessante para um programador diz respeito ao papel da IA na conceção do próprio chip. A OpenAI afirma ter passado da conceção inicial ao envio para fabrico (tapeout) em nove meses, encurtando os ciclos de conceção, medição e verificação. O chip foi concebido como um alvo de programação previsível tanto para a IA como para os humanos: trabalho descrito através de tensores locais, comunicação explícita e sincronização previsível. Com o Codex e o GPT-Astra, a equipa adaptou em dois meses três modelos de pesos abertos ausentes do plano de produção inicial e, em blocos selecionados de attention e mixture-of-experts do GPT-OSS, os kernels gerados por IA são executados entre 1,5 e 1,8 vezes mais depressa do que as implementações escritas por especialistas humanos. A ressalva deve ser preservada: estes números dizem respeito aos blocos selecionados, não ao modelo completo. O calendário continua prudente — qualificação para produção em curso, software ainda por amadurecer, implementação na infraestrutura da OpenAI anunciada para o final do ano, Gen 2 em desenvolvimento avançado e Gen 3 a tomar forma.
No mesmo dia, Sarah Friar publica o artigo que apresenta a lógica económica subjacente a tudo isto. Nele, defende um portefólio de compute amplo — assente na Microsoft e na NVIDIA, complementadas por AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy e SoftBank — com um argumento tanto comercial como técnico: preservar uma escolha credível entre fornecedores permite encaminhar cada carga de trabalho para a melhor relação desempenho-preço e manter uma disciplina de preços. O texto inclui um número concreto: no Artificial Analysis Coding Agent Index, o GPT-5.6 Sol com raciocínio máximo alcança um novo recorde, consumindo simultaneamente menos 54% de tokens de saída do que outro modelo de referência. Por fim, o texto assume o paradoxo de Jevons — tornar a inteligência mais barata não reduz o seu consumo; amplia o leque de utilizações rentáveis. No que respeita à infraestrutura, o Project Camellia, na Geórgia, é apresentado com um circuito fechado de água e compromissos sujeitos a uma auditoria pública independente anual. A OpenAI esclarece que continuará a implementar amplamente os aceleradores da NVIDIA e dos seus outros parceiros, tanto para treino como para inferência.
🔗 Jalapeño — primeiros resultados · A stack completa por detrás de uma inteligência abundante
Perplexity Portable Computer: tudo é executado na máquina, com benchmarks que o comprovam
25 de agosto — A Perplexity lança o Portable Computer, uma versão do seu agente Computer que é executada integralmente na máquina do utilizador. A mudança é mais arquitetónica do que cosmética: não é apenas o modelo que funciona localmente, mas toda a cadeia de orquestração — orquestrador, planeador, router de ferramentas, scheduler, fila de tarefas persistente e índice de pesquisa local.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇵🇹 Lançamos hoje o Portable Computer no @NVIDIA DGX Spark. O Portable Computer é uma versão totalmente local do Perplexity Computer, na qual todo o ambiente de execução — o LLM orquestrador, o LLM dos subagentes e o harness do agente — funciona no seu hardware local. Sem qualquer dependência da cloud. — @perplexity_ai no X
O anúncio é feito em conjunto com a NVIDIA e visa inicialmente o DGX Spark — plataforma Grace Blackwell GB10, CPU Arm de 20 núcleos, GPU NVIDIA, 128 GB de memória unificada — com uma expansão anunciada para PCs equipados com GPU RTX. São propostos dois modelos à escolha, Qwen 3.8 27B ou PPLX 27B, a versão pós-treinada pela Perplexity do modelo Qwen, e o NVIDIA Nemotron 3.5 Lightning, um modelo aberto de 30B, deverá juntar-se ao seletor. O trabalho processado localmente não consome créditos. A escalada para a cloud continua a ser possível — informações atualizadas, browser, aplicações ligadas ou um dos mais de 15 modelos frontier — mas está sujeita à autorização explícita do utilizador. Os conectores Google Drive, Gmail, Slack e GitHub funcionam a partir do dispositivo, o ditado é executado localmente através do NVIDIA Nemotron 3.5 ASR Model sem que o áudio saia da máquina, e a execução de código ocorre numa sandbox isolada. O Portable Computer está reservado aos subscritores Pro e Max que disponham de um DGX Spark, primeiro em Linux e depois em Windows, com instalação num clique a partir da aplicação.
No mesmo dia, a equipa de engenharia publica os números que documentam este lançamento. A tese é que o modelo e o harness devem ser concebidos em conjunto: os harnesses genéricos pressupõem um modelo frontier capaz de absorver contextos longos e planear a longo prazo, algo que os modelos locais têm dificuldade em fazer.
| Benchmark medido | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench (53 tarefas) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp (1 266 tarefas) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100 (documentos multimodais) | 65,1 % | 13,9 % | 34,6 % | — |
No BrowseComp, o Computer consome ainda 61 % menos tempo e 16 % menos tokens do que o Hermes, e 51 % menos tempo e 70 % menos tokens do que o Pi. Quatro opções de conceção explicam a diferença: um prompt de sistema mínimo, capacidades modularizadas em skills carregadas e descarregadas ao longo da trajetória, conectores muito utilizados (Gmail, GitHub, Outlook, Google Calendar) convertidos em ferramentas de linha de comandos compactas em vez de expostos como servidores MCP cujas definições consomem o contexto, e uma sandbox sempre ativa e não configurável — se estiver indisponível, o harness desativa-se antes de qualquer chamada de ferramenta, em vez de passar para uma execução não isolada. A Perplexity assinala também uma constatação prática útil: o Qwen 3.8 27B anuncia uma janela de 260K tokens, mas começa empiricamente a ter dificuldades acima dos 100K.
| Terminal Bench 2.1 (89 tarefas) | Pontuação | Custo da API por execução |
|---|---|---|
| Qwen 3.8 27B, 100 % local | 59,6 % | cerca de 0 |
| Qwen 3.8 27B + conselho Claude Opus 5 | 73,0 % | 0,415 USD |
| Apenas Claude Opus 5 | 82,4 % | 0,65 USD |
O mecanismo de escalada para um modelo consultor (advisor) é o ponto mais interessante do relatório: recupera cerca de três quintos da diferença em relação ao frontier por aproximadamente dois terços do seu custo, e a decisão permanece nas mãos do utilizador. Antes de cada chamada, o harness seleciona o contexto relevante, aplica um classificador de dados pessoais e mostra ao utilizador o que sairia do dispositivo; o modelo consultor devolve apenas texto e não tem qualquer acesso direto aos ficheiros nem às ferramentas. Por fim, o pós-treino do PPLX 27B combina um ajuste fino por rejeição (rejection fine-tuning) seguido de aprendizagem por reforço em ambientes sintéticos executados em contentores Docker, sem quaisquer dados reais de utilizadores. São anunciados um relatório técnico e a disponibilização em open source do benchmark de avaliação.
🔗 Benchmarks do harness local · Portable Computer — publicação da Perplexity
Claude: uma única memória entre o chat e o Cowork, legível ficheiro a ficheiro
25 de agosto — A Anthropic elimina a fronteira entre duas memórias que coexistiam até agora. Aquilo que o Claude retém das suas conversas no chat é agora exatamente o que tem disponível no Claude Cowork, e o inverso também é verdade. Na prática, quando o Cowork executa uma tarefa na cloud, começa com o contexto acumulado ao longo dos meses: as prioridades do trimestre, o estado de progresso dos projetos e as preferências de redação de um interlocutor. A Anthropic apresenta exemplos deliberadamente prosaicos — pedir uma atualização de progresso para o seu responsável sem ter de especificar de quem se trata nem como essa pessoa prefere receber a informação.
A segunda alteração é mais discreta, mas modifica o comportamento quotidiano: a memória é atualizada ao longo da conversa, em vez de através de um resumo produzido posteriormente. Basta mencionar que um prazo foi adiado para setembro para que a conversa seguinte tenha isso em conta. A fórmula «lembra-te disto» continua disponível para forçar o registo de um elemento específico, e a memória pode ser colocada em pausa ou reinicializada a qualquer momento.
Em termos de transparência, a Anthropic escolheu uma representação legível em vez de uma caixa negra: tudo o que o Claude retém aparece sob a forma de ficheiros curtos, organizados por assunto, em Definições e depois Memória. Cada um pode ser lido, corrigido ou eliminado. A utilidade prática é imediata — basta corrigir o nome antigo da sua empresa num único ficheiro para que todas as conversas seguintes utilizem o nome correto.
O tratamento de temas sensíveis é o ponto mais interessante ao nível das escolhas de produto. Por predefinição, o Claude não memoriza o que esteja relacionado com saúde, origem, etnia, crenças religiosas, opiniões políticas ou identidade de género. A Anthropic reconhece, contudo, que esta fronteira é pessoal e propõe uma definição opcional para incluir estes temas — permitindo que o Claude se lembre de uma intolerância ao glúten ao sugerir receitas. Esta definição não é retroativa e pode ser desativada a qualquer momento. Uma categoria permanece excluída, independentemente da definição: números de identificação, antecedentes criminais, estatuto migratório e, de forma mais geral, tudo o que viole a Política de Utilização Aceitável. O Claude indica explicitamente quando não pode registar uma informação deste tipo, uma escolha de conceção que privilegia a recusa visível em detrimento da filtragem silenciosa.
| Aspeto da memória | Comportamento descrito |
|---|---|
| Âmbito | Memória única partilhada entre o chat e o Claude Cowork |
| Momento da atualização | Durante a conversa, em vez de um resumo após o fim, como anteriormente |
| Formato de armazenamento | Ficheiros curtos organizados por assunto, legíveis e editáveis individualmente |
| Temas sensíveis | Não memorizados por predefinição, ativáveis por definição, sem efeito retroativo |
| Exclusões permanentes | Números de identificação, antecedentes criminais, estatuto migratório |
| Planos Free, Pro e Max | Memória ativa por predefinição na web, no desktop e em dispositivos móveis |
| Planos Team e Enterprise | Disponibilizada pelo administrador, desativada por utilizador até à ativação |
🔗 A memória do Claude funciona em todo o lado · Anúncio de @claudeai
IBM abre o Granite 4.2, a sua primeira família de raciocínio, e dois modelos ASR de 470M
25 de agosto — A IBM publica o Granite 4.2, apresentado como a sua primeira família de modelos de linguagem densos, apenas com decoder, explicitamente concebidos para o raciocínio. Enquanto as gerações anteriores visavam a eficiência e as tarefas empresariais clássicas, esta versão coloca o raciocínio no centro e torna-o ajustável: cada modelo disponibiliza três modos — thinking, non-thinking e low-effort — que a aplicação escolhe consoante o orçamento de latência e de tokens que aceita pagar. Os três tamanhos (3B, 8B, 30B) partilham a mesma arquitetura e o mesmo pipeline, o que torna indolor a passagem de um para outro ao nível da integração.
A arquitetura permanece clássica: atenção GQA com 40 cabeças para 8 cabeças KV, RoPE com um θ de 10 milhões para suportar os 131 072 tokens de contexto, MLP SwiGLU, normalização RMSNorm e treino em bfloat16 num cluster NVIDIA GB200 NVL72 alojado pela CoreWeave. O pré-treino começa do zero com cerca de 15 biliões de tokens distribuídos por cinco fases. O que realmente distingue o Granite 4.2 é o pós-treino: um pipeline de reforço numa cadeia de etapas especializadas, em vez de uma única passagem, com GRPO assíncrono e amostragem de importância truncada, para que as metades de geração e treino do ciclo nunca se bloqueiem mutuamente. O currículo encadeia três passagens de RLVR com recompensas verificáveis, amplificadores direcionados para o seguimento de instruções e o código, duas etapas de software engineering em contexto 128K, uma etapa de terminal, uma etapa de pesquisa e, por fim, o alinhamento RLHF. O bloco de reforço agêntico é aplicado apenas aos modelos 8B e 30B, o que explica a diferença de desempenho em programação agêntica entre o 3B e os seus irmãos maiores.
| Benchmark publicado pela IBM | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
A publicação não se limita aos pesos bfloat16: quatro variantes quantizadas acompanham o lançamento para vLLM — FP8 dinâmico por canal sem calibração, NVFP4 e MXFP4 através de GPTQ calibrado com 2 000 amostras SFT — bem como catorze formatos GGUF para llama.cpp, de Q2_K a Q8_0. São suportadas doze línguas, incluindo o francês, e três harnesses de programação agêntica estão documentados desde o primeiro dia: OpenCode, Pi e OpenHands. Quanto à qualidade dos dados, a IBM detalha uma cadeia na qual GPT-OSS-120B e Gemma 4 atuam como avaliadores para classificar as amostras SFT, antes de uma desduplicação local e global através de hashing SHA-256.
No mesmo dia, a IBM publica o Granite Speech 5.0 Turbo CTC, dois modelos de reconhecimento de voz em inglês com 470 milhões de parâmetros que diferem apenas nos dados de treino e na licença — Apache 2.0 para a variante padrão, CC-BY-NC-SA-4.0 para a variante treinada com dados adicionais. A mudança de arquitetura é significativa: os modelos Granite Speech anteriores combinavam um encoder acústico, um projetor e um LLM; estes são apenas encoder. A stack reúne 16 blocos Conformer, aplica autocondicionamento à saída do oitavo bloco, substitui a atenção de produto escalar por atenção em blocos (chunkwise) para evitar a escalabilidade quadrática e otimiza diretamente a perda CTC. A verdadeira novidade é a taxa de tokens: operações de subamostragem reduzem o fluxo de 100 frames por segundo à saída do espectrograma log-Mel para 12,5 por segundo, o que explica o «Turbo» do nome. Os resultados são apresentados no OpenASR Leaderboard e no FFASR Leaderboard para campo distante, com gráficos de Pareto de velocidade/precisão em vez de pontuações isoladas, e uma demonstração de reconhecimento contínuo executada no browser através de WebGPU, limitada ao Chrome e ao Edge.
🔗 Granite 4.2 — percurso técnico · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, primeiro modelo de IA utilizado em tempo real pelo National Hurricane Center
25 de agosto — A Google AI detalha o WeatherNext Cyclones, um modelo de previsão de ciclones tropicais desenvolvido pela Google DeepMind e pela Google Research. O anúncio é notável menos pelo desempenho bruto do que pelo que revela sobre a passagem da IA meteorológica do laboratório para as operações.
O problema enfrentado é estrutural. Até agora, acompanhar um ciclone exigia uma escolha: os modelos físicos executados em supercomputadores captam bem as grandes estruturas atmosféricas que percorrem o planeta, mas compreender a física local e intensa que determina a força de uma tempestade obrigava a recorrer a modelos regionais completamente diferentes. O WeatherNext Cyclones elimina essa alternância ao prever, de uma só vez, a trajetória, a intensidade e o tamanho.
O ganho anunciado é de um dia inteiro de antecedência em relação aos sistemas anteriores. A Google apresenta a comparação de forma elucidativa: as previsões para três dias agora alcançam a precisão das antigas previsões para dois dias, um progresso que historicamente exigia uma década de avanços metodológicos. A segunda contribuição é probabilística: o modelo é rápido o suficiente para produzir até 1.000 simulações por tempestade, substituindo a trajetória única “mais provável” por uma variedade de cenários. Isso torna mais clara a intensificação rápida, definida por um aumento dos ventos máximos sustentados de pelo menos 30 nós em 24 horas. Este ano, 1.000 previsões probabilísticas por tempestade são fornecidas aos meteorologistas por meio do WeatherLab.
O elemento mais significativo continua sendo a implantação no mundo real. Durante a temporada de furacões de 2025, o WeatherNext Cyclones foi posto à prova no National Hurricane Center dos Estados Unidos — a primeira vez que essa instituição utiliza modelos de IA em operações em tempo real. Os meteorologistas recorreram a ele para elaborar a previsão da chegada à terra do furacão Melissa, de categoria 5, na Jamaica, dando às autoridades locais mais tempo de preparação. Um artigo foi publicado na Nature, e a Google anunciou a publicação do código e dos pesos do modelo em open source no GitHub.
| Aspecto do modelo | Contribuição do WeatherNext Cyclones |
|---|---|
| Grandezas previstas | Trajetória, intensidade e tamanho em uma única passagem |
| Ganho de antecedência | Um dia; previsão para 3 dias = precisão da antiga para 2 dias |
| Simulações por tempestade | Até 1.000 |
| Implantação operacional | U.S. National Hurricane Center, temporada de furacões de 2025 |
| Caso de uso documentado | Chegada à terra do furacão Melissa, de categoria 5, na Jamaica |
| Limiar de intensificação | Mais de 30 nós de ventos máximos sustentados em 24 horas |
| Formas de disponibilização | WeatherLab; código e pesos em open source no GitHub |
🔗 Anúncio da @GoogleAI · Publicação da Google DeepMind
Stability AI conclui uma Série B de 76 milhões de dólares com EA, Sony Music, Universal e Warner
25 de agosto — A Stability AI anuncia o fechamento de sua Série B: 76 milhões de dólares em capital novo, elevando o financiamento total para 232 milhões desde que Prem Akkaraju assumiu o comando da empresa em junho de 2024, incluindo duas rodadas de ações e obrigações convertíveis. O valor continua modesto para os padrões do setor, mas a composição da rodada é o verdadeiro destaque.
Quatro gigantes do entretenimento passam a integrar o capital: Electronic Arts nos videojogos, Sony Music Group, Universal Music Group e Warner Music Group na música. As três grandes gravadoras são agora acionistas do mesmo laboratório. A elas somam-se AMD Ventures e Pacific Alliance Ventures. Esses investidores não surgiram do nada: EA, Universal e Warner já eram parceiras estratégicas da Stability AI desde o outono de 2025. A rodada transforma, portanto, acordos comerciais existentes em participações no capital.
Outro sinal é a fidelidade dos investidores financeiros. Coatue, Greycroft, Kadmos Capital, Sean Parker e Eric Schmidt voltam a investir pela segunda rodada consecutiva sob a nova direção — o que, após o período conturbado atravessado pela Stability AI em 2023 e 2024, representa uma confirmação. Thomas Laffont, cofundador da Coatue, entra para o conselho de administração, do qual já fazem parte James Cameron, Sean Parker, Dana Settle e Prem Akkaraju.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇵🇹 Este grupo incomparável de investidores confirma a nossa visão de uma IA generativa que capacita cada produtor, músico e contador de histórias. A Stability é única no campo da IA porque somos criativos que desenvolvem ferramentas para criativos. — Prem Akkaraju, CEO da Stability AI, comunicado de 25 de agosto
A estratégia assumida é a de um laboratório de nicho: nenhum modelo generalista, mas ferramentas para profissionais da criação, desenvolvidas com os detentores de direitos, e não contra eles. Essa é exatamente a orientação do Stable Audio 3.0, família de modelos com pesos abertos treinada com dados totalmente licenciados, ampliada em 18 de agosto por um plugin para estações de trabalho de áudio. O dinheiro deverá financiar a evolução dos produtos, a pesquisa aplicada e a divisão de serviços profissionais.
ChatGPT para empresas: plugin Admin, extensão para vários navegadores e licença Premium de 100 dólares
25 de agosto — Três anúncios da OpenAI convergem para o mesmo público: as organizações que implantam o ChatGPT e o Codex em grande escala.
O mais substancial é o plugin Admin para ChatGPT Work e Codex, que reúne numa conversa o que até agora exigia navegar entre painéis de analytics, ecrãs de configurações e relatórios. O âmbito abrange as tarefas quotidianas: compreender a adoção e o consumo de créditos, identificar membros ou grupos próximos dos seus limites, gerir entradas e saídas, examinar as permissões efetivas e diagnosticar um problema de acesso, ajustar os limites de utilização e avaliar os pedidos de despesas comparando-os com o consumo real. A parte mais interessante é a automação sem escrever código: os pedidos de utilização pendentes podem ser encaminhados para o Slack ou o Microsoft Teams para aprovação na ferramenta que os responsáveis já utilizam, e os pedidos de acesso a uma funcionalidade podem ser aprovados automaticamente quando cumprem critérios predefinidos, sendo as exceções encaminhadas para uma pessoa. Um ponto fundamental em termos de segurança: o plugin opera dentro da função e das permissões existentes do utilizador e não amplia qualquer acesso, com cada instrução mapeada para uma ação de leitura ou escrita suportada e um resultado estruturado. A OpenAI cita a sua própria utilização — um agente do ChatGPT Work no Slack processa os pedidos internos de TI, e os fluxos de trabalho implantados resolvem cerca de 45% do volume de tickets, eliminando o backlog apesar de o volume de suporte ter aproximadamente duplicado.
Segundo anúncio: a extensão de navegador do ChatGPT deixa de estar limitada ao Chrome e passa a ser compatível com Microsoft Edge, Brave, Opera e Vivaldi. A mudança é importante para quem trabalha num navegador alternativo por razões de privacidade ou devido a restrições empresariais. Dois usos são destacados: levar o contexto dos separadores abertos para uma tarefa por meio da menção @ tab no ChatGPT Desktop, para que o Codex trabalhe com base na documentação ou no ticket já apresentados; e permitir que o agente controle o navegador para executar tarefas concretas na web, com o cancelamento de assinaturas entre os exemplos fornecidos.
Terceiro anúncio, mais lacónico: uma licença Premium de 100 dólares passa a integrar a oferta ChatGPT Business, destinada a pequenas empresas e startups, com um plano apresentado como flexível e escalável de acordo com o tamanho da equipa. O anúncio foi feito no X sem uma publicação detalhada no blog, e a composição exata da licença não é especificada na mensagem.
🔗 Plugin Admin · Extensão para vários navegadores · Licença Premium do ChatGPT Business
NVIDIA: Gamescom para o RTX Spark e SANA reduz em 27 vezes a latência do MiniMax H3
25 de agosto — A NVIDIA aproveita a Gamescom, realizada esta semana em Colónia, para ampliar o catálogo do RTX Spark, a sua plataforma para PC Windows prevista para este outono. Electronic Arts, Embark Studios e Ubisoft juntam-se à KRAFTON, NetEase, Riot Games e XBOX, que já se tinham comprometido durante a COMPUTEX, em maio. Os títulos mencionados abrangem diferentes requisitos técnicos: EA SPORTS F1 25 e Apex Legends, da EA, Anno 117: Pax Romana, da Ubisoft, e ARC Raiders e THE FINALS, da Embark Studios.
O ponto mais concreto diz respeito ao sistema antitrapaça. Executar um jogo não é suficiente: os grandes títulos online dependem de sistemas antitrapaça que precisam de ser adaptados a cada plataforma, caso contrário o jogo fica inutilizável no modo multijogador. A NVIDIA anuncia que está a trabalhar com a EA para levar o EA Javelin Anticheat nativamente ao RTX Spark — o tipo de detalhe de infraestrutura que determina a adoção real de uma nova plataforma para PC. No campo da renderização, o DLSS 4.5 Ray Reconstruction está disponível de imediato, com um modelo transformer de segunda geração que substitui os removedores de ruído clássicos por uma rede treinada num supercomputador. O path tracing chega a CONTROL Resonant e 007 First Light, Gears of War: E-Day integra RTX Mega Geometry, e as tecnologias NVIDIA ACE são anunciadas para Aniimo no início de 2027.
A outra faceta da mesma empresa, em 24 de agosto, é mais técnica. A MiniMax divulga os resultados obtidos pela equipa SANA da NVIDIA com o Sol Engine aplicado ao seu modelo de vídeo H3: dez segundos de vídeo em 768p gerados num único GB200 passam de 414 segundos para 14,93 segundos, uma aceleração de 27,7 vezes. O método não se baseia numa otimização de kernels, mas na divisão da geração em duas passagens — um rascunho em baixa resolução produzido pelo H3 em 4 etapas, seguido de uma passagem de refinamento na resolução de destino, executada pelo LTX em 3 etapas com Sol-Attn. Sete etapas no total. Como segundo recurso, as dispendiosas decodificações VAE são substituídas por TAEH3 e TAEHV, decodificadores mais leves, mantendo os latents estáveis para a passagem de refinamento.
| Medição no MiniMax H3 | Valor medido |
|---|---|
| Carga medida | 10 s de vídeo em 768p, um único GB200 |
| Latência anterior | 414 s |
| Latência posterior | 14,93 s |
| Fator de aceleração | 27,7x |
| Etapas de geração | 4 (rascunho H3 em baixa resolução) + 3 (LTX) |
| Decodificadores substituídos | TAEH3 e TAEHV em substituição das decodificações VAE |
| Débito projetado por nó | 378.000 vídeos por mês, mais de 97% de margem de GPU |
O débito projetado é uma estimativa da MiniMax, e não uma medição de produção, devendo ser interpretado como tal. Mas a direção é clara: com quinze segundos para gerar dez segundos de vídeo, a geração de vídeo de alta fidelidade deixa a renderização assíncrona em lotes e avança para uma infraestrutura quase interativa.
🔗 NVIDIA na Gamescom · SANA e Sol Engine no H3
Modelos abertos chineses tornam-se referência na pesquisa, e Qwen3.8-27B entra no top 10 do Code Arena
25 de agosto — A Qwen divulga dois resultados na mesma manhã, e o segundo dá sentido ao primeiro.
O primeiro é uma classificação. O Qwen3.8-27B entra na classificação Code Arena: WebDev, que avalia os modelos na geração de interfaces web, em 9.º lugar no geral, com 1595 pontos. É o único modelo da sua categoria de tamanho no top 10 e está apenas seis posições atrás do Qwen3.8-Max, muito maior. A Arena destaca que ele redefine a fronteira de Pareto da classificação e fornece uma referência elucidativa: o Gemma 4-31B, de tamanho comparável, mas lançado em abril, ocupa o 80.º lugar.
| Modelo avaliado | Posição no Code Arena: WebDev | Pontos obtidos | Observação da classificação |
|---|---|---|---|
| GLM-5.3 (Max) | 8.º no geral | 1597 | Registo de 20 de agosto, 2.º entre os modelos abertos |
| Qwen3.8-27B | 9.º no geral | 1595 | Único modelo do seu tamanho no top 10 |
| Qwen3.8-Max | Seis posições à frente do 27B | n.c. | Modelo muito maior da mesma família |
| Gemma 4-31B | 80.º no geral | n.c. | Lançado em abril de 2026 |
O segundo resultado é uma medição de utilização. Nathan Lambert, que codirigiu o projeto Olmo na Ai2, fez com que o Codex analisasse 500.000 artigos do arXiv sobre IA e aprendizagem automática publicados desde o lançamento do ChatGPT, para identificar os modelos abertos efetivamente utilizados na pesquisa. A inversão resume-se a dois números: em 2024, cerca de 30% dos artigos mencionavam um modelo aberto americano, contra 10% que mencionavam um modelo chinês; hoje, cerca de 40% citam um LLM aberto chinês, e apenas 25% a 30% citam um americano.
| Família de modelos | Percentagem de artigos que citam um LLM |
|---|---|
| OpenAI (modelos fechados) | cerca de 37% |
| Qwen | cerca de 33% |
| Gemini, Claude | 10% a 15% |
| Gemma, Mistral | 5% a 10% |
| Olmo | cerca de 1% |
Em detalhe, o Qwen é mencionado num terço dos artigos que citam algum LLM. O Llama atingiu o seu pico por volta de abril de 2025, com 30%, precisamente quando o Llama 4 foi lançado, e vem recuando desde então. O próprio Lambert aponta uma limitação importante: as publicações estão atrasadas em relação aos lançamentos dos modelos, porque a pesquisa leva tempo — estes números descrevem o estado dos trabalhos em curso, e não as preferências do momento. Em paralelo, observa-se uma tendência de fundo, distinta da disputa entre modelos abertos e fechados: a percentagem de artigos de IA que mencionam um LLM passou de 10,43% em janeiro de 2023 para mais de 50% em 2026.
🔗 Qwen3.8-27B no Code Arena · Divulgação da análise do arXiv pela Qwen · Análise de @natolambert
Claude Code passa para a versão 2.1.245, e a renderização do Claude na web torna-se 4 vezes mais fluida
Duas versões do Claude Code foram lançadas nesse intervalo, e o seu conteúdo visa claramente as implementações em organizações. O CHANGELOG não apresenta datas, mas o histórico do Git permite situá-las: a 2.1.243 aparece no commit de 24 de agosto, às 23:40 UTC, e a 2.1.245 no de 25 de agosto, às 05:13 UTC.
| Configuração adicionada | Versão em questão | Utilidade prática |
|---|---|---|
modelPricing | 2.1.243 | Preços contratuais em /cost, na barra de estado e na telemetria |
modelPicker | 2.1.243 | Lista de modelos ordenada e etiquetada para /model |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | Cache de prompt de uma hora na conversa, 5 min nos subagents |
Detalhamento de Loops em /usage | 2.1.243 | Identificar as tarefas /loop que saem do rumo |
| Início de sessão sem chave pela Console | 2.1.243 | Organizações que proíbem chaves de API |
| Correção para glibc 2.44 | 2.1.245 | Falha ao iniciar no Arch Linux, CachyOS e Fedora Rawhide |
A configuração mais estrutural é modelPricing: até agora, os custos apresentados eram calculados com base no preço público; uma organização pode agora inserir os seus preços contratuais por modelo e o seu coeficiente de desconto, tornando os valores diretamente utilizáveis para a refaturação interna. A combinação de promptCacheTtl e subagentPromptCacheTtl aborda um compromisso económico concreto para os utilizadores de chaves de API: manter um cache de uma hora na conversa principal, onde o contexto permanece estável, deixando os subagents em cinco minutos, uma vez que os seus contextos são mais voláteis. Quanto às correções, os servidores MCP remotos em modo não interativo já não ficam bloqueados após uma interrupção, /resume já não se limita às cinquenta sessões mais recentes, e as sessões sem atividade há mais de dez minutos passam agora a expirar ao fim de cerca de três minutos antes de uma nova tentativa e de um erro explícito.
Em 24 de agosto, a Anthropic anunciou também ter reescrito o motor que apresenta as respostas em processo de geração no Claude para web e desktop. O princípio é clássico na renderização de interfaces: alterar apenas aquilo que ainda está a mudar, em vez de redesenhar toda a resposta a cada novo fragmento. Numa resposta longa, a diferença é estrutural — o custo da renderização deixa de aumentar com a extensão do texto já apresentado. Os ganhos anunciados são coerentes: cerca de 4 vezes mais fluidez, 9 vezes menos bloqueios num portátil pouco potente, o pior congelamento da interface 4,5 vezes mais curto e 120 imagens por segundo mantidas do início ao fim num MacBook de 120 Hz. O pormenor interessante é o público-alvo: são as configurações mais modestas que mais beneficiam.
🔗 CHANGELOG do Claude Code · Renderização 4x mais fluida, @ClaudeDevs
Os agentes de código industrializam-se: a Warp publica o formato das suas factories, a Rohlik faz com que agentes escrevam 90% do seu código
24 de agosto, ao fim do dia — a Warp revela o funcionamento interno do Warp Factories, a sua plataforma de agentes na cloud anunciada em 18 de agosto: o formato de configuração adotado e a abertura de um acesso antecipado. O ponto de partida é assumido — a Warp transfere os seus próprios agentes para fora das máquinas locais, por razões de qualidade e de custo, e precisava de descrever ambientes, harnesses e permissões de segurança como código com controlo de versões.
| Elemento de configuração | Valor adotado |
|---|---|
| Ficheiro de definição | factory.yaml, schemaVersion: v1alpha1 |
| Chaves principais | name, repositories (owner / name), agentDefaults.model |
| Definição de um agente | agents/<nom>/agent.md com agentType (FOREMAN, REVIEW…) e model |
| Acionadores | automations/<nom>/automation.md: agent, triggers (fornecedor, evento) |
| Interfaces disponíveis | CLI (warp agent run-cloud), API REST, SDK TypeScript, servidor MCP |
| Acesso antecipado | Até 10 000 USD de utilização oferecidos aos clientes qualificados |
A separação é interessante: os agentes não são descritos num único YAML, mas em ficheiros Markdown dedicados, pelo que a definição de um agente se torna um documento legível e comparável. A Warp aplica a receita a si própria — a sua factory interna, chamada «wilson», abrange repositórios como warp-server ou warp-terraform, declara os seus segredos e servidores MCP e organiza os seus agentes por função (code-review, foreman, implementation, spec, triage) em 34 linhas. Os números apresentados na página de pedido de acesso são argumentos comerciais que não podem ser verificados externamente: 200 000 execuções de agentes por dia, mais de 30% de pull requests integradas sem alterações e um custo 20% inferior por pull request.
Em 25 de agosto, a Cognition publicou, por sua vez, um estudo de caso muito mais documentado do que o anterior. O Rohlik Group é um distribuidor alimentar online nascido na República Checa, presente em cinco países, rentável, com mais de 1,3 mil milhões de dólares de volume de negócios no ano passado; entrega uma compra semanal completa de 17 000 produtos em menos de uma hora ou em janelas de quinze minutos. O número que estrutura o artigo: atualmente, cerca de 90% do código é gerado por agentes, e a organização de engenharia descreve-se como «agent-mostly».
Este não é um resultado obtido simplesmente ligando uma ferramenta. A Rohlik afirma ter começado há um ano, com uma primeira experiência com o Devin considerada repleta de erros. O que mudou o cenário foram as bases estabelecidas no lado do cliente: mais de cinquenta integrações MCP internas e externas, com o princípio de que qualquer nova ferramenta deve estar acessível aos agentes desde o primeiro dia, uma camada semântica sobre o data warehouse Snowflake e uma base de conhecimentos que fornece aos agentes o contexto que seria transmitido a um novo colega. O trabalho chega ao Devin a partir do local onde surge, seja uma conversa no Slack sobre um bug ou um documento de especificação no Linear, seguindo até à pull request. Os resultados reivindicados — throughput de engenharia duplicado desde novembro, integração da robótica AutoStore entregue em oito meses quando o setor demora entre dois e três anos, prototipagem reduzida de um mês para um dia — continuam a ser os de uma página de cliente publicada pelo fornecedor. O efeito mais revelador está noutro lugar: os melhores engenheiros passam agora 80% do seu tempo a rever código, e cerca de 30% da utilização do Devin na Rohlik corresponde à análise de dados por utilizadores de negócio.
🔗 Formato factory.yaml, @warpdotdev · Estudo de caso Rohlik, @cognition · Página de cliente do Devin
GitHub: quatro exercícios sobre workflows agentic e o separador Customize em disponibilidade geral
25 de agosto — o GitHub disponibilizou quatro novos exercícios na sua plataforma de aprendizagem GitHub Skills. A abordagem é explícita: em vez de documentar as novidades agentic do ano, o GitHub propõe praticá-las num repositório de demonstração, com instruções fornecidas progressivamente através de pull requests.
| Exercício publicado | Objetivo do exercício |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Agentes personalizados no Copilot CLI: planear, conceber, construir, validar, transmitir |
| Agentic Workflows that Read the Room | Extensão gh aw, workflow agentic em Markdown, alterações submetidas através de pull requests |
| Idea to Merge with the Copilot App | De uma sessão a uma pull request integrada, inteiramente na app GitHub Copilot |
| Ship with Quality | Sinais de qualidade automatizados, cobertura de testes, verificações obrigatórias nas pull requests |
O mais notável dos quatro é o primeiro: é a primeira vez que o GitHub propõe um percurso guiado sobre a orquestração multi-agent na sua CLI, um tema que até agora estava documentado apenas em prosa. O segundo introduz a extensão gh aw, com um ponto importante para a segurança — as alterações propostas pelo workflow passam por pull requests em vez de serem aplicadas diretamente, o que preserva um ponto de revisão humana.
No mesmo dia, a app GitHub Copilot recebeu um separador Customize em disponibilidade geral. A sua função é reunir numa única superfície os quatro mecanismos de extensão introduzidos separadamente nos últimos meses: servidores MCP, plugins, skills e canvases. Uma vista Featured apresenta uma seleção editorial de cada categoria para o utilizador que sabe o que pretende fazer, mas não que tipo de extensão responde à sua necessidade, e os servidores MCP beneficiam de uma navegação própria, com opções destacadas de acordo com a sua popularidade e um percurso por categoria. O changelog ilustra a utilidade dos canvases com um caso concreto: um canvas Azure DevOps para organizar as issues, dar prioridade a um backlog, atribuir os acompanhamentos e depois confiar uma tarefa ao Copilot para que investigue, implemente ou prepare a revisão.
🔗 Quatro exercícios GitHub Skills · Separador Customize em disponibilidade geral
As ferramentas da Google para programadores: Gemini CLI 0.57.0 e Antigravity 2.10.0
25 de agosto — a Google publicou a versão estável 0.57.0 do Gemini CLI, antecedida, quinze minutos antes, pela preview 0.58.0. O conteúdo desta versão revela menos sobre novas funcionalidades do que sobre a forma como a Google mantém a sua ferramenta: das 24 entradas do changelog, 13 têm o prefixo [SSR Agent] Issue Fix e remetem para números de issues frequentemente antigos, de 19239 a 28518. Estas correções abordam problemas acumulados no backlog — um bloqueio indefinido da interface do terminal, ao qual são adicionados tempos-limite, uma mensagem de erro de administração enganadora para contas pessoais, a ausência de espaço após as sugestões de preenchimento automático, a renderização do terminal que não era atualizada ao sair de um editor externo. Por outras palavras, a Google coloca um agente a trabalhar na sua própria dívida técnica e o resultado chega diretamente à versão estável.
| Versão publicada | Data e hora (UTC) | Canal de publicação | Pontos de destaque |
|---|---|---|---|
| v0.57.0 | 25 de agosto, 18:37:14 | Estável | 13 correções [SSR Agent], validação das evals, retries contextuais |
| v0.58.0-preview.0 | 25 de agosto, 18:22:01 | Preview | Isolamento Docker no perfil Seatbelt do macOS, verificadores de segurança |
Quanto às funcionalidades, o esforço centra-se na avaliação, com um comando de validação das evals e um formatador de chamadas de ferramentas que integra resumos de falhas. A fiabilidade também progride: os erros de capacidade acionam retries silenciosos que têm em conta o contexto, e o cancelamento de um pedido multi-turn provoca um rollback completo, em vez de deixar um estado parcial. Para quem procura as notas de versão, importa referir que o ficheiro docs/changelogs/index.md do repositório não foi atualizado para além da v0.54.0, de 6 de agosto.
Quatro dias depois da versão 2.9.1 e do seu Remote Control, o Google Antigravity passa para a versão 2.10.0 em 24 de agosto e colmata duas lacunas que obrigavam a sair da ferramenta: um terminal integrado e um controlo de versões Git nativo, ambos alojados diretamente na barra lateral. O agrupamento é coerente com a trajetória do produto — o Antigravity posiciona-se como um ambiente onde se coordenam agentes, em vez de se editar código linha a linha, mas ainda é necessário poder executar um comando e inspecionar um diff sem mudar de janela. O resto da versão amplia aquilo que pode ser submetido a um agente e aquilo que se vê do seu trabalho: os ficheiros de áudio juntam-se aos anexos aceites, os comentários interativos em imagens permitem anotar um elemento visual para orientar o agente, e as pré-visualizações enriquecidas da execução das ferramentas MCP tornam legível aquilo que um servidor de ferramentas realmente fez. A Google contabiliza 13 melhorias e 8 correções nesta versão, com uma implementação progressiva.
🔗 Gemini CLI v0.57.0 · Changelog do Antigravity
A Anthropic financia 5 milhões de dólares em avaliações independentes sobre o bem-estar
25 de agosto — a Anthropic lançou um programa de bolsas de 5 milhões de dólares destinado a financiar investigações independentes sobre o efeito da IA no bem-estar dos seus utilizadores. Os bolseiros recebem financiamento direto, acesso aos modelos e apoio técnico, mas trabalham com total independência: as suas avaliações são publicadas em open source e podem ser reutilizadas por toda a indústria. As candidaturas estão abertas até 21 de setembro, e os candidatos selecionados para apresentar uma proposta completa serão notificados antes de 5 de outubro.
A argumentação técnica explica por que razão este domínio resiste aos métodos habituais de avaliação. Para a maioria dos comportamentos de um modelo, basta examinar uma resposta isolada para determinar se é exata e apropriada. O bem-estar exige contexto: um utilizador em sofrimento não menciona necessariamente de imediato pensamentos de automutilação, e conselhos razoáveis sobre uma alimentação equilibrada num determinado caso tornam-se potencialmente perigosos se a pessoa tiver demonstrado antecedentes de perturbações alimentares. A equipa Safeguards publica, em paralelo, cinco critérios de rigor: indicar claramente o que está a ser medido, envolver médicos e especialistas da área na conceção, testar tanto as precauções como os danos — ou seja, avaliar tanto o risco de complacência excessiva como o de recusa excessiva —, refletir a utilização real através de cenários multi-turn e validar os avaliadores automáticos com verdadeiros especialistas. Este terceiro critério, a simetria entre sobreconformidade e sobrerecusa, é o que distingue esta abordagem de um simples reforço das proteções.
🔗 Bolsas de investigação sobre o bem-estar
Quantization-Aware Healing: um modelo de 4 bits que supera o original em precisão total
25 de agosto — O pipeline padrão para tornar um grande modelo implementável encadeia três etapas: comprimir a arquitetura, quantificar o resultado e, depois, reparar a perda de qualidade. A abordagem dominante para esta última etapa é o QAT (quantization-aware training), que insere operações de quantificação simulada e volta a treinar; uma alternativa, o QAD, destila a partir do modelo comprimido em precisão total. Em ambos os casos, o aluno pode, na melhor das hipóteses, alcançar o seu professor comprimido, herdando assim o limite imposto pela compressão.
A Multiverse Computing propõe uma mudança de uma única linha: destilar diretamente a partir do modelo original, anterior à compressão. A quantificação deixa então de ser um pós-processamento com perdas para se tornar uma etapa de aprendizagem por direito próprio. O resultado é contraintuitivo — aplicado ao GPT-OSS 120B comprimido para 60B e depois quantificado em MXFP4, o método produz um modelo de 4 bits que iguala ou supera a sua própria fonte bfloat16 em sete de nove benchmarks, com os ganhos mais acentuados onde a compressão causa mais danos: +7,4 pontos no AA-LCR em raciocínio de contexto longo e +5,6 no AIME 2025. Os únicos dois recuos, no MMLU-Pro e no SciCode, permanecem abaixo de um ponto e meio.
A comparação direta com o QAT num pipeline idêntico é talvez o resultado mais útil na prática. No GPT-OSS 9B quantificado em MXFP4, os dois métodos atingem um pico comparável, 54,9 contra 54,6, mas não ao mesmo custo: o QAH chega lá em cerca de uma centena de etapas e mantém-se nesse nível, enquanto o QAT demora aproximadamente 700 etapas a alcançá-lo e depois degrada-se. A consequência concreta é um risco de implementação diferente — um checkpoint QAT exige uma monitorização cuidadosa da paragem antecipada, enquanto um checkpoint QAH exige muito menos.
Gradio integra gr.Workflow, um construtor de pipelines de IA em grafo
25 de agosto — A Hugging Face publica um guia que apresenta gr.Workflow, uma primitiva agora integrada no Gradio. A constatação inicial é simples: a maioria das aplicações de IA interessantes não consiste numa chamada a um modelo, mas numa sequência — gera-se uma imagem, remove-se o fundo, cria-se uma narração e pede-se um título a um LLM. Até agora, ligar esta sequência e disponibilizá-la adequadamente exigia escrever tanto a lógica como a interface. gr.Workflow combina ambas: as etapas são descritas como um grafo de nós tipados, e o próprio grafo torna-se a interface.
O interesse para os programadores vai além da demonstração visual. Cada saída do grafo obtém automaticamente o seu próprio endpoint REST: o estúdio multimédia apresentado como exemplo, que encadeia uma geração FLUX, uma remoção de fundo, uma síntese de voz e um LLM, disponibiliza três rotas distintas (/sticker, /voiceover, /episode_title), que podem ser chamadas a partir de código sem passar pela interface. Os nós conseguem comunicar com quatro universos — os modelos alojados através dos Inference Providers da Hugging Face, outros Spaces Gradio públicos reutilizados como componentes, uma linha de um conjunto de dados do Hub e Python arbitrário. Este último ponto é o que abre mais possibilidades: um nó operador decorado com @spaces.GPU reserva uma GPU ZeroGPU durante a sua execução, permitindo executar os seus próprios pesos. Cinco aplicações efetivamente implementadas em Spaces acompanham o guia, incluindo um analisador de conjuntos de dados e uma demonstração que anima uma imagem estática com Lightricks/LTX-Video.
ElevenLabs lança Composer, um editor de canções secção a secção
25 de agosto — A ElevenLabs anuncia o Composer, um editor de canções que funciona secção a secção. O princípio rompe com o modo de geração dominante nos modelos de música: em vez de produzir uma faixa completa de uma só vez e reiniciar tudo quando uma passagem não agrada, o Composer permite refazer isoladamente uma estrofe, um refrão ou uma ponte. São propostos quatro pontos de partida — as suas próprias letras, uma faixa existente fornecida por si, uma página em branco ou um simples prompt — e a faixa é depois construída através de retoques sucessivos.
Este é o segundo avanço da ElevenLabs no domínio da música depois do Eleven Music, e chega numa semana movimentada para a empresa, tendo o CLI v1 sido lançado no dia anterior. O posicionamento é coerente com o resto do setor do áudio: a Suno lançou o Studio 2.0 em 13 de agosto, a Pika lançou a sua gama Pika Music em 18 de agosto e a Stability AI disponibilizou o seu plugin para estações de trabalho de áudio no mesmo dia. O controlo preciso da estrutura da faixa, mais do que a qualidade bruta da geração, tornou-se o terreno da competição. Há, contudo, uma ressalva: o anúncio não é acompanhado por nenhuma publicação no blog, e não há qualquer informação disponível sobre os planos que dão acesso ao Composer, os formatos de exportação ou o acesso à API.
🔗 Anúncio do Composer, @ElevenLabs
LiveAvatar elimina todos os limites de concorrência e reduz o preço para 0,01 USD por minuto
25 de agosto — A HeyGen anuncia a eliminação dos limites de concorrência no LiveAvatar, o seu produto de avatares em tempo real. A formulação enfatiza a natureza da mudança: os limites não são aumentados, desaparecem. Uma sessão ou dez mil são executadas na mesma API, sem negociação prévia de quotas. Dois parâmetros acompanham o anúncio — a renderização continua a ser de corpo inteiro em 1080p, e o preço desce até 0,01 USD por minuto em escala.
Este nível de preço altera a natureza das utilizações possíveis: a um cêntimo por minuto, um avatar em tempo real torna-se viável para apoio ao cliente em massa, formação ou quiosques interativos, casos em que o custo unitário determinava até agora a viabilidade. A eliminação do limite de concorrência é o ponto tecnicamente interessante. As plataformas de avatares em tempo real geralmente limitam o número de sessões simultâneas porque cada sessão utiliza continuamente recursos de GPU; eliminar esse limite pressupõe uma margem de capacidade significativa ou um ganho de eficiência no modelo. A HeyGen publica um artigo que explica a sua abordagem, cujos detalhes técnicos não estavam acessíveis no momento da análise.
🔗 Concorrência ilimitada no LiveAvatar
Grok 4.6 chega ao OpenCode Go
25 de agosto — O Grok 4.6 passa a integrar o OpenCode Go, o plano de subscrição do agente de código open source OpenCode. O anúncio foi feito pela OpenCode ao final do dia, e a conta @grok partilhou-o meia hora depois. O ponto concreto para os programadores é a quota: 169 pedidos por período de 5 horas para os utilizadores do plano Go. Trata-se de um limite móvel, não de uma contagem mensal, o que se adequa à utilização em rajadas típica das sessões de programação assistida.
Esta integração insere-se numa série de aberturas do Grok 4.6 a ferramentas de terceiros: o modelo chegou ao GitHub Copilot em 14 de agosto, ao Amazon Bedrock em 19 de agosto e, depois, à Gemini Enterprise Agent Platform da Google em 21 de agosto. Além disso, a xAI já tinha ligado o OpenCode às suas subscrições SuperGrok e X Premium em maio de 2026 — a novidade de hoje não é, portanto, o acesso ao OpenCode em si, mas a presença do modelo 4.6 no plano Go, com uma quota incluída em vez de uma subscrição xAI que o próprio utilizador tenha de fornecer.
🔗 Partilha de @grok · Anúncio da @opencode
Cohere publica um estudo da IDC sobre a adoção da IA soberana em 2026
25 de agosto — A Cohere publica os resultados de um InfoBrief encomendado à IDC sobre a adoção da IA soberana em setores regulados. O estudo inquiriu mais de 500 decisores seniores de empresas com um volume de negócios superior a mil milhões de dólares no Canadá, nos Estados Unidos, no Reino Unido e na Alemanha, entre abril e maio de 2026.
O resultado mais notável diz menos respeito à adoção do que à confusão conceptual. Um em cada três dirigentes tem dificuldade em descrever a IA soberana pelas suas próprias palavras, e apenas 13 % afirmam ter um nível muito elevado de conhecimento sobre o tema. Entre aqueles que conseguem dar uma definição, 52 % formulam-na em termos de controlo local ou nacional e 35 % mencionam a independência digital. A diferença também atravessa o organograma: os responsáveis de IT apresentam um nível de conhecimento duas vezes superior ao dos responsáveis das áreas de negócio.
| Setor inquirido | Fuga de dados e conformidade como principal preocupação | Vantagem competitiva como motivação |
|---|---|---|
| Serviços financeiros | 82 % | 21 % |
| Indústria | 77 % | 32 % |
| Telecomunicações | 75 % | 37 % |
| Saúde | 74 % | 28 % |
| Energia | 70 % | 21 % |
Quanto às motivações, o consenso é claro e transversal: a fuga de dados, a privacidade e a conformidade surgem em primeiro lugar em todos os setores inquiridos. A vantagem competitiva aparece como uma motivação secundária, mas em crescimento, sendo mais destacada no Canadá (35 %) e nos Estados Unidos (28 %) do que na Alemanha (23 %) ou no Reino Unido (18 %). O estudo serve evidentemente o posicionamento da Cohere, cuja plataforma de agentes North é executada na infraestrutura e na jurisdição escolhidas pelo cliente; ainda assim, os números são atribuídos a uma fonte identificada. A IDC prevê também que, até 2028, os CIO das multinacionais aumentarão em 65 % os seus investimentos em ambientes cloud soberanos modulares e na localização de dados.
🔗 Estado da adoção da IA soberana em 2026
Notícias breves
- Bain & Company junta-se à Claude Partner Network — A consultora torna-se parceira Global Premier, apoiada por uma implementação do Claude junto dos seus 19 000 funcionários; mais de 7 000 utilizadores ativos logo na fase-piloto, e mais de dois terços dos participantes adotaram o Claude for Excel. 🔗 Publicação da Anthropic
- Amp explica o que são os orbs — Nota de Thorsten Ball em resposta à confusão sobre o nome: um orb é um agente remoto, controlável a partir da web, do telefone ou do CLI. Dois esclarecimentos úteis sobre o custo: o tempo de suspensão ilimitado não é faturado e o número de orbs simultâneos não tem limite. 🔗 Nota da Amp
- Together AI abre o Qwen3.8 27B ao fine-tuning e à inferência dedicada — O modelo passa a estar disponível tanto para o ajuste fino com dados próprios como para Dedicated Model Inference em hardware reservado. 🔗 Tweet de @togethercompute
- FINAL-Bench abre o FINCHAL, um concurso de previsão financeira para agentes — Com um prémio de 2 000 dólares, pede posições em vez de previsões e publica um limite de sorte (luck ceiling) para separar a competência do acaso. 🔗 Publicação do FINAL-Bench
- Au-Zone publica o EdgeFirst Model Zoo — Quatro famílias YOLO em deteção e segmentação, avaliadas em silício integrado real, com cada valor publicado a remeter para a sessão de validação que o produziu, em contraste com a opacidade dos TOPS anunciados pelos fabricantes. 🔗 Publicação do EdgeFirst
- O ditado inteligente do Gemini para macOS — Permite ditar em qualquer janela do ambiente de trabalho, com remoção automática das hesitações e consideração das correções a meio da frase; a voz também serve para resumir ficheiros e reescrever texto. 🔗 Guia do blog.google
- As push rules aceitam exceções de caminho — Em pré-visualização pública, as regras Restrict file paths e Restrict file size podem isentar caminhos específicos, por exemplo, bloquear ficheiros JAR em todo o lado exceto em
**/gradle/wrapper/*.jar. 🔗 Changelog do GitHub - Bloqueio de um utilizador a partir de um aviso de segurança — A ação é realizada através do menu de três pontos da descrição ou de um comentário, em repositórios públicos, sem voltar às definições; o aviso permanece intacto. 🔗 Changelog do GitHub
- Manus assinala uma forte procura pela restauração de dados — As restaurações que não forem concluídas devem ser reiniciadas mais tarde no mesmo dia; há uma instrução explícita para manter os pacotes de backup intactos e inalterados. 🔗 Tweet de @ManusAI
- Kling publica três guias sobre o seu servidor MCP — Ligar o Kling a um assistente compatível com MCP para reproduzir uma configuração criativa validada e gerar variantes em lote; dois dos três tutoriais citam o Claude Code como cliente. 🔗 Blog da Kling
- Wan 3.0 chega ao Runway e ao Replicate — O Runway integra-o em 24 de agosto com múltiplas entradas de referência em imagem, vídeo e áudio; o Replicate segue-se no dia 25, destacando os 30 segundos nativos numa única tomada com áudio sincronizado. 🔗 Tweet de @runwayml
- Runway anuncia novos oradores para o seu AI Summit — Programa alargado à robótica, aos veículos autónomos, ao marketing e à infraestrutura para o evento de setembro em São Francisco. 🔗 Tweet de @runwayml
- MiniMax publica um índice das integrações do H3 — Awesome MiniMax H3 Integrations reúne o que está a ser desenvolvido em torno do modelo de vídeo aberto, incluindo configurações executadas com 24 GB de VRAM. 🔗 Tweet de @MiniMax_AI
- Luma lança Dream Lab Weekly — Primeiro episódio de uma série de vídeos dedicada aos profissionais criativos da Luma e ao seu trabalho semanal no produto. 🔗 Tweet de @LumaLabsAI
- NVIDIA transmite uma sessão Nemotron Labs sobre o encaminhamento de modelos abertos — Transmissão em direto de 55 minutos intitulada Get Started with Open Model Routing, que dá continuidade ao trabalho sobre o Nemotron 3.5 Lightning e o NeMo Switchyard. 🔗 Tweet de @NVIDIAAI
- Resta uma semana para o concurso Grok Imagine sobre a Odisseia — É necessário criar uma cena retirada da Odisseia que destaque as capacidades de vídeo e voz da ferramenta; prémios de 100 000, 50 000 e 25 000 dólares. 🔗 Tweet de @grok
- Banco de reposições de limites para subscritores Plus e Pro — Em vez de esperar pela janela de reposição, o utilizador consome uma reposição guardada em reserva; uma gratuita no lançamento e outras através de referências, com créditos de workspace partilhados no plano Business. 🔗 Changelog do ChatGPT e do Codex
O que isto significa
O silício volta a ser um tema de laboratório de modelos. A OpenAI publica no mesmo dia os primeiros números medidos do seu próprio chip de inferência e o artigo que apresenta a sua estratégia de compute. Não é uma coincidência de calendário: um fornecedor de modelos que concebe o seu silício, o mede num benchmark público de terceiros e assume publicamente um portefólio de dez parceiros altera a natureza da concorrência. A questão deixa de ser «qual é o melhor modelo» para passar a ser «a que custo por tarefa bem-sucedida», e a resposta joga-se tanto no rack como nos pesos. O pormenor mais significativo talvez esteja noutro lugar: a IA foi utilizada para conceber o chip e escrever os respetivos kernels, com passagem à produção em nove meses e implementações geradas que superam as de especialistas humanos nos blocos selecionados. O ciclo fecha-se — os modelos concebem o hardware que os fará funcionar.
A IA regressa ao dispositivo, e os números começam a acompanhar. Três sinais no mesmo dia apontam na mesma direção. A Perplexity executa a totalidade do seu agente localmente num DGX Spark, sem consumir créditos, com uma escalada para a cloud que continua a ser uma decisão do utilizador. A Multiverse Computing publica um método no qual um modelo de 4 bits iguala ou supera o modelo de origem em precisão total, eliminando o argumento habitual contra a quantificação agressiva. A Au-Zone publica medições de visão por silício embarcado, criticando o facto de os TOPS anunciados nada dizerem sobre o desempenho real de um determinado modelo. Nenhum destes três trabalhos afirma igualar o frontier: o número honesto da Perplexity é 59,6% localmente contra 82,4% para o Claude Opus 5 isoladamente no Terminal Bench 2.1. Mas a escalada para um modelo consultor recupera três quintos da diferença por dois terços do custo, e é este compromisso, mais do que a paridade, que torna defensável a execução local.
A abertura dos pesos estabelece-se como posição de referência. A análise de 500 000 artigos do arXiv divulgada pela Qwen documenta uma inversão já percetível: os modelos abertos chineses passaram de 10% para cerca de 40% das menções, enquanto os modelos abertos americanos estagnam entre 25% e 30%. O Qwen3.8-27B, que entra no top 10 do Code Arena sendo o único do seu tamanho, o GLM-5.3, que superava o GPT-5.6 Sol e o Claude Fable 5 no DeepSWE em testes múltiplos a um custo 2,1 a 5,4 vezes inferior, e a IBM, que abre o Granite 4.2 com quatro variantes quantificadas e catorze formatos GGUF logo no primeiro dia — a mesma lógica repete-se. Abrir os pesos já não é um gesto de recuperação, mas uma forma de se tornar a infraestrutura predefinida dos outros, com a ressalva que o próprio Nathan Lambert faz: as publicações surgem depois dos lançamentos, e estas curvas descrevem os trabalhos em curso, não as preferências do momento.
E a web prepara-se para ser lida por agentes, em vez de por olhos. O WebMCP Challenge é um concurso com um prémio de 35 000 dólares, o que é pouco; aquilo que revela vale mais. Chrome, Cloudflare, Shopify, Vercel, Render e Netlify alinham-se com a OpenAI num standard que pede aos sites que exponham ferramentas estruturadas, em vez de deixarem os agentes adivinhar uma interface. No mesmo dia, o ChatGPT desktop passa a conseguir consumir WebMCP nativamente, o Codex passa a conseguir produzir e implementar uma aplicação compatível, e a OpenAI documenta a utilização interna do protocolo numa ferramenta de notebooks. Esta convergência coincide com aquilo que a Rohlik descreve, por seu lado, com mais de cinquenta integrações MCP e o princípio de que qualquer nova ferramenta deve estar acessível aos agentes desde o primeiro dia. A camada de interface para agentes deixa de ser um tema de investigação para se tornar um requisito de engenharia.
Fontes
- OpenAI — WebMCP Challenge
- OpenAI — anúncio do WebMCP Challenge no X
- OpenAI — WebMCP no ChatGPT desktop e em Sites
- OpenAI — automatizar o trabalho repetitivo com Codex, Runme e WebMCP
- OpenAI — Jalapeño, primeiros resultados
- OpenAI — A stack completa por detrás da inteligência abundante
- OpenAI — plugin Admin para ChatGPT Work e Codex
- OpenAI — extensão de navegador alargada ao Edge, Brave, Opera e Vivaldi
- OpenAI — licença Premium do ChatGPT Business
- ChatGPT e Codex — registo de alterações
- Perplexity — lançamento do Portable Computer
- Perplexity — artigo sobre o Portable Computer
- Perplexity — benchmarks do harness local
- Anthropic — a memória do Claude funciona em todo o lado
- Anthropic — anúncio da memória no X
- Anthropic — CHANGELOG do Claude Code
- Anthropic — renderização em streaming 4x mais fluida
- Anthropic — bolsas de investigação sobre o bem-estar
- Anthropic — Bain & Company junta-se à Claude Partner Network
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — guia gr.Workflow
- FINAL-Bench — concurso FINCHAL
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B em fine-tuning e inferência dedicada
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — registo de alterações do Antigravity
- Google — ditado inteligente do Gemini para macOS
- Stability AI — Série B de 76 milhões de dólares
- Stability AI — anúncio no X
- NVIDIA — Gamescom e RTX Spark
- MiniMax — SANA e Sol Engine no H3
- MiniMax — índice das integrações do H3
- NVIDIA — sessão Nemotron Labs sobre o encaminhamento de modelos abertos
- Qwen — Qwen3.8-27B no Code Arena WebDev
- Qwen — divulgação da análise do arXiv
- Nathan Lambert — 500 000 artigos do arXiv analisados ao pormenor
- Warp — formato factory.yaml e acesso antecipado
- Cognition — estudo de caso do Rohlik Group
- Devin — página de cliente do Rohlik Group
- Amp — explicação dos orbs
- GitHub — quatro novos exercícios do GitHub Skills
- GitHub — separador Customize em disponibilidade geral
- GitHub — exceções de caminho nas push rules
- GitHub — bloqueio a partir de um aviso de segurança
- Manus — atualização sobre o restauro dos dados
- ElevenLabs — Composer
- HeyGen — concorrência ilimitada no LiveAvatar
- Kling — guias sobre o servidor MCP
- Runway — Wan 3.0 disponível na plataforma
- Runway — novos oradores do AI Summit
- Luma — Dream Lab Weekly
- xAI — Grok 4.6 no OpenCode Go
- OpenCode — Grok 4.6 no plano Go
- xAI — concurso Grok Imagine sobre a Odisseia
- Cohere — Estado da adoção da IA soberana em 2026