ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
Cincizeci și unu de anunțuri în douăzeci și patru de ore, repartizate în nouă domenii: ziua de 25 august este cea mai încărcată a săptămânii. Patru evoluții ies în evidență. OpenAI publică primele rezultate măsurate ale Jalapeño, cipul său intern pentru inferență, și lansează imediat un hackathon de zece zile dedicat WebMCP, alături de Chrome, Cloudflare, Shopify, Vercel, Render și Netlify. Perplexity mută întregul său agent Computer pe dispozitivul utilizatorului. IBM lansează în regim open source Granite 4.2, prima sa familie de modele de raționament. Iar Anthropic unifică memoria Claude între chat și Cowork, făcând-o lizibilă și modificabilă fișier cu fișier. Restul — WeatherNext Cyclones intrat în serviciu la National Hurricane Center, runda de finanțare Seria B a Stability AI, aproximativ douăzeci de actualizări de instrumente — urmează mai jos.
WebMCP: un standard, integrarea sa în produse, utilizarea sa internă și un concurs pentru a-i da impulsul inițial
25 august — OpenAI lansează WebMCP Challenge, un hackathon de zece zile dedicat unui standard deschis, încă experimental, care schimbă modul în care agenții interacționează cu webul. Problema vizată este concretă: în prezent, un agent care trebuie să îndeplinească o sarcină pe un site trebuie să deducă modul de navigare într-o interfață concepută pentru ochi și mouse. WebMCP inversează logica: site-ul însuși expune instrumente structurate pe care agentul le apelează direct.
Concursul nu este aspectul cel mai remarcabil al anunțului. Mai importantă este alinierea pe care o dezvăluie: Chrome (Google), Cloudflare, Shopify, Vercel, Render și Netlify se alătură cu toții OpenAI în jurul aceluiași standard. Componența juriului reflectă acest lucru, cu Sarah Drasner (Distinguished Engineer, Chrome), Andrew Galloni (VP Research & Innovation, Cloudflare), Jude Gao (echipa Next.js Core, Vercel), Ilya Grigorik (Distinguished Engineer, Shopify), Sean Roberts (VP of Applied AI, Netlify), Justin Rushing (Browser Agent Lead, OpenAI) și Alex Nahas, creatorul MCP-B.
The WebMCP Challenge is here. We’ve teamed up with @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render, and @Netlify for a 10-day hackathon. Up for grabs: $35,000 in cash prizes, Codex Micros, ChatGPT Pro subscriptions, and more prizes from our supporters.
🇷🇴 WebMCP Challenge a început. Ne-am asociat cu @ChromiumDev, @CloudflareDev, @ShopifyDevs, @vercel, @render și @Netlify pentru un hackathon de zece zile. Premiile includ 35.000 de dolari în numerar, Codex Micro, abonamente ChatGPT Pro și alte premii oferite de partenerii noștri. — @OpenAIDevs pe X
Calendarul este strâns, iar criteriile de evaluare sunt explicite: utilitate, originalitate, execuție, utilizarea chibzuită a WebMCP și calitatea experienței om-agent. Înscrierile și proiectele se depun prin Devpost. OpenAI publică și aplicații demonstrative native pentru agenți, menite să ofere un punct de plecare proiectelor — modelare 3D controlată de agent, scriere colaborativă în care agentul comentează sub propria identitate, generator de cuvinte încrucișate personalizate, Wandernote pentru transformarea notițelor de călătorie într-un itinerar și explorarea datelor prin DuckDB-Wasm în browser. Este permisă și pornirea de la o aplicație existentă, căreia să i se adauge WebMCP.
| Element al concursului | Detaliu anunțat |
|---|---|
| Durata anunțată | 10 zile |
| Deschiderea înscrierilor | 25 august 2026, ora 12 PT |
| Termenul-limită de depunere | 3 septembrie 2026, ora 13 PT |
| Anunțarea câștigătorilor | 23 septembrie 2026 (dată orientativă) |
| Valoarea totală a premiilor | 35.000 de dolari |
| Premiu per câștigător (top 10) | 3.000 de dolari, un an de ChatGPT Pro, o tastatură Codex Micro, articole promoționale |
| Platforma de depunere | Devpost |
Componenta de produs care face standardul utilizabil zi de zi sosește în aceeași zi: browserul integrat în aplicația desktop ChatGPT și ChatGPT Sites pot acum să utilizeze WebMCP. Când ChatGPT sau Codex vizitează un site compatibil, agentul detectează instrumentele expuse de pagină și le folosește automat în loc să bâjbâie prin interfață — este necesară actualizarea la cea mai recentă versiune a aplicației desktop. Cealaltă jumătate a circuitului se află în zona de producție: acum i se poate cere lui Codex să creeze o aplicație compatibilă cu WebMCP și apoi să o implementeze direct pe Sites. Este de remarcat asimetria suportului față de Chrome, unde WebMCP rămâne în spatele unui flag experimental sau al unui test de origine (origin trial), în timp ce browserul ChatGPT îl gestionează nativ.
Rămâne a treia componentă, cea mai instructivă: OpenAI își documentează propria utilizare internă. Un inginer al companiei povestește cum a încetat să mai scrie câte o automatizare pentru fiecare sarcină și a construit Runme, o aplicație web open source de notebook-uri, concepută pentru colaborarea cu Codex. În aceasta, el scrie un obiectiv scurt, cu instrucțiuni explicite — consultarea unei execuții anterioare, redactarea unui plan detaliat, așteptarea validării înainte de începere, documentarea comenzilor executate și a interpretării lor — iar Codex citește și actualizează notebook-ul pe parcursul lucrului. Două alegeri de arhitectură merită atenție. Mai întâi, persistența: notebook-urile sunt salvate în Google Drive, iar Runme generează în paralel un index Markdown asociat *.index.md, pe care Drive îl poate indexa, permițând unui agent să găsească o execuție anterioară și să o folosească drept context operațional. Apoi, expunerea capabilităților: Runme este o aplicație client servită static, iar adăugarea unui server doar pentru expunerea unui endpoint MCP clasic ar fi introdus infrastructură suplimentară și ar fi mutat procesarea datelor notebook-ului. WebMCP îi permite aplicației să își înregistreze instrumentele direct din browser.
🔗 WebMCP Challenge · Suport în ChatGPT desktop și Sites · Codex, Runme și WebMCP la OpenAI
Jalapeño: OpenAI publică primele rezultate ale cipului său de inferență și își asumă strategia de compute
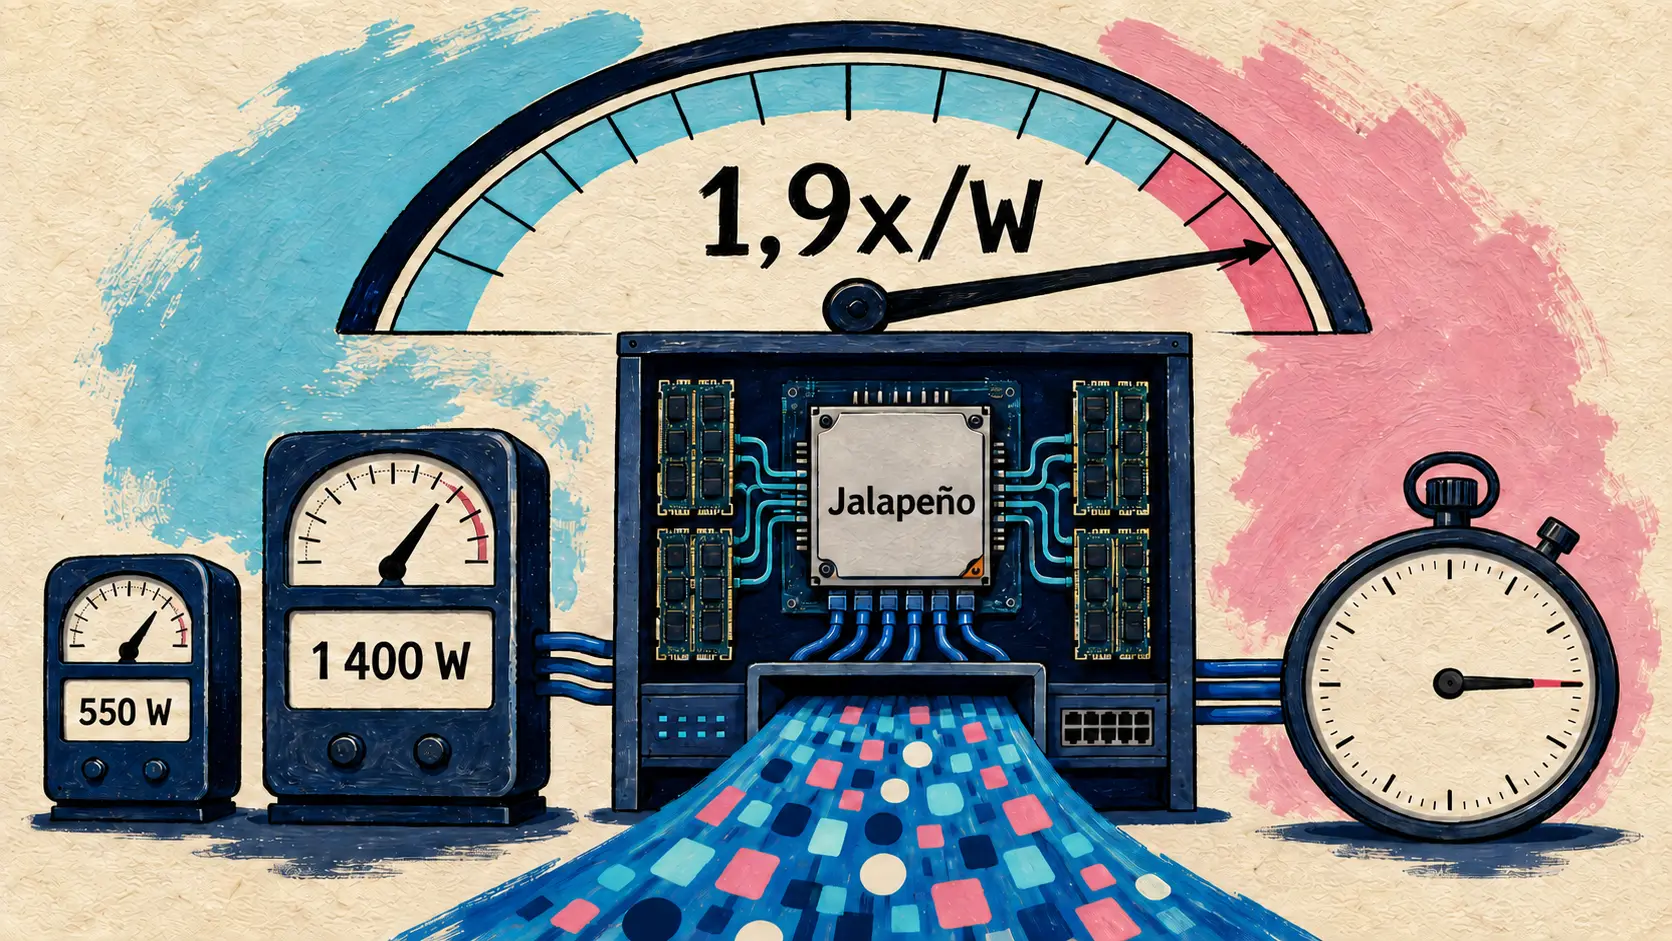
25 august — OpenAI publică primele rezultate măsurate ale Jalapeño, primul cip de inferență proiectat intern. Interesul anunțului nu constă doar în câștigurile brute, ci și în natura compromisului pe care cipul pretinde că îl elimină: sistemele de inferență existente trebuie, în general, să aleagă între debit și latență, în timp ce Jalapeño susține că le oferă pe ambele într-o singură arhitectură.
Măsurătorile se bazează pe InferenceX, un benchmark public al SemiAnalysis care simulează procesarea completă a unei solicitări. Au fost testate trei modele deschise — GPT-OSS 120B, DeepSeek R1 670B și Kimi K2.5 1T — în comparație cu sisteme comerciale. Alegerea normalizării per watt, nu per cip, este explicită și convenabilă: Jalapeño consumă de două ori mai puțin decât sistemele cu care este comparat. Jalapeño are o putere declarată de 700 W, iar consumul susținut măsurat a rămas la 550 W sau mai puțin pentru sarcinile testate, față de 1.200 W pentru GB200 și 1.400 W pentru GB300.
| Model evaluat (sistem comparat) | Debit maxim per kW | Latență de la un capăt la altul | TBT minim |
|---|---|---|---|
| GPT-OSS 120B (GB200, 1 200 W) | ≈1,9x (85 448 vs 44 960) | ≈1,7x (1,03 s vs 1,80 s) | ≈2,7x (0,69 vs 1,87 ms) |
| DeepSeek R1 670B (GB300, 1 400 W) | ≈1,7x (19 641 vs 11 781) | ≈3,6x (1,65 s vs 5,99 s) | ≈4,1x (1,43 vs 5,90 ms) |
| Kimi K2.5 1T (GB300, 1 400 W) | ≈1,5x (18 195 vs 11 862) | ≈3,4x (1,56 s vs 5,31 s) | ≈3,8x (1,44 vs 5,48 ms) |
Pentru toate cele trei modele, OpenAI anunță între 1,5 și 1,9 ori mai multă procesare IA per watt la debit maxim și o latență de la un capăt la altul de 1,7 până la 3,6 ori mai mică decât a sistemelor de comparație, precum și performanțe de până la 2,1–4,1 ori mai mari pentru sarcinile foarte interactive. Din punct de vedere tehnic, câștigurile provin din proiectarea comună a cipului, memoriei, rețelei, software-ului și sistemului la nivel de rack. Inferența parcurge două faze cu blocaje diferite: preîncărcarea (prefill), care procesează promptul și saturează capacitatea de calcul, și generarea (decode), care produce tokenurile unul câte unul și depinde în principal de lățimea de bandă a memoriei. Jalapeño urmărește să reducă la minimum transferurile de date, iar starea modelului — inclusiv cache-ul KV — poate fi plasată explicit și păstrată local, în timp ce sistemul activează combinația potrivită de calcul, memorie și rețea în funcție de fază.
Aspectul cel mai interesant pentru un dezvoltator privește rolul IA în proiectarea cipului însuși. OpenAI afirmă că a trecut de la proiectarea inițială la trimiterea în fabricație (tapeout) în nouă luni, scurtând ciclurile de proiectare, măsurare și verificare. Cipul a fost conceput ca o țintă de programare previzibilă atât pentru IA, cât și pentru oameni: activități descrise prin tensori locali, comunicare explicită și sincronizare previzibilă. Cu Codex și GPT-Astra, echipa a portat în două luni trei modele cu ponderi deschise care nu făceau parte din planul inițial de producție, iar pe anumite blocuri de atenție și mixture-of-experts din GPT-OSS, kernelurile generate de IA rulează de 1,5 până la 1,8 ori mai rapid decât implementările scrise de experți umani. Nuanța merită păstrată: aceste cifre se referă la blocurile selectate, nu la modelul complet. Calendarul rămâne prudent — calificarea pentru producție este în curs, software-ul trebuie maturizat, implementarea în infrastructura OpenAI este anunțată pentru sfârșitul anului, Gen 2 se află într-un stadiu avansat de dezvoltare, iar Gen 3 începe să prindă contur.
În aceeași zi, Sarah Friar publică articolul care explică logica economică din spatele tuturor acestor lucruri. Ea revendică un portofoliu compute larg — Microsoft și NVIDIA la bază, completate de AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy și SoftBank — cu un argument atât comercial, cât și tehnic: păstrarea unei alegeri credibile între furnizori permite direcționarea fiecărei sarcini de lucru către cel mai bun raport performanță-preț și menținerea disciplinei tarifare. Afirmația este însoțită de o cifră concretă: în Artificial Analysis Coding Agent Index, GPT-5.6 Sol cu raționament maxim atinge un nou record, consumând în același timp cu 54 % mai puține tokenuri de ieșire decât un alt model de top. Textul își asumă, în cele din urmă, paradoxul lui Jevons — reducerea costului inteligenței nu îi diminuează consumul, ci extinde domeniul utilizărilor rentabile. În ceea ce privește infrastructura, Project Camellia din Georgia este prezentat cu un circuit închis pentru apă și cu angajamente supuse anual unui audit public independent. OpenAI precizează că va continua să implementeze pe scară largă acceleratoarele NVIDIA și pe cele ale celorlalți parteneri ai săi, atât pentru antrenare, cât și pentru inferență.
🔗 Jalapeño — primele rezultate · Întregul stack din spatele inteligenței abundente
Perplexity Portable Computer: totul rulează pe dispozitiv, cu benchmark-uri care confirmă acest lucru
25 august — Perplexity lansează Portable Computer, o variantă a agentului său Computer care rulează integral pe dispozitivul utilizatorului. Schimbarea este mai degrabă arhitecturală decât cosmetică: nu doar modelul rulează local, ci întregul lanț de orchestrare — orchestrator, planificator, router de instrumente, scheduler, coadă persistentă de sarcini și index local de căutare.
Today we’re launching Portable Computer on @NVIDIA DGX Spark.
Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency.
🇷🇴 Astăzi lansăm Portable Computer pe @NVIDIA DGX Spark. Portable Computer este o versiune complet locală a Perplexity Computer, în care întregul mediu de execuție — LLM-ul orchestrator, LLM-ul subagenților, infrastructura agentului — rulează pe hardware-ul vostru local. Nicio dependență de cloud. — @perplexity_ai pe X
Anunțul este făcut împreună cu NVIDIA și vizează inițial DGX Spark — platformă Grace Blackwell GB10, CPU Arm cu 20 de nuclee, GPU NVIDIA, 128 GB de memorie unificată — urmând ca disponibilitatea să fie extinsă la PC-urile echipate cu GPU-uri RTX. Sunt oferite două modele la alegere, Qwen 3.8 27B sau PPLX 27B, versiunea post-antrenată de Perplexity a modelului Qwen, iar NVIDIA Nemotron 3.5 Lightning, un model deschis de 30B, urmează să fie adăugat în selector. Activitatea procesată local nu consumă credite. Escaladarea către cloud rămâne posibilă — pentru informații actualizate, browser, aplicații conectate sau unul dintre cele peste 15 modele frontier — dar necesită autorizarea explicită a utilizatorului. Conectorii Google Drive, Gmail, Slack și GitHub funcționează de pe dispozitiv, dictarea rulează local prin NVIDIA Nemotron 3.5 ASR Model fără ca sunetul să părăsească dispozitivul, iar codul este executat într-un mediu izolat (sandbox). Portable Computer este rezervat abonaților Pro și Max care dețin un DGX Spark, fiind disponibil mai întâi pe Linux și ulterior pe Windows, cu instalare printr-un singur clic din aplicație.
În aceeași zi, echipa de inginerie publică cifrele care documentează această lansare. Teza este că modelul și infrastructura (harness) trebuie proiectate împreună: infrastructurile generice presupun existența unui model frontier capabil să gestioneze contexte lungi și să planifice pe un orizont extins, cerințe pe care modelele locale le îndeplinesc cu dificultate.
| Benchmark măsurat | Computer (Qwen 3.8 27B) | Pi | Hermes | Computer + PPLX 27B |
|---|---|---|---|---|
| Local Knowledge Work Bench (53 de sarcini) | 82,6 % | 77,6 % | 74,0 % | 85,4 % |
| BrowseComp (1 266 de sarcini) | 66,7 % | 50,2 % | 43,9 % | — |
| ParseBench-100 (documente multimodale) | 65,1 % | 13,9 % | 34,6 % | — |
Pe BrowseComp, Computer consumă, de asemenea, cu 61 % mai puțin timp și cu 16 % mai puțini tokeni decât Hermes și cu 51 % mai puțin timp și cu 70 % mai puțini tokeni decât Pi. Patru opțiuni de proiectare explică diferența: un prompt de sistem minimal, capacități modularizate sub formă de skills încărcate și descărcate pe parcursul procesului, conectori utilizați intens (Gmail, GitHub, Outlook, Google Calendar) transformați în instrumente compacte pentru linia de comandă, în loc să fie expuși prin servere MCP ale căror definiții consumă contextul, și un mediu izolat permanent activ și neconfigurabil — dacă acesta nu este disponibil, infrastructura se dezactivează înaintea oricărui apel de instrument, în loc să treacă la o execuție neizolată. Perplexity menționează și o constatare practică utilă: Qwen 3.8 27B declară o fereastră de 260K tokeni, dar, empiric, începe să întâmpine dificultăți dincolo de 100K.
| Terminal Bench 2.1 (89 de sarcini) | Scor | Cost API per execuție |
|---|---|---|
| Qwen 3.8 27B, 100 % local | 59,6 % | aproximativ 0 |
| Qwen 3.8 27B + consultanță Claude Opus 5 | 73,0 % | 0,415 USD |
| Doar Claude Opus 5 | 82,4 % | 0,65 USD |
Mecanismul de escaladare către un model consultant (advisor) este cel mai interesant aspect al raportului: acesta recuperează aproximativ trei cincimi din diferența față de un model frontier pentru circa două treimi din costul acestuia, iar decizia rămâne în mâinile utilizatorului. Înaintea fiecărui apel, infrastructura selectează contextul relevant, aplică un clasificator pentru date cu caracter personal și îi arată utilizatorului ce informații ar părăsi dispozitivul; modelul consultant returnează doar text și nu are acces direct la fișiere sau instrumente. În cele din urmă, post-antrenarea PPLX 27B combină ajustarea fină prin respingere (rejection fine-tuning) cu învățarea prin întărire în medii sintetice executate în containere Docker, fără date reale ale utilizatorilor. Au fost anunțate publicarea unui raport tehnic și lansarea benchmark-ului de evaluare în regim open source.
🔗 Benchmark-uri ale infrastructurii locale · Portable Computer — articol Perplexity
Claude: o singură memorie pentru chat și Cowork, lizibilă fișier cu fișier
25 august — Anthropic elimină granița dintre două memorii care coexistau până acum. Ceea ce Claude reține din conversațiile voastre în chat este acum exact ceea ce are la dispoziție în Claude Cowork, iar reciproca este, de asemenea, valabilă. Concret, atunci când Cowork execută o sarcină în cloud, pornește cu contextul acumulat de-a lungul lunilor: prioritățile trimestrului, stadiul proiectelor, preferințele de redactare ale unui interlocutor. Anthropic oferă exemple intenționat de ordin practic — solicitarea unei actualizări de progres pentru manager fără a mai preciza despre cine este vorba sau cum preferă persoana respectivă să primească informațiile.
A doua schimbare este mai discretă, dar modifică utilizarea cotidiană: memoria se actualizează pe parcursul conversației, nu printr-un rezumat generat ulterior. Este suficient să menționați că un termen-limită a fost amânat până în septembrie pentru ca următoarea conversație să țină cont de acest lucru. Formula „reține acest lucru” rămâne disponibilă pentru a forța salvarea unui element precis, iar memoria poate fi suspendată sau resetată în orice moment.
În ceea ce privește transparența, Anthropic a ales o reprezentare lizibilă în locul unei cutii negre: tot ceea ce reține Claude apare sub forma unor fișiere scurte, clasificate pe subiecte, în Setări, apoi Memorie. Fiecare fișier poate fi citit, corectat sau șters. Beneficiul practic este imediat — este suficientă corectarea vechiului nume al companiei într-un singur fișier pentru ca toate conversațiile ulterioare să folosească numele corect.
Gestionarea subiectelor sensibile este cel mai interesant aspect din perspectiva alegerilor de produs. În mod implicit, Claude nu memorează informațiile legate de sănătate, origine, etnie, convingeri religioase, opinii politice sau identitate de gen. Anthropic recunoaște însă că această limită este personală și oferă o setare opțională pentru includerea acestor subiecte — permițându-i astfel lui Claude să-și amintească de o intoleranță la gluten atunci când propune rețete. Această setare nu este retroactivă și poate fi dezactivată în orice moment. O categorie rămâne exclusă indiferent de setare: numerele de identificare, antecedentele penale, statutul de imigrare și, în sens mai larg, orice încalcă Politica de utilizare acceptabilă. Claude semnalează explicit situațiile în care nu poate salva o informație de acest tip, o alegere de proiectare care favorizează refuzul vizibil în locul filtrării silențioase.
| Aspect al memoriei | Comportament descris |
|---|---|
| Arie de utilizare | Memorie unică, partajată între chat și Claude Cowork |
| Momentul actualizării | În timpul conversației, față de un rezumat generat anterior după încheierea ei |
| Format de stocare | Fișiere scurte, clasificate pe subiecte, lizibile și modificabile individual |
| Subiecte sensibile | Nu sunt memorate implicit, pot fi activate printr-o setare, fără efect retroactiv |
| Excluderi permanente | Numere de identificare, antecedente penale, statut de imigrare |
| Planurile Free, Pro și Max | Memorie activă implicit pe web, desktop și mobil |
| Planurile Team și Enterprise | Activată de administrator, dezactivată pentru fiecare utilizator până la activare |
🔗 Memoria Claude funcționează pretutindeni · Anunțul @claudeai
IBM lansează Granite 4.2, prima sa familie pentru raționament, și două modele ASR de 470M
25 august — IBM publică Granite 4.2, prezentată drept prima sa familie de modele lingvistice dense, exclusiv cu decodor, concepute explicit pentru raționament. În timp ce generațiile anterioare vizau eficiența și sarcinile clasice de business, această versiune pune raționamentul în centru și îl face configurabil: fiecare model oferă trei moduri — thinking, non-thinking și low-effort — pe care aplicația le alege în funcție de bugetul de latență și tokeni pe care este dispusă să îl aloce. Cele trei dimensiuni (3B, 8B, 30B) au aceeași arhitectură și același pipeline, ceea ce facilitează trecerea de la una la alta în procesul de integrare.
Arhitectura rămâne clasică: atenție GQA cu 40 de capete pentru 8 capete KV, RoPE cu un θ de 10 milioane pentru a susține un context de 131 072 de tokeni, MLP SwiGLU, normalizare RMSNorm, antrenare în bfloat16 pe un cluster NVIDIA GB200 NVL72 găzduit de CoreWeave. Preantrenarea pornește de la zero pe aproximativ 15 000 de miliarde de tokeni, în cinci etape. Ceea ce diferențiază cu adevărat Granite 4.2 este post-antrenarea: un pipeline de învățare prin întărire alcătuit dintr-un lanț de etape specializate, în locul unei singure treceri, folosind GRPO asincron cu eșantionare de importanță trunchiată, astfel încât jumătățile de generare și de antrenare ale buclei să nu se blocheze niciodată reciproc. Curriculum-ul cuprinde succesiv trei treceri RLVR cu recompense verificabile, amplificatoare axate pe respectarea instrucțiunilor și pe cod, două etape de software engineering în context 128K, o etapă pentru terminal, o etapă de cercetare, apoi alinierea RLHF. Blocul de învățare prin întărire agentică este aplicat numai modelelor 8B și 30B, ceea ce explică diferența de performanță în programarea agentică dintre modelul 3B și frații săi mai mari.
| Benchmark publicat de IBM | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| SWE-Bench Verified | — | 47,67 | 57,00 |
| SWE-Bench Multilingual | — | 30,78 | 41,89 |
| Terminal-Bench 2.1 | — | 20,56 | 29,24 |
| τ³-bench | 45,78 | 58,06 | 62,00 |
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
Publicarea nu se limitează la ponderile bfloat16: lansarea include patru variante cuantizate pentru vLLM — FP8 dinamic per canal, fără calibrare, NVFP4 și MXFP4 prin GPTQ calibrat pe 2 000 de eșantioane SFT — precum și paisprezece formate GGUF pentru llama.cpp, de la Q2_K la Q8_0. Sunt acceptate douăsprezece limbi, inclusiv franceza, iar trei infrastructuri de programare agentică sunt documentate încă din prima zi: OpenCode, Pi și OpenHands. În privința calității datelor, IBM descrie un lanț în care GPT-OSS-120B și Gemma 4 servesc drept evaluatori pentru notarea eșantioanelor SFT, înaintea deduplicării locale și globale prin hashing SHA-256.
În aceeași zi, IBM publică Granite Speech 5.0 Turbo CTC, două modele de recunoaștere vocală în limba engleză, cu 470 de milioane de parametri, care diferă doar prin datele de antrenare și licență — Apache 2.0 pentru varianta standard, CC-BY-NC-SA-4.0 pentru varianta antrenată pe date suplimentare. Schimbarea arhitecturii este notabilă: modelele Granite Speech anterioare combinau un codificator acustic, un proiector și un LLM, în timp ce acestea folosesc exclusiv un codificator. Stiva suprapune 16 blocuri Conformer, aplică autocondiționarea la ieșirea celui de-al optulea bloc, înlocuiește atenția cu produs scalar cu atenția pe blocuri (chunkwise) pentru a evita scalarea pătratică și optimizează direct pierderea CTC. Adevărata noutate este rata de tokeni: operațiile de subeșantionare reduc fluxul de la 100 de cadre pe secundă la ieșirea spectrogramei log-Mel la 12,5 pe secundă, ceea ce explică termenul „Turbo” din denumire. Rezultatele sunt prezentate în OpenASR Leaderboard și FFASR Leaderboard pentru câmp îndepărtat, prin grafice Pareto viteză/precizie, nu prin scoruri izolate, alături de o demonstrație de recunoaștere continuă executată în browser prin WebGPU, limitată la Chrome și Edge.
🔗 Granite 4.2 — prezentare tehnică · Granite Speech 5.0 Turbo CTC
WeatherNext Cyclones, primul model AI utilizat în timp real de National Hurricane Center
25 august — Google AI prezintă în detaliu WeatherNext Cyclones, un model de prognozare a cicloanelor tropicale dezvoltat de Google DeepMind și Google Research. Anunțul este remarcabil mai puțin prin performanța brută și mai mult prin ceea ce dezvăluie despre trecerea AI meteorologice din laborator în operațiunile reale.
Problema abordată este structurală. Până acum, urmărirea unui ciclon impunea un compromis: modelele fizice care rulează pe supercomputere surprind bine marile structuri atmosferice care străbat planeta, dar înțelegerea fizicii locale și intense care determină forța unei furtuni necesita trecerea la modele regionale complet diferite. WeatherNext Cyclones elimină această trecere înainte și înapoi, prezicând într-o singură etapă traiectoria, intensitatea și dimensiunea.
Câștigul anunțat este de o zi întreagă de anticipare față de sistemele anterioare. Google formulează comparația într-un mod sugestiv: prognozele pe trei zile ating acum precizia vechilor prognoze pe două zile, un progres care necesita în trecut un deceniu de progrese metodologice. A doua contribuție este de natură probabilistică: modelul este suficient de rapid pentru a produce până la 1.000 de simulări pentru fiecare furtună, înlocuind traiectoria unică „cea mai probabilă” cu o gamă de scenarii. Acest lucru face mai ușor de înțeles fenomenul de intensificare rapidă, definit drept o creștere a vitezei maxime susținute a vântului cu cel puțin 30 de noduri în 24 de ore. Anul acesta, 1.000 de predicții probabilistice pentru fiecare furtună sunt puse la dispoziția meteorologilor prin WeatherLab.
Elementul cel mai semnificativ rămâne implementarea în condiții reale. În timpul sezonului uraganelor din 2025, WeatherNext Cyclones a fost testat în cadrul National Hurricane Center din SUA — prima dată când această instituție utilizează modele AI în operațiuni în timp real. Meteorologii l-au folosit pentru a elabora prognoza privind atingerea uscatului în Jamaica de către uraganul Melissa, de categoria 5, oferindu-le autorităților locale timp suplimentar de pregătire. Un articol a fost publicat în Nature, iar Google anunță publicarea în regim open source pe GitHub a codului și a ponderilor modelului.
| Aspect al modelului | Contribuția WeatherNext Cyclones |
|---|---|
| Mărimi prezise | Traiectorie, intensitate și dimensiune într-o singură trecere |
| Câștig de anticipare | O zi; prognoza pe 3 zile = precizia celei vechi pe 2 zile |
| Simulări per furtună | Până la 1.000 |
| Implementare operațională | U.S. National Hurricane Center, sezonul uraganelor din 2025 |
| Caz de utilizare documentat | Atingerea uscatului în Jamaica de către uraganul Melissa, categoria 5 |
| Prag de intensificare | Peste 30 de noduri pentru viteza maximă susținută a vântului în 24 de ore |
| Modalități de punere la dispoziție | WeatherLab; cod și ponderi open source pe GitHub |
🔗 Anunț @GoogleAI · Articol Google DeepMind
Stability AI încheie o rundă Series B de 76 de milioane de dolari cu EA, Sony Music, Universal și Warner
25 august — Stability AI anunță încheierea rundei sale Series B: 76 de milioane de dolari în capital nou, care ridică finanțarea totală la 232 de milioane de dolari de la preluarea conducerii companiei de către Prem Akkaraju în iunie 2024, incluzând două runde de finanțare prin acțiuni și obligațiuni convertibile. Suma rămâne modestă la scara sectorului, dar componența grupului de investitori este adevăratul subiect.
Patru giganți ai divertismentului intră în acționariat: Electronic Arts pentru jocuri video, iar Sony Music Group, Universal Music Group și Warner Music Group pentru muzică. Cele trei mari case de discuri sunt acum acționare ale aceluiași laborator. Lor li se alătură AMD Ventures și Pacific Alliance Ventures. Acești investitori nu apar de nicăieri: EA, Universal și Warner erau deja parteneri strategici ai Stability AI din toamna anului 2025. Prin urmare, runda transformă acorduri comerciale existente în participații la capital.
Un alt semnal este fidelitatea investitorilor financiari. Coatue, Greycroft, Kadmos Capital, Sean Parker și Eric Schmidt investesc din nou, pentru a doua rundă consecutivă sub noua conducere — ceea ce, după perioada tulbure prin care a trecut Stability AI în 2023 și 2024, reprezintă o confirmare. Thomas Laffont, cofondator al Coatue, se alătură consiliului de administrație, din care fac deja parte James Cameron, Sean Parker, Dana Settle și Prem Akkaraju.
This unmatched group of investors is an affirmation of our vision where generative AI empowers every producer, musician, and storyteller. Stability is unique in the AI field because we are creative people making tools for creatives.
🇷🇴 Acest grup de investitori fără egal ne confirmă viziunea asupra unei AI generative care oferă mijloace fiecărui producător, muzician și povestitor. Stability este unică în domeniul AI deoarece suntem creatori care construiesc instrumente pentru creatori. — Prem Akkaraju, CEO al Stability AI, comunicat din 25 august
Strategia asumată este cea a unui laborator de nișă: fără un model generalist, ci instrumente pentru profesioniștii din domeniul creației, construite împreună cu titularii drepturilor, nu împotriva lor. Aceasta este exact direcția Stable Audio 3.0, o familie de modele cu ponderi deschise, antrenate pe date licențiate integral, extinsă pe 18 august printr-un plugin pentru stații de lucru audio. Banii trebuie să finanțeze continuarea dezvoltării produselor, cercetarea aplicată și divizia de servicii profesionale.
ChatGPT pentru companii: plugin Admin, extensie pentru mai multe browsere și loc Premium la 100 de dolari
25 august — Trei anunțuri OpenAI vizează același public: organizațiile care implementează ChatGPT și Codex la scară largă.
Cel mai consistent este pluginul Admin pentru ChatGPT Work și Codex, care reunește într-o conversație ceea ce până acum necesita navigarea între panouri de analytics, ecrane de setări și rapoarte. Domeniul acoperă sarcinile cotidiene: înțelegerea gradului de adoptare și a consumului de credite, identificarea membrilor sau grupurilor care se apropie de limite, gestionarea sosirilor și plecărilor, examinarea permisiunilor efective și diagnosticarea unei probleme de acces, ajustarea limitelor de utilizare și soluționarea cererilor de cheltuieli prin compararea lor cu consumul real. Partea cea mai interesantă este automatizarea fără scriere de cod: cererile de utilizare în așteptare pot fi direcționate către Slack sau Microsoft Teams pentru aprobare în instrumentul pe care evaluatorii îl folosesc deja, iar cererile de acces la o funcționalitate pot fi aprobate automat atunci când îndeplinesc criterii prestabilite, excepțiile fiind trimise unui om. Un aspect structural în materie de securitate: pluginul operează în cadrul rolului și permisiunilor existente ale utilizatorului și nu extinde accesul, fiecare instrucțiune fiind asociată unei acțiuni de citire sau scriere acceptate, cu un rezultat structurat. OpenAI citează propria utilizare — un agent ChatGPT Work din Slack procesează cererile IT interne, iar fluxurile de lucru implementate rezolvă aproximativ 45% din volumul tichetelor, eliminând restanțele în timp ce volumul solicitărilor de asistență aproape se dublase.
Al doilea anunț: extensia de browser ChatGPT se extinde dincolo de Chrome și acceptă Microsoft Edge, Brave, Opera și Vivaldi. Schimbarea este importantă pentru cei care lucrează într-un browser alternativ din motive de confidențialitate sau din cauza constrângerilor companiei. Sunt evidențiate două utilizări: integrarea contextului filelor deschise într-o sarcină prin mențiunea @ tab în ChatGPT Desktop, astfel încât Codex să lucreze pornind de la documentația sau tichetul deja afișat; și permiterea agentului să controleze browserul pentru a executa sarcini web concrete, anularea abonamentelor fiind unul dintre exemplele oferite.
Al treilea anunț, mai laconic: un loc Premium la 100 de dolari se alătură ofertei ChatGPT Business, fiind destinat companiilor mici și startupurilor, cu un plan prezentat drept flexibil și scalabil în funcție de dimensiunea echipei. Anunțul a fost făcut pe X, fără un articol de blog detaliat, iar componența exactă a locului nu este precizată în mesaj.
🔗 Plugin Admin · Extensie pentru mai multe browsere · Loc Premium ChatGPT Business
NVIDIA: Gamescom pentru RTX Spark și SANA, care reduce de 27 de ori latența MiniMax H3
25 august — NVIDIA profită de Gamescom, care are loc săptămâna aceasta la Köln, pentru a extinde catalogul RTX Spark, platforma sa pentru PC-uri Windows așteptată în această toamnă. Electronic Arts, Embark Studios și Ubisoft se alătură KRAFTON, NetEase, Riot Games și XBOX, care își anunțaseră angajamentul încă de la COMPUTEX, în mai. Titlurile menționate acoperă cerințe tehnice variate: EA SPORTS F1 25 și Apex Legends din partea EA, Anno 117: Pax Romana de la Ubisoft, ARC Raiders și THE FINALS de la Embark Studios.
Aspectul cel mai concret privește sistemele anti-cheat. Rularea unui joc nu este suficientă: marile titluri online depind de sisteme anti-cheat care trebuie portate pe fiecare platformă, altfel jocul rămâne imposibil de jucat în modul multiplayer. NVIDIA anunță că lucrează cu EA pentru a aduce EA Javelin Anticheat în mod nativ pe RTX Spark — genul de detaliu de infrastructură care determină adoptarea reală a unei noi platforme PC. În materie de randare, DLSS 4.5 Ray Reconstruction este disponibil imediat, cu un model transformer de a doua generație care înlocuiește soluțiile clasice de eliminare a zgomotului cu o rețea antrenată pe un supercomputer. Path tracing ajunge în CONTROL Resonant și 007 First Light, Gears of War: E-Day integrează RTX Mega Geometry, iar tehnologiile NVIDIA ACE sunt anunțate în Aniimo pentru începutul anului 2027.
Cealaltă latură a aceluiași actor, din 24 august, este mai tehnică. MiniMax prezintă rezultatele obținute de echipa SANA de la NVIDIA cu Sol Engine aplicat modelului său video H3: generarea a zece secunde de video la 768p pe un singur GB200 scade de la 414 secunde la 14,93 secunde, adică o accelerare de 27,7 ori. Metoda nu se bazează pe optimizarea kernelurilor, ci pe împărțirea generării în două treceri — o schiță la rezoluție joasă produsă de H3 în 4 pași, urmată de o trecere de rafinare la rezoluția țintă, realizată de LTX în 3 pași cu Sol-Attn. În total, șapte pași. A doua pârghie: decodările VAE costisitoare sunt înlocuite cu TAEH3 și TAEHV, decodoare simplificate, menținând în același timp reprezentările latente stabile pentru trecerea de rafinare.
| Măsurătoare pe MiniMax H3 | Valoare măsurată |
|---|---|
| Sarcină măsurată | 10 s de video la 768p, un singur GB200 |
| Latență înainte | 414 s |
| Latență după | 14,93 s |
| Factor de accelerare | 27,7x |
| Pași de generare | 4 (schiță H3 la rezoluție joasă) + 3 (LTX) |
| Decodoare înlocuite | TAEH3 și TAEHV în locul decodărilor VAE |
| Debit estimat per nod | 378.000 de videoclipuri pe lună, marjă GPU de peste 97% |
Debitul estimat este o evaluare MiniMax, nu o măsurătoare din producție, și trebuie interpretat ca atare. Dar direcția este clară: la cincisprezece secunde pentru zece secunde de video, generarea video de înaltă fidelitate trece de la randarea asincronă în loturi la o infrastructură aproape interactivă.
🔗 NVIDIA la Gamescom · SANA și Sol Engine pe H3
Modelele deschise chinezești devin reperul cercetării, iar Qwen3.8-27B intră în top 10 Code Arena
25 august — Qwen prezintă două rezultate în aceeași dimineață, iar al doilea îi conferă sens primului.
Primul este un clasament. Qwen3.8-27B intră în clasamentul Code Arena: WebDev, care evaluează modelele pentru generarea de interfețe web, pe locul 9 în clasamentul general, cu 1595 de puncte. Este singurul model din categoria sa de dimensiune aflat în top 10 și se situează la doar șase poziții în urma modelului Qwen3.8-Max, mult mai mare. Arena subliniază că acesta redesenează frontiera Pareto a clasamentului și oferă un reper sugestiv: Gemma 4-31B, de dimensiune comparabilă, dar lansat în aprilie, ocupă locul 80.
| Model evaluat | Poziție Code Arena: WebDev | Puncte obținute | Observația clasamentului |
|---|---|---|---|
| GLM-5.3 (Max) | Locul 8 în clasamentul general | 1597 | Înregistrare din 20 august, locul 2 între modelele deschise |
| Qwen3.8-27B | Locul 9 în clasamentul general | 1595 | Singurul model de dimensiunea sa din top 10 |
| Qwen3.8-Max | Cu șase poziții înaintea modelului 27B | n.c. | Model mult mai mare din aceeași familie |
| Gemma 4-31B | Locul 80 în clasamentul general | n.c. | Lansat în aprilie 2026 |
Al doilea rezultat este o măsurătoare a utilizării. Nathan Lambert, care a coordonat împreună cu alții proiectul Olmo la Ai2, a folosit Codex pentru a analiza 500.000 de articole arXiv despre AI și machine learning publicate de la lansarea ChatGPT, pentru a identifica modelele deschise utilizate efectiv în cercetare. Răsturnarea situației poate fi rezumată prin două cifre: în 2024, aproximativ 30% dintre articole menționau un model deschis american, față de 10% un model chinezesc; astăzi, aproximativ 40% citează un LLM deschis chinezesc și doar 25–30% unul american.
| Familie de modele | Ponderea articolelor care citează un LLM |
|---|---|
| OpenAI (modele închise) | aproximativ 37% |
| Qwen | aproximativ 33% |
| Gemini, Claude | 10–15% |
| Gemma, Mistral | 5–10% |
| Olmo | aproximativ 1% |
În detaliu, Qwen este menționat într-o treime dintre articolele care citează un LLM, indiferent care. Llama a atins punctul maxim în jurul lunii aprilie 2025, la 30%, chiar în momentul lansării Llama 4, și este în scădere de atunci. Lambert indică el însuși o limită importantă: publicațiile rămân în urma lansărilor de modele, deoarece cercetarea necesită timp — aceste cifre descriu starea lucrărilor în desfășurare, nu preferințele momentului. În paralel se conturează o tendință de fond, distinctă de disputa dintre modelele deschise și cele închise: proporția articolelor despre AI care menționează un LLM a crescut de la 10,43% în ianuarie 2023 la peste 50% în 2026.
🔗 Qwen3.8-27B pe Code Arena · Prezentarea de către Qwen a analizei arXiv · Analiza @natolambert
Claude Code trece la 2.1.245, iar redarea Claude pe web devine de 4 ori mai fluidă
Două versiuni Claude Code au fost lansate în acest interval, iar conținutul lor vizează în mod clar implementările în organizații. CHANGELOG-ul nu conține date, dar istoricul Git le plasează astfel: 2.1.243 apare în commitul din 24 august, la 23:40 UTC, iar 2.1.245 în cel din 25 august, la 05:13 UTC.
| Setare adăugată | Versiunea vizată | Utilitate practică |
|---|---|---|
modelPricing | 2.1.243 | Tarife contractuale în /cost, bara de stare și telemetrie |
modelPicker | 2.1.243 | Listă de modele ordonată și etichetată pentru /model |
promptCacheTtl / subagentPromptCacheTtl | 2.1.243 | Cache pentru prompt de o oră în conversație, 5 min pentru subagenți |
Detalierea Loops în /usage | 2.1.243 | Identificarea sarcinilor /loop care scapă de sub control |
| Conectare fără cheie prin Console | 2.1.243 | Organizații care interzic cheile API |
| Remediere glibc 2.44 | 2.1.245 | Blocare la pornire pe Arch Linux, CachyOS și Fedora Rawhide |
Setarea cu cel mai mare impact structural este modelPricing: până acum, costurile afișate erau calculate folosind tariful public; o organizație își poate introduce acum tarifele contractuale pentru fiecare model și coeficientul de reducere, ceea ce face cifrele direct utilizabile pentru refacturarea internă. Perechea promptCacheTtl și subagentPromptCacheTtl abordează un compromis economic concret pentru utilizatorii care folosesc o cheie API: păstrarea unui cache de o oră pentru conversația principală, unde contextul rămâne stabil, și menținerea duratei de cinci minute pentru subagenți, ale căror contexte sunt mai volatile. În privința remedierilor, serverele MCP la distanță în modul neinteractiv nu mai rămân blocate după o întrerupere, /resume nu se mai limitează la cele mai recente cincizeci de sesiuni, iar sesiunile inactive mai mult de zece minute expiră acum după aproximativ trei minute, înaintea unei noi încercări și a afișării unei erori explicite.
Pe 24 august, Anthropic anunță, de asemenea, că a rescris motorul care afișează răspunsurile în curs de generare în Claude pentru web și desktop. Principiul este unul clasic în redarea interfețelor: se modifică doar ceea ce încă se schimbă, în loc să se redeseneze întregul răspuns la fiecare fragment nou. Pentru un răspuns lung, diferența este structurală — costul redării nu mai crește odată cu lungimea textului deja afișat. Câștigurile anunțate sunt coerente: o fluiditate de aproximativ 4 ori mai mare, de 9 ori mai puține blocări pe un laptop cu performanțe reduse, cea mai gravă înghețare a interfeței de 4,5 ori mai scurtă și menținerea a 120 de cadre pe secundă de la început până la sfârșit pe un MacBook de 120 Hz. Detaliul interesant este publicul vizat: configurațiile modeste sunt cele care beneficiază cel mai mult.
🔗 CHANGELOG Claude Code · Redare de 4 ori mai fluidă, @ClaudeDevs
Agenții de cod se industrializează: Warp publică formatul propriilor factories, iar Rohlik scrie 90 % din cod cu ajutorul agenților
24 august, spre sfârșitul zilei — Warp dezvăluie mecanismul intern al Warp Factories, platforma sa de agenți cloud anunțată pe 18 august: formatul de configurare ales și deschiderea accesului anticipat. Punctul de plecare este asumat — Warp își mută propriii agenți în afara mașinilor locale, din motive de calitate și cost, și avea nevoie să descrie mediile, harnașamentele și permisiunile de securitate sub formă de cod versionat.
| Element de configurare | Valoare aleasă |
|---|---|
| Fișier de definiție | factory.yaml, schemaVersion: v1alpha1 |
| Chei principale | name, repositories (owner / name), agentDefaults.model |
| Definirea unui agent | agents/<nom>/agent.md cu agentType (FOREMAN, REVIEW…) și model |
| Declanșatoare | automations/<nom>/automation.md: agent, triggers (furnizor, eveniment) |
| Interfețe disponibile | CLI (warp agent run-cloud), API REST, SDK TypeScript, server MCP |
| Acces anticipat | Utilizare în valoare de până la 10.000 USD oferită clienților eligibili |
Separarea este interesantă: agenții nu sunt descriși într-un singur fișier YAML, ci în fișiere Markdown dedicate, astfel încât definiția unui agent devine un document ușor de citit și de comparat. Warp aplică rețeta propriilor operațiuni — factory-ul său intern, denumit „wilson”, acoperă depozite precum warp-server sau warp-terraform, își declară secretele și serverele MCP și își grupează agenții după rol (code-review, foreman, implementation, spec, triage) în 34 de linii. Cifrele prezentate pe pagina de solicitare a accesului sunt argumente comerciale imposibil de verificat din exterior: 200.000 de execuții ale agenților pe zi, peste 30 % dintre pull request-uri fuzionate fără modificări și un cost per pull request cu 20 % mai mic.
Pe 25 august, Cognition publică, la rândul său, un studiu de caz mult mai bine documentat decât precedentul. Rohlik Group este un distribuitor alimentar online fondat în Republica Cehă, prezent în cinci țări, profitabil și cu o cifră de afaceri de peste 1,3 miliarde de dolari anul trecut; livrează cumpărături săptămânale complete dintr-o gamă de 17.000 de produse în mai puțin de o oră sau în intervale de cincisprezece minute. Cifra care structurează articolul: aproximativ 90 % din cod este generat în prezent de agenți, iar organizația de inginerie se descrie drept „agent-mostly”.
Acesta nu este un rezultat obținut prin simpla conectare a unui instrument. Rohlik afirmă că a început acum un an, cu o primă experiență cu Devin considerată plină de erori. Ceea ce a schimbat situația au fost bazele puse de client: peste cincizeci de integrări MCP interne și externe, pornind de la principiul că orice instrument nou trebuie să fie accesibil agenților încă din prima zi, un strat semantic deasupra depozitului de date Snowflake și o bază de cunoștințe care le oferă agenților contextul ce i-ar fi transmis unui nou coleg. Sarcinile ajung la Devin din locul în care apar, fie că este vorba despre o conversație Slack privind o eroare sau despre un document de specificații Linear, și sunt duse până la pull request. Rezultatele revendicate — dublarea volumului de lucru al ingineriei din noiembrie, integrarea sistemului robotic AutoStore livrată în opt luni, în condițiile în care sectorul are nevoie de doi până la trei ani, reducerea prototipării de la o lună la o zi — rămân afirmații de pe o pagină dedicată unui client, publicată de furnizor. Efectul cel mai grăitor este altul: cei mai buni ingineri își petrec acum 80 % din timp revizuind cod, iar aproximativ 30 % din utilizarea Devin la Rohlik constă în analiza datelor de către utilizatori din departamentele de business.
🔗 Format factory.yaml, @warpdotdev · Studiu de caz Rohlik, @cognition · Pagina pentru clienți Devin
GitHub: patru exerciții despre workflow-uri agentice și fila Customize disponibilă publicului larg
25 august — GitHub publică patru exerciții noi pe platforma sa de învățare GitHub Skills. Abordarea este explicită: în loc să documenteze noutățile agentice ale anului, GitHub propune exersarea acestora într-un depozit demonstrativ, cu instrucțiuni oferite treptat prin pull request-uri.
| Exercițiu publicat | Obiectivul exercițiului |
|---|---|
| Agent Orchestration Build Your AI Dream Team | Agenți personalizați în Copilot CLI: planificare, proiectare, construire, validare, predare |
| Agentic Workflows that Read the Room | Extensia gh aw, workflow agentic în Markdown, modificări trimise prin pull request-uri |
| Idea to Merge with the Copilot App | De la o sesiune la un pull request fuzionat, în întregime în aplicația GitHub Copilot |
| Ship with Quality | Semnale automate de calitate, acoperirea testelor, verificări obligatorii pentru pull request-uri |
Cel mai remarcabil dintre cele patru este primul: este prima dată când GitHub oferă un parcurs ghidat despre orchestrarea multi-agent în CLI-ul său, un subiect documentat până acum doar în proză. Al doilea introduce extensia gh aw, cu un aspect important pentru securitate — modificările propuse de workflow trec prin pull request-uri în loc să fie aplicate direct, păstrând astfel un punct de revizuire umană.
În aceeași zi, aplicația GitHub Copilot primește o filă Customize, disponibilă publicului larg. Rolul său este de a reuni într-un singur loc cele patru mecanisme de extensie introduse separat în ultimele luni: servere MCP, plugins, skills și canvases. O vizualizare Featured prezintă o selecție editorială din fiecare categorie, pentru utilizatorul care știe ce dorește să facă, dar nu și ce tip de extensie răspunde nevoii sale, iar serverele MCP beneficiază de o navigare dedicată, cu opțiuni evidențiate în funcție de popularitate și explorare pe categorii. Changelog-ul ilustrează utilitatea canvases cu un caz concret: un canvas Azure DevOps pentru sortarea issues, prioritizarea unui backlog, atribuirea sarcinilor de urmărire, apoi încredințarea unei sarcini către Copilot pentru investigare, implementare sau pregătirea revizuirii.
🔗 Patru exerciții GitHub Skills · Fila Customize disponibilă publicului larg
Instrumentele Google pentru dezvoltatori: Gemini CLI 0.57.0 și Antigravity 2.10.0
25 august — Google publică versiunea stabilă 0.57.0 a Gemini CLI, precedată cu un sfert de oră de preview-ul 0.58.0. Conținutul acestei versiuni spune mai puține despre funcționalități noi și mai multe despre modul în care Google își întreține instrumentul: dintre cele 24 de intrări din changelog, 13 au prefixul [SSR Agent] Issue Fix și fac trimitere la numere de issues adesea vechi, de la 19239 la 28518. Aceste remedieri tratează neajunsuri acumulate în backlog — o blocare pe termen nedefinit a interfeței terminalului, căreia i se adaugă limite de timp, un mesaj de eroare administrativă înșelător pentru conturile personale, lipsa unui spațiu după sugestiile de completare automată, redarea terminalului care nu se actualiza la ieșirea din editorul extern. Cu alte cuvinte, Google pune un agent să lucreze la propria datorie tehnică, iar rezultatul ajunge direct în versiunea stabilă.
| Versiune publicată | Data și ora (UTC) | Canal de publicare | Aspecte importante |
|---|---|---|---|
| v0.57.0 | 25 august, 18:37:14 | Stabil | 13 remedieri [SSR Agent], validarea evals, retries contextuale |
| v0.58.0-preview.0 | 25 august, 18:22:01 | Preview | Izolare Docker în profilul Seatbelt macOS, verificatoare de siguranță |
În privința funcționalităților, efortul se concentrează asupra evaluării, cu o comandă pentru validarea evals și un instrument de formatare a apelurilor către unelte care integrează rezumate ale eșecurilor. Fiabilitatea se îmbunătățește și ea: erorile de capacitate declanșează retries silențioase care țin cont de context, iar anularea unei solicitări cu mai multe tururi provoacă un rollback complet, în loc să lase o stare parțială. De remarcat pentru cei care caută notele de versiune: fișierul docs/changelogs/index.md din depozit nu a fost actualizat după v0.54.0 din 6 august.
La patru zile după 2.9.1 și funcția sa Remote Control, Google Antigravity trece la 2.10.0 pe 24 august și acoperă două lipsuri care obligau utilizatorul să iasă din instrument: un terminal integrat și un control al versiunilor Git nativ, ambele amplasate direct în bara laterală. Gruparea este în concordanță cu traiectoria produsului — Antigravity se poziționează ca un mediu în care sunt coordonați agenți, nu ca unul în care codul este editat linie cu linie, însă trebuie să permită lansarea unei comenzi și inspectarea unui diff fără schimbarea ferestrei. Restul versiunii extinde atât ceea ce poate fi trimis unui agent, cât și ceea ce poate fi văzut din activitatea lui: fișierele audio se alătură atașamentelor acceptate, comentariile interactive pe imagini permit adnotarea unui element vizual pentru a ghida agentul, iar previzualizările îmbogățite ale execuției instrumentelor MCP clarifică ceea ce a făcut efectiv un server de instrumente. Google cuantifică versiunea la 13 îmbunătățiri și 8 remedieri, cu o implementare progresivă.
🔗 Gemini CLI v0.57.0 · Changelog Antigravity
Anthropic finanțează cu 5 milioane de dolari evaluări independente privind bunăstarea
25 august — Anthropic lansează un program de granturi în valoare de 5 milioane de dolari destinat finanțării cercetărilor independente privind efectul AI asupra bunăstării utilizatorilor săi. Câștigătorii primesc finanțare directă, acces la modele și asistență tehnică, dar lucrează în deplină independență: evaluările lor sunt publicate în regim open source și pot fi reutilizate de întreaga industrie. Înscrierile sunt deschise până la 21 septembrie, iar candidații selectați pentru a trimite o propunere completă vor fi anunțați înainte de 5 octombrie.
Argumentația tehnică explică de ce acest domeniu rezistă metodelor obișnuite de evaluare. Pentru majoritatea comportamentelor unui model, este suficientă examinarea unui răspuns izolat pentru a determina dacă este corect și adecvat. Bunăstarea necesită context: un utilizator aflat în suferință nu menționează neapărat de la început gânduri de auto-vătămare, iar sfaturile rezonabile într-un caz privind echilibrul alimentar pot deveni periculoase dacă persoana a manifestat anterior tulburări de alimentație. Echipa Safeguards publică în paralel cinci criterii de rigoare: precizarea clară a ceea ce se măsoară, implicarea clinicienilor și a specialiștilor din domeniu în proiectare, testarea atât a măsurilor de precauție, cât și a prejudiciilor — adică evaluarea riscului de complezență excesivă, precum și a celui de refuz excesiv —, reflectarea utilizării reale prin scenarii cu mai multe tururi și validarea evaluatorilor automați în raport cu experți reali. Acest al treilea criteriu, simetria dintre conformarea excesivă și refuzul excesiv, este cel care deosebește această abordare de o simplă înăsprire a măsurilor de protecție.
🔗 Granturi pentru cercetarea bunăstării
Quantization-Aware Healing: un model pe 4 biți care își depășește originalul la precizie completă
25 august — Pipeline-ul standard pentru a face un model mare implementabil cuprinde trei etape: comprimarea arhitecturii, cuantizarea rezultatului, apoi remedierea pierderii de calitate. Rețeta dominantă pentru această ultimă etapă este QAT (quantization-aware training), care introduce operații de cuantizare simulată și reantrenează modelul; o alternativă, QAD, face distilarea pornind de la modelul comprimat la precizie completă. În ambele cazuri, elevul poate cel mult să-și ajungă din urmă profesorul comprimat și moștenește astfel plafonul impus de comprimare.
Multiverse Computing propune o modificare de o singură linie: distilarea directă din modelul original, cel anterior comprimării. Cuantizarea încetează astfel să mai fie o postprocesare cu pierderi și devine o etapă de învățare în sine. Rezultatul este contraintuitiv — aplicată modelului GPT-OSS 120B comprimat la 60B și apoi cuantizat în MXFP4, metoda produce un model pe 4 biți care egalează sau își depășește propria sursă bfloat16 pe șapte din nouă benchmark-uri, cu cele mai mari câștiguri acolo unde comprimarea afectează cel mai mult performanța: +7,4 puncte pe AA-LCR la raționamentul cu context lung și +5,6 pe AIME 2025. Singurele două scăderi, pe MMLU-Pro și SciCode, rămân sub un punct și jumătate.
Comparația directă cu QAT, folosind un pipeline identic, este probabil rezultatul cel mai util în practică. Pe GPT-OSS 9B cuantizat în MXFP4, cele două metode ating un vârf comparabil, 54,9 față de 54,6, dar nu cu același cost: QAH ajunge acolo în aproximativ o sută de pași și își menține nivelul, în timp ce QAT are nevoie de circa 700 de pași pentru a-l atinge, după care se degradează. Consecința concretă este un risc de implementare diferit — un punct de control QAT necesită monitorizarea atentă a opririi anticipate, iar unul QAH, mult mai puțin.
Gradio integrează gr.Workflow, un constructor de pipeline-uri AI sub formă de graf
25 august — Hugging Face publică un ghid care prezintă gr.Workflow, o primitivă integrată acum în Gradio. Premisa este simplă: majoritatea aplicațiilor AI interesante nu constau într-un apel de model, ci într-o succesiune de operații — se generează o imagine, i se elimină fundalul, se creează o voce din ea, apoi i se cere unui LLM un titlu. Până acum, conectarea acestei succesiuni și expunerea sa într-o formă adecvată necesitau scrierea atât a logicii, cât și a interfeței. gr.Workflow le combină pe cele două: etapele sunt descrise ca un graf de noduri tipizate, iar graful însuși devine interfața.
Interesul pentru dezvoltatori depășește demonstrația vizuală. Fiecare ieșire a grafului primește automat propriul endpoint REST: studioul media oferit ca exemplu, care înlănțuiește o generare FLUX, eliminarea fundalului, sinteza vocală și un LLM, expune trei rute distincte (/sticker, /voiceover, /episode_title), care pot fi apelate din cod fără a trece prin interfață. Nodurile pot comunica cu patru ecosisteme — modelele găzduite prin Inference Providers de la Hugging Face, alte Spaces Gradio publice reutilizate drept componente, un rând dintr-un set de date de pe Hub și cod Python arbitrar. Ultimul punct deschide cele mai multe posibilități: un nod operator decorat cu @spaces.GPU rezervă un GPU ZeroGPU pe durata execuției sale, ceea ce permite rularea propriilor ponderi. Ghidul este însoțit de cinci aplicații implementate efectiv în Spaces, printre care un instrument de profilare a seturilor de date și o demonstrație care animează o imagine statică folosind Lightricks/LTX-Video.
ElevenLabs lansează Composer, un editor de melodii secțiune cu secțiune
25 august — ElevenLabs anunță Composer, un editor de melodii care funcționează secțiune cu secțiune. Principiul se îndepărtează de modul dominant de generare al modelelor muzicale: în loc să producă o piesă completă dintr-o singură încercare și să reia totul când un pasaj nu este potrivit, Composer permite refacerea separată a unui vers, a unui refren sau a unei punți. Sunt oferite patru puncte de plecare — propriile versuri, o piesă existentă furnizată de utilizator, o pagină goală sau un simplu prompt — după care piesa este construită prin ajustări succesive.
Este al doilea pas al ElevenLabs către muzică după Eleven Music și vine într-o săptămână aglomerată pentru companie, versiunea CLI v1 fiind lansată cu o zi înainte. Poziționarea este coerentă cu restul sectorului audio: Suno a lansat Studio 2.0 pe 13 august, Pika și-a lansat gama Pika Music pe 18 august, iar Stability AI și-a livrat pluginul pentru stații de lucru audio în aceeași zi. Controlul fin asupra structurii piesei, mai degrabă decât calitatea brută a generării, a devenit terenul competiției. Există totuși o rezervă: anunțul nu este însoțit de nicio postare pe blog și nu sunt disponibile informații despre planurile care oferă acces la Composer, formatele de export sau accesul API.
🔗 Anunțul Composer, @ElevenLabs
LiveAvatar elimină orice limită de concurență și ajunge la 0,01 USD pe minut
25 august — HeyGen anunță eliminarea limitelor de concurență pentru LiveAvatar, produsul său de avatare în timp real. Formularea subliniază natura schimbării: limitele nu sunt majorate, ci dispar. O sesiune sau zece mii rulează prin același API, fără negocierea prealabilă a unei cote. Anunțul este însoțit de doi parametri — redarea rămâne la 1080p pentru întregul corp, iar tariful scade până la 0,01 USD pe minut la scară mare.
Acest nivel de preț schimbă natura utilizărilor posibile: la un cent pe minut, un avatar în timp real devine viabil pentru asistență pentru clienți la scară largă, instruire sau chioșcuri interactive, cazuri în care costul unitar determina până acum fezabilitatea. Eliminarea limitei de concurență este aspectul interesant din punct de vedere tehnic. Platformele de avatare în timp real limitează de obicei numărul de sesiuni simultane, deoarece fiecare sesiune utilizează continuu resurse GPU; eliminarea acestui plafon presupune fie o rezervă semnificativă de capacitate, fie o creștere a eficienței modelului. HeyGen publică un articol în care își explică abordarea, ale cărui detalii tehnice nu erau accesibile la momentul monitorizării.
🔗 Concurență nelimitată pe LiveAvatar
Grok 4.6 ajunge în OpenCode Go
25 august — Grok 4.6 se alătură OpenCode Go, planul de abonament al agentului de programare open source OpenCode. Anunțul a fost făcut de OpenCode la sfârșitul zilei, iar contul @grok l-a redistribuit o jumătate de oră mai târziu. Aspectul concret pentru dezvoltatori este cota: 169 de solicitări în fiecare interval de 5 ore pentru utilizatorii planului Go. Este un plafon glisant, nu un contor lunar, ceea ce se potrivește utilizării în rafale tipice sesiunilor de programare asistată.
Această integrare se înscrie într-o serie de deschideri ale Grok 4.6 către instrumente terțe: modelul a ajuns în GitHub Copilot pe 14 august, pe Amazon Bedrock pe 19 august, apoi pe Gemini Enterprise Agent Platform de la Google pe 21 august. De altfel, xAI conectase deja OpenCode la abonamentele sale SuperGrok și X Premium în mai 2026 — noutatea zilei nu este, așadar, accesul la OpenCode în sine, ci prezența modelului 4.6 în planul Go, cu o cotă inclusă, în locul necesității de a furniza personal un abonament xAI.
🔗 Redistribuirea @grok · Anunțul @opencode
Cohere publică un studiu IDC despre adoptarea AI suverane în 2026
25 august — Cohere publică rezultatele unui InfoBrief comandat de la IDC privind adoptarea AI suverane în sectoarele reglementate. Studiul a chestionat peste 500 de factori de decizie de rang înalt din companii cu venituri de peste un miliard de dolari din Canada, Statele Unite, Regatul Unit și Germania, în perioada aprilie-mai 2026.
Cel mai notabil rezultat privește mai puțin adoptarea și mai mult confuzia conceptuală. Unul din trei directori întâmpină dificultăți în a descrie AI suverană în propriile cuvinte și doar 13 % declară că sunt foarte bine informați despre subiect. Dintre cei care reușesc să ofere o definiție, 52 % o formulează în termeni de control local sau național, iar 35 % menționează independența digitală. Diferența se regăsește și în organigramă: responsabilii IT prezintă un nivel de informare de două ori mai ridicat decât responsabilii de business.
| Sector chestionat | Scurgerile de date și conformitatea drept preocupare principală | Avantajul competitiv drept factor determinant |
|---|---|---|
| Servicii financiare | 82 % | 21 % |
| Industrie | 77 % | 32 % |
| Telecomunicații | 75 % | 37 % |
| Sănătate | 74 % | 28 % |
| Energie | 70 % | 21 % |
În privința motivațiilor, consensul este clar și transversal: scurgerile de date, confidențialitatea și conformitatea se situează pe primul loc în toate sectoarele chestionate. Avantajul competitiv apare ca un factor secundar, dar în creștere, fiind evidențiat mai mult în Canada (35 %) și Statele Unite (28 %) decât în Germania (23 %) sau Regatul Unit (18 %). Studiul servește, evident, poziționării Cohere, a cărei platformă agentică North rulează în infrastructura și jurisdicția alese de client; rămâne însă faptul că cifrele sunt atribuite unei surse identificate. IDC preconizează, de asemenea, că până în 2028 directorii IT ai multinaționalelor își vor majora cu 65 % investițiile în medii cloud suverane modulare și în localizarea datelor.
🔗 Stadiul adoptării AI suverane în 2026
Pe scurt
- Bain & Company se alătură Claude Partner Network — Firma devine partener Global Premier, pe fondul implementării Claude pentru cei 19 000 de angajați ai săi; peste 7 000 de utilizatori activi încă din faza-pilot, iar mai mult de două treimi dintre participanți au adoptat Claude for Excel. 🔗 Postarea Anthropic
- Amp explică ce sunt orb-urile — Notă semnată de Thorsten Ball ca răspuns la confuzia privind denumirea: un orb este un agent la distanță, care poate fi controlat de pe web, telefon sau CLI. Două precizări utile despre costuri: starea de repaus nelimitată nu este facturată, iar numărul de orb-uri simultane nu este plafonat. 🔗 Nota Amp
- Together AI deschide Qwen3.8 27B pentru fine-tuning și inferență dedicată — Modelul devine disponibil atât pentru ajustarea fină pe date proprii, cât și pentru Dedicated Model Inference pe hardware rezervat. 🔗 Postarea @togethercompute
- FINAL-Bench lansează FINCHAL, un concurs de prognoză financiară pentru agenți — Cu premii de 2 000 de dolari, acesta solicită poziții, nu predicții, și publică un plafon al norocului (luck ceiling) pentru a separa competența de hazard. 🔗 Postarea FINAL-Bench
- Au-Zone publică EdgeFirst Model Zoo — Patru familii YOLO pentru detecție și segmentare, măsurate pe cipuri integrate reale, fiecare valoare publicată făcând trimitere la sesiunea de validare care a produs-o, în contrast cu lipsa de transparență a valorilor TOPS anunțate de producători. 🔗 Postarea EdgeFirst
- Dictarea inteligentă Gemini pentru macOS — Dictare în orice fereastră de pe desktop, cu eliminarea automată a ezitărilor și luarea în considerare a corecturilor făcute în mijlocul propoziției; vocea poate fi folosită și pentru a rezuma fișiere și a rescrie un text. 🔗 Ghidul blog.google
- Regulile push acceptă excepții pentru căi — În versiune publică preliminară, regulile Restrict file paths și Restrict file size pot excepta anumite căi, de exemplu pentru a bloca fișierele JAR peste tot, cu excepția
**/gradle/wrapper/*.jar. 🔗 Jurnalul de modificări GitHub - Blocarea unui utilizator dintr-un aviz de securitate — Acțiunea se realizează prin meniul cu trei puncte al descrierii sau al unui comentariu, în depozitele publice, fără a mai trece prin setări; avizul rămâne intact. 🔗 Jurnalul de modificări GitHub
- Manus semnalează o cerere ridicată pentru restaurarea datelor — Restaurările care nu se finalizează trebuie relansate mai târziu în cursul zilei; există instrucțiunea explicită de a păstra pachetele de backup intacte și nemodificate. 🔗 Postarea @ManusAI
- Kling publică trei ghiduri despre serverul său MCP — Conectarea Kling la un asistent compatibil MCP pentru a reutiliza o configurație creativă validată și a genera variante în lot; două dintre cele trei tutoriale menționează Claude Code drept client. 🔗 Blogul Kling
- Wan 3.0 ajunge pe Runway și Replicate — Runway îl integrează pe 24 august, cu mai multe intrări de referință pentru imagini, video și audio; Replicate urmează pe 25, evidențiind cele 30 de secunde native generate dintr-o singură încercare, cu sunet sincronizat. 🔗 Postarea @runwayml
- Runway anunță noi vorbitori pentru AI Summit — Program extins către robotică, vehicule autonome, marketing și infrastructură pentru evenimentul din septembrie de la San Francisco. 🔗 Postarea @runwayml
- MiniMax publică un index al integrărilor H3 — Awesome MiniMax H3 Integrations inventariază proiectele construite în jurul modelului video deschis, inclusiv configurații care rulează cu 24 Go de VRAM. 🔗 Postarea @MiniMax_AI
- Luma lansează Dream Lab Weekly — Primul episod al unei serii video dedicate profesioniștilor creativi de la Luma și activității lor săptămânale asupra produsului. 🔗 Postarea @LumaLabsAI
- NVIDIA difuzează o sesiune Nemotron Labs despre rutarea modelelor deschise — Transmisiune în direct de 55 de minute, intitulată Get Started with Open Model Routing, care continuă activitatea asupra Nemotron 3.5 Lightning și NeMo Switchyard. 🔗 Postarea @NVIDIAAI
- A mai rămas o săptămână pentru concursul Grok Imagine despre Odiseea — Participanții trebuie să compună o scenă din Odiseea care să evidențieze capacitățile video și vocale ale instrumentului; premii de 100 000, 50 000 și 25 000 de dolari. 🔗 Postarea @grok
- Rezervă de resetări ale limitelor pentru abonații Plus și Pro — În loc să aștepte intervalul de resetare, utilizatorul consumă o resetare păstrată în rezervă; una gratuită la lansare și altele prin recomandări, cu credite de workspace partajate pentru planul Business. 🔗 Jurnalul de modificări ChatGPT și Codex
Ce înseamnă acest lucru
Siliciul redevine un subiect de laborator pentru modele. OpenAI publică în aceeași zi primele rezultate măsurate ale propriului cip de inferență și articolul care îi prezintă strategia de compute. Nu este o coincidență de calendar: un furnizor de modele care își proiectează propriul siliciu, îl măsoară pe un benchmark public terț și își asumă public un portofoliu de zece parteneri schimbă natura concurenței. Întrebarea nu mai este „care model este cel mai bun”, ci „la ce cost per sarcină reușită”, iar răspunsul depinde atât de rack, cât și de ponderi. Detaliul cel mai semnificativ este poate altul: IA a fost folosită pentru proiectarea cipului și scrierea kernelurilor sale, cu trimiterea în fabricație în nouă luni și implementări generate care le depășesc pe cele ale experților umani pentru blocurile selectate. Bucla se închide — modelele proiectează hardware-ul pe care vor rula.
IA revine pe dispozitiv, iar cifrele încep să confirme tendința. Trei semnale din aceeași zi indică aceeași direcție. Perplexity își rulează întregul agent local pe un DGX Spark, fără a consuma credite, cu o escaladare către cloud care rămâne la decizia utilizatorului. Multiverse Computing publică o metodă prin care un model pe 4 biți egalează sau își depășește sursa la precizie completă, eliminând argumentul obișnuit împotriva cuantificării agresive. Au-Zone publică măsurători de vision în funcție de siliciul embedded, reproșând valorilor TOPS anunțate că nu spun nimic despre ce va face în realitate un anumit model. Niciuna dintre aceste trei lucrări nu pretinde că egalează nivelul frontier: cifra onestă a Perplexity este de 59,6 % local, față de 82,4 % pentru Claude Opus 5 singur pe Terminal Bench 2.1. Însă escaladarea către un model consultant recuperează trei cincimi din diferență la două treimi din cost, iar acest compromis, mai mult decât paritatea, face executarea locală justificabilă.
Deschiderea ponderilor se consolidează ca poziție de referință. Analiza a 500 000 de articole arXiv distribuită de Qwen documentează o inversare deja perceptibilă: modelele deschise chinezești au trecut de la 10 % la aproximativ 40 % dintre mențiuni, în timp ce modelele deschise americane stagnează între 25 și 30 %. Qwen3.8-27B, care intră în top 10 Code Arena fiind singurul de dimensiunea sa, GLM-5.3, care a depășit GPT-5.6 Sol și Claude Fable 5 pe DeepSWE în teste multiple, la un cost de 2,1 până la 5,4 ori mai mic, IBM, care deschide Granite 4.2 cu patru variante cuantificate și paisprezece formate GGUF încă din prima zi — aceeași logică se repetă. Deschiderea ponderilor nu mai este o încercare de recuperare a decalajului, ci o modalitate de a deveni infrastructura implicită a celorlalți, cu nuanța formulată chiar de Nathan Lambert: publicațiile rămân în urma lansărilor, iar aceste curbe descriu lucrările în desfășurare, nu preferințele momentului.
Iar webul se pregătește să fie citit de agenți, nu de ochi. WebMCP Challenge este un concurs cu premii de 35 000 de dolari, ceea ce este puțin; ceea ce dezvăluie valorează mai mult. Chrome, Cloudflare, Shopify, Vercel, Render și Netlify se aliniază cu OpenAI în jurul unui standard care le cere site-urilor să expună instrumente structurate, în loc să lase agenții să ghicească o interfață. În aceeași zi, ChatGPT desktop poate utiliza WebMCP nativ, Codex poate produce și implementa o aplicație compatibilă, iar OpenAI documentează utilizarea internă a protocolului într-un instrument pentru notebook-uri. Această convergență se întâlnește cu ceea ce descrie Rohlik, la rândul său, prin peste cincizeci de integrări MCP și prin principiul conform căruia orice instrument nou trebuie să fie accesibil agenților încă din prima zi. Stratul de interfață pentru agenți încetează să mai fie un subiect de cercetare și devine o cerință de inginerie.
Surse
- OpenAI — WebMCP Challenge
- OpenAI — anunțul WebMCP Challenge pe X
- OpenAI — WebMCP în ChatGPT desktop și Sites
- OpenAI — automatizarea muncii repetitive cu Codex, Runme și WebMCP
- OpenAI — Jalapeño, primele rezultate
- OpenAI — Întregul stack din spatele inteligenței abundente
- OpenAI — pluginul Admin pentru ChatGPT Work și Codex
- OpenAI — extensia de browser extinsă la Edge, Brave, Opera și Vivaldi
- OpenAI — licența Premium ChatGPT Business
- ChatGPT și Codex — jurnal de modificări
- Perplexity — lansarea Portable Computer
- Perplexity — articolul Portable Computer
- Perplexity — benchmark-urile frameworkului local
- Anthropic — memoria Claude funcționează peste tot
- Anthropic — anunțul privind memoria pe X
- Anthropic — CHANGELOG Claude Code
- Anthropic — randare în streaming de 4 ori mai fluidă
- Anthropic — burse de cercetare privind bunăstarea
- Anthropic — Bain & Company se alătură Claude Partner Network
- IBM — Granite 4.2
- IBM — Granite Speech 5.0 Turbo CTC
- Multiverse Computing — Quantization-Aware Healing
- Hugging Face — ghidul gr.Workflow
- FINAL-Bench — concursul FINCHAL
- Au-Zone — EdgeFirst Model Zoo
- Together AI — Qwen3.8 27B pentru fine-tuning și inferență dedicată
- Google AI — WeatherNext Cyclones
- Google DeepMind — WeatherNext Cyclones
- Google — Gemini CLI v0.57.0
- Google — jurnalul de modificări Antigravity
- Google — dictarea inteligentă Gemini pentru macOS
- Stability AI — rundă Series B de 76 de milioane de dolari
- Stability AI — anunțul pe X
- NVIDIA — Gamescom și RTX Spark
- MiniMax — SANA și Sol Engine pe H3
- MiniMax — indexul integrărilor H3
- NVIDIA — sesiunea Nemotron Labs despre rutarea modelelor deschise
- Qwen — Qwen3.8-27B pe Code Arena WebDev
- Qwen — distribuirea analizei arXiv
- Nathan Lambert — 500 000 de articole arXiv analizate în detaliu
- Warp — formatul factory.yaml și acces anticipat
- Cognition — studiul de caz Rohlik Group
- Devin — pagina de client Rohlik Group
- Amp — explicația orbs
- GitHub — patru exerciții GitHub Skills noi
- GitHub — fila Customize disponibilă pentru publicul larg
- GitHub — excepții de cale în push rules
- GitHub — blocarea dintr-un aviz de securitate
- Manus — actualizare privind restaurarea datelor
- ElevenLabs — Composer
- HeyGen — concurență nelimitată pe LiveAvatar
- Kling — ghiduri despre serverul MCP
- Runway — Wan 3.0 disponibil pe platformă
- Runway — noi vorbitori la AI Summit
- Luma — Dream Lab Weekly
- xAI — Grok 4.6 în OpenCode Go
- OpenCode — Grok 4.6 în abonamentul Go
- xAI — concursul Grok Imagine despre Odiseea
- Cohere — Situația adoptării IA suverane în 2026