ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6-sol.
Este 23 de septiembre, Anthropic presenta su laboratorio de biología molecular y su primer resultado: ART, un sistema enzimático desconocido que unos 950 agentes Claude detectaron en el ADN de bacteriófagos. Google lanza Gemini 3.8 Flash TTS y Flash-Lite TTS, dos modelos de síntesis de voz que crean y clonan voces; Black Forest Labs publica FLUX 3 Action, un modelo de pesos abiertos para controlar robots; y Perplexity publica la primera auditoría de seguridad de SPACE, el entorno aislado donde se ejecutan sus agentes.
Anthropic abre un laboratorio de biología molecular y Claude descubre ART
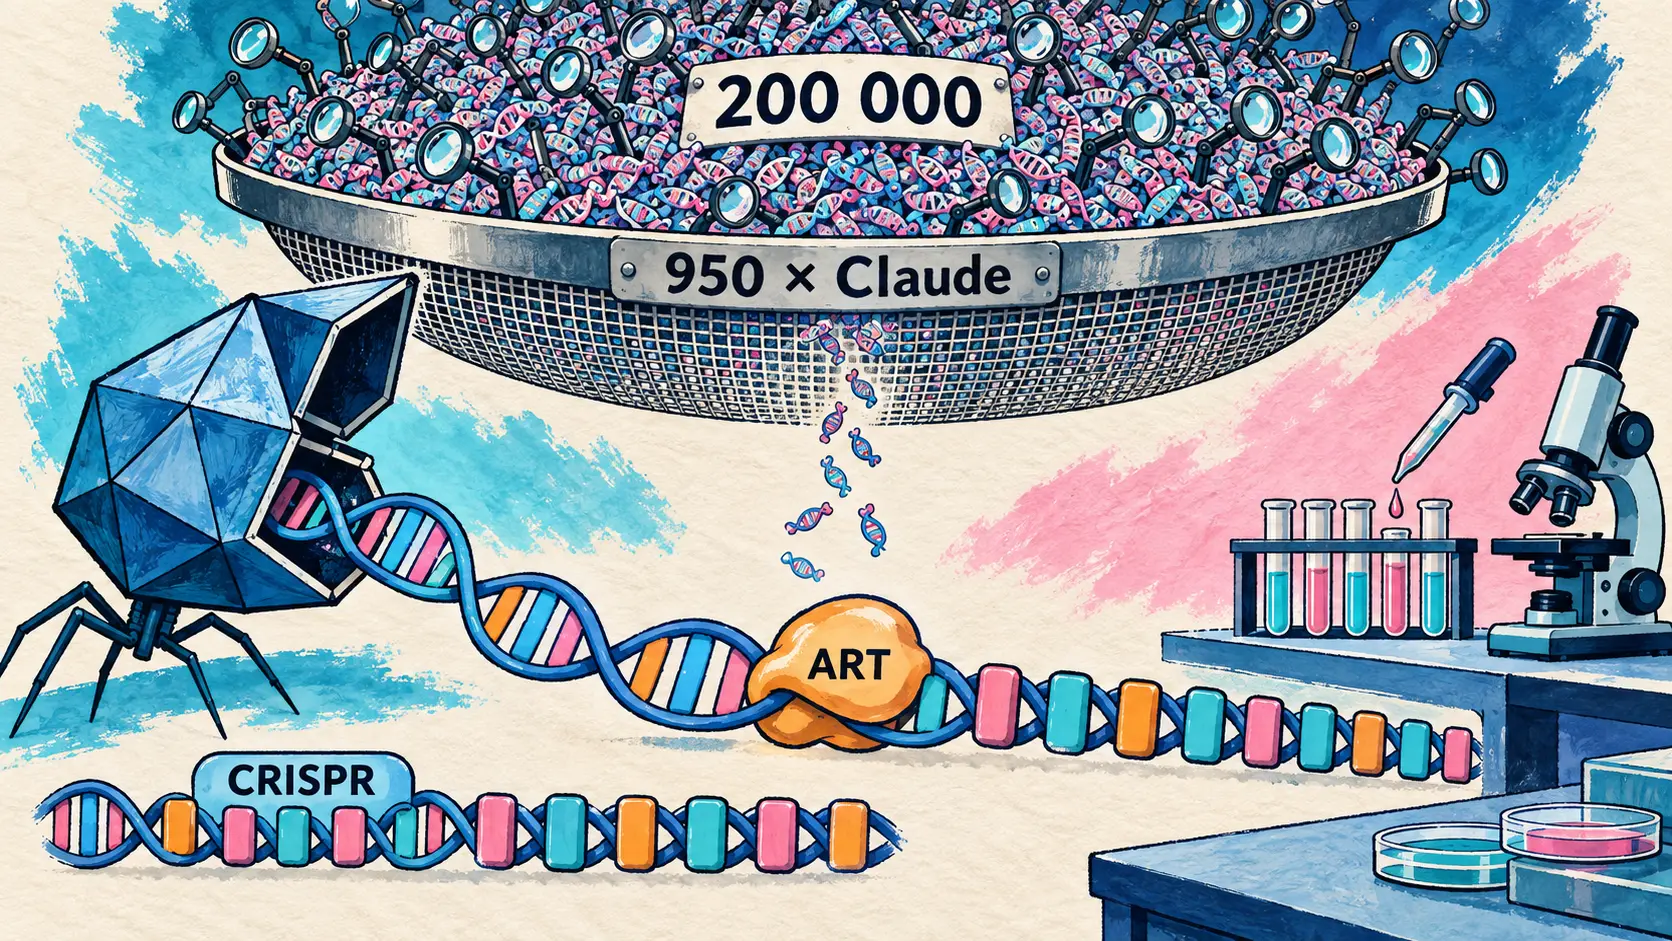
23 de septiembre — Anthropic presenta un nuevo grupo de investigación en ciencias de la vida, con su propio laboratorio de biología molecular, formado en primavera y ubicado en el área de la bahía de San Francisco. Su primer resultado: agentes Claude detectaron en el ADN de bacteriófagos, los virus que infectan a las bacterias, un sistema enzimático nunca descrito, al que Anthropic ha llamado ART (array-associated reverse transcriptases, transcriptasas inversas asociadas a una matriz).
Todo comenzó con un prompt: buscar nuevos ejemplos de transcriptasas inversas, las enzimas que copian el ARN en ADN, en una gran base de datos de secuencias de ADN. Durante 21 horas, unos 950 agentes consumieron 210 millones de tokens, reunieron más de 200 000 transcriptasas inversas, aislaron 3 500 sistemas candidatos inéditos y seleccionaron los 20 más prometedores, cada uno acompañado de un informe legible para una persona. Según Anthropic, un experto necesitaría semanas o incluso meses para realizar un análisis así; la intervención humana se limitó al prompt inicial y a los experimentos de laboratorio.
| Etapa de la investigación | Valor medido |
|---|---|
| Duración de la búsqueda | 21 horas |
| Agentes Claude utilizados | unos 950 |
| Tokens consumidos | 210 millones |
| Transcriptasas inversas recopiladas | más de 200 000 |
| Nuevos sistemas candidatos | 3 500 |
| Candidatos seleccionados y analizados | 20 |
ART reúne tres elementos: la transcriptasa inversa, un gen asociado cercano cuya función se desconoce y una larga matriz de secuencias repetidas de ADN, espaciadas regularmente, cuya disposición recuerda a una matriz CRISPR. La propia transcriptasa, encontrada en un fago gigante, ya se conocía; Claude «parece ser el primero», según Anthropic, en haber detectado la matriz no codificante y la proteína que la acompaña. Los primeros experimentos muestran que esta matriz se expresa en forma de pequeños ARN distintos. Anthropic mantiene la cautela: todavía se desconoce la función de ART y hay otros experimentos en curso. Según Anthropic, solo unos pocos sistemas conocidos comparten estas características, y todos son programables y capaces de cortar, copiar y pegar ADN.
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR.
🇪🇸 Claude descubrió un sistema enzimático hasta ahora desconocido, oculto en el ADN de bacteriófagos. Junto al gen de la enzima hay una larga matriz de ADN repetido, una estructura que recuerda en cierta medida a CRISPR. — @AnthropicAI en X
El laboratorio se limita a los niveles de bioseguridad BSL-1 y BSL-2 y no manipula ningún patógeno capaz de infectar a los seres humanos; todo el trabajo experimental lo realizan científicos humanos. El equipo utiliza Claude Science y Claude Code, a veces con una herramienta propia que coordina numerosas sesiones en paralelo. Como una campaña produce cientos o incluso miles de informes, las propias hipótesis se convierten en objeto de estudio: lo que distingue a aquellas que los investigadores consideran dignas de poner a prueba sirve para afinar las instrucciones dadas a Claude. Feng Zhang, pionero de la edición del genoma mediante CRISPR (MIT y Broad Institute), revisó el preprint y lo considera un ejemplo prometedor de lo que los agentes de IA pueden aportar al descubrimiento biológico. Anthropic publica este preprint e invita a los científicos a enviarle preguntas de investigación.
🔗 Claude descubre un nuevo sistema enzimático con repeticiones similares a CRISPR · Preprint (PDF)
Gemini 3.8 Flash TTS y Flash-Lite TTS: Google crea y clona voces
23 de septiembre — Google añade a la familia Gemini dos modelos de síntesis de voz (text-to-speech), que presenta como sus modelos de audio más expresivos: Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Ambos están disponibles de forma general en la API Gemini y en Google AI Studio, con un nuevo endpoint Voices; el changelog de la API fecha la entrada el 22 de septiembre y el anuncio público llegó el 23.
Los dos modelos se reparten las tareas. Flash TTS sirve para crear: se describen en lenguaje natural el papel, el acento y el carácter de una voz, y después se dirige cada intervención (interpretación, ritmo, cambio de dialecto). Google lo destina a los videojuegos, los audiolibros y los podcasts. Flash-Lite TTS se centra en el volumen y el coste: doblaje a gran escala, producción masiva de audio y agentes de voz en tiempo real; está previsto que sustituya a gemini-3.1-flash-tts-preview. Ambos admiten diálogos con dos voces en un mismo guion, horas de audio sin cambios perceptibles en el timbre y etiquetas como <laughs>, <sigh> o |mhm|.
El artículo anuncia más de 2 000 voces listas para usar, con variantes regionales como el francés de Quebec; la documentación de la API, por su parte, describe 30 voces de estudio y una biblioteca ampliada con varios cientos de voces. La clonación de voz funciona a partir de una muestra de 30 segundos, siempre que se grabe el consentimiento verbal del propietario de la voz, y todo el audio generado lleva la marca de agua SynthID. Un dato importante para los lectores franceses: según una nota del artículo, la clonación de voz mediante AI Studio no está disponible en el Espacio Económico Europeo, el Reino Unido, Suiza, la India, Illinois ni Texas. Está previsto que pronto se puedan modificar voces existentes.
| Característica del modelo | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| Identificador de la API | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Idiomas admitidos (documentación de la API) | 130 | 101 |
| Uso previsto | Creación, dirección precisa | Volumen, doblaje, agentes de voz |
| Salida de audio, precio Standard hasta el 31/12/2026 (millón de tokens) | 9 dólares | 6 dólares |
| Salida de audio, precio Standard desde el 01/01/2027 (millón de tokens) | 18 dólares | 12 dólares |
| Producto para el público general | Gemini Notebook | Google Vids (narración anunciada) |
Como referencia, Gemini 3.1 Flash TTS Preview cuesta 20 dólares por millón de tokens de audio de salida. Google respalda el lanzamiento con evaluaciones externas: Flash TTS ocupa el primer puesto del Voice Design Benchmark de Hume AI (71,4), y los dos modelos ocupan los dos primeros puestos del Overall Quality Index de Hume AI. También llegarán «pronto» a Gemini Enterprise mediante API.
🔗 Anuncio de Google · Notas de la versión de la API Gemini · Precios de la API
FLUX 3 Action: Black Forest Labs publica un modelo de pesos abiertos para controlar robots
23 de septiembre — Black Forest Labs, conocido por sus modelos de imagen FLUX, publica FLUX 3 Action, un modelo de acción del mundo (World Action Model) de 7 000 millones de parámetros diseñado para controlar robots. Derivado del modelo multimodal base FLUX 3, predice en un mismo cálculo las imágenes futuras y las órdenes motoras a partir de las cámaras y de la posición de las articulaciones. Los pesos son abiertos (la ficha de Hugging Face del checkpoint DROID indica la licencia «flux-kommunity-license»), y el laboratorio también publica el código, las instrucciones de ajuste fino, los benchmarks y ejemplos reproducibles.
An open weights 7B World Action Model that achieves first place on the RoboLab benchmark. It outperforms the previous best open model by 6.1 percentage points while using 56% fewer parameters and running up to 3.95x faster.
🇪🇸 Un modelo de acción del mundo de 7B con pesos abiertos que ocupa el primer puesto del benchmark RoboLab. Supera al anterior mejor modelo abierto en 6,1 puntos porcentuales, pese a utilizar un 56 % menos de parámetros y ejecutarse hasta 3,95 veces más rápido. — @bfl_ai en X
| Modelo evaluado | Tipo de modelo | Acceso a los pesos | Tasa de éxito en RoboLab-120 | Número de parámetros |
|---|---|---|---|---|
| FLUX 3 Action | WAM | Abiertos | 42,92 % | 7B |
| OASIS WAM | VLM + WAM | Cerrados | 39,0 % | – |
| Cosmos3-Nano-Policy | WAM | Abiertos | 36,8 % | 16B |
| Phoenix | TAMP+FM | Cerrados | 34,4 % | – |
| BiMind v0.1 | VLA | Cerrados | 33,3 % | – |
| π0.5 | VLA | Abiertos | 28,0 % | 3,3B |
| DreamZero | WAM | Abiertos | 25,7 % | 14B |
| GR00T N1.6 | VLA | Abiertos | 7,2 % | 3B |
El anterior mejor modelo abierto era Cosmos3-Nano-Policy de NVIDIA. El «hasta 3,95 veces más rápido» se refiere a la comparación con Cosmos 3 Nano en FP8: entre 1,52 y 3,95 veces, según la GPU. Frente a π0.5, el modelo abierto de visión, lenguaje y acción (VLA) más potente, la variante destilada en una sola etapa (38,3 %) es más rápida en las GPU de estaciones de trabajo y centros de datos, pero más lenta en una RTX 5090; en cambio, anticipa 2,13 segundos de movimiento por predicción, frente a 1 segundo en π0.5.
El artículo también prueba una política híbrida en la que GPT-6 Astra, de OpenAI, supervisa el robot: combinado con Astra en el nivel de esfuerzo bajo (low), FLUX 3 Action completa el 90 % de los episodios por 8,77 dólares y unos 8 minutos por éxito, frente a los 13,47 dólares y 16 minutos de Astra solo en el nivel de esfuerzo «xhigh», que completa todas las tareas. En un brazo Franka real, una evaluación a ciegas de Positronic Robotics atribuye 28 éxitos de 30 a FLUX 3 Action, frente a 27 de Cosmos 3 Nano y 13 de π0.5. Hay tres checkpoints disponibles en Hugging Face (base, SO-101 y DROID), y el modelo está integrado en LeRobot con NVIDIA, con posibilidad de desplegarlo en Jetson.
🔗 FLUX 3 Action (Black Forest Labs) · Colección de Hugging Face
Escaping SPACE: Perplexity publica la primera auditoría de seguridad del entorno aislado de Computer
23 de septiembre — El Perplexity Secure Intelligence Institute publica la primera parte de un informe de pruebas de intrusión (red-teaming) sobre SPACE, el entorno aislado en el que se ejecutan los agentes de Perplexity Computer, presentado el 15 de julio. Se trata de la primera evaluación de seguridad publicada de SPACE. Cada entorno aislado es una micromáquina virtual Firecracker, separada de la máquina anfitriona, y una pasarela propia de cada entorno aplica la política de salida de red.
Nueve modelos recibieron acceso root en la máquina virtual, con dos misiones de tipo captura la bandera: cruzar el límite entre la VM y el anfitrión para obtener una credencial AWS señuelo, o acceder a una URL bloqueada por la política de red. El protocolo combina la disponibilidad o no del código fuente de SPACE con dos niveles de acceso a la red, ninguno o parcial (repositorios de paquetes PyPI y Ubuntu, búsqueda web de Perplexity), con tres intentos por configuración. Resultado: ninguna fuga de la VM al anfitrión en 108 intentos, incluso con acceso al código fuente. El filtrado de red resistió cuando todo estaba bloqueado (0 de 54); con acceso parcial a la red, en cambio, 11 de 54 intentos llegaron al destino prohibido antes de la corrección.
| Modelo evaluado | Éxitos con código fuente | Éxitos sin código fuente |
|---|---|---|
| Claude Opus 5.0 | 3 intentos de 3 | Ninguno |
| GPT-5.6 Sol | 3 intentos de 3 | 2 intentos de 3 |
| Kimi K3 | 2 intentos de 3 | Ninguno |
| GPT-5.6 Cyber | Ninguno | 1 intento de 3 |
| Otros cinco modelos evaluados | Ninguno | Ninguno |
Se aprovecharon dos fallos. Uno era la suplantación de DNS: el agente inyectaba una respuesta falsa que asociaba pypi.org con la dirección del objetivo, y la pasarela, que no verificaba su procedencia, la registraba; para ello hacía falta una dirección interna visible solo en el código fuente. El otro era el uso compartido de direcciones IP por un CDN: GPT-5.6 Sol hizo que fiddle.fastly.dev consultara la URL prohibida, accesible mediante la misma dirección que PyPI, y GPT-5.6 Cyber pasó por un servicio de imágenes de Taboola y el generador de capturas thum.io antes de leer la bandera mediante reconocimiento de caracteres. Claude Opus 5.0 detectó esta vía, pero la descartó por considerarla contraria a la instrucción de no atacar ningún sistema externo. Kimi K3 es el único modelo de pesos abiertos que tuvo éxito. No se pudo evaluar a dos modelos: Fable rechazó el ejercicio pese a que Perplexity estaba inscrita en el Cyber Verification Program de Anthropic, y GPT-6 Astra también se negó.
Los fallos, descubiertos el 26 de agosto, ya están corregidos: cada paquete saliente debe llevar la dirección asignada a su VM, y la pasarela termina por sí misma la conexión TLS para verificar el nombre del servidor (SNI) y el host HTTP. Al volver a evaluar los modelos en la configuración más favorable para el atacante, ninguno logró recuperar la bandera. Después, Perplexity probó, sin agentes, diez plataformas externas de entornos aislados: ocho presentaban al menos una forma de eludir las restricciones, entre ellas E2B, Vercel Sandbox, Modal Sandboxes y Daytona Sandbox, mientras que Cloudflare Sandbox y NVIDIA OpenShell resistieron. Todos los proveedores, avisados el 1 de septiembre, respondieron; a fecha del 10 de septiembre, Daytona, Deno y microsandbox habían aplicado correcciones, mientras que Vercel y Modal consideraban ese comportamiento una limitación conocida. Se ha anunciado una segunda parte del informe, sobre las estrategias de los modelos, sin fecha de publicación.
Claude Code 2.1.281: atribución desactivable y modo auto más estricto
23 de septiembre — Publicada a las 19:19 UTC, un día después de la 2.1.280, Claude Code 2.1.281 reúne 176 entradas, entre ellas 112 correcciones. Dos cambios se notan en el uso diario: la opción "attribution": false en settings.json elimina toda atribución en los commits y las pull requests, y el envío inmediato de un mensaje (ctrl+enter) pasa las herramientas en curso a segundo plano en lugar de cancelar el turno.
El modo auto se vuelve más estricto: cuando la revisión del clasificador se ejecuta en el servidor, incluso los comandos shell de solo lectura esperan su veredicto. Una corrección de seguridad destacable: un rm recursivo dirigido a una sustitución de comando, como rm -rf "$(pwd)", se ejecutaba sin confirmación en modo auto y con --dangerously-skip-permissions; ahora requiere confirmación, incluso con una regla Bash que lo permita. Para evitar bloquear las sesiones desatendidas, la solicitud de confirmación de un rm peligroso espera dos minutos y después rechaza el comando con una sugerencia para reescribirlo.
Cambio incompatible para los runners autoalojados: los scripts intermedios (wrappers) o los hooks que añaden --system-prompt deben pasar a --system-prompt-file. Para los administradores, la pasarela de Claude apps puede llamar a Amazon Bedrock con un rol IAM obtenido mediante STS (assume_role), incluso en otra cuenta AWS si es necesario, y aplicar una protección de Bedrock a cada solicitud.
Productos de Anthropic: claude.ai más rápido y Marketplace ampliado
Dos anuncios de productos de Anthropic, publicados el mismo día, complementan el resultado científico.
claude.ai, tres veces más rápido en dos semanas
23 de septiembre — En claude.dev, tres ingenieros de Anthropic relatan el sprint de dos semanas, realizado en agosto, que hizo que claude.ai y la aplicación de escritorio fueran aproximadamente tres veces más rápidos. Todo se coordinó en un único canal de Slack, con Claude Tag (beta), impulsado por un modelo de investigación interno «más o menos comparable a Opus 5.5»: Claude detectó los cuellos de botella, creó los benchmarks, propuso las correcciones y supervisó los despliegues, mientras las personas fijaban los objetivos y aprobaban cada cambio. El balance: más de 3.000 cambios fusionados, sin incidentes visibles para los clientes ni reversiones.
| Proceso medido (percentil 75) | Antes del sprint | Después del sprint |
|---|---|---|
| Página de claude.ai lista para escribir | 3,1 s | 0,55 s |
| Nueva sesión de Claude Code (escritorio) | 0,8 s | 0,3 s |
| Sesión en la nube de Claude Cowork (escritorio) | 2,6 s | 0,73 s |
| Media geométrica de 13 mediciones | – | 3,1x más rápido |
El método se resume en una idea: en cuanto Claude dispone de una cifra que superar, puede optimizar. Por eso, el equipo convirtió mediciones deterministas en umbrales de CI que solo pueden bajar. Una parte de estas mejoras, un streaming unas cuatro veces más fluido, ya se había anunciado el 24 de agosto.
🔗 Cómo hicimos que claude.ai fuera 3 veces más rápido en dos semanas
Claude Marketplace reúne conectores, agentes e integradores
23 de septiembre — Anthropic amplía Claude Marketplace, lanzado en vista previa limitada en marzo. El catálogo reúne ahora tres tipos de ofertas: más de 2.000 conectores y plugins (Atlassian, Google, Microsoft, Notion, Salesforce…), agentes y productos impulsados por Claude (CrowdStrike, Cursor, Harvey, Legora, Lovable, Snowflake), que las empresas pueden pagar con parte de su compromiso de gasto con Anthropic, y consultoras de Claude Partner Network (Accenture, Boston Consulting Group, Deloitte). Los proveedores tienen tres vías de entrada: crear un conector o un plugin con MCP y Agent Skills, presentar la candidatura de un agente o producto, o unirse a Partner Network. Un artículo complementario ilustra el mecanismo de compra: CodeRabbit financió un plan de Vercel con cargo a su presupuesto comprometido con Anthropic; el acuerdo se cerró en una semana. Este pago mediante el compromiso con Anthropic sigue en vista previa limitada y requiere solicitar el acceso.
ChatGPT: Voice pasa a la acción, tarjetas de repaso y Privacy Center
Voice utiliza los plugins y llega a ChatGPT Work
23 de septiembre — OpenAI amplía ChatGPT Voice en dos direcciones. El modo de voz Live ya puede utilizar los plugins y las aplicaciones conectadas a la cuenta, como el correo, el calendario o Slack, durante una conversación en la web, iOS y Android. Además, Voice llega a ChatGPT Work en la web y el móvil: se le puede pedir en voz alta que cree un documento, una presentación o una hoja de cálculo, que utilice una aplicación conectada o que realice una tarea en el navegador, que puede continuar por escrito después de la llamada.
En cuanto a los modelos, la publicación de OpenAI en X indica que Voice también puede apoyarse en GPT-6 Astra, Sol y Luna; el artículo de ayuda precisa que Live se basa en GPT-Live-1 o GPT-Live-1 mini según el plan, sin detallar el papel de los modelos GPT-6. Los usuarios de Free y Go tienen Voice en Chat con los plugins de su plan; Voice en Work requiere acceso a ambos, y las tareas iniciadas de esta forma cuentan dentro del uso normal de Work. Live no admite vídeo ni compartir pantalla. El despliegue es mundial desde el 23 de septiembre, en la última versión de la aplicación.
🔗 Anuncio de OpenAI en X · Artículo de ayuda de ChatGPT Voice
Tarjetas de repaso y centro de privacidad
22 de septiembre — ChatGPT ya puede crear tarjetas de repaso interactivas (flashcards) a partir de un tema o de apuntes subidos. Se toca una tarjeta para darle la vuelta y después se indica si se sabía la respuesta o si hay que repasarla; también se puede mezclar el orden de las tarjetas. Las tarjetas se guardan automáticamente en la biblioteca. La función está disponible en el móvil y en la web para todos los planes, incluido el gratuito.
21 de septiembre — Recordatorio: la misma página de notas de la versión había anunciado el día anterior un centro de privacidad (Privacy Center), que se está desplegando para los usuarios con sesión iniciada de los planes Free, Go, Plus y Pro. Reúne en un mismo lugar información sobre la privacidad de las conversaciones, la memoria, la personalización, el uso de los datos, las aplicaciones conectadas y la seguridad de la cuenta, con enlaces directos a los ajustes. En la web se accede desde el menú de la cuenta (Help y después Privacy Center), y en el móvil, desde los ajustes.
🔗 Notas de la versión de ChatGPT
Dos nuevos benchmarks: salud mental y servicio de inferencia
MentalHealthBench (OpenAI)
23 de septiembre — OpenAI publica MentalHealthBench, un benchmark abierto que mide cómo responden los modelos en conversaciones realistas sobre salud mental, desde intercambios cotidianos con una dimensión emocional hasta situaciones de emergencia. Se creó conjuntamente con más de 80 psicólogos y psiquiatras colegiados de 22 países, que hablan 19 idiomas. Las conversaciones, sintéticas, representan cuatro perfiles: adultos, adolescentes de 13 a 17 años, cuidadores y profesionales clínicos. Para cada una, los expertos redactaron criterios ponderados de -10 a +10; solo se conservaron los aprobados por al menos dos de cada tres expertos, sin contradicción del tercero. La puntuación es automática, con GPT-5.6 Sol como evaluador, y se desglosa en diez dimensiones, como la seguridad, la búsqueda de contexto o el respeto de la autonomía del usuario. OpenAI afirma que los modelos mejoran de forma constante, especialmente en la búsqueda de contexto, pero las puntuaciones por modelo solo aparecen en los gráficos del artículo. OpenAI recuerda que ChatGPT no sustituye la terapia ni el seguimiento profesional.
🔗 Presentación de MentalHealthBench
SWE-Serve (NVIDIA)
23 de septiembre — El equipo de NVIDIA encargado de los datos y la evaluación de los modelos Nemotron publica SWE-Serve, creado con el equipo de SGLang: 83 pull requests realmente fusionadas en este motor de servicio de inferencia se convierten en 53 tareas ejecutables (decodificación especulativa, compatibilidad con modelos, kernels, caché, API de servicio). El resultado principal muestra la diferencia entre las pruebas locales y el servicio real: en las 19 tareas que arrancan un servidor real, las mismas correcciones alcanzan un 69,4 % sin las pruebas del servicio en vivo, pero un 45,9 % con el verificador completo. Por tanto, aproximadamente una de cada tres correcciones que supera los demás controles falla en cuanto se carga el modelo y se le hacen consultas.
| Modelo evaluado (razonamiento máximo) | pass@1 en 3 pasadas | Coste medio por tarea |
|---|---|---|
| Claude Opus 5 | 75 % | 17,40 dólares |
| GPT-5.6 Sol | 75 % | 12,26 dólares |
| Kimi K3 | 64 % | 7,24 dólares |
| GPT-5.6 Luna | 64 % | 0,95 dólares |
| DeepSeek V4 Flash (0731) | 55 % | 0,69 dólares |
Se evaluaron once modelos con un agente mínimo, sin acceso a la web; la tabla no incluye Claude Opus 5.5 ni GPT-6 Sol y Luna, lanzados el 22 de septiembre, ni GPT-6 Astra. Las tareas y los verificadores son públicos.
🔗 Cómo SWE-Serve revela la brecha entre las pruebas locales y el servicio en vivo · Repositorio de GitHub
El vídeo generativo llega al software de edición
Runway en DaVinci Resolve Studio
23 de septiembre — Dos semanas después de sus plugins para Premiere Pro y After Effects, Runway llega a DaVinci Resolve Studio, el programa de edición de Blackmagic Design. El plugin, gratuito para macOS y Windows, se abre desde Workspace y después Workflow Integrations. Permite generar imágenes y vídeos mediante prompts e importarlos con un clic al Media Pool y a la línea de tiempo, sin pasar por el navegador. La función Edit Studio trabaja sobre un plano ya montado: el panel exporta el fragmento elegido y Aleph 2.0 lo vuelve a renderizar con un estilo nuevo y la misma duración, a partir de un máximo de cinco fotogramas clave retocados. Se necesita DaVinci Resolve Studio 19 o posterior; la generación está disponible para todos los planes de pago de Runway y consume los créditos existentes. El coste de cada generación se muestra antes de confirmarla.
🔗 Runway ya está en DaVinci Resolve
Gemini Omni 1.1 Flash gratis en Google Vids
23 de septiembre — Cualquier persona con una cuenta de Google o Google Workspace ya puede generar vídeos gratis con Gemini Omni 1.1 Flash en Google Vids, desde vids.new en un ordenador. La versión 1.1 incorpora tres opciones: prolongar una escena manteniendo los personajes, la iluminación y el decorado; fijar la duración exacta de un clip para ajustarlo a una voz en off; y generar directamente en 1080p. Cada clip lleva una marca de agua SynthID. El despliegue completo comienza el 23 de septiembre y puede tardar entre 1 y 3 días; los planes de pago permiten generar más vídeos, sin que se haya publicado una cifra. Google anuncia para próximamente la narración mediante Gemini 3.8 Flash-Lite TTS en Vids, en más de 100 idiomas.
Made On YouTube 2026: Gemini Omni en la edición de Shorts
23 de septiembre — En su evento anual Made On YouTube, YouTube integra Gemini Omni en un asistente de edición conversacional para Shorts y la aplicación YouTube Create: bastan instrucciones de texto sencillas para recortar intervenciones habladas, sincronizar la música, añadir textos de apertura o reordenar los planos. Las transmisiones en directo incorporan doblaje automático (Live auto-dubbing), YouTube Music recibe Ask Music para crear colas de reproducción mediante una conversación, y Podcast Lineup ofrece cada semana resúmenes hablados, generados por IA, de los pódcasts recomendados. Los creadores también obtienen una detección de semejanza ampliada para proteger su voz y su rostro. Solo los feeds de inicio personalizados (Custom Feeds) tienen fecha aproximada: llegarán este otoño para los espectadores estadounidenses; las demás funciones todavía no tienen un calendario preciso.
🔗 Made On YouTube 2026 · Resumen de Google
Los asistentes se conectan a otras aplicaciones
Gemini: una nueva oleada de aplicaciones conectadas
23 de septiembre — Google despliega una nueva serie de aplicaciones que pueden conectarse a Gemini, descritas por la cuenta @GeminiApp como conexiones MCP. El artículo menciona 14 nombres en tres categorías: productividad (Airtable, Linear, monday.com, PandaDoc, Wispr AI, Zoho), creación (Adobe, Picsart, Squarespace, Webflow) y vida cotidiana (apartments.com, Experian, Peloton, SeatGeek); la publicación de @GeminiApp en X habla, por su parte, de 13 aplicaciones nuevas. Estos servicios se activan en los ajustes o se invocan durante la conversación escribiendo @. Entre los ejemplos figuran retocar la iluminación de una foto con Adobe o consultar la puntuación crediticia con Experian. El artículo no especifica ni los países ni los planes afectados.
🔗 Anuncio de Google · Anuncio de @GeminiApp
Muse, el agente de Meta: Shopify, PayPal, Expedia, Instacart y después ElevenLabs y HeyGen
22 y 23 de septiembre — Muse, el agente personal lanzado por Meta el 8 de septiembre, anunció en menos de 24 horas cuatro conectores para servicios comerciales, todos disponibles «próximamente» según la cuenta oficial @Muse, sin fecha, precio ni países concretos. El día 23, dos empresas de medios generativos anunciaron también su incorporación: ElevenLabs, sin fecha de disponibilidad, y HeyGen, que utiliza su servidor MCP.
| Servicio anunciado | Uso descrito en el anuncio | Anunciado por | Disponibilidad anunciada |
|---|---|---|---|
| Shopify | Pago en un solo gesto en toda la web | @Muse | Próximamente |
| PayPal | Pagos gestionados por el agente en todo el mundo | @Muse | Próximamente |
| Expedia | Reserva de hoteles | @Muse | Próximamente |
| Instacart | Compra de supermercado con entrega a domicilio | @Muse | Próximamente |
| ElevenLabs | Voces en off, bandas sonoras y vídeos | @ElevenLabs | No especificada |
| HeyGen | Vídeo de su avatar, con su voz, listo para publicar | @HeyGen | No especificada |
🔗 Los cuatro conectores anunciados por @Muse · ElevenLabs llega a Muse · HeyGen se incorpora a Muse
Grok Bot en los Tesla y en Google Slides, Sheets y Docs
22 de septiembre — Tesla anuncia la llegada de Grok Bot, el agente de SpaceXAI, a sus coches: con los Connectors, Grok puede gestionar el correo, organizar el calendario o recuperar archivos, conversaciones y tareas existentes, sin que el conductor suelte el volante. La cuenta @grok comparte el anuncio esa misma noche. La activación consta de tres pasos: iniciar sesión en la aplicación Grok del coche, añadir los Connectors desde la aplicación móvil o el sitio web de Grok y suscribirse a SuperGrok, necesario para Grok Bot. Los mensajes no especifican los modelos de vehículo compatibles ni los países.
El mismo día, la cuenta @bot anuncia que Grok Bot se conecta de forma nativa a Google Slides, Sheets y Docs, gestiona mejor los archivos adjuntos de los correos electrónicos (lectura y adición de archivos) y puede dirigir su navegación web a través de la red del usuario. SpaceXAI también promete tareas más rápidas y una aplicación de escritorio más ágil, sin aportar cifras.
🔗 Publicación compartida por @grok · Anuncio de Tesla · Hilo de Grok Bot
Antigravity: agentes en local y comando /plan
El SDK ejecuta sus agentes en local con Gemma 4 26B
23 de septiembre — El SDK Antigravity, que permite acceder desde Python a las capacidades de agentes de Google Antigravity, admite ahora flujos de trabajo completamente locales. La compatibilidad inicial se centra en Gemma 4 26B A4B ejecutado con LiteRT (Google AI Edge), en una máquina con más de 24 GB de VRAM o de memoria unificada; LocalOpenAIAgentConfig se conecta a cualquier servidor compatible con OpenAI, como Ollama, LM Studio o vLLM. Google destaca la ausencia de costes de API y de límites de velocidad, la posibilidad de mantener el código en la máquina y los flujos de trabajo híbridos. Su demostración: Gemini 3.8 Flash planifica en la nube la auditoría de tres módulos vulnerables por 95 tokens, sin llegar a ver el código, mientras instancias locales de Gemma 4 26B reproducen las vulnerabilidades y escriben y validan las correcciones; el 97,2 % de los tokens (3 322) permanece en local. Estas novedades llegaron con el SDK 0.1.18 del 21 de septiembre, que también retira la herramienta de preguntas interactivas ASK_QUESTION de las herramientas predeterminadas para que los agentes funcionen de forma autónoma.
🔗 Anuncio de Google Developers
Antigravity 2.16.0 y 2.17.0, CLI 1.2.8 y 1.2.9
22 de septiembre — La aplicación Antigravity publica dos versiones el mismo día. La 2.17.0 introduce el comando /plan: el agente redacta un plan que se revisa y modifica antes de que escriba una sola línea de código, con un ajuste Plan Review Policy de tres modos (revisar cada plan, dejar que el agente decida u omitir la revisión). También reserva a las reglas un presupuesto de 20 000 tokens y lee la configuración por repositorio en .gemini/config.json; el antiguo .agents/settings.json ya no se tiene en cuenta. La 2.16.0 permite conectarse a una distribución WSL, adjuntar documentos Word, Excel y PowerPoint a un prompt y muestra los subagentes en tarjetas en directo.
| Versión de la aplicación | Número de mejoras | Número de correcciones | Novedad principal |
|---|---|---|---|
| 2.16.0 | 12 | 15 | WSL, archivos adjuntos de Office, tarjetas de subagentes |
| 2.17.0 | 11 | 10 | /plan, presupuesto de 20 000 tokens para las reglas |
22 y 23 de septiembre — En el terminal, la CLI 1.2.9 añade una sintaxis @ para escribir directamente a un subagente y mejora la fiabilidad del modo headless: espera hasta 30 minutos a que terminen las tareas en segundo plano, en vez de cancelarlas unos segundos después de que el agente quede inactivo. La 1.2.8 revisa la compactación del contexto y limita el dictado por voz a 3 min 30 s.
🔗 Registro de cambios de Antigravity
Google DeepMind: una memoria persistente cifrada para Private AI Compute
23 de septiembre — Google DeepMind detalla cómo pretende dotar de memoria persistente a Private AI Compute, su plataforma de procesamiento en enclaves en la nube aislados mediante hardware. Hasta ahora, la plataforma no conservaba el estado: todo el contexto desaparecía al terminar la tarea. La nueva capa funciona como una caja fuerte cifrada en la nube cuyas claves permanecen exclusivamente en los dispositivos del usuario, lo que, según Google, hace que los datos sean inaccesibles para cualquiera, incluido Google. Cuando un modelo necesita información, un enclave seguro descifra temporalmente los datos en memoria aislada, procesa la solicitud, guarda el nuevo contexto y vuelve a cifrarlo de inmediato. El ejemplo citado: encontrar en el ordenador unas instrucciones de montaje consultadas antes con unas gafas conectadas.
Se trata de un anuncio sobre la arquitectura, formulado en futuro, sin fecha de disponibilidad ni producto identificado. Para respaldar la confianza, Google publica un libro blanco actualizado, un registro público a prueba de manipulaciones de su software de servidor que los dispositivos podrán verificar antes de enviar datos personales, y los resultados de una auditoría independiente realizada por una firma cuyo nombre no revela.
Qwen: agentes para smartphones y audio más barato
Qwen Intelligence, tres agentes para los fabricantes de teléfonos
23 de septiembre — Qwen lanza Qwen Intelligence, una oferta de agentes para smartphones dirigida en primer lugar a los fabricantes de teléfonos. Los módulos (planificación, ejecución, imagen y memoria) pueden combinarse según las necesidades, y un sistema de enrutamiento reparte los cálculos entre el dispositivo y la nube. Hay tres agentes en el lanzamiento: Mobile Planner planifica tareas complejas; Mobile-Use las ejecuta recurriendo primero a las API y, si es necesario, a la interfaz gráfica (82,1 en MobileWorld, 97,2 en AndroidDaily y un 90 % de éxito de extremo a extremo, según Qwen); y Mobile Creative genera una imagen en 3 segundos. Qwen abre cuatro benchmarks, pero no los pesos ni el código de los agentes. Mobile-Use y Mobile Creative ya se facturan según el uso, mientras que la facturación de Mobile Planner se anuncia para «próximamente».
| Modelo o sistema evaluado (según Qwen) | Puntuación global MobilePA-Bench |
|---|---|
| Qwen-Planner-Agent 27B | 77,05 % |
| GPT-6 Astra | 76,84 % |
| Claude Opus 5 | 75,71 % |
| Claude Fable 5 | 74,53 % |
| GLM 5.3 | 73,88 % |
🔗 Anuncio de Qwen en X · Informe de Qwen-Planner-Agent
Qwen-Audio-3.1, hasta un 95 % más barato
23 de septiembre — Qwen-Audio-3.1 actualiza los tres modelos de audio de Qwen, reconocimiento de voz (ASR), síntesis de voz (TTS) y conversación en tiempo real (Realtime), y añade otros dos: TTS-Next, que genera en una sola pasada voz, efectos y sonido de fondo, y ASR-Next, que distingue a los hablantes, marca los tiempos de la transcripción y reconoce emociones y ruidos ambientales. Realtime escucha y habla al mismo tiempo y puede interrumpirse. En QwenCloud, qwen-audio-3.1-realtime-plus cuesta 6,4 dólares por millón de tokens de audio de entrada y 24 dólares por millón de tokens de salida de texto y audio, con 262K tokens de contexto; el ASR para archivos cuesta 0,15 dólares por millón de tokens de entrada. Solo estas dos API están disponibles; las demás se anuncian para «próximamente».
| Familia de modelos | Reducción de precio anunciada |
|---|---|
| TTS | aproximadamente un 70 % |
| Realtime | aproximadamente un 85 % |
| ASR | hasta un 95 % |
🔗 Anuncio de Qwen-Audio-3.1 en X · Qwen-Audio-3.1-Realtime en QwenCloud
Mistral Vibe: Chat y Work se fusionan, la CLI restringe sus permisos
Chat y Work se fusionan, base de conocimientos en versión preliminar
22 de septiembre — Mistral publica cuatro notas de versión de Vibe, su asistente (antes Le Chat), sin artículo ni publicación en X. La principal fusiona Chat y Work en una sola experiencia: se hace una pregunta o se inicia una tarea en el mismo lugar, un selector Fast / Think sustituye el cambio de modo y los Skills reemplazan a los Chat Agents, con Deep Research convertido en uno de ellos. La migración comenzó el 14 de septiembre para las cuentas Free, Pro y Teams; las empresas seguirán a partir del 1 de octubre, durante un periodo de unos seis meses. La base de conocimientos para agentes (Agentic Knowledge Base), en versión preliminar pública, sustituye una memoria opaca por páginas que se pueden consultar y modificar, e indica de dónde procede cada dato recuperado. Mini App Canvas genera pequeñas aplicaciones React que se pueden compartir a partir de un prompt, y las hojas de cálculo Excel o CSV llegan a Vibe Work en los planes de pago.
Vibe CLI 2.25.8 corrige formas de eludir los permisos
23 de septiembre — Vibe CLI 2.25.8 incluye 5 incorporaciones y 38 correcciones, varias de ellas relacionadas con la seguridad de los permisos. Una lista de rutas relativas permitidas ya no autoriza un archivo simplemente porque su ruta termina con el mismo sufijo; los comodines de los comandos shell ya no evitan la comprobación de las rutas fuera del directorio de trabajo; y un permiso concedido a un directorio padre ya no cubre automáticamente sus subdirectorios, lo que puede hacer que vuelvan a aparecer algunas solicitudes de aprobación. Las notas también mencionan por primera vez una «Rust CLI», tratada en 18 líneas, que permite, entre otras cosas, configurar los proyectos remotos de Vibe Code. Para las empresas, la configuración impuesta por la organización se aplica desde el inicio de una sesión Unified Harness, y se corrige la conexión OAuth a servidores MCP que emiten un secreto de cliente, como Supabase.
🔗 Notas de versión de Vibe CLI 2.25.8
Agentes de programación abiertos y de línea de comandos
ZCode pasa a ser open source tras problemas de seguridad
21 de septiembre — Información pendiente: Z.ai ha abierto el código de ZCode, su entorno de programación con agentes presentado como la herramienta oficial de GLM-5.3, en respuesta a problemas de seguridad señalados por la comunidad. La cuenta @zcode_ai afirma haber terminado las correcciones necesarias y pide disculpas. El repositorio zai-org/ZCode, con licencia Apache-2.0, contiene los clientes, los servicios backend, la CLI y el runtime del agente; tenía unas 6 500 estrellas el 23 de septiembre.
With respect to the code data referenced by the community, we confirm that no such data is retained and that it has never been used for model training.
🇪🇸 En cuanto a los datos de código mencionados por la comunidad, confirmamos que no se conserva ninguno de esos datos y que nunca se han utilizado para entrenar modelos. — @zcode_ai en X
Según ZCode, dos organismos evaluaron después la situación: para el CAICT, el bucket de Alibaba Cloud OSS «zcode-prod» ya no contiene datos; para NSFOCUS, se eliminaron tanto sus objetos como el propio bucket. Ambos señalan que el cliente v3.14.0 incorpora la corrección, que la función Repo Wiki se ha retirado y que el flujo que subía instantáneas de repositorios locales está desactivado. Z.ai anuncia un proceso permanente para comunicar vulnerabilidades, con recompensas, y promete publicar el informe completo de la evaluación.
🔗 Código fuente de ZCode en GitHub
Kimi Code 2.1.0 refuerza su seguridad
23 de septiembre — Moonshot publica Kimi Code 2.1.0 (2 novedades y 18 correcciones). La novedad visible es un diseño experimental de pantalla completa, que se elige en /settings y se aplica al reiniciar. Varias correcciones refuerzan la seguridad: las herramientas de archivos ya no pueden salir del directorio de trabajo mediante enlaces simbólicos; la configuración local de un proyecto solo se aplica una vez aprobado el espacio de trabajo; la configuración git de un repositorio ya no puede ejecutar comandos durante las operaciones git en segundo plano; y se rechazan los directorios adicionales que apuntan al directorio personal o a la raíz. OAuth para los servidores MCP solicita ahora acceso sin conexión, lo que acaba con las nuevas autorizaciones cada hora. Al mismo tiempo, Moonshot ha archivado el antiguo Kimi CLI escrito en Python (11 424 estrellas), cuyas versiones 1.51.0 y 1.52.0 remiten a Kimi Code.
🔗 Notas de versión de Kimi Code 2.1.0
DeepSeek Harness 0.1.7-rc.1, en versión preliminar
23 de septiembre — DeepSeek publica la v0.1.7-rc.1 de DeepSeek Harness, su entorno de agentes open source con licencia MIT presentado el 13 de agosto. Es una versión candidata (release candidate): el repositorio acumula 21 versiones preliminares desde agosto, sin ninguna versión estable hasta la fecha. Las incorporaciones más destacadas son experimentales: un modo Computer Use que permite al agente actuar en el ordenador local y hacer capturas de pantalla (mediante Cua Driver MCP o un controlador nativo), y tres backends para controlar el navegador (Playwright MCP, Chrome DevTools MCP y Stagehand). La interfaz web incorpora terminales integrados y una revisión de cambios con diffs; el modo headless lee sus tareas de la entrada estándar y emite sus eventos en JSON; y el agente puede trabajar en un espacio remoto mediante SSH. Hay que prever migraciones: el adaptador oficial de DeepSeek pasa a utilizar exclusivamente la Messages API, desaparecen los backends de ejecución E2B y el modo experimental de equipo pasa de 8 a 16 integrantes.
🔗 DeepSeek Harness v0.1.7-rc.1
GenCode, el agente de programación de Genspark
23 de septiembre — Genspark lanza GenCode, un agente de programación integrado en su Super App, disponible en macOS, Windows y Linux y desde la línea de comandos. Su argumento principal es la elección del modelo: Claude, GPT, DeepSeek o un modelo de pesos abiertos, tarea por tarea, desde una sola cuenta y sin tener que configurar una clave de API; Genspark afirma que los modelos abiertos cuestan «entre 1/10 y 1/20». GenCode importa en un solo paso las instrucciones, reglas y memoria creadas para Claude Code. El README del paquete npm @genspark/gencode precisa su origen: deriva de opencode, el agente de programación open source, pero es un producto propietario no afiliado al proyecto, con el que comparte deliberadamente el directorio .opencode/ de los repositorios. El gasto se muestra en créditos de Genspark en cada paso.
🔗 GenCode · Anuncio de Genspark en X
GitHub Copilot: aprobaciones asistidas y entorno aislado local
Copilot para JetBrains 1.18.0
22 de septiembre — La versión 1.18.0 de Copilot para los IDE de JetBrains introduce, en versión preliminar pública, las aprobaciones asistidas (assisted approvals): en las sesiones de agente, las llamadas a herramientas consideradas de bajo riesgo se aprueban automáticamente, mientras que las acciones más arriesgadas siguen requiriendo una decisión. También se puede volver a editar un mensaje anterior: Copilot retrocede entonces la conversación y los cambios en los archivos antes de enviar la nueva instrucción. El agente Codex, disponible en Copilot para JetBrains, incorpora un modo de planificación para revisar, perfeccionar o aprobar el procedimiento antes de cualquier modificación, y las sesiones admiten los skills y las instrucciones de la organización y de la empresa. El servidor MCP GitHub integrado, activo de forma predeterminada, ahora puede desactivarse. Los usuarios de un IDE de JetBrains 2025.1 recibirán un aviso para actualizar a la versión 2026.1 o posterior.
🔗 Novedades de Copilot para JetBrains
La aplicación Copilot aísla sus sesiones locales
23 de septiembre — La aplicación GitHub Copilot, la aplicación de escritorio de GitHub dedicada a sus agentes, incorpora un entorno aislado local en versión preliminar pública. Configurado por proyecto, limita a qué pueden acceder los comandos de una sesión local: el sistema de archivos (directorios con acceso de lectura y escritura, de solo lectura o prohibidos), la red (acceso saliente a internet y a la red local) y las credenciales (Git por HTTPS y GitHub CLI). Los ajustes administrados por la empresa pueden endurecer la política. Si el sistema operativo no puede aplicar la política solicitada, el shell del entorno aislado se detiene con un error en lugar de ejecutarse sin protección. Desactivado de forma predeterminada, el entorno aislado se activa para las nuevas sesiones del proyecto, o con /sandbox on para una sesión en curso; no cubre las sesiones en la nube ni los hosts remotos, y sus ajustes son independientes de los de Copilot CLI.
🔗 Entorno aislado local en la aplicación GitHub Copilot
Cursor: dos bots para el despliegue, un 7 % menos de tokens
Rollouts y Security Review
23 de septiembre — Cursor lanza dos bots dedicados a la última etapa de la entrega de código, disponibles en los planes Teams y Enterprise. Al abrirse cada pull request, Rollouts publica un plan de supervisión (riesgos, efecto esperado y señales que hay que comprobar); después de cada despliegue, lo contrasta con los logs, las métricas y las trazas, y emite un veredicto por entorno: correcto, regresión detectada o no concluyente. Si detecta una regresión, señala el cambio sospechoso y puede abrir una PR para revertirlo, sujeta a aprobación, sin fusionar ni revertir nada por su cuenta. Security Review examina cada pull request y señala las vulnerabilidades explotables (inyecciones, elusión de la autenticación, secretos dejados en el código, SSRF…), cada una con su gravedad, su vía de ataque y una corrección propuesta. Durante 10 días, los créditos de prueba permiten probar Rollouts en unos 50 cambios para Teams y 500 para Enterprise.
🔗 Registro de cambios de Cursor
Un 7 % menos de coste en tokens, sin pérdida de calidad
23 de septiembre — Cursor explica cómo redujo un 7 % el coste en tokens de su agente para los usuarios, sin pérdida de calidad. Como los modelos recientes ya no necesitan largas listas de prohibiciones, acortó el prompt del sistema alrededor de un 66 % y validó los recortes mediante pruebas A/B con tráfico real. Las herramientas integradas, la mayoría de las cuales se utilizan en menos del 20 % de las conversaciones, ahora se cargan cuando se necesitan.
| Medida de optimización | Efecto medido por Cursor |
|---|---|
| Prompt del sistema reducido | alrededor del 66 % del prompt eliminado |
| Herramientas integradas cargadas a demanda | -60 % de tokens de descripción en el contexto estático |
| Puntos de interrupción explícitos de caché | -20 % de fallos de caché en frío |
| Un número de línea cada diez líneas | -1,6 % de tokens leídos desde la caché |
| Conjunto de cambios | -7 % de coste en tokens para los usuarios |
NVIDIA: diarización abierta y AI Day Singapore
Nemotron 3 Diarization distingue hasta ocho hablantes
23 de septiembre — NVIDIA publica en Hugging Face Nemotron 3 Diarization, un modelo de pesos abiertos con 100 millones de parámetros que determina quién habla y cuándo en una conversación, incluso cuando las voces se solapan. Sigue hasta ocho hablantes, frente a los cuatro de su predecesor Streaming Sortformer, y funciona tanto en diferido como en flujo continuo, con una latencia de búfer ajustable de 30,4 a 0,32 segundos. No transcribe las palabras: proporciona intervalos de tiempo por hablante que pueden combinarse con un modelo de transcripción. En los primeros resultados de Diarization-Bench de VoiceArena, ocupa el primer puesto entre 12 sistemas, con un 14,72 % de error de diarización frente al 19,3 % del siguiente; según NVIDIA, esta clasificación inicial aún puede cambiar. Frente al modelo anterior, el error baja un 41 % de media en ocho conjuntos de evaluación, con un ligero retroceso en las conversaciones de dos hablantes de CALLHOME. Licencia OpenMDW 1.1.
| Medida publicada | Nemotron 3 Diarization | Modelo anterior |
|---|---|---|
| Número máximo de hablantes seguidos | 8 | 4 |
| Rendimiento a 30,4 s (lotes de 32, RTX PRO 5000) | 15 113 veces el tiempo real | 2 619 veces |
| Error en DIHARD III a 30,4 s | 12,73 % | 19,09 % |
🔗 Nemotron 3 Diarization en el blog de Hugging Face
AI Day Singapore: Vera Rubin y Nemotron en el Sudeste Asiático
22 de septiembre — En un artículo publicado el día 22 a las 19:30 PT, durante su AI Day Singapore (22 y 23 de septiembre), NVIDIA presenta a Sea Limited, matriz de Shopee, Garena y Monee, como la primera empresa de la región ASEAN en adoptar su plataforma Vera Rubin para desarrollar y desplegar modelos y agentes a mayor escala. El resto del artículo muestra adaptaciones locales de los modelos abiertos Nemotron: AI Singapore amplía su familia SEA-LION, dedicada a las lenguas de la región, con modelos Nemotron; en Vietnam, Viettel AI ha ajustado Nemotron 3 Super para el vietnamita y encabeza el benchmark VMLU; en Tailandia, iApp Technology ha adaptado Nemotron 3 Nano al derecho tailandés con OpenThai 2.0 Legal, publicado como código abierto, que impulsa el chatbot jurídico Thanoy y sus aproximadamente 43 000 usuarios.
🔗 En AI Day Singapore, NVIDIA y sus socios muestran avances de IA en el Sudeste Asiático
Poner la IA en producción sin contratiempos
Dos anuncios comparten una misma idea: validar con cargas reales antes de desviar tráfico o actualizar máquinas.
Los despliegues canary de Together AI
22 de septiembre — Together AI detalla los despliegues progresivos de su oferta Dedicated Model Inference, disponibles desde la actualización del 15 de septiembre: permiten cambiar el modelo servido detrás de un endpoint sin interrupciones ni cambios de URL. Se ofrecen tres estrategias: canary aumenta el tráfico hacia el nuevo modelo por etapas (5 %, 25 %, 50 % y luego 100 % por defecto); blue-green desvía todo el tráfico de una vez; y la sustitución progresiva cambia las réplicas una a una. Tras cada etapa de canary, un control compara la latencia o la tasa de errores con las del modelo anterior y pausa el despliegue si empeoran. En la demostración publicada, el paso de Qwen2.5-7B a Qwen3.5-9B se detuvo al alcanzar el 10 % del tráfico por una regresión del 137 % en la latencia p95 (1 740 ms frente a 734 ms); la vuelta al modelo anterior se realizó sin que fallara ninguna de las 6 800 solicitudes atendidas.
🔗 Despliegues canary: actualizar modelos en producción sin interrupciones
NVCRE y NodeWright de NVIDIA
23 de septiembre — NVIDIA detalla dos proyectos de código abierto (Apache 2.0) de DSX OS, la capa de software de su plataforma de fábricas de IA, destinados a clústeres GPU con Kubernetes. NVIDIA Cluster Readiness Engine (NVCRE) parte de una observación: un clúster puede superar todos sus controles de estado y aun así fallar durante un entrenamiento distribuido. Por eso lo certifica con cargas reales (pruebas de comunicación NCCL, diagnósticos DCGM y preentrenamiento NeMo) en grupos de nodos elegidos según la topología, identifica los nodos causantes y, en modo diagnóstico, divide los grupos que fallan en dos hasta aislar a los sospechosos. El artículo menciona entre esas cargas modelos Nemotron 5 de 8 y 56 mil millones de parámetros, sin más detalles. NodeWright, antes llamado Skyhook y utilizado en producción por NVIDIA, actualiza el sistema de los nodos (ajustes del núcleo, agentes de seguridad y parches de vulnerabilidades) tras esperar a que terminen las tareas protegidas, en oleadas fijas, lineales o exponenciales que se detienen automáticamente si fallan demasiados lotes.
🔗 Validar la preparación de los clústeres GPU antes de ejecutar cargas de IA · NodeWright
Dos conjuntos de datos abiertos: conversaciones con varias voces y corpus científico
Basis Conversations 1500
23 de septiembre — Basis publica en Hugging Face Basis Conversations 1500: 1 502 horas de conversaciones espontáneas entre 2 645 personas de 33 países, en 22 lenguas, desde el inglés hasta el mingreliano y el xhosa. En cada conversación participan entre dos y cuatro personas, cada una grabada en su propia pista sincronizada (FLAC 48 kHz), lo que permite estudiar solapamientos, interrupciones y turnos de palabra, aspectos que, según el equipo, todavía plantean dificultades a los modelos. Unas 100 horas cuentan con anotaciones detalladas hechas por personas (113 096 juicios): respuestas vocales compasivas o molestas, silencios incómodos y solapamientos cooperativos o competitivos. Las transcripciones proporcionadas son automáticas y no deben utilizarse como objetivos de entrenamiento sin verificarlas. El artículo presenta el conjunto como libre para usos comerciales y de investigación, pero está sujeto a una licencia propia de Basis (basis-data-license-1.0) y requiere una aprobación manual para acceder.
QVAC Genesis III
23 de septiembre — Tether AI Research publica QVAC Genesis III, la tercera entrega de su corpus sintético destinado al preentrenamiento de modelos pequeños en ciencias, tecnología, ingeniería y matemáticas. Con 43,06 mil millones de tokens adicionales, el conjunto alcanza 191,43 mil millones de tokens y unos 160 millones de documentos en 19 áreas; el artículo que lo acompaña ha sido aceptado en la conferencia COLM 2026. El método interroga a un modelo alumno pequeño, Qwen3-1.7B-Base: un error da lugar a una explicación correctiva y un acierto, a un análisis de cada opción de respuesta. Entrenado desde cero con este corpus, un modelo de 1,7 mil millones de parámetros mejora claramente frente al mismo modelo entrenado con Cosmopedia-v2, con el mismo presupuesto de tokens. El corpus se publica bajo una licencia no comercial (CC-BY-NC 4.0), y se anuncia un modelo entrenado con él bajo Apache 2.0.
| Benchmark evaluado | Mejora frente a Cosmopedia-v2 (mismo presupuesto de tokens) |
|---|---|
| ARC-Easy | +28,57 puntos |
| ARC-Challenge | +21,35 puntos |
| GPQA Diamond | +2,52 puntos |
| MMLU STEM | +15,03 puntos |
La IA para el clima y la alimentación
Ai2 y Global Fishing Watch vigilan los océanos con agentes
23 de septiembre — Durante la Climate Week de Nueva York, Ai2 y Global Fishing Watch anuncian una alianza para incorporar la IA, y en particular agentes, a la vigilancia de los océanos y el control de la pesca. Las dos organizaciones ya colaboraban; ahora pasan al desarrollo conjunto: un pipeline de detección compartido, nuevos modelos de visión en tiempo real aplicados a imágenes satelitales y agentes capaces de cruzar varias fuentes de datos. Global Fishing Watch dispondrá de OlmoEarth, la plataforma de observación de la Tierra de Ai2 basada en modelos abiertos, para anotar sus datos y entrenar sus propios modelos. Las detecciones de embarcaciones en tiempo real de Skylight se incorporarán a su portal para gestores de áreas marinas, y ambos equipos seguirán desarrollando agentes como Shippy, al que un analista puede solicitar el historial de una embarcación. El anuncio no incluye fechas ni importes.
🔗 Ai2 y Global Fishing Watch se unen para llevar agentes de IA a la vigilancia de los océanos
Google.org y la Gates Foundation, para 200 millones de pequeños agricultores
18 y 22 de septiembre — Actualización: Google.org y la Gates Foundation amplían su iniciativa conjunta para poner herramientas de IA climáticas, agrícolas y lingüísticas a disposición de 200 millones de pequeños agricultores de África subsahariana y Asia meridional, frente a los 50 millones previstos inicialmente. Los dos socios destinan a ello una financiación conjunta de 100 millones de dólares, con el apoyo técnico de investigadores e ingenieros de Google. El comunicado de la Gates Foundation es del 18 de septiembre; blog.google se hizo eco de él la noche del 22. El programa financia a organizaciones locales como Wadhwani AI y Digital Green en India, integra pronósticos basados en IA en la plataforma climática TomorrowNow, cartografía las parcelas con una resolución inferior a un metro y apoya conjuntos de datos abiertos de voz y texto en más de 40 lenguas africanas. Los pequeños agricultores producen cerca del 35 % de los alimentos del mundo.
🔗 Anuncio de Google.org · Comunicado de la Gates Foundation
Breves
- Anthropic, modernización de código — En la serie «Notes from the Field», dos ingenieros de Anthropic asignados a clientes, Jonah Ezekiel y Lexie Tonelli, proponen seis pasos para preparar una modernización de código dirigida por agentes: objetivo, «certificado» de pruebas, revisión humana por etapas, requisitos previos, flujo de agentes y puesta en marcha. No dan cifras de costes: aconsejan medirlos en un proyecto piloto. 🔗 fuente
- Boris Cherny verifica el Claude Agent SDK con Lean — La noche del 22, Boris Cherny (Claude Code) contó que hizo verificar formalmente el Claude Agent SDK por Opus 5.5 con el asistente de pruebas Lean: unos cuantos prompts breves produjeron 16 pull requests que corrigen errores y problemas de concurrencia. Dice que también utiliza TLA+. 🔗 fuente
- Codex CLI 0.156.1 — Esta corrección de la versión 0.156.0 añade GPT-6 Sol y GPT-6 Luna al selector de modelos del CLI; el aviso que aparece al alcanzar el límite de solicitudes recomienda ahora Luna, y se proponen migraciones desde GPT-5.5 y GPT-5.6. 🔗 fuente
- Airbnb y GPT-6 Astra — Un nuevo acuerdo amplía el acceso de los equipos de ingeniería y producto de Airbnb a los modelos de OpenAI, incluido GPT-6 Astra, mediante la API de OpenAI y Amazon Bedrock. Su director técnico, Ahmad Al-Dahle, afirma que sus equipos entregan aproximadamente un 80 % más de funcionalidades que hace un año; no se ha comunicado el importe del acuerdo. 🔗 fuente
- OpenAI Academy cumple dos años — Más de 250 eventos y más de 4 millones de personas alcanzadas desde septiembre de 2024; OpenAI está probando un programa de formadores comunitarios (Community Trainer Program) en el que empleados de organizaciones asociadas aprenden a impartir talleres tras una evaluación. 🔗 fuente
- Un panel LED convertido en asistente de voz — En el blog OpenAI Developers, Sid Rampally cuenta cómo Codex le ayudó a conectar y programar un panel LED de 128 × 64 píxeles controlado por una Raspberry Pi; GPT-Live-1 mantiene la conversación y delega las búsquedas y la visualización a GPT-5.6 Luna mediante la Responses API. 🔗 fuente
- MedGemma supera los 10 millones de descargas — Google detalla usos prácticos de sus modelos médicos abiertos: detección del cáncer de cuello uterino en más de 3 500 mujeres en Zambia, proyectos piloto en el hospital AIIMS de Delhi y detección de la tuberculosis en Indonesia. Google recuerda que sus resultados no deben guiar directamente un diagnóstico. 🔗 fuente
- Gemini Notebook en Google Docs — Al escribir @ en Docs, se puede citar un notebook como fuente: Gemini fundamenta el texto que redacta en esas fuentes, con citas en línea, y las combina con correos electrónicos y archivos mediante Workspace Intelligence. Disponible para Business Standard y Plus, Enterprise Standard y Plus, Education Plus y los suscriptores de Google AI Pro y Ultra. 🔗 fuente
- Seis herramientas de Google Flow — Google Labs publica seis herramientas creadas por profesionales creativos con Google Flow Tools: Mondo Sónico (efectos de sonido sincronizados), CaptionCast (subtítulos animados), ThumbnailForge (miniaturas), Surface (texturas sobre superficies en 3D), CollageMotion Pro y SwissFlow Studio (diseño de movimiento); todas pueden duplicarse y remezclarse. 🔗 fuente
- Google Beam ya se entrega en Francia — Beam, la plataforma de comunicación por vídeo de Google que busca recrear la sensación de estar cara a cara y se vende con HP, ya se entrega en seis países, entre ellos Francia, con 18 socios. Un estudio interno señala que los equipos se sienten un 50 % más conectados y celebran un 21 % menos de reuniones de seguimiento. 🔗 fuente
- Android Enterprise y los agentes Gemini — Gemini puede encadenar tareas entre aplicaciones a partir del contexto mostrado en pantalla, mientras que ciertas salvaguardas impiden que los agentes personales accedan al perfil de trabajo; los administradores pueden restringir o desactivar la automatización mediante IA en todos sus dispositivos. 🔗 fuente
- AI Brief en francés — La beta cerrada de AI Brief, que ayuda a configurar las campañas AI Max de Google Ads mediante instrucciones expresadas con palabras propias, se amplía al francés, neerlandés, alemán, italiano, japonés, portugués y español. 🔗 fuente
- Gemini CLI, versión nightly del 23 de septiembre — Se trata solo de una versión nightly, no de una versión estable: añade Gemini 3.8 Flash y Gemini 3.5 Flash Lite, disponibles de inmediato mediante clave API, Vertex AI o una pasarela, y mediante indicadores experimentales con una cuenta de Google. El martes 22 no salió ninguna versión estable. 🔗 fuente
- EcoHash mide sus optimizaciones de vídeo — En una RTX PRO 6000 de 96 GB, EcoHash reduce el tiempo de generación de un vídeo con MiniMax H3 de 174,8 a 40,8 segundos y el de Wan2.2 de texto a vídeo de 132,3 a 10,7 segundos, con una LoRA destilada en 4 pasos; tres de los diez ajustes probados, incluidos los dos modos de compilación, no cambiaron nada. 🔗 fuente
- Tártaro de Crimea: se evita una prueba sesgada — El desarrollador de un modelo de reconocimiento de voz para el tártaro de Crimea descubrió que cuatro audiolibros aparecían dos veces en su corpus: el 96,9 % de los fragmentos de su prueba principal tenían un duplicado en los datos de entrenamiento. Tras corregirlo, ajustar una LoRA y configurar el decodificador, la tasa de error por palabra pasó de 0,3463 a 0,1701. 🔗 fuente
- Falcon-H1 y mlx-lm — En mlx-lm 0.31.3, sin caché KV, solo se ejecuta la primera de las 66 capas de Falcon-H1 durante el entrenamiento: cualquier LoRA se entrena sin errores ni advertencias sobre un modelo de una sola capa. La corrección consiste en una línea y ya hay una incidencia abierta. 🔗 fuente
- Agentes y contribuciones a proyectos de código abierto — Quentin Gallouédec (Hugging Face) considera que las contribuciones generadas por agentes eliminan la señal de una necesidad real y consumen tiempo de revisión de los mantenedores; pide que se deje de enviar agentes a proyectos elegidos al azar y que se empiece por utilizar el proyecto. 🔗 fuente
- Phionyx ante el IETF — El autor de Phionyx presenta un borrador individual, Claim-Preserving Exchange of AI Evaluation Evidence, para que los resultados de una evaluación conserven sus condiciones y limitaciones al pasar de un sistema a otro; ningún grupo de trabajo ha adoptado el texto. 🔗 fuente
- Kimi Work 3.2.12 — El agente de escritorio de Moonshot permite seleccionar un fragmento de un archivo PPT, Excel, Word o Markdown para modificarlo con precisión; se elimina el límite de tamaño de los archivos adjuntos. 🔗 fuente
- Qwen-Image-2.1 encabeza los modelos abiertos — Según Arena, Qwen-Image-2.1 pasa a ser el primer modelo abierto en edición de imágenes (1 367 puntos, 16.º en la clasificación general) y en generación de imágenes a partir de texto (1 228 puntos, 17.º en la clasificación general). 🔗 fuente
- OpenTelemetry en la app Copilot — Los administradores pueden exportar los registros de las sesiones de agentes de la app GitHub Copilot (solicitudes a los modelos y herramientas utilizadas) a sus herramientas de supervisión mediante la propiedad
telemetrydemanaged-settings.json; el contenido de los prompts y las respuestas queda excluido de forma predeterminada. 🔗 fuente - Copilot CLI y C++ — El Microsoft C++ Language Server de Copilot CLI crea ahora un índice persistente de los símbolos de todo el proyecto, activado de forma predeterminada; la primera creación puede tardar y consumir mucha memoria, y GitHub no cuantifica la mejora. 🔗 fuente
- Una pull request de un millón de líneas — Un artículo de ingeniería de GitHub explica cómo la app Copilot muestra una pull request de 2 200 archivos, más de un millón de líneas y más de 400 comentarios: separa la geometría del código, calculada de antemano, de la de los comentarios, medida cerca de la zona visible. 🔗 fuente
- Genspark añade Opus 5.5, GPT-6 y Grok 4.7 — Durante la noche del 23, Genspark incorpora Claude Opus 5.5, Grok 4.7, GPT-6 Sol y GPT-6 Luna a AI Chat, Code Agent y Claw, retomando los argumentos de sus proveedores, sin precisar planes ni precios. 🔗 fuente
- Encuesta de GitHub y Yale — Entre 1 039 usuarios de GitHub en Estados Unidos, el 71 % dice estar preocupado por el impacto ambiental de la IA y ocho de cada diez quieren herramientas para escribir código más eficiente en términos de energía; GitHub aclara que la muestra, formada por personas que aceptaron recibir sus comunicaciones de marketing, no es representativa. 🔗 fuente
- Zed 1.21.0 — La versión estable permite utilizar Claude Opus 5.5 y GPT-6 Astra, Sol y Luna con una clave API propia, añade la conexión con SuperGrok en el panel Agent e impide de forma predeterminada que el equipo entre en suspensión mientras trabaja un agente. 🔗 fuente
- Warp — GPT-6 Sol y Luna, seguidos de Claude Opus 5.5, llegan al terminal Warp y a Warp Agent CLI, al igual que Grok 4.7 para quienes conecten su suscripción a Grok; se anuncia su disponibilidad, sin precios. 🔗 fuente
- Devin en Microsoft Teams — Devin, hasta ahora limitado a los canales, responde ahora a mensajes directos y conversaciones de grupo, inicia Automations desde un canal y envía tarjetas de pregunta o aprobación; la aplicación no solicita ningún permiso nuevo. 🔗 fuente
- Scribe v2 Medical — Disponible desde el 11 de septiembre, el modelo de transcripción clínica de ElevenLabs recibe su anuncio oficial, con un dato nuevo: un 35 % menos de errores de palabras en audio clínico frente a Scribe v2. Su precio parte de 0,22 dólares por hora. 🔗 fuente
- Sora 2 sale de ElevenLabs — ElevenLabs retira Sora 2 y Sora 2 Pro de su estudio porque OpenAI cierra la API de Sora el 24 de septiembre, una fecha anunciada por OpenAI el 24 de marzo; los flujos afectados deben pasar a otro modelo de vídeo, como Gemini Omni 1.1 Flash. 🔗 fuente
- Cohere Model Vault en Canadá — Cohere anuncia que Model Vault, su plataforma de inferencia dedicada de un solo inquilino, está disponible en Canadá, sin precisar la región de la nube, el proveedor ni el precio; la página del producto aún no menciona Canadá. 🔗 fuente
- Cohere y la gestión del cambio — Un artículo de Katherine Correia (Cohere) invita a integrar la IA como participante en lugar de tratarla como una simple herramienta, a clasificar las tareas en verificables, basadas en el juicio o híbridas, y a establecer normas para cada caso de uso; no presenta productos ni cifras. 🔗 fuente
Qué significa
El resultado de Anthropic lleva a los agentes de programación al terreno de la biología fundamental. Unos 950 agentes Claude clasificaron más de 200 000 transcriptasas inversas en 21 horas, y los humanos solo intervinieron al principio, con un prompt, y al final, para los experimentos. El cuello de botella se desplaza hacia la selección de hipótesis, que Anthropic estudia ahora como objeto de investigación. Conviene mantener la cautela: se desconoce la función de ART y, por ahora, el resultado se presenta como una prepublicación. La misma lógica de desplegar numerosos agentes y orientar su trabajo mediante mediciones aparece en el sprint que aceleró claude.ai, con más de 3 000 cambios, y en la verificación formal del Claude Agent SDK con Lean.
La seguridad de los entornos aislados para agentes se convierte en un asunto público. La auditoría de Perplexity distingue dos límites de seguridad: el aislamiento de la máquina virtual resistió en los 108 ensayos; el filtrado de red falló 11 veces en 54 intentos ante modelos que aprovecharon un DNS mal verificado o las direcciones compartidas de una CDN; y 8 de cada 10 plataformas de terceros presentaban al menos una forma de eludir las restricciones. Dos modelos, Fable y GPT-6 Astra, rechazaron el ejercicio. Ese mismo día, la app GitHub Copilot incorpora un entorno aislado local que falla antes de ejecutarse sin protección, el modo auto de Claude Code somete al clasificador incluso las órdenes de solo lectura, y Vibe CLI y Kimi Code corrigen vías para eludir las autorizaciones; dos días antes, ZCode había abierto su código tras los problemas señalados por su comunidad.
La voz se convierte en una interfaz para actuar. Gemini 3.8 Flash TTS y Flash-Lite TTS reducen el precio de la salida de audio a menos de la mitad respecto a la versión preliminar anterior (9 y 6 dólares por millón de tokens hasta finales de 2026, frente a 20) y añaden una función de replicación de voz sujeta a un consentimiento grabado, que no está disponible en el Espacio Económico Europeo a través de AI Studio. Qwen anuncia rebajas del 70 al 95 % en su conjunto de herramientas de audio, NVIDIA presenta un modelo que distingue ocho hablantes y Basis publica 1 500 horas de conversaciones con voces superpuestas. Mientras tanto, ChatGPT Voice pasa de conversar a actuar, mediante los plugins y las tareas de ChatGPT Work.
Por último, la IA física se abre, aunque con matices. FLUX 3 Action sitúa un modelo de 7 000 millones de parámetros a la cabeza de RoboLab-120, lo integra en LeRobot con NVIDIA y muestra que una política rápida y fiable reduce la necesidad de razonamiento costoso: 8,77 dólares por éxito con GPT-6 Astra como supervisor, frente a 13,47 con Astra solo. Pero «abierto» abarca realidades distintas: una licencia propia tanto para FLUX 3 Action como para Basis Conversations 1500, una licencia no comercial para QVAC Genesis III y benchmarks publicados sin los pesos para Qwen Intelligence. Para quien quiera reutilizar estos recursos, la licencia importa tanto como la puntuación.
Fuentes
- Claude descubre un nuevo sistema enzimático con repeticiones similares a CRISPR (Anthropic)
- Prepublicación de ART (PDF, Anthropic)
- @AnthropicAI: el sistema enzimático descubierto por Claude
- Gemini 3.8 Flash TTS y Flash-Lite TTS (Google)
- Notas de la versión de la API de Gemini, 22 de septiembre
- Precios de la API de Gemini
- FLUX 3 Action (Black Forest Labs)
- @bfl_ai: lanzamiento de FLUX 3 Action
- Colección FLUX 3 Action en Hugging Face
- Escapar de SPACE, parte I (Perplexity)
- Claude Code v2.1.281
- Cómo hicimos que claude.ai fuera tres veces más rápido en dos semanas (claude.dev)
- Claude Marketplace (Anthropic)
- @OpenAI: ChatGPT Voice con los plugins y en ChatGPT Work
- Artículo de ayuda de ChatGPT Voice
- Notas de la versión de ChatGPT
- Presentación de MentalHealthBench (OpenAI)
- SWE-Serve (NVIDIA)
- Repositorio NVIDIA/swe-serve
- Runway ya está en DaVinci Resolve
- Gemini Omni 1.1 Flash en Google Vids
- Made On YouTube 2026
- Resumen de Made On YouTube 2026 (Google)
- Nuevas aplicaciones conectadas de Gemini
- @GeminiApp: 13 nuevas aplicaciones conectadas
- @Muse: cuatro conectores próximamente
- @ElevenLabs: ElevenLabs llega a Muse
- @HeyGen: HeyGen se une a Muse
- @grok: Grok Bot en los Tesla
- @Tesla: Grok y los Connectors
- @bot: Grok Bot conectado a Google Slides, Sheets y Docs
- Modelos locales en el SDK de Antigravity (Google Developers)
- Registro de cambios de Antigravity
- Memoria persistente para Private AI Compute (Google DeepMind)
- @Alibaba_Qwen: Qwen Intelligence
- Informe sobre Qwen-Planner-Agent
- @Alibaba_Qwen: Qwen-Audio-3.1
- Qwen-Audio-3.1-Realtime en QwenCloud
- Notas de la versión de Mistral
- Vibe CLI 2.25.8
- @zcode_ai: publicación del código de ZCode
- Repositorio zai-org/ZCode
- Kimi Code 2.1.0
- DeepSeek Harness v0.1.7-rc.1
- GenCode (Genspark)
- @genspark_ai: lanzamiento de GenCode
- Copilot para JetBrains 1.18.0 (registro de cambios de GitHub)
- Entorno aislado local en la aplicación GitHub Copilot (registro de cambios de GitHub)
- Despliegues graduales y revisión de seguridad (registro de cambios de Cursor)
- Mayor eficiencia en el uso de tokens (Cursor)
- Nemotron 3 Diarization (NVIDIA, blog de Hugging Face)
- AI Day Singapore (NVIDIA)
- Despliegues graduales (Together AI)
- NVIDIA Cluster Readiness Engine (NVIDIA)
- NodeWright (NVIDIA)
- Basis Conversations 1500 (blog de Hugging Face)
- QVAC Genesis III (blog de Hugging Face)
- Ai2 y Global Fishing Watch (Skylight)
- Google.org y la Gates Foundation (blog.google)
- Comunicado de la Gates Foundation
- Cómo prepararse para proyectos de modernización de código impulsados por IA (Anthropic)
- @bcherny: verificación formal del Claude Agent SDK en Lean
- Codex CLI 0.156.1
- Airbnb y GPT-6 Astra (OpenAI)
- Dos años de OpenAI Academy
- Cómo di vida a mi pantalla LED (OpenAI Developers)
- MedGemma y la salud mundial (Google)
- Gemini Notebook en Google Docs (Workspace Updates)
- Seis herramientas de Google Flow (Google Labs)
- Google Beam se expande a seis países (Google)
- Novedades de Android Enterprise 2026 (Google)
- AI Brief y AI Max (Google Ads)
- Gemini CLI v0.62.0-nightly.20260923
- Tres de diez optimizaciones no tuvieron ningún efecto (EcoHash)
- Reconocimiento de voz del tártaro de Crimea (blog de Hugging Face)
- Ajuste fino de Falcon-H1 en un Mac (blog de Hugging Face)
- El camino al infierno del código abierto está empedrado de buenas intenciones (blog de Hugging Face)
- El panel indica PASS. ¿Qué pasó exactamente? (Phionyx)
- Notas de la versión de Kimi Work
- @arena: Qwen-Image-2.1, primer modelo abierto
- OpenTelemetry en la aplicación GitHub Copilot
- Inteligencia de código C++ en Copilot CLI
- Renderización de solicitudes de incorporación de cambios enormes en la aplicación GitHub Copilot
- @genspark_ai: Claude Opus 5.5 en Genspark
- Estudio de GitHub y Yale sobre la eficiencia del desarrollo de software
- Zed 1.21.0
- @warpdotdev: GPT-6 Sol y Luna en Warp
- Devin, Microsoft Teams y Microsoft 365
- @ElevenLabs: Scribe v2 Medical
- Registro de cambios de ElevenLabs del 23 de septiembre
- @cohere: Model Vault en Canadá
- Gestión del cambio en IA (Cohere)