ai-powered-markdown-translatorgpt-6-sol을 사용해 프랑스어에서 한국어로 번역한 기사.
9월 23일, Anthropic은 분자생물학 연구실과 그 첫 성과를 공개했다. 약 950개의 Claude 에이전트가 박테리오파지 DNA에서 미지의 효소 시스템 ART를 찾아냈다. Google은 음성을 만들고 복제하는 합성 음성 모델 Gemini 3.8 Flash TTS와 Flash-Lite TTS를 출시했다. Black Forest Labs는 로봇 제어용 공개 가중치 모델 FLUX 3 Action을 발표했고, Perplexity는 자사 에이전트가 실행되는 샌드박스 SPACE의 첫 보안 감사 결과를 공개했다.
Anthropic이 분자생물학 연구실을 열고 Claude가 ART를 발견하다
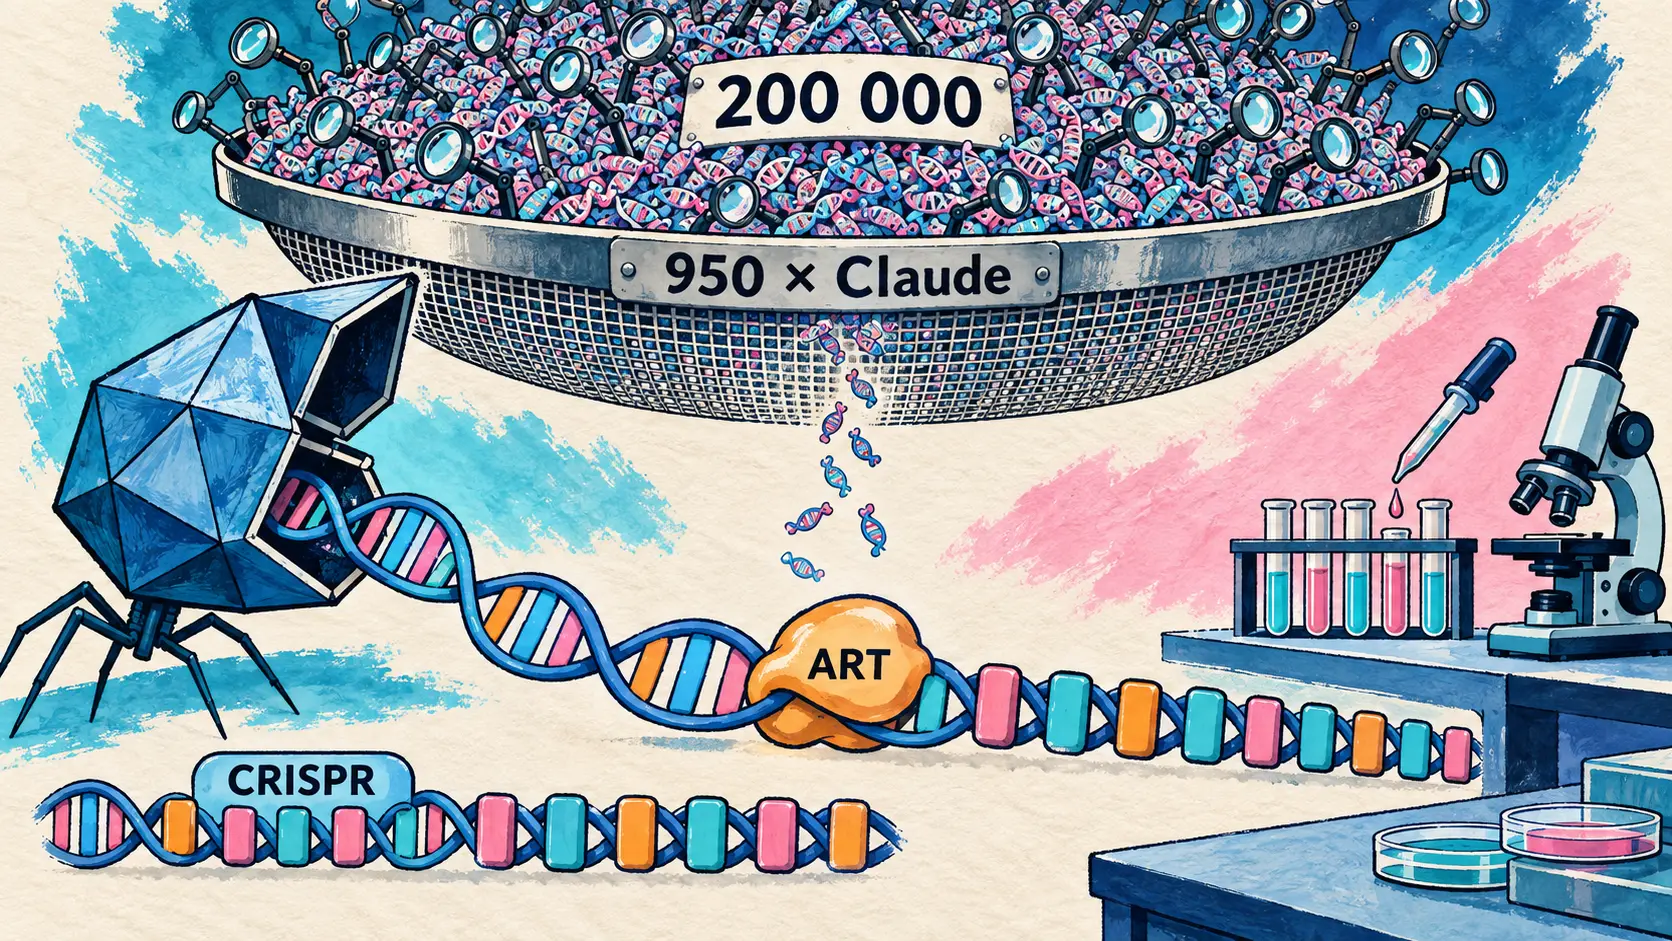
9월 23일 — Anthropic은 생명과학 연구 조직을 새로 소개했다. 이 조직은 봄에 구성됐으며 샌프란시스코 베이 지역에 자체 분자생물학 연구실을 두고 있다. 첫 성과는 Claude 에이전트가 박테리아를 감염시키는 바이러스인 박테리오파지의 DNA에서 발견한, 지금까지 보고된 적 없는 효소 시스템이다. Anthropic은 이를 ART(array-associated reverse transcriptases, 배열 연관 역전사효소)라고 이름 붙였다.
출발점은 하나의 프롬프트였다. 방대한 DNA 서열 데이터베이스에서 RNA를 DNA로 복사하는 효소인 역전사효소의 새로운 사례를 찾으라는 요청이었다. 약 950개의 에이전트는 21시간 동안 토큰 2억 1,000만 개를 사용해 역전사효소 20만 개 이상을 모으고, 새로운 후보 시스템 3,500개를 추려낸 뒤, 가장 유망한 20개를 선정했다. 각 후보에는 사람이 읽을 수 있는 보고서가 첨부됐다. Anthropic에 따르면 이런 분석에는 전문가가 몇 주에서 몇 달까지 걸리며, 사람의 개입은 최초 프롬프트와 실험실 실험에 한정됐다.
| 연구 과정 단계 | 측정값 |
|---|---|
| 탐색 시간 | 21시간 |
| 투입된 Claude 에이전트 | 약 950개 |
| 사용한 토큰 | 2억 1,000만 개 |
| 수집한 역전사효소 | 20만 개 이상 |
| 새로운 후보 시스템 | 3,500개 |
| 선정해 분석한 후보 | 20개 |
ART는 세 요소로 이루어진다. 역전사효소, 기능이 알려지지 않은 인접 유전자, 그리고 일정한 간격으로 반복되는 긴 DNA 서열 배열이다. 이 배열의 구조는 CRISPR 배열을 연상시킨다. 거대 파지에서 발견된 역전사효소 자체는 이미 알려져 있었지만, Anthropic에 따르면 Claude가 이와 함께 있는 비암호화 배열과 단백질에 주목한 것은 « 최초인 것으로 보인다 ». 초기 실험에서는 이 배열이 각각 구별되는 작은 RNA 형태로 발현됨을 보여준다. Anthropic은 ART의 기능이 아직 알려지지 않았고 추가 실험이 진행 중이라며 신중한 입장을 보인다. Anthropic에 따르면 알려진 시스템 중 이런 특징을 공유하는 것은 소수에 불과하며, 모두 프로그래밍이 가능하고 DNA를 자르고, 복사하고, 붙여 넣을 수 있다.
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR.
🇰🇷 Claude는 박테리오파지의 DNA에 숨어 있던, 지금까지 알려지지 않은 효소 시스템을 발견했습니다. 효소 유전자 옆에는 CRISPR와 조금 닮은 구조의 긴 반복 DNA 배열이 있습니다. — X의 @AnthropicAI
이 연구실은 생물안전등급 BSL-1과 BSL-2 수준의 작업만 수행하며, 사람을 감염시킬 수 있는 병원체는 다루지 않는다. 실험대에서 하는 모든 작업은 인간 과학자가 맡는다. 연구진은 Claude Science와 Claude Code를 사용하며, 때로는 여러 세션을 병렬로 조율하는 자체 개발 도구도 쓴다. 한 번의 연구에서 수백 개, 많게는 수천 개의 보고서가 나오기 때문에 가설 자체도 연구 대상이 된다. 연구자들이 어떤 가설을 시험할 가치가 있다고 판단하는지 분석해 Claude에 주는 지시를 다듬는다. CRISPR 유전체 편집의 선구자인 Feng Zhang(MIT 및 Broad Institute)은 사전 공개 논문을 검토하고, AI 에이전트가 생물학적 발견에 기여할 수 있음을 보여주는 고무적인 사례라고 평가했다. Anthropic은 이 사전 공개 논문을 발표하고 과학자들에게 연구 질문을 보내 달라고 요청했다.
🔗 Claude가 CRISPR 유사 반복 서열을 가진 새로운 효소 시스템을 발견하다 · 사전 공개 논문(PDF)
Gemini 3.8 Flash TTS와 Flash-Lite TTS: Google이 음성을 만들고 복제하다
9월 23일 — Google은 Gemini 제품군에 두 가지 음성 합성(text-to-speech) 모델을 추가했다. Google이 자사에서 가장 표현력이 뛰어난 오디오 모델이라고 소개한 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS다. 두 모델 모두 Gemini API와 Google AI Studio에서 정식으로 제공되며, 새로운 Voices 엔드포인트도 사용할 수 있다. API 변경 기록에는 9월 22일 자로 올라왔고, 공식 발표는 23일에 나왔다.
두 모델의 용도는 다르다. Flash TTS는 음성 제작에 쓰인다. 자연어로 목소리의 역할, 억양, 성격을 설명한 다음 각 대사의 연기, 속도, 방언 변화를 지시할 수 있다. Google은 게임, 오디오북, 팟캐스트에 적합하다고 설명한다. Flash-Lite TTS는 대량 처리와 비용에 초점을 맞췄다. 대규모 더빙, 대량 오디오 제작, 실시간 음성 에이전트를 겨냥하며 gemini-3.1-flash-tts-preview을 대체할 예정이다. 두 모델 모두 하나의 대본에서 두 목소리의 대화를 처리하고, 음색이 눈에 띄게 변하지 않는 몇 시간 분량의 오디오를 생성하며, <laughs>, <sigh>, |mhm| 같은 태그를 지원한다.
발표 글은 퀘벡 프랑스어 같은 지역별 변형을 포함해 바로 쓸 수 있는 음성이 2,000개 이상이라고 밝힌다. 한편 API 문서에는 스튜디오 음성 30개와 수백 개의 음성으로 이루어진 확장 라이브러리가 설명돼 있다. 음성 복제에는 30초 분량의 샘플이 필요하며, 음성 소유자의 구두 동의를 녹음해야 한다. 생성된 모든 오디오에는 SynthID 워터마크가 적용된다. 프랑스 독자에게 중요한 점은 발표 글의 주석에 따르면 AI Studio를 통한 음성 복제가 유럽경제지역, 영국, 스위스, 인도, 일리노이주, 텍사스주에서는 제공되지 않는다는 것이다. 기존 음성의 리믹스 기능도 곧 제공될 예정이다.
| 모델 특성 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| API 식별자 | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 지원 언어(API 문서 기준) | 130 | 101 |
| 주된 용도 | 제작, 세밀한 연출 | 대량 처리, 더빙, 음성 에이전트 |
| 출력 오디오, 31/12/2026까지의 Standard 요금(토큰 100만 개당) | 9달러 | 6달러 |
| 출력 오디오, 01/01/2027부터의 Standard 요금(토큰 100만 개당) | 18달러 | 12달러 |
| 일반 소비자용 제품 | Gemini Notebook | Google Vids(내레이션 도입 예정) |
비교하면 Gemini 3.1 Flash TTS Preview의 출력 오디오 요금은 토큰 100만 개당 20달러다. Google은 외부 평가 결과도 제시했다. Flash TTS는 Hume AI의 Voice Design Benchmark에서 71,4점으로 1위를 차지했고, 두 모델은 Hume AI의 Overall Quality Index에서 각각 1위와 2위에 올랐다. 두 모델은 « 곧 » API를 통해 Gemini Enterprise에도 제공될 예정이다.
🔗 Google 발표 · Gemini API 출시 기록 · API 요금
FLUX 3 Action: Black Forest Labs가 로봇 제어용 공개 가중치 모델을 발표하다
9월 23일 — 이미지 모델 FLUX로 알려진 Black Forest Labs가 로봇 제어를 위해 설계한 매개변수 70억 개 규모의 세계 행동 모델(World Action Model) FLUX 3 Action을 공개했다. 멀티모달 기반 모델 FLUX 3에서 파생된 이 모델은 카메라 영상과 관절 위치를 입력받아 앞으로의 이미지와 모터 명령을 한 번의 연산으로 예측한다. 가중치는 공개돼 있다(DROID 체크포인트의 Hugging Face 페이지에는 라이선스가 « flux-kommunity-license »로 표시된다). 연구소는 코드, 미세 조정 방법, 벤치마크, 재현 가능한 예제도 함께 공개했다.
An open weights 7B World Action Model that achieves first place on the RoboLab benchmark. It outperforms the previous best open model by 6.1 percentage points while using 56% fewer parameters and running up to 3.95x faster.
🇰🇷 공개 가중치 7B 세계 행동 모델이 RoboLab 벤치마크에서 1위를 차지했습니다. 매개변수를 56 % 적게 사용하면서도 종전 최고 공개 모델보다 6,1%포인트 높은 성적을 기록하고, 최대 3,95배 빠르게 실행됩니다. — X의 @bfl_ai
| 평가 모델 | 모델 유형 | 가중치 접근 | RoboLab-120 성공률 | 매개변수 수 |
|---|---|---|---|---|
| FLUX 3 Action | WAM | 공개 | 42,92 % | 7B |
| OASIS WAM | VLM + WAM | 비공개 | 39,0 % | – |
| Cosmos3-Nano-Policy | WAM | 공개 | 36,8 % | 16B |
| Phoenix | TAMP+FM | 비공개 | 34,4 % | – |
| BiMind v0.1 | VLA | 비공개 | 33,3 % | – |
| π0.5 | VLA | 공개 | 28,0 % | 3,3B |
| DreamZero | WAM | 공개 | 25,7 % | 14B |
| GR00T N1.6 | VLA | 공개 | 7,2 % | 3B |
이전의 최고 공개 모델은 NVIDIA의 Cosmos3-Nano-Policy였다. « 최대 3,95배 빠르다 »는 수치는 FP8로 실행한 Cosmos 3 Nano와 비교한 것으로, GPU에 따라 1,52배에서 3,95배까지 달라진다. 가장 성능이 좋은 공개 시각·언어·행동 모델(VLA)인 π0.5와 비교하면, 한 단계로 증류한 변형 모델(38,3 %)은 워크스테이션과 데이터센터 GPU에서는 더 빠르지만 RTX 5090에서는 더 느리다. 다만 예측 한 번에 2,13초 분량의 움직임을 내다보는 반면 π0.5는 1초 분량을 예측한다.
발표 글은 OpenAI의 GPT-6 Astra가 로봇을 감독하는 혼합 방식도 시험했다. 낮은 추론 수준(low)의 Astra와 결합한 FLUX 3 Action은 에피소드의 90 %에 성공했으며, 성공 한 건당 비용은 8,77달러, 소요 시간은 약 8분이었다. Astra 단독으로 « xhigh » 추론 수준을 사용하면 모든 과제에 성공했지만, 성공 한 건당 13,47달러와 16분이 들었다. 실제 Franka 로봇 팔을 사용한 Positronic Robotics의 블라인드 평가에서는 FLUX 3 Action이 30회 중 28회 성공했다. Cosmos 3 Nano는 27회, π0.5는 13회였다. Hugging Face에는 세 가지 체크포인트(기본형, SO-101, DROID)가 공개돼 있으며, 모델은 NVIDIA와 함께 LeRobot에 통합돼 Jetson에도 배포할 수 있다.
🔗 FLUX 3 Action(Black Forest Labs) · Hugging Face 컬렉션
SPACE 탈출: Perplexity가 Computer 샌드박스의 첫 보안 감사 결과를 발표하다
9월 23일 — Perplexity Secure Intelligence Institute가 7월 15일 공개된 Perplexity Computer의 에이전트가 실행되는 샌드박스 SPACE에 대한 침투 시험(red-teaming) 보고서의 첫 부분을 발표했다. 이번 발표는 제품 출시가 아니라 SPACE에 관해 공개된 첫 보안 평가다. 각 샌드박스는 호스트 컴퓨터와 격리된 Firecracker 마이크로 가상 머신이며, 샌드박스마다 별도의 게이트웨이가 네트워크 송신 정책을 적용한다.
9개 모델에 가상 머신의 root 접근 권한을 주고 두 가지 깃발 탈취 과제를 맡겼다. VM과 호스트 사이의 경계를 넘어 미끼 AWS 식별자를 가져오거나, 네트워크 정책이 차단한 URL에 도달하는 과제였다. 시험은 SPACE 소스 코드 접근 가능 여부와 네트워크 접근 수준 두 가지, 즉 완전 차단 또는 부분 허용(PyPI와 Ubuntu 패키지 저장소, Perplexity 웹 검색)을 조합했으며, 각 설정에서 세 번씩 시도했다. 결과적으로 소스 코드가 주어진 경우를 포함한 108번의 시도에서 VM을 벗어나 호스트에 접근한 사례는 없었다. 네트워크를 모두 차단했을 때도 필터링이 유지됐다(54번 중 0번). 반면 네트워크가 부분적으로 허용된 경우에는 수정 전 54번 중 11번이 금지된 목적지에 도달했다.
| 평가 모델 | 소스 코드 제공 시 성공 | 소스 코드 미제공 시 성공 |
|---|---|---|
| Claude Opus 5.0 | 3번 중 3번 | 없음 |
| GPT-5.6 Sol | 3번 중 3번 | 3번 중 2번 |
| Kimi K3 | 3번 중 2번 | 없음 |
| GPT-5.6 Cyber | 없음 | 3번 중 1번 |
| 그 밖에 평가한 모델 5개 | 없음 | 없음 |
두 가지 취약점이 이용됐다. 첫째는 DNS 스푸핑이다. 에이전트가 pypi.org를 목표 주소에 연결하는 거짓 응답을 주입했고, 출처를 확인하지 않는 게이트웨이가 이를 기록했다. 이 방법에는 소스 코드에서만 확인할 수 있는 내부 주소가 필요했다. 둘째는 CDN의 IP 주소 공유다. GPT-5.6 Sol은 PyPI와 같은 주소로 접속할 수 있는 fiddle.fastly.dev에 금지된 URL을 조회하게 했다. GPT-5.6 Cyber는 Taboola의 이미지 서비스와 스크린샷 생성기 thum.io를 거친 뒤 문자 인식으로 깃발을 읽었다. Claude Opus 5.0은 이 경로를 발견했지만 외부 시스템을 공격하지 말라는 지시에 어긋난다고 판단해 사용하지 않았다. Kimi K3는 성공한 유일한 공개 가중치 모델이었다. 두 모델은 평가할 수 없었다. Fable은 Perplexity가 Anthropic의 Cyber Verification Program에 등록했음에도 시험을 거부했고, GPT-6 Astra도 거부했다.
8월 26일 발견된 취약점은 수정됐다. 이제 모든 송신 패킷에는 해당 VM에 할당된 주소가 있어야 하며, 게이트웨이가 직접 TLS 연결을 종료해 서버 이름(SNI)과 HTTP 호스트를 검증한다. 공격자에게 가장 유리한 설정으로 다시 평가했을 때 모델들은 더 이상 깃발을 가져오지 못했다. 이후 Perplexity는 에이전트를 사용하지 않고 타사 샌드박스 플랫폼 10곳을 시험했다. E2B, Vercel Sandbox, Modal Sandboxes, Daytona Sandbox를 포함한 8곳에서 적어도 하나의 우회 방법이 발견됐고, Cloudflare Sandbox와 NVIDIA OpenShell은 방어에 성공했다. 9월 1일 통보받은 모든 업체가 답변했다. 9월 10일 기준 Daytona, Deno, microsandbox는 문제를 수정했고, Vercel과 Modal은 해당 동작을 알려진 한계로 취급했다. 모델의 전략을 다룰 보고서 2부는 발표될 예정이지만 날짜는 정해지지 않았다.
Claude Code 2.1.281: 기여 표시 해제 기능과 강화된 자동 모드
9월 23일 — 2.1.280 출시 다음 날인 UTC 19시 19분에 공개된 Claude Code 2.1.281에는 수정 사항 112건을 포함해 변경 항목 176건이 담겼다. 일상에서 체감할 변화는 두 가지다. settings.json의 "attribution": false 설정으로 커밋과 pull request의 기여 표시를 모두 없앨 수 있고, 메시지를 즉시 전송하면(ctrl+enter) 진행 중인 도구가 턴을 취소하는 대신 백그라운드로 이동한다.
자동 모드의 기준도 엄격해졌다. 분류기 검토가 서버에서 실행되는 경우 읽기 전용 shell 명령도 판정을 기다린다. 주목할 보안 수정 사항도 있다. rm -rf "$(pwd)"처럼 명령 치환을 대상으로 하는 재귀적 rm는 자동 모드에서 --dangerously-skip-permissions과 함께 사용할 때 확인 없이 실행됐지만, 이제는 허용된 Bash 규칙이 있어도 확인을 요청한다. 무인 세션이 멈추지 않도록 위험한 rm의 확인 요청은 2분간 기다린 뒤 명령을 거부하고 재작성을 제안한다.
자체 호스팅 runner에는 호환성이 깨지는 변경이 있다. --system-prompt를 추가하는 중간 스크립트(wrapper)나 hook은 --system-prompt-file으로 전환해야 한다. 관리자는 Claude apps 게이트웨이에서 STS로 얻은 IAM 역할(assume_role)을 사용해 Amazon Bedrock을 호출할 수 있다. 필요하면 다른 AWS 계정의 역할도 사용할 수 있으며, 각 요청에 Bedrock 보호 장치를 적용할 수 있다.
Anthropic 제품 소식: 빨라진 claude.ai와 확장된 Marketplace
같은 날 발표된 Anthropic의 제품 소식 두 가지가 과학 분야 소식에 이어진다.
2주 만에 세 배 빨라진 claude.ai
9월 23일 — Anthropic 엔지니어 세 명은 claude.dev에서 8월에 진행한 2주간의 집중 작업을 소개했다. 이 작업으로 claude.ai와 데스크톱 앱의 속도가 약 세 배 빨라졌다. 작업은 하나의 Slack 채널에서 진행됐으며, 내부 연구 모델을 기반으로 한 Claude Tag(베타)가 함께했다. 해당 모델은 “Opus 5.5와 대략 비슷한 수준”이다. Claude는 병목을 찾아내고, benchmark를 구축하고, 수정안을 제안하고, 배포를 감시했다. 사람은 목표를 정하고 모든 변경을 승인했다. 그 결과 고객에게 보이는 장애나 롤백 없이 3,000건이 넘는 변경이 병합됐다.
| 측정한 과정(75백분위수) | 집중 작업 전 | 집중 작업 후 |
|---|---|---|
| claude.ai 페이지 입력 준비 완료 | 3.1초 | 0.55초 |
| 새 Claude Code 세션(데스크톱) | 0.8초 | 0.3초 |
| Claude Cowork 클라우드 세션(데스크톱) | 2.6초 | 0.73초 |
| 13개 측정치의 기하평균 | – | 3.1배 빠름 |
방법의 핵심은 Claude에게 개선할 수치를 주면 최적화할 수 있다는 것이다. 이에 팀은 재현 가능한 측정치를 수치가 낮아지는 방향으로만 바뀌도록 하는 CI 검사로 만들었다. 약 네 배 매끄러워진 streaming을 비롯한 일부 성과는 이미 8월 24일 발표됐다.
🔗 2주 만에 claude.ai를 세 배 빠르게 만든 방법
Claude Marketplace에 모인 connector, agent, 통합 업체
9월 23일 — Anthropic이 지난 3월 제한적 미리보기로 출시한 Claude Marketplace를 확장한다. 이제 이곳에는 세 종류의 제품과 서비스가 모인다. 2,000개가 넘는 connector와 plugin(Atlassian, Google, Microsoft, Notion, Salesforce 등), 기업이 Anthropic 지출 약정의 일부로 비용을 지불할 수 있는 Claude 기반 agent와 제품(CrowdStrike, Cursor, Harvey, Legora, Lovable, Snowflake), 그리고 Claude Partner Network의 컨설팅 업체(Accenture, Boston Consulting Group, Deloitte)다. 개발사는 MCP와 Agent Skills를 이용해 connector나 plugin을 구축하거나, agent 또는 제품을 신청하거나, Partner Network에 가입할 수 있다. 함께 공개된 글은 구매 방식을 보여 준다. CodeRabbit은 Anthropic 예산 약정을 활용해 Vercel 요금제를 마련했고, 계약은 일주일 만에 체결됐다. Anthropic 지출 약정으로 결제하는 방식은 자격 신청을 거쳐 이용할 수 있는 제한적 미리보기 단계다.
ChatGPT: 작업을 수행하는 Voice, 복습 카드, Privacy Center
plugin을 사용하는 Voice, ChatGPT Work에도 도입
9월 23일 — OpenAI가 ChatGPT Voice를 두 방향으로 확장한다. 이제 웹, iOS, Android에서 대화하는 동안 Live 음성 모드가 메시지 앱, 캘린더, Slack 등 계정에 연결된 plugin과 앱을 사용할 수 있다. Voice는 웹과 모바일의 ChatGPT Work에도 도입된다. 음성으로 문서, 프레젠테이션, 스프레드시트 생성을 요청하거나 연결된 앱을 사용하고 브라우저에서 작업을 수행하게 할 수 있다. 통화가 끝난 뒤에는 글로 작업을 이어갈 수도 있다.
모델에 관해서는 OpenAI의 X 게시물이 Voice에서 GPT-6 Astra, Sol, Luna도 사용할 수 있다고 밝힌다. 반면 도움말 문서는 요금제에 따라 Live가 GPT-Live-1 또는 GPT-Live-1 mini를 기반으로 한다고 설명하며, GPT-6 모델의 역할은 자세히 밝히지 않는다. Free와 Go 사용자는 각 요금제에서 제공하는 plugin과 함께 Chat에서 Voice를 사용할 수 있다. Work에서 Voice를 사용하려면 두 기능에 모두 접근할 수 있어야 하며, 이렇게 시작한 작업은 일반적인 Work 사용량에 포함된다. Live는 동영상이나 화면 공유를 지원하지 않는다. 최신 버전 앱에서 9월 23일부터 전 세계에 배포되고 있다.
🔗 OpenAI의 X 발표 · ChatGPT Voice 도움말
복습 카드와 개인정보 보호 센터
9월 22일 — 이제 ChatGPT는 주제나 업로드한 노트를 바탕으로 대화형 복습 카드(flashcards)를 만들 수 있다. 카드를 눌러 뒤집은 다음 답을 알고 있었는지, 다시 봐야 하는지 표시할 수 있으며 카드 순서를 섞을 수도 있다. 카드는 라이브러리에 자동 저장된다. 무료 요금제를 포함한 모든 요금제에서 모바일과 웹으로 이용할 수 있다.
9월 21일 — 앞서 발표된 소식도 있다. 같은 릴리스 노트 페이지에는 전날 개인정보 보호 센터(Privacy Center)가 발표됐다. 이 기능은 로그인한 Free, Go, Plus, Pro 사용자에게 배포 중이다. 대화의 개인정보 보호, 메모리, 개인화, 데이터 사용, 연결된 앱, 계정 보안에 관한 정보를 한곳에 모으고 관련 설정으로 바로 가는 링크를 제공한다. 웹에서는 계정 메뉴에서 Help를 누른 뒤 Privacy Center를 선택하면 되고, 모바일에서는 설정에서 접근할 수 있다.
새로운 benchmark 두 가지: 정신건강과 추론 서비스
MentalHealthBench(OpenAI)
9월 23일 — OpenAI가 MentalHealthBench를 공개했다. 이 공개 benchmark는 일상의 감정적 대화부터 긴급 상황까지, 현실적인 정신건강 대화에서 모델이 어떻게 응답하는지 측정한다. 22개국에서 19개 언어를 사용하는 공인 심리학자와 정신과 의사 80여 명이 함께 만들었다. 합성 대화에는 성인, 13~17세 청소년, 돌봄 제공자, 임상의라는 네 유형의 인물이 등장한다. 전문가는 각 대화에 -10부터 +10까지 가중치를 매긴 평가 기준을 작성했다. 전문가 세 명 중 최소 두 명이 승인하고 나머지 한 명이 반대하지 않은 기준만 채택했다. GPT-5.6 Sol을 평가자로 사용해 자동 채점하며, 점수는 안전성, 맥락 파악, 사용자 자율성 존중 등 열 가지 차원으로 나뉜다. OpenAI는 특히 맥락 파악에서 모델이 꾸준히 발전한다고 밝히지만, 모델별 점수는 게시물의 그래프에만 제시했다. 또한 ChatGPT가 치료나 전문가의 지속적인 관리를 대신하지 않는다고 강조한다.
SWE-Serve(NVIDIA)
9월 23일 — NVIDIA의 Nemotron 모델 데이터·평가팀이 SGLang 팀과 함께 만든 SWE-Serve를 공개했다. 이 추론 서비스 엔진에 실제로 병합된 pull request 83건을 실행 가능한 작업 53개로 구성했다. 작업에는 추측 디코딩, 모델 지원, kernel, cache, 서비스 API가 포함된다. 핵심 결과는 로컬 테스트와 실제 서비스 사이의 차이를 보여 준다. 실제 서버를 시작하는 19개 작업에서 동일한 수정안의 통과율은 실시간 서비스 테스트를 제외하면 69.4%지만, 전체 검증기를 적용하면 45.9%로 떨어진다. 즉, 다른 검사를 통과한 수정안 약 세 개 중 하나는 모델을 로드하고 질의하는 순간 실패한다.
| 평가한 모델(최대 추론) | 3회 실행의 pass@1 | 작업당 평균 비용 |
|---|---|---|
| Claude Opus 5 | 75 % | 17.40달러 |
| GPT-5.6 Sol | 75 % | 12.26달러 |
| Kimi K3 | 64 % | 7.24달러 |
| GPT-5.6 Luna | 64 % | 0.95달러 |
| DeepSeek V4 Flash (0731) | 55 % | 0.69달러 |
웹 접근 권한이 없는 최소 구성의 agent로 모델 11개를 평가했다. 표에는 9월 22일에 출시된 Claude Opus 5.5와 GPT-6 Sol·Luna, 그리고 GPT-6 Astra가 포함되지 않았다. 작업과 검증기는 공개돼 있다.
🔗 SWE-Serve가 드러낸 로컬 테스트와 실제 서비스의 차이 · GitHub 저장소
동영상 편집 소프트웨어에 들어온 생성형 동영상
DaVinci Resolve Studio에 도입된 Runway
9월 23일 — Premiere Pro와 After Effects용 plugin을 출시한 지 2주 만에 Runway가 Blackmagic Design의 동영상 편집 소프트웨어 DaVinci Resolve Studio에 들어왔다. macOS와 Windows용 무료 plugin은 Workspace의 Workflow Integrations에서 열 수 있다. prompt로 이미지와 동영상을 생성한 뒤 브라우저를 거치지 않고 클릭 한 번으로 Media Pool과 timeline에 가져올 수 있다. Edit Studio 기능은 이미 편집한 영상 구간에 적용된다. 패널에서 선택한 구간을 내보내면 Aleph 2.0이 보정한 핵심 프레임 최대 다섯 개를 바탕으로 동일한 길이의 영상을 새로운 스타일로 다시 렌더링한다. DaVinci Resolve Studio 19 이상이 필요하다. 생성 기능은 Runway의 모든 유료 요금제에서 제공되며 기존 크레딧을 사용한다. 각 생성 작업의 비용은 확정 전에 표시된다.
Google Vids에서 무료로 제공되는 Gemini Omni 1.1 Flash
9월 23일 — Google 또는 Google Workspace 계정이 있으면 누구나 컴퓨터의 vids.new에서 Gemini Omni 1.1 Flash로 동영상을 무료 생성할 수 있다. 1.1 버전에는 세 가지 조작 기능이 추가됐다. 인물·조명·배경을 유지하면서 장면을 연장하고, 음성 해설에 맞도록 clip 길이를 정확히 지정하고, 1080p로 바로 생성할 수 있다. 모든 clip에는 SynthID 워터마크가 들어간다. 전체 배포는 9월 23일 시작되며 1~3일이 걸릴 수 있다. 유료 요금제에서는 더 많은 동영상을 생성할 수 있지만 구체적인 수량은 공개되지 않았다. Google은 100개 이상의 언어를 지원하는 Gemini 3.8 Flash-Lite TTS의 Vids 내레이션 기능도 곧 제공하겠다고 밝혔다.
Made On YouTube 2026: Shorts 편집에 도입된 Gemini Omni
9월 23일 — YouTube가 연례 행사 Made On YouTube에서 Gemini Omni를 Shorts와 YouTube Create 앱의 대화형 편집 도우미에 통합했다. 간단한 텍스트 지시만으로 말하는 구간을 자르고, 음악을 동기화하고, 시선을 끄는 문구를 추가하거나 영상 구간의 순서를 바꿀 수 있다. 생방송에는 자동 더빙(Live auto-dubbing)이 추가된다. YouTube Music에는 대화로 재생 대기열을 구성하는 Ask Music이 도입되고, Podcast Lineup은 추천 podcast를 AI가 생성한 음성으로 매주 미리 소개한다. 창작자는 자신의 목소리와 얼굴을 보호할 수 있도록 확장된 유사성 감지 기능도 받는다. 출시 시기가 나온 기능은 개인화된 홈 피드(Custom Feeds)뿐이다. 미국 시청자에게 올가을 제공될 예정이며, 다른 기능의 구체적인 일정은 아직 없다.
🔗 Made On YouTube 2026 · Google 요약
다른 앱과 연결되는 비서들
Gemini: 새로운 연결 앱 확대
9월 23일 — Google이 Gemini에 연결할 수 있는 새로운 앱을 배포한다. @GeminiApp 계정은 이를 MCP 연결이라고 설명한다. 게시물에는 생산성(Airtable, Linear, monday.com, PandaDoc, Wispr AI, Zoho), 창작(Adobe, Picsart, Squarespace, Webflow), 일상생활(apartments.com, Experian, Peloton, SeatGeek)의 세 분야에 걸쳐 14개 서비스가 나열돼 있다. 반면 @GeminiApp의 X 게시물은 새 앱이 13개라고 밝힌다. 이 서비스는 설정에서 활성화하거나 대화 중 @를 입력해 호출할 수 있다. 제시된 예로는 Adobe를 이용한 사진 조명 보정과 Experian을 통한 신용점수 조회가 있다. 게시물은 대상 국가나 요금제를 명시하지 않았다.
Meta의 agent Muse: Shopify, PayPal, Expedia, Instacart에 이어 ElevenLabs와 HeyGen까지
9월 22일과 23일 — Meta가 9월 8일 출시한 개인 agent Muse는 24시간도 안 되는 사이에 상거래 서비스 connector 네 가지를 발표했다. 공식 @Muse 계정에 따르면 모두 “곧” 제공되지만 날짜, 요금, 국가는 밝히지 않았다. 23일에는 생성형 미디어 업체 두 곳도 Muse 도입을 발표했다. ElevenLabs는 제공 시기를 밝히지 않았고, HeyGen은 자사의 MCP 서버를 활용한다.
| 발표된 서비스 | 발표에서 설명한 용도 | 발표 계정 | 발표된 제공 시기 |
|---|---|---|---|
| Shopify | 웹 전반에서 한 번에 결제 | @Muse | 곧 |
| PayPal | agent가 전 세계에서 결제 처리 | @Muse | 곧 |
| Expedia | 호텔 예약 | @Muse | 곧 |
| Instacart | 장보기 상품을 집으로 배송 | @Muse | 곧 |
| ElevenLabs | 음성 해설, 사운드트랙, 동영상 | @ElevenLabs | 미정 |
| HeyGen | 본인의 목소리를 담아 게시할 준비가 된 아바타 동영상 | @HeyGen | 미정 |
🔗 @Muse가 발표한 connector 네 가지 · Muse에 도입되는 ElevenLabs · Muse에 합류하는 HeyGen
Tesla와 Google Slides, Sheets, Docs에 도입되는 Grok Bot
9월 22일 — Tesla가 SpaceXAI의 agent Grok Bot을 자사 차량에 도입한다고 발표했다. Connectors를 통해 Grok은 운전자가 운전대에서 손을 떼지 않고도 메일함을 관리하고, 일정을 정리하고, 기존 파일·대화·작업을 이어서 사용할 수 있다. @grok 계정도 같은 날 저녁 이 발표를 전했다. 활성화에는 세 단계가 필요하다. 차량의 Grok 앱에 로그인하고, Grok 모바일 앱이나 웹사이트에서 Connectors를 추가한 다음, Grok Bot 이용에 필요한 SuperGrok을 구독해야 한다. 게시물에는 지원 차량 모델이나 국가가 명시되지 않았다.
같은 날 @bot 계정은 Grok Bot이 Google Slides, Sheets, Docs에 기본 연결되고, 이메일 첨부파일을 읽거나 추가하는 기능이 개선됐으며, 사용자의 네트워크를 통해 웹을 탐색할 수 있다고 발표했다. SpaceXAI는 작업 속도와 데스크톱 앱의 반응성도 향상됐다고 밝혔지만 이를 뒷받침하는 수치는 제시하지 않았다.
🔗 @grok의 공유 게시물 · Tesla 발표 · Grok Bot 게시물 모음
Antigravity: 로컬 agent와 /plan 명령
SDK, Gemma 4 26B로 로컬에서 에이전트 실행
9월 23일 — Python에서 Google Antigravity의 에이전트 기능을 사용할 수 있게 해 주는 Antigravity SDK가 이제 완전히 로컬에서 실행되는 워크플로를 지원한다. 초기 지원 대상은 VRAM 또는 통합 메모리가 24GB를 넘는 컴퓨터에서 LiteRT(Google AI Edge)로 실행하는 Gemma 4 26B A4B다. LocalOpenAIAgentConfig는 Ollama, LM Studio, vLLM처럼 OpenAI와 호환되는 모든 서버에 연결된다. Google은 API 비용과 요청 속도 제한이 없고, 코드가 컴퓨터 밖으로 나가지 않으며, 하이브리드 워크플로를 구성할 수 있다고 설명한다. 시연에서는 Gemini 3.8 Flash가 코드를 전혀 보지 않은 채 클라우드에서 95토큰으로 취약한 모듈 세 개의 감사를 계획하고, 로컬의 Gemma 4 26B 인스턴스가 취약점을 재현하고 수정 사항을 작성·검증한다. 토큰의 97.2%(3,322개)는 로컬에서 처리된다. 이 기능은 9월 21일 출시된 SDK 0.1.18에 추가됐다. 이 버전은 에이전트가 자율적으로 실행되도록 기본 도구에서 대화형 질문 도구 ASK_QUESTION도 제외한다.
Antigravity 2.16.0 및 2.17.0, CLI 1.2.8 및 1.2.9
9월 22일 — Antigravity 앱이 같은 날 두 버전을 출시했다. 2.17.0에는 /plan 명령이 추가됐다. 에이전트가 코드를 한 줄이라도 작성하기 전에 계획을 만들면 사용자가 이를 검토하고 수정할 수 있다. Plan Review Policy 설정은 모든 계획 검토, 에이전트의 판단에 맡기기, 검토 생략의 세 가지 모드를 제공한다. 규칙에는 20,000토큰의 예산을 할당하며, 저장소별 설정은 .gemini/config.json에서 읽는다. 이전의 .agents/settings.json는 더 이상 반영되지 않는다. 2.16.0에서는 WSL 배포판에 연결하고 Word, Excel, PowerPoint 문서를 프롬프트에 끌어다 놓을 수 있으며, 하위 에이전트를 실시간 카드로 표시한다.
| 앱 버전 | 개선 사항 수 | 수정 사항 수 | 주요 새 기능 |
|---|---|---|---|
| 2.16.0 | 12 | 15 | WSL, Office 첨부 파일, 하위 에이전트 카드 |
| 2.17.0 | 11 | 10 | /plan, 규칙에 20,000토큰 예산 할당 |
9월 22일과 23일 — 터미널용 CLI 1.2.9에는 @ 구문을 사용해 하위 에이전트에게 직접 메시지를 보내는 기능이 추가됐고, headless 모드의 안정성도 개선됐다. 백그라운드 작업은 에이전트가 비활성 상태가 된 지 몇 초 만에 취소되지 않고 최대 30분까지 기다린다. 1.2.8은 컨텍스트 압축을 손보고 음성 받아쓰기 시간을 3분 30초로 제한한다.
Google DeepMind: Private AI Compute를 위한 암호화된 영구 메모리
9월 23일 — Google DeepMind가 하드웨어로 격리된 클라우드 엔클레이브에서 처리하는 플랫폼인 Private AI Compute에 영구 메모리를 도입할 계획을 상세히 설명했다. 지금까지 이 플랫폼은 ‘상태 비저장’ 방식이어서 작업이 끝나면 모든 컨텍스트가 사라졌다. 새 계층은 클라우드의 암호화된 금고처럼 작동하며, 키는 사용자 기기에만 보관된다. Google에 따르면 이 때문에 Google을 포함한 누구도 데이터에 접근할 수 없다. 모델에 정보가 필요하면 보안 엔클레이브가 격리된 메모리에서 데이터를 일시적으로 복호화하고 요청을 처리한 뒤 새 컨텍스트를 저장하고 즉시 다시 암호화한다. Google이 든 예시는 스마트 안경으로 앞서 살펴본 조립 설명서를 컴퓨터에서 찾아내는 것이다.
이는 향후 적용할 아키텍처에 관한 발표로, 출시일이나 제품명은 제시되지 않았다. Google은 신뢰도를 뒷받침하기 위해 업데이트된 백서와 서버 소프트웨어의 변조 방지 공개 기록을 공개한다. 기기는 개인 데이터를 보내기 전에 이 기록을 확인할 수 있다. 이름이 공개되지 않은 업체가 수행한 독립 감사 결과도 발표한다.
Qwen: 스마트폰용 에이전트와 저렴해진 오디오
Qwen Intelligence, 휴대전화 제조사를 위한 에이전트 세 가지
9월 23일 — Qwen이 주로 휴대전화 제조사를 겨냥한 스마트폰용 에이전트 서비스 Qwen Intelligence를 출시했다. 계획, 실행, 이미지, 메모리 모듈을 필요한 대로 조합할 수 있고, 라우팅 기능이 기기와 클라우드에 연산을 분배한다. 출시 시점의 에이전트는 세 가지다. Mobile Planner는 복잡한 작업을 계획하고, Mobile-Use는 API를 우선 사용하되 필요하면 그래픽 인터페이스로 전환해 작업을 실행한다. Qwen에 따르면 Mobile-Use는 MobileWorld에서 82.1점, AndroidDaily에서 97.2점을 기록했고, 처음부터 끝까지 작업을 완료한 비율은 90%다. Mobile Creative는 3초 만에 이미지를 생성한다. Qwen은 벤치마크 네 가지를 공개하지만 에이전트의 가중치와 코드는 공개하지 않는다. Mobile-Use와 Mobile Creative는 이미 사용량에 따라 요금이 부과되며, Mobile Planner의 유료화는 ‘곧’ 시작될 예정이다.
| 평가 대상 모델 또는 시스템(Qwen 기준) | MobilePA-Bench 종합 점수 |
|---|---|
| Qwen-Planner-Agent 27B | 77,05 % |
| GPT-6 Astra | 76,84 % |
| Claude Opus 5 | 75,71 % |
| Claude Fable 5 | 74,53 % |
| GLM 5.3 | 73,88 % |
🔗 X에 게시된 Qwen 발표 · Qwen-Planner-Agent 보고서
Qwen-Audio-3.1, 최대 95% 저렴하게
9월 23일 — Qwen-Audio-3.1은 Qwen의 기존 오디오 모델 세 가지인 음성 인식(ASR), 음성 합성(TTS), 실시간 대화(Realtime)를 업그레이드하고 두 가지를 추가한다. TTS-Next는 한 번에 음성, 효과음, 배경음을 생성한다. ASR-Next는 화자를 구분하고 전사 내용에 타임스탬프를 붙이며 감정과 주변 소음을 인식한다. Realtime은 동시에 듣고 말할 수 있으며, 사용자가 중간에 끼어들 수 있다. QwenCloud에서 qwen-audio-3.1-realtime-plus의 요금은 오디오 입력 100만 토큰당 6.4달러, 텍스트 및 오디오 출력 100만 토큰당 24달러이며 컨텍스트는 262K토큰이다. 파일용 ASR은 입력 100만 토큰당 0.15달러다. 현재 사용할 수 있는 API는 이 두 가지뿐이며 나머지는 ‘곧’ 공개될 예정이다.
| 모델 계열 | 발표된 가격 인하 폭 |
|---|---|
| TTS | 약 70 % |
| Realtime | 약 85 % |
| ASR | 최대 95 % |
🔗 X에 게시된 Qwen-Audio-3.1 발표 · QwenCloud의 Qwen-Audio-3.1-Realtime
Mistral Vibe: Chat과 Work 통합, CLI 권한 관리 강화
Chat과 Work 통합, 지식 베이스 공개 미리 보기
9월 22일 — Mistral이 자사 어시스턴트 Vibe(이전 Le Chat)의 릴리스 노트 네 건을 게시했다. 별도의 블로그 글이나 게시물은 없었다. 가장 큰 변화는 Chat과 Work를 하나의 환경으로 통합한 것이다. 같은 곳에서 질문하거나 작업을 시작할 수 있고, 모드 전환 대신 Fast / Think 선택기를 사용한다. Skills는 Chat Agents를 대체하며 Deep Research도 Skills 중 하나가 된다. Free, Pro, Teams 계정의 이전 작업은 9월 14일 시작됐다. 기업 계정은 10월 1일부터 약 6개월에 걸쳐 이전된다. 공개 미리 보기로 제공되는 에이전트형 지식 베이스(Agentic Knowledge Base)는 내용을 알 수 없던 기존 메모리를 열람하고 수정할 수 있는 페이지로 바꾸고, 다시 불러온 각 사실의 출처를 보여 준다. Mini App Canvas는 프롬프트로 공유 가능한 작은 React 앱을 생성한다. 유료 요금제의 Vibe Work에는 Excel 또는 CSV 스프레드시트 기능도 추가된다.
Vibe CLI 2.25.8, 권한 검사 우회 문제 수정
9월 23일 — Vibe CLI 2.25.8에는 새 기능 5개와 수정 사항 38개가 포함됐으며, 그중 여러 건이 권한 보안과 관련된다. 상대 경로 기반 허용 목록은 경로 끝부분이 같다는 이유만으로 파일을 허용하지 않게 됐다. shell 명령의 와일드카드도 작업 폴더 밖 경로에 대한 검사를 건너뛰지 못한다. 상위 폴더에 부여한 권한은 하위 폴더에 자동으로 적용되지 않으므로 일부 승인 요청이 다시 나타날 수 있다. 릴리스 노트는 18개 항목과 관련된 ‘Rust CLI’를 처음 언급하며, 여기에는 Vibe Code의 원격 프로젝트 설정 기능도 포함된다. 기업용 기능에서는 조직이 강제한 설정이 Unified Harness 세션을 시작할 때부터 적용된다. Supabase처럼 클라이언트 시크릿을 발급하는 MCP 서버의 OAuth 연결 문제도 수정됐다.
오픈 소스 및 명령줄 코딩 에이전트
ZCode, 보안 문제 이후 오픈 소스로 전환
9월 21일 — 지난 소식: Z.ai가 커뮤니티에서 제기한 보안 문제에 대응해 GLM-5.3의 공식 도구로 소개했던 에이전트형 코딩 실행 환경 ZCode의 소스 코드를 공개했다. @zcode_ai 계정은 필요한 수정 작업을 마쳤다고 밝히고 사과했다. Apache-2.0 라이선스의 zai-org/ZCode 저장소에는 클라이언트, 백엔드 서비스, CLI, 에이전트 런타임이 들어 있다. 9월 23일 기준 별은 약 6,500개였다.
With respect to the code data referenced by the community, we confirm that no such data is retained and that it has never been used for model training.
🇰🇷 커뮤니티에서 언급한 코드 데이터와 관련해, 해당 데이터는 전혀 보관되지 않으며 모델 학습에 사용된 적도 없음을 확인합니다. — X의 @zcode_ai
ZCode에 따르면 이후 두 기관이 상황을 평가했다. CAICT는 Alibaba Cloud OSS의 ‘zcode-prod’ 버킷에 데이터가 더 이상 없다고 확인했고, NSFOCUS는 버킷 자체와 그 안의 객체가 삭제됐다고 확인했다. 두 기관 모두 클라이언트 v3.14.0에 수정 사항이 포함됐고, Repo Wiki 기능이 제거됐으며, 로컬 저장소의 스냅샷을 업로드하던 흐름이 비활성화됐다고 밝혔다. Z.ai는 보상이 따르는 상시 취약점 신고 절차를 발표하고 전체 평가 보고서를 공개하겠다고 약속했다.
Kimi Code 2.1.0, 보안 강화
9월 23일 — Moonshot이 Kimi Code 2.1.0을 출시했다. 새 기능 2개와 수정 사항 18개가 포함됐다. 눈에 띄는 새 기능은 /settings에서 선택할 수 있는 실험적인 전체 화면 레이아웃으로, 다시 시작한 뒤 적용된다. 여러 수정 사항은 보안을 강화한다. 파일 도구는 심볼릭 링크를 통해 작업 폴더 밖으로 나갈 수 없고, 프로젝트의 로컬 설정은 작업 공간을 승인한 뒤에만 적용된다. 저장소의 git 설정은 백그라운드 git 작업 중 명령을 실행할 수 없으며, 홈 폴더나 루트 폴더를 가리키는 추가 폴더는 거부된다. MCP 서버의 OAuth는 이제 오프라인 접근 권한을 요청하므로 매시간 다시 승인할 필요가 없다. 한편 Moonshot은 Python으로 작성된 이전 Kimi CLI를 보관 처리했다. 별 11,424개를 받은 이 프로젝트의 1.51.0 및 1.52.0 버전은 사용자를 Kimi Code로 안내한다.
DeepSeek Harness 0.1.7-rc.1 미리 보기
9월 23일 — DeepSeek가 8월 13일 공개한 MIT 라이선스 오픈 소스 에이전트 실행 환경 DeepSeek Harness의 v0.1.7-rc.1을 출시했다. 이번 버전은 릴리스 후보(release candidate)다. 저장소에는 8월 이후 미리 보기 버전이 21개 올라왔지만 아직 안정 버전은 없다. 주요 추가 기능은 실험 단계다. Computer Use 모드를 통해 에이전트가 로컬 컴퓨터를 조작하고 화면을 캡처할 수 있으며(Cua Driver MCP 또는 기본 제공 드라이버 사용), 브라우저를 제어하는 백엔드 세 가지(Playwright MCP, Chrome DevTools MCP, Stagehand)도 추가됐다. 웹 인터페이스에는 내장 터미널과 diff를 이용한 변경 사항 검토 기능이 생겼다. headless 모드는 표준 입력에서 작업을 읽고 이벤트를 JSON으로 출력하며, 에이전트는 SSH를 통해 원격 작업 공간에서도 일할 수 있다. 이전 시 고려할 변경 사항도 있다. DeepSeek 공식 어댑터는 Messages API만 사용하고, E2B 실행 백엔드는 제거되며, 실험적인 팀 모드의 팀원 수는 8명에서 16명으로 늘어난다.
🔗 DeepSeek Harness v0.1.7-rc.1
Genspark의 코딩 에이전트 GenCode
9월 23일 — Genspark가 Super App에 통합된 코딩 에이전트 GenCode를 macOS, Windows, Linux용으로 출시했다. 명령줄에서도 사용할 수 있다. 핵심은 모델 선택이다. 하나의 계정에서 API 키를 설정하지 않고도 작업마다 Claude, GPT, DeepSeek 또는 공개 가중치 모델을 고를 수 있다. Genspark는 공개 모델의 비용이 ‘10분의 1에서 20분의 1’이라고 주장한다. GenCode는 Claude Code용으로 만든 지침, 규칙, 메모리를 한 단계로 가져온다. npm 패키지 @genspark/gencode의 README에는 출처가 명시돼 있다. GenCode는 오픈 소스 코딩 에이전트 opencode에서 파생됐지만 해당 프로젝트와 제휴하지 않은 독점 제품이며, 저장소의 .opencode/ 폴더를 의도적으로 공유한다. 각 단계의 지출은 Genspark 크레딧으로 표시된다.
🔗 GenCode · X에 게시된 Genspark 발표
GitHub Copilot: 보조 승인과 로컬 샌드박스
JetBrains용 Copilot 1.18.0
9월 22일 — JetBrains IDE용 Copilot 1.18.0에는 공개 미리 보기로 보조 승인(assisted approvals) 기능이 도입됐다. 에이전트 세션에서 위험이 낮다고 판단된 도구 호출은 자동으로 승인하고, 위험이 더 큰 작업은 계속 사용자의 결정을 요청한다. 이전 메시지를 다시 편집할 수도 있다. 이 경우 Copilot은 새 지시를 보내기 전에 대화와 파일 변경 사항을 해당 시점으로 되돌린다. JetBrains용 Copilot에서 사용할 수 있는 Codex 에이전트에는 파일을 수정하기 전에 접근 방식을 검토·개선·승인하는 계획 모드가 추가됐다. 세션에서는 조직 및 기업의 skills와 지침도 사용할 수 있다. 기본적으로 활성화되는 내장 GitHub MCP 서버는 이제 비활성화할 수 있다. JetBrains IDE 2025.1 사용자는 2026.1 이상으로 업그레이드하라는 안내를 받는다.
Copilot 앱, 로컬 세션을 격리
9월 23일 — GitHub의 에이전트용 데스크톱 앱인 GitHub Copilot 앱에 로컬 샌드박스가 공개 미리 보기로 추가됐다. 프로젝트별로 설정하는 이 기능은 로컬 세션의 명령이 접근할 수 있는 범위를 제한한다. 파일 시스템에서는 읽기·쓰기 가능, 읽기 전용, 접근 금지 폴더를 지정하고, 네트워크에서는 인터넷과 로컬 네트워크로 나가는 연결을 제어하며, 자격 증명에서는 HTTPS를 통한 Git과 GitHub CLI의 접근을 제한한다. 기업이 관리하는 설정으로 정책을 더 강화할 수도 있다. 운영체제가 요청한 정책을 적용할 수 없으면 샌드박스 shell은 보호 없이 실행되는 대신 오류와 함께 중단된다. 기본적으로 꺼져 있는 샌드박스는 프로젝트의 새 세션에서 활성화하거나, 진행 중인 세션에서 /sandbox on로 활성화할 수 있다. 클라우드 세션과 원격 호스트에는 적용되지 않으며, 설정은 Copilot CLI의 설정과 별개다.
Cursor: 배포용 봇 두 가지, 토큰 사용량 7% 감소
Rollouts와 Security Review
9월 23일 — Cursor가 코드 배포의 마지막 단계를 담당하는 두 봇을 Teams와 Enterprise 요금제에 출시했다. Rollouts는 각 pull request가 열릴 때 감시 계획(위험, 예상 효과, 확인할 신호)을 게시한다. 이후 배포할 때마다 로그, 지표, 추적 데이터를 계획과 대조해 환경별로 정상, 회귀 감지, 결론 불가 중 하나로 판정한다. 회귀가 발생하면 의심되는 변경 사항을 지목하고 승인을 받아야 하는 롤백 PR을 열 수 있지만, 스스로 병합하거나 롤백하지는 않는다. Security Review는 모든 pull request를 검사해 악용 가능한 취약점(인젝션, 인증 우회, 코드에 남은 비밀 정보, SSRF 등)을 알리고, 각각의 심각도, 공격 경로, 수정안을 제시한다. 10일 동안 제공되는 체험 크레딧으로 Teams에서는 약 50건, Enterprise에서는 약 500건의 변경 사항에 Rollouts를 시험할 수 있다.
품질 저하 없이 토큰 비용 7% 절감
9월 23일 — Cursor가 품질을 낮추지 않으면서 사용자의 에이전트 토큰 비용을 7% 줄인 방법을 설명했다. 최신 모델에는 긴 금지 사항 목록이 더 이상 필요하지 않아 시스템 프롬프트를 약 66% 줄였고, 실제 트래픽을 대상으로 한 A/B 테스트로 축약 내용을 검증했다. 대화의 20% 미만에서 사용되는 도구가 대부분인 내장 도구는 이제 필요할 때 불러온다.
| 최적화 방법 | Cursor가 측정한 효과 |
|---|---|
| 시스템 프롬프트 축소 | 프롬프트의 약 66% 삭제 |
| 내장 도구를 필요할 때 불러오기 | 고정 컨텍스트의 도구 설명 토큰 60% 감소 |
| 명시적인 캐시 중단 지점 | 콜드 캐시 실패 20% 감소 |
| 10줄마다 줄 번호 하나 표시 | 캐시에서 읽는 토큰 1.6% 감소 |
| 전체 변경 사항 | 사용자 토큰 비용 7% 감소 |
NVIDIA: 공개 화자 분리 모델과 AI Day Singapore
Nemotron 3 Diarization, 최대 8명의 화자 구분
9월 23일 — NVIDIA가 대화에서 누가 언제 말하는지 판별하는 1억 매개변수의 공개 가중치 모델 Nemotron 3 Diarization을 Hugging Face에 공개했다. 목소리가 겹칠 때도 판별할 수 있다. 이전 모델인 Streaming Sortformer의 4명보다 많은 최대 8명의 화자를 추적하며, 녹음된 음성과 실시간 스트림 모두에서 작동한다. 버퍼 지연 시간은 30.4초에서 0.32초까지 조절할 수 있다. 단어를 전사하지는 않으며, 전사 모델과 결합할 수 있도록 화자별 발화 시간 구간을 제공한다. VoiceArena의 Diarization-Bench 초기 결과에서는 화자 분리 오류율 14.72%로 12개 시스템 중 1위를 차지했다. 다음 순위 시스템의 오류율은 19.3%이며, NVIDIA에 따르면 이 초기 순위는 바뀔 수 있다. 이전 모델과 비교하면 8개 평가 데이터셋에서 오류율이 평균 41% 낮아졌지만, CALLHOME의 두 화자 대화에서는 성능이 소폭 떨어졌다. 라이선스는 OpenMDW 1.1이다.
| 발표된 측정 항목 | Nemotron 3 Diarization | 이전 모델 |
|---|---|---|
| 추적 가능한 최대 화자 수 | 8 | 4 |
| 30.4초에서의 처리 속도(배치 크기 32, RTX PRO 5000) | 실시간의 15 113배 | 2 619배 |
| 30.4초에서의 DIHARD III 오류율 | 12,73 % | 19,09 % |
🔗 Hugging Face 블로그의 Nemotron 3 Diarization 소개
AI Day Singapore: 동남아시아의 Vera Rubin과 Nemotron
9월 22일 — NVIDIA는 AI Day Singapore(9월 22~23일) 기간인 22일 오후 7시 30분(PT)에 게시한 글에서 Shopee, Garena, Monee의 모회사 Sea Limited를 Vera Rubin 플랫폼을 도입하는 ASEAN 지역 최초의 기업으로 소개했다. Sea Limited는 이 플랫폼으로 모델과 에이전트를 더 큰 규모로 개발하고 배포할 예정이다. 글의 나머지 부분에서는 지역에 맞게 확장한 공개 Nemotron 모델을 소개한다. AI Singapore는 지역 언어에 특화된 SEA-LION 모델 제품군을 Nemotron 모델로 확장하고 있다. 베트남에서는 Viettel AI가 Nemotron 3 Super를 베트남어에 맞게 미세 조정해 VMLU 벤치마크에서 1위를 차지했다. 태국에서는 iApp Technology가 Nemotron 3 Nano를 태국 법률에 맞게 조정한 OpenThai 2.0 Legal을 오픈 소스로 공개했다. 이 모델은 약 43 000명이 사용하는 법률 챗봇 Thanoy를 구동한다.
🔗 AI Day Singapore에서 NVIDIA와 협력사들이 선보인 동남아시아 전역의 AI 발전 사례
문제없이 AI를 운영 환경에 적용하기
두 발표의 공통된 생각은 트래픽을 전환하거나 머신을 업데이트하기 전에 실제 작업 부하로 검증하는 것이다.
Together AI의 카나리 배포
9월 22일 — Together AI가 9월 15일 업데이트부터 제공한 Dedicated Model Inference의 단계적 배포 기능을 자세히 설명했다. 중단이나 URL 변경 없이 endpoint 뒤에서 제공하는 모델을 바꿀 수 있다. 세 가지 전략이 있다. 카나리는 새 모델이 처리하는 트래픽을 단계적으로 늘리고(기본값은 5%, 25%, 50%, 100%), 블루 그린은 모든 트래픽을 한 번에 전환하며, 점진적 교체는 복제본을 하나씩 바꾼다. 카나리의 각 단계가 끝나면 검증 절차가 지연 시간이나 오류율을 이전 모델과 비교하고, 수치가 악화되면 배포를 일시 중지한다. 공개된 시연에서는 Qwen2.5-7B에서 Qwen3.5-9B로 전환하는 도중 트래픽 10% 단계에서 p95 지연 시간이 137% 증가해(734 ms에서 1 740 ms로) 배포가 중단됐다. 이전 모델로 되돌리는 동안 처리한 요청 6 800건은 모두 성공했다.
🔗 카나리 배포: 서비스 중단 없이 운영 환경의 모델 업그레이드
NVIDIA의 NVCRE와 NodeWright
9월 23일 — NVIDIA가 Kubernetes 기반 GPU 클러스터를 위한 자사 AI 팩토리 플랫폼의 소프트웨어 계층 DSX OS에 속한 오픈 소스 프로젝트 두 가지(Apache 2.0)를 자세히 소개했다. NVIDIA Cluster Readiness Engine(NVCRE)은 클러스터가 모든 상태 검사를 통과하고도 분산 학습에는 실패할 수 있다는 문제에서 출발한다. 그래서 토폴로지에 따라 선택한 노드 그룹에서 실제 작업 부하(NCCL 통신 테스트, DCGM 진단, NeMo 사전 학습)를 실행해 준비 상태를 인증하고, 문제가 있는 노드를 지목한다. 진단 모드에서는 실패한 그룹을 반으로 나누는 과정을 반복해 의심 노드를 분리한다. 해당 글은 작업 부하의 예로 매개변수 80억 개와 560억 개의 Nemotron 5 모델을 언급하지만, 더 자세한 내용은 제공하지 않는다. NVIDIA가 운영 환경에서 사용해 온 Skyhook의 후속인 NodeWright는 보호 대상 작업이 끝날 때까지 기다렸다가 노드의 시스템 설정(커널 설정, 보안 에이전트, 취약점 패치)을 업데이트한다. 업데이트는 고정, 선형 또는 지수적으로 늘어나는 묶음 단위로 진행되며, 실패한 묶음이 너무 많으면 자동으로 중단된다.
🔗 AI 작업 부하를 실행하기 전 GPU 클러스터 준비 상태 검증 · NodeWright
공개 데이터셋 두 가지: 여러 화자의 대화와 과학 코퍼스
Basis Conversations 1500
9월 23일 — Basis가 Hugging Face에 Basis Conversations 1500을 공개했다. 영어부터 메그렐어와 코사어까지 22개 언어로, 33개국 출신 2 645명이 자연스럽게 나눈 대화 1 502시간이 담겨 있다. 대화마다 2~4명이 참여했으며 각자의 음성이 동기화된 별도 트랙(FLAC 48 kHz)에 녹음됐다. 연구팀에 따르면 모델이 여전히 어려워하는 발화 겹침, 끼어들기, 발언 순서를 연구하는 데 쓸 수 있다. 약 100시간 분량에는 사람이 세밀하게 주석을 달았다(판단 113 096건). 여기에는 공감하거나 짜증을 드러내는 음성 반응, 어색한 침묵, 협력적이거나 경쟁적인 발화 겹침이 포함된다. 제공되는 전사문은 자동 생성된 것이므로 검증 없이 학습 목표 데이터로 사용해서는 안 된다. 소개 글은 상업 및 연구 목적으로 자유롭게 사용할 수 있다고 설명하지만, 데이터셋에는 Basis 자체 라이선스(basis-data-license-1.0)가 적용되며 접근 권한은 수동으로 승인된다.
QVAC Genesis III
9월 23일 — Tether AI Research가 과학, 기술, 공학, 수학 분야의 소형 모델 사전 학습을 위한 합성 코퍼스의 세 번째 부분인 QVAC Genesis III를 공개했다. 430억 6천만 토큰이 추가되면서 전체 규모는 19개 분야의 문서 약 1억 6천만 건, 총 1,914억 3천만 토큰에 이르렀다. 함께 발표된 논문은 COLM 2026 학회에 채택됐다. 이 방법은 소형 학생 모델 Qwen3-1.7B-Base에 질문한다. 답이 틀리면 오류를 바로잡는 설명을 만들고, 맞히면 각 선택지를 분석한다. 이 코퍼스만으로 처음부터 학습한 17억 매개변수 모델은 같은 토큰 예산으로 Cosmopedia-v2를 학습한 동일 모델보다 뚜렷하게 나은 성능을 보였다. 코퍼스는 비상업적 이용 라이선스(CC-BY-NC 4.0)로 공개됐으며, 이를 학습한 모델은 Apache 2.0으로 공개하겠다고 발표했다.
| 평가 벤치마크 | Cosmopedia-v2 대비 향상 폭(동일한 토큰 예산) |
|---|---|
| ARC-Easy | +28,57점 |
| ARC-Challenge | +21,35점 |
| GPQA Diamond | +2,52점 |
| MMLU STEM | +15,03점 |
기후와 식량을 위한 AI
Ai2와 Global Fishing Watch, 에이전트로 해양 감시
9월 23일 — 뉴욕 Climate Week에서 Ai2와 Global Fishing Watch가 해양 감시와 어업 감독에 AI, 특히 에이전트를 도입하기 위한 협력 관계를 발표했다. 이미 협력해 온 두 기관은 이제 공동 개발에 나선다. 공동 탐지 파이프라인, 위성 이미지에 적용할 새로운 실시간 비전 모델, 여러 데이터 소스를 교차 분석할 수 있는 에이전트를 개발할 계획이다. Global Fishing Watch는 공개 모델을 기반으로 한 Ai2의 지구 관측 플랫폼 OlmoEarth를 이용해 자체 데이터에 주석을 달고 모델을 학습할 수 있게 된다. Skylight의 실시간 선박 탐지 결과도 해양 보호구역 관리자용 포털에 들어간다. 두 팀은 분석가가 선박의 이력을 물어볼 수 있는 Shippy 같은 에이전트도 발전시킬 예정이다. 발표에는 일정이나 금액이 포함되지 않았다.
🔗 Ai2와 Global Fishing Watch, 해양 감시에 AI 에이전트를 도입하기 위해 협력
Google.org와 Gates Foundation, 소규모 농업인 2억 명 지원
9월 18일과 22일 — 앞선 소식: Google.org와 Gates Foundation이 사하라 이남 아프리카와 남아시아의 소규모 농업인 2억 명에게 기후, 농업, 언어 분야의 AI 도구를 제공하도록 공동 사업을 확대한다. 당초 목표는 5천만 명이었다. 두 협력 기관은 총 1억 달러를 지원하며, Google의 연구원과 엔지니어가 기술적으로 뒷받침한다. Gates Foundation의 보도자료는 9월 18일에 나왔고 blog.google은 22일 저녁 이를 전했다. 이 사업은 인도의 Wadhwani AI와 Digital Green 같은 현지 기관에 자금을 지원하고, AI 예측을 TomorrowNow 기후 플랫폼에 통합하며, 농지를 1m 미만 해상도로 지도화하고, 40개가 넘는 아프리카 언어의 공개 음성·텍스트 데이터셋을 지원한다. 소규모 농업인은 전 세계 식량의 약 35%를 생산한다.
🔗 Google.org 발표 · Gates Foundation 보도자료
단신
- Anthropic, 코드 현대화 — Anthropic의 고객사 파견 엔지니어 Jonah Ezekiel과 Lexie Tonelli은 「Notes from the Field」 시리즈에서 에이전트가 수행하는 코드 현대화를 준비하는 6단계를 제안한다. 목표 설정, 테스트 ‘인증서’, 단계별 사람의 검토, 사전 요건, 에이전트 워크플로, 실행이다. 비용 수치는 제시하지 않았으며, 시범 프로젝트에서 측정하라고 권한다. 🔗 출처
- Boris Cherny, Lean으로 Claude Agent SDK 검증 — 22일 저녁, Boris Cherny(Claude Code)는 Opus 5.5와 증명 보조 도구 Lean으로 Claude Agent SDK를 형식 검증했다고 전했다. 몇 개의 짧은 프롬프트로 버그와 동시성 문제를 수정하는 pull request 16건이 만들어졌다. 그는 TLA+도 사용한다고 밝혔다. 🔗 출처
- Codex CLI 0.156.1 — 0.156.0의 이 수정 버전은 CLI 모델 선택 메뉴에 GPT-6 Sol과 GPT-6 Luna를 추가한다. 요청 속도 제한에 걸렸을 때 표시되는 안내는 이제 Luna를 권하며, GPT-5.5와 GPT-5.6에서 옮겨 가는 선택지도 제공한다. 🔗 출처
- Airbnb와 GPT-6 Astra — 새 계약으로 Airbnb의 엔지니어링팀과 제품팀은 OpenAI API와 Amazon Bedrock을 통해 GPT-6 Astra를 비롯한 OpenAI 모델을 더 폭넓게 사용할 수 있게 됐다. 최고기술책임자 Ahmad Al-Dahle는 팀들이 1년 전보다 약 80% 더 많은 기능을 출시한다고 밝혔다. 계약 금액은 공개되지 않았다. 🔗 출처
- OpenAI Academy 2주년 — 2024년 9월 이후 250회가 넘는 행사를 열어 400만 명이 넘는 사람에게 도달했다. OpenAI는 파트너 기관 직원이 평가를 거친 뒤 워크숍 진행 방법을 배우는 지역사회 강사 프로그램(Community Trainer Program)을 시험하고 있다. 🔗 출처
- 음성 비서가 된 LED 디스플레이 — OpenAI Developers 블로그에서 Sid Rampally는 Codex의 도움으로 Raspberry Pi가 제어하는 128 × 64픽셀 LED 패널을 배선하고 프로그래밍한 과정을 소개한다. GPT-Live-1이 대화를 맡고, Responses API를 통해 검색과 화면 표시를 GPT-5.6 Luna에 위임한다. 🔗 출처
- MedGemma 다운로드 1,000만 회 돌파 — Google은 공개 의료 모델의 현장 활용 사례로 잠비아 여성 3,500명 이상의 자궁경부암 검진, 델리 AIIMS 병원의 시범 사업, 인도네시아의 결핵 탐지를 소개했다. Google은 모델 출력이 진단을 직접 좌우해서는 안 된다고 강조한다. 🔗 출처
- Google Docs의 Gemini Notebook — Docs에서 @를 입력해 notebook을 출처로 지정할 수 있다. Gemini는 해당 출처를 근거로 글을 작성하고 본문에 인용을 달며, Workspace Intelligence를 통해 이메일과 파일도 함께 활용한다. Business Standard 및 Plus, Enterprise Standard 및 Plus, Education Plus, Google AI Pro 및 Ultra 구독자가 사용할 수 있다. 🔗 출처
- Google Flow 도구 6종 — Google Labs는 창작자들이 Google Flow Tools로 만든 도구 6종을 공개했다. 동기화된 효과음을 만드는 Mondo Sónico, 움직이는 자막을 만드는 CaptionCast, 썸네일용 ThumbnailForge, 3D 표면에 질감을 입히는 Surface, 모션 디자인용 CollageMotion Pro와 SwissFlow Studio다. 각 도구는 복제하고 변형할 수 있다. 🔗 출처
- 프랑스에 공급되기 시작한 Google Beam — 대면하는 듯한 현장감을 구현하려는 Google의 영상 통신 플랫폼 Beam은 HP와 함께 판매되며, 이제 프랑스를 포함한 6개국에 18개 파트너를 통해 공급된다. 내부 연구에서는 팀의 연결감이 50% 높아지고 후속 회의가 21% 줄었다고 한다. 🔗 출처
- Android Enterprise와 Gemini 에이전트 — Gemini는 화면에 표시된 내용을 바탕으로 여러 앱에 걸친 작업을 이어서 수행할 수 있다. 보호 장치는 개인용 에이전트가 업무용 프로필에 접근하지 못하게 하며, 관리자는 관리 대상 기기 전체에서 AI 자동화를 제한하거나 끌 수 있다. 🔗 출처
- 프랑스어로 제공되는 AI Brief — 사용자의 표현을 바탕으로 Google Ads의 AI Max 캠페인을 안내하는 AI Brief의 비공개 베타가 프랑스어, 네덜란드어, 독일어, 이탈리아어, 일본어, 포르투갈어, 스페인어로 확대된다. 🔗 출처
- Gemini CLI, 9월 23일 nightly — 안정 버전이 아닌 nightly 빌드다. Gemini 3.8 Flash와 Gemini 3.5 Flash Lite가 추가됐으며, API 키나 Vertex AI 또는 게이트웨이로 바로 사용할 수 있다. Google 계정에서는 실험 기능 표시를 켜야 한다. 22일 화요일에는 안정 버전이 출시되지 않았다. 🔗 출처
- EcoHash, 영상 최적화 효과 측정 — 96GB RTX PRO 6000에서 EcoHash는 MiniMax H3 영상 처리 시간을 174.8초에서 40.8초로, Wan2.2의 텍스트 기반 영상 생성 시간을 132.3초에서 10.7초로 줄였다. 4단계로 증류한 LoRA를 사용한 결과다. 시험한 설정 10개 가운데 두 가지 컴파일 모드를 포함한 3개는 효과가 없었다. 🔗 출처
- 크림 타타르어, 왜곡된 평가 방지 — 크림 타타르어 음성 인식 모델 개발자는 오디오북 4권이 말뭉치에 두 번씩 들어간 사실을 발견했다. 주요 평가용 음성 조각의 96.9%에는 학습 데이터에 똑같은 조각이 있었다. 이를 바로잡고 LoRA 미세 조정과 디코더 설정을 거친 뒤 단어 오류율은 0.3463에서 0.1701로 낮아졌다. 🔗 출처
- Falcon-H1과 mlx-lm — mlx-lm 0.31.3에서 KV 캐시를 사용하지 않으면 학습 중 Falcon-H1의 66개 층 가운데 첫 번째 층만 실행된다. 이 상태에서도 모든 LoRA가 오류나 경고 없이 한 층짜리 모델을 대상으로 학습된다. 수정은 코드 한 줄이면 되며, 관련 이슈가 등록됐다. 🔗 출처
- 에이전트와 오픈 소스 기여 — Quentin Gallouédec(Hugging Face)은 에이전트가 만든 기여가 실제 필요를 보여 주는 신호를 흐리고 유지관리자의 검토 시간을 소모한다고 본다. 무작위로 고른 프로젝트에 에이전트를 투입하는 일을 멈추고, 먼저 해당 프로젝트를 사용해 보라고 요청한다. 🔗 출처
- IETF의 Phionyx — Phionyx의 작성자는 평가 결과가 시스템 간에 전달될 때 그 조건과 한계를 유지하도록 하는 개인 초안 Claim-Preserving Exchange of AI Evaluation Evidence를 제출했다. 이 문서는 아직 어느 작업 그룹에도 채택되지 않았다. 🔗 출처
- Kimi Work 3.2.12 — Moonshot의 데스크톱 에이전트는 PPT, Excel, Word, Markdown 파일에서 특정 부분을 선택해 정확히 수정하도록 요청할 수 있게 됐다. 첨부파일 크기 제한도 없어졌다. 🔗 출처
- 공개 모델 선두에 오른 Qwen-Image-2.1 — Arena에 따르면 Qwen-Image-2.1은 이미지 편집에서 1,367점으로 전체 16위, 텍스트 기반 이미지 생성에서 1,228점으로 전체 17위를 기록하며 두 분야의 공개 모델 중 1위가 됐다. 🔗 출처
- Copilot 앱의 OpenTelemetry — 관리자는 GitHub Copilot 앱의 에이전트 세션 추적 정보(모델 요청, 사용 도구)를
managed-settings.json의telemetry속성을 통해 자체 모니터링 도구로 내보낼 수 있다. 프롬프트와 응답 내용은 기본적으로 제외된다. 🔗 출처 - Copilot CLI와 C++ — Copilot CLI의 Microsoft C++ Language Server는 이제 프로젝트 전체의 기호를 영구 인덱스로 만들며, 이 기능은 기본으로 켜져 있다. 첫 인덱스 구축에는 시간과 메모리가 많이 들 수 있다. GitHub는 성능 향상 수치를 제시하지 않았다. 🔗 출처
- 100만 줄짜리 pull request — GitHub 엔지니어링 글은 Copilot 앱이 파일 2,200개, 100만 줄 이상, 댓글 400개 이상으로 구성된 pull request를 표시하는 방법을 설명한다. 코드의 화면 배치는 미리 계산하고 댓글의 화면 배치는 보이는 영역 가까이에서 측정한다. 🔗 출처
- Genspark, Opus 5.5·GPT-6·Grok 4.7 추가 — 23일 밤 Genspark는 AI Chat, Code Agent, Claw에서 Claude Opus 5.5, Grok 4.7, GPT-6 Sol, GPT-6 Luna를 사용할 수 있게 했다. 각 개발사의 홍보 문구를 그대로 사용했으며, 요금제나 가격은 밝히지 않았다. 🔗 출처
- GitHub와 Yale의 설문조사 — 미국의 GitHub 사용자 1,039명 가운데 71%가 AI의 환경 영향을 우려한다고 답했고, 10명 중 8명은 에너지 효율이 높은 코드를 작성하도록 돕는 도구를 원했다. GitHub는 마케팅 정보 수신에 동의한 사람들로 구성된 표본이 대표성을 갖지 않는다고 명시했다. 🔗 출처
- Zed 1.21.0 — 안정 버전에서 사용자 자신의 API 키로 Claude Opus 5.5와 GPT-6 Astra, Sol, Luna를 사용할 수 있다. Agent 패널에는 SuperGrok 연결이 추가됐고, 에이전트가 작업하는 동안 컴퓨터가 절전 상태로 들어가지 않도록 기본 설정이 바뀌었다. 🔗 출처
- Warp — GPT-6 Sol과 Luna에 이어 Claude Opus 5.5가 Warp 터미널과 Warp Agent CLI에 추가된다. Grok 구독을 연결한 사용자에게는 Grok 4.7도 제공된다. 이용 가능 여부만 발표됐으며 가격은 공개되지 않았다. 🔗 출처
- Microsoft Teams의 Devin — 지금까지 채널에서만 사용할 수 있었던 Devin이 이제 일대일 메시지와 그룹 대화에서도 응답한다. 채널에서 Automations를 시작하고 질문이나 승인 카드도 보낼 수 있다. 앱은 새로운 권한을 요구하지 않는다. 🔗 출처
- Scribe v2 Medical — 9월 11일부터 제공된 ElevenLabs의 임상 음성 전사 모델이 공식 발표됐다. 새로 공개된 수치에 따르면 임상 음성에서 Scribe v2보다 단어 오류가 35% 적다. 가격은 시간당 0.22달러부터다. 🔗 출처
- ElevenLabs에서 빠지는 Sora 2 — OpenAI가 3월 24일 예고한 대로 9월 24일 Sora API를 종료함에 따라 ElevenLabs는 스튜디오에서 Sora 2와 Sora 2 Pro를 제거한다. 해당 워크플로는 Gemini Omni 1.1 Flash 같은 다른 영상 모델로 옮겨야 한다. 🔗 출처
- 캐나다의 Cohere Model Vault — Cohere는 단일 고객 전용 추론 플랫폼 Model Vault를 캐나다에서 제공한다고 발표했다. 클라우드 리전, 공급업체, 가격은 밝히지 않았으며 제품 페이지에도 아직 캐나다가 언급되지 않았다. 🔗 출처
- Cohere와 변화 관리 — Katherine Correia(Cohere)는 글에서 AI를 단순한 도구가 아닌 참여자로 받아들이고, 업무를 검증 가능한 일·판단이 필요한 일·두 성격이 섞인 일로 나누며, 사용 사례별로 관리하자고 제안한다. 특정 제품이나 수치는 제시하지 않았다. 🔗 출처
이것이 의미하는 것
Anthropic의 결과는 코딩 에이전트를 기초 생물학 연구로 확장한다. 약 950개의 Claude 에이전트가 21시간 동안 20만 개가 넘는 역전사효소를 분류했으며, 사람은 처음에 프롬프트를 제공하고 마지막에 실험을 하는 데만 관여했다. 병목은 가설을 가려내는 단계로 옮겨 갔고, Anthropic은 이제 이를 연구 대상으로 삼고 있다. 다만 신중한 해석이 필요하다. ART의 기능은 알려지지 않았고, 현재 결과물은 사전 공개 논문 형태다. 많은 에이전트를 투입하고 측정 기준으로 작업 범위를 정하는 같은 방식은 3,000건이 넘는 변경으로 claude.ai를 가속한 집중 개발 작업과 Lean을 이용한 Claude Agent SDK의 형식 검증에서도 나타난다.
에이전트 샌드박스의 보안이 공개적인 논의 주제가 되고 있다. Perplexity의 감사는 두 경계를 구분한다. 가상 머신 격리는 108차례 시험에서 유지됐지만, 네트워크 필터링은 DNS 검증의 허점이나 CDN의 공유 주소를 악용한 모델을 상대로 54차례 중 11차례 뚫렸다. 외부 플랫폼 10개 중 8개에서는 적어도 하나의 우회 방법이 발견됐다. Fable과 GPT-6 Astra, 두 모델은 이 시도를 거부했다. 같은 날 GitHub Copilot 앱은 보호 기능 없이 실행하는 대신 실행을 중단하는 로컬 샌드박스를 제공했고, Claude Code의 자동 모드는 읽기 전용 명령까지 분류기에 맡겼으며, Vibe CLI와 Kimi Code는 권한 검사를 우회하는 경로를 막았다. 이틀 전에는 ZCode가 커뮤니티에서 문제를 제기한 뒤 코드를 공개했다.
음성이 작업을 실행하는 인터페이스가 되고 있다. Gemini 3.8 Flash TTS와 Flash-Lite TTS의 음성 출력 비용은 이전 미리보기 버전의 절반 이하로 내려갔다. 2026년 말까지 토큰 100만 개당 각각 9달러와 6달러로, 이전에는 20달러였다. 녹음된 동의를 조건으로 하는 음성 복제 기능도 추가됐지만, 유럽경제지역에서는 AI Studio를 통해 사용할 수 없다. Qwen은 자사 오디오 기술군의 비용을 70~95% 낮춘다고 발표했고, NVIDIA는 화자 8명을 구분하는 모델을 공개했으며, Basis는 여러 사람의 목소리가 겹치는 대화 1,500시간을 공개했다. 한편 ChatGPT Voice는 ChatGPT Work의 플러그인과 작업 기능을 통해 대화에서 실행으로 나아간다.
마지막으로 물리적 세계에 쓰이는 AI도 개방되고 있지만, 조건은 제각각이다. 70억 개 매개변수의 FLUX 3 Action은 RoboLab-120에서 1위에 올랐고, NVIDIA와 함께 LeRobot에 통합됐다. 또한 빠르고 안정적인 제어 정책이 값비싼 추론의 필요성을 줄인다는 점을 보여 준다. GPT-6 Astra가 감독자로 참여할 때 성공 1회당 비용은 8.77달러로, Astra만 사용할 때의 13.47달러보다 낮다. 하지만 ‘개방’의 의미는 서로 다르다. FLUX 3 Action과 Basis Conversations 1500에는 각각 별도의 라이선스가 적용되고, QVAC Genesis III는 비상업용 라이선스를 사용하며, Qwen Intelligence는 모델 가중치 없이 벤치마크만 공개했다. 이 자원을 재사용하려는 사람에게는 점수만큼 라이선스도 중요하다.
출처
- Claude가 CRISPR와 유사한 반복 서열을 가진 새로운 효소 시스템 발견 (Anthropic)
- ART 사전 공개 논문 (PDF, Anthropic)
- @AnthropicAI: Claude가 발견한 효소 시스템
- Gemini 3.8 Flash TTS 및 Flash-Lite TTS (Google)
- Gemini API 9월 22일 릴리스 노트
- Gemini API 요금
- FLUX 3 Action (Black Forest Labs)
- @bfl_ai: FLUX 3 Action 출시
- Hugging Face의 FLUX 3 Action 컬렉션
- SPACE 탈출, 1부 (Perplexity)
- Claude Code v2.1.281
- 2주 만에 claude.ai를 3배 빠르게 만든 방법 (claude.dev)
- Claude Marketplace (Anthropic)
- @OpenAI: 플러그인과 ChatGPT Work에서 사용할 수 있는 ChatGPT Voice
- ChatGPT Voice 도움말
- ChatGPT 릴리스 노트
- MentalHealthBench 소개 (OpenAI)
- SWE-Serve (NVIDIA)
- NVIDIA/swe-serve 저장소
- DaVinci Resolve에서 사용할 수 있는 Runway
- Google Vids의 Gemini Omni 1.1 Flash
- Made On YouTube 2026
- Made On YouTube 2026 요약 (Google)
- Gemini의 새로운 연결 앱
- @GeminiApp: 새로운 연결 앱 13개
- @Muse: 출시 예정인 커넥터 4개
- @ElevenLabs: Muse에 추가되는 ElevenLabs
- @HeyGen: Muse에 합류하는 HeyGen
- @grok: Tesla 차량의 Grok Bot
- @Tesla: Grok과 커넥터
- @bot: Google Slides, Sheets, Docs와 연결된 Grok Bot
- Antigravity SDK의 로컬 모델 (Google Developers)
- Antigravity 변경 기록
- Private AI Compute의 영구 메모리 (Google DeepMind)
- @Alibaba_Qwen: Qwen Intelligence
- Qwen-Planner-Agent 보고서
- @Alibaba_Qwen: Qwen-Audio-3.1
- QwenCloud의 Qwen-Audio-3.1-Realtime
- Mistral 릴리스 노트
- Vibe CLI 2.25.8
- @zcode_ai: ZCode 소스 코드 공개
- zai-org/ZCode 저장소
- Kimi Code 2.1.0
- DeepSeek Harness v0.1.7-rc.1
- GenCode (Genspark)
- @genspark_ai: GenCode 출시
- JetBrains용 Copilot 1.18.0 (GitHub 변경 기록)
- GitHub Copilot 앱의 로컬 샌드박스 (GitHub 변경 기록)
- 단계적 배포와 보안 검토 (Cursor 변경 기록)
- 토큰 효율 개선 (Cursor)
- Nemotron 3 화자 분리 (NVIDIA, Hugging Face 블로그)
- AI Day Singapore (NVIDIA)
- 카나리아 배포 (Together AI)
- NVIDIA 클러스터 준비 상태 엔진 (NVIDIA)
- NodeWright (NVIDIA)
- Basis Conversations 1500 (Hugging Face 블로그)
- QVAC Genesis III (Hugging Face 블로그)
- Ai2와 Global Fishing Watch (Skylight)
- Google.org와 Gates Foundation (blog.google)
- Gates Foundation 보도자료
- AI 기반 코드 현대화 프로젝트를 준비하는 방법 (Anthropic)
- @bcherny: Lean을 이용한 Claude Agent SDK의 형식 검증
- Codex CLI 0.156.1
- Airbnb와 GPT-6 Astra (OpenAI)
- OpenAI Academy 2주년
- 내 LED 디스플레이에 생명 불어넣기 (OpenAI Developers)
- MedGemma와 세계 보건 (Google)
- Google Docs의 Gemini Notebook (Workspace 업데이트)
- Google Flow 도구 6가지 (Google Labs)
- Google Beam, 6개국으로 확대 (Google)
- Android Enterprise 2026의 새로운 기능 (Google)
- AI Brief와 AI Max (Google Ads)
- Gemini CLI v0.62.0-nightly.20260923
- 최적화 10건 중 3건은 효과가 없었다 (EcoHash)
- 크림 타타르어 음성 인식 (Hugging Face 블로그)
- Mac에서 Falcon-H1 미세 조정하기 (Hugging Face 블로그)
- 오픈소스 지옥으로 가는 길은 선의로 포장되어 있다 (Hugging Face 블로그)
- 대시보드에는 합격이라고 나온다. 정확히 무엇이 통과했을까? (Phionyx)
- Kimi Work 릴리스 노트
- @arena: Qwen-Image-2.1, 공개 모델 중 1위
- GitHub Copilot 앱의 OpenTelemetry
- Copilot CLI의 C++ 코드 인텔리전스
- GitHub Copilot 앱에서 대규모 풀 리퀘스트 렌더링하기
- @genspark_ai: Genspark의 Claude Opus 5.5
- 소프트웨어 개발 효율성에 관한 GitHub와 Yale의 조사
- Zed 1.21.0
- @warpdotdev: Warp의 GPT-6 Sol 및 Luna
- Devin, Microsoft Teams 및 Microsoft 365
- @ElevenLabs: Scribe v2 Medical
- ElevenLabs 9월 23일 변경 기록
- @cohere: 캐나다의 Model Vault
- AI 변화 관리 (Cohere)