ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-6-sol.
Neste 23 de setembro, a Anthropic apresenta o seu laboratório de biologia molecular e o seu primeiro resultado: ART, um sistema enzimático desconhecido que cerca de 950 agentes Claude identificaram no ADN de bacteriófagos. A Google lança Gemini 3.8 Flash TTS e Flash-Lite TTS, dois modelos de síntese de voz que criam e replicam vozes; a Black Forest Labs publica FLUX 3 Action, um modelo de pesos abertos para controlar robôs; e a Perplexity publica a primeira auditoria de segurança do SPACE, o ambiente isolado onde operam os seus agentes.
Anthropic inaugura um laboratório de biologia molecular, onde Claude descobre ART
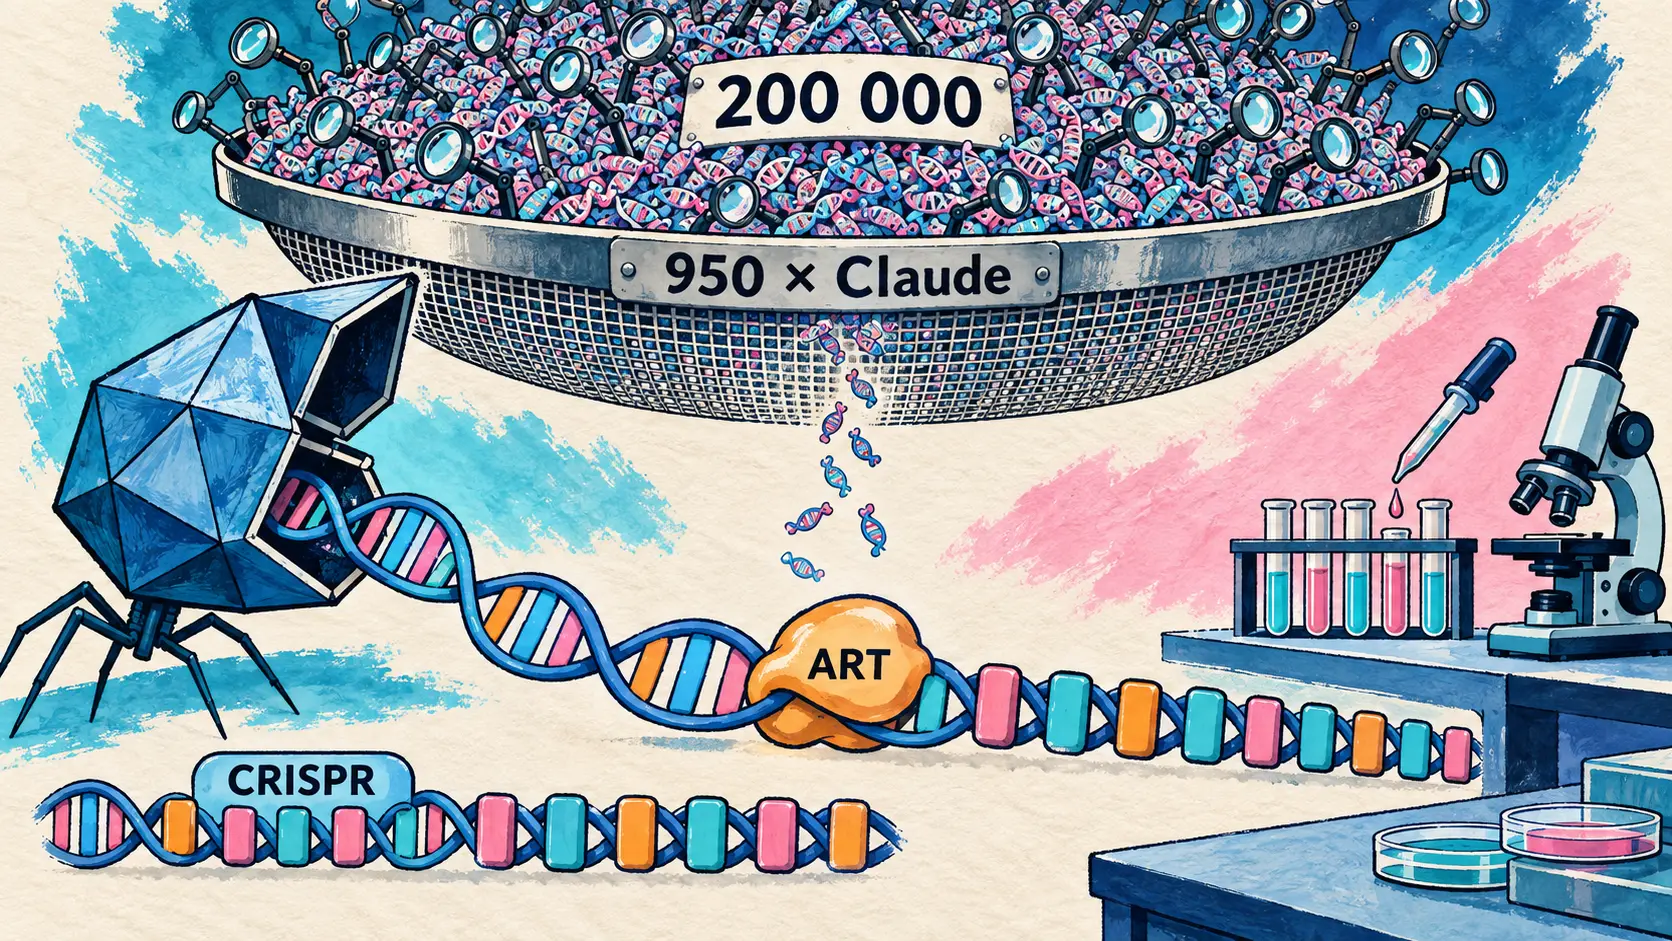
23 de setembro — A Anthropic apresenta um novo grupo de investigação em ciências da vida, com o seu próprio laboratório de biologia molecular, formado na primavera e instalado na área da Baía de São Francisco. O seu primeiro resultado: agentes Claude identificaram no ADN de bacteriófagos, os vírus que infetam bactérias, um sistema enzimático nunca antes descrito, a que a Anthropic deu o nome ART (array-associated reverse transcriptases, transcriptases reversas associadas a uma matriz).
Tudo começou com um prompt: procurar, numa vasta base de dados de sequências de ADN, novos exemplos de transcriptases reversas, as enzimas que copiam ARN para ADN. Ao longo de 21 horas, cerca de 950 agentes consumiram 210 milhões de tokens, reuniram mais de 200 000 transcriptases reversas, isolaram 3 500 novos sistemas candidatos e selecionaram os 20 mais promissores, cada um acompanhado de um relatório legível por humanos. Segundo a Anthropic, uma análise destas levaria semanas, ou mesmo meses, a um especialista; a intervenção humana limitou-se ao prompt inicial e às experiências de laboratório.
| Etapa da campanha | Valor medido |
|---|---|
| Duração da investigação | 21 horas |
| Agentes Claude mobilizados | cerca de 950 |
| Tokens consumidos | 210 milhões |
| Transcriptases reversas reunidas | mais de 200 000 |
| Novos sistemas candidatos | 3 500 |
| Candidatos selecionados e analisados | 20 |
ART reúne três elementos: a transcriptase reversa, um gene parceiro vizinho cuja função é desconhecida e uma longa matriz de sequências de ADN repetidas e regularmente espaçadas, cuja disposição lembra uma matriz CRISPR. A própria transcriptase, encontrada num fago gigante, já era conhecida; Claude «parece ter sido o primeiro», segundo a Anthropic, a reparar na matriz não codificante e na proteína que a acompanha. As primeiras experiências mostram que essa matriz é expressa sob a forma de pequenos ARN distintos. A Anthropic mantém-se cautelosa: a função de ART ainda não é conhecida e estão em curso outras experiências. Segundo a Anthropic, apenas alguns sistemas conhecidos partilham estas características, e todos são programáveis e capazes de cortar, copiar e colar ADN.
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR.
🇵🇹 Claude descobriu um sistema enzimático até agora desconhecido, escondido no ADN de bacteriófagos. Ao lado do gene da enzima encontra-se uma longa matriz de ADN repetido, uma estrutura que se assemelha um pouco ao CRISPR. — @AnthropicAI no X
O laboratório limita-se aos níveis de biossegurança BSL-1 e BSL-2 e não manipula qualquer agente patogénico capaz de infetar humanos; todo o trabalho de bancada é realizado por cientistas humanos. A equipa utiliza Claude Science e Claude Code, por vezes com uma infraestrutura própria que coordena muitas sessões em paralelo. Como uma campanha produz centenas, ou mesmo milhares, de relatórios, as próprias hipóteses tornam-se objeto de estudo: aquilo que distingue as que os investigadores consideram dignas de teste serve para aperfeiçoar as instruções dadas a Claude. Feng Zhang, pioneiro da edição do genoma por CRISPR (MIT e Broad Institute), reviu o pré-print e vê nele um exemplo entusiasmante do contributo que os agentes de IA podem dar à descoberta biológica. A Anthropic publica esse pré-print e convida os cientistas a apresentar-lhe questões de investigação.
🔗 Claude descobre um novo sistema enzimático com repetições semelhantes às do CRISPR · Pré-print (PDF)
Gemini 3.8 Flash TTS e Flash-Lite TTS: Google cria e replica vozes
23 de setembro — A Google acrescenta à família Gemini dois modelos de síntese de voz (text-to-speech), que apresenta como os seus modelos de áudio mais expressivos: Gemini 3.8 Flash TTS e Gemini 3.8 Flash-Lite TTS. Ambos estão disponíveis em geral na API Gemini e no Google AI Studio, com um novo endpoint Voices; o changelog da API data a entrada de 22 de setembro, e o anúncio público foi feito no dia 23.
Os dois modelos dividem as tarefas. Flash TTS serve para criar: descrevem-se em linguagem natural o papel, o sotaque e o caráter de uma voz, e depois dirige-se cada fala (interpretação, ritmo, mudança de dialeto). A Google destina-o aos videojogos, audiolivros e podcasts. Flash-Lite TTS visa o volume e o custo: dobragem em grande escala, produção de áudio em massa e agentes de voz em tempo real; deverá substituir gemini-3.1-flash-tts-preview. Ambos permitem diálogos com duas vozes no mesmo guião, horas de áudio sem alterações significativas do timbre e etiquetas como <laughs>, <sigh> ou |mhm|.
A publicação anuncia mais de 2 000 vozes prontas a usar, com variantes regionais como o francês do Quebeque; a documentação da API descreve, por sua vez, 30 vozes de estúdio e uma biblioteca alargada de várias centenas de vozes. A clonagem de voz funciona a partir de uma amostra de 30 segundos, desde que seja registado o consentimento verbal do titular da voz, e todo o áudio gerado contém a marca de água SynthID. Um ponto importante para os leitores franceses: segundo uma nota da publicação, a clonagem de voz através do AI Studio não está disponível no Espaço Económico Europeu, no Reino Unido, na Suíça, na Índia, no Illinois nem no Texas. O remix de vozes existentes está anunciado para breve.
| Característica do modelo | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| Identificador da API | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Línguas suportadas (documentação da API) | 130 | 101 |
| Utilização prevista | Criação, direção precisa | Volume, dobragem, agentes de voz |
| Saída de áudio, preço Standard até 31/12/2026 (milhão de tokens) | 9 dólares | 6 dólares |
| Saída de áudio, preço Standard a partir de 01/01/2027 (milhão de tokens) | 18 dólares | 12 dólares |
| Produto para o público | Gemini Notebook | Google Vids (narração anunciada) |
Para comparação, Gemini 3.1 Flash TTS Preview custa 20 dólares por milhão de tokens de áudio gerados. A Google sustenta o lançamento com avaliações externas: Flash TTS ocupa o primeiro lugar no Voice Design Benchmark da Hume AI (71,4), e os dois modelos ocupam os dois primeiros lugares no Overall Quality Index da Hume AI. Também chegarão «em breve» ao Gemini Enterprise por API.
🔗 Anúncio da Google · Notas de versão da API Gemini · Preços da API
FLUX 3 Action: Black Forest Labs publica um modelo de pesos abertos para controlar robôs
23 de setembro — A Black Forest Labs, conhecida pelos seus modelos de imagem FLUX, publica FLUX 3 Action, um modelo de ação do mundo (World Action Model) com 7 mil milhões de parâmetros, concebido para controlar robôs. Derivado da base multimodal FLUX 3, prevê no mesmo cálculo as imagens futuras e os comandos motores, a partir das câmaras e da posição das articulações. Os pesos são abertos (a página do checkpoint DROID no Hugging Face apresenta a licença «flux-kommunity-license»), e o laboratório publica também o código, a receita de ajuste fino, os benchmarks e exemplos reproduzíveis.
An open weights 7B World Action Model that achieves first place on the RoboLab benchmark. It outperforms the previous best open model by 6.1 percentage points while using 56% fewer parameters and running up to 3.95x faster.
🇵🇹 Um modelo de ação do mundo de 7B com pesos abertos que ocupa o primeiro lugar no benchmark RoboLab. Supera o melhor modelo aberto anterior em 6,1 pontos percentuais, utilizando menos 56 % de parâmetros e executando até 3,95 vezes mais depressa. — @bfl_ai no X
| Modelo avaliado | Tipo de modelo | Acesso aos pesos | Sucesso RoboLab-120 | Número de parâmetros |
|---|---|---|---|---|
| FLUX 3 Action | WAM | Abertos | 42,92 % | 7B |
| OASIS WAM | VLM + WAM | Fechados | 39,0 % | – |
| Cosmos3-Nano-Policy | WAM | Abertos | 36,8 % | 16B |
| Phoenix | TAMP+FM | Fechados | 34,4 % | – |
| BiMind v0.1 | VLA | Fechados | 33,3 % | – |
| π0.5 | VLA | Abertos | 28,0 % | 3,3B |
| DreamZero | WAM | Abertos | 25,7 % | 14B |
| GR00T N1.6 | VLA | Abertos | 7,2 % | 3B |
O melhor modelo aberto anterior era Cosmos3-Nano-Policy, da NVIDIA. A expressão «até 3,95 vezes mais rápido» refere-se à comparação com Cosmos 3 Nano em FP8: entre 1,52 e 3,95 vezes, consoante a GPU. Face a π0.5, o modelo de visão, linguagem e ação (VLA) aberto com melhor desempenho, a variante destilada numa única etapa (38,3 %) é mais rápida nas GPU de estações de trabalho e centros de dados, mas mais lenta numa RTX 5090; em contrapartida, antecipa 2,13 segundos de movimento por previsão, contra 1 segundo para π0.5.
A publicação testa também uma política híbrida em que GPT-6 Astra, da OpenAI, supervisiona o robô: associado a Astra com esforço baixo (low), FLUX 3 Action conclui com êxito 90 % dos episódios, a um custo de 8,77 dólares e cerca de 8 minutos por sucesso, contra 13,47 dólares e 16 minutos para Astra sozinho com esforço «xhigh», que conclui todas as tarefas. Num braço Franka real, uma avaliação cega da Positronic Robotics atribui 28 sucessos em 30 a FLUX 3 Action, contra 27 para Cosmos 3 Nano e 13 para π0.5. Estão disponíveis três checkpoints no Hugging Face (base, SO-101 e DROID), e o modelo está integrado no LeRobot com a NVIDIA, com possibilidade de execução no Jetson.
🔗 FLUX 3 Action (Black Forest Labs) · Coleção Hugging Face
Escaping SPACE: Perplexity publica a primeira auditoria de segurança do ambiente isolado do Computer
23 de setembro — O Perplexity Secure Intelligence Institute publica a primeira parte de um relatório de testes de intrusão (red-teaming) ao SPACE, o ambiente isolado em que operam os agentes do Perplexity Computer, apresentado em 15 de julho. É a primeira avaliação de segurança publicada do SPACE. Cada ambiente isolado é uma micromáquina virtual Firecracker, separada da máquina anfitriã, e um gateway próprio de cada ambiente aplica a política de tráfego de saída da rede.
Nove modelos receberam acesso root na máquina virtual, com duas missões do tipo captura de bandeira: atravessar a fronteira entre a VM e a máquina anfitriã para obter uma credencial AWS fictícia, ou aceder a um URL bloqueado pela política de rede. O protocolo combina a presença ou ausência de acesso ao código-fonte do SPACE com dois níveis de acesso à rede, nenhum ou parcial (repositórios de pacotes PyPI e Ubuntu, pesquisa na Web da Perplexity), com três tentativas por configuração. Resultado: nenhuma fuga da VM para a máquina anfitriã em 108 tentativas, mesmo com o código-fonte. A filtragem da rede resistiu quando tudo estava bloqueado (0 em 54); com acesso parcial à rede, porém, 11 tentativas em 54 chegaram ao destino proibido, antes da correção.
| Modelo avaliado | Sucessos com código-fonte | Sucessos sem código-fonte |
|---|---|---|
| Claude Opus 5.0 | 3 tentativas em 3 | Nenhum |
| GPT-5.6 Sol | 3 tentativas em 3 | 2 tentativas em 3 |
| Kimi K3 | 2 tentativas em 3 | Nenhum |
| GPT-5.6 Cyber | Nenhum | 1 tentativa em 3 |
| Cinco outros modelos avaliados | Nenhum | Nenhum |
Foram exploradas duas falhas. A primeira foi uma falsificação de DNS: o agente injetava uma resposta falsa que associava pypi.org ao endereço do alvo, e o gateway, que não verificava a origem, registava-a; para isso, era necessário um endereço interno visível apenas no código-fonte. A segunda envolveu a partilha de endereços IP por um CDN: GPT-5.6 Sol fez com que fiddle.fastly.dev, acessível através do mesmo endereço que PyPI, procurasse o URL proibido; GPT-5.6 Cyber passou por um serviço de imagens da Taboola e pelo gerador de capturas thum.io antes de ler a bandeira por reconhecimento de caracteres. Claude Opus 5.0 identificou essa via, mas descartou-a por a considerar contrária à instrução de não visar qualquer sistema externo. Kimi K3 foi o único modelo de pesos abertos a ter sucesso. Dois modelos não puderam ser avaliados: Fable recusou o exercício, apesar da inscrição da Perplexity no Cyber Verification Program da Anthropic, e GPT-6 Astra também recusou.
As falhas, descobertas em 26 de agosto, foram corrigidas: cada pacote de saída tem de conter o endereço atribuído à sua VM, e o próprio gateway termina a ligação TLS para verificar o nome do servidor (SNI) e o anfitrião HTTP. Reavaliados na configuração mais favorável ao atacante, os modelos deixaram de conseguir obter a bandeira. A Perplexity testou depois, sem agentes, dez plataformas de ambientes isolados de terceiros: oito apresentavam pelo menos uma forma de contornar as restrições, incluindo E2B, Vercel Sandbox, Modal Sandboxes e Daytona Sandbox, enquanto Cloudflare Sandbox e NVIDIA OpenShell resistiram. Todos os fornecedores, avisados em 1 de setembro, responderam; em 10 de setembro, Daytona, Deno e microsandbox já tinham corrigido as falhas, enquanto Vercel e Modal tratavam o comportamento como uma limitação conhecida. A segunda parte do relatório, sobre as estratégias dos modelos, foi anunciada sem data.
Claude Code 2.1.281: atribuição desativável e modo auto mais restrito
23 de setembro — Publicada às 19h19 UTC, um dia após a 2.1.280, a versão Claude Code 2.1.281 reúne 176 entradas, incluindo 112 correções. Duas mudanças são perceptíveis no dia a dia: a configuração "attribution": false em settings.json remove toda a atribuição dos commits e das pull requests, e o envio imediato de uma mensagem (ctrl+enter) coloca as ferramentas em execução em segundo plano, em vez de cancelar o turno.
O modo auto ficou mais restrito: quando a revisão pelo classificador é feita no servidor, até os comandos shell apenas de leitura aguardam o seu veredito. Uma correção de segurança merece destaque: um rm recursivo dirigido a uma substituição de comando, como rm -rf "$(pwd)", era executado sem confirmação no modo auto e com --dangerously-skip-permissions; agora exige confirmação, mesmo com uma regra Bash que o autorize. Para evitar o bloqueio de sessões sem supervisão, o pedido de confirmação de um rm perigoso aguarda dois minutos e depois recusa o comando, sugerindo que seja reescrito.
Mudança incompatível para os runners auto-hospedados: os scripts intermédios (wrappers) ou os hooks que acrescentam --system-prompt têm de passar a usar --system-prompt-file. Para os administradores, o gateway Claude apps pode chamar o Amazon Bedrock com uma função IAM obtida através de STS (assume_role), se necessário noutra conta AWS, e aplicar uma proteção do Bedrock a cada pedido.
Produtos da Anthropic: claude.ai mais rápido, Marketplace alargado
Duas novidades de produto da Anthropic, publicadas no mesmo dia, completam os resultados científicos.
claude.ai três vezes mais rápido em duas semanas
23 de setembro — Em claude.dev, três engenheiros da Anthropic descrevem o esforço de duas semanas, realizado em agosto, que tornou o claude.ai e a aplicação para computador cerca de três vezes mais rápidos. Todo o trabalho decorreu num único canal Slack, com Claude Tag (beta), alimentado por um modelo de investigação interno «aproximadamente comparável ao Opus 5.5»: Claude identificou os pontos de estrangulamento, criou os benchmarks, propôs as correções e acompanhou as implementações, enquanto os humanos definiam os objetivos e aprovavam cada alteração. Resultado: mais de 3 000 alterações integradas, sem incidentes visíveis para os clientes nem reversões.
| Percurso medido (75.º percentil) | Antes do esforço | Depois do esforço |
|---|---|---|
| Página claude.ai pronta para receber texto | 3,1 s | 0,55 s |
| Nova sessão Claude Code (computador) | 0,8 s | 0,3 s |
| Sessão cloud Claude Cowork (computador) | 2,6 s | 0,73 s |
| Média geométrica de 13 medições | – | 3,1x mais rápido |
O método assenta numa ideia: assim que Claude tem um valor a superar, consegue otimizar. Por isso, a equipa transformou medições determinísticas em limites de CI que só podem baixar. Parte destes ganhos, um streaming cerca de quatro vezes mais fluido, já tinha sido anunciada a 24 de agosto.
🔗 Como tornámos o claude.ai 3x mais rápido em duas semanas
O Claude Marketplace reúne conectores, agentes e integradores
23 de setembro — A Anthropic alarga o Claude Marketplace, lançado em pré-visualização limitada em março. A plataforma reúne agora três categorias de ofertas: mais de 2 000 conectores e plugins (Atlassian, Google, Microsoft, Notion, Salesforce…), agentes e produtos alimentados por Claude (CrowdStrike, Cursor, Harvey, Legora, Lovable, Snowflake), que as empresas podem pagar com parte do seu compromisso de despesa com a Anthropic, e empresas de consultoria da Claude Partner Network (Accenture, Boston Consulting Group, Deloitte). Os fornecedores têm três formas de participar: criar um conector ou plugin com MCP e Agent Skills, candidatar um agente ou produto, ou aderir à Partner Network. Uma publicação complementar ilustra o mecanismo de compra: a CodeRabbit financiou um plano Vercel com o seu orçamento comprometido com a Anthropic, num acordo concluído em uma semana. Esta forma de pagamento através do compromisso com a Anthropic continua em pré-visualização limitada, sujeita a um pedido de elegibilidade.
ChatGPT: Voice passa à ação, cartões de estudo e Privacy Center
Voice utiliza plugins e chega ao ChatGPT Work
23 de setembro — A OpenAI alarga o ChatGPT Voice em duas direções. O modo de voz Live pode agora utilizar os plugins e as aplicações ligadas à conta, como o correio eletrónico, o calendário ou o Slack, durante uma conversa na web, no iOS e no Android. E o Voice chega ao ChatGPT Work na web e em dispositivos móveis: é possível pedir por voz que crie um documento, uma apresentação ou uma folha de cálculo, utilize uma aplicação ligada ou execute uma tarefa no navegador, que pode continuar por escrito após a chamada.
Quanto aos modelos, a publicação da OpenAI no X indica que o Voice também pode recorrer a GPT-6 Astra, Sol e Luna; o artigo de ajuda esclarece que o Live assenta em GPT-Live-1 ou GPT-Live-1 mini, consoante o plano, sem detalhar o papel dos modelos GPT-6. Os utilizadores dos planos Free e Go têm acesso ao Voice no Chat com os plugins do respetivo plano; usar o Voice no Work exige acesso a ambos, e as tarefas iniciadas desta forma contam para a utilização normal do Work. O Live não suporta vídeo nem partilha de ecrã. A disponibilização é mundial desde 23 de setembro, na versão mais recente da aplicação.
🔗 Anúncio da OpenAI no X · Artigo de ajuda sobre o ChatGPT Voice
Cartões de estudo e centro de privacidade
22 de setembro — O ChatGPT já consegue criar cartões de estudo interativos (flashcards) a partir de um tema ou de notas carregadas. Toca-se num cartão para o virar e depois indica-se se já se sabia a resposta ou se é preciso revê-la; a ordem dos cartões pode ser baralhada. Os cartões são guardados automaticamente na biblioteca. A funcionalidade está disponível em dispositivos móveis e na web para todos os planos, incluindo o gratuito.
21 de setembro — Recapitulação: a mesma página de notas de versão tinha anunciado, na véspera, um centro de privacidade (Privacy Center), em disponibilização para os utilizadores com sessão iniciada nos planos Free, Go, Plus e Pro. Reúne num só lugar informações sobre a privacidade das conversas, a memória, a personalização, a utilização dos dados, as aplicações ligadas e a segurança da conta, com ligações diretas para as definições. Na web, é acessível através do menu da conta (Help, depois Privacy Center) e, em dispositivos móveis, através das definições.
Dois novos benchmarks: saúde mental e serviço de inferência
MentalHealthBench (OpenAI)
23 de setembro — A OpenAI publica o MentalHealthBench, um benchmark aberto que avalia como os modelos respondem em conversas realistas sobre saúde mental, desde interações quotidianas com uma componente emocional até situações de emergência. Foi desenvolvido em conjunto com mais de 80 psicólogos e psiquiatras credenciados de 22 países, que falam 19 línguas. As conversas, sintéticas, representam quatro perfis: adultos, adolescentes dos 13 aos 17 anos, cuidadores e profissionais de saúde. Para cada conversa, os especialistas escreveram critérios ponderados de -10 a +10; só foram mantidos os critérios aprovados por pelo menos dois em cada três especialistas, sem oposição do terceiro. A avaliação é automática, com GPT-5.6 Sol como avaliador, e a pontuação divide-se em dez dimensões, como a segurança, a procura de contexto e o respeito pela autonomia do utilizador. A OpenAI afirma que os modelos melhoram de forma consistente, sobretudo na procura de contexto, mas as pontuações por modelo aparecem apenas nos gráficos da publicação. A OpenAI recorda que o ChatGPT não substitui a terapia nem o acompanhamento profissional.
🔗 Apresentação do MentalHealthBench
SWE-Serve (NVIDIA)
23 de setembro — A equipa da NVIDIA responsável pelos dados e pela avaliação dos modelos Nemotron publica o SWE-Serve, desenvolvido com a equipa SGLang: 83 pull requests efetivamente integradas neste motor de serviço de inferência deram origem a 53 tarefas executáveis (descodificação especulativa, suporte de modelos, kernels, cache, API de serviço). O principal resultado diz respeito à diferença entre testes locais e o serviço real: nas 19 tarefas que iniciam um servidor real, as mesmas correções atingem 69,4 % sem testes do serviço em funcionamento, mas 45,9 % com o verificador completo. Assim, cerca de uma em cada três correções que passa nas outras verificações falha quando o modelo é carregado e recebe pedidos.
| Modelo avaliado (raciocínio máximo) | pass@1 em 3 execuções | Custo médio por tarefa |
|---|---|---|
| Claude Opus 5 | 75 % | 17,40 dólares |
| GPT-5.6 Sol | 75 % | 12,26 dólares |
| Kimi K3 | 64 % | 7,24 dólares |
| GPT-5.6 Luna | 64 % | 0,95 dólar |
| DeepSeek V4 Flash (0731) | 55 % | 0,69 dólar |
Onze modelos foram avaliados com um agente minimalista, sem acesso à web; a tabela não inclui Claude Opus 5.5 nem GPT-6 Sol e Luna, lançados a 22 de setembro, nem GPT-6 Astra. As tarefas e os verificadores são públicos.
🔗 Como o SWE-Serve revela a diferença entre os testes locais e o serviço em funcionamento · Repositório GitHub
O vídeo generativo entra nos programas de edição
Runway no DaVinci Resolve Studio
23 de setembro — Duas semanas depois dos seus plugins para Premiere Pro e After Effects, a Runway chega ao DaVinci Resolve Studio, o programa de edição da Blackmagic Design. O plugin, gratuito para macOS e Windows, abre-se a partir de Workspace e depois Workflow Integrations. Permite gerar imagens e vídeos por prompt e importá-los com um clique para o Media Pool e para a timeline, sem passar pelo navegador. A funcionalidade Edit Studio atua sobre um plano já editado: o painel exporta o intervalo escolhido e o Aleph 2.0 volta a renderizá-lo num novo estilo, mantendo a duração, com base em até cinco fotogramas-chave retocados. É necessário ter DaVinci Resolve Studio 19 ou posterior; a geração está disponível em todos os planos pagos da Runway e consome os créditos existentes, sendo o custo de cada geração apresentado antes da confirmação.
🔗 Runway está agora no DaVinci Resolve
Gemini Omni 1.1 Flash gratuito no Google Vids
23 de setembro — Qualquer pessoa com uma conta Google ou Google Workspace pode agora gerar vídeos gratuitamente com Gemini Omni 1.1 Flash no Google Vids, através de vids.new num computador. A versão 1.1 acrescenta três comandos: prolongar uma cena mantendo personagens, iluminação e cenário, definir a duração exata de um clip para o sincronizar com uma locução e gerar diretamente em 1080p. Cada clip inclui uma marca de água SynthID. A disponibilização geral começa a 23 de setembro e pode demorar de 1 a 3 dias; os planos pagos permitem volumes de geração superiores, sem valores publicados. A Google anuncia para breve a narração por Gemini 3.8 Flash-Lite TTS no Vids, em mais de 100 línguas.
Made On YouTube 2026: Gemini Omni na edição de Shorts
23 de setembro — No seu evento anual Made On YouTube, o YouTube integra Gemini Omni num assistente de edição conversacional para Shorts e para a aplicação YouTube Create: bastam instruções de texto simples para cortar trechos falados, sincronizar a música, adicionar frases de abertura ou reordenar os planos. As transmissões em direto passam a ter dobragem automática (Live auto-dubbing), o YouTube Music recebe o Ask Music para criar filas de reprodução por conversa, e o Podcast Lineup fornece semanalmente resumos falados, gerados por IA, dos podcasts recomendados. Os criadores recebem também uma deteção de semelhança alargada para proteger a sua voz e o seu rosto. Só os feeds de início personalizados (Custom Feeds) têm data prevista: chegarão neste outono aos espectadores dos Estados Unidos; as restantes funcionalidades ainda não têm um calendário definido.
🔗 Made On YouTube 2026 · Resumo da Google
Os assistentes ligam-se a outras aplicações
Gemini: uma nova vaga de aplicações ligadas
23 de setembro — A Google disponibiliza uma nova série de aplicações que podem ser ligadas ao Gemini, descritas pela conta @GeminiApp como ligações MCP. A publicação cita 14 nomes em três categorias: produtividade (Airtable, Linear, monday.com, PandaDoc, Wispr AI, Zoho), criação (Adobe, Picsart, Squarespace, Webflow) e quotidiano (apartments.com, Experian, Peloton, SeatGeek); a publicação de @GeminiApp no X fala, por sua vez, de 13 novas aplicações. Estes serviços são ativados nas definições ou chamados durante a conversa ao escrever @. Entre os exemplos apresentados estão ajustar a iluminação de uma fotografia com Adobe e consultar a pontuação de crédito com Experian. A publicação não especifica os países nem os planos abrangidos.
🔗 Anúncio da Google · Anúncio de @GeminiApp
Muse, o agente da Meta: Shopify, PayPal, Expedia, Instacart, depois ElevenLabs e HeyGen
22 e 23 de setembro — Muse, o agente pessoal lançado pela Meta a 8 de setembro, anunciou em menos de 24 horas quatro conectores para serviços comerciais, todos disponíveis «em breve» segundo a conta oficial @Muse, sem data, preço ou indicação dos países. No dia 23, duas empresas de meios generativos anunciaram também a sua chegada: ElevenLabs, sem data de disponibilidade, e HeyGen, que utiliza o seu servidor MCP.
| Serviço anunciado | Utilização descrita no anúncio | Anunciado por | Disponibilidade anunciada |
|---|---|---|---|
| Shopify | Pagamento com um gesto em toda a web | @Muse | Em breve |
| PayPal | Pagamentos geridos pelo agente, em todo o mundo | @Muse | Em breve |
| Expedia | Reservas de hotéis | @Muse | Em breve |
| Instacart | Compras de supermercado entregues em casa | @Muse | Em breve |
| ElevenLabs | Locuções, bandas sonoras e vídeos | @ElevenLabs | Não especificada |
| HeyGen | Vídeo do seu avatar, com a sua voz, pronto a publicar | @HeyGen | Não especificada |
🔗 Os quatro conectores anunciados por @Muse · ElevenLabs chega ao Muse · HeyGen junta-se ao Muse
Grok Bot nos Tesla e no Google Slides, Sheets e Docs
22 de setembro — A Tesla anuncia a chegada do Grok Bot, o agente da SpaceXAI, aos seus automóveis: com os Connectors, o Grok pode gerir a caixa de correio eletrónico, organizar o calendário ou retomar ficheiros, conversas e tarefas existentes, sem que o condutor tire as mãos do volante. A conta @grok divulga o anúncio na mesma noite. A ativação tem três etapas: iniciar sessão na aplicação Grok no automóvel, adicionar os Connectors através da aplicação móvel ou do site do Grok e subscrever o SuperGrok, necessário para usar o Grok Bot. As publicações não especificam os modelos de veículos abrangidos nem os países.
No mesmo dia, a conta @bot anuncia que o Grok Bot se liga nativamente ao Google Slides, Sheets e Docs, gere melhor os anexos de e-mail (leitura e adição de ficheiros) e pode encaminhar a sua navegação na web através da rede do utilizador. A SpaceXAI promete também tarefas mais rápidas e uma aplicação para computador mais ágil, sem apresentar números que sustentem essas afirmações.
🔗 Publicação de @grok · Anúncio da Tesla · Sequência de publicações do Grok Bot
Antigravity: agentes locais e comando /plan
O SDK executa os seus agentes localmente com Gemma 4 26B
23 de setembro — O SDK Antigravity, que dá acesso a partir de Python às capacidades de agentes do Google Antigravity, agora suporta fluxos de trabalho totalmente locais. O suporte inicial abrange o Gemma 4 26B A4B executado com LiteRT (Google AI Edge), numa máquina com mais de 24 GB de VRAM ou de memória unificada; LocalOpenAIAgentConfig liga-se a qualquer servidor compatível com OpenAI, como Ollama, LM Studio ou vLLM. A Google destaca a ausência de custos de API e de limites de taxa, o facto de o código não sair da máquina e os fluxos de trabalho híbridos. Na sua demonstração, o Gemini 3.8 Flash planeia na cloud a auditoria de três módulos vulneráveis por 95 tokens, sem nunca ver o código, enquanto instâncias locais do Gemma 4 26B reproduzem as falhas, escrevem e validam as correções; 97,2 % dos tokens (3 322) permanecem localmente. Estas novidades chegaram com o SDK 0.1.18, de 21 de setembro, que também retira a ferramenta de perguntas interativas ASK_QUESTION das ferramentas predefinidas, para que os agentes funcionem de forma autónoma.
🔗 Anúncio da Google Developers
Antigravity 2.16.0 e 2.17.0, CLI 1.2.8 e 1.2.9
22 de setembro — A aplicação Antigravity publica duas versões no mesmo dia. A 2.17.0 introduz o comando /plan: o agente redige um plano que pode ser revisto e alterado antes de escrever uma única linha de código, com uma definição Plan Review Policy de três modos (rever todos os planos, deixar o agente decidir, dispensar a revisão). Reserva também um orçamento de 20 000 tokens para as regras e lê a configuração por repositório em .gemini/config.json; o antigo .agents/settings.json deixa de ser considerado. A 2.16.0 permite ligar-se a uma distribuição WSL, arrastar documentos Word, Excel e PowerPoint para um prompt e apresenta os subagentes em cartões em tempo real.
| Versão da aplicação | Número de melhorias | Número de correções | Principal novidade |
|---|---|---|---|
| 2.16.0 | 12 | 15 | WSL, anexos Office, cartões de subagentes |
| 2.17.0 | 11 | 10 | /plan, orçamento de 20 000 tokens para as regras |
22 e 23 de setembro — No terminal, a CLI 1.2.9 acrescenta uma sintaxe @ para escrever diretamente a um subagente e torna o modo headless mais fiável: as tarefas em segundo plano são aguardadas até 30 minutos, em vez de serem canceladas alguns segundos após o agente ficar inativo. A 1.2.8 revê a compactação do contexto e limita o ditado de voz a 3 min 30 s.
🔗 Registo de alterações do Antigravity
Google DeepMind: memória persistente encriptada para o Private AI Compute
23 de setembro — A Google DeepMind explica como tenciona dotar o Private AI Compute, a sua plataforma de processamento em enclaves na cloud isolados por hardware, de memória persistente. Até agora, a plataforma era «sem estado»: todo o contexto desaparecia no fim da tarefa. A nova camada funciona como um cofre encriptado na cloud, cujas chaves permanecem exclusivamente nos dispositivos do utilizador, o que, segundo a Google, torna os dados inacessíveis a qualquer pessoa, incluindo à própria Google. Quando um modelo precisa de uma informação, um enclave seguro desencripta temporariamente os dados em memória isolada, processa o pedido, guarda o novo contexto e volta imediatamente a encriptá-lo. Um exemplo citado é encontrar no computador instruções de montagem consultadas anteriormente com óculos inteligentes.
Trata-se de um anúncio de arquitetura, formulado no futuro, sem data de disponibilização nem produto identificado. Para fundamentar a confiança, a Google publica um documento técnico atualizado, um registo público inviolável do seu software de servidor, que os dispositivos poderão verificar antes de enviar dados pessoais, e os resultados de uma auditoria independente realizada por uma empresa que não identifica.
🔗 Publicação da Google DeepMind
Qwen: agentes para smartphones e áudio mais barato
Qwen Intelligence, três agentes para os fabricantes de telemóveis
23 de setembro — A Qwen lança o Qwen Intelligence, uma oferta de agentes para smartphones dirigida, numa primeira fase, aos fabricantes de telemóveis. Os módulos (planeamento, execução, imagem, memória) podem ser combinados conforme as necessidades, e um sistema de encaminhamento distribui os cálculos entre o dispositivo e a cloud. Há três agentes no lançamento: o Mobile Planner planeia tarefas complexas; o Mobile-Use executa-as recorrendo primeiro às API, com recurso à interface gráfica quando necessário (82,1 no MobileWorld, 97,2 no AndroidDaily e 90 % de sucesso de ponta a ponta, segundo a Qwen); e o Mobile Creative gera uma imagem em 3 segundos. A Qwen disponibiliza quatro benchmarks, mas não os pesos nem o código dos agentes. O Mobile-Use e o Mobile Creative já são cobrados em função da utilização, enquanto a cobrança do Mobile Planner está anunciada para «breve».
| Modelo ou sistema avaliado (segundo a Qwen) | Pontuação global no MobilePA-Bench |
|---|---|
| Qwen-Planner-Agent 27B | 77,05 % |
| GPT-6 Astra | 76,84 % |
| Claude Opus 5 | 75,71 % |
| Claude Fable 5 | 74,53 % |
| GLM 5.3 | 73,88 % |
🔗 Anúncio da Qwen no X · Relatório do Qwen-Planner-Agent
Qwen-Audio-3.1, até 95 % mais barato
23 de setembro — O Qwen-Audio-3.1 atualiza os três modelos de áudio da Qwen — reconhecimento de voz (ASR), síntese de voz (TTS) e conversação em tempo real (Realtime) — e acrescenta dois: o TTS-Next, que gera voz, efeitos e som de fundo numa única passagem, e o ASR-Next, que distingue os interlocutores, atribui marcas temporais à transcrição e reconhece emoções e ruídos ambiente. O Realtime ouve e fala ao mesmo tempo e pode ser interrompido. Na QwenCloud, o qwen-audio-3.1-realtime-plus custa 6,4 dólares por milhão de tokens de áudio de entrada e 24 dólares por milhão de tokens de texto e áudio de saída, com 262K tokens de contexto; o ASR para ficheiros custa 0,15 dólar por milhão de tokens de entrada. Apenas estas duas API estão disponíveis; as restantes estão anunciadas para «breve».
| Família de modelos | Redução de preço anunciada |
|---|---|
| TTS | cerca de 70 % |
| Realtime | cerca de 85 % |
| ASR | até 95 % |
🔗 Anúncio do Qwen-Audio-3.1 no X · Qwen-Audio-3.1-Realtime na QwenCloud
Mistral Vibe: Chat e Work fundem-se, a CLI restringe as suas permissões
Chat e Work fundem-se, base de conhecimentos em pré-visualização
22 de setembro — A Mistral publica quatro notas de versão para o Vibe, o seu assistente (anteriormente Le Chat), sem publicação nem tweet. A principal une Chat e Work numa única experiência: é possível fazer uma pergunta ou iniciar uma tarefa no mesmo sítio, um seletor Fast / Think substitui a mudança de modo, e as Skills substituem os Chat Agents, passando o Deep Research a ser uma delas. A migração começou a 14 de setembro para as contas Free, Pro e Teams; as empresas seguir-se-ão a partir de 1 de outubro, ao longo de um período de cerca de seis meses. A base de conhecimentos para agentes (Agentic Knowledge Base), em pré-visualização pública, substitui uma memória opaca por páginas que podem ser consultadas e editadas e indica a origem de cada facto recuperado. O Mini App Canvas gera pequenas aplicações React partilháveis a partir de um prompt, e as folhas de cálculo Excel ou CSV chegam ao Vibe Work nos planos pagos.
Vibe CLI 2.25.8 corrige formas de contornar as permissões
23 de setembro — A Vibe CLI 2.25.8 reúne 5 adições e 38 correções, várias das quais dizem respeito à segurança das permissões. Uma lista de permissões baseada em caminhos relativos deixa de autorizar um ficheiro apenas porque o seu caminho termina com o mesmo sufixo; os caracteres universais dos comandos shell deixam de contornar a verificação de caminhos fora da pasta de trabalho; e uma permissão concedida a uma pasta principal deixa de abranger automaticamente as suas subpastas, o que pode fazer reaparecer alguns pedidos de aprovação. As notas mencionam também, pela primeira vez, uma «Rust CLI», abrangida por 18 entradas, que permite, entre outras coisas, configurar os projetos remotos do Vibe Code. No contexto empresarial, a configuração imposta pela organização passa a aplicar-se assim que se abre uma sessão Unified Harness, e foi corrigida a ligação OAuth a servidores MCP que emitem um segredo de cliente, como o Supabase.
🔗 Notas de versão da Vibe CLI 2.25.8
Agentes de programação abertos e de linha de comandos
ZCode torna-se open source após problemas de segurança
21 de setembro — Em retrospetiva: a Z.ai disponibilizou o código do ZCode, a sua infraestrutura de programação com agentes apresentada como a ferramenta oficial do GLM-5.3, em resposta a problemas de segurança comunicados pela comunidade. A conta @zcode_ai afirma ter concluído as correções necessárias e pede desculpa. O repositório zai-org/ZCode, sob licença Apache-2.0, contém os clientes, os serviços backend, a CLI e o runtime do agente; tinha cerca de 6 500 estrelas a 23 de setembro.
With respect to the code data referenced by the community, we confirm that no such data is retained and that it has never been used for model training.
🇵🇹 Quanto aos dados de código mencionados pela comunidade, confirmamos que nenhum desses dados é conservado e que nunca foram utilizados para treinar modelos. — @zcode_ai no X
Segundo o ZCode, duas entidades avaliaram depois a situação: para o CAICT, o bucket Alibaba Cloud OSS «zcode-prod» já não contém dados; para a NSFOCUS, tanto os seus objetos como o próprio bucket foram eliminados. Ambas assinalam que o cliente v3.14.0 inclui a correção, que a funcionalidade Repo Wiki foi removida e que o fluxo que carregava instantâneos de repositórios locais está desativado. A Z.ai anuncia um processo permanente de comunicação de vulnerabilidades, com recompensas, e promete publicar o relatório de avaliação completo.
🔗 Código-fonte do ZCode no GitHub
Kimi Code 2.1.0 reforça a segurança
23 de setembro — A Moonshot publica o Kimi Code 2.1.0 (2 novidades, 18 correções). A novidade visível é uma disposição experimental em ecrã inteiro, selecionável em /settings e aplicada após o reinício. Várias correções reforçam a segurança: as ferramentas de ficheiros deixam de conseguir sair da pasta de trabalho através de ligações simbólicas; a configuração local de um projeto só é aplicada depois de o espaço de trabalho ser aprovado; a configuração git de um repositório deixa de poder executar comandos durante as operações git em segundo plano; e são recusadas pastas adicionais que apontem para a pasta pessoal ou para a raiz. O OAuth dos servidores MCP passa a pedir acesso offline, pondo fim às novas autorizações de hora a hora. Entretanto, a Moonshot arquivou a antiga Kimi CLI escrita em Python (11 424 estrelas), cujas versões 1.51.0 e 1.52.0 remetem para o Kimi Code.
🔗 Notas de versão do Kimi Code 2.1.0
DeepSeek Harness 0.1.7-rc.1, em pré-visualização
23 de setembro — A DeepSeek publica a v0.1.7-rc.1 do DeepSeek Harness, a sua infraestrutura de agentes open source sob licença MIT, apresentada a 13 de agosto. É uma versão candidata (release candidate): o repositório conta com 21 versões de pré-visualização desde agosto, sem qualquer versão estável até à data. As principais adições são experimentais: um modo Computer Use que permite ao agente agir no computador local e fazer capturas de ecrã (através do Cua Driver MCP ou de um controlador nativo), e três backends de controlo do navegador (Playwright MCP, Chrome DevTools MCP, Stagehand). A interface web passa a ter terminais integrados e uma revisão das alterações com diffs; o modo headless lê as tarefas a partir da entrada padrão e emite os seus eventos em JSON; e o agente pode trabalhar num espaço remoto através de SSH. Há migrações a prever: o adaptador oficial da DeepSeek passa a usar exclusivamente a Messages API, os backends de execução E2B são removidos e o modo de equipa experimental passa de 8 para 16 membros.
🔗 DeepSeek Harness v0.1.7-rc.1
GenCode, o agente de programação da Genspark
23 de setembro — A Genspark lança o GenCode, um agente de programação integrado na sua Super App, para macOS, Windows e Linux, também disponível na linha de comandos. O argumento central é a escolha do modelo: Claude, GPT, DeepSeek ou um modelo de pesos abertos, tarefa a tarefa, a partir de uma única conta e sem necessidade de configurar uma chave de API; a Genspark anuncia modelos abertos «a 1/10 a 1/20 do custo». O GenCode importa numa única etapa as instruções, regras e memória criadas para o Claude Code. O README do pacote npm @genspark/gencode esclarece a sua origem: deriva do opencode, o agente de programação open source, mas continua a ser um produto proprietário sem ligação ao projeto, com o qual partilha deliberadamente a pasta .opencode/ dos repositórios. O custo é apresentado em créditos Genspark a cada etapa.
🔗 GenCode · Anúncio da Genspark no X
GitHub Copilot: aprovações assistidas e ambiente isolado local
Copilot para JetBrains 1.18.0
22 de setembro — A versão 1.18.0 do Copilot para os IDE JetBrains introduz, em pré-visualização pública, as aprovações assistidas (assisted approvals): nas sessões de agentes, as chamadas de ferramentas consideradas de baixo risco são aprovadas automaticamente, enquanto as ações mais arriscadas continuam a exigir uma decisão. Também é possível editar novamente uma mensagem anterior: o Copilot recua então a conversa e as alterações aos ficheiros antes de enviar a nova instrução. O agente Codex, disponível no Copilot para JetBrains, passa a ter um modo de planeamento para rever, aperfeiçoar ou aprovar a abordagem antes de qualquer alteração, e as sessões aceitam skills e instruções da organização e da empresa. O servidor MCP GitHub integrado, ativo por predefinição, pode agora ser desativado. Os utilizadores de um IDE JetBrains 2025.1 receberão um aviso a convidá-los a atualizar para a versão 2026.1 ou posterior.
🔗 Novidades do Copilot para JetBrains
A aplicação Copilot isola as suas sessões locais
23 de setembro — A aplicação GitHub Copilot, a aplicação de computador da GitHub dedicada aos seus agentes, recebe um ambiente isolado local em pré-visualização pública. Configurado projeto a projeto, limita aquilo a que os comandos de uma sessão local podem aceder: o sistema de ficheiros (pastas com leitura e escrita, só de leitura ou interditas), a rede (acesso de saída à internet e à rede local) e as credenciais (Git por HTTPS, GitHub CLI). As definições geridas pela empresa podem tornar a política mais restritiva. Se o sistema operativo não conseguir aplicar a política pedida, o shell do ambiente isolado termina com um erro em vez de ser executado sem proteção. Desativado por predefinição, o ambiente isolado pode ser ativado para as novas sessões do projeto ou, com /sandbox on, para uma sessão em curso; não abrange sessões na cloud nem anfitriões remotos, e as suas definições são distintas das do Copilot CLI.
🔗 Ambiente isolado local na aplicação GitHub Copilot
Cursor: dois bots para a entrada em produção, menos 7 % de tokens
Rollouts e Security Review
23 de setembro — A Cursor lança dois bots dedicados à «última etapa» da entrega de código, disponíveis nos planos Teams e Enterprise. Quando cada pull request é aberta, o Rollouts publica um plano de monitorização (riscos, efeito esperado, sinais a verificar). Depois, compara esse plano com os logs, as métricas e os rastos após cada implementação e emite um veredito por ambiente: saudável, regressão detetada ou inconclusivo. Em caso de regressão, identifica a alteração suspeita e pode abrir uma PR de reversão sujeita a aprovação, sem fazer merge nem reverter nada por si só. O Security Review analisa cada pull request e assinala vulnerabilidades exploráveis (injeções, formas de contornar a autenticação, segredos deixados no código, SSRF…), indicando para cada uma a gravidade, o percurso de ataque e uma correção proposta. Durante 10 dias, créditos de teste permitem experimentar o Rollouts em cerca de 50 alterações no plano Teams e 500 no Enterprise.
🔗 Registo de alterações da Cursor
Menos 7 % de custo em tokens, sem perda de qualidade
23 de setembro — A Cursor explica como reduziu em 7 % o custo em tokens do seu agente para os utilizadores, sem perda de qualidade. Como os modelos recentes já não precisam de longas listas de proibições, o prompt de sistema foi reduzido em cerca de 66 %, com os cortes validados por testes A/B em tráfego real. As ferramentas integradas, cuja maioria é usada em menos de 20 % das conversas, passaram a ser carregadas a pedido.
| Medida de otimização | Efeito medido pela Cursor |
|---|---|
| Prompt de sistema reduzido | cerca de 66 % do prompt removido |
| Ferramentas integradas carregadas a pedido | -60 % de tokens de descrição no contexto estático |
| Pontos de paragem da cache explícitos | -20 % de falhas da cache a frio |
| Um número de linha a cada dez linhas | -1,6 % de tokens lidos a partir da cache |
| Conjunto das alterações | -7 % de custo em tokens para os utilizadores |
NVIDIA: diarização aberta e AI Day Singapore
Nemotron 3 Diarization distingue até oito intervenientes
23 de setembro — A NVIDIA publica no Hugging Face o Nemotron 3 Diarization, um modelo de pesos abertos com 100 milhões de parâmetros que determina quem fala e quando numa conversa, mesmo quando as vozes se sobrepõem. Acompanha até oito intervenientes, contra quatro do seu antecessor, o Streaming Sortformer, e funciona tanto em processamento diferido como em fluxo contínuo, com uma latência de buffer ajustável entre 30,4 e 0,32 segundos. Não transcreve as palavras: fornece intervalos de tempo por interveniente, a combinar com um modelo de transcrição. Nos primeiros resultados do Diarization-Bench da VoiceArena, ocupa o primeiro lugar entre 12 sistemas, com 14,72 % de erro de diarização, contra 19,3 % do seguinte; segundo a NVIDIA, esta classificação inicial ainda pode mudar. Face ao modelo anterior, o erro diminui em média 41 % em oito conjuntos de avaliação, com um ligeiro recuo nas conversas com dois intervenientes do CALLHOME. Licença OpenMDW 1.1.
| Métrica publicada | Nemotron 3 Diarization | Modelo anterior |
|---|---|---|
| Número máximo de intervenientes acompanhados | 8 | 4 |
| Débito a 30,4 s (lotes de 32, RTX PRO 5000) | 15 113 vezes o tempo real | 2 619 vezes |
| Erro no DIHARD III a 30,4 s | 12,73 % | 19,09 % |
🔗 Nemotron 3 Diarization no blog do Hugging Face
AI Day Singapore: Vera Rubin e Nemotron no Sudeste Asiático
22 de setembro — Num artigo publicado no dia 22 às 19h30 PT, durante o AI Day Singapore (22 e 23 de setembro), a NVIDIA apresenta a Sea Limited, empresa-mãe da Shopee, Garena e Monee, como a primeira empresa da região ASEAN a adotar a sua plataforma Vera Rubin para desenvolver e implementar modelos e agentes em maior escala. O restante artigo mostra adaptações locais dos modelos abertos Nemotron: a AI Singapore expande a sua família SEA-LION, dedicada às línguas da região, com modelos Nemotron; no Vietname, a Viettel AI ajustou o Nemotron 3 Super para vietnamita, alcançando o primeiro lugar no benchmark VMLU; na Tailândia, a iApp Technology adaptou o Nemotron 3 Nano ao direito tailandês com o OpenThai 2.0 Legal, publicado em open source, que alimenta o chatbot jurídico Thanoy e os seus cerca de 43 000 utilizadores.
🔗 No AI Day Singapore, a NVIDIA e os parceiros apresentam avanços da IA no Sudeste Asiático
Colocar a IA em produção sem problemas
Duas notícias partilham a mesma ideia: validar com cargas de trabalho reais antes de transferir tráfego ou atualizar máquinas.
As implementações canary da Together AI
22 de setembro — A Together AI detalha as implementações progressivas da sua oferta Dedicated Model Inference, disponíveis desde a atualização de 15 de setembro: permitem mudar o modelo servido por um endpoint sem interrupção nem alteração do URL. São propostas três estratégias: a canary aumenta o tráfego do novo modelo por etapas (5 %, 25 %, 50 % e depois 100 % por predefinição), a blue-green transfere todo o tráfego de uma só vez e a substituição progressiva troca as réplicas uma a uma. Após cada etapa da canary, uma verificação compara a latência ou a taxa de erro com as do modelo anterior e pausa a implementação se piorarem. Na demonstração publicada, a passagem do Qwen2.5-7B para o Qwen3.5-9B é interrompida logo aos 10 % do tráfego devido a um aumento de 137 % na latência p95 (1 740 ms contra 734 ms); o regresso ao modelo anterior ocorreu sem falhas em nenhum dos 6 800 pedidos processados.
🔗 Implementações canary: atualizar modelos em produção sem interrupções
NVCRE e NodeWright da NVIDIA
23 de setembro — A NVIDIA detalha dois projetos open source (Apache 2.0) do DSX OS, a camada de software da sua plataforma de fábricas de IA, destinados a clusters de GPU com Kubernetes. O NVIDIA Cluster Readiness Engine (NVCRE) parte de uma constatação: um cluster pode passar em todas as verificações de integridade e, ainda assim, falhar numa tarefa de treino distribuído. Por isso, certifica-o com cargas de trabalho reais (testes de comunicação NCCL, diagnósticos DCGM, pré-treino NeMo) em grupos de nós escolhidos segundo a topologia, identifica os nós responsáveis e, em modo de diagnóstico, divide sucessivamente em dois os grupos com falhas até isolar os suspeitos. Entre essas cargas, o artigo menciona modelos Nemotron 5 de 8 e 56 mil milhões de parâmetros, sem mais pormenores. O NodeWright, anteriormente chamado Skyhook e usado em produção pela NVIDIA, atualiza o sistema dos nós (definições do kernel, agentes de segurança, correções de vulnerabilidades) depois de terminarem as tarefas protegidas. As atualizações decorrem em vagas fixas, lineares ou exponenciais que param automaticamente se demasiados lotes falharem.
🔗 Validar a preparação dos clusters de GPU antes de receberem cargas de trabalho de IA · NodeWright
Dois conjuntos de dados abertos: conversas com várias vozes e corpus científico
Basis Conversations 1500
23 de setembro — A Basis publica no Hugging Face o Basis Conversations 1500: 1 502 horas de conversas espontâneas entre 2 645 pessoas de 33 países, em 22 línguas, do inglês ao mingreliano e ao xhosa. Cada conversa reúne duas a quatro pessoas, cada uma gravada na sua própria pista sincronizada (FLAC 48 kHz), permitindo estudar sobreposições, interrupções e alternâncias de fala, fenómenos com que os modelos ainda têm dificuldades, segundo a equipa. Cerca de 100 horas foram anotadas em detalhe por humanos (113 096 avaliações): respostas vocais compassivas ou irritadas, silêncios embaraçosos, sobreposições cooperativas ou competitivas. As transcrições fornecidas são automáticas e não devem ser usadas como dados de referência para treino sem verificação. O artigo apresenta o conjunto como disponível para uso comercial e de investigação, mas este está sujeito a uma licença própria da Basis (basis-data-license-1.0), com acesso aprovado manualmente.
QVAC Genesis III
23 de setembro — A Tether AI Research publica o QVAC Genesis III, a terceira parte do seu corpus sintético destinado ao pré-treino de pequenos modelos em ciências, tecnologia, engenharia e matemática. Com mais 43,06 mil milhões de tokens, o conjunto atinge 191,43 mil milhões de tokens e cerca de 160 milhões de documentos em 19 áreas; o artigo que o acompanha foi aceite na conferência COLM 2026. O método interroga um pequeno modelo aluno, Qwen3-1.7B-Base: uma resposta errada dá origem a uma explicação corretiva; uma resposta certa, a uma análise de cada opção de resposta. Treinado de raiz com este corpus, um modelo de 1,7 mil milhões de parâmetros apresenta progressos claros face ao mesmo modelo treinado com Cosmopedia-v2, com o mesmo orçamento de tokens. O corpus é publicado sob uma licença não comercial (CC-BY-NC 4.0), e foi anunciado um modelo treinado com ele sob a licença Apache 2.0.
| Benchmark avaliado | Ganho face ao Cosmopedia-v2 (mesmo orçamento de tokens) |
|---|---|
| ARC-Easy | +28,57 pontos |
| ARC-Challenge | +21,35 pontos |
| GPQA Diamond | +2,52 pontos |
| MMLU STEM | +15,03 pontos |
A IA para o clima e a alimentação
Ai2 e Global Fishing Watch monitorizam os oceanos com agentes
23 de setembro — Na Climate Week de Nova Iorque, a Ai2 e a Global Fishing Watch anunciam uma parceria para aplicar a IA, em particular agentes, à monitorização dos oceanos e à fiscalização das pescas. As duas organizações já colaboravam; agora passam ao desenvolvimento conjunto: um pipeline comum de deteção, novos modelos de visão em tempo real aplicados a imagens de satélite e agentes capazes de cruzar várias fontes de dados. A Global Fishing Watch terá acesso ao OlmoEarth, a plataforma de observação da Terra da Ai2 baseada em modelos abertos, para anotar os seus dados e treinar os seus próprios modelos. As deteções de embarcações em tempo real do Skylight passarão a estar disponíveis no seu portal para gestores de áreas marinhas, e as duas equipas desenvolverão agentes como o Shippy, ao qual um analista pode pedir o histórico de uma embarcação. O anúncio não inclui calendário nem montantes.
🔗 Ai2 e Global Fishing Watch unem-se para levar agentes de IA à monitorização dos oceanos
Google.org e Gates Foundation, para 200 milhões de pequenos agricultores
18 e 22 de setembro — Em retrospetiva: a Google.org e a Gates Foundation alargam a sua iniciativa conjunta para disponibilizar ferramentas de IA nas áreas do clima, da agricultura e das línguas a 200 milhões de pequenos agricultores na África subsaariana e no Sul da Ásia, face aos 50 milhões inicialmente previstos. Os dois parceiros destinam-lhe um financiamento conjunto de 100 milhões de dólares, com apoio técnico de investigadores e engenheiros da Google. O comunicado da Gates Foundation é de 18 de setembro; o blog.google divulgou-o na noite de 22. O programa financia organizações locais como a Wadhwani AI e a Digital Green na Índia, integra previsões baseadas em IA na plataforma climática TomorrowNow, cartografa parcelas com resolução inferior a um metro e apoia conjuntos de dados abertos de voz e texto em mais de 40 línguas africanas. Os pequenos agricultores produzem cerca de 35 % dos alimentos do mundo.
🔗 Anúncio da Google.org · Comunicado da Gates Foundation
Breves
- Anthropic, modernização de código — Na série « Notes from the Field », dois engenheiros da Anthropic destacados para trabalhar com clientes, Jonah Ezekiel e Lexie Tonelli, propõem seis etapas para preparar uma modernização de código conduzida por agentes: definir o objetivo, criar um « certificado » de testes, fazer revisões humanas por etapas, estabelecer pré-requisitos, organizar o fluxo de trabalho dos agentes e, por fim, iniciar o projeto. Não apresentam valores de custo: recomendam medi-los num projeto piloto. 🔗 fonte
- Boris Cherny verifica o Claude Agent SDK em Lean — Na noite do dia 22, Boris Cherny (Claude Code) contou que fez o Opus 5.5 verificar formalmente o Claude Agent SDK com o assistente de provas Lean: alguns prompts curtos produziram 16 pull requests que corrigem bugs e condições de concorrência. Diz que também utiliza TLA+. 🔗 fonte
- Codex CLI 0.156.1 — Esta correção da versão 0.156.0 acrescenta GPT-6 Sol e GPT-6 Luna ao seletor de modelos do CLI; a mensagem apresentada quando se atinge o limite de pedidos passa a recomendar Luna, e são propostas migrações a partir de GPT-5.5 e GPT-5.6. 🔗 fonte
- Airbnb e GPT-6 Astra — Um novo acordo alarga o acesso das equipas de engenharia e produto da Airbnb aos modelos da OpenAI, incluindo GPT-6 Astra, através da API da OpenAI e do Amazon Bedrock. O seu diretor de tecnologia, Ahmad Al-Dahle, afirma que as equipas entregam cerca de 80 % mais funcionalidades do que há um ano; não foi divulgado qualquer montante. 🔗 fonte
- OpenAI Academy faz dois anos — Mais de 250 eventos e mais de 4 milhões de pessoas alcançadas desde setembro de 2024; a OpenAI está a testar um programa de formadores comunitários (Community Trainer Program) em que funcionários de organizações parceiras aprendem a conduzir workshops, após uma avaliação. 🔗 fonte
- Um painel LED transformado em assistente de voz — No blogue OpenAI Developers, Sid Rampally conta como o Codex o ajudou a ligar e programar um painel LED de 128 × 64 píxeis controlado por um Raspberry Pi; GPT-Live-1 conduz a conversa e delega as pesquisas e a apresentação no painel a GPT-5.6 Luna através da Responses API. 🔗 fonte
- MedGemma ultrapassa 10 milhões de downloads — A Google descreve utilizações no terreno dos seus modelos médicos abertos: rastreio do cancro do colo do útero em mais de 3 500 mulheres na Zâmbia, projetos piloto no hospital AIIMS de Deli e deteção da tuberculose na Indonésia. A Google recorda que as respostas dos modelos não devem orientar diretamente um diagnóstico. 🔗 fonte
- Gemini Notebook no Google Docs — Ao escrever @ no Docs, é possível citar um notebook como fonte: o Gemini fundamenta o texto nessas fontes, com citações no próprio texto, e combina-as com e-mails e ficheiros através do Workspace Intelligence. Disponível para Business Standard e Plus, Enterprise Standard e Plus, Education Plus e subscritores do Google AI Pro e Ultra. 🔗 fonte
- Seis ferramentas Google Flow — O Google Labs publica seis ferramentas criadas por profissionais criativos com Google Flow Tools: Mondo Sónico (efeitos sonoros sincronizados), CaptionCast (legendas animadas), ThumbnailForge (miniaturas), Surface (texturas em superfícies 3D), CollageMotion Pro e SwissFlow Studio (motion design); todas podem ser duplicadas e adaptadas. 🔗 fonte
- Google Beam chega a França — Beam, a plataforma de comunicação por vídeo da Google que procura recriar a sensação de presença frente a frente e é vendida com a HP, já é fornecida em seis países, incluindo França, com 18 parceiros. Um estudo interno indica que as equipas se sentem 50 % mais ligadas e realizam menos 21 % de reuniões de acompanhamento. 🔗 fonte
- Android Enterprise e os agentes Gemini — O Gemini pode executar tarefas entre aplicações a partir do contexto apresentado no ecrã, enquanto medidas de proteção impedem os agentes pessoais de aceder ao perfil profissional; os administradores podem restringir ou desativar a automação por IA em toda a sua frota de dispositivos. 🔗 fonte
- AI Brief em francês — A versão beta fechada do AI Brief, que permite orientar as campanhas AI Max do Google Ads com palavras próprias, passa a estar disponível em francês, neerlandês, alemão, italiano, japonês, português e espanhol. 🔗 fonte
- Gemini CLI, versão nightly de 23 de setembro — Trata-se apenas de uma versão nightly, não de uma versão estável: acrescenta Gemini 3.8 Flash e Gemini 3.5 Flash Lite, acessíveis desde já por chave de API, Vertex AI ou gateway, e mediante a ativação de funcionalidades experimentais com uma conta Google. Não foi lançada nenhuma versão estável na terça-feira, dia 22. 🔗 fonte
- EcoHash mede as suas otimizações de vídeo — Numa RTX PRO 6000 de 96 GB, a EcoHash reduz o tempo de geração de um vídeo MiniMax H3 de 174,8 para 40,8 segundos e o de um vídeo Wan2.2 gerado a partir de texto de 132,3 para 10,7 segundos, com uma LoRA destilada em 4 etapas; três das dez configurações testadas, incluindo os dois modos de compilação, não tiveram qualquer efeito. 🔗 fonte
- Tártaro da Crimeia, um teste enviesado evitado — O criador de um modelo de reconhecimento de voz para o tártaro da Crimeia descobriu que quatro audiolivros apareciam duas vezes no seu corpus: 96,9 % dos excertos do teste principal tinham um duplicado nos dados de treino. Depois da correção, de um ajuste fino com LoRA e da configuração do descodificador, a taxa de erro por palavra passou de 0,3463 para 0,1701. 🔗 fonte
- Falcon-H1 e mlx-lm — No mlx-lm 0.31.3, sem cache KV, apenas a primeira das 66 camadas do Falcon-H1 é executada durante o treino: qualquer LoRA é treinada, sem erro nem aviso, sobre um modelo de uma só camada. A correção cabe numa linha, e foi aberta uma issue. 🔗 fonte
- Agentes e contribuições open source — Quentin Gallouédec (Hugging Face) considera que as contribuições produzidas por agentes eliminam o sinal de uma necessidade real e consomem o tempo dos responsáveis pela manutenção na revisão; pede que deixem de lançar agentes sobre projetos escolhidos ao acaso e comecem por utilizar o projeto. 🔗 fonte
- Phionyx na IETF — O autor de Phionyx apresenta um rascunho individual, Claim-Preserving Exchange of AI Evaluation Evidence, para que um resultado de avaliação mantenha as suas condições e limitações ao passar de um sistema para outro; o texto não foi adotado por nenhum grupo de trabalho. 🔗 fonte
- Kimi Work 3.2.12 — O agente de desktop da Moonshot permite selecionar uma passagem num ficheiro PPT, Excel, Word ou Markdown para a alterar de forma precisa; deixa de haver um limite para o tamanho dos anexos. 🔗 fonte
- Qwen-Image-2.1 lidera entre os modelos abertos — Segundo a Arena, Qwen-Image-2.1 torna-se o primeiro modelo aberto na edição de imagens (1 367 pontos, 16.º na classificação geral) e na geração de imagens a partir de texto (1 228 pontos, 17.º na classificação geral). 🔗 fonte
- OpenTelemetry na aplicação Copilot — Os administradores podem exportar os rastos das sessões de agentes da aplicação GitHub Copilot (pedidos aos modelos, ferramentas utilizadas) para as suas ferramentas de monitorização através da propriedade
telemetrydemanaged-settings.json; o conteúdo dos prompts e das respostas é excluído por predefinição. 🔗 fonte - Copilot CLI e C++ — O Microsoft C++ Language Server do Copilot CLI cria agora um índice persistente dos símbolos de todo o projeto, ativado por predefinição; a criação inicial pode ser demorada e consumir muita memória, e o GitHub não quantifica o ganho. 🔗 fonte
- Uma pull request de um milhão de linhas — Um artigo de engenharia do GitHub explica como a aplicação Copilot apresenta uma pull request com 2 200 ficheiros, mais de um milhão de linhas e mais de 400 comentários, separando a geometria do código, calculada antecipadamente, da geometria dos comentários, medida perto da área visível. 🔗 fonte
- Genspark acrescenta Opus 5.5, GPT-6 e Grok 4.7 — Na noite do dia 23, a Genspark disponibiliza Claude Opus 5.5, Grok 4.7, GPT-6 Sol e GPT-6 Luna no AI Chat, Code Agent e Claw, reproduzindo os argumentos dos fornecedores, sem especificar planos nem preços. 🔗 fonte
- Inquérito do GitHub e de Yale — Entre 1 039 utilizadores do GitHub nos Estados Unidos, 71 % dizem estar preocupados com o impacto ambiental da IA e oito em cada dez querem ferramentas para escrever código mais eficiente em termos energéticos; o GitHub esclarece que a amostra, composta por pessoas que aceitaram receber as suas comunicações de marketing, não é representativa. 🔗 fonte
- Zed 1.21.0 — A versão estável disponibiliza Claude Opus 5.5 e GPT-6 Astra, Sol e Luna com uma chave de API própria, acrescenta o início de sessão com SuperGrok no painel Agent e impede, por predefinição, que o computador entre em suspensão enquanto um agente trabalha. 🔗 fonte
- Warp — GPT-6 Sol e Luna, seguidos de Claude Opus 5.5, chegam ao terminal Warp e ao Warp Agent CLI, tal como Grok 4.7 para quem ligar a sua subscrição Grok; é apenas um anúncio de disponibilidade, sem indicação de preços. 🔗 fonte
- Devin no Microsoft Teams — Devin, até agora limitado aos canais, passa a responder em mensagens diretas e conversas de grupo, a iniciar Automations a partir de um canal e a enviar cartões com perguntas ou pedidos de aprovação; a aplicação não pede novas permissões. 🔗 fonte
- Scribe v2 Medical — Disponível desde 11 de setembro, o modelo de transcrição clínica da ElevenLabs recebe o seu anúncio oficial, com um dado novo: menos 35 % de erros por palavra em áudio clínico face ao Scribe v2. O preço começa nos 0,22 dólares por hora. 🔗 fonte
- Sora 2 sai da ElevenLabs — A ElevenLabs retira Sora 2 e Sora 2 Pro do seu estúdio porque a OpenAI encerra a API Sora a 24 de setembro, um prazo anunciado pela OpenAI a 24 de março; os fluxos de trabalho afetados têm de passar para outro modelo de vídeo, como Gemini Omni 1.1 Flash. 🔗 fonte
- Cohere Model Vault no Canadá — A Cohere anuncia que Model Vault, a sua plataforma de inferência dedicada a um único cliente, está disponível no Canadá, sem indicar a região de cloud, o fornecedor ou os preços; a página do produto ainda não menciona o Canadá. 🔗 fonte
- Cohere e a gestão da mudança — Num artigo, Katherine Correia (Cohere) sugere integrar a IA como participante, em vez de a tratar como uma simples ferramenta, classificar as tarefas como verificáveis, dependentes de julgamento ou híbridas e definir a governação por caso de utilização; não apresenta produtos nem números. 🔗 fonte
O que isto significa
O resultado da Anthropic leva os agentes de programação para a biologia fundamental. Cerca de 950 agentes Claude analisaram mais de 200 000 transcriptases reversas em 21 horas, e os humanos só intervieram no início, com um prompt, e no fim, para realizar as experiências. O principal entrave passa a ser a seleção das hipóteses, que a Anthropic estuda agora como tema de investigação. É preciso manter a cautela: a função de ART é desconhecida e, por enquanto, o resultado assume a forma de um pré-print. A mesma lógica de mobilizar muitos agentes e orientar o seu trabalho por métricas surge no sprint que acelerou o claude.ai, com mais de 3 000 alterações, e na verificação formal do Claude Agent SDK em Lean.
A segurança dos ambientes isolados dos agentes torna-se um tema público. A auditoria da Perplexity distingue duas barreiras: o isolamento da máquina virtual resistiu às 108 tentativas, mas a filtragem de rede falhou 11 vezes em 54 perante modelos que exploraram uma validação deficiente do DNS ou os endereços partilhados de uma CDN; 8 em cada 10 plataformas de terceiros apresentavam pelo menos uma forma de contornar as proteções. Dois modelos, Fable e GPT-6 Astra, recusaram participar no exercício. No mesmo dia, a aplicação GitHub Copilot disponibiliza um ambiente isolado local que interrompe a execução se não conseguir garantir a proteção, o modo auto do Claude Code submete até os comandos de leitura ao classificador, e Vibe CLI e Kimi Code corrigem formas de contornar as autorizações; dois dias antes, a ZCode tinha aberto o seu código após problemas assinalados pela comunidade.
A voz torna-se uma interface para agir. Gemini 3.8 Flash TTS e Flash-Lite TTS tornam a geração de áudio mais de duas vezes mais barata do que na versão de pré-visualização anterior (9 e 6 dólares por milhão de tokens até ao fim de 2026, face a 20) e acrescentam replicação de voz sujeita a consentimento gravado, indisponível no Espaço Económico Europeu através do AI Studio. A Qwen anuncia reduções de 70 a 95 % nos preços da sua gama de modelos de áudio, a NVIDIA disponibiliza um modelo que distingue oito oradores e a Basis publica 1 500 horas de conversas com vozes sobrepostas. Entretanto, o ChatGPT Voice passa da conversa à ação, com os plugins e as tarefas do ChatGPT Work.
Por fim, a IA aplicada ao mundo físico torna-se mais aberta, com algumas ressalvas. FLUX 3 Action coloca um modelo de 7 mil milhões de parâmetros no topo do RoboLab-120, integra-o no LeRobot com a NVIDIA e mostra que uma política rápida e fiável reduz a necessidade de raciocínio dispendioso: 8,77 dólares por sucesso com GPT-6 Astra como supervisor, face a 13,47 dólares com Astra sozinho. Mas « aberto » abrange realidades diferentes: uma licença própria para FLUX 3 Action e para Basis Conversations 1500, uma licença não comercial para QVAC Genesis III e benchmarks publicados sem os pesos para Qwen Intelligence. Para quem pretende reutilizar estes recursos, a licença é tão importante como a pontuação.
Fontes
- Claude descobre um novo sistema enzimático com repetições semelhantes às do CRISPR (Anthropic)
- Pré-publicação ART (PDF, Anthropic)
- @AnthropicAI: o sistema enzimático descoberto por Claude
- Gemini 3.8 Flash TTS e Flash-Lite TTS (Google)
- Notas de lançamento da API Gemini, 22 de setembro
- Preços da API Gemini
- FLUX 3 Action (Black Forest Labs)
- @bfl_ai: lançamento do FLUX 3 Action
- Coleção FLUX 3 Action no Hugging Face
- Escapando do SPACE, Parte I (Perplexity)
- Claude Code v2.1.281
- Como tornámos o claude.ai 3 vezes mais rápido em duas semanas (claude.dev)
- Claude Marketplace (Anthropic)
- @OpenAI: ChatGPT Voice com plugins e no ChatGPT Work
- Artigo de ajuda do ChatGPT Voice
- Notas de lançamento do ChatGPT
- Apresentação do MentalHealthBench (OpenAI)
- SWE-Serve (NVIDIA)
- Repositório NVIDIA/swe-serve
- Runway agora no DaVinci Resolve
- Gemini Omni 1.1 Flash no Google Vids
- Made On YouTube 2026
- Resumo do Made On YouTube 2026 (Google)
- Novas aplicações ligadas ao Gemini
- @GeminiApp: 13 novas aplicações ligadas
- @Muse: quatro conectores a chegar
- @ElevenLabs: ElevenLabs chega ao Muse
- @HeyGen: HeyGen junta-se ao Muse
- @grok: Grok Bot nos Tesla
- @Tesla: Grok e os Connectors
- @bot: Grok Bot ligado ao Google Slides, Sheets e Docs
- Modelos locais no SDK Antigravity (Google Developers)
- Registo de alterações do Antigravity
- Memória persistente para o Private AI Compute (Google DeepMind)
- @Alibaba_Qwen: Qwen Intelligence
- Relatório Qwen-Planner-Agent
- @Alibaba_Qwen: Qwen-Audio-3.1
- Qwen-Audio-3.1-Realtime no QwenCloud
- Notas de lançamento da Mistral
- Vibe CLI 2.25.8
- @zcode_ai: disponibilização do código do ZCode
- Repositório zai-org/ZCode
- Kimi Code 2.1.0
- DeepSeek Harness v0.1.7-rc.1
- GenCode (Genspark)
- @genspark_ai: lançamento do GenCode
- Copilot para JetBrains 1.18.0 (registo de alterações do GitHub)
- Ambiente isolado local na aplicação GitHub Copilot (registo de alterações do GitHub)
- Rollouts e Security Review (registo de alterações do Cursor)
- Maior eficiência no uso de tokens (Cursor)
- Nemotron 3 Diarization (NVIDIA, blogue do Hugging Face)
- AI Day Singapore (NVIDIA)
- Lançamentos canário (Together AI)
- NVIDIA Cluster Readiness Engine (NVIDIA)
- NodeWright (NVIDIA)
- Basis Conversations 1500 (blogue do Hugging Face)
- QVAC Genesis III (blogue do Hugging Face)
- Ai2 e Global Fishing Watch (Skylight)
- Google.org e a Gates Foundation (blog.google)
- Comunicado da Gates Foundation
- Como preparar projetos de modernização de código com IA (Anthropic)
- @bcherny: verificação formal do Claude Agent SDK em Lean
- Codex CLI 0.156.1
- Airbnb e GPT-6 Astra (OpenAI)
- Dois anos da OpenAI Academy
- Como dei vida ao meu ecrã LED (OpenAI Developers)
- MedGemma e a saúde mundial (Google)
- Gemini Notebook no Google Docs (Workspace Updates)
- Seis ferramentas do Google Flow (Google Labs)
- Google Beam expande-se a seis países (Google)
- Novidades do Android Enterprise 2026 (Google)
- AI Brief e AI Max (Google Ads)
- Gemini CLI v0.62.0-nightly.20260923
- Três em cada dez otimizações não tiveram efeito (EcoHash)
- Reconhecimento de voz em tártaro da Crimeia (blogue do Hugging Face)
- Ajuste fino do Falcon-H1 num Mac (blogue do Hugging Face)
- O caminho para o inferno do código aberto está cheio de boas intenções (blogue do Hugging Face)
- O painel indica PASS. O que passou, exatamente? (Phionyx)
- Notas de lançamento do Kimi Work
- @arena: Qwen-Image-2.1, primeiro modelo aberto
- OpenTelemetry na aplicação GitHub Copilot
- Inteligência de código C++ no Copilot CLI
- Apresentação de pedidos de integração enormes na aplicação GitHub Copilot
- @genspark_ai: Claude Opus 5.5 no Genspark
- Estudo do GitHub e de Yale sobre a eficiência no desenvolvimento de software
- Zed 1.21.0
- @warpdotdev: GPT-6 Sol e Luna no Warp
- Devin, Microsoft Teams e Microsoft 365
- @ElevenLabs: Scribe v2 Medical
- Registo de alterações da ElevenLabs de 23 de setembro
- @cohere: Model Vault no Canadá
- Gestão da mudança associada à IA (Cohere)