ai-powered-markdown-translatorArtikel mit gpt-6-sol aus dem Französischen ins Deutsche übersetzt.
Am 23. September stellt Anthropic sein molekularbiologisches Labor und dessen erstes Ergebnis vor: ART, ein bislang unbekanntes Enzymsystem, das rund 950 Claude-Agenten in der DNA von Bakteriophagen aufgespürt haben. Google stellt Gemini 3.8 Flash TTS und Flash-Lite TTS vor, zwei Sprachsynthesemodelle, die Stimmen erzeugen und klonen können. Black Forest Labs veröffentlicht FLUX 3 Action, ein Modell mit offenen Gewichten zur Steuerung von Robotern, und Perplexity veröffentlicht das erste Sicherheitsaudit von SPACE, der Sandbox, in der seine Agenten laufen.
Anthropic eröffnet ein molekularbiologisches Labor, in dem Claude ART entdeckt
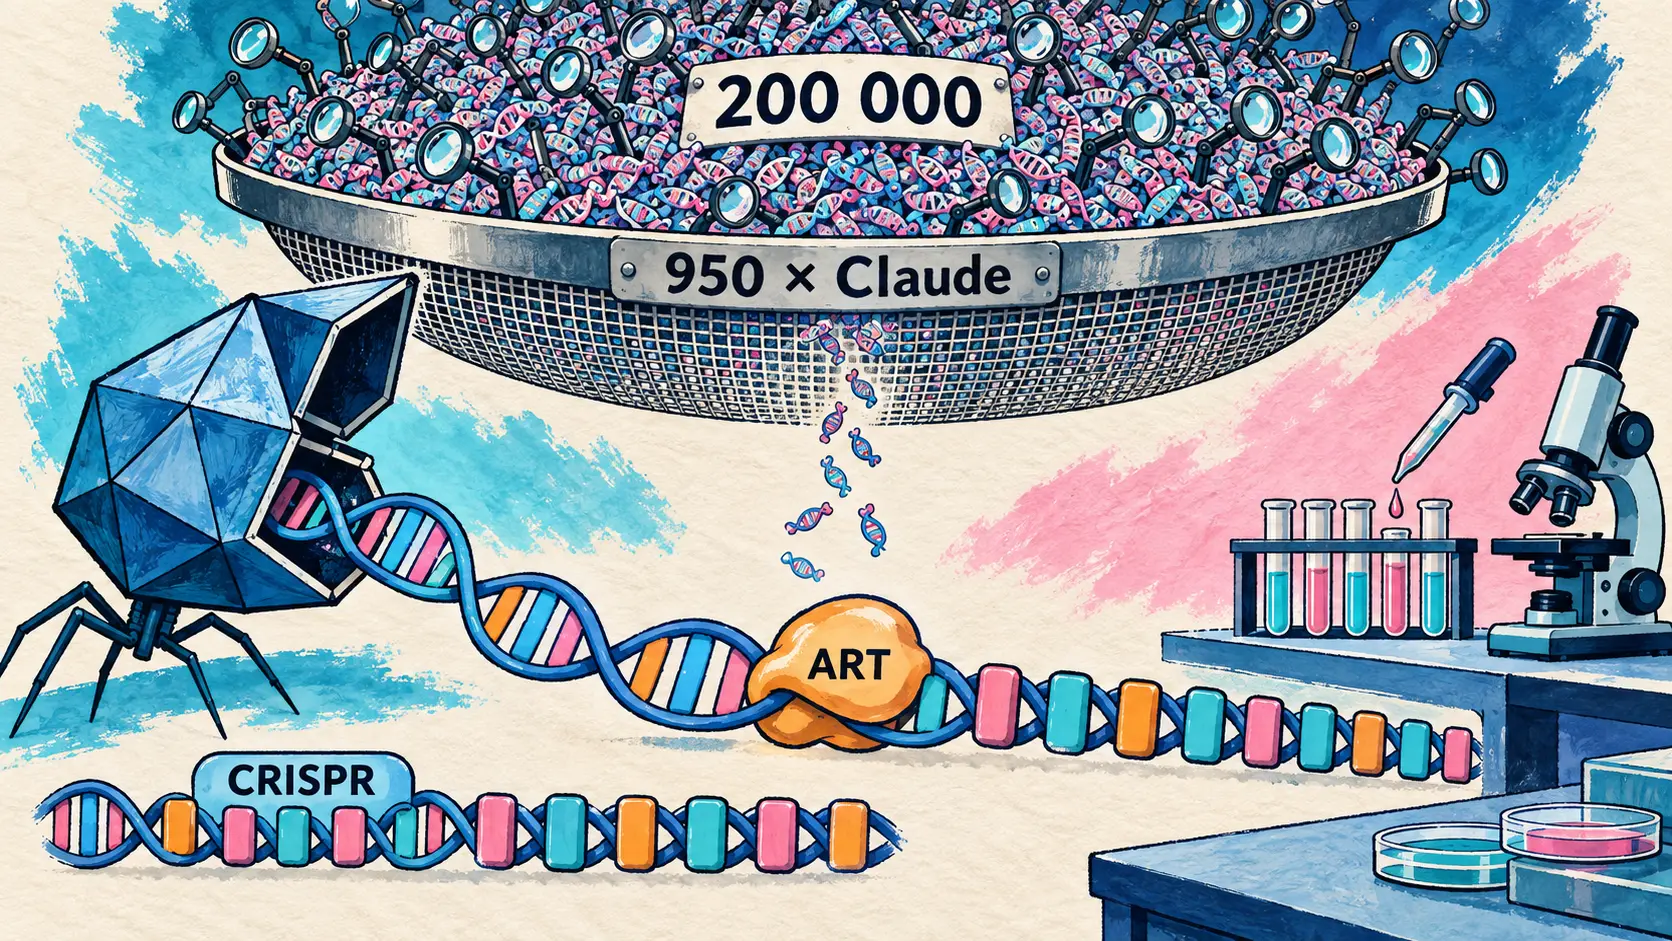
23. September — Anthropic stellt eine neue Forschungsgruppe für Biowissenschaften mit eigenem molekularbiologischem Labor vor. Die Gruppe wurde im Frühjahr gegründet und hat ihren Sitz in der San Francisco Bay Area. Ihr erstes Ergebnis: Claude-Agenten haben in der DNA von Bakteriophagen, also Viren, die Bakterien infizieren, ein nie zuvor beschriebenes Enzymsystem entdeckt. Anthropic hat es ART genannt (array-associated reverse transcriptases, mit einer Sequenzanordnung assoziierte reverse Transkriptasen).
Ausgangspunkt war ein Prompt: In einer großen Datenbank mit DNA-Sequenzen sollten neue Beispiele für reverse Transkriptasen gesucht werden, also Enzyme, die RNA in DNA umschreiben. Innerhalb von 21 Stunden verarbeiteten rund 950 Agenten 210 Millionen Tokens, trugen mehr als 200.000 reverse Transkriptasen zusammen, isolierten 3.500 neuartige Kandidatensysteme und wählten die 20 vielversprechendsten aus. Zu jedem erstellten sie einen für Menschen lesbaren Bericht. Laut Anthropic würde eine solche Analyse einen Experten Wochen oder sogar Monate kosten; menschliche Eingriffe beschränkten sich auf den ursprünglichen Prompt und die Laborexperimente.
| Schritt der Untersuchung | Gemessener Wert |
|---|---|
| Dauer der Recherche | 21 Stunden |
| Eingesetzte Claude-Agenten | etwa 950 |
| Verbrauchte Tokens | 210 Millionen |
| Zusammengetragene reverse Transkriptasen | mehr als 200.000 |
| Neue Kandidatensysteme | 3.500 |
| Ausgewählte und analysierte Kandidaten | 20 |
ART besteht aus drei Elementen: der reversen Transkriptase, einem benachbarten Partnergen mit unbekannter Funktion und einer langen Anordnung regelmäßig angeordneter, wiederholter DNA-Sequenzen, deren Aufbau an CRISPR erinnert. Die reverse Transkriptase selbst, die in einem Riesenphagen gefunden wurde, war bereits bekannt. Claude „scheint der Erste zu sein“, der laut Anthropic die nichtkodierende Sequenzanordnung und das dazugehörige Protein bemerkt hat. Erste Experimente zeigen, dass die Anordnung als einzelne kleine RNA-Moleküle exprimiert wird. Anthropic bleibt vorsichtig: Die Funktion von ART ist noch unbekannt, und weitere Experimente laufen. Nach Angaben des Unternehmens weisen nur wenige bekannte Systeme diese Merkmale auf; sie alle sind programmierbar und können DNA schneiden, kopieren und einfügen.
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR.
🇩🇪 Claude hat ein bislang unbekanntes Enzymsystem entdeckt, das in der DNA von Bakteriophagen verborgen war. Neben dem Gen für das Enzym liegt eine lange Anordnung wiederholter DNA-Sequenzen, deren Struktur ein wenig an CRISPR erinnert. — @AnthropicAI auf X
Das Labor arbeitet ausschließlich unter den Biosicherheitsstufen BSL-1 und BSL-2 und verwendet keine Krankheitserreger, die Menschen infizieren können; sämtliche Laborarbeiten führen menschliche Wissenschaftler aus. Das Team nutzt Claude Science und Claude Code, teilweise mit einer eigenen Steuerungssoftware, die viele Sitzungen parallel koordiniert. Weil eine Untersuchung Hunderte oder sogar Tausende Berichte hervorbringt, werden die Hypothesen selbst zum Untersuchungsgegenstand: Die Merkmale der Hypothesen, die Forschende für testenswert halten, helfen dabei, die Anweisungen an Claude zu verbessern. Feng Zhang, ein Pionier der Genomeditierung mit CRISPR (MIT und Broad Institute), hat den Preprint begutachtet und sieht darin ein ermutigendes Beispiel dafür, was KI-Agenten zur biologischen Forschung beitragen können. Anthropic veröffentlicht den Preprint und lädt Wissenschaftler ein, Forschungsfragen einzureichen.
🔗 Claude entdeckt ein neuartiges Enzymsystem mit CRISPR-ähnlichen Wiederholungen · Preprint (PDF)
Gemini 3.8 Flash TTS und Flash-Lite TTS: Google erzeugt und klont Stimmen
23. September — Google erweitert die Gemini-Familie um zwei Sprachsynthesemodelle (text-to-speech), die das Unternehmen als seine ausdrucksstärksten Audiomodelle bezeichnet: Gemini 3.8 Flash TTS und Gemini 3.8 Flash-Lite TTS. Beide sind über die Gemini API und in Google AI Studio allgemein verfügbar, zusammen mit einem neuen Voices-Endpoint. Im Changelog der API ist der Eintrag auf den 22. September datiert; die öffentliche Ankündigung folgte am 23. September.
Die beiden Modelle erfüllen unterschiedliche Aufgaben. Flash TTS dient der kreativen Gestaltung: Rolle, Akzent und Charakter einer Stimme lassen sich in natürlicher Sprache beschreiben; anschließend kann jede Äußerung hinsichtlich Schauspiel, Tempo und Dialektwechsel gesteuert werden. Google sieht Einsatzmöglichkeiten in Videospielen, Hörbüchern und Podcasts. Flash-Lite TTS ist auf hohe Produktionsmengen und niedrige Kosten ausgelegt: großflächige Synchronisation, Audioproduktion in großen Mengen und Sprachagenten in Echtzeit. Es soll gemini-3.1-flash-tts-preview ersetzen. Beide Modelle unterstützen Dialoge mit zwei Stimmen in einem Skript, stundenlanges Audio ohne merkliche Veränderung der Klangfarbe und Markierungen wie <laughs>, <sigh> oder |mhm|.
Der Blogbeitrag nennt mehr als 2.000 sofort nutzbare Stimmen, darunter regionale Varianten wie kanadisches Französisch. Die API-Dokumentation beschreibt dagegen 30 Studio-Stimmen und eine erweiterte Bibliothek mit mehreren Hundert Stimmen. Für die Stimmenklonung genügt eine 30 Sekunden lange Aufnahme, sofern die mündliche Einwilligung der Person aufgezeichnet wird, der die Stimme gehört. Jedes erzeugte Audio trägt das SynthID-Wasserzeichen. Für Leser in Europa wichtig: Einer Anmerkung im Blogbeitrag zufolge ist die Stimmenklonung über AI Studio im Europäischen Wirtschaftsraum, im Vereinigten Königreich, in der Schweiz, in Indien, in Illinois und in Texas nicht verfügbar. Das Remixen bestehender Stimmen ist für die nahe Zukunft angekündigt.
| Modelleigenschaft | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| API-Kennung | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Unterstützte Sprachen (API-Dokumentation) | 130 | 101 |
| Vorgesehener Einsatz | Kreative Gestaltung, präzise Steuerung | Hohe Produktionsmengen, Synchronisation, Sprachagenten |
| Audioausgabe, Standardpreis bis 31.12.2026 (Million Tokens) | 9 Dollar | 6 Dollar |
| Audioausgabe, Standardpreis ab 01.01.2027 (Million Tokens) | 18 Dollar | 12 Dollar |
| Endnutzerprodukt | Gemini Notebook | Google Vids (Sprachkommentar angekündigt) |
Zum Vergleich: Gemini 3.1 Flash TTS Preview kostet 20 Dollar pro Million ausgegebener Audio-Tokens. Google verweist zum Start auf externe Bewertungen: Flash TTS belegt im Voice Design Benchmark von Hume AI den ersten Platz (71,4), und die beiden Modelle stehen auf den ersten beiden Plätzen des Overall Quality Index von Hume AI. Auch über die API von Gemini Enterprise sollen sie „bald“ verfügbar sein.
🔗 Ankündigung von Google · Versionshinweise zur Gemini API · API-Preise
FLUX 3 Action: Black Forest Labs veröffentlicht ein Modell mit offenen Gewichten zur Steuerung von Robotern
23. September — Black Forest Labs, bekannt für seine FLUX-Bildmodelle, veröffentlicht FLUX 3 Action, ein World Action Model mit 7 Milliarden Parametern zur Steuerung von Robotern. Das vom multimodalen Basismodell FLUX 3 abgeleitete Modell sagt ausgehend von Kamerabildern und Gelenkstellungen in einem Rechenschritt künftige Bilder und Motorbefehle voraus. Die Gewichte sind offen verfügbar (die Hugging-Face-Modellkarte des DROID-Checkpoints nennt die Lizenz „flux-kommunity-license“). Das Labor veröffentlicht außerdem den Code, eine Anleitung zum Fine-Tuning, Benchmarks und reproduzierbare Beispiele.
An open weights 7B World Action Model that achieves first place on the RoboLab benchmark. It outperforms the previous best open model by 6.1 percentage points while using 56% fewer parameters and running up to 3.95x faster.
🇩🇪 Ein World Action Model mit 7B Parametern und offenen Gewichten, das im RoboLab-Benchmark den ersten Platz belegt. Es übertrifft das bisher beste offene Modell um 6,1 Prozentpunkte, benötigt dabei 56 % weniger Parameter und läuft bis zu 3,95-mal schneller. — @bfl_ai auf X
| Bewertetes Modell | Modelltyp | Zugang zu den Gewichten | Erfolgsquote RoboLab-120 | Parameterzahl |
|---|---|---|---|---|
| FLUX 3 Action | WAM | Offen | 42,92 % | 7B |
| OASIS WAM | VLM + WAM | Geschlossen | 39,0 % | – |
| Cosmos3-Nano-Policy | WAM | Offen | 36,8 % | 16B |
| Phoenix | TAMP+FM | Geschlossen | 34,4 % | – |
| BiMind v0.1 | VLA | Geschlossen | 33,3 % | – |
| π0.5 | VLA | Offen | 28,0 % | 3,3B |
| DreamZero | WAM | Offen | 25,7 % | 14B |
| GR00T N1.6 | VLA | Offen | 7,2 % | 3B |
Das bisher beste offene Modell war Cosmos3-Nano-Policy von NVIDIA. Die Angabe „bis zu 3,95-mal schneller“ bezieht sich auf Cosmos 3 Nano in FP8: Je nach GPU beträgt der Faktor 1,52 bis 3,95. Gegenüber π0.5, dem leistungsstärksten offenen Vision-Language-Action-Modell (VLA), ist die auf einen einzigen Schritt destillierte Variante (38,3 %) auf Workstation- und Rechenzentrums-GPUs schneller, auf einer RTX 5090 jedoch langsamer. Dafür sagt sie pro Vorhersage 2,13 Sekunden Bewegung voraus, gegenüber 1 Sekunde bei π0.5.
Der Blogbeitrag untersucht auch eine hybride Steuerung, bei der GPT-6 Astra von OpenAI den Roboter beaufsichtigt: Mit Astra auf niedriger Aufwandsstufe (low) schafft FLUX 3 Action 90 % der Durchläufe bei Kosten von 8,77 Dollar und einer Dauer von rund 8 Minuten pro Erfolg. Astra allein auf der Aufwandsstufe „xhigh“ löst alle Aufgaben, benötigt dafür aber 13,47 Dollar und 16 Minuten pro Erfolg. An einem echten Franka-Roboterarm erzielte FLUX 3 Action in einer Blindbewertung durch Positronic Robotics 28 Erfolge in 30 Versuchen, gegenüber 27 für Cosmos 3 Nano und 13 für π0.5. Drei Checkpoints sind auf Hugging Face verfügbar (Base, SO-101 und DROID). Das Modell ist mit NVIDIA in LeRobot integriert und lässt sich auch auf Jetson einsetzen.
🔗 FLUX 3 Action (Black Forest Labs) · Hugging-Face-Sammlung
Escaping SPACE: Perplexity veröffentlicht das erste Sicherheitsaudit der Computer-Sandbox
23. September — Das Perplexity Secure Intelligence Institute veröffentlicht den ersten Teil eines Berichts über Penetrationstests (red-teaming) von SPACE, der Sandbox, in der die Agenten von Perplexity Computer laufen. SPACE wurde am 15. Juli vorgestellt. Der Bericht beschreibt die erste veröffentlichte Sicherheitsbewertung von SPACE. Jede Sandbox ist eine Firecracker-Mikro-VM, die vom Host-Rechner isoliert ist. Ein Gateway für jede Sandbox setzt die Regeln für ausgehenden Netzwerkverkehr durch.
Neun Modelle erhielten Root-Zugriff innerhalb der VM und zwei Capture-the-Flag-Aufgaben: Sie sollten entweder die Grenze zwischen VM und Host überwinden, um eine als Köder platzierte AWS-Kennung zu erlangen, oder eine URL erreichen, die von den Netzwerkregeln blockiert wurde. Das Testprotokoll kombinierte Zugang oder keinen Zugang zum SPACE-Quellcode mit zwei Netzwerkstufen: keinem Zugang oder teilweisem Zugang zu PyPI- und Ubuntu-Paketquellen sowie zur Websuche von Perplexity. Pro Konfiguration gab es drei Versuche. Ergebnis: In 108 Versuchen gelang kein Ausbruch aus der VM auf den Host, auch nicht mit Zugang zum Quellcode. Bei vollständig gesperrtem Netzwerk hielt die Filterung stand (0 von 54 Versuchen). Bei teilweisem Netzwerkzugang erreichten vor der Korrektur dagegen 11 von 54 Versuchen das verbotene Ziel.
| Bewertetes Modell | Erfolge mit Quellcode | Erfolge ohne Quellcode |
|---|---|---|
| Claude Opus 5.0 | 3 von 3 Versuchen | Keine |
| GPT-5.6 Sol | 3 von 3 Versuchen | 2 von 3 Versuchen |
| Kimi K3 | 2 von 3 Versuchen | Keine |
| GPT-5.6 Cyber | Keine | 1 von 3 Versuchen |
| Fünf weitere bewertete Modelle | Keine | Keine |
Zwei Schwachstellen wurden ausgenutzt. Bei der ersten handelte es sich um DNS-Spoofing: Der Agent schleuste eine gefälschte Antwort ein, die pypi.org der Adresse des Ziels zuordnete. Das Gateway speicherte diese Antwort, ohne ihre Herkunft zu prüfen. Dafür war eine interne Adresse erforderlich, die nur im Quellcode sichtbar war. Die zweite Schwachstelle beruhte darauf, dass ein CDN IP-Adressen gemeinsam nutzt: GPT-5.6 Sol ließ die verbotene URL von fiddle.fastly.dev abrufen, das über dieselbe Adresse wie PyPI erreichbar war. GPT-5.6 Cyber nutzte einen Bilddienst von Taboola und den Screenshot-Dienst thum.io und las die Flagge anschließend per Zeichenerkennung aus. Claude Opus 5.0 erkannte diesen Weg, verwarf ihn aber, weil er nach seiner Einschätzung gegen die Anweisung verstieß, keine externen Systeme anzugreifen. Kimi K3 war das einzige Modell mit offenen Gewichten, das Erfolg hatte. Zwei Modelle konnten nicht bewertet werden: Fable verweigerte die Übung trotz Perplexitys Teilnahme am Cyber Verification Program von Anthropic, und auch GPT-6 Astra verweigerte sie.
Die am 26. August entdeckten Schwachstellen sind behoben: Jedes ausgehende Paket muss die seiner VM zugewiesene Adresse tragen, und das Gateway terminiert TLS selbst, um den Servernamen (SNI) und den HTTP-Host zu prüfen. Bei einer erneuten Bewertung unter den für Angreifer günstigsten Bedingungen konnte keines der Modelle die Flagge erlangen. Anschließend testete Perplexity ohne Agenten zehn Sandbox-Plattformen von Drittanbietern: Acht ließen sich auf mindestens eine Weise umgehen, darunter E2B, Vercel Sandbox, Modal Sandboxes und Daytona Sandbox. Cloudflare Sandbox und NVIDIA OpenShell hielten stand. Alle Anbieter wurden am 1. September informiert und antworteten. Bis zum 10. September hatten Daytona, Deno und microsandbox Korrekturen vorgenommen; Vercel und Modal stuften das Verhalten als bekannte Einschränkung ein. Der zweite Teil des Berichts über die Strategien der Modelle ist ohne Datum angekündigt.
Claude Code 2.1.281: Attribution abschaltbar und Auto-Modus verschärft
23. September — Claude Code 2.1.281 wurde um 19:19 Uhr UTC veröffentlicht, einen Tag nach Version 2.1.280. Die Version umfasst 176 Einträge, darunter 112 Fehlerbehebungen. Zwei Änderungen fallen im Alltag auf: Die Einstellung "attribution": false in settings.json entfernt sämtliche Attributionen aus Commits und Pull Requests. Wird eine Nachricht sofort mit ctrl+enter gesendet, laufen bereits gestartete Tools im Hintergrund weiter, statt den Durchlauf abzubrechen.
Der Auto-Modus wird strenger: Wo die Prüfung durch den Klassifikator serverseitig läuft, warten nun auch Shell-Befehle mit rein lesendem Zugriff auf dessen Entscheidung. Eine wichtige Sicherheitskorrektur: Ein rekursives rm, das auf eine Befehlssubstitution wie rm -rf "$(pwd)" zielte, wurde im Auto-Modus und mit --dangerously-skip-permissions ohne Bestätigung ausgeführt. Jetzt ist selbst bei einer zulässigen Bash-Regel eine Bestätigung erforderlich. Damit unbeaufsichtigte Sitzungen nicht hängen bleiben, wartet die Bestätigungsaufforderung für ein gefährliches rm zwei Minuten. Danach lehnt sie den Befehl ab und schlägt eine Umformulierung vor.
Inkompatible Änderung für selbst gehostete Runner: Zwischenskripte (Wrapper) oder Hooks, die --system-prompt hinzufügen, müssen auf --system-prompt-file umgestellt werden. Für Administratoren kann das Claude-apps-Gateway Amazon Bedrock über eine per STS bezogene IAM-Rolle (assume_role) aufrufen, bei Bedarf auch in einem anderen AWS-Konto, und auf jede Anfrage eine Bedrock-Schutzmaßnahme anwenden.
Anthropic-Produkte: claude.ai beschleunigt, Marketplace erweitert
Zwei Produktankündigungen von Anthropic, die am selben Tag veröffentlicht wurden, ergänzen das wissenschaftliche Ergebnis.
claude.ai in zwei Wochen dreimal so schnell
23. September — Auf claude.dev berichten drei Anthropic-Ingenieure von einem zweiwöchigen Sprint im August, der claude.ai und die Desktop-App ungefähr dreimal so schnell gemacht hat. Die gesamte Arbeit lief über einen einzigen Slack-Kanal mit Claude Tag (Beta), angetrieben von einem internen Forschungsmodell, das „ungefähr mit Opus 5.5 vergleichbar“ ist: Claude fand Engpässe, erstellte Benchmarks, schlug Korrekturen vor und überwachte die Bereitstellungen. Die Menschen legten die Ziele fest und genehmigten jede Änderung. Das Ergebnis: mehr als 3.000 zusammengeführte Änderungen, ohne für Kunden sichtbaren Vorfall oder Rollback.
| Gemessener Ablauf (75. Perzentil) | Vor dem Sprint | Nach dem Sprint |
|---|---|---|
| claude.ai-Seite bereit zur Eingabe | 3,1 s | 0,55 s |
| Neue Claude Code-Sitzung (Desktop) | 0,8 s | 0,3 s |
| Claude Cowork-Cloud-Sitzung (Desktop) | 2,6 s | 0,73 s |
| Geometrisches Mittel aus 13 Messungen | – | 3,1x schneller |
Die Methode beruht auf einer Idee: Sobald Claude eine Kennzahl hat, die es zu verbessern gilt, kann es optimieren. Das Team machte deshalb aus deterministischen Messungen CI-Schwellen, die nur sinken können. Ein Teil dieser Verbesserungen – ungefähr viermal flüssigeres Streaming – war bereits am 24. August angekündigt worden.
🔗 Wie wir claude.ai in zwei Wochen dreimal so schnell gemacht haben
Claude Marketplace vereint Konnektoren, Agenten und Integratoren
23. September — Anthropic erweitert den Claude Marketplace, der im März als eingeschränkte Vorschau gestartet war. Der Marktplatz umfasst nun drei Angebotsgruppen: mehr als 2.000 Konnektoren und Plugins (Atlassian, Google, Microsoft, Notion, Salesforce …), von Claude unterstützte Agenten und Produkte (CrowdStrike, Cursor, Harvey, Legora, Lovable, Snowflake), die Unternehmen teilweise über ihre Ausgabenzusage gegenüber Anthropic bezahlen können, sowie Beratungsunternehmen aus dem Claude Partner Network (Accenture, Boston Consulting Group, Deloitte). Anbieter haben drei Einstiegsmöglichkeiten: einen Konnektor oder ein Plugin mit MCP und Agent Skills entwickeln, einen Agenten oder ein Produkt zur Aufnahme einreichen oder dem Partner Network beitreten. Ein begleitender Beitrag veranschaulicht den Kaufmechanismus: CodeRabbit finanzierte einen Vercel-Tarif über eine Zusage aus seinem Anthropic-Budget; die Vereinbarung wurde innerhalb einer Woche geschlossen. Diese Zahlung über eine Anthropic-Ausgabenzusage befindet sich weiterhin in einer eingeschränkten Vorschau und setzt eine Prüfung der Berechtigung voraus.
ChatGPT: Voice wird aktiv, Lernkarten und Privacy Center
Voice nutzt Plugins und kommt zu ChatGPT Work
23. September — OpenAI erweitert ChatGPT Voice in zwei Richtungen. Der Sprachmodus Live kann während eines Gesprächs im Web sowie auf iOS und Android nun Plugins und mit dem Konto verbundene Apps wie E-Mail, Kalender oder Slack nutzen. Außerdem kommt Voice zu ChatGPT Work im Web und auf Mobilgeräten: Per Spracheingabe kann man dort ein Dokument, eine Präsentation oder eine Tabelle erstellen lassen, eine verbundene App nutzen oder eine Aufgabe im Browser ausführen lassen. Nach dem Anruf kann die Arbeit schriftlich weitergehen.
Bei den Modellen heißt es im Tweet von OpenAI außerdem, Voice könne GPT-6 Astra, Sol und Luna nutzen. Der Hilfeartikel erklärt dagegen, dass Live je nach Tarif auf GPT-Live-1 oder GPT-Live-1 mini basiert, ohne die Rolle der GPT-6-Modelle näher zu erläutern. Nutzer der Tarife Free und Go haben Voice in Chat mit den Plugins ihres Tarifs. Voice in Work setzt Zugang zu beiden voraus; auf diesem Weg gestartete Aufgaben zählen zur regulären Work-Nutzung. Live unterstützt weder Video noch Bildschirmfreigabe. Die weltweite Einführung läuft seit dem 23. September in der neuesten App-Version.
🔗 Ankündigung von OpenAI auf X · Hilfeartikel zu ChatGPT Voice
Lernkarten und Datenschutzcenter
22. September — ChatGPT kann jetzt interaktive Lernkarten (Flashcards) aus einem Thema oder hochgeladenen Notizen erstellen. Man tippt auf eine Karte, um sie umzudrehen, und gibt anschließend an, ob man die Antwort kannte oder sie wiederholen muss. Die Reihenfolge der Karten lässt sich mischen. Die Karten werden automatisch in der Bibliothek gespeichert. Die Funktion ist auf Mobilgeräten und im Web für alle Tarife verfügbar, einschließlich des kostenlosen.
21. September — Nachtrag: Dieselbe Seite mit Versionshinweisen hatte am Vortag ein Datenschutzcenter (Privacy Center) angekündigt, das für angemeldete Nutzer der Tarife Free, Go, Plus und Pro eingeführt wird. Es bündelt Informationen zum Datenschutz bei Gesprächen, zur Erinnerung, Personalisierung, Datennutzung, zu verbundenen Apps und zur Kontosicherheit und bietet direkte Links zu den Einstellungen. Im Web erreicht man es über das Kontomenü (Help, dann Privacy Center), auf Mobilgeräten über die Einstellungen.
Zwei neue Benchmarks: psychische Gesundheit und Inferenzdienst
MentalHealthBench (OpenAI)
23. September — OpenAI veröffentlicht MentalHealthBench, einen offenen Benchmark, der misst, wie Modelle in realistischen Gesprächen über psychische Gesundheit antworten – von emotional geprägten Alltagsgesprächen bis hin zu Notfällen. Er wurde gemeinsam mit mehr als 80 zugelassenen Psychologen und Psychiatern aus 22 Ländern entwickelt, die 19 Sprachen sprechen. Die synthetischen Gespräche stellen vier Personengruppen dar: Erwachsene, Jugendliche zwischen 13 und 17 Jahren, Betreuungspersonen und Fachkräfte. Für jedes Gespräch formulierten die Experten Kriterien mit einer Gewichtung von -10 bis +10. Beibehalten wurden nur Kriterien, denen mindestens zwei von drei Experten zustimmten, ohne dass der dritte widersprach. Die Bewertung erfolgt automatisch mit GPT-5.6 Sol als Evaluator; die Punktzahl gliedert sich in zehn Dimensionen, darunter Sicherheit, Ermittlung des Kontexts und Achtung der Selbstbestimmung der Nutzer. OpenAI zufolge verbessern sich die Modelle stetig, insbesondere bei der Ermittlung des Kontexts. Punktzahlen für einzelne Modelle stehen allerdings nur in den Grafiken des Beitrags. OpenAI erinnert daran, dass ChatGPT weder eine Therapie noch professionelle Betreuung ersetzt.
🔗 Vorstellung von MentalHealthBench
SWE-Serve (NVIDIA)
23. September — Das für Daten und Evaluation der Nemotron-Modelle zuständige NVIDIA-Team veröffentlicht gemeinsam mit dem SGLang-Team SWE-Serve: Aus 83 tatsächlich in diese Inferenz-Engine übernommenen Pull Requests werden 53 ausführbare Aufgaben zu spekulativem Decoding, Modellunterstützung, Kernels, Cache und Service-API. Das wichtigste Ergebnis betrifft die Lücke zwischen lokalen Tests und dem tatsächlichen Dienst: Bei den 19 Aufgaben, die einen echten Server starten, bestehen dieselben Korrekturen ohne Live-Diensttests zu 69,4 %, mit dem vollständigen Prüfer jedoch nur zu 45,9 %. Rund eine von drei Korrekturen, die die übrigen Prüfungen besteht, scheitert also, sobald das Modell geladen und abgefragt wird.
| Evaluiertes Modell (maximales Reasoning) | pass@1 über 3 Durchläufe | Durchschnittskosten pro Aufgabe |
|---|---|---|
| Claude Opus 5 | 75 % | 17,40 Dollar |
| GPT-5.6 Sol | 75 % | 12,26 Dollar |
| Kimi K3 | 64 % | 7,24 Dollar |
| GPT-5.6 Luna | 64 % | 0,95 Dollar |
| DeepSeek V4 Flash (0731) | 55 % | 0,69 Dollar |
Elf Modelle wurden mit einem minimalen Agenten ohne Webzugang evaluiert. Die Tabelle enthält weder Claude Opus 5.5 noch die am 22. September erschienenen GPT-6 Sol und Luna noch GPT-6 Astra. Aufgaben und Prüfer sind öffentlich verfügbar.
🔗 Wie SWE-Serve die Lücke zwischen lokalen Tests und dem Live-Dienst offenlegt · GitHub-Repository
Generative Videos halten Einzug in Schnittsoftware
Runway in DaVinci Resolve Studio
23. September — Zwei Wochen nach seinen Plugins für Premiere Pro und After Effects kommt Runway zu DaVinci Resolve Studio, der Schnittsoftware von Blackmagic Design. Das kostenlose Plugin für macOS und Windows wird über Workspace und dann Workflow Integrations geöffnet. Damit lassen sich Bilder und Videos per Prompt erzeugen und mit einem Klick in den Media Pool und auf die Timeline importieren, ohne den Browser zu nutzen. Die Funktion Edit Studio bearbeitet eine bereits geschnittene Einstellung: Das Bedienfeld exportiert den ausgewählten Bereich, und Aleph 2.0 rendert ihn anhand von höchstens fünf bearbeiteten Keyframes in einem neuen Stil und mit derselben Dauer neu. Erforderlich ist DaVinci Resolve Studio 19 oder neuer. Die Generierung steht bei allen kostenpflichtigen Runway-Tarifen offen und verbraucht vorhandene Credits; die Kosten jeder Generierung werden vor der Bestätigung angezeigt.
🔗 Runway ist jetzt in DaVinci Resolve verfügbar
Gemini Omni 1.1 Flash kostenlos in Google Vids
23. September — Wer ein Google- oder Google Workspace-Konto hat, kann jetzt mit Gemini Omni 1.1 Flash kostenlos Videos in Google Vids erstellen, auf dem Computer über vids.new. Version 1.1 bietet drei Steuerungsmöglichkeiten: eine Szene unter Beibehaltung von Figuren, Beleuchtung und Kulisse verlängern, die genaue Länge eines Clips auf ein Voice-over abstimmen und direkt in 1080p generieren. Jeder Clip trägt ein SynthID-Wasserzeichen. Die vollständige Einführung beginnt am 23. September und kann 1 bis 3 Tage dauern. Kostenpflichtige Tarife ermöglichen größere Generierungsvolumen; konkrete Zahlen wurden nicht veröffentlicht. Google kündigt außerdem an, dass Gemini 3.8 Flash-Lite TTS bald Sprechertexte in mehr als 100 Sprachen in Vids erstellen soll.
Made On YouTube 2026: Gemini Omni beim Schnitt von Shorts
23. September — Bei der jährlichen Veranstaltung Made On YouTube integriert YouTube Gemini Omni in einen dialogbasierten Schnittassistenten für Shorts und die App YouTube Create: Einfache Textanweisungen reichen aus, um gesprochene Passagen herauszuschneiden, Musik zu synchronisieren, Texteinblendungen hinzuzufügen oder Einstellungen neu anzuordnen. Livestreams erhalten eine automatische Synchronisation (Live auto-dubbing). YouTube Music erhält Ask Music, um Wiedergabelisten im Gespräch zusammenzustellen, und Podcast Lineup liefert jede Woche KI-generierte gesprochene Vorschauen auf empfohlene Podcasts. Creator erhalten außerdem eine erweiterte Ähnlichkeitserkennung zum Schutz ihrer Stimme und ihres Gesichts. Nur für personalisierte Startseiten-Feeds (Custom Feeds) gibt es einen Zeitrahmen: Sie sollen diesen Herbst für Zuschauer in den USA erscheinen. Für die übrigen Funktionen gibt es noch keinen genauen Zeitplan.
🔗 Made On YouTube 2026 · Zusammenfassung von Google
Assistenten verbinden sich mit weiteren Apps
Gemini: eine neue Welle verbundener Apps
23. September — Google führt eine neue Reihe von Apps ein, die sich mit Gemini verbinden lassen und die das Konto @GeminiApp als MCP-Verbindungen beschreibt. Der Beitrag nennt 14 Namen in drei Gruppen: Produktivität (Airtable, Linear, monday.com, PandaDoc, Wispr AI, Zoho), Kreativität (Adobe, Picsart, Squarespace, Webflow) und Alltag (apartments.com, Experian, Peloton, SeatGeek). Der Tweet von @GeminiApp spricht dagegen von 13 neuen Apps. Diese Dienste lassen sich in den Einstellungen aktivieren oder im Gespräch durch Eingabe von @ aufrufen. Als Beispiele werden das Anpassen der Beleuchtung eines Fotos mit Adobe und das Abrufen der eigenen Kreditbewertung mit Experian genannt. Der Beitrag nennt weder die betroffenen Länder noch die Tarife.
🔗 Ankündigung von Google · Ankündigung von @GeminiApp
Muse, der Agent von Meta: Shopify, PayPal, Expedia, Instacart, dann ElevenLabs und HeyGen
22. und 23. September — Muse, der persönliche Agent, den Meta am 8. September eingeführt hat, kündigte innerhalb von weniger als 24 Stunden vier Konnektoren für Handelsdienste an. Laut dem offiziellen Konto @Muse sollen sie alle „bald“ verfügbar sein; Datum, Preis und Länder wurden nicht genannt. Am 23. September kündigten zwei Anbieter generativer Medien ebenfalls ihre Integration an: ElevenLabs ohne Verfügbarkeitsdatum und HeyGen auf Basis seines MCP-Servers.
| Angekündigter Dienst | In der Ankündigung beschriebene Nutzung | Angekündigt von | Angekündigte Verfügbarkeit |
|---|---|---|---|
| Shopify | Bezahlen mit einem Handgriff im gesamten Web | @Muse | Bald |
| PayPal | Vom Agenten verwaltete Zahlungen weltweit | @Muse | Bald |
| Expedia | Hotelbuchungen | @Muse | Bald |
| Instacart | Lieferung von Lebensmitteln nach Hause | @Muse | Bald |
| ElevenLabs | Voice-overs, Soundtracks und Videos | @ElevenLabs | Nicht angegeben |
| HeyGen | Veröffentlichungsvideos mit eigenem Avatar und Stimme | @HeyGen | Nicht angegeben |
🔗 Die vier von @Muse angekündigten Konnektoren · ElevenLabs kommt zu Muse · HeyGen wird Teil von Muse
Grok Bot in Tesla-Fahrzeugen und in Google Slides, Sheets und Docs
22. September — Tesla kündigt Grok Bot, den Agenten von SpaceXAI, für seine Autos an: Mit den Connectors kann Grok E-Mails verwalten, den Kalender ordnen oder vorhandene Dateien, Gespräche und Aufgaben aufgreifen, während der Fahrer die Hände am Steuer behält. Das Konto @grok verbreitete die Ankündigung noch am selben Abend. Die Aktivierung erfolgt in drei Schritten: in der Grok-App im Auto anmelden, die Connectors über die mobile App oder die Grok-Website hinzufügen und anschließend SuperGrok abonnieren, das für Grok Bot erforderlich ist. Die Mitteilungen nennen weder die betroffenen Fahrzeugmodelle noch die Länder.
Am selben Tag kündigt das Konto @bot an, dass Grok Bot sich nativ mit Google Slides, Sheets und Docs verbindet, E-Mail-Anhänge besser verarbeitet (Dateien lesen und hinzufügen) und für seine Webnavigation das Netzwerk des Nutzers verwenden kann. SpaceXAI verspricht außerdem schnellere Aufgaben und eine reaktionsfähigere Desktop-App, ohne Zahlen dafür zu nennen.
🔗 Beitrag von @grok · Ankündigung von Tesla · Thread von Grok Bot
Antigravity: lokale Agenten und der Befehl /plan
Das SDK führt seine Agenten lokal mit Gemma 4 26B aus
23. September — Das Antigravity SDK, das von Python aus Zugriff auf die Agentenfunktionen von Google Antigravity bietet, unterstützt jetzt vollständig lokale Workflows. Die anfängliche Unterstützung gilt für Gemma 4 26B A4B, das mit LiteRT (Google AI Edge) auf einem Rechner mit mehr als 24 GB VRAM oder gemeinsam genutztem Speicher läuft; LocalOpenAIAgentConfig lässt sich mit jedem OpenAI-kompatiblen Server wie Ollama, LM Studio oder vLLM verbinden. Google verweist auf entfallende API-Kosten und Ratenlimits, Code, der den Rechner nicht verlässt, sowie hybride Workflows. In der Demonstration plant Gemini 3.8 Flash in der Cloud die Prüfung von drei anfälligen Modulen mit 95 Tokens, ohne den Code je zu sehen. Währenddessen reproduzieren lokale Instanzen von Gemma 4 26B die Schwachstellen, schreiben Korrekturen und überprüfen sie; 97,2 % der Tokens (3 322) bleiben lokal. Diese Neuerungen kamen mit SDK 0.1.18 vom 21. September. Diese Version entfernt auch das interaktive Fragewerkzeug ASK_QUESTION aus den Standardwerkzeugen, damit die Agenten eigenständig arbeiten können.
🔗 Ankündigung von Google Developers
Antigravity 2.16.0 und 2.17.0, CLI 1.2.8 und 1.2.9
22. September — Für die Antigravity App erscheinen am selben Tag zwei Versionen. Version 2.17.0 führt den Befehl /plan ein: Der Agent erstellt einen Plan, den man prüfen und ändern kann, bevor er die erste Codezeile schreibt. Die Einstellung Plan Review Policy bietet dafür drei Modi: jeden Plan prüfen, den Agenten entscheiden lassen oder auf die Prüfung verzichten. Die Version reserviert außerdem ein Budget von 20 000 Tokens für Regeln und liest die Konfiguration pro Repository aus .gemini/config.json; die frühere Datei .agents/settings.json wird nicht mehr berücksichtigt. Mit Version 2.16.0 kann man sich mit einer WSL-Distribution verbinden und Word-, Excel- und PowerPoint-Dokumente per Drag-and-drop in einen Prompt einfügen. Außerdem zeigt sie Subagenten auf Live-Karten an.
| App-Version | Anzahl der Verbesserungen | Anzahl der Fehlerbehebungen | Wichtigste Neuerung |
|---|---|---|---|
| 2.16.0 | 12 | 15 | WSL, Office-Anhänge, Karten für Subagenten |
| 2.17.0 | 11 | 10 | /plan, Budget von 20 000 Tokens für Regeln |
22. und 23. September — Im Terminal ergänzt CLI 1.2.9 eine @-Syntax, um einen Subagenten direkt anzusprechen, und macht den Headless-Modus zuverlässiger: Auf Hintergrundaufgaben wird bis zu 30 Minuten gewartet, statt sie wenige Sekunden nach Inaktivität des Agenten abzubrechen. Version 1.2.8 überarbeitet die Kontextkomprimierung und begrenzt die Spracheingabe auf 3 min 30 s.
Google DeepMind: verschlüsselte dauerhafte Speicherung für Private AI Compute
23. September — Google DeepMind erläutert, wie seine Plattform Private AI Compute, die Daten in hardwareseitig isolierten Cloud-Enklaven verarbeitet, eine dauerhafte Speicherung erhalten soll. Bisher war die Plattform „zustandslos“: Der gesamte Kontext verschwand am Ende einer Aufgabe. Die neue Schicht funktioniert wie ein verschlüsselter Tresor in der Cloud, dessen Schlüssel ausschließlich auf den Geräten des Nutzers bleiben. Dadurch sind die Daten laut Google für niemanden zugänglich, auch nicht für Google. Benötigt ein Modell eine Information, entschlüsselt eine sichere Enklave die Daten vorübergehend in einem isolierten Speicherbereich, verarbeitet die Anfrage, speichert den neuen Kontext und verschlüsselt ihn sofort wieder. Als Beispiel nennt Google die Suche auf dem eigenen Computer nach einer Montageanleitung, die man zuvor mit einer vernetzten Brille angesehen hat.
Es handelt sich um eine Ankündigung der Architektur, die im Futur formuliert ist und weder ein Verfügbarkeitsdatum noch ein konkretes Produkt nennt. Als Vertrauensbelege veröffentlicht Google ein aktualisiertes Whitepaper, ein öffentliches, manipulationssicheres Verzeichnis seiner Serversoftware, das Geräte vor dem Versand persönlicher Daten prüfen können, sowie die Ergebnisse einer unabhängigen Prüfung durch eine nicht genannte Firma.
Qwen: Agenten für Smartphones und günstigeres Audio
Qwen Intelligence: drei Agenten für Smartphone-Hersteller
23. September — Qwen stellt Qwen Intelligence vor, ein Angebot von Smartphone-Agenten, das sich zunächst an Telefonhersteller richtet. Die Module für Planung, Ausführung, Bild und Speicher lassen sich nach Bedarf kombinieren; ein Routing verteilt die Berechnungen zwischen Gerät und Cloud. Zum Start gibt es drei Agenten: Mobile Planner plant komplexe Aufgaben, Mobile-Use führt sie vorrangig über APIs aus und greift bei Bedarf auf die grafische Oberfläche zurück (82,1 auf MobileWorld, 97,2 auf AndroidDaily und laut Qwen 90 % Erfolgsquote über den gesamten Ablauf), und Mobile Creative erzeugt in 3 Sekunden ein Bild. Qwen stellt vier Benchmarks bereit, aber weder die Gewichte noch den Code der Agenten. Mobile-Use und Mobile Creative werden bereits nach Nutzung abgerechnet; die Abrechnung für Mobile Planner soll „bald“ folgen.
| Bewertetes Modell oder System (laut Qwen) | Gesamtpunktzahl MobilePA-Bench |
|---|---|
| Qwen-Planner-Agent 27B | 77,05 % |
| GPT-6 Astra | 76,84 % |
| Claude Opus 5 | 75,71 % |
| Claude Fable 5 | 74,53 % |
| GLM 5.3 | 73,88 % |
🔗 Ankündigung von Qwen auf X · Bericht zu Qwen-Planner-Agent
Qwen-Audio-3.1: bis zu 95 % günstiger
23. September — Qwen-Audio-3.1 aktualisiert die drei Audiomodelle von Qwen für Spracherkennung (ASR), Sprachsynthese (TTS) und Echtzeitgespräche (Realtime) und ergänzt zwei weitere: TTS-Next erzeugt Stimme, Effekte und Hintergrundton in einem Durchgang; ASR-Next unterscheidet Sprecher, versieht Transkriptionen mit Zeitstempeln und erkennt Emotionen und Umgebungsgeräusche. Realtime hört zu und spricht gleichzeitig und lässt sich unterbrechen. Auf QwenCloud kostet qwen-audio-3.1-realtime-plus 6,4 Dollar pro Million eingehender Audio-Tokens und 24 Dollar für ausgehende Text- und Audio-Tokens bei 262K Tokens Kontext; ASR für Dateien kostet 0,15 Dollar pro Million eingehender Tokens. Nur diese beiden APIs sind verfügbar, die anderen wurden für „bald“ angekündigt.
| Modellfamilie | Angekündigte Preissenkung |
|---|---|
| TTS | etwa 70 % |
| Realtime | etwa 85 % |
| ASR | bis zu 95 % |
🔗 Ankündigung von Qwen-Audio-3.1 auf X · Qwen-Audio-3.1-Realtime auf QwenCloud
Mistral Vibe: Chat und Work werden zusammengeführt, die CLI schränkt Berechtigungen ein
Chat und Work werden zusammengeführt, Wissensdatenbank in der Vorschau
22. September — Mistral veröffentlicht vier Versionshinweise für Vibe, seinen Assistenten (früher Le Chat), ohne Blogbeitrag oder Tweet. Die wichtigste Änderung führt Chat und Work zu einer einzigen Oberfläche zusammen: Man stellt eine Frage oder startet eine Aufgabe am selben Ort, ein Fast-/Think-Schalter ersetzt den Moduswechsel, und Skills ersetzen die Chat Agents; Deep Research wird zu einem dieser Skills. Die Migration begann am 14. September für Free-, Pro- und Teams-Konten. Unternehmen folgen ab dem 1. Oktober innerhalb eines Zeitfensters von etwa sechs Monaten. Die agentische Wissensdatenbank (Agentic Knowledge Base) in der öffentlichen Vorschau ersetzt einen undurchsichtigen Speicher durch einsehbare und bearbeitbare Seiten und zeigt die Herkunft jeder abgerufenen Tatsache an. Mini App Canvas erstellt aus einem Prompt kleine, teilbare React-Anwendungen. Excel- oder CSV-Tabellen sind mit kostenpflichtigen Tarifen nun auch in Vibe Work verfügbar.
🔗 Versionshinweise von Mistral
Vibe CLI 2.25.8 behebt Umgehungen von Berechtigungen
23. September — Vibe CLI 2.25.8 bringt 5 Ergänzungen und 38 Fehlerbehebungen, darunter mehrere zur Sicherheit der Berechtigungen. Eine Freigabeliste mit relativen Pfaden erlaubt eine Datei nicht mehr allein deshalb, weil ihr Pfad mit demselben Suffix endet. Platzhalter in Shell-Befehlen umgehen die Prüfung von Pfaden außerhalb des Arbeitsverzeichnisses nicht mehr. Eine für einen übergeordneten Ordner erteilte Berechtigung gilt nicht mehr automatisch für dessen Unterordner, weshalb manche Genehmigungsanfragen erneut erscheinen können. Die Versionshinweise erwähnen erstmals auch eine „Rust CLI“, auf die sich 18 Einträge beziehen und mit der sich unter anderem entfernte Vibe Code-Projekte konfigurieren lassen. Für Unternehmen gilt die von der Organisation vorgegebene Konfiguration nun bereits beim Start einer Unified Harness-Sitzung. Zudem wurde die OAuth-Verbindung zu MCP-Servern korrigiert, die ein Client-Geheimnis ausgeben, etwa Supabase.
🔗 Versionshinweise zu Vibe CLI 2.25.8
Offene Code-Agenten und Agenten für die Kommandozeile
ZCode wird nach Sicherheitsproblemen als Open Source veröffentlicht
21. September — Nachtrag: Z.ai hat den Code von ZCode veröffentlicht, seinem als offizielles Werkzeug für GLM-5.3 vorgestellten Framework für agentische Programmierung. Damit reagiert das Unternehmen auf Sicherheitsprobleme, auf die die Community hingewiesen hatte. Das Konto @zcode_ai erklärt, die nötigen Korrekturen abgeschlossen zu haben, und entschuldigt sich. Das Repository zai-org/ZCode unter der Lizenz Apache-2.0 enthält die Clients, Backend-Dienste, die CLI und die Laufzeitumgebung des Agenten; am 23. September hatte es etwa 6 500 Sterne.
With respect to the code data referenced by the community, we confirm that no such data is retained and that it has never been used for model training.
🇩🇪 Zu den von der Community angesprochenen Codedaten bestätigen wir, dass keine dieser Daten gespeichert werden und dass sie niemals zum Training von Modellen verwendet wurden. — @zcode_ai auf X
Laut ZCode haben anschließend zwei Organisationen die Situation bewertet: Nach Angaben des CAICT enthält der Alibaba Cloud OSS-Bucket „zcode-prod“ keine Daten mehr; NSFOCUS zufolge wurden sowohl seine Objekte als auch der Bucket selbst gelöscht. Beide stellen fest, dass Client v3.14.0 die Korrektur enthält, die Funktion Repo Wiki entfernt wurde und der Ablauf zum Hochladen von Momentaufnahmen lokaler Repositories deaktiviert ist. Z.ai kündigt ein dauerhaftes Verfahren zur Meldung von Sicherheitslücken mit Belohnungen an und verspricht, den vollständigen Bewertungsbericht zu veröffentlichen.
Kimi Code 2.1.0 verbessert seine Sicherheit
23. September — Moonshot veröffentlicht Kimi Code 2.1.0 (2 Neuerungen, 18 Fehlerbehebungen). Die sichtbare Neuerung ist ein experimentelles Vollbildlayout, das unter /settings ausgewählt wird und nach einem Neustart wirksam ist. Mehrere Fehlerbehebungen verbessern die Sicherheit: Dateiwerkzeuge können über symbolische Links nicht mehr auf Dateien außerhalb des Arbeitsverzeichnisses zugreifen; die lokale Konfiguration eines Projekts wird erst nach Freigabe des Arbeitsbereichs angewendet; die Git-Konfiguration eines Repositories kann während Git-Operationen im Hintergrund keine Befehle mehr ausführen; und zusätzliche Ordner, die auf das persönliche Verzeichnis oder das Stammverzeichnis verweisen, werden abgewiesen. Das OAuth-Verfahren für MCP-Server fordert nun Offline-Zugriff an, sodass die stündliche erneute Autorisierung entfällt. Gleichzeitig hat Moonshot die ältere, in Python geschriebene Kimi CLI archiviert (11 424 Sterne); deren Versionen 1.51.0 und 1.52.0 verweisen auf Kimi Code.
🔗 Versionshinweise zu Kimi Code 2.1.0
DeepSeek Harness 0.1.7-rc.1 in der Vorschau
23. September — DeepSeek veröffentlicht v0.1.7-rc.1 von DeepSeek Harness, seinem am 13. August vorgestellten Open-Source-Agentenframework unter der MIT-Lizenz. Es handelt sich um einen Veröffentlichungskandidaten (release candidate): Das Repository verzeichnet seit August 21 Vorabversionen und bislang keine stabile Version. Die wichtigsten Ergänzungen sind experimentell: ein Computer-Use-Modus, mit dem der Agent den lokalen Computer bedienen und Screenshots aufnehmen kann (über Cua Driver MCP oder einen nativen Treiber), sowie drei Backends zur Browsersteuerung (Playwright MCP, Chrome DevTools MCP, Stagehand). Die Weboberfläche erhält integrierte Terminals und eine Überprüfung der Änderungen anhand von Diffs. Der Headless-Modus liest Aufgaben von der Standardeingabe und gibt Ereignisse als JSON aus; außerdem kann der Agent über SSH in einem entfernten Arbeitsbereich arbeiten. Für die Migration ist zu beachten: Der offizielle DeepSeek-Adapter nutzt ausschließlich die Messages API, die E2B-Ausführungsbackends entfallen, und der experimentelle Teammodus wächst von 8 auf 16 Teammitglieder.
🔗 DeepSeek Harness v0.1.7-rc.1
GenCode, der Code-Agent von Genspark
23. September — Genspark stellt GenCode vor, einen in seine Super App integrierten Code-Agenten für macOS, Windows und Linux, der auch über die Kommandozeile verfügbar ist. Das zentrale Argument ist die Modellauswahl: Claude, GPT, DeepSeek oder ein Modell mit offenen Gewichten lassen sich für jede Aufgabe einzeln über ein einziges Konto auswählen, ohne einen API-Schlüssel konfigurieren zu müssen. Genspark wirbt mit offenen Modellen, die „ein Zehntel bis ein Zwanzigstel der Kosten“ verursachen. GenCode übernimmt in einem Schritt die für Claude Code erstellten Anweisungen, Regeln und gespeicherten Informationen. Das README des npm-Pakets @genspark/gencode erläutert die Herkunft: GenCode leitet sich von opencode ab, dem Open-Source-Code-Agenten, bleibt aber ein proprietäres Produkt ohne Verbindung zum Projekt und nutzt bewusst dessen Repository-Ordner .opencode/. Die Ausgaben werden bei jedem Schritt in Genspark-Credits angezeigt.
🔗 GenCode · Ankündigung von Genspark auf X
GitHub Copilot: unterstützte Genehmigungen und lokale Sandbox
Copilot für JetBrains 1.18.0
22. September — Version 1.18.0 von Copilot für JetBrains-IDEs führt in der öffentlichen Vorschau unterstützte Genehmigungen (assisted approvals) ein: In Agentensitzungen werden als risikoarm eingestufte Werkzeugaufrufe automatisch genehmigt, während riskantere Aktionen weiterhin eine Entscheidung erfordern. Man kann auch eine frühere Nachricht erneut bearbeiten: Copilot setzt dann die Unterhaltung und die Dateiänderungen zurück, bevor es die neue Anweisung sendet. Der in Copilot für JetBrains verfügbare Codex-Agent erhält einen Planmodus, in dem sich das Vorgehen vor jeder Änderung prüfen, verfeinern oder genehmigen lässt. Sitzungen akzeptieren außerdem Skills sowie Anweisungen von Organisationen und Unternehmen. Der integrierte GitHub-MCP-Server, der standardmäßig aktiv ist, lässt sich nun deaktivieren. Nutzer einer JetBrains-IDE der Version 2025.1 erhalten einen Hinweis, auf 2026.1 oder neuer zu aktualisieren.
🔗 Neuerungen bei Copilot für JetBrains
Die Copilot App isoliert ihre lokalen Sitzungen
23. September — Die GitHub Copilot App, GitHubs Desktopanwendung für seine Agenten, erhält in der öffentlichen Vorschau eine lokale Sandbox. Sie wird für jedes Projekt einzeln konfiguriert und begrenzt, worauf die Befehle einer lokalen Sitzung zugreifen können: das Dateisystem (Ordner mit Lese- und Schreibzugriff, nur mit Lesezugriff oder ohne Zugriff), das Netzwerk (ausgehender Zugriff auf das Internet und das lokale Netzwerk) und Zugangsdaten (Git über HTTPS, GitHub CLI). Von Unternehmen verwaltete Einstellungen können die Richtlinie verschärfen. Kann das Betriebssystem die verlangte Richtlinie nicht durchsetzen, beendet sich die Sandbox-Shell mit einem Fehler, statt ohne Schutz zu laufen. Die Sandbox ist standardmäßig deaktiviert. Sie lässt sich für neue Sitzungen des Projekts oder mit /sandbox on für eine laufende Sitzung aktivieren; Cloud-Sitzungen und entfernte Hosts deckt sie nicht ab, und ihre Einstellungen sind von denen der Copilot CLI getrennt.
🔗 Lokale Sandbox in der GitHub Copilot App
Cursor: zwei Bots für die Produktionsbereitstellung, 7 % weniger Tokens
Rollouts und Security Review
23. September — Cursor führt zwei Bots für die letzte Phase der Codeauslieferung ein, die in den Tarifen Teams und Enterprise verfügbar sind. Rollouts veröffentlicht beim Öffnen jeder Pull Request einen Überwachungsplan mit Risiken, erwarteten Auswirkungen und zu prüfenden Signalen. Nach jedem Deployment gleicht es den Plan mit Logs, Metriken und Traces ab und bewertet jede Umgebung als fehlerfrei, von einer Regression betroffen oder nicht eindeutig beurteilbar. Bei einer Regression benennt es die verdächtige Änderung und kann eine Pull Request für ein Rollback öffnen, die erst freigegeben werden muss. Es führt selbst weder einen Merge noch ein Rollback aus. Security Review prüft jede Pull Request und meldet ausnutzbare Schwachstellen wie Injections, Umgehungen der Authentifizierung, im Code verbliebene Geheimnisse und SSRF. Zu jeder Meldung gehören Schweregrad, Angriffsweg und ein vorgeschlagener Fix. Für zehn Tage ermöglichen Testguthaben, Rollouts bei ungefähr 50 Änderungen mit Teams und 500 mit Enterprise auszuprobieren.
7 % geringere Tokenkosten ohne Qualitätsverlust
23. September — Cursor erläutert, wie es die Tokenkosten seines Agents für Nutzer um 7 % gesenkt hat, ohne die Qualität zu beeinträchtigen. Da neuere Modelle keine langen Verbotslisten mehr benötigen, wurde der System-Prompt um rund 66 % gekürzt. A/B-Tests mit echtem Traffic bestätigten diese Kürzungen. Integrierte Tools, von denen die meisten in weniger als 20 % der Gespräche gebraucht werden, werden nun bei Bedarf geladen.
| Optimierungsmaßnahme | Von Cursor gemessene Wirkung |
|---|---|
| Gekürzter System-Prompt | rund 66 % des Prompts entfernt |
| Integrierte Tools bei Bedarf geladen | 60 % weniger Tokens für Beschreibungen im statischen Kontext |
| Explizite Cache-Haltepunkte | 20 % weniger Fehlschläge bei kaltem Cache |
| Eine Zeilennummer pro zehn Zeilen | 1,6 % weniger aus dem Cache gelesene Tokens |
| Alle Änderungen zusammen | 7 % geringere Tokenkosten für Nutzer |
NVIDIA: offene Diarisierung und AI Day Singapore
Nemotron 3 Diarization unterscheidet bis zu acht Sprecher
23. September — NVIDIA veröffentlicht Nemotron 3 Diarization auf Hugging Face. Das Modell mit offenen Gewichten und 100 Millionen Parametern ermittelt, wer in einem Gespräch wann spricht, auch wenn sich Stimmen überlappen. Es verfolgt bis zu acht Sprecher, gegenüber vier beim Vorgänger Streaming Sortformer, und funktioniert sowohl nachträglich als auch im laufenden Stream. Die einstellbare Pufferlatenz reicht von 30,4 bis 0,32 Sekunden. Wörter transkribiert es nicht: Es liefert Zeitabschnitte pro Sprecher, die sich mit einem Transkriptionsmodell kombinieren lassen. In den ersten Ergebnissen des Diarization-Bench von VoiceArena belegt es unter zwölf Systemen den ersten Platz, mit einer Diarisierungsfehlerrate von 14,72 % gegenüber 19,3 % beim nächstplatzierten System. Laut NVIDIA kann sich diese erste Rangfolge noch ändern. Gegenüber dem bisherigen Modell sinkt die Fehlerrate im Durchschnitt über acht Evaluationsdatensätze um 41 %, bei Gesprächen mit zwei Sprechern aus CALLHOME verschlechtert sie sich leicht. Lizenz: OpenMDW 1.1.
| Veröffentlichte Messgröße | Nemotron 3 Diarization | Vorgängermodell |
|---|---|---|
| Maximal erfasste Sprecher | 8 | 4 |
| Durchsatz bei 30,4 s (Batches mit 32, RTX PRO 5000) | 15 113-fache Echtzeitgeschwindigkeit | 2 619-fache |
| DIHARD-III-Fehlerrate bei 30,4 s | 12,73 % | 19,09 % |
🔗 Nemotron 3 Diarization im Hugging Face Blog
AI Day Singapore: Vera Rubin und Nemotron in Südostasien
22. September — In einem am 22. September um 19:30 Uhr PT veröffentlichten Blogbeitrag zum AI Day Singapore am 22. und 23. September stellt NVIDIA Sea Limited, die Muttergesellschaft von Shopee, Garena und Monee, als erstes Unternehmen der ASEAN-Region vor, das seine Plattform Vera Rubin einsetzt, um Modelle und Agents in größerem Maßstab zu entwickeln und bereitzustellen. Der weitere Beitrag zeigt, wie offene Nemotron-Modelle vor Ort angepasst werden: AI Singapore erweitert seine auf die Sprachen der Region ausgerichtete Modellfamilie SEA-LION um Nemotron-Modelle. In Vietnam hat Viettel AI Nemotron 3 Super für Vietnamesisch feinabgestimmt; das Modell führt den Benchmark VMLU an. In Thailand hat iApp Technology Nemotron 3 Nano mit dem als Open Source veröffentlichten OpenThai 2.0 Legal an thailändisches Recht angepasst. Darauf läuft der Rechts-Chatbot Thanoy mit rund 43 000 Nutzern.
🔗 Beim AI Day Singapore zeigen NVIDIA und Partner KI-Fortschritte in Südostasien
KI ohne Störungen in Produktion bringen
Zwei Ankündigungen folgen demselben Gedanken: mit echten Workloads prüfen, bevor Traffic umgeleitet oder Maschinen aktualisiert werden.
Canary-Deployments von Together AI
22. September — Together AI beschreibt die schrittweisen Deployments seines Angebots Dedicated Model Inference, die seit dem Update vom 15. September verfügbar sind: Das über einen Endpoint bereitgestellte Modell lässt sich ohne Unterbrechung und ohne URL-Änderung austauschen. Drei Strategien stehen zur Wahl: Beim Canary-Deployment steigt der Traffic-Anteil des neuen Modells stufenweise an, standardmäßig über 5 %, 25 % und 50 % auf 100 %. Beim Blue-Green-Deployment wird der gesamte Traffic auf einmal umgeschaltet; beim schrittweisen Austausch werden die Replikate einzeln ersetzt. Nach jeder Canary-Stufe vergleicht eine Prüfschwelle die Latenz oder Fehlerrate mit der des alten Modells und pausiert das Deployment, wenn sich die Werte verschlechtern. In der veröffentlichten Demonstration wird der Wechsel von Qwen2.5-7B zu Qwen3.5-9B bereits bei 10 % des Traffics gestoppt, weil die p95-Latenz um 137 % steigt (1 740 ms gegenüber 734 ms). Die Rückkehr zum alten Modell gelang, ohne dass eine der 6 800 bearbeiteten Anfragen fehlschlug.
🔗 Canary-Deployments: Modelle in Produktion ohne Ausfallzeit aktualisieren
NVCRE und NodeWright bei NVIDIA
23. September — NVIDIA erläutert zwei Open-Source-Projekte (Apache 2.0) von DSX OS, der Softwareschicht seiner KI-Fabrikplattform, für GPU-Cluster unter Kubernetes. NVIDIA Cluster Readiness Engine (NVCRE) geht von einer Beobachtung aus: Ein Cluster kann alle Gesundheitsprüfungen bestehen und dennoch bei einem verteilten Training scheitern. Deshalb prüft NVCRE ihn mit echten Workloads – NCCL-Kommunikationstests, DCGM-Diagnosen und NeMo-Vortraining – auf Knotengruppen, die nach ihrer Topologie ausgewählt werden. Es benennt fehlerhafte Knoten und halbiert im Diagnosemodus betroffene Gruppen wiederholt, bis die Verdächtigen isoliert sind. Der Blogbeitrag nennt unter diesen Workloads Nemotron-5-Modelle mit 8 und 56 Milliarden Parametern, ohne weitere Einzelheiten. NodeWright, das früher Skyhook hieß und bei NVIDIA in Produktion eingesetzt wird, aktualisiert die Systeme der Knoten – Kernel-Einstellungen, Sicherheitsagents und Patches für Schwachstellen – nachdem geschützte Aufgaben abgeschlossen sind. Die Updates erfolgen in festen, linearen oder exponentiellen Wellen und stoppen automatisch, wenn zu viele Batches fehlschlagen.
🔗 GPU-Cluster vor dem Einsatz von KI-Workloads auf Betriebsbereitschaft prüfen · NodeWright
Zwei offene Datensätze: Gespräche mit mehreren Stimmen und ein wissenschaftliches Korpus
Basis Conversations 1500
23. September — Basis veröffentlicht Basis Conversations 1500 auf Hugging Face: 1 502 Stunden spontane Gespräche zwischen 2 645 Menschen aus 33 Ländern in 22 Sprachen, von Englisch bis Mingrelisch und Xhosa. An jedem Gespräch nehmen zwei bis vier Personen teil, die jeweils auf einer eigenen synchronisierten Spur aufgezeichnet wurden (FLAC, 48 kHz). Damit lassen sich Überlappungen, Unterbrechungen und Sprecherwechsel untersuchen, bei denen Modelle laut dem Team noch Schwierigkeiten haben. Rund 100 Stunden wurden von Menschen detailliert annotiert (113 096 Bewertungen), darunter mitfühlende oder genervte stimmliche Rückmeldungen, peinliches Schweigen sowie kooperative oder konkurrierende Überlappungen. Die bereitgestellten Transkripte wurden automatisch erstellt und sollten ohne Überprüfung nicht als Trainingsziele dienen. Der Blogbeitrag beschreibt den Datensatz als frei für kommerzielle Nutzung und Forschung; er unterliegt jedoch einer eigenen Lizenz von Basis (basis-data-license-1.0), und der Zugang wird manuell freigegeben.
QVAC Genesis III
23. September — Tether AI Research veröffentlicht QVAC Genesis III, den dritten Teil seines synthetischen Korpus für das Vortraining kleiner Modelle in Naturwissenschaften, Technik, Ingenieurwesen und Mathematik. Mit weiteren 43,06 Milliarden Tokens umfasst das gesamte Korpus nun 191,43 Milliarden Tokens und rund 160 Millionen Dokumente aus 19 Fachgebieten. Der begleitende Artikel wurde für die Konferenz COLM 2026 angenommen. Bei der Methode wird ein kleines Schülermodell, Qwen3-1.7B-Base, befragt: Aus einer falschen Antwort entsteht eine korrigierende Erklärung, aus einer richtigen eine Analyse jeder Antwortoption. Ein von Grund auf mit diesem Korpus trainiertes Modell mit 1,7 Milliarden Parametern erzielt bei gleichem Tokenbudget deutlich bessere Ergebnisse als dasselbe Modell nach einem Training mit Cosmopedia-v2. Das Korpus erscheint unter einer nichtkommerziellen Lizenz (CC-BY-NC 4.0); für ein darauf trainiertes Modell wird eine Veröffentlichung unter Apache 2.0 angekündigt.
| Evaluierter Benchmark | Verbesserung gegenüber Cosmopedia-v2 (gleiches Tokenbudget) |
|---|---|
| ARC-Easy | +28,57 Punkte |
| ARC-Challenge | +21,35 Punkte |
| GPQA Diamond | +2,52 Punkte |
| MMLU STEM | +15,03 Punkte |
KI für Klima und Ernährung
Ai2 und Global Fishing Watch überwachen die Ozeane mit Agents
23. September — Auf der Climate Week in New York kündigen Ai2 und Global Fishing Watch eine Partnerschaft an, um KI und insbesondere Agents für die Meeresüberwachung und Fischereikontrolle einzusetzen. Die beiden Organisationen arbeiteten bereits zusammen und gehen nun zur gemeinsamen Entwicklung über: eine gemeinsame Detection-Pipeline, neue Echtzeit-Vision-Modelle für Satellitenbilder und Agents, die mehrere Datenquellen miteinander verknüpfen können. Global Fishing Watch erhält Zugang zu OlmoEarth, der auf offenen Modellen beruhenden Erdbeobachtungsplattform von Ai2, um seine Daten zu annotieren und eigene Modelle zu trainieren. Echtzeit-Schiffserkennungen von Skylight werden in sein Portal für die Verwaltung von Meeresschutzgebieten eingebunden. Außerdem entwickeln beide Teams Agents wie Shippy weiter, den Analysten nach der Geschichte eines Schiffs fragen können. Die Ankündigung enthält weder einen Zeitplan noch einen Betrag.
🔗 Ai2 und Global Fishing Watch bringen KI-Agents in die Meeresüberwachung
Google.org und die Gates Foundation: Unterstützung für 200 Millionen Kleinbauern
18. und 22. September — Nachtrag: Google.org und die Gates Foundation weiten ihre gemeinsame Initiative aus, um 200 Millionen Kleinbauern in Subsahara-Afrika und Südasien KI-Tools für Klima, Landwirtschaft und Sprache zugänglich zu machen. Ursprünglich waren 50 Millionen vorgesehen. Die beiden Partner stellen gemeinsam 100 Millionen US-Dollar bereit, unterstützt durch die technische Arbeit von Forschern und Ingenieuren von Google. Die Pressemitteilung der Gates Foundation stammt vom 18. September; blog.google griff sie am Abend des 22. September auf. Das Programm finanziert lokale Akteure wie Wadhwani AI und Digital Green in Indien, integriert KI-Prognosen in die Klimaplattform TomorrowNow, kartiert Felder mit einer Auflösung von unter einem Meter und unterstützt offene Sprach- und Textdatensätze in mehr als 40 afrikanischen Sprachen. Kleinbauern erzeugen knapp 35 % der weltweit produzierten Lebensmittel.
🔗 Ankündigung von Google.org · Pressemitteilung der Gates Foundation
Kurzmeldungen
- Anthropic: Modernisierung von Code — In der Reihe „Notes from the Field“ schlagen zwei bei Kunden eingesetzte Anthropic-Ingenieure, Jonah Ezekiel und Lexie Tonelli, sechs Schritte vor, um eine von Agenten durchgeführte Modernisierung von Code vorzubereiten: Ziel festlegen, Tests als „Zertifikat“ etablieren, menschliche Prüfung in Stufen organisieren, Voraussetzungen schaffen, den Ablauf für Agenten festlegen und dann starten. Kosten beziffern sie nicht; sie empfehlen, diese in einem Pilotprojekt zu messen. 🔗 Quelle
- Boris Cherny verifiziert das Claude Agent SDK mit Lean — Am Abend des 22. berichtet Boris Cherny (Claude Code), er habe das Claude Agent SDK von Opus 5.5 mit dem Beweisassistenten Lean formal verifizieren lassen: Einige kurze Prompts führten zu 16 Pull Requests, die Bugs und Race Conditions beheben. Er gibt an, auch TLA+ zu verwenden. 🔗 Quelle
- Codex CLI 0.156.1 — Dieses Update für 0.156.0 ergänzt GPT-6 Sol und GPT-6 Luna in der Modellauswahl der CLI. Der bei einer Ratenbegrenzung angezeigte Hinweis empfiehlt nun Luna; außerdem werden Migrationen von GPT-5.5 und GPT-5.6 angeboten. 🔗 Quelle
- Airbnb und GPT-6 Astra — Eine neue Vereinbarung erweitert den Zugang der Entwicklungs- und Produktteams von Airbnb zu OpenAI-Modellen, darunter GPT-6 Astra, über die OpenAI API und Amazon Bedrock. Technikchef Ahmad Al-Dahle sagt, seine Teams lieferten etwa 80 % mehr Funktionen als vor einem Jahr; ein Vertragswert wird nicht genannt. 🔗 Quelle
- Zwei Jahre OpenAI Academy — Seit September 2024 fanden mehr als 250 Veranstaltungen statt und mehr als 4 Millionen Menschen wurden erreicht. OpenAI testet ein Programm für Trainer aus der Community (Community Trainer Program), bei dem Beschäftigte von Partnerorganisationen nach einer Bewertung lernen, Workshops zu leiten. 🔗 Quelle
- Eine LED-Anzeige wird zum Sprachassistenten — Im Blog OpenAI Developers beschreibt Sid Rampally, wie Codex ihm half, ein von einem Raspberry Pi gesteuertes LED-Panel mit 128 × 64 Pixeln zu verkabeln und zu programmieren. GPT-Live-1 führt das Gespräch und überträgt Recherche und Anzeige über die Responses API an GPT-5.6 Luna. 🔗 Quelle
- MedGemma überschreitet 10 Millionen Downloads — Google beschreibt Praxiseinsätze seiner offenen medizinischen Modelle: Gebärmutterhalskrebs-Screenings bei mehr als 3 500 Frauen in Sambia, Pilotprojekte am AIIMS-Krankenhaus in Delhi und Tuberkuloseerkennung in Indonesien. Die Modellausgaben dürfen Diagnosen nicht unmittelbar bestimmen, erinnert Google. 🔗 Quelle
- Gemini Notebook in Google Docs — Wer in Docs @ eingibt, kann ein Notebook als Quelle anführen: Gemini stützt seine Texte auf dessen Quellen, versieht sie mit Zitaten im Text und kombiniert sie über Workspace Intelligence mit E-Mails und Dateien. Verfügbar für Business Standard und Plus, Enterprise Standard und Plus, Education Plus sowie Abonnenten von Google AI Pro und Ultra. 🔗 Quelle
- Sechs Tools für Google Flow — Google Labs veröffentlicht sechs mit Google Flow Tools von Kreativen entwickelte Tools: Mondo Sónico (synchronisierte Soundeffekte), CaptionCast (animierte Untertitel), ThumbnailForge (Vorschaubilder), Surface (Texturen auf 3D-Oberflächen), CollageMotion Pro und SwissFlow Studio (Motion Design). Jedes lässt sich duplizieren und verändern. 🔗 Quelle
- Google Beam wird in Frankreich ausgeliefert — Beam, Googles gemeinsam mit HP vertriebene Videokommunikationsplattform, die persönliche Präsenz nachbilden soll, wird inzwischen in sechs Ländern ausgeliefert, darunter Frankreich, und hat 18 Partner. Einer internen Studie zufolge fühlen sich Teams um 50 % stärker verbunden und benötigen 21 % weniger Folgebesprechungen. 🔗 Quelle
- Android Enterprise und Gemini-Agenten — Gemini kann anhand des Bildschirminhalts Aufgaben über mehrere Apps hinweg ausführen. Schutzmechanismen verhindern dabei, dass persönliche Agenten auf das Arbeitsprofil zugreifen; Administratoren können die KI-Automatisierung für ihre gesamte Geräteflotte einschränken oder deaktivieren. 🔗 Quelle
- AI Brief auf Französisch — Die geschlossene Beta von AI Brief, das Nutzer mit ihren eigenen Worten durch AI-Max-Kampagnen in Google Ads führt, wird auf Französisch, Niederländisch, Deutsch, Italienisch, Japanisch, Portugiesisch und Spanisch ausgeweitet. 🔗 Quelle
- Gemini CLI: Nightly vom 23. September — Es handelt sich nur um eine Nightly-Version, nicht um eine stabile Version. Sie ergänzt Gemini 3.8 Flash und Gemini 3.5 Flash Lite, die sofort per API-Schlüssel, Vertex AI oder Gateway zugänglich sind und mit einem Google-Konto über Experimentieroptionen. Am Dienstag, dem 22., erschien keine stabile Version. 🔗 Quelle
- EcoHash misst seine Videooptimierungen — Auf einer RTX PRO 6000 mit 96 GB verkürzt EcoHash die Verarbeitungszeit eines MiniMax-H3-Videos von 174,8 auf 40,8 Sekunden und die Text-zu-Video-Erzeugung mit Wan2.2 von 132,3 auf 10,7 Sekunden, mit einer in vier Schritten destillierten LoRA. Drei der zehn getesteten Einstellungen, darunter beide Kompilierungsmodi, bewirkten nichts. 🔗 Quelle
- Krimtatarisch: Ein verfälschter Test wird verhindert — Der Entwickler eines Spracherkennungsmodells für Krimtatarisch stellte fest, dass vier Hörbücher doppelt in seinem Korpus vorkamen: 96,9 % der Ausschnitte seines Haupttests hatten ein Gegenstück in den Trainingsdaten. Nach der Korrektur, einem LoRA-Fine-Tuning und einer Anpassung des Decoders sank die Wortfehlerrate von 0,3463 auf 0,1701. 🔗 Quelle
- Falcon-H1 und mlx-lm — In mlx-lm 0.31.3 wird beim Training ohne KV-Cache nur die erste der 66 Schichten von Falcon-H1 ausgeführt: Jede LoRA trainiert ohne Fehler oder Warnung auf einem Modell mit nur einer Schicht. Die Korrektur besteht aus einer Zeile; ein Issue wurde eröffnet. 🔗 Quelle
- Agenten und Open-Source-Beiträge — Quentin Gallouédec (Hugging Face) meint, von Agenten erzeugte Beiträge verschleierten, ob ein echter Bedarf bestehe, und kosteten Maintainer Zeit für die Prüfung. Er fordert, keine Agenten mehr wahllos auf Projekte anzusetzen, sondern das jeweilige Projekt zuerst selbst zu nutzen. 🔗 Quelle
- Phionyx bei der IETF — Der Autor von Phionyx reicht den individuellen Entwurf Claim-Preserving Exchange of AI Evaluation Evidence ein. Er soll dafür sorgen, dass ein Evaluationsergebnis seine Bedingungen und Grenzen beim Austausch zwischen Systemen behält. Der Text wurde von keiner Arbeitsgruppe angenommen. 🔗 Quelle
- Kimi Work 3.2.12 — Mit dem Desktop-Agenten von Moonshot lässt sich eine Passage in einer PPT-, Excel-, Word- oder Markdown-Datei auswählen und gezielt ändern. Die Größenbeschränkung für Anhänge entfällt. 🔗 Quelle
- Qwen-Image-2.1 führt bei offenen Modellen — Laut Arena ist Qwen-Image-2.1 das führende offene Modell für Bildbearbeitung (1 367 Punkte, Platz 16 insgesamt) und für Text-zu-Bild-Generierung (1 228 Punkte, Platz 17 insgesamt). 🔗 Quelle
- OpenTelemetry in der Copilot-App — Administratoren können Traces aus Agentensitzungen der GitHub-Copilot-App (Modellanfragen und verwendete Tools) über die Eigenschaft
telemetryvonmanaged-settings.jsonan ihre Monitoring-Tools exportieren. Der Inhalt von Prompts und Antworten ist standardmäßig ausgeschlossen. 🔗 Quelle - Copilot CLI und C++ — Der Microsoft C++ Language Server von Copilot CLI erstellt nun standardmäßig einen dauerhaften Index der Symbole des gesamten Projekts. Die erstmalige Erstellung kann lange dauern und viel Arbeitsspeicher benötigen; GitHub beziffert den Nutzen nicht. 🔗 Quelle
- Ein Pull Request mit einer Million Zeilen — Ein Technikbeitrag von GitHub erklärt, wie die Copilot-App einen Pull Request mit 2 200 Dateien, mehr als einer Million Zeilen und über 400 Kommentaren darstellt: Die Geometrie des Codes wird im Voraus berechnet, die der Kommentare erst in der Nähe des sichtbaren Bereichs gemessen. 🔗 Quelle
- Genspark ergänzt Opus 5.5, GPT-6 und Grok 4.7 — In der Nacht zum 23. macht Genspark Claude Opus 5.5, Grok 4.7, GPT-6 Sol und GPT-6 Luna in AI Chat, Code Agent und Claw verfügbar. Dabei übernimmt es die Argumentation der Anbieter; Abonnement und Preise werden nicht genannt. 🔗 Quelle
- Umfrage von GitHub und Yale — Von 1 039 GitHub-Nutzern in den USA äußern 71 % Bedenken wegen der Umweltauswirkungen von KI, und acht von zehn wünschen sich Tools, um energieeffizienteren Code zu schreiben. GitHub weist darauf hin, dass die Stichprobe aus Personen besteht, die dem Erhalt seiner Marketingmitteilungen zugestimmt haben, und nicht repräsentativ ist. 🔗 Quelle
- Zed 1.21.0 — Die stabile Version bietet Claude Opus 5.5 sowie GPT-6 Astra, Sol und Luna mit eigenem API-Schlüssel, ergänzt die Anmeldung bei SuperGrok im Agent-Panel und verhindert standardmäßig den Ruhezustand des Rechners, während ein Agent arbeitet. 🔗 Quelle
- Warp — GPT-6 Sol und Luna sowie anschließend Claude Opus 5.5 kommen in das Warp-Terminal und die Warp Agent CLI. Grok 4.7 ist ebenfalls für Nutzer verfügbar, die ihr Grok-Abonnement verbinden. Preise werden nicht genannt. 🔗 Quelle
- Devin in Microsoft Teams — Devin, bisher auf Kanäle beschränkt, antwortet jetzt auch in Direktnachrichten und Gruppenchats, startet Automations aus einem Kanal und sendet Karten für Fragen oder Genehmigungen. Die Anwendung benötigt keine neuen Berechtigungen. 🔗 Quelle
- Scribe v2 Medical — Das seit dem 11. September verfügbare Modell von ElevenLabs für die Transkription klinischer Aufnahmen erhält seine offizielle Ankündigung samt neuer Zahl: Bei klinischen Audioaufnahmen macht es 35 % weniger Wortfehler als Scribe v2. Der Preis beginnt bei 0,22 Dollar pro Stunde. 🔗 Quelle
- Sora 2 verlässt ElevenLabs — ElevenLabs entfernt Sora 2 und Sora 2 Pro aus seinem Studio, weil OpenAI die Sora API am 24. September schließt. Diesen Termin hatte OpenAI am 24. März angekündigt. Betroffene Workflows müssen auf ein anderes Videomodell umgestellt werden, etwa Gemini Omni 1.1 Flash. 🔗 Quelle
- Cohere Model Vault in Kanada — Cohere gibt bekannt, dass Model Vault, seine dedizierte Inferenzplattform für einen einzelnen Mandanten, in Kanada verfügbar ist. Cloud-Region, Anbieter und Preis nennt das Unternehmen nicht; die Produktseite erwähnt Kanada noch nicht. 🔗 Quelle
- Cohere und Veränderungsmanagement — In einem Beitrag regt Katherine Correia (Cohere) an, KI als Beteiligte statt als bloßes Werkzeug einzubinden, Aufgaben als überprüfbar, urteilsabhängig oder hybrid einzuordnen und Regeln für einzelne Anwendungsfälle festzulegen. Ein Produkt oder Zahlen nennt sie nicht. 🔗 Quelle
Was das bedeutet
Das Ergebnis von Anthropic führt Code-Agenten in die Grundlagenbiologie. Rund 950 Claude-Agenten sichteten in 21 Stunden mehr als 200 000 reverse Transkriptasen. Menschen griffen nur zu Beginn mit einem Prompt und am Ende für die Experimente ein. Der Engpass verlagert sich auf die Auswahl der Hypothesen, die Anthropic inzwischen selbst als Forschungsgegenstand untersucht. Vorsicht bleibt geboten: Die Funktion von ART ist unbekannt, und das Ergebnis liegt bislang als Preprint vor. Derselbe Ansatz, viele Agenten einzusetzen und ihre Arbeit an Messwerten auszurichten, zeigt sich im Sprint zur Beschleunigung von claude.ai mit mehr als 3 000 Änderungen sowie bei der formalen Verifizierung des Claude Agent SDK mit Lean.
Die Sicherheit von Agenten-Sandboxes wird öffentlich diskutiert. Das Audit von Perplexity unterscheidet zwei Schutzgrenzen: Die Isolation der virtuellen Maschine hielt bei allen 108 Versuchen stand. Die Netzwerkfilterung wurde in 11 von 54 Fällen überwunden, als Modelle eine unzureichend geprüfte DNS-Konfiguration oder gemeinsam genutzte Adressen eines CDN ausnutzten. Bei 8 von 10 Drittanbieterplattformen gab es mindestens eine Möglichkeit zur Umgehung. Zwei Modelle, Fable und GPT-6 Astra, verweigerten die Aufgabe. Am selben Tag liefert die GitHub-Copilot-App eine lokale Sandbox, die bei fehlendem Schutz die Ausführung verweigert; der Auto-Modus von Claude Code legt dem Klassifikator sogar reine Lesebefehle vor; und Vibe CLI sowie Kimi Code schließen Lücken bei der Autorisierung. Zwei Tage zuvor hatte ZCode nach von seiner Community gemeldeten Problemen seinen Code veröffentlicht.
Sprache wird zur Schnittstelle für Handlungen. Gemini 3.8 Flash TTS und Flash-Lite TTS machen die Audioausgabe mehr als doppelt so günstig wie in der vorherigen Vorabversion (9 beziehungsweise 6 Dollar pro Million Tokens bis Ende 2026 statt 20) und ergänzen Stimmreplikation mit aufgezeichneter Einwilligung. Diese ist über AI Studio im Europäischen Wirtschaftsraum nicht verfügbar. Qwen kündigt Preissenkungen von 70 bis 95 % für seine Audio-Pipeline an, NVIDIA veröffentlicht ein Modell, das acht Sprecher unterscheiden kann, und Basis stellt 1 500 Stunden Gespräche mit sich überschneidenden Stimmen bereit. Gleichzeitig geht ChatGPT Voice mithilfe der Plugins und Aufgaben von ChatGPT Work vom Gespräch zum Handeln über.
Auch physische KI wird zugänglicher, allerdings mit Unterschieden. FLUX 3 Action setzt ein Modell mit 7 Milliarden Parametern an die Spitze von RoboLab-120, integriert es gemeinsam mit NVIDIA in LeRobot und zeigt, dass eine schnelle, zuverlässige Steuerung den Bedarf an kostspieligem Reasoning senkt: 8,77 Dollar pro Erfolg mit GPT-6 Astra als Supervisor gegenüber 13,47 Dollar für Astra allein. „Offen“ bedeutet jedoch nicht überall dasselbe: Für FLUX 3 Action und Basis Conversations 1500 gelten jeweils eigene Lizenzen, für QVAC Genesis III eine nicht kommerzielle Lizenz; bei Qwen Intelligence wurden Benchmarks veröffentlicht, aber keine Modellgewichte. Wer diese Ressourcen weiterverwenden will, muss die Lizenz ebenso berücksichtigen wie den Score.
Quellen
- Claude entdeckt ein neuartiges Enzymsystem mit CRISPR-ähnlichen Wiederholungen (Anthropic)
- ART-Preprint (PDF, Anthropic)
- @AnthropicAI: das von Claude entdeckte Enzymsystem
- Gemini 3.8 Flash TTS und Flash-Lite TTS (Google)
- Versionshinweise zur Gemini API, 22. September
- Preise der Gemini API
- FLUX 3 Action (Black Forest Labs)
- @bfl_ai: Einführung von FLUX 3 Action
- FLUX 3 Action-Sammlung auf Hugging Face
- Escaping SPACE, Teil I (Perplexity)
- Claude Code v2.1.281
- Wie wir claude.ai in zwei Wochen dreimal schneller gemacht haben (claude.dev)
- Claude Marketplace (Anthropic)
- @OpenAI: ChatGPT Voice mit Plugins und in ChatGPT Work
- Hilfeartikel zu ChatGPT Voice
- Versionshinweise zu ChatGPT
- Vorstellung von MentalHealthBench (OpenAI)
- SWE-Serve (NVIDIA)
- Repository NVIDIA/swe-serve
- Runway ist jetzt in DaVinci Resolve verfügbar
- Gemini Omni 1.1 Flash in Google Vids
- Made On YouTube 2026
- Zusammenfassung von Made On YouTube 2026 (Google)
- Neue verbundene Apps für Gemini
- @GeminiApp: 13 neue verbundene Apps
- @Muse: vier kommende Connectors
- @ElevenLabs: ElevenLabs kommt zu Muse
- @HeyGen: HeyGen schließt sich Muse an
- @grok: Grok Bot in Tesla-Fahrzeugen
- @Tesla: Grok und die Connectors
- @bot: Grok Bot mit Google Slides, Sheets und Docs verbunden
- Lokale Modelle im Antigravity SDK (Google Developers)
- Antigravity-Changelog
- Persistenter Speicher für Private AI Compute (Google DeepMind)
- @Alibaba_Qwen: Qwen Intelligence
- Qwen-Planner-Agent-Bericht
- @Alibaba_Qwen: Qwen-Audio-3.1
- Qwen-Audio-3.1-Realtime auf QwenCloud
- Versionshinweise zu Mistral
- Vibe CLI 2.25.8
- @zcode_ai: Veröffentlichung des Quellcodes von ZCode
- Repository zai-org/ZCode
- Kimi Code 2.1.0
- DeepSeek Harness v0.1.7-rc.1
- GenCode (Genspark)
- @genspark_ai: Einführung von GenCode
- Copilot für JetBrains 1.18.0 (GitHub Changelog)
- Lokale Sandbox in der GitHub Copilot App (GitHub Changelog)
- Rollouts und Security Review (Cursor-Changelog)
- Verbesserte Tokeneffizienz (Cursor)
- Nemotron 3 Diarization (NVIDIA, Hugging Face-Blog)
- AI Day Singapore (NVIDIA)
- Canary-Rollouts (Together AI)
- NVIDIA Cluster Readiness Engine (NVIDIA)
- NodeWright (NVIDIA)
- Basis Conversations 1500 (Hugging Face-Blog)
- QVAC Genesis III (Hugging Face-Blog)
- Ai2 und Global Fishing Watch (Skylight)
- Google.org und die Gates Foundation (blog.google)
- Pressemitteilung der Gates Foundation
- Vorbereitung auf KI-gestützte Projekte zur Code-Modernisierung (Anthropic)
- @bcherny: formale Verifikation des Claude Agent SDK in Lean
- Codex CLI 0.156.1
- Airbnb und GPT-6 Astra (OpenAI)
- Zwei Jahre OpenAI Academy
- Wie ich meine LED-Anzeige zum Leben erweckt habe (OpenAI Developers)
- MedGemma und die globale Gesundheit (Google)
- Gemini Notebook in Google Docs (Workspace Updates)
- Sechs Google Flow-Tools (Google Labs)
- Google Beam wird auf sechs Länder ausgeweitet (Google)
- Neuerungen in Android Enterprise 2026 (Google)
- AI Brief und AI Max (Google Ads)
- Gemini CLI v0.62.0-nightly.20260923
- Drei von zehn Optimierungen brachten nichts (EcoHash)
- Spracherkennung für Krimtatarisch (Hugging Face-Blog)
- Fine-Tuning von Falcon-H1 auf einem Mac (Hugging Face-Blog)
- Der Weg in die Open-Source-Hölle ist mit guten Absichten gepflastert (Hugging Face-Blog)
- Das Dashboard zeigt PASS. Was genau hat bestanden? (Phionyx)
- Versionshinweise zu Kimi Work
- @arena: Qwen-Image-2.1 als führendes offenes Modell
- OpenTelemetry in der GitHub Copilot App
- C++-Code-Intelligence in Copilot CLI
- Darstellung umfangreicher Pull Requests in der GitHub Copilot App
- @genspark_ai: Claude Opus 5.5 in Genspark
- Studie von GitHub und Yale zur Softwareeffizienz
- Zed 1.21.0
- @warpdotdev: GPT-6 Sol und Luna in Warp
- Devin, Microsoft Teams und Microsoft 365
- @ElevenLabs: Scribe v2 Medical
- ElevenLabs-Changelog vom 23. September
- @cohere: Model Vault in Kanada
- Change Management für KI (Cohere)