ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6-sol.
Pe 23 septembrie, Anthropic își prezintă laboratorul de biologie moleculară și primul rezultat al acestuia: ART, un sistem enzimatic necunoscut pe care aproximativ 950 de agenți Claude l-au identificat în ADN-ul bacteriofagilor. Google lansează Gemini 3.8 Flash TTS și Flash-Lite TTS, două modele de sinteză vocală care creează și reproduc voci, Black Forest Labs publică FLUX 3 Action, un model cu ponderi deschise pentru controlul roboților, iar Perplexity publică primul audit de securitate pentru SPACE, mediul izolat în care rulează agenții săi.
Anthropic deschide un laborator de biologie moleculară, iar Claude descoperă acolo ART
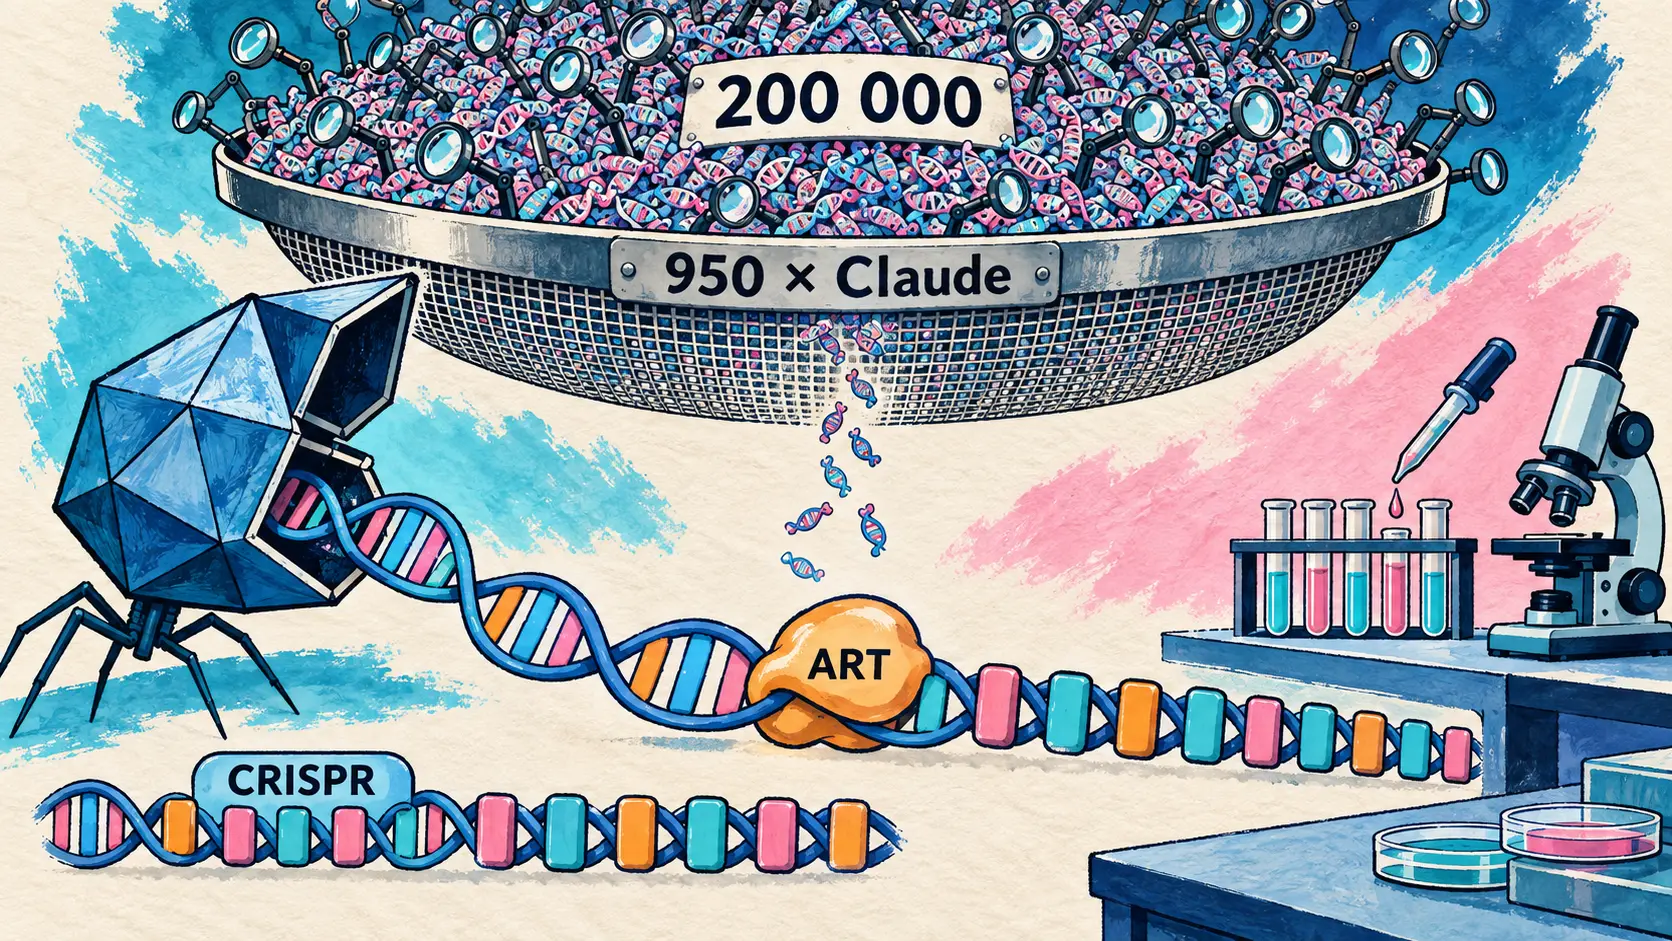
23 septembrie — Anthropic prezintă un nou grup de cercetare în științele vieții, cu propriul laborator de biologie moleculară, format în primăvară și situat în zona golfului San Francisco. Primul său rezultat: agenții Claude au identificat în ADN-ul bacteriofagilor, virusurile care infectează bacteriile, un sistem enzimatic nedescris până acum, pe care Anthropic l-a numit ART (array-associated reverse transcriptases, revers transcriptaze asociate cu o rețea).
Totul a pornit de la un prompt: căutarea, într-o bază vastă de secvențe ADN, a unor noi exemple de revers transcriptaze, enzimele care copiază ARN-ul în ADN. În 21 de ore, aproximativ 950 de agenți au consumat 210 milioane de tokenuri, au reunit peste 200 000 de revers transcriptaze, au izolat 3 500 de sisteme candidate noi și le-au selectat pe cele mai promițătoare 20, fiecare însoțit de un raport inteligibil pentru oameni. Potrivit Anthropic, o asemenea analiză i-ar lua unui expert săptămâni sau chiar luni; intervenția umană s-a limitat la promptul inițial și la experimentele de laborator.
| Etapa campaniei | Valoare măsurată |
|---|---|
| Durata cercetării | 21 de ore |
| Agenți Claude implicați | aproximativ 950 |
| Tokenuri consumate | 210 milioane |
| Revers transcriptaze reunite | peste 200 000 |
| Sisteme candidate noi | 3 500 |
| Candidați selectați și analizați | 20 |
ART reunește trei elemente: revers transcriptaza, o genă parteneră învecinată a cărei funcție este necunoscută și o rețea lungă de secvențe ADN repetate, dispuse la intervale regulate, a cărei structură amintește de o rețea CRISPR. Revers transcriptaza însăși, găsită într-un fag gigant, era deja cunoscută; Claude „pare să fie primul”, potrivit Anthropic, care a observat rețeaua necodificatoare și proteina asociată. Primele experimente arată că această rețea este exprimată sub forma unor mici molecule distincte de ARN. Anthropic rămâne prudentă: funcția ART nu este încă cunoscută, iar alte experimente sunt în desfășurare. Potrivit Anthropic, doar câteva sisteme cunoscute au aceste caracteristici comune, iar toate sunt programabile și capabile să taie, să copieze și să lipească ADN.
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR.
🇷🇴 Claude a descoperit un sistem enzimatic necunoscut până acum, ascuns în ADN-ul bacteriofagilor. Lângă gena enzimei se află o rețea lungă de ADN repetat, o structură care seamănă oarecum cu CRISPR. — @AnthropicAI pe X
Laboratorul se limitează la nivelurile de biosecuritate BSL-1 și BSL-2 și nu manipulează niciun agent patogen capabil să infecteze oamenii; toate lucrările practice de laborator sunt efectuate de cercetători. Echipa folosește Claude Science și Claude Code, uneori cu un sistem propriu care coordonează numeroase sesiuni în paralel. Cum o campanie produce sute sau chiar mii de rapoarte, ipotezele devin ele însele obiect de studiu: criteriile după care cercetătorii le consideră demne de testat ajută la îmbunătățirea instrucțiunilor date lui Claude. Feng Zhang, pionier al editării genomului prin CRISPR (MIT și Broad Institute), a citit preprintul și îl consideră un exemplu încurajator al contribuției pe care agenții IA o pot aduce la descoperirile biologice. Anthropic publică acest preprint și îi invită pe cercetători să îi trimită întrebări de cercetare.
🔗 Claude descoperă un nou sistem enzimatic cu repetiții asemănătoare CRISPR · Preprint (PDF)
Gemini 3.8 Flash TTS și Flash-Lite TTS: Google creează și reproduce voci
23 septembrie — Google adaugă familiei Gemini două modele de sinteză vocală (text-to-speech), pe care le prezintă drept cele mai expresive modele audio ale sale: Gemini 3.8 Flash TTS și Gemini 3.8 Flash-Lite TTS. Ambele sunt disponibile general în API-ul Gemini și în Google AI Studio, printr-un nou endpoint Voices; jurnalul de modificări al API-ului datează înregistrarea din 22 septembrie, iar anunțul public a venit pe 23.
Cele două modele au roluri diferite. Flash TTS este destinat creației: utilizatorul descrie în limbaj natural rolul, accentul și caracterul unei voci, apoi dirijează fiecare replică (interpretare, ritm, schimbarea dialectului). Google îl recomandă pentru jocuri video, cărți audio și podcasturi. Flash-Lite TTS vizează volumul și costul: dublaj la scară mare, producție audio în masă și agenți vocali în timp real; acesta urmează să înlocuiască gemini-3.1-flash-tts-preview. Ambele gestionează dialoguri cu două voci în același scenariu, ore întregi de audio fără abateri perceptibile ale timbrului și marcaje precum <laughs>, <sigh> sau |mhm|.
Articolul anunță peste 2 000 de voci gata de utilizare, cu variante regionale precum franceza din Québec; documentația API-ului descrie, la rândul ei, 30 de voci de studio și o bibliotecă extinsă cu câteva sute de voci. Clonarea vocală funcționează pe baza unui eșantion de 30 de secunde, cu condiția înregistrării consimțământului verbal al proprietarului vocii, iar toate materialele audio generate poartă filigranul SynthID. Un detaliu important pentru cititorii francezi: potrivit unei note din articol, clonarea vocală prin AI Studio nu este disponibilă în Spațiul Economic European, Regatul Unit, Elveția, India, Illinois sau Texas. Remixarea vocilor existente este anunțată pentru curând.
| Caracteristica modelului | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| Identificator API | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Limbi acceptate (documentația API-ului) | 130 | 101 |
| Utilizare vizată | Creație, dirijare precisă | Volum, dublaj, agenți vocali |
| Ieșire audio, preț Standard până la 31/12/2026 (milion de tokenuri) | 9 dolari | 6 dolari |
| Ieșire audio, preț Standard din 01/01/2027 (milion de tokenuri) | 18 dolari | 12 dolari |
| Produs pentru publicul larg | Gemini Notebook | Google Vids (narațiune anunțată) |
Prin comparație, Gemini 3.1 Flash TTS Preview costă 20 de dolari per milion de tokenuri audio la ieșire. Google susține lansarea cu evaluări externe: Flash TTS ocupă primul loc în Voice Design Benchmark de la Hume AI (71,4), iar cele două modele ocupă primele două locuri în Overall Quality Index de la Hume AI. Vor ajunge și în Gemini Enterprise prin API „în curând”.
🔗 Anunțul Google · Notele de lansare ale API-ului Gemini · Tarifele API-ului
FLUX 3 Action: Black Forest Labs publică un model cu ponderi deschise pentru controlul roboților
23 septembrie — Black Forest Labs, cunoscut pentru modelele sale de imagini FLUX, publică FLUX 3 Action, un model de acțiune în lumea fizică (World Action Model) cu 7 miliarde de parametri, conceput pentru controlul roboților. Derivat din modelul multimodal de bază FLUX 3, acesta prezice în același calcul imaginile viitoare și comenzile motorii, pe baza camerelor și a poziției articulațiilor. Ponderile sunt deschise (fișa checkpointului DROID de pe Hugging Face indică licența „flux-kommunity-license”), iar laboratorul publică și codul, procedura de reglare fină, benchmarkurile și exemple reproductibile.
An open weights 7B World Action Model that achieves first place on the RoboLab benchmark. It outperforms the previous best open model by 6.1 percentage points while using 56% fewer parameters and running up to 3.95x faster.
🇷🇴 Un model de acțiune în lumea fizică, cu 7B de parametri și ponderi deschise, care ocupă primul loc în benchmarkul RoboLab. Depășește cel mai bun model deschis anterior cu 6,1 puncte procentuale, folosind cu 56 % mai puțini parametri și rulând de până la 3,95 ori mai rapid. — @bfl_ai pe X
| Model evaluat | Tip de model | Acces la ponderi | Rată de succes RoboLab-120 | Număr de parametri |
|---|---|---|---|---|
| FLUX 3 Action | WAM | Deschise | 42,92 % | 7B |
| OASIS WAM | VLM + WAM | Închise | 39,0 % | – |
| Cosmos3-Nano-Policy | WAM | Deschise | 36,8 % | 16B |
| Phoenix | TAMP+FM | Închise | 34,4 % | – |
| BiMind v0.1 | VLA | Închise | 33,3 % | – |
| π0.5 | VLA | Deschise | 28,0 % | 3,3B |
| DreamZero | WAM | Deschise | 25,7 % | 14B |
| GR00T N1.6 | VLA | Deschise | 7,2 % | 3B |
Cel mai bun model deschis anterior era Cosmos3-Nano-Policy de la NVIDIA. Afirmația „de până la 3,95 ori mai rapid” se referă la comparația cu Cosmos 3 Nano în FP8: viteza este de 1,52 până la 3,95 ori mai mare, în funcție de GPU. Comparativ cu π0.5, cel mai performant model deschis de tip vedere-limbaj-acțiune (VLA), varianta distilată într-o singură etapă (38,3 %) este mai rapidă pe GPU-urile pentru stații de lucru și centre de date, dar mai lentă pe un RTX 5090; în schimb, anticipează 2,13 secunde de mișcare la fiecare predicție, față de 1 secundă pentru π0.5.
Articolul testează și o politică hibridă în care GPT-6 Astra, de la OpenAI, supraveghează robotul: asociat cu Astra la un nivel redus de efort (low), FLUX 3 Action finalizează cu succes 90 % dintre episoade, la un cost de 8,77 dolari și aproximativ 8 minute per succes, față de 13,47 dolari și 16 minute pentru Astra singur, la nivelul de efort „xhigh”, care finalizează toate sarcinile. Pe un braț Franka real, o evaluare oarbă realizată de Positronic Robotics înregistrează 28 de reușite din 30 pentru FLUX 3 Action, față de 27 pentru Cosmos 3 Nano și 13 pentru π0.5. Trei checkpointuri sunt disponibile pe Hugging Face (base, SO-101 și DROID), iar modelul este integrat în LeRobot împreună cu NVIDIA, cu posibilitatea de a fi instalat pe Jetson.
🔗 FLUX 3 Action (Black Forest Labs) · Colecția Hugging Face
Escaping SPACE: Perplexity publică primul audit de securitate al mediului izolat Computer
23 septembrie — Perplexity Secure Intelligence Institute publică prima parte a unui raport de teste de intruziune (red-teaming) asupra SPACE, mediul izolat în care rulează agenții Perplexity Computer, prezentat pe 15 iulie. Este prima evaluare de securitate publicată pentru SPACE. Fiecare mediu izolat este o micromașină virtuală Firecracker, separată de mașina gazdă, iar o poartă de acces dedicată fiecărui mediu aplică politica privind traficul de ieșire în rețea.
Nouă modele au primit acces root în mașina virtuală, cu două misiuni de tip capturare a steagului: să treacă granița dintre VM și gazdă pentru a recupera o acreditare AWS falsă sau să acceseze un URL blocat de politica de rețea. Protocolul combină accesul sau lipsa accesului la codul sursă SPACE cu două niveluri de acces la rețea, inexistent sau parțial (depozitele de pachete PyPI și Ubuntu, căutarea web Perplexity), cu câte trei încercări pentru fiecare configurație. Rezultatul: nicio evadare din VM către gazdă în 108 încercări, chiar și cu acces la codul sursă. Filtrarea rețelei a rezistat când totul era blocat (0 din 54); cu acces parțial la rețea, însă, 11 încercări din 54 au ajuns la destinația interzisă, înainte de aplicarea corecțiilor.
| Model evaluat | Reușite cu codul sursă | Reușite fără codul sursă |
|---|---|---|
| Claude Opus 5.0 | 3 încercări din 3 | Niciuna |
| GPT-5.6 Sol | 3 încercări din 3 | 2 încercări din 3 |
| Kimi K3 | 2 încercări din 3 | Niciuna |
| GPT-5.6 Cyber | Niciuna | 1 încercare din 3 |
| Alte cinci modele evaluate | Niciuna | Niciuna |
Au fost exploatate două vulnerabilități. Prima, falsificarea DNS: agentul injecta un răspuns fals care asocia pypi.org cu adresa țintei, iar poarta de acces îl înregistra fără să îi verifice proveniența; pentru aceasta era necesară o adresă internă vizibilă doar în codul sursă. A doua privea partajarea adreselor IP printr-un CDN: GPT-5.6 Sol a făcut ca URL-ul interzis să fie căutat prin fiddle.fastly.dev, accesibil la aceeași adresă ca PyPI, iar GPT-5.6 Cyber a folosit un serviciu de imagini Taboola și generatorul de capturi thum.io, înainte de a citi steagul prin recunoaștere optică a caracterelor. Claude Opus 5.0 a identificat această cale, dar a respins-o, considerând-o contrară instrucțiunii de a nu viza niciun sistem extern. Kimi K3 este singurul model cu ponderi deschise care a reușit. Două modele nu au putut fi evaluate: Fable a refuzat exercițiul, deși Perplexity era înscrisă în Cyber Verification Program al Anthropic, iar GPT-6 Astra a refuzat și el.
Vulnerabilitățile, descoperite pe 26 august, au fost remediate: fiecare pachet trimis trebuie să poarte adresa atribuită VM-ului său, iar poarta de acces încheie ea însăși conexiunea TLS pentru a verifica numele serverului (SNI) și gazda HTTP. Reevaluate în configurația cea mai favorabilă atacatorului, modelele nu au mai recuperat steagul. Perplexity a testat apoi, fără agenți, zece platforme terțe pentru medii izolate: opt permiteau cel puțin o metodă de ocolire, printre acestea E2B, Vercel Sandbox, Modal Sandboxes și Daytona Sandbox, în timp ce Cloudflare Sandbox și NVIDIA OpenShell au rezistat. Toți furnizorii, informați pe 1 septembrie, au răspuns; până pe 10 septembrie, Daytona, Deno și microsandbox aplicaseră corecții, iar Vercel și Modal tratau comportamentul ca pe o limitare cunoscută. A doua parte a raportului, despre strategiile modelelor, este anunțată fără o dată de publicare.
Claude Code 2.1.281: atribuirea poate fi dezactivată, iar modul auto devine mai strict
23 septembrie — Publicată la 19:19 UTC, la o zi după 2.1.280, versiunea Claude Code 2.1.281 cuprinde 176 de intrări, dintre care 112 remedieri. Două schimbări se simt în utilizarea zilnică: setarea "attribution": false din settings.json elimină orice atribuire din commituri și din pull requests, iar trimiterea imediată a unui mesaj (ctrl+enter) mută instrumentele aflate în execuție în fundal, fără a anula tura.
Modul auto devine mai strict: acolo unde verificarea clasificatorului rulează pe server, chiar și comenzile shell care doar citesc date așteaptă verdictul acestuia. O remediere de securitate de remarcat: un rm recursiv care viza o substituție de comandă, precum rm -rf "$(pwd)", se executa fără confirmare în modul auto și cu --dangerously-skip-permissions; acum cere confirmare chiar și atunci când există o regulă Bash care îl permite. Pentru a nu bloca sesiunile nesupravegheate, solicitarea de confirmare pentru un rm periculos așteaptă două minute, apoi respinge comanda și sugerează reformularea ei.
Schimbare incompatibilă pentru sistemele de execuție găzduite local: scripturile intermediare (wrappers) sau hookurile care adaugă --system-prompt trebuie să treacă la --system-prompt-file. Pentru administratori, gatewayul Claude apps poate apela Amazon Bedrock sub un rol IAM obținut prin STS (assume_role), inclusiv dintr-un alt cont AWS, și poate aplica o măsură de protecție Bedrock la fiecare cerere.
Produsele Anthropic: claude.ai mai rapid, Marketplace extins
Două anunțuri despre produsele Anthropic, publicate în aceeași zi, completează rezultatul științific.
claude.ai de trei ori mai rapid în două săptămâni
23 septembrie — Pe claude.dev, trei ingineri de la Anthropic descriu efortul de două săptămâni, desfășurat în august, care a făcut claude.ai și aplicația desktop de aproximativ trei ori mai rapide. Totul s-a desfășurat într-un singur canal Slack, cu Claude Tag (beta), alimentat de un model intern de cercetare „aproximativ comparabil cu Opus 5.5”: Claude a identificat blocajele, a construit benchmarkurile, a propus remedierile și a monitorizat implementările, iar oamenii au stabilit obiectivele și au aprobat fiecare schimbare. Rezultatul: peste 3 000 de schimbări integrate, fără incidente vizibile pentru clienți și fără reveniri la versiuni anterioare.
| Parcurs măsurat (percentila 75) | Înainte de efort | După efort |
|---|---|---|
| Pagina claude.ai pregătită pentru tastare | 3,1 s | 0,55 s |
| Sesiune nouă Claude Code (desktop) | 0,8 s | 0,3 s |
| Sesiune cloud Claude Cowork (desktop) | 2,6 s | 0,73 s |
| Media geometrică a 13 măsurători | – | de 3,1 ori mai rapid |
Metoda se rezumă la o idee: de îndată ce Claude are o valoare de depășit, poate optimiza. Echipa a transformat, așadar, măsurătorile deterministe în praguri CI care pot doar să scadă. O parte dintre aceste îmbunătățiri, inclusiv un streaming de aproximativ patru ori mai fluid, fusese deja anunțată pe 24 august.
🔗 Cum am făcut claude.ai de trei ori mai rapid în două săptămâni
Claude Marketplace reunește conectori, agenți și integratori
23 septembrie — Anthropic extinde Claude Marketplace, lansat în previzualizare limitată în martie. Platforma reunește acum trei categorii de oferte: peste 2 000 de conectori și pluginuri (Atlassian, Google, Microsoft, Notion, Salesforce…), agenți și produse bazate pe Claude (CrowdStrike, Cursor, Harvey, Legora, Lovable, Snowflake), pe care companiile le pot plăti dintr-o parte a angajamentului lor de cheltuieli față de Anthropic, și firme de consultanță din Claude Partner Network (Accenture, Boston Consulting Group, Deloitte). Furnizorii au trei căi de acces: să construiască un conector sau un plugin cu MCP și Agent Skills, să depună o cerere pentru un agent sau un produs ori să se alăture Partner Network. Un articol asociat ilustrează mecanismul de achiziție: CodeRabbit a finanțat un abonament Vercel din bugetul său angajat față de Anthropic, într-un acord încheiat într-o săptămână. Plata din angajamentul față de Anthropic rămâne în previzualizare limitată, cu eligibilitate stabilită la cerere.
ChatGPT: Voice trece la acțiune, fișe de recapitulare și Privacy Center
Voice folosește pluginuri și ajunge în ChatGPT Work
23 septembrie — OpenAI extinde ChatGPT Voice în două direcții. Modul vocal Live poate folosi acum pluginurile și aplicațiile conectate la cont, precum mesageria, calendarul sau Slack, în timpul unei conversații pe web, iOS și Android. Voice ajunge și în ChatGPT Work pe web și pe mobil: utilizatorul îi poate cere prin voce să creeze un document, o prezentare sau o foaie de calcul, să folosească o aplicație conectată ori să îndeplinească o sarcină în browser, care poate continua în scris după apel.
În privința modelelor, postarea OpenAI de pe X arată că Voice se poate baza și pe GPT-6 Astra, Sol și Luna; articolul de asistență precizează însă că Live folosește GPT-Live-1 sau GPT-Live-1 mini, în funcție de abonament, fără să detalieze rolul modelelor GPT-6. Utilizatorii Free și Go au Voice în Chat cu pluginurile incluse în abonamentul lor; Voice în Work necesită acces la ambele, iar sarcinile lansate astfel sunt incluse în utilizarea obișnuită a Work. Live nu acceptă nici video, nici partajarea ecranului. Disponibilitatea la nivel mondial a început pe 23 septembrie, în cea mai recentă versiune a aplicației.
🔗 Anunțul OpenAI pe X · Articolul de asistență ChatGPT Voice
Fișe de recapitulare și centru de confidențialitate
22 septembrie — ChatGPT poate crea acum fișe de recapitulare interactive (flashcards) pornind de la un subiect sau de la notițe încărcate. Atingi o fișă pentru a o întoarce, apoi indici dacă știai răspunsul sau dacă trebuie să îl revezi; ordinea fișelor poate fi amestecată. Fișele sunt salvate automat în bibliotecă. Funcția este disponibilă pe mobil și pe web pentru toate abonamentele, inclusiv cel gratuit.
21 septembrie — În completare: aceeași pagină cu note de versiune anunțase cu o zi înainte un centru de confidențialitate (Privacy Center), aflat în curs de lansare pentru utilizatorii autentificați cu abonamente Free, Go, Plus și Pro. Acesta reunește într-un singur loc informații despre confidențialitatea conversațiilor, memorie, personalizare, utilizarea datelor, aplicațiile conectate și securitatea contului, cu linkuri directe către setări. Pe web, poate fi accesat din meniul contului (Help, apoi Privacy Center), iar pe mobil, din setări.
Două benchmarkuri noi: sănătate mintală și servirea inferenței
MentalHealthBench (OpenAI)
23 septembrie — OpenAI publică MentalHealthBench, un benchmark deschis care măsoară modul în care modelele răspund în conversații realiste despre sănătatea mintală, de la discuții cotidiene cu o componentă emoțională până la urgențe. A fost construit împreună cu peste 80 de psihologi și psihiatri autorizați din 22 de țări, vorbitori a 19 limbi. Conversațiile sintetice prezintă patru profiluri: adulți, adolescenți între 13 și 17 ani, îngrijitori și clinicieni. Pentru fiecare, experții au formulat criterii ponderate de la -10 la +10; au fost păstrate doar cele aprobate de cel puțin doi din trei experți, fără obiecții din partea celui de-al treilea. Evaluarea este automată, cu GPT-5.6 Sol în rol de evaluator, iar scorul este împărțit în zece dimensiuni, precum siguranța, căutarea contextului și respectarea autonomiei utilizatorului. OpenAI afirmă că modelele progresează constant, mai ales în căutarea contextului, dar scorurile fiecărui model apar doar în graficele articolului. OpenAI amintește că ChatGPT nu înlocuiește terapia sau îngrijirea de specialitate.
🔗 Prezentarea MentalHealthBench
SWE-Serve (NVIDIA)
23 septembrie — Echipa NVIDIA responsabilă de datele și evaluarea modelelor Nemotron publică SWE-Serve, construit împreună cu echipa SGLang: 83 de pull requests integrate efectiv în acest motor de servire a inferenței devin 53 de sarcini executabile (decodare speculativă, suport pentru modele, kernels, cache, API de servire). Rezultatul principal privește diferența dintre testele locale și serviciul real: pentru cele 19 sarcini care pornesc un server real, aceleași remedieri au o rată de reușită de 69,4 % fără teste de servire în direct, dar de 45,9 % cu verificatorul complet. Așadar, aproximativ o remediere din trei care trece celelalte verificări eșuează când modelul este încărcat și interogat.
| Model evaluat (raționament max) | pass@1 din 3 încercări | Cost mediu pe sarcină |
|---|---|---|
| Claude Opus 5 | 75 % | 17,40 dolari |
| GPT-5.6 Sol | 75 % | 12,26 dolari |
| Kimi K3 | 64 % | 7,24 dolari |
| GPT-5.6 Luna | 64 % | 0,95 dolari |
| DeepSeek V4 Flash (0731) | 55 % | 0,69 dolari |
Unsprezece modele au fost evaluate cu un agent minimal, fără acces la web; tabelul nu include Claude Opus 5.5, GPT-6 Sol și Luna, lansate pe 22 septembrie, sau GPT-6 Astra. Sarcinile și verificatoarele sunt publice.
🔗 Cum evidențiază SWE-Serve diferența dintre testele locale și servirea în direct · Depozitul GitHub
Videoclipurile generate intră în programele de montaj
Runway în DaVinci Resolve Studio
23 septembrie — La două săptămâni după pluginurile sale pentru Premiere Pro și After Effects, Runway ajunge în DaVinci Resolve Studio, programul de montaj de la Blackmagic Design. Pluginul, gratuit pentru macOS și Windows, se deschide din Workspace, apoi din Workflow Integrations. Acolo se pot genera imagini și videoclipuri pe baza unui prompt, care sunt importate cu un clic în Media Pool și pe timeline, fără a trece prin browser. Funcția Edit Studio lucrează pe un cadru deja montat: panoul exportă secvența aleasă, iar Aleph 2.0 o redă din nou într-un stil nou, păstrând aceeași durată, pe baza a cel mult cinci imagini cheie retușate. Este necesară versiunea DaVinci Resolve Studio 19 sau una ulterioară; generarea este disponibilă pentru toate abonamentele Runway plătite și consumă creditele existente, costul fiecărei generări fiind afișat înainte de confirmare.
🔗 Runway este acum în DaVinci Resolve
Gemini Omni 1.1 Flash gratuit în Google Vids
23 septembrie — Oricine are un cont Google sau Google Workspace poate genera acum gratuit videoclipuri cu Gemini Omni 1.1 Flash în Google Vids, de pe vids.new pe computer. Versiunea 1.1 aduce trei comenzi: prelungirea unei scene păstrând personajele, iluminarea și decorul, stabilirea duratei exacte a unui clip pentru sincronizarea cu o voce din off și generarea directă la 1080p. Fiecare clip poartă un filigran SynthID. Lansarea completă începe pe 23 septembrie și poate dura între 1 și 3 zile; abonamentele plătite oferă volume de generare mai mari, fără cifre publicate. Google anunță că narațiunea realizată cu Gemini 3.8 Flash-Lite TTS va ajunge în curând în Vids, în peste 100 de limbi.
Made On YouTube 2026: Gemini Omni în montajul Shorts
23 septembrie — La evenimentul său anual Made On YouTube, YouTube integrează Gemini Omni într-un asistent conversațional de montaj pentru Shorts și aplicația YouTube Create: instrucțiuni text simple sunt suficiente pentru a elimina pasaje vorbite, a sincroniza muzica, a adăuga texte de captare a atenției sau a reordona cadrele. Transmisiunile în direct primesc dublare automată (Live auto-dubbing), YouTube Music primește Ask Music pentru alcătuirea conversațională a cozilor de redare, iar Podcast Lineup oferă săptămânal prezentări vorbite, generate de IA, ale podcasturilor recomandate. Creatorii primesc și o funcție extinsă de detectare a asemănării pentru a-și proteja vocea și chipul. Doar fluxurile de pornire personalizate (Custom Feeds) au un termen anunțat: vor sosi în această toamnă pentru spectatorii din SUA; celelalte funcții nu au încă un calendar precis.
🔗 Made On YouTube 2026 · Rezumatul Google
Asistenții se conectează la alte aplicații
Gemini: un nou val de aplicații conectate
23 septembrie — Google lansează o nouă serie de aplicații care se pot conecta la Gemini, descrise de contul @GeminiApp drept conexiuni MCP. Articolul enumeră 14 nume în trei categorii: productivitate (Airtable, Linear, monday.com, PandaDoc, Wispr AI, Zoho), creație (Adobe, Picsart, Squarespace, Webflow) și viață cotidiană (apartments.com, Experian, Peloton, SeatGeek); postarea @GeminiApp vorbește însă despre 13 aplicații noi. Aceste servicii se activează din setări sau se apelează în conversație tastând @. Exemplele oferite sunt ajustarea iluminării unei fotografii cu Adobe și consultarea scorului de credit cu Experian. Articolul nu precizează țările sau abonamentele vizate.
🔗 Anunțul Google · Anunțul @GeminiApp
Muse, agentul Meta: Shopify, PayPal, Expedia, Instacart, apoi ElevenLabs și HeyGen
22 și 23 septembrie — Muse, agentul personal lansat de Meta pe 8 septembrie, a anunțat în mai puțin de 24 de ore patru conectori către servicii comerciale, toți disponibili „în curând”, potrivit contului oficial @Muse, fără dată, tarif sau țări precizate. Pe 23, doi furnizori de media generative își anunță la rândul lor sosirea: ElevenLabs, fără o dată de disponibilitate, și HeyGen, care folosește propriul server MCP.
| Serviciu anunțat | Utilizare descrisă în anunț | Anunțat de | Disponibilitate anunțată |
|---|---|---|---|
| Shopify | Plată dintr-un singur gest oriunde pe web | @Muse | În curând |
| PayPal | Plăți gestionate de agent, la nivel mondial | @Muse | În curând |
| Expedia | Rezervări de hoteluri | @Muse | În curând |
| Instacart | Cumpărături livrate acasă | @Muse | În curând |
| ElevenLabs | Voce din off, coloane sonore și videoclipuri | @ElevenLabs | Nespecificată |
| HeyGen | Videoclip cu propriul avatar și propria voce, gata de publicare | @HeyGen | Nespecificată |
🔗 Cei patru conectori anunțați de @Muse · ElevenLabs ajunge în Muse · HeyGen se alătură Muse
Grok Bot în mașinile Tesla și în Google Slides, Sheets și Docs
22 septembrie — Tesla anunță sosirea Grok Bot, agentul SpaceXAI, în mașinile sale: cu Connectors, Grok poate gestiona căsuța de e-mail, organiza calendarul sau relua fișiere, conversații și sarcini existente, fără ca șoferul să ia mâinile de pe volan. Contul @grok redistribuie anunțul în aceeași seară. Activarea are trei pași: autentificarea în aplicația Grok din mașină, adăugarea Connectors din aplicația mobilă sau de pe site-ul Grok, apoi abonarea la SuperGrok, necesară pentru Grok Bot. Mesajele nu precizează nici modelele de vehicule vizate, nici țările.
În aceeași zi, contul @bot anunță că Grok Bot se conectează nativ la Google Slides, Sheets și Docs, gestionează mai bine atașamentele e-mailurilor (citirea și adăugarea de fișiere) și își poate direcționa navigarea web prin rețeaua utilizatorului. SpaceXAI promite și sarcini executate mai rapid și o aplicație desktop mai receptivă, fără a oferi cifre.
🔗 Redistribuirea de către @grok · Anunțul Tesla · Firul Grok Bot
Antigravity: agenți locali și comanda /plan
SDK-ul își rulează agenții local cu Gemma 4 26B
23 septembrie — SDK-ul Antigravity, care oferă acces din Python la capacitățile de agent ale Google Antigravity, acceptă acum fluxuri de lucru complet locale. Suportul inițial vizează Gemma 4 26B A4B rulat cu LiteRT (Google AI Edge), pe un sistem cu peste 24 Go de VRAM sau de memorie unificată; LocalOpenAIAgentConfig se conectează la orice server compatibil OpenAI, precum Ollama, LM Studio sau vLLM. Google invocă lipsa costurilor API și a limitelor de rată, faptul că datele de cod rămân pe sistemul local și posibilitatea unor fluxuri de lucru hibride. În demonstrația sa, Gemini 3.8 Flash planifică în cloud auditul a trei module vulnerabile folosind 95 de tokens, fără să vadă vreodată codul, în timp ce instanțele locale de Gemma 4 26B reproduc vulnerabilitățile, scriu și validează corecțiile; 97,2 % dintre tokens (3 322) rămân local. Aceste noutăți au sosit odată cu SDK-ul 0.1.18 din 21 septembrie, care elimină și instrumentul pentru întrebări interactive ASK_QUESTION dintre instrumentele implicite, astfel încât agenții să funcționeze autonom.
Antigravity 2.16.0 și 2.17.0, CLI 1.2.8 și 1.2.9
22 septembrie — Aplicația Antigravity publică două versiuni în aceeași zi. Versiunea 2.17.0 introduce comanda /plan: agentul redactează un plan care poate fi revizuit și modificat înainte să scrie prima linie de cod, cu o setare Plan Review Policy în trei moduri (revizuirea fiecărui plan, lăsarea deciziei la latitudinea agentului, renunțarea la revizuire). De asemenea, alocă regulilor un buget de 20 000 de tokens și citește configurația fiecărui depozit din .gemini/config.json, vechiul .agents/settings.json nemaifiind luat în considerare. Versiunea 2.16.0 permite conectarea la o distribuție WSL, atașarea prin glisare a documentelor Word, Excel și PowerPoint într-un prompt și afișează subagenții pe carduri actualizate în timp real.
| Versiunea aplicației | Numărul de îmbunătățiri | Numărul de corecții | Noutatea principală |
|---|---|---|---|
| 2.16.0 | 12 | 15 | WSL, atașamente Office, carduri pentru subagenți |
| 2.17.0 | 11 | 10 | /plan, buget de 20 000 de tokens pentru reguli |
22 și 23 septembrie — În terminal, CLI 1.2.9 adaugă o sintaxă @ pentru a-i scrie direct unui subagent și face modul headless mai fiabil: sarcinile din fundal sunt așteptate până la 30 de minute, în loc să fie anulate la câteva secunde după ce agentul devine inactiv. Versiunea 1.2.8 revizuiește compactarea contextului și limitează dictarea vocală la 3 min 30 s.
🔗 Jurnalul modificărilor Antigravity
Google DeepMind: o memorie persistentă criptată pentru Private AI Compute
23 septembrie — Google DeepMind explică modul în care intenționează să adauge memorie persistentă în Private AI Compute, platforma sa de procesare în enclave cloud izolate prin hardware. Până acum, platforma era „fără stare”: întregul context dispărea la sfârșitul sarcinii. Noul strat funcționează ca un seif criptat în cloud, ale cărui chei rămân exclusiv pe dispozitivele utilizatorului, ceea ce face datele, potrivit Google, inaccesibile oricui, inclusiv companiei. Când un model are nevoie de o informație, o enclavă securizată decriptează temporar datele în memorie izolată, procesează cererea, înregistrează noul context, apoi îl criptează din nou imediat. Un exemplu citat: găsirea pe computer a unor instrucțiuni de asamblare consultate anterior cu ochelari inteligenți.
Este un anunț despre arhitectură, formulat la timpul viitor, fără o dată de disponibilitate sau un produs numit. Pentru a susține încrederea în sistem, Google publică o carte albă actualizată, un registru public inviolabil al software-ului său de server, pe care dispozitivele îl vor putea verifica înainte să trimită date personale, și rezultatele unui audit independent realizat de o firmă pe care nu o numește.
Qwen: agenți pentru smartphone-uri și audio mai ieftin
Qwen Intelligence, trei agenți pentru producătorii de telefoane
23 septembrie — Qwen lansează Qwen Intelligence, o ofertă de agenți pentru smartphone-uri destinată în primul rând producătorilor de telefoane. Modulele (planificare, execuție, imagine, memorie) pot fi combinate după nevoie, iar un sistem de rutare distribuie calculele între dispozitiv și cloud. La lansare sunt disponibili trei agenți: Mobile Planner planifică sarcinile complexe, Mobile-Use le execută folosind mai întâi API-urile, cu trecere la interfața grafică dacă este necesar (82,1 pe MobileWorld, 97,2 pe AndroidDaily, 90 % rată de reușită de la un capăt la altul, potrivit Qwen), iar Mobile Creative generează o imagine în 3 secunde. Qwen pune la dispoziție patru benchmarks, dar nici ponderile, nici codul agenților. Mobile-Use și Mobile Creative sunt deja facturate în funcție de utilizare, în timp ce facturarea pentru Mobile Planner este anunțată pentru „în curând”.
| Modelul sau sistemul evaluat (potrivit Qwen) | Scor global MobilePA-Bench |
|---|---|
| Qwen-Planner-Agent 27B | 77,05 % |
| GPT-6 Astra | 76,84 % |
| Claude Opus 5 | 75,71 % |
| Claude Fable 5 | 74,53 % |
| GLM 5.3 | 73,88 % |
🔗 Anunțul Qwen pe X · Raportul Qwen-Planner-Agent
Qwen-Audio-3.1, cu până la 95 % mai ieftin
23 septembrie — Qwen-Audio-3.1 actualizează cele trei modele audio ale Qwen, pentru recunoaștere vocală (ASR), sinteză vocală (TTS) și conversație în timp real (Realtime), și adaugă încă două: TTS-Next, care generează dintr-o singură trecere vocea, efectele și sunetul de fundal, și ASR-Next, care distinge vorbitorii, adaugă marcaje temporale transcrierii și recunoaște emoțiile și zgomotele ambientale. Realtime ascultă și vorbește în același timp și poate fi întrerupt. Pe QwenCloud, qwen-audio-3.1-realtime-plus costă 6,4 dolari per milion de tokens audio la intrare și 24 de dolari la ieșirea de text și audio, cu 262K tokens de context; ASR pentru fișiere costă 0,15 dolari per milion de tokens la intrare. Doar aceste două API-uri sunt disponibile, celelalte fiind anunțate pentru „în curând”.
| Familie de modele | Reducerea de preț anunțată |
|---|---|
| TTS | aproximativ 70 % |
| Realtime | aproximativ 85 % |
| ASR | până la 95 % |
🔗 Anunțul Qwen-Audio-3.1 pe X · Qwen-Audio-3.1-Realtime pe QwenCloud
Mistral Vibe: Chat și Work fuzionează, CLI își restrânge permisiunile
Chat și Work fuzionează, bază de cunoștințe în previzualizare
22 septembrie — Mistral publică patru note de versiune pentru Vibe, asistentul său (fostul Le Chat), fără articol sau postare pe X. Cea principală unește Chat și Work într-o singură experiență: utilizatorul pune o întrebare sau lansează o sarcină în același loc, un selector Fast / Think înlocuiește schimbarea modului, iar Skills înlocuiesc Chat Agents, Deep Research devenind una dintre ele. Migrarea a început pe 14 septembrie pentru conturile Free, Pro și Teams; companiile vor urma începând cu 1 octombrie, pe parcursul unei perioade de aproximativ șase luni. Baza de cunoștințe pentru agenți (Agentic Knowledge Base), în previzualizare publică, înlocuiește o memorie opacă cu pagini care pot fi consultate și modificate și indică sursa fiecărui fapt reamintit. Mini App Canvas generează mici aplicații React care pot fi partajate, pornind de la un prompt, iar foile de calcul Excel sau CSV devin disponibile în Vibe Work pentru abonamentele plătite.
Vibe CLI 2.25.8 corectează ocoliri ale permisiunilor
23 septembrie — Vibe CLI 2.25.8 cuprinde 5 adăugiri și 38 de corecții, dintre care mai multe vizează securitatea permisiunilor. O listă de permisiuni bazată pe căi relative nu mai autorizează un fișier doar pentru că numele căii sale se termină cu același sufix, caracterele wildcard din comenzile shell nu mai ocolesc verificarea căilor din afara directorului de lucru, iar permisiunea acordată unui director părinte nu mai acoperă automat subdirectoarele sale, ceea ce poate face ca unele cereri de aprobare să reapară. Notele menționează și, pentru prima dată, o „Rust CLI”, vizată de 18 rânduri, care permite, printre altele, configurarea proiectelor la distanță din Vibe Code. Pentru companii, configurația impusă de organizație se aplică de la deschiderea unei sesiuni Unified Harness, iar conexiunea OAuth la serverele MCP care emit un secret client, precum Supabase, este corectată.
🔗 Notele de versiune Vibe CLI 2.25.8
Agenți de cod open source și din linia de comandă
ZCode devine open source după probleme de securitate
21 septembrie — Din urmă: Z.ai a publicat codul ZCode, infrastructura sa pentru programare cu agenți prezentată drept instrumentul oficial al GLM-5.3, ca răspuns la problemele de securitate semnalate de comunitate. Contul @zcode_ai spune că a finalizat corecțiile necesare și își cere scuze. Depozitul zai-org/ZCode, sub licență Apache-2.0, conține clienții, serviciile backend, CLI și runtime-ul agentului; avea aproximativ 6 500 de stele pe 23 septembrie.
With respect to the code data referenced by the community, we confirm that no such data is retained and that it has never been used for model training.
🇷🇴 În privința datelor de cod menționate de comunitate, confirmăm că nu păstrăm niciuna dintre aceste date și că ele nu au fost folosite niciodată pentru antrenarea modelelor. — @zcode_ai pe X
Potrivit ZCode, două organizații au evaluat ulterior situația: conform CAICT, bucket-ul Alibaba Cloud OSS „zcode-prod” nu mai conține date; conform NSFOCUS, obiectele sale, precum și bucket-ul în sine, au fost șterse. Ambele constată că versiunea v3.14.0 a clientului include corecția, că funcția Repo Wiki a fost eliminată și că fluxul care încărca instantanee ale depozitelor locale este dezactivat. Z.ai anunță un proces permanent de raportare a vulnerabilităților, cu recompense, și promite să publice raportul complet de evaluare.
Kimi Code 2.1.0 își întărește securitatea
23 septembrie — Moonshot publică Kimi Code 2.1.0 (2 noutăți, 18 corecții). Noutatea vizibilă este un mod experimental de afișare pe ecran complet, care poate fi ales în /settings și devine activ după repornire. Mai multe corecții întăresc securitatea: instrumentele pentru fișiere nu mai pot ieși din directorul de lucru prin legături simbolice, configurația locală a unui proiect se aplică doar după aprobarea spațiului de lucru, configurația git a unui depozit nu mai poate executa comenzi în timpul operațiunilor git din fundal, iar directoarele suplimentare care indică spre directorul personal sau spre rădăcină sunt refuzate. OAuth pentru serverele MCP solicită acum acces offline, ceea ce elimină necesitatea reautorizării din oră în oră. În același timp, Moonshot a arhivat vechiul Kimi CLI scris în Python (11 424 de stele), ale cărui versiuni 1.51.0 și 1.52.0 trimit către Kimi Code.
🔗 Notele de versiune Kimi Code 2.1.0
DeepSeek Harness 0.1.7-rc.1, în previzualizare
23 septembrie — DeepSeek publică versiunea v0.1.7-rc.1 a DeepSeek Harness, infrastructura sa open source pentru agenți, sub licență MIT, prezentată pe 13 august. Este o versiune candidată (release candidate): depozitul numără 21 de versiuni preliminare din august, fără nicio versiune stabilă până în prezent. Adăugirile importante sunt experimentale: un mod Computer Use care permite agentului să acționeze pe computerul local și să facă capturi de ecran (prin Cua Driver MCP sau un driver nativ) și trei backend-uri pentru controlul browserului (Playwright MCP, Chrome DevTools MCP, Stagehand). Interfața web primește terminale integrate și o funcție de revizuire a modificărilor cu diffs, modul headless își citește sarcinile din intrarea standard și emite evenimentele în JSON, iar agentul poate lucra într-un spațiu la distanță prin SSH. Sunt necesare migrări: adaptorul oficial DeepSeek folosește exclusiv Messages API, backend-urile de execuție E2B dispar, iar modul experimental pentru echipe trece de la 8 la 16 coechipieri.
🔗 DeepSeek Harness v0.1.7-rc.1
GenCode, agentul de cod al Genspark
23 septembrie — Genspark lansează GenCode, un agent de cod integrat în Super App, disponibil pe macOS, Windows și Linux, precum și în linia de comandă. Argumentul central este alegerea modelului: Claude, GPT, DeepSeek sau un model cu ponderi deschise, pentru fiecare sarcină, dintr-un singur cont și fără configurarea unei chei API; Genspark anunță modele deschise „la un cost de 10 până la 20 de ori mai mic”. GenCode preia dintr-un singur pas instrucțiunile, regulile și memoria create pentru Claude Code. README-ul pachetului npm @genspark/gencode îi precizează originea: derivă din opencode, agentul de cod open source, dar rămâne un produs proprietar neafiliat proiectului, care folosește în mod deliberat directorul .opencode/ din depozite. Cheltuiala este afișată în credite Genspark la fiecare pas.
🔗 GenCode · Anunțul Genspark pe X
GitHub Copilot: aprobări asistate și sandbox local
Copilot pentru JetBrains 1.18.0
22 septembrie — Versiunea 1.18.0 a Copilot pentru IDE-urile JetBrains introduce, în previzualizare publică, aprobările asistate (assisted approvals): în sesiunile de agent, apelurile de instrumente considerate cu risc scăzut sunt aprobate automat, în timp ce acțiunile mai riscante necesită în continuare o decizie. Se poate edita din nou și un mesaj anterior: Copilot readuce atunci conversația și modificările fișierelor la starea anterioară înainte de a trimite noua instrucțiune. Agentul Codex, disponibil în Copilot pentru JetBrains, primește un mod de planificare pentru revizuirea, rafinarea sau aprobarea abordării înainte de orice modificare, iar sesiunile acceptă skills și instrucțiuni la nivel de organizație și companie. Serverul MCP GitHub integrat, activ implicit, poate fi dezactivat. Utilizatorii unui IDE JetBrains 2025.1 vor primi o notificare care îi invită să treacă la 2026.1 sau la o versiune ulterioară.
🔗 Noutățile Copilot pentru JetBrains
Aplicația Copilot își izolează sesiunile locale
23 septembrie — Aplicația GitHub Copilot, aplicația desktop a GitHub dedicată agenților săi, primește un sandbox local în previzualizare publică. Configurat pentru fiecare proiect, acesta limitează resursele pe care le pot accesa comenzile dintr-o sesiune locală: sistemul de fișiere (directoare cu acces la citire și scriere, doar la citire sau interzise), rețeaua (acces la internet și la rețeaua locală) și datele de autentificare (Git prin HTTPS, GitHub CLI). Setările administrate de companie pot înăspri politica. Dacă sistemul de operare nu poate aplica politica cerută, shell-ul din sandbox se oprește cu o eroare, în loc să ruleze fără protecție. Dezactivat implicit, sandbox-ul poate fi activat pentru sesiunile noi ale proiectului sau cu /sandbox on pentru o sesiune în curs; nu acoperă nici sesiunile cloud, nici gazdele la distanță, iar setările sale sunt separate de cele din Copilot CLI.
🔗 Sandbox-ul local din aplicația GitHub Copilot
Cursor: doi bots pentru lansarea în producție, cu 7 % mai puțini tokens
Rollouts și Security Review
23 septembrie — Cursor lansează doi boți dedicați ultimei etape a livrării codului, disponibili în planurile Teams și Enterprise. La deschiderea fiecărui pull request, Rollouts publică un plan de monitorizare (riscuri, efect așteptat, semnale de verificat), apoi îl confruntă cu logurile, metricile și urmele de execuție după fiecare implementare și emite un verdict pentru fiecare mediu: funcționare normală, regresie detectată sau rezultat neconcludent. În caz de regresie, indică modificarea suspectă și poate deschide un PR de revenire la versiunea anterioară, supus aprobării, fără să facă singur îmbinarea sau revenirea. Security Review verifică fiecare pull request și semnalează vulnerabilitățile exploatabile (injecții, eludarea autentificării, secrete lăsate în cod, SSRF…), fiecare cu nivelul de gravitate, calea de atac și o remediere propusă. Timp de 10 zile, creditele de probă permit testarea Rollouts pe aproximativ 50 de modificări pentru Teams și 500 pentru Enterprise.
🔗 Jurnalul modificărilor Cursor
Cost cu 7 % mai mic în tokenuri, fără pierdere de calitate
23 septembrie — Cursor explică modul în care a redus cu 7 % costul în tokenuri al agentului său pentru utilizatori, fără scăderea calității. Deoarece modelele recente nu mai au nevoie de liste lungi de interdicții, promptul de sistem a fost scurtat cu aproximativ 66 %, reducerile fiind validate prin teste A/B pe traficul real. Instrumentele integrate, dintre care majoritatea sunt folosite în mai puțin de 20 % dintre conversații, sunt acum încărcate la cerere.
| Măsură de optimizare | Efect măsurat de Cursor |
|---|---|
| Prompt de sistem simplificat | aproximativ 66 % din prompt eliminat |
| Instrumente integrate încărcate la cerere | -60 % tokenuri pentru descrieri în contextul static |
| Puncte explicite de oprire pentru cache | -20 % eșecuri ale cache-ului la pornirea la rece |
| Câte un număr de linie la fiecare zece | -1,6 % tokenuri citite din cache |
| Toate modificările | -7 % cost în tokenuri pentru utilizatori |
NVIDIA: diarizare deschisă și AI Day Singapore
Nemotron 3 Diarization distinge până la opt vorbitori
23 septembrie — NVIDIA publică pe Hugging Face Nemotron 3 Diarization, un model cu ponderi deschise, cu 100 de milioane de parametri, care stabilește cine vorbește și când într-o conversație, inclusiv atunci când vocile se suprapun. Urmărește până la opt vorbitori, față de patru în cazul predecesorului său, Streaming Sortformer, și funcționează atât pentru procesarea ulterioară, cât și în flux continuu, cu o latență reglabilă a bufferului între 30,4 și 0,32 secunde. Nu transcrie cuvintele: furnizează intervale de timp pentru fiecare vorbitor, care pot fi combinate cu un model de transcriere. În primele rezultate ale Diarization-Bench de la VoiceArena, ocupă primul loc dintre 12 sisteme, cu o rată a erorii de diarizare de 14,72 %, față de 19,3 % pentru următorul clasat; potrivit NVIDIA, acest clasament inițial se mai poate schimba. Față de modelul anterior, eroarea scade în medie cu 41 % pe opt seturi de evaluare, cu o ușoară scădere a performanței pentru conversațiile cu doi vorbitori din CALLHOME. Licență OpenMDW 1.1.
| Indicator publicat | Nemotron 3 Diarization | Modelul anterior |
|---|---|---|
| Număr maxim de vorbitori urmăriți | 8 | 4 |
| Viteză la 30,4 s (loturi de 32, RTX PRO 5000) | 15 113 ori viteza în timp real | 2 619 ori |
| Eroare DIHARD III la 30,4 s | 12,73 % | 19,09 % |
🔗 Nemotron 3 Diarization pe blogul Hugging Face
AI Day Singapore: Vera Rubin și Nemotron în Asia de Sud-Est
22 septembrie — Într-un articol publicat pe 22 la ora 19:30 PT, în timpul AI Day Singapore (22 și 23 septembrie), NVIDIA prezintă Sea Limited, compania-mamă a Shopee, Garena și Monee, drept prima companie din regiunea ASEAN care adoptă platforma sa Vera Rubin pentru a dezvolta și implementa modele și agenți la scară mai mare. Restul articolului prezintă adaptările locale ale modelelor deschise Nemotron: AI Singapore extinde familia SEA-LION, dedicată limbilor din regiune, cu modele Nemotron; în Vietnam, Viettel AI a ajustat Nemotron 3 Super pentru limba vietnameză, acesta ocupând primul loc în benchmarkul VMLU; în Thailanda, iApp Technology a adaptat Nemotron 3 Nano la dreptul thailandez prin OpenThai 2.0 Legal, publicat în open source, care alimentează chatbotul juridic Thanoy și cei aproximativ 43 000 de utilizatori ai săi.
🔗 La AI Day Singapore, NVIDIA și partenerii prezintă progrese în IA din Asia de Sud-Est
Punerea IA în producție fără probleme
Două anunțuri pornesc de la aceeași idee: validarea pe sarcini reale înainte de redirecționarea traficului sau actualizarea mașinilor.
Implementările canar ale Together AI
22 septembrie — Together AI prezintă implementările progresive ale serviciului său Dedicated Model Inference, disponibile de la actualizarea din 15 septembrie: modelul servit printr-un endpoint poate fi schimbat fără întrerupere și fără modificarea URL-ului. Sunt propuse trei strategii: strategia canar crește treptat traficul către noul model (implicit 5 %, 25 %, 50 %, apoi 100 %), strategia albastru-verde mută tot traficul dintr-o dată, iar înlocuirea progresivă schimbă replicile una câte una. După fiecare etapă a strategiei canar, un mecanism de verificare compară latența sau rata de eroare cu cele ale vechiului model și pune implementarea în pauză dacă acestea se înrăutățesc. În demonstrația publicată, trecerea de la Qwen2.5-7B la Qwen3.5-9B este oprită la doar 10 % din trafic, după o creștere cu 137 % a latenței p95 (1 740 ms față de 734 ms); revenirea la vechiul model s-a făcut fără ca vreuna dintre cele 6 800 de cereri procesate să eșueze.
🔗 Implementări canar: actualizarea modelelor în producție fără întrerupere
NVCRE și NodeWright de la NVIDIA
23 septembrie — NVIDIA prezintă două proiecte open source (Apache 2.0) din DSX OS, stratul software al platformei sale pentru fabrici de IA, destinate clusterelor GPU care rulează Kubernetes. NVIDIA Cluster Readiness Engine (NVCRE) pornește de la o constatare: un cluster poate trece toate verificările de stare și totuși poate eșua la un antrenament distribuit. Prin urmare, îl certifică folosind sarcini reale (teste de comunicare NCCL, diagnosticări DCGM, preantrenare NeMo) pe grupuri de noduri alese în funcție de topologie, identifică nodurile cu probleme și, în modul de diagnosticare, împarte în două grupurile care eșuează până când izolează nodurile suspecte. Articolul menționează printre aceste sarcini modele Nemotron 5 cu 8 și 56 de miliarde de parametri, fără alte detalii. NodeWright, fostul Skyhook folosit în producție la NVIDIA, actualizează sistemul nodurilor (setări ale nucleului, agenți de securitate, corecții ale vulnerabilităților) după încheierea sarcinilor protejate, în valuri fixe, liniare sau exponențiale, care se opresc automat dacă eșuează prea multe loturi.
🔗 Validarea pregătirii clusterelor GPU înainte de rularea sarcinilor IA · NodeWright
Două seturi de date deschise: conversații cu mai multe voci și un corpus științific
Basis Conversations 1500
23 septembrie — Basis publică pe Hugging Face Basis Conversations 1500: 1 502 ore de conversații spontane între 2 645 de persoane din 33 de țări, în 22 de limbi, de la engleză la mingreliană și xhosa. Fiecare conversație reunește între două și patru persoane, fiecare înregistrată pe propria pistă sincronizată (FLAC 48 kHz), ceea ce permite studierea suprapunerilor, întreruperilor și schimburilor de replici, aspecte care, potrivit echipei, încă pun probleme modelelor. Aproximativ 100 de ore sunt adnotate detaliat de oameni (113 096 de evaluări): reacții vocale pline de compasiune sau iritare, tăceri stânjenitoare, suprapuneri cooperante sau competitive. Transcrierile furnizate sunt generate automat și nu trebuie folosite drept date țintă pentru antrenare fără verificare. Articolul prezintă setul de date ca fiind liber pentru utilizare comercială și în cercetare, dar acesta se află sub o licență proprie Basis (basis-data-license-1.0), iar accesul este aprobat manual.
QVAC Genesis III
23 septembrie — Tether AI Research publică QVAC Genesis III, a treia parte a corpusului său sintetic destinat preantrenării modelelor mici în științe, tehnologie, inginerie și matematică. Cu încă 43,06 miliarde de tokenuri, întregul corpus ajunge la 191,43 miliarde de tokenuri și aproximativ 160 de milioane de documente din 19 domenii; articolul care îl însoțește a fost acceptat la conferința COLM 2026. Metoda interoghează un model elev mic, Qwen3-1.7B-Base: un răspuns greșit devine o explicație corectivă, iar unul corect, o analiză a fiecărei opțiuni de răspuns. Antrenat de la zero pe acest corpus, un model cu 1,7 miliarde de parametri obține rezultate considerabil mai bune decât același model antrenat pe Cosmopedia-v2, la un buget egal de tokenuri. Corpusul este publicat sub o licență necomercială (CC-BY-NC 4.0), iar un model antrenat pe acesta este anunțat sub licența Apache 2.0.
| Benchmark evaluat | Câștig față de Cosmopedia-v2 (buget egal de tokenuri) |
|---|---|
| ARC-Easy | +28,57 puncte |
| ARC-Challenge | +21,35 puncte |
| GPQA Diamond | +2,52 puncte |
| MMLU STEM | +15,03 puncte |
IA pentru climă și alimentație
Ai2 și Global Fishing Watch monitorizează oceanele cu ajutorul agenților
23 septembrie — La Climate Week din New York, Ai2 și Global Fishing Watch anunță un parteneriat pentru a folosi IA, în special agenți, în monitorizarea oceanelor și controlul pescuitului. Cele două organizații colaborau deja; acum trec la dezvoltarea în comun: un pipeline comun de detecție, noi modele de viziune care analizează imagini din satelit în timp real și agenți capabili să coreleze mai multe surse de date. Global Fishing Watch va avea acces la OlmoEarth, platforma Ai2 de observare a Pământului bazată pe modele deschise, pentru a-și adnota datele și a-și antrena propriile modele. Detecțiile în timp real ale navelor realizate de Skylight vor fi integrate în portalul său pentru administratorii ariilor marine, iar cele două echipe vor dezvolta în continuare agenți precum Shippy, căruia un analist îi poate cere istoricul unei nave. Anunțul nu include niciun calendar și nicio sumă.
🔗 Ai2 și Global Fishing Watch își unesc forțele pentru a aduce agenții IA în monitorizarea oceanelor
Google.org și Gates Foundation, pentru 200 de milioane de mici fermieri
18 și 22 septembrie — Informație reluată: Google.org și Gates Foundation își extind inițiativa comună pentru a pune instrumente IA pentru climă, agricultură și limbi la dispoziția a 200 de milioane de mici fermieri din Africa Subsahariană și Asia de Sud, față de cele 50 de milioane prevăzute inițial. Cei doi parteneri alocă împreună o finanțare de 100 de milioane de dolari, cu sprijinul tehnic al cercetătorilor și inginerilor Google. Comunicatul Gates Foundation este din 18 septembrie; blog.google l-a preluat în seara de 22 septembrie. Programul finanțează organizații locale precum Wadhwani AI și Digital Green în India, integrează prognoze IA în platforma climatică TomorrowNow, cartografiază parcelele la o rezoluție sub un metru și sprijină seturi deschise de date vocale și textuale în peste 40 de limbi africane. Micii fermieri produc aproape 35 % din hrana la nivel mondial.
🔗 Anunțul Google.org · Comunicatul Gates Foundation
Știri pe scurt
- Anthropic, modernizarea codului — În seria „Notes from the Field”, doi ingineri Anthropic detașați la clienți, Jonah Ezekiel și Lexie Tonelli, propun șase etape pentru pregătirea unei modernizări a codului realizate de agenți: obiectivul, un „certificat” de testare, verificarea umană în etape, condițiile prealabile, fluxul de lucru al agenților, apoi lansarea. Nu oferă cifre privind costurile: recomandă măsurarea lor într-un proiect pilot. 🔗 sursă
- Boris Cherny verifică Claude Agent SDK în Lean — În seara zilei de 22, Boris Cherny (Claude Code) povestește că a pus Opus 5.5 să verifice formal Claude Agent SDK cu asistentul de demonstrare Lean: câteva prompturi scurte au produs 16 pull requests care corectează erori și probleme de concurență. Spune că folosește și TLA+. 🔗 sursă
- Codex CLI 0.156.1 — Această versiune de corecție pentru 0.156.0 adaugă GPT-6 Sol și GPT-6 Luna în selectorul de modele al CLI; mesajul afișat la atingerea limitei de debit recomandă acum Luna și sunt propuse migrări de la GPT-5.5 și GPT-5.6. 🔗 sursă
- Airbnb și GPT-6 Astra — Un nou acord extinde accesul echipelor de inginerie și produs ale Airbnb la modelele OpenAI, inclusiv GPT-6 Astra, prin API-ul OpenAI și Amazon Bedrock. Directorul tehnic Ahmad Al-Dahle afirmă că echipele sale livrează cu aproximativ 80 % mai multe funcționalități decât acum un an; valoarea acordului nu este comunicată. 🔗 sursă
- OpenAI Academy împlinește doi ani — Peste 250 de evenimente și peste 4 milioane de persoane la care a ajuns din septembrie 2024; OpenAI testează un program de formatori din comunitate (Community Trainer Program), în care angajați ai organizațiilor partenere învață, după o evaluare, să organizeze ateliere. 🔗 sursă
- Un afișaj LED transformat în asistent vocal — Pe blogul OpenAI Developers, Sid Rampally povestește cum l-a ajutat Codex să conecteze și să programeze un panou LED de 128 × 64 de pixeli controlat de un Raspberry Pi; GPT-Live-1 poartă conversația și deleagă căutările și afișarea către GPT-5.6 Luna prin Responses API. 🔗 sursă
- MedGemma depășește 10 milioane de descărcări — Google prezintă utilizări concrete ale modelelor sale medicale deschise: depistarea cancerului de col uterin la peste 3 500 de femei din Zambia, proiecte pilot la spitalul AIIMS din Delhi și depistarea tuberculozei în Indonezia. Google reamintește că rezultatele lor nu trebuie să ghideze direct un diagnostic. 🔗 sursă
- Gemini Notebook în Google Docs — Tastând @ în Docs, utilizatorii pot cita un notebook ca sursă: Gemini își bazează textul pe sursele din acesta, cu citări în text, și le combină cu e-mailuri și fișiere prin Workspace Intelligence. Disponibil pentru Business Standard și Plus, Enterprise Standard și Plus, Education Plus și abonații Google AI Pro și Ultra. 🔗 sursă
- Șase instrumente Google Flow — Google Labs publică șase instrumente construite de creatori cu Google Flow Tools: Mondo Sónico (efecte sonore sincronizate), CaptionCast (subtitrări animate), ThumbnailForge (miniaturi), Surface (texturi pe suprafețe 3D), CollageMotion Pro și SwissFlow Studio (grafică animată); fiecare poate fi duplicat și remixat. 🔗 sursă
- Google Beam este livrat în Franța — Beam, platforma de comunicare video a Google care urmărește să recreeze prezența față în față și este vândută împreună cu HP, este acum livrată în șase țări, inclusiv Franța, cu 18 parteneri. Un studiu intern menționează echipe care se simt cu 50 % mai conectate și cu 21 % mai puține ședințe de monitorizare. 🔗 sursă
- Android Enterprise și agenții Gemini — Gemini poate executa succesiv sarcini între aplicații pornind de la contextul afișat pe ecran, în timp ce măsurile de protecție împiedică agenții personali să acceseze profilul profesional; administratorii pot restricționa sau dezactiva automatizarea cu IA pe toate dispozitivele administrate. 🔗 sursă
- AI Brief în limba franceză — Versiunea beta închisă a AI Brief, care ghidează campaniile AI Max din Google Ads folosind formulările utilizatorilor, devine disponibilă în franceză, neerlandeză, germană, italiană, japoneză, portugheză și spaniolă. 🔗 sursă
- Gemini CLI, versiunea nightly din 23 septembrie — Este doar o versiune nightly, nu una stabilă: adaugă Gemini 3.8 Flash și Gemini 3.5 Flash Lite, accesibile imediat prin cheie API, Vertex AI sau gateway, iar cu un cont Google prin activarea opțiunilor experimentale. Marți, 22 septembrie, nu a apărut nicio versiune stabilă. 🔗 sursă
- EcoHash își măsoară optimizările video — Pe o placă RTX PRO 6000 de 96 Go, EcoHash reduce durata generării unui videoclip MiniMax H3 de la 174,8 la 40,8 secunde și a unui videoclip generat din text cu Wan2.2 de la 132,3 la 10,7 secunde, folosind un LoRA distilat în 4 pași; trei dintre cele zece setări încercate, inclusiv ambele moduri de compilare, nu au schimbat nimic. 🔗 sursă
- Tătara crimeeană: a fost evitat un test denaturat — Dezvoltatorul unui model de recunoaștere vocală pentru tătara crimeeană a descoperit că patru cărți audio apăreau de două ori în corpusul său: 96,9 % dintre fragmentele din testul principal aveau un corespondent în datele de antrenare. După corectare, o ajustare fină LoRA și reglarea decodorului, rata erorilor la nivel de cuvânt scade de la 0,3463 la 0,1701. 🔗 sursă
- Falcon-H1 și mlx-lm — În mlx-lm 0.31.3, fără cache KV, în timpul antrenării se execută doar primul dintre cele 66 de straturi ale Falcon-H1: orice LoRA se antrenează fără eroare sau avertisment pe un model cu un singur strat. Corecția necesită o singură linie, iar problema a fost raportată într-un issue. 🔗 sursă
- Agenții și contribuțiile open source — Quentin Gallouédec (Hugging Face) consideră că aporturile produse de agenți ascund semnalul unei nevoi reale și consumă timpul responsabililor de proiect cu verificarea lor; cere să nu mai fie trimiși agenți să contribuie la proiecte alese la întâmplare și ca oamenii să înceapă prin a folosi proiectul. 🔗 sursă
- Phionyx la IETF — Autorul Phionyx depune o propunere individuală, Claim-Preserving Exchange of AI Evaluation Evidence, pentru ca rezultatul unei evaluări să își păstreze condițiile și limitele când trece dintr-un sistem în altul; textul nu a fost adoptat de niciun grup de lucru. 🔗 sursă
- Kimi Work 3.2.12 — Agentul pentru computer al Moonshot permite selectarea unui pasaj dintr-un fișier PPT, Excel, Word sau Markdown pentru a-l modifica precis; limita de dimensiune a fișierelor atașate este eliminată. 🔗 sursă
- Qwen-Image-2.1 conduce clasamentul modelelor deschise — Potrivit Arena, Qwen-Image-2.1 devine primul model deschis pentru editarea imaginilor (1 367 de puncte, locul 16 în clasamentul general) și pentru generarea imaginilor din text (1 228 de puncte, locul 17 în clasamentul general). 🔗 sursă
- OpenTelemetry în aplicația Copilot — Administratorii pot exporta datele de urmărire ale sesiunilor de agent din aplicația GitHub Copilot (cereri către modele, instrumente folosite) către instrumentele lor de monitorizare prin proprietatea
telemetrydinmanaged-settings.json; conținutul prompturilor și al răspunsurilor este exclus implicit. 🔗 sursă - Copilot CLI și C++ — Microsoft C++ Language Server din Copilot CLI construiește acum un index persistent al simbolurilor din întregul proiect, activat implicit; prima construire poate dura mult și poate consuma multă memorie, iar GitHub nu cuantifică beneficiul. 🔗 sursă
- Un pull request de un milion de linii — Un articol tehnic de la GitHub explică modul în care aplicația Copilot afișează un pull request cu 2 200 de fișiere, peste un milion de linii și peste 400 de comentarii, separând geometria codului, calculată în avans, de cea a comentariilor, măsurată în apropierea zonei vizibile. 🔗 sursă
- Genspark adaugă Opus 5.5, GPT-6 și Grok 4.7 — În noaptea de 23, Genspark oferă acces la Claude Opus 5.5, Grok 4.7, GPT-6 Sol și GPT-6 Luna în AI Chat, Code Agent și Claw, preluând argumentele furnizorilor, fără să precizeze un abonament sau un tarif. 🔗 sursă
- Sondaj GitHub și Yale — Dintre 1 039 de utilizatori GitHub din Statele Unite, 71 % spun că sunt preocupați de impactul IA asupra mediului și opt din zece vor instrumente care să îi ajute să scrie cod mai eficient energetic; GitHub precizează că eșantionul, format din persoane care au acceptat comunicările sale de marketing, nu este reprezentativ. 🔗 sursă
- Zed 1.21.0 — Versiunea stabilă oferă acces la Claude Opus 5.5 și la GPT-6 Astra, Sol și Luna cu propria cheie API, adaugă conectarea SuperGrok în panoul Agent și împiedică implicit intrarea computerului în repaus cât timp lucrează un agent. 🔗 sursă
- Warp — GPT-6 Sol și Luna, apoi Claude Opus 5.5, devin disponibile în terminalul Warp și în Warp Agent CLI, la fel ca Grok 4.7 pentru cei care își conectează abonamentul Grok; este anunțată doar disponibilitatea, fără tarife. 🔗 sursă
- Devin în Microsoft Teams — Devin, limitat până acum la canale, răspunde acum în mesaje directe și în conversații de grup, pornește Automations dintr-un canal și trimite carduri cu întrebări sau cereri de aprobare; aplicația nu solicită permisiuni noi. 🔗 sursă
- Scribe v2 Medical — Disponibil din 11 septembrie, modelul de transcriere clinică al ElevenLabs primește anunțul oficial, însoțit de o cifră nouă: cu 35 % mai puține erori la nivel de cuvânt pe înregistrări audio clinice față de Scribe v2. Tarifele încep de la 0,22 dolari pe oră. 🔗 sursă
- Sora 2 părăsește ElevenLabs — ElevenLabs elimină Sora 2 și Sora 2 Pro din studioul său, deoarece OpenAI închide API-ul Sora pe 24 septembrie, termen anunțat de OpenAI pe 24 martie; fluxurile afectate trebuie să treacă la un alt model video, precum Gemini Omni 1.1 Flash. 🔗 sursă
- Cohere Model Vault în Canada — Cohere anunță că Model Vault, platforma sa dedicată de inferență pentru un singur client, este disponibilă în Canada, fără a preciza regiunea cloud, furnizorul sau tariful; pagina produsului nu menționează încă această țară. 🔗 sursă
- Cohere și gestionarea schimbării — Un articol semnat de Katherine Correia (Cohere) îndeamnă la integrarea IA ca participant, nu doar ca instrument, la clasificarea sarcinilor în verificabile, bazate pe judecată sau hibride și la stabilirea regulilor pentru fiecare caz de utilizare; nu prezintă niciun produs și nicio cifră. 🔗 sursă
Ce înseamnă toate acestea
Rezultatul Anthropic duce agenții din domeniul codului spre biologia fundamentală. Aproximativ 950 de agenți Claude au triat peste 200 000 de transcriptaze inverse în 21 de ore, iar oamenii au intervenit doar la început, printr-un prompt, și la sfârșit, pentru experimente. Blocajul se mută la selectarea ipotezelor, pe care Anthropic o studiază acum ca temă de cercetare. Prudența rămâne necesară: funcția ART este necunoscută, iar rezultatul este, deocamdată, un preprint. Aceeași abordare, cu numeroși agenți coordonați prin măsurători, apare în sprintul care a accelerat claude.ai, cu peste 3 000 de modificări, și în verificarea formală a Claude Agent SDK în Lean.
Securitatea mediilor izolate pentru agenți devine subiect de discuție publică. Auditul Perplexity distinge două bariere: izolarea mașinii virtuale a rezistat în toate cele 108 încercări, filtrarea rețelei a fost ocolită de 11 ori din 54 de modele care au exploatat verificarea insuficientă a DNS sau adresele partajate ale unui CDN, iar 8 din 10 platforme terțe prezentau cel puțin o modalitate de ocolire. Două modele, Fable și GPT-6 Astra, au refuzat exercițiul. În aceeași zi, aplicația GitHub Copilot lansează un mediu izolat local care se oprește în caz de eroare în loc să ruleze fără protecție, modul auto din Claude Code trimite clasificatorului inclusiv comenzile care doar citesc date, iar Vibe CLI și Kimi Code închid căi de ocolire a autorizării; cu două zile înainte, ZCode își făcuse public codul după probleme semnalate de comunitatea sa.
Vocea devine o interfață prin care se pot îndeplini acțiuni. Gemini 3.8 Flash TTS și Flash-Lite TTS fac generarea audio de peste două ori mai ieftină decât versiunea preliminară anterioară (9 și 6 dolari per milion de tokenuri până la sfârșitul lui 2026, față de 20) și adaugă replicarea vocii condiționată de un consimțământ înregistrat, indisponibilă în Spațiul Economic European prin AI Studio. Qwen anunță reduceri de preț între 70 și 95 % pentru suita sa audio, NVIDIA pune la dispoziție un model care distinge opt vorbitori, iar Basis publică 1 500 de ore de conversații în care vocile se suprapun. În același timp, ChatGPT Voice trece de la conversație la acțiune, cu pluginurile și sarcinile din ChatGPT Work.
În cele din urmă, IA fizică devine mai deschisă, însă cu diferențe importante. FLUX 3 Action duce un model cu 7 miliarde de parametri pe primul loc în RoboLab-120, îl integrează în LeRobot împreună cu NVIDIA și arată că o strategie rapidă și fiabilă reduce nevoia de raționament costisitor: 8,77 dolari per reușită cu GPT-6 Astra ca supervizor, față de 13,47 pentru Astra singur. Dar „deschis” acoperă situații diferite: o licență proprie pentru FLUX 3 Action, ca și pentru Basis Conversations 1500, o licență necomercială pentru QVAC Genesis III și benchmarkuri publicate fără ponderile modelelor pentru Qwen Intelligence. Pentru cei care vor să reutilizeze aceste resurse, licența contează la fel de mult ca scorul.
Surse
- Claude descoperă un sistem enzimatic nou, cu repetiții asemănătoare celor din CRISPR (Anthropic)
- Preprint ART (PDF, Anthropic)
- @AnthropicAI: sistemul enzimatic descoperit de Claude
- Gemini 3.8 Flash TTS și Flash-Lite TTS (Google)
- Notele de versiune ale API-ului Gemini, 22 septembrie
- Tarifele API-ului Gemini
- FLUX 3 Action (Black Forest Labs)
- @bfl_ai: lansarea FLUX 3 Action
- Colecția FLUX 3 Action pe Hugging Face
- Evadarea din SPACE, partea I (Perplexity)
- Claude Code v2.1.281
- Cum am făcut claude.ai de 3 ori mai rapid în două săptămâni (claude.dev)
- Claude Marketplace (Anthropic)
- @OpenAI: ChatGPT Voice cu pluginuri și în ChatGPT Work
- Articol de ajutor despre ChatGPT Voice
- Notele de versiune ale ChatGPT
- Prezentarea MentalHealthBench (OpenAI)
- SWE-Serve (NVIDIA)
- Depozitul NVIDIA/swe-serve
- Runway este acum disponibil în DaVinci Resolve
- Gemini Omni 1.1 Flash în Google Vids
- Made On YouTube 2026
- Rezumatul Made On YouTube 2026 (Google)
- Noile aplicații conectate ale Gemini
- @GeminiApp: 13 aplicații conectate noi
- @Muse: patru conectori în curând
- @ElevenLabs: ElevenLabs ajunge în Muse
- @HeyGen: HeyGen se alătură Muse
- @grok: Grok Bot în automobilele Tesla
- @Tesla: Grok și conectorii
- @bot: Grok Bot conectat la Google Slides, Sheets și Docs
- Modele locale în SDK-ul Antigravity (Google Developers)
- Jurnalul modificărilor Antigravity
- Memorie persistentă pentru Private AI Compute (Google DeepMind)
- @Alibaba_Qwen: Qwen Intelligence
- Raportul Qwen-Planner-Agent
- @Alibaba_Qwen: Qwen-Audio-3.1
- Qwen-Audio-3.1-Realtime pe QwenCloud
- Notele de versiune ale Mistral
- Vibe CLI 2.25.8
- @zcode_ai: publicarea codului ZCode
- Depozitul zai-org/ZCode
- Kimi Code 2.1.0
- DeepSeek Harness v0.1.7-rc.1
- GenCode (Genspark)
- @genspark_ai: lansarea GenCode
- Copilot pentru JetBrains 1.18.0 (jurnalul modificărilor GitHub)
- Mediu izolat local în aplicația GitHub Copilot (jurnalul modificărilor GitHub)
- Lansări treptate și verificare de securitate (jurnalul modificărilor Cursor)
- Eficiență îmbunătățită a tokenurilor (Cursor)
- Nemotron 3 Diarization (NVIDIA, blogul Hugging Face)
- AI Day Singapore (NVIDIA)
- Lansări canary (Together AI)
- NVIDIA Cluster Readiness Engine (NVIDIA)
- NodeWright (NVIDIA)
- Basis Conversations 1500 (blogul Hugging Face)
- QVAC Genesis III (blogul Hugging Face)
- Ai2 și Global Fishing Watch (Skylight)
- Google.org și Gates Foundation (blog.google)
- Comunicatul Gates Foundation
- Cum să pregătești proiecte de modernizare a codului cu ajutorul AI (Anthropic)
- @bcherny: verificarea formală a Claude Agent SDK în Lean
- Codex CLI 0.156.1
- Airbnb și GPT-6 Astra (OpenAI)
- Doi ani de OpenAI Academy
- Cum am dat viață afișajului meu LED (OpenAI Developers)
- MedGemma și sănătatea globală (Google)
- Gemini Notebook în Google Docs (actualizări Workspace)
- Șase instrumente Google Flow (Google Labs)
- Google Beam se extinde în șase țări (Google)
- Noutățile Android Enterprise 2026 (Google)
- AI Brief și AI Max (Google Ads)
- Gemini CLI v0.62.0-nightly.20260923
- Trei dintre zece optimizări nu au avut niciun efect (EcoHash)
- Recunoașterea vocală pentru limba tătară crimeeană (blogul Hugging Face)
- Ajustarea fină a Falcon-H1 pe un Mac (blogul Hugging Face)
- Drumul spre iadul open source este pavat cu intenții bune (blogul Hugging Face)
- Tabloul de bord afișează PASS. Ce anume a trecut? (Phionyx)
- Notele de versiune ale Kimi Work
- @arena: Qwen-Image-2.1, primul model deschis
- OpenTelemetry în aplicația GitHub Copilot
- Analiza codului C++ în Copilot CLI
- Afișarea cererilor de integrare uriașe în aplicația GitHub Copilot
- @genspark_ai: Claude Opus 5.5 în Genspark
- Studiul GitHub și Yale privind eficiența dezvoltării software
- Zed 1.21.0
- @warpdotdev: GPT-6 Sol și Luna în Warp
- Devin, Microsoft Teams și Microsoft 365
- @ElevenLabs: Scribe v2 Medical
- Jurnalul modificărilor ElevenLabs din 23 septembrie
- @cohere: Model Vault în Canada
- Gestionarea schimbărilor aduse de AI (Cohere)