ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
Denna fredag närmar sig agentverktygen gemensamma format: Claude Code läser nu AGENTS.md när ett projekt saknar CLAUDE.md, Antigravity infogar katalogen över underagenter i systemprompten för sina Markdown-agenter, Codex redovisar sin förbrukning per underagent och MiniMax öppnar källkoden för sin terminalagent. Resten av dagen präglas av två modellsläpp – Qwen3.8-Omni-Flash och Grok Voice Transcribe 2.0 – och ett ovanligt partnerskap: Anthropic tar in utvärderare från Accenture i det egna företaget.
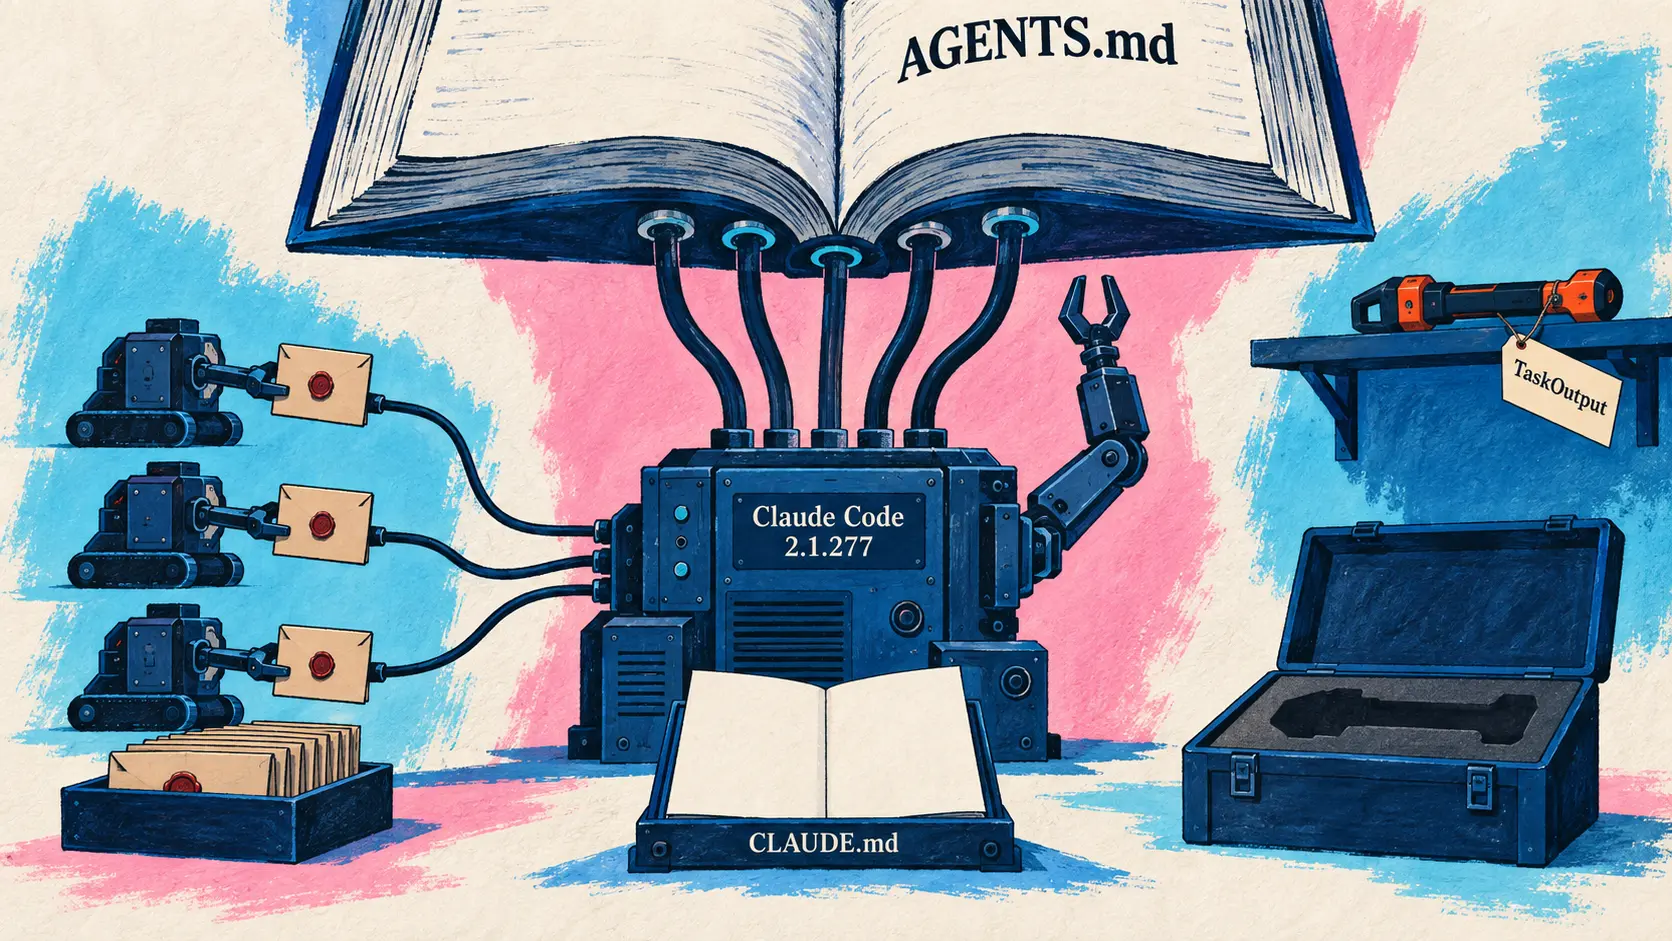
Claude Code läser AGENTS.md, isolerar underagenter och tar bort TaskOutput
18 september – Tre versioner av Claude Code lanserades inom loppet av tjugo timmar: 2.1.275 den 17 september kl. 22.33 UTC, 2.1.276 den 18 september kl. 02.12 UTC och 2.1.277 den 18 september kl. 18.06 UTC.
Den mest genomgripande nyheten ryms på en enda rad i 2.1.277. I ett projekt som saknar CLAUDE.md läser Claude Code AGENTS.md, instruktionsfilen som har blivit en gemensam konvention för flera av marknadens kodagenter. Valet görs i /config under ”Project instructions”. Funktionen är ännu inte tillgänglig på Bedrock, Vertex eller Foundry.
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇸🇪 Stöd för AGENTS.md har lagts till: i ett projekt utan CLAUDE.md läser Claude Code AGENTS.md i stället; inställningen ändras under ”Project instructions” i /config (ännu inte på Bedrock, Vertex eller Foundry). — CHANGELOG för Claude Code, anthropics/claude-code
Två andra ändringar i samma version rör kontextsäkerheten. Resultat från underagenter skickas tillbaka till huvudagenten under en rubrik som markerar dem som sådana, så att text från en underagent inte kan utges för att vara en sessionsinstruktion. Dessutom tas osynliga Unicode-formateringstecken bort från prompter, och den rensade versionen visas innan den skickas. I 2.1.277 tas också det föråldrade verktyget TaskOutput bort: Claude läser nu utdatafilen från en bakgrundsuppgift med Read.
I 2.1.275 tillkommer en tangent för omedelbar sändning (ctrl+enter), som avbryter den pågående turen och skickar alla köade meddelanden på en gång, samt synkronisering till terminalen av skills och plugins som aktiverats på claude.ai-kontot. När det gäller leveranskedjan hämtas plugins från npm via npm pack --ignore-scripts med integritetskontroll, vilket förhindrar att ett pakets installationsskript körs. 2.1.276, som publicerades mindre än fyra timmar senare, åtgärdar endast en regression i den versionen: ett 400-fel som fick alla förfrågningar bakom en proxy att misslyckas.
| Versionsnummer | Publicering (UTC) | Viktigaste innehåll |
|---|---|---|
| 2.1.275 | 17/09 kl. 22.33 | Omedelbar sändning, synkronisering av skills från claude.ai, npm --ignore-scripts |
| 2.1.276 | 18/09 kl. 02.12 | En enda korrigering: 400-fel bakom en proxy |
| 2.1.277 | 18/09 kl. 18.06 | Stöd för AGENTS.md, isolering av underagenter, borttagning av TaskOutput |
🔗 Versionsinformation för 2.1.277
Qwen3.8-Omni-Flash, Qwens första agentiska omnimodala modell
18 september – Qwen lanserar Qwen3.8-Omni-Flash, som presenteras som företagets första omnimodala modell utformad kring agentiska funktioner. Fokus flyttas enligt tillkännagivandet från att förstå multimodalt innehåll till att använda det: förstå innehållet, planera uppgiften, utföra den med verktyg och leverera resultatet. Modellen tar emot text, bild, ljud och video i ett kontextfönster på en miljon tokens.
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇸🇪 Här är Qwen3.8-Omni-Flash, Qwens första omnimodala modell som byggts kring agentiska funktioner. — @Alibaba_Qwen på X
I de 29 utvärderingar som Qwen har valt ut ökar genomsnittspoängen med mer än 25 % jämfört med Qwen3.5-Omni-Plus, och vinsterna är koncentrerade till ljud- och videoagenter. Igenkänning av flera talare är det område som förbättras mest.
| Utvald utvärdering | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (lägre är bättre) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
Det mest originella inslaget är agentisk perception tillämpad på långa videor. I stället för att bearbeta en inspelning från början till slut utgår modellen från frågan, bestämmer själv vad den ska titta och lyssna på och lokaliserar informationen genom successiva genomgångar från grovt till detaljerat. På OmniVideoBench höjer detta läge precisionen från 63,4 till 67,8 samtidigt som förbrukningen minskar från 145 736 till 79 117 tokens per förfrågan, cirka 45,7 % mindre – en siffra som anges i det officiella inlägget.
Prissättningen följer samma linje: enligt Qwens metod minskar priset per timme inkommande ljud med mer än 98 % jämfört med Qwen3.5-Omni-Plus. Samtidigt öppnas två komponenter: Qwen-MM-Plugins, som är kompatibel med ramverken Codex, Claude Code, Qwen Code och Gemini CLI, samt Qwen-Live Harness för interaktion i realtid. En Realtime-variant är avsedd för kontinuerlig interaktion med låg latens och levererar sin första token efter mellan 591 och 981 millisekunder.
🔗 Qwens inlägg om Qwen3.8-Omni-Flash
Codex CLI 0.155.0 introducerar röstsamtal som experimentell funktion
17 september – OpenAI lanserar Codex CLI 0.155.0, den första stabila versionen sedan 0.154.0 den 10 september, som kan installeras med npm install -g @openai/codex@0.155.0. Det är den changelog-post som saknades för röstagenten som tillkännagavs dagen innan på X: funktionen heter /voice, erbjuder transkribering i realtid och mikrofonkontroller och är fortfarande experimentell – den är endast tillgänglig i kompatibla byggen (supported builds) och måste aktiveras med /experimental.
Resten av versionen är mer lågmäld men mer omedelbart användbar. Terminalgränssnittet får sammanfattningar av resonemanget i realtid på statusraden samt en sluttidsstämpel efter varje slutförd tur. Agentöversikten gör det möjligt att dölja, arkivera och ta bort uppgifter, visar ägarinformation för worktrees och begär bekräftelse innan hanterade, rena worktrees tas bort. På kompatibla Mac-datorer kan MCP-förfrågningar från lokala TUI-sessioner godkännas med Touch ID. Amazon Bedrock kan hämta sina AWS-autentiseringsuppgifter från konfigurerade kommandon, med cachelagring, förnyelse vid utgång och återupptagning efter autentiseringsfel.
Flera korrigeringar gäller säkerheten: processflykter från begränsade WSL-sandlådor i Windows blockeras, förmedlade shell-ögonblicksbilder förstärks mot exponering av autentiseringsuppgifter och ett kontobyte ogiltigförklarar fjärrstyrningssessioner, cachelagrat WebSocket-tillstånd och modellkataloger som tillhör den tidigare identiteten.
| Nyhet i versionen | Detalj |
|---|---|
/voice | Transkribering i realtid och mikrofonkontroller, experimentellt via /experimental |
| Terminalgränssnitt | Resonemangssammanfattningar på statusraden, sluttidsstämpel för turen |
| Agentöversikt | Döljning, arkivering och borttagning av uppgifter, ägarskap för worktrees |
| Touch ID | Godkännande av MCP-förfrågningar i lokala sessioner på kompatibla Mac-datorer |
| Amazon Bedrock | AWS-autentiseringsuppgifter hämtade via kommando, med cache och förnyelse |
🔗 Versionsinformation för Codex CLI 0.155.0
Codex redovisar sin förbrukning per uppgift, underagent och konversation
18 september – OpenAI Developers tillkännager detaljerad förbrukningsspårning i Codex: verktyget visar hur uppgifter, underagenter och enskilda konversationer bidrar till den totala användningen. Informationen finns i datorappen, under Inställningar och sedan Usage & billing för personliga konton och Business-konton, eller under Usage för berättigade Enterprise-konton. Den senaste versionen krävs för att få tillgång till funktionen. Tillkännagivandet åtföljs varken av något blogginlägg eller någon changelog-post.
Detaljnivån är det centrala. Hittills har en förbrukad kvot inte visat var förbrukningen uppstod. En uppdelning per underagent gör det möjligt att se vilken delegering som kostar och att skriva om den. Det är den redovisningsmässiga motsvarigheten till underagenternas utbredning i kodramverk.
🔗 Tillkännagivande från OpenAI Developers på X
Grok Voice Transcribe 2.0, SpaceXAI:s taligenkänning till oförändrat pris
18 september – SpaceXAI tillkännager Grok Voice Transcribe 2.0, sin nya modell för taligenkänning (speech-to-text), som beskrivs som dubbelt så exakt som version 1.0 till samma pris. Modellen bygger på den ljudgrund som redan driver Grok Voice, vilket enligt företaget hanterar tiotusentals kundsupportsamtal per dag och transkriberar miljontals timmar videoberättande.
Huvudargumentet gäller verkligt ljud snarare än laboratorieljud: instabila telefonlinjer, konkurrerande röster, lokala accenter samt telefonnummer och e-postadresser som dikteras högt. SpaceXAI gör anspråk på förstaplatsen i precision bland 32 modeller för kontinuerlig strömning i den offentliga rankningen från Artificial Analysis och hänvisar till fyra interna datamängder hämtade från produktionstrafik – telefoni i 8 kHz, samtal med Grok, dikterade identifierare och korta röstkommandon på 19 språk.
Den tydligaste förbättringen gäller flerspråkighet. I datamängden med korta fraser, som ger minst kontext för att identifiera språket, sjunker ordfelet från 20,6 % till 6,8 %. Modellen identifierar språket automatiskt och följer språkbyten under en inspelning i en enda genomgång.
| Uppmätt mått | Angivet värde |
|---|---|
| Påstådd precision jämfört med Transcribe 1.0 | dubbelt så hög |
| Rankning i Artificial Analysis (kontinuerligt flöde) | 1:a av 32 modeller |
| Felfrekvens för korta fraser (1.0 → 2.0) | 20,6 % → 6,8 % |
| Pris för batchbearbetning | 0,10 dollar per ljudtimme |
| Pris för kontinuerlig strömning | 0,20 dollar per ljudtimme |
| Kanaler som transkriberas oberoende | upp till 8 |
| Facktermer per förfrågan | upp till 100 |
Modellen hanterar batchbearbetning och kontinuerlig strömning, tidsstämplar på ordnivå med konfidenspoäng, talarseparering (diarization) utan extra kostnad och identifiering av slutet på en talares tur. Befintliga API-integrationer får den högre precisionen utan kodändringar. Grok Voice Transcribe 2.0 blir snart API:ets standardmodell och 1.0 kommer att fasas ut under de kommande veckorna: grok-voice-transcribe-1.0 måste anges uttryckligen för att fortsätta använda den.
🔗 Tillkännagivande av Grok Voice Transcribe 2.0
Anthropic tar in utvärderare från Accenture i företaget
18 september – Anthropic tillkännager ett partnerskap med Accenture om oberoende utvärdering av frontier-modeller, vilket presenteras som ett viktigt steg mot vd:ns utfästelse att ta in integrerade utvärderare (embedded). Arbetet ska utföras av Faculty, Accentures AI-specialiserade dotterbolag, och omfatta modellutvärdering och red-teaming, utvärderingar av alignment samt tester av skyddsåtgärder.
Skillnaden mot externa utvärderare anges uttryckligen: en integrerad utvärderare arbetar inne i AI-företaget med åtkomst jämförbar med en anställds. Utvärderaren kan observera modeller under träningen, följa besluten som styr hur de byggs och driftsätts, tala direkt med anställda, kontrollera att säkerhetsåtaganden uppfylls, rapportera incidenter och publicera en bättre underbyggd beskrivning av fördelar och risker. Anthropic betonar att arrangemanget inte minskar företagets ansvar utan gör det lättare att verifiera.
Tillkännagivandet är ovanligt öppet om vad som saknas. Det finns ingen standard för vilken information en integrerad utvärderare bör få tillgång till, hur resultaten bör publiceras eller hur oberoende utvärdering ska finansieras. Anthropic anser att finansieringen på sikt bör komma från gemensamma eller offentliga fonder. Eftersom någon sådan mekanism inte finns i dag finansierar företaget Accentures arbete direkt – vilket är arrangemangets tydligaste begränsning.
| Del av partnerskapet | Angivet värde |
|---|---|
| Utförande enhet | Faculty, Accentures AI-dotterbolag |
| Investering | Minst 1 miljard dollar per part under fem år |
| Omfattning | Utvärdering, red-teaming, alignment, skyddsåtgärder |
| Åtkomstnivå | Jämförbar med en anställds |
| Finansiering | Direkt från Anthropic i avsaknad av gemensamma fonder |
| Exklusivitet | Ingen, för någondera parten |
Anthropic uppger också att företaget för samtal med METR och andra ideella utvärderare om att experimentera med delar av integrerad utvärdering med egen finansiering och meddelar att fler partner kommer att presenteras under de kommande veckorna.
🔗 Anthropics tillkännagivande om integrerad utvärdering
Antigravity: tre versioner på två dagar kring anpassade agenter
Google har i snabb följd släppt två versioner av sin CLI och en version av Antigravity-appen. Alla tre behandlar samma ämne ur tre perspektiv: vad en anpassad agent vet, vad den kan vägra och hur länge den kan köras utan tillsyn. De fortsätter en intensiv serie som inleddes den 11 september, vars versioner 1.2.1 till 1.2.4 inte tas upp här.
CLI 1.2.6 öppnar en sessionsbunden Remote Control och tar bort femminutersgränsen
18 september — Åtta dagar efter 1.2.0, som gjorde CLI:n till en beständig systemtjänst, går Google i motsatt riktning med en andra, betydligt lättare form av Remote Control: en sessionsomfattande anslutning (session-scoped), som öppnas med flaggan --remote-control vid start eller med kommandot /remote-control under körning. Om man skriver /remote-control off eller stänger sessionen tas tunneln ned och enheten bort från listan. Medan 1.2.0 var inriktad på en demon som överlever sessionen, har 1.2.6 motsatt mål.
Den andra förändringen gäller läget utan gränssnitt (headless): standardtidsgränsen för körningar med -p / --prompt ändras från fem minuter till obegränsad, såvida inte --print-timeout anges uttryckligen. Den tredje strukturerar felrapporteringen — vid agent- eller API-fel skriver CLI:n en JSON-rad AGY_ERROR: {...} till standardfel som innehåller kanonisk status, HTTP- eller gRPC-kod, om felet kan försökas igen och ett fel-ID, samtidigt som slutkoden ändras från 1 till 3. Ett orkestreringsskript kan därmed skilja ett tillfälligt nätverksfel från ett permanent fel utan att analysera fritext.
CLI 1.2.5 ger äntligen Markdown-agenter en katalog över deras underagenter
17 september — Hittills kunde en anpassad agent definierad i Markdown ange invoke_subagent bland sina verktyg utan att någonsin veta vilka underagenter som fanns: den hade verktyget men inte katalogen. CLI:n lägger nu automatiskt till katalogen över tillgängliga underagenter och instruktioner för hur de används i systemprompten, vilket gör delegeringen faktisk.
Formuleringen i ändringsloggen kräver ett förtydligande: det handlar om att produkten själv lägger till kontext, inte om en säkerhetslucka eller en korrigering. Den andra förbättringen bevarar det uttryckliga namnet på en uppgift som skickats till bakgrunden, vilket tidigare försvann mellan aviseringarna och uppgiftslistorna. De fem korrigeringarna hanterar rensning av ogiltigförklarade identifierare, slutkoder för avbrutna kommandon och resonemangsrutor som blev kvar i ett fruset tillstånd.
Antigravity 2.15.0 låter anpassade agenter stänga av standardprompter och standardverktyg
18 september — Tre dagar efter 2.14.0 släpper appen 7 förbättringar och 16 korrigeringar. Den viktigaste förändringen ger anpassade agenter kontroll över sin egen kontext: de kan inaktivera standardsektionerna i prompten och standardverktygen och sedan endast återinföra dem de behöver. För en specialiserad agent minskar detta den påtvingade systemprompten i motsvarande grad.
Resten gäller navigering och beständighet: Page Up, Page Down, Home och End bläddrar i en konversation, Esc lämnar inmatningsområdet och den valda anpassade agenten sparas efter en omladdning. Två korrigeringar berör dataintegriteten — sparade inställningar och projektlistan kunde skrivas över när appen inte lyckades läsa sin tillståndsfil, och behörighetsinställningarna samlade på sig dubbletter som fick konversationsfilerna att växa.
🔗 Ändringslogg för Antigravity
GitHub Copilot: en Sentry-canvas, sex borttagna modeller och mätvärden per anpassning
Tre poster i ändringsloggen under två dagar vittnar om samma fokus: att mäta vad teamen faktiskt gör med Copilot och rensa bort det de inte längre använder.
Sammanfattningen för den 14 september lyfter fram två nya komponenter
18 september — GitHub publicerar sin veckosammanfattning för Copilot för veckan den 14 september. Merparten av sammanfattningen återger poster som redan har publicerats löpande i ändringsloggen; endast två delar hade aldrig tidigare tillkännagivits separat. Den första är Sentry-canvasen i Copilot-appen, som kopplar en produktionskraschrapport till en korrigering utan att man behöver lämna appen: den visar fel, stackspårningar (stack traces) och kontext och gör det sedan möjligt att undersöka orsaken, validera en korrigering och förbereda en pull request. Det är den första integreringen av ett felövervakningsverktyg i canvaser, efter Jira i början av september.
Den andra är agentvågen i VS Code 1.138. Fönstret Agents kan köra en agent i en lokal Dev Container, med projektets verktyg och beroenden — gradvis utrullning, Docker krävs. Inaktiva sessioner kan automatiskt markeras som avslutade när alla deras pull requests har slagits samman, med valfri radering efter en respitperiod; funktionen är i förhandsversion och måste aktiveras uttryckligen. Slutligen kan en pull request skapas direkt från en Agent Host-session.
🔗 Veckosammanfattning för Copilot
Sex modeller försvinner från alla Copilot-ytor den 19 oktober
18 september — GitHub meddelar att sex modeller tas bort från samtliga Copilot-ytor — Copilot Chat, redigering online, ask- och agentlägen samt kodkompletteringar — den 19 oktober 2026. Det är den andra utfasningsvågen som tillkännages i september.
| Borttagen modell | Datum för borttagning | Föreslaget alternativ |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
När standardaktivering av modeller används aktiveras alternativen automatiskt för Copilot Enterprise- och Business-kunder, såvida inte en administratör har inaktiverat det globala standardvärdet eller uttryckligen blockerat den berörda modellen. I så fall kan åtkomsten öppnas igen via modellpolicyerna i inställningarna. Ingen åtgärd krävs för att ta bort modellerna.
🔗 Tillkännagivande om utfasning av Copilot-modeller
Mätvärdes-API:t räknar skills, agenter, MCP-servrar och CLI-plugins
17 september — Copilots API för användningsmätvärden omfattar nu fem kategorier av agentbaserade CLI-anpassningar: skills, anpassade agenter, MCP-servrar, slash commands och plugins. Tabellerna totals_by_skill, totals_by_custom_agent, totals_by_mcp, totals_by_slash_cmd och totals_by_plugin listar de fem mest aktiva elementen med deras interaction_count, medan fälten distinct_*_use_count räknar variationen av element som används utöver dessa fem främsta.
Två nyanser förhindrar feltolkningar. För MCP-servrar ökar räknaren endast när CLI:n försöker ansluta eller återansluta — oavsett om försöket lyckas eller misslyckas — inte vid varje verktygsanrop via en etablerad anslutning. Mätvärdena för plugins räknar endast anrop av skills som är kopplade till ett plugin: de utgör en delmängd av det totala antalet skills och ska inte adderas till det. Av integritetsskäl visas endast namn som tillhandahålls av GitHub, medan namn som definierats av kunder grupperas under other.
🔗 Agentbaserade CLI-anpassningar i mätvärdes-API:t
Kodagenter i terminalen: MiniMax öppnar sin, Mistral stabiliserar sitt harness
Två tillkännagivanden från två oberoende aktörer, samma dag och på samma marknad: kodningsagenten som lever i en terminal blir allt vanligare, och differentieringen förskjuts mot licensen och stabiliteten hos dess harness.
MiniMax publicerar koden för MiniMax Code CLI under MIT-licensen
18 september — MiniMax öppnar källkoden till sin terminalbaserade kodningsagent i version 0.4.12. Verktyget installeras under namnet mcode och erbjuder tre ingångspunkter: ett interaktivt terminalgränssnitt, ett läge utan gränssnitt (mcode exec) avsett för shellskript, kontinuerlig integration och utvärderingar samt ett ACP-läge för redigerare som är kompatibla med Agent Client Protocol. Det läser projektfiler, granskar skillnader, kör shellkommandon och tester under ett system med behörigheter och sandboxing.
Valet av modell förblir öppet: MiniMax-konto och dess Token Plan å ena sidan, en tredjepartsleverantör å den andra så länge den erbjuder ett API-format som är kompatibelt med OpenAI eller Anthropic. Dessutom finns integrerad sökning, multimodala verktyg, MCP-protokollet, underagenter och ett pluginsystem. Förstapartskoden publiceras som standard under MIT-licensen. Repositoriet omfattar TUI:n, CLI:n utan gränssnitt och ACP-läget, men inte skrivbordsappen, även om felrapporteringen för den finns där. Kodförslag accepteras för närvarande endast från repositoriets medarbetare.
🔗 MiniMax tillkännagivande på X
Unified Harness i Vibe CLI lämnar experimentstatusen
18 september — Mistral släpper Vibe CLI 2.25.5, sex dagar efter 2.25.4. Den strukturella förändringen ryms på en rad i versionsanteckningarna: Unified Harness är inte längre märkt ”experimental”, och --legacy-harness fungerar nu som den dokumenterade reträttvägen till det gamla Python-harnesst. Efter en serie korrigeringsversioner med fokus på säkerheten för shellgodkännanden blir det nya harnesst det uttalade standardvalet — det är den viktiga informationen, inte versionsnumret.
Övergången åtföljs av återställd funktionsparitet: Unified Harness lägger nu in aktuell Git-gren, repositoriets status och de senaste commits i systeminstruktionerna, hooks körs äntligen inuti underagenter i stället för att ignoreras i tysthet, och leverantörer som konfigurerats utan en miljövariabel för API-nyckeln — lokala eller egenhostade servrar — fungerar återigen. Behörigheterna fortsätter att skärpas: shellgodkännanden utvidgas inte längre till ett annat program eller en annan miljö, MCP-verktygsanrop följer nu behörighetssystemet i stället för att kringgå det och smart approve slutar åsidosätta användarens regler.
🔗 Versionsanteckningar för Vibe CLI 2.25.5
ChatGPT-plugins stöder flera konton samtidigt
18 september — Stöd för flera konton införs i de flesta ChatGPT-plugins. Det blir möjligt att ansluta sitt personliga konto, sitt arbetskonto och kontona för sidoprojekt och sedan hämta kontext från vart och ett av dem till samma konversation. Kontona ansluts från plugin-katalogen på chatgpt.com/plugins.
Tillkännagivandet från kontot OpenAI Developers återger ett meddelande från Max Stoiber som publicerades en timme tidigare. För pluginutvecklare krävs ingen åtgärd: funktionen aktiveras automatiskt utan några ändringar. De som vill gå längre kan lägga till ett profile-verktyg på sin MCP-server så att ChatGPT kan etikettera anslutna konton — det är den enda konkreta åtgärd som förväntas av dem. Tillkännagivandet, som publicerades klockan 18.10 Paristid, åtföljs varken av ett blogginlägg eller en post i ändringsloggen.
Det avsedda användningsfallet är en utvecklare som håller sina identiteter åtskilda per arbetsgivare eller projekt och som hittills har behövt byta anslutning för att byta kontext.
🔗 Tillkännagivande om flera konton på X
🔗 Max Stoibers ursprungliga meddelande
Genspark lägger till ett veckovist kreditsaldo i Plus- och Pro-abonnemangen
18 september — Genspark ändrar förmånerna i sina Plus- och Pro-abonnemang genom att lägga till ett veckovist kreditsaldo utan att ändra priserna. Saldot tillkommer varje vecka utöver det befintliga abonnemanget och täcker användning i Standard-läge för samtliga agenter och verktyg på plattformen: Super Agent, AI Chat, AI Image, AI Slides, AI Sheets, AI Docs och Deep Research.
Ett andra meddelande i samma tråd beskriver hur det fungerar för AI Chat och AI Image. För befintliga abonnenter läggs saldot till det de redan har, och fram till den 31 december 2026 kan alla modeller i AI Chat och AI Image användas utan kreditkostnad, inklusive flaggskeppsmodeller som Opus. För personer som tecknar ett abonnemang från och med den 18 september är basmodellerna (core models) i AI Chat och AI Image kostnadsfria. Genspark förtydligar att förändringarna varken gäller Team- eller Enterprise-abonnemang och hänvisar till sitt hjälpcenter för närmare information om villkoren.
🔗 Gensparks tillkännagivande på X
Google Research: vad AlphaGenome Atlas har åstadkommit och simuleringar som testar sig själva
Två forskningspublikationer samma dag, med en gemensam nämnare: i båda fallen visas inte modellen, utan vad tredje parter har fått ut av den eller vad valideringsloopen kontrollerar i dess ställe.
AlphaGenome Atlas levererar de första resultaten från sina partner
17 september — Nio dagar efter publiceringen av AlphaGenome Atlas, den prediktiva kartan över de 9 miljarder möjliga substitutionerna i mänskligt DNA, fäster Google DeepMind en tråd som beskriver tre samarbeten.
| Vetenskaplig partner | Rapporterat resultat |
|---|---|
| Stowers Institute | Över 2 500 regulatoriska motiv kartlagda |
| University of Exeter / UK Biobank | Över 54 000 deltagare analyserade, mer än 22 % högre detektion av sällsynta genetiska signaler |
| Broad Institute | Kritisk mutation i genen DNM1 identifierad, därefter bekräftad och validerad i laboratorium |
Regulatoriska motiv är DNA-sekvenser som fungerar som strömbrytare och dimrar för genaktiviteten. Arbetet i Exeter identifierade också nya varianter som påverkar mängden PLA2G7, ett protein med koppling till metabol hälsa. Fallet med Broad Institute är det mest konkreta av de tre: inför en enorm lista över möjliga mutationer vid oförklarade sällsynta sjukdomar används Atlas för att peka ut den rätta, som sedan bekräftas vid laboratoriebänken. Allt detta presenteras dock endast i en tråd på X, utan något utförligt blogginlägg eller någon tillhörande publikation.
🔗 Tråd om AlphaGenome Atlas på X
Genererade pedagogiska simuleringar som sedan testas av en agent i Chrome
17 september — Gal Elidan och Yael Haramaty publicerar ett experiment där ett generativt gränssnitt (generative UI) används för att skapa pedagogiska simuleringar. Läraren behåller initiativet: läraren föreslår ämnet och Google genererar en uppsättning redigerbara lärandemål som läraren får godkänna och som ligger till grund för genereringen. Varje interaktiv simulering är uppdelad i nivåer med stigande svårighetsgrad och innehåller en verktygslåda, stegvisa ledtrådar och detaljerade lösningar.
Det mest intressanta inslaget är självkorrigeringsloopen. Genereringen kontrolleras mot pedagogiska, mekaniska och presentationsmässiga kriterier, och vissa utvärderingar utförs av agenter: testet av lösbarheten öppnar en instans av Chrome och interagerar med simuleringen som en användare skulle göra, samtidigt som det även prövar kontradiktoriska handlingar, såsom att dra reglagen till deras extremvärden. Loopen upprepas tills alla kriterier är uppfyllda, till priset av en längre genereringstid. Google publicerar över 30 interaktiva STEM-simuleringar på engelska. En samling med 40 simuleringar har utvärderats av brittiska lärare, och en studie med 12 amerikanska lärare ger ett genomsnittligt betyg på 8 av 10.
🔗 Google Researchs blogginlägg om pedagogiska interaktiva simuleringar
Claude snabbar upp över 30 biologimodeller och finansierar en proteintävling
17 september — Anthropic publicerar ett blogginlägg som beskriver hur Claude på knappt fyra veckor optimerade inferensen för över 30 open source-modeller som används av biologer – förutsägelse av strukturer, proteindesign samt språkmodeller för proteiner och genomik – med en genomsnittlig förbättring på omkring 4x. All kod publiceras som open source.
Det tekniska kärnområdet är triangular attention och triangular multiplication, som båda är kubiska i fråga om tid och minne. Claude skapade FlashPairformer, en uppsättning kernels som överträffar branschstandarden med 2,7 till 2,9x för attention. Ett lågt minnesläge kallat ”Big” gör det möjligt att noggrant vika system med över 10 000 tokens på en enda GPU-nod, medan 40S-ribosomen som förutsades av AlphaFold3 omfattade 7 663 tokens. Metoden är lika betydelsefull: arbetet övervakades av två tekniska medarbetare utan tidigare erfarenhet av inferensoptimering.
Slutligen sponsrar Anthropic tillsammans med Adaptyv Bio en tävling i proteindesign med fem svåra problem, över 5 000 experimentellt validerade designer från communityn, upp till 1 miljon dollar i Claude-krediter och 250 000 dollar i beräkningsresurser från Modal.
Öppna modeller och labb: Muse kommer till Mac, Sakana presenterar sin frontier-grupp
Meta tar sin agent Muse till macOS
18 september — Meta lanserar Muse på Mac, vilket tillkännagavs natten mellan den 17 och 18 september. Kontot @AIatMeta delar ett inlägg som beskriver en personlig agent som kan agera direkt på användarens dator, varje gång med användarens uttryckliga tillstånd. Tre användningsområden nämns: organisera mappen Hämtade filer, hitta en borttappad fil samt sammanfatta meddelanden och anteckningar.
Tillkännagivandet bygger vidare på lanseringen av Muse den 8 september, en agent som drivs av Muse Spark 1.3 och hittills har varit tillgänglig på iOS, Android, webben och WhatsApp. Övergången till Mac innebär ett nytt steg för denna typ av produkt: agenten arbetar inte längre i sin egen sandbox utan med användarens personliga filer. Meta uppger varken pris, vilka länder tjänsten finns i eller systemkrav, och inget säkerhetsdokument specifikt för Mac medföljer lanseringen – bloggen ai.meta.com har inte publicerat något sedan den 27 juli.
Sakana AI presenterar Frontier Intelligence Group och sin syn på paradigmet
18 september — Sakana AI tillkännager Frontier Intelligence Group (FIG), ett internt kollektiv som har vuxit sedan företagets tidiga dagar. Utgångspunkten är en fråga från Llion Jones, teknikchef på Sakana AI och en av uppfinnarna bakom Transformer: räcker det att skala upp Transformer-arkitekturen med ständigt mer data och beräkningskraft för att nå hela vägen till AGI? Labbets svar är nej.
Det är här den verkliga nyheten finns, snarare än i katalogen över arbeten som åtföljer den. Inlägget räknar upp de brister som det nuvarande paradigmet inte har löst – modeller som med stor säkerhet producerar falsk information, kollapsar inför verkligt nya situationer och förbrukar mycket energi – och ställer dem mot biologisk intelligens, som lär sig kontinuerligt och generaliserar utifrån betydligt mindre data. Gruppen har antagit fem principer, däribland friheten att misslyckas utan press på benchmarkresultaten. Bland de presenterade arbetena utgår de glesa Transformer-modeller som utvecklats tillsammans med NVIDIA från en uppmätt observation – över 95 % av neuronerna i ett feed-forward-lager förblir inaktiva när ett ord behandlas – och har resulterat i ett dataformat kallat TwELL, som har godkänts till ICML 2026.
🔗 Sakana AI:s inlägg om Frontier Intelligence Group
Generativ video: Runway förenar sina krediter, Pika lanserar sin första applikation
Runway gör sina krediter utbytbara mellan webbapplikationen och Runway Dev
18 september — Runway river barriären mellan sina två produkter: köpta krediter kan nu användas både i webbapplikationen och i Runway Dev, erbjudandet för utvecklare. Hittills har de två miljöerna haft separata kreditreserver och avtal, utan någon gemensam plats för att följa förbrukningen mellan olika projekt.
Förändringen åtföljs av fyra punkter: en gemensam reserv som köps centralt på en enda faktura, ett sammanhängande flöde mellan att bygga en arbetskedja i webbapplikationen och att exponera den via API, förstärkt support för Runway Dev med tillgång till Applied AI Architects samt en omarbetad analysvy för arbetsytan där administratörer kan överföra krediter mellan webb- och Dev-arbetsytor. Två kommersiella erbjudanden gäller till den 31 december 2026: 10 % extra krediter vid avtalstecknande för nya företagskunder, vilket enligt Runways angivna omräkning motsvarar minst 130 minuters video eller 12 000 bilder, samt för befintliga kunder 5 000 krediter och en dag med en Applied AI Architect i utbyte mot en rekommendation till den produktansvarige för AI-applikationer.
🔗 Runways inlägg om enhetlig prissättning
Pika lanserar Product Ad, från produktfoto till videoreklam
18 september — Dagen efter presentationen av sin nya kreativa plattform lanserar Pika dess första applikation: Product Ad. Applikationen tar en eller flera produktbilder, kombinerar dem med en skriftlig brief och skapar en video som presenteras som marknadsfärdig.
| Genereringsparameter | Föreslaget värde |
|---|---|
| Tillgängliga längder | 6 s, 15 s, 30 s, 60 s, 2 min |
| Utdataformat | 16:9 |
| Förväntade indata | produktbilder och skriftlig brief |
| Åtkomst | konto måste skapas |
Pika publicerar tillkännagivandet med hänvisning till sitt eget meddelande från dagen före om omarbetningen av plattformen, vilket placerar Product Ad i en serie väntade applikationer snarare än som en fristående funktion. Ingen modell namnges och inget pris anges.
NVIDIA lanserar AIPerf, efterföljaren till GenAI-Perf för att mäta storskalig inferens
18 september — NVIDIA presenterar AIPerf, sitt verktyg för prestandamätning av generativ inferens, som beskrivs som efterföljaren till GenAI-Perf och har skrivits om från grunden. Utgångspunkten är välbekant: när en modell väl har driftsatts besvaras frågan ”är den snabb?” ofta med curl-kommandon eller en improviserad lastgenerator, som ger siffror man inte kan lita på.
Skillnaden ligger i arkitekturen. Medan de flesta verktyg körs i en enda process och stöter på Python-tolkens globala lås när samtidigheten ökar, fördelar AIPerf arbetet: arbetsprocesser genererar lasten och separata tjänster behandlar resultaten, medan allt samordnas via ZMQ. Målet är uttryckligt – mätklienten ska aldrig själv bli flaskhalsen.
| Rapporterat mått | Vad det mäter |
|---|---|
| Time to First Token | Tiden från att begäran skickas tills första token |
| Inter-Token Latency | Tiden mellan två efterföljande tokens under genereringen |
| Svarstid för begäran | Tiden från början till slut för det fullständiga svaret |
| Genomströmning av utdata | Tokens som produceras per sekund för alla begäranden |
| Rapporterade percentiler | p25, p50, p75, p90, p95, p99 |
| Typer av endpoints | över 15 |
Verktyget kan också spela upp spår från verklig trafik i formaten Mooncake, Baseten och WEKA. Artikeln betonar framför allt nyttan med fördelningar: en server vars genomsnittliga tid till första token ser sund ut men vars p99 skjuter i höjden passerar obemärkt i aggregerade data och misslyckas i produktion.
Mistral tillbakavisar ett påstående om obehörig åtkomst till sina system
18 september — Mistral publicerar klockan 05.48 UTC ett kort uttalande på sitt X-konto som svar på ett påstående om obehörig åtkomst till företagets system. Företaget uppger att det har genomfört en grundlig utredning, inte funnit några belägg för påståendet och bekräftar att dess system inte har komprometterats.
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇸🇪 Vi känner till ett påstående om obehörig åtkomst till våra system. Efter en grundlig utredning har vi inte funnit några belägg som stöder detta påstående och kan bekräfta att våra system inte har komprometterats. — @MistralAI på X
Meddelandet namnger inte den som framförde påståendet, anger varken dess datum eller karaktär och lämnar inga detaljer om utredningens omfattning. Det är Mistrals ståndpunkt, och endast den, som återges här: det ursprungliga påståendet har inte kunnat granskas. Uttalandet är kontots mest visade meddelande under perioden, och ingen kompletterande publicering har hittats på företagets webbplats.
Kortnyheter
- Balyasny Asset Management berättar hur bolaget styr användningen av Claude Fable 5 — bolaget, som förvaltar omkring 38 miljarder dollar, kortar den inledande analysen av ett fusionsarbitrage från tre–fem dagar till mindre än en dag, med en agent som körs i cirka 30 minuter och en mänsklig granskning. 🔗 källa
- Codex CLI 0.155.1 inaktiverar återigen resonemangssammanfattningar som standard — en enda korrigering dagen efter 0.155.0: när de aktiverades automatiskt avvisades förfrågningarna av leverantörer som inte stöder dem. 🔗 källa
- Gemini CLI återupptar sin nightly-serie efter en dag utan utgåva — fyra ändringar den 18 september, däribland att OAuth-refresh token behålls vid en förnyelse och att borttagningen av autentiseringsuppgifter har gjorts idempotent; kanalerna stable och preview är oförändrade. 🔗 källa
- Kimi Code 2.0.1 snabbar upp start och återupptagning av sessioner — en korrigeringsversion 32 timmar efter 2.0.0: komprimering av sessionsindexet, snabbare återupptagning för långa historiker, möjlighet att läsa API-nyckeln från en namngiven miljövariabel och begränsade filövervakare. 🔗 källa
- Qwen Code går in i förhandsversion v0.24.1 med ett Playwright-SDK för webbläsare — det är inte en stabil version; den introducerar integrerad webbläsarstyrning med vidarebefordran via Chrome native messaging samt körning av underagenter i containrar. 🔗 källa
- Zed släpper den stabila versionen 1.20.2, med endast två korrigeringar — betalningsfel från tredjepartsleverantörer av modeller visar inte längre en uppmaning att uppgradera till Zed Pro i stället för det ursprungliga meddelandet, och två snippets-tillägg för samma språk tar inte längre ut varandra. 🔗 källa
- Replit hävdar att Free Mode är ”30 gånger” generösare, utan publicerad referens — endast en tweet, utan länk eller changelog, som inte anger vad faktorn jämförs med: detta bör ses som ett påstående från Replit, inte som ett mätresultat. 🔗 källa
- Copilots instrumentpanel för påverkan delar upp engagemanget per funktion — sju ytor över 28 dagar, med åtskillnad mellan aktiv och passiv kodgranskning, och en population för införandefasen som nu beräknas med ett glidande fönster. 🔗 källa
- GitHub planerar en direktsänd introduktion till Copilot SDK på sex språk — sessioner, verktyg, MCP-servrar och strömmande händelser, med särskilda sessioner för .NET och Java, utan förkunskapskrav. 🔗 källa
- Runway Ruby bevarar alfakanalen vid konvertering till HDR — konverteringen av råmaterial till HDR behåller transparensen intakt i ett enda steg; varken pris eller abonnemangsnivå anges. 🔗 källa
- MiniMax ansluter sig till Singtel AI Pass för Singapores SkillsFuture-program — MiniMax H3, MiniMax Agent och MiniMax Audio ingår nu i erbjudandet, som riktar sig till berättigade deltagare i fler än 200 AI-kurser med stöd av SWDA; inga belopp eller tidsplaner anges. 🔗 källa
- VC-Attention snabbar upp uppmärksamhetsmekanismen i MiniMax-H3 utan ny träning — MiniMax lyfter fram Nunchux AI:s arbete med en uppmärksamhetsmekanism med låg precision som kan tillämpas på den befintliga modellen; Nunchux AI uppger 1,6× på B200 och 1,5× på B300 jämfört med FlashAttention-4. 🔗 källa
- Wan3.0 placerar sig på andra plats i videokategorin i OpenArt Arena — Alibaba framhäver 30-sekunderssekvenser, inbyggt ljud och stöd för alla typer av referenser; det handlar om en placering i en tredjepartsrankning, utan någon produktnyhet. 🔗 källa
- Synthesia öppnar sitt amerikanska huvudkontor i New York — en företagsnyhet utan uppgifter om produkt, personalstyrka eller investeringsplan, två dagar efter att företagets Interactive Avatar API blev allmänt tillgängligt. 🔗 källa
- Grok Imagine redovisar kostnaden för ett pilotavsnitt som producerats helt med AI — PJaccetturos studio uppger nio dagars arbete, 3 627 genererade bilder och 3 043 genererade videor till en genereringskostnad på 2 677 dollar för pilotavsnittet av tävlingen Odyssée. 🔗 källa
- BananaMind 2 Pro närmar sig SmolLM2 med tjugo gånger färre tokens — en modell med 139 miljoner parametrar, tränad på 100 miljarder tokens och ett RTX 5070 Ti, når 42,78 % på HellaSwag jämfört med 43,22 för SmolLM2-135M, som tränades på 2 000 miljarder tokens. 🔗 källa
- Optimum-Intel v2.2.0 och OpenVINO GenAI 2026.4.0 utökar exporten till Intel-hårdvara — Hugging Face och Intel släpper gemensamma versioner som omfattar Intel-processorer, grafikkort och NPU:er, och Mistral 3 kan nu exporteras. 🔗 källa
- AmberTrace Labs mäter troheten i Olmo 3:s resonemang under RL med verifierbar belöning — för prober som hölls utanför träningen ökar troheten från 0,238 till 0,262: en positiv utveckling snarare än en försämring, med publicerade checkpoints. 🔗 källa
- Together AI hävdar den bästa tiden till första token för DeepSeek V4.1 Flash — företaget vidarebefordrar en tredjepartsmätning för förvärmda förfrågningar utan att publicera vare sig metod eller värde: ett påstående, inte ett verifierbart resultat. 🔗 källa
- Google Flow hjälper två kreatörer under New York Fashion Week — skräddarsydda verktyg som tagits fram tillsammans med Jane Wade och Sergio Hudson; ett användningsexempel, utan någon ny modell eller lanserad funktion. 🔗 källa
- Google AI Educator Series ger rätt till akademiska poäng — utbildningens kurser ger nu akademiska poäng eller fortbildningspoäng. 🔗 källa
Vad det innebär
Dagen säger framför allt en sak: kodagenter slutar vara slutna produkter och börjar dela format med varandra. Claude Code läser AGENTS.md när ett projekt saknar CLAUDE.md — det vill säga att Anthropic godtar en instruktionsfil som definierats någon annanstans, så att samma kodförråd kan användas av flera verktyg. Samma dag infogar Antigravity katalogen över tillgängliga underagenter i systemprompten för sina Markdown-agenter, Vibe CLI ser äntligen till att hooks körs inuti underagenter, Codex delar upp kostnaden per underagent och Qwen Code placerar sina i containrar. Delegering mellan agenter var ett konfigurationslöfte; nu blir den en mekanism som måste dokumenteras, isoleras och faktureras. Claude Code fullföljer dessutom misstroendets logik genom att märka resultat från underagenter med en särskild rubrik, så att vidarebefordrad text inte kan utge sig för att vara en instruktion.
Marknaden för terminalagenter håller samtidigt uppenbart på att standardiseras. MiniMax släpper sin under MIT-licens med TUI, headless-läge, ACP och fritt modellval; Mistral tar bort etiketten ”experimentell” från sitt Unified Harness och dokumenterar --legacy-harness som en utväg; Kimi Code släpper en prestandakorrigering 32 timmar efter sin huvudversion. När fyra leverantörer erbjuder samma typ av produkt med samma ingångar flyttas differentieringen: den ligger i licensen, verktygsramverkets stabilitet och behörighetsmodellen — och det är just där dagens ändringar hos såväl Mistral som Anthropic sker.
På modellsidan går utvecklingen mot att ljud och video blir agentiska snarare än beskrivande. Qwen3.8-Omni-Flash försöker inte längre beskriva en video utan hitta ett svar i den: genom att utgå från frågan ökar modellen resultatet på OmniVideoBench med 4,4 poäng samtidigt som den förbrukar 45,7 % färre tokens — prestanda och besparing går åt samma håll, vilket är ovanligt. Grok Voice Transcribe 2.0 satsar å sin sida inte på en laboratoriedemonstration utan på verklig trafik, med en felfrekvens för korta meningar som sjunker från 20,6 % till 6,8 % och ett oförändrat pris. De båda tillkännagivandena pekar åt samma håll: värdet kommer inte längre från vilken modalitet som stöds, utan från vad modellen beslutar att behandla.
Kvar står frågan om vad laboratorierna är beredda att låta andra verifiera. Anthropic betalar Accenture för att placera utvärderare inom det egna företaget, med åtkomst som anställda — och medger i samma tillkännagivande att det inte finns någon standard för vad en sådan utvärderare bör få tillgång till, hur slutsatserna bör publiceras eller vem som bör finansiera arbetet. Det är lika mycket ett erkännande som ett arrangemang. Vid sidan av detta är dagens starkaste belägg sådana som en tredje part kan återskapa: resultaten från Exeter och Stowers Institute om AlphaGenome Atlas, den biomolekylära optimeringskoden som publicerats som open source och AmberTrace Labs checkpoints. Och motsatsen syns lika tydligt: Replit anger en faktor på 30 utan referens, Together AI återger en rankning utan metod och Mistral förnekar ett påstående som ingen har kunnat läsa. I det här landskapet kommer AIPerf helt rätt i tiden — ett mätverktyg som börjar med att medge att den som mäter ofta är problemet.
Källor
- Claude Code, versionsinformation för 2.1.277
- CHANGELOG för Claude Code
- Qwen, inlägg om Qwen3.8-Omni-Flash
- Alibaba Qwen på X, tillkännagivande av modellen
- Codex CLI, versionsinformation för 0.155.0
- OpenAI Developers på X, detaljerad förbrukning i Codex
- SpaceXAI, Grok Voice Transcribe 2.0
- Anthropic, integrerad utvärdering med Accenture
- Antigravity-changelog
- GitHub, veckosammanfattning för Copilot den 14 september
- GitHub, utfasning av sex Copilot-modeller
- GitHub, agentiska CLI-anpassningar i API:et för mätvärden
- MiniMax på X, publicering av källkoden för MiniMax Code CLI
- Vibe CLI, versionsinformation för 2.25.5
- OpenAI Developers på X, plugins för flera konton
- Max Stoiber på X, det ursprungliga meddelandet om flera konton
- Genspark på X, veckosaldot för Plus och Pro
- Google DeepMind på X, partnernas resultat för AlphaGenome Atlas
- Google Research, pedagogiska interaktiva upplevelser genom ett generativt gränssnitt
- Anthropic Research, Claude och biomolekylär modellering
- Meta AI på X, Muse för Mac
- Sakana AI, Frontier Intelligence Group
- Runway, enhetlig prissättning
- Pika på X, lansering av Product Ad
- NVIDIA, mätning av inferens i stor skala med AIPerf
- Mistral AI på X, dementi den 18 september