ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-5.6-sol.
هذا الجمعة، تتجه أدوات الوكلاء نحو صيغ مشتركة: يقرأ Claude Code الآن AGENTS.md عندما لا يحتوي المشروع على CLAUDE.md، ويُدرج Antigravity فهرس الوكلاء الفرعيين في موجّه النظام لوكلائه المكتوبين بصيغة Markdown، ويعرض Codex استهلاكه بالتفصيل حسب كل وكيل فرعي، فيما تفتح MiniMax الشيفرة المصدرية لوكيل الطرفية الخاص بها. أما بقية اليوم فتتلخص في إصدار نموذجين — Qwen3.8-Omni-Flash وGrok Voice Transcribe 2.0 — وشراكة غير مألوفة: تستضيف Anthropic مقيّمين من Accenture داخل شركتها نفسها.
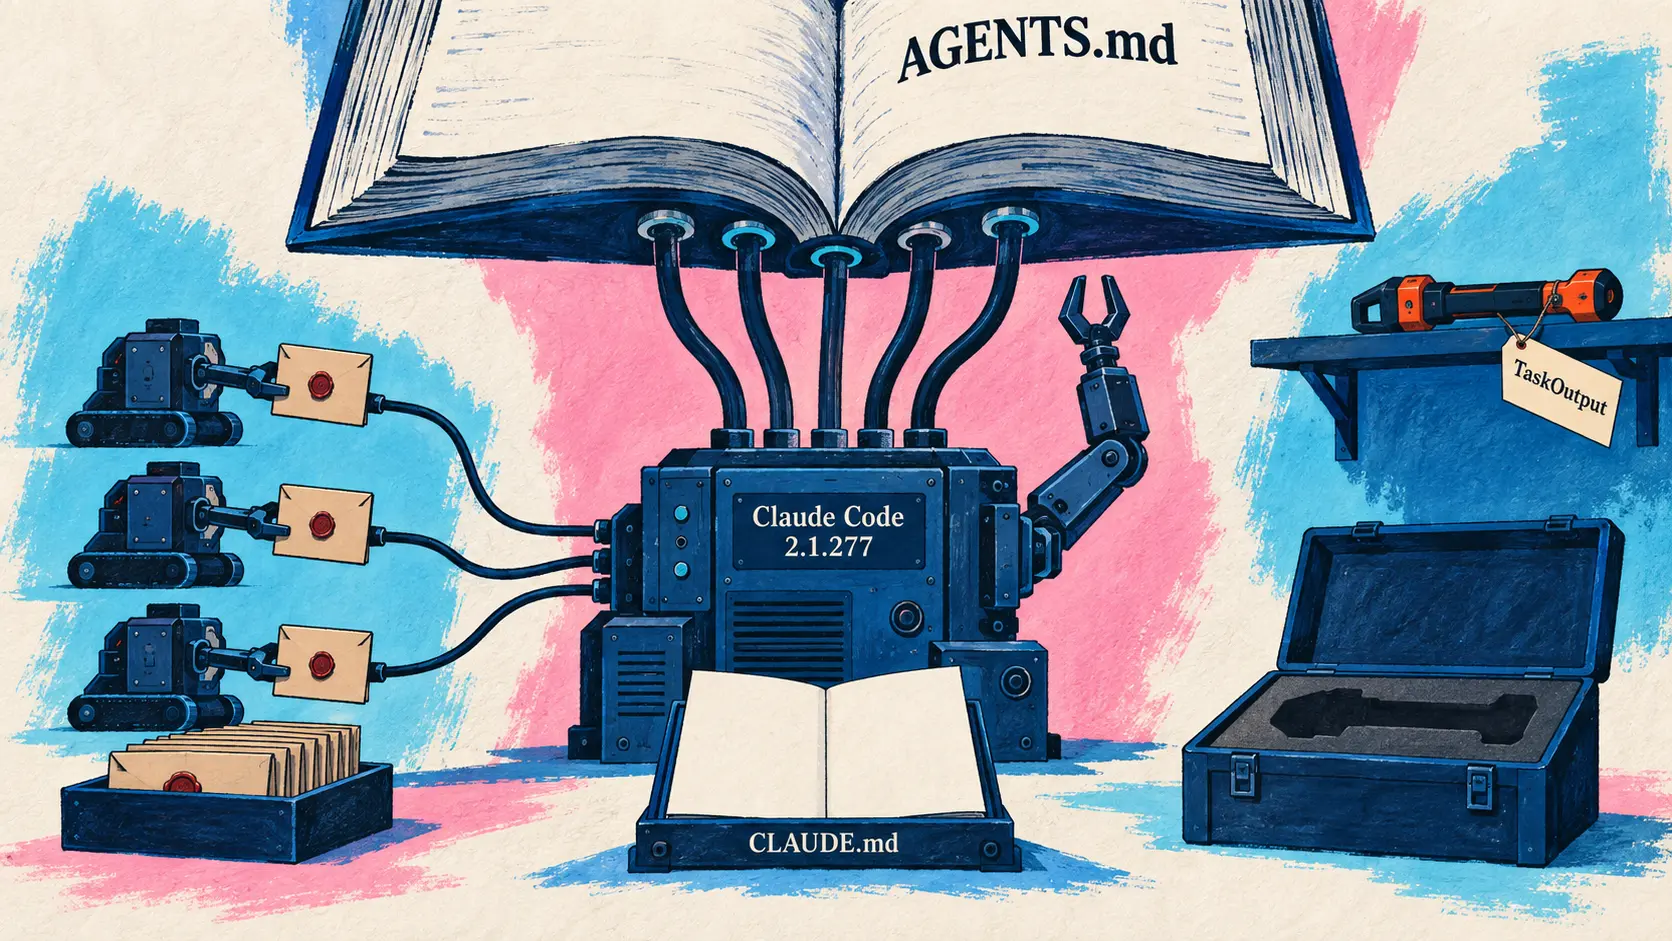
Claude Code يقرأ AGENTS.md ويعزل الوكلاء الفرعيين ويلغي TaskOutput
18 سبتمبر — توالت ثلاثة إصدارات من Claude Code خلال عشرين ساعة: الإصدار 2.1.275 في 17 سبتمبر عند الساعة 22:33 بالتوقيت العالمي المنسق، والإصدار 2.1.276 في 18 سبتمبر عند الساعة 02:12 بالتوقيت العالمي المنسق، والإصدار 2.1.277 في 18 سبتمبر عند الساعة 18:06 بالتوقيت العالمي المنسق.
تتمثل الإضافة الأكثر تأثيرًا في البنية في سطر واحد ضمن الإصدار 2.1.277. ففي أي مشروع يخلو من CLAUDE.md، يقرأ Claude Code ملف AGENTS.md، وهو ملف التعليمات الذي أصبح عُرفًا مشتركًا بين عدة وكلاء برمجة في السوق. ويمكن ضبط الخيار في /config ضمن «تعليمات المشروع». ولم تتوفر الميزة بعد على Bedrock أو Vertex أو Foundry.
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇸🇦 أُضيف دعم AGENTS.md: في أي مشروع بلا CLAUDE.md، يقرأ Claude Code ملف AGENTS.md بدلًا منه؛ ويمكن تغيير الإعداد ضمن «تعليمات المشروع» في /config (لم يتوفر بعد على Bedrock أو Vertex أو Foundry). — سجل تغييرات Claude Code، anthropics/claude-code
يمس تغييران آخران في الإصدار نفسه أمن السياق. إذ تُعاد نتائج الوكلاء الفرعيين إلى الوكيل الرئيسي تحت ترويسة تميّزها بصفتها كذلك، حتى لا يتمكن نص أعاده وكيل فرعي من الظهور بمظهر تعليمات صادرة عن الجلسة؛ كما تُحذف محارف تنسيق Unicode غير المرئية من الموجّهات، وتُعرض النسخة المنقحة قبل إرسالها. ويحذف الإصدار 2.1.277 أيضًا الأداة المهملة TaskOutput: إذ يقرأ Claude الآن ملف إخراج مهمة تعمل في الخلفية باستخدام Read.
يضيف الإصدار 2.1.275 مفتاحًا للإرسال الفوري (ctrl+enter) يوقف الجولة الجارية ويرسل دفعة واحدة جميع الرسائل الموجودة في قائمة الانتظار، كما يضيف مزامنة المهارات والإضافات المفعّلة في حساب claude.ai إلى الطرفية. وعلى صعيد سلسلة التوريد، تُسترجع الإضافات القادمة من npm بواسطة npm pack --ignore-scripts مع التحقق من السلامة، ما يمنع تشغيل نصوص تثبيت الحزمة. أما الإصدار 2.1.276، الذي نُشر بعد أقل من أربع ساعات، فلا يصلح سوى تراجع في هذا الإصدار: خطأ 400 كان يُفشل جميع الطلبات خلف خادم وكيل.
| رقم الإصدار | النشر (UTC) | أبرز المحتويات |
|---|---|---|
| 2.1.275 | 17/09 عند 22:33 | إرسال فوري، ومزامنة مهارات claude.ai، وnpm --ignore-scripts |
| 2.1.276 | 18/09 عند 02:12 | إصلاح وحيد: خطأ 400 خلف خادم وكيل |
| 2.1.277 | 18/09 عند 18:06 | دعم AGENTS.md، وعزل الوكلاء الفرعيين، وإلغاء TaskOutput |
Qwen3.8-Omni-Flash، أول نموذج شامل الوسائط ووكيل من Qwen
18 سبتمبر — تنشر Qwen نموذج Qwen3.8-Omni-Flash، وتقدّمه بوصفه أول نموذج شامل الوسائط لديها صُمم حول القدرات الوكيلة. لم يعد التحول المعلن يقتصر على فهم المحتوى متعدد الوسائط، بل أصبح يتمثل في استخدامه: فهم المحتوى، والتخطيط للمهمة، وتنفيذها بالأدوات، وتسليم النتيجة. يقبل النموذج النصوص والصور والصوت والفيديو ضمن نافذة سياق تبلغ مليون token.
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇸🇦 نقدم لكم Qwen3.8-Omni-Flash، أول نموذج شامل الوسائط من Qwen مبني حول القدرات الوكيلة. — @Alibaba_Qwen على X
في التقييمات الـ29 التي اختارتها Qwen، ارتفع متوسط النتيجة بأكثر من 25% مقارنةً بـQwen3.5-Omni-Plus، مع تركز المكاسب لدى وكلاء الصوت والفيديو. وشهد التعرف على المتحدثين المتعددين أكبر تحسن.
| التقييم المختار | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (الأقل أفضل) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
تتمثل النقطة الأكثر ابتكارًا في تطبيق الإدراك الوكيل على مقاطع الفيديو الطويلة. فبدلًا من معالجة التسجيل من بدايته إلى نهايته، ينطلق النموذج من السؤال المطروح، ويقرر بنفسه ما ينبغي مشاهدته والاستماع إليه، ويحدد موضع المعلومة عبر مراحل متعاقبة تنتقل من العام إلى الدقيق. وفي OmniVideoBench، يرفع هذا الوضع الدقة من 63,4 إلى 67,8، مع خفض الاستهلاك من 145 736 إلى 79 117 token لكل طلب، أي أقل بنحو 45,7% — وهو رقم يورده المنشور الرسمي نفسه.
ويتبع ذلك جانب التسعير: وفق منهجية Qwen، ينخفض سعر كل ساعة من مدخلات الصوت بأكثر من 98% مقارنةً بـQwen3.5-Omni-Plus. كما أُتيح مكونان في الوقت نفسه، هما Qwen-MM-Plugins، المتوافق مع بيئات Codex وClaude Code وQwen Code وGemini CLI، وQwen-Live Harness للتفاعل في الوقت الفعلي. وخُصص إصدار Realtime للتفاعل المستمر منخفض الكمون، مع ظهور أول token خلال مدة تتراوح بين 591 و981 ميلي ثانية.
🔗 منشور Qwen عن Qwen3.8-Omni-Flash
Codex CLI 0.155.0 يُدخل المحادثات الصوتية إلى المرحلة التجريبية
17 سبتمبر — تنشر OpenAI الإصدار Codex CLI 0.155.0، وهو أول إصدار مستقر منذ 0.154.0 الصادر في 10 سبتمبر، ويمكن تثبيته بواسطة npm install -g @openai/codex@0.155.0. وهذا هو إدخال سجل التغييرات الذي كان ينقص الوكيل الصوتي المُعلن عنه في اليوم السابق على X: تحمل الميزة اسم /voice، وتوفر النسخ المباشر وعناصر التحكم في الميكروفون، ولا تزال تجريبية — فهي متاحة فقط في الإصدارات المدعومة، ويجب تفعيلها بواسطة /experimental.
أما بقية الإصدار فهي أقل بروزًا، لكنها أكثر فائدة بصورة فورية. تحصل واجهة الطرفية على ملخصات مباشرة للاستدلال في سطر الحالة، إضافةً إلى طابع زمني للانتهاء بعد كل جولة ناجحة. وتتيح معاينة الوكلاء إخفاء المهام وأرشفتها وحذفها، مع تفاصيل ملكية أشجار العمل وتأكيد قبل حذف أشجار العمل المُدارة والنظيفة. وعلى أجهزة Mac المتوافقة، يمكن اعتماد طلبات MCP الخاصة بجلسات TUI المحلية باستخدام Touch ID. ويمكن لـAmazon Bedrock الحصول على بيانات اعتماد AWS من أوامر معدّة مسبقًا، مع التخزين المؤقت والتحديث عند انتهاء الصلاحية والاستئناف بعد فشل المصادقة.
ترتبط عدة إصلاحات بالأمن: إذ حُظرت عمليات الهروب الخاصة بعمليات Windows من بيئات WSL المعزولة والمقيّدة، وعُززت حماية لقطات shell الوسيطة من كشف بيانات الاعتماد، وأصبح تغيير الحساب يبطل جلسات التحكم عن بُعد وحالة WebSocket المخزنة مؤقتًا وفهارس النماذج التابعة للهوية السابقة.
| ميزة الإصدار الجديدة | التفاصيل |
|---|---|
/voice | نسخ مباشر وعناصر تحكم في الميكروفون، تجريبية عبر /experimental |
| واجهة الطرفية | ملخصات الاستدلال في سطر الحالة، وطابع زمني لنهاية الجولة |
| معاينة الوكلاء | إخفاء المهام وأرشفتها وحذفها، وملكية أشجار العمل |
| Touch ID | اعتماد طلبات MCP في الجلسة المحلية على أجهزة Mac المتوافقة |
| Amazon Bedrock | بيانات اعتماد AWS تُستخرج بواسطة أمر، مع التخزين المؤقت والتحديث |
🔗 ملاحظات إصدار Codex CLI 0.155.0
Codex يعرض استهلاكه بالتفصيل حسب المهمة والوكيل الفرعي والمحادثة
18 سبتمبر — تعلن OpenAI Developers عن تتبع مفصل للاستهلاك في Codex: توضح الأداة كيفية مساهمة المهام والوكلاء الفرعيين والمحادثات الفردية في إجمالي الاستخدام. توجد المعلومة في تطبيق سطح المكتب، ضمن «الإعدادات» ثم «الاستخدام والفوترة» للحسابات الشخصية وحسابات Business، أو ضمن «الاستخدام» لحسابات Enterprise المؤهلة؛ ويجب تحديث التطبيق إلى أحدث إصدار للاستفادة منها. ولم يرافق الإعلان أي منشور في المدونة أو إدخال في سجل التغييرات.
مستوى التفصيل هو جوهر المسألة. ففي السابق، لم يكن نفاد الحصة يكشف مصدر الإنفاق؛ أما توزيع الاستهلاك حسب الوكيل الفرعي فيتيح معرفة أي تفويض يستهلك الموارد، ثم إعادة صياغته. وهذا هو النظير المحاسبي لتعميم الوكلاء الفرعيين في بيئات البرمجة.
🔗 إعلان OpenAI Developers على X
Grok Voice Transcribe 2.0، نظام التعرف على الكلام من SpaceXAI بالسعر نفسه
18 سبتمبر — تعلن SpaceXAI عن Grok Voice Transcribe 2.0، نموذجها الجديد للتعرف على الكلام، وتصفه بأنه أدق بمرتين من الإصدار 1.0 بالسعر نفسه. يستند النموذج إلى البنية الصوتية الأساسية التي تشغّل Grok Voice بالفعل، والتي تعالج، وفقًا للشركة، عشرات الآلاف من مكالمات دعم العملاء يوميًا وتنسخ ملايين الساعات من السرد المرئي.
تتمحور الحجة الأساسية حول الصوت الواقعي بدلًا من الصوت المختبري: خطوط هاتف غير مستقرة، وأصوات متداخلة، ولهجات محلية، وأرقام هواتف وعناوين بريد إلكتروني تُملى بصوت مرتفع. وتدّعي SpaceXAI احتلال المركز الأول في الدقة بين 32 نموذجًا للبث المستمر في تصنيف Artificial Analysis العام، وتستند إلى أربع مجموعات بيانات داخلية مأخوذة من حركة الاستخدام الفعلية — اتصالات هاتفية بتردد 8 kHz، ومحادثات مع Grok، ومعرّفات مُملاة، وأوامر صوتية قصيرة بـ19 لغة.
يتعلق أوضح تحسن بتعدد اللغات. ففي مجموعة الجمل القصيرة، وهي الجمل التي توفر أقل قدر من السياق لتحديد اللغة، ينخفض معدل الخطأ في الكلمات من 20,6% إلى 6,8%. ويكتشف النموذج اللغة تلقائيًا ويتتبع تغيرها أثناء التسجيل ضمن معالجة واحدة.
| المقياس المقاس | القيمة المعلنة |
|---|---|
| الدقة المعلنة مقارنةً بـTranscribe 1.0 | أعلى بمرتين |
| ترتيب Artificial Analysis (البث المستمر) | الأول من بين 32 نموذجًا |
| معدل الخطأ في الجمل القصيرة (1.0 ← 2.0) | 20,6% ← 6,8% |
| سعر المعالجة على دفعات | 0,10 دولار لكل ساعة صوت |
| سعر البث المستمر | 0,20 دولار لكل ساعة صوت |
| القنوات المنسوخة بصورة مستقلة | حتى 8 |
| مصطلحات المجال لكل طلب | حتى 100 |
يدعم النموذج المعالجة على دفعات والبث المستمر، والطوابع الزمنية على مستوى الكلمة مع درجة ثقة، وفصل المتحدثين دون تكلفة إضافية، واكتشاف نهاية دور المتحدث. وتحصل عمليات التكامل الحالية مع API على زيادة الدقة من دون أي تغيير في الشيفرة. وسيصبح Grok Voice Transcribe 2.0 قريبًا النموذج الافتراضي في API، فيما سيُهمل الإصدار 1.0 خلال الأسابيع المقبلة: وسيتعين تثبيت grok-voice-transcribe-1.0 للاستمرار في استخدامه.
🔗 إعلان Grok Voice Transcribe 2.0
Anthropic تستضيف مقيّمين من Accenture داخل الشركة
18 سبتمبر — تعلن Anthropic عن شراكة مع Accenture لإجراء تقييم مستقل لنماذج الحدود القصوى، وتقدمها بوصفها خطوة مهمة نحو الوفاء بالتزام مديرها التنفيذي باستضافة مقيّمين مدمجين. ستتولى Faculty، الشركة التابعة لـAccenture والمتخصصة في الذكاء الاصطناعي، تنفيذ العمل، وسيشمل تقييم النماذج واختبارها الهجومي، وتقييمات المواءمة، واختبارات حواجز الأمان.
التمييز بينها وبين المقيّمين الخارجيين واضح: يعمل المقيّم المدمج داخل شركة الذكاء الاصطناعي بصلاحية وصول تضاهي صلاحية الموظف. ويمكنه مراقبة النماذج أثناء تدريبها، وتتبع القرارات التي تحكم بناءها ونشرها، والتحدث مباشرةً إلى الموظفين، والتحقق من الوفاء بالتزامات السلامة، والإبلاغ عن الحوادث، ونشر وصف أكثر استنارة للفوائد والمخاطر. وتوضح Anthropic أن هذا الترتيب لا يقلل مسؤوليتها، بل يجعلها أكثر قابلية للتحقق.
يتسم الإعلان بصراحة غير معتادة بشأن ما ليس موجودًا. فلا توجد أي معايير تحدد المعلومات التي ينبغي أن يستطيع المقيّم المدمج الوصول إليها، ولا كيفية نشر نتائجه، ولا نظام راسخ لتمويل التقييم المستقل. وترى Anthropic أن هذا التمويل ينبغي أن يأتي في نهاية المطاف من صناديق مشتركة أو عامة؛ وفي غياب مثل هذه الآلية حاليًا، تمول الشركة عمل Accenture مباشرةً — وهو ما يمثل أبرز قيود هذا الترتيب.
| عنصر الشراكة | القيمة المعلنة |
|---|---|
| الجهة المنفذة | Faculty، شركة الذكاء الاصطناعي التابعة لـAccenture |
| الاستثمار | ما لا يقل عن مليار دولار من كل طرف على مدى خمس سنوات |
| النطاق المشمول | التقييم، والاختبار الهجومي، والمواءمة، وحواجز الأمان |
| مستوى الوصول | مماثل لمستوى وصول الموظف |
| التمويل | مباشر من Anthropic في غياب صناديق مشتركة |
| الحصرية | لا توجد لدى أي من الطرفين |
وتشير Anthropic أيضًا إلى أنها تجري مناقشات مع METR ومقيّمين آخرين غير ربحيين لتجربة بعض عناصر التقييم المدمج بتمويلهم الخاص، وتعلن عن شركاء آخرين خلال الأسابيع المقبلة.
🔗 إعلان Anthropic عن التقييم المدمج
Antigravity: ثلاثة إصدارات في يومين حول الوكلاء المخصصين
أصدرت Google تباعًا إصدارين من CLI وإصدارًا من تطبيق Antigravity. تتناول الإصدارات الثلاثة الموضوع نفسه من ثلاث زوايا: ما يعرفه الوكيل المخصص، وما يمكنه رفضه، وإلى أي مدى يمكنه العمل دون إشراف. وهي تواصل سلسلة كثيفة بدأت في 11 سبتمبر، ولا تشمل هنا الإصدارات من 1.2.1 إلى 1.2.4.
يتيح CLI 1.2.6 ميزة Remote Control مرتبطة بالجلسة ويلغي حد الدقائق الخمس
18 سبتمبر — بعد ثمانية أيام من الإصدار 1.2.0، الذي جعل CLI خدمة نظام دائمة، تتخذ Google اتجاهًا معاكسًا مع صيغة ثانية أخف بكثير من Remote Control: اتصال يقتصر نطاقه على الجلسة، يُفتح بواسطة الخيار --remote-control عند بدء التشغيل أو بواسطة الأمر /remote-control أثناء العمل. تؤدي كتابة /remote-control off أو إغلاق الجلسة إلى تفكيك النفق وإزالة الجهاز من القائمة. وبينما كان الإصدار 1.2.0 يستهدف خدمة خفية تبقى بعد انتهاء الجلسة، يستهدف الإصدار 1.2.6 العكس.
يتعلق التغيير الثاني بالوضع دون واجهة: أصبحت مهلة انتهاء تنفيذات -p / --prompt الافتراضية غير محدودة بدلًا من خمس دقائق، ما لم يُحدَّد --print-timeout صراحةً. أما التغيير الثالث فينظم الإبلاغ عن الأخطاء: عند فشل الوكيل أو API، يكتب CLI في مخرجات الخطأ سطر JSON من نوع AGY_ERROR: {...} يتضمن الحالة المعيارية، ورمز HTTP أو gRPC، وما إذا كانت إعادة المحاولة ممكنة، ومعرّفًا للخطأ، مع تغيير رمز الخروج من 1 إلى 3. وبذلك يستطيع برنامج نصي للتنسيق التمييز بين عطل مؤقت في الشبكة وخطأ نهائي دون تحليل نص حر.
يمنح CLI 1.2.5 أخيرًا وكلاء Markdown دليل وكلائهم الفرعيين
17 سبتمبر — حتى الآن، كان بإمكان وكيل مخصص معرّف في Markdown إعلان invoke_subagent ضمن أدواته دون أن يعرف مطلقًا الوكلاء الفرعيين الموجودين: فقد كان يمتلك الأداة دون الدليل. يضيف CLI الآن تلقائيًا إلى موجه النظام الخاص به فهرس الوكلاء الفرعيين المتاحين وتعليمات استخدامهم، ما يجعل التفويض فعالًا.
تستحق مفردات سجل التغييرات بعض الحذر: فالأمر إضافة للسياق يجريها المنتج نفسه، وليس ثغرة أمنية ولا إصلاحًا. ويحافظ التحسين الثاني على الاسم الصريح لمهمة أُرسلت إلى الخلفية، إذ كان يضيع بين الإشعارات وقوائم المهام. وتعالج الإصلاحات الخمسة حذف المعرّفات التي أُبطلت، ورموز خروج الأوامر التي تمت مقاطعتها، وإطارات التفكير التي كانت تظل عالقة.
يتيح Antigravity 2.15.0 للوكلاء المخصصين تعطيل الموجهات والأدوات الافتراضية
18 سبتمبر — بعد ثلاثة أيام من الإصدار 2.14.0، أصدر التطبيق 7 تحسينات و16 إصلاحًا. يمنح التغيير الرئيسي الوكلاء المخصصين التحكم في سياقهم الخاص: إذ يمكنهم تعطيل أقسام الموجه الافتراضية والأدوات الافتراضية، ثم إعادة إدراج ما يحتاجون إليه فقط. وبالنسبة إلى وكيل متخصص، يقلل ذلك بقدر مماثل موجه النظام المفروض.
أما البقية فتتناول التنقل والاستمرارية: تتيح مفاتيح Page Up وPage Down وHome وEnd تمرير المحادثة، ويُخرج مفتاح Escape التركيز من منطقة الإدخال، ويُحفظ الوكيل المخصص المحدد بعد إعادة التحميل. ويتناول إصلاحان سلامة البيانات؛ إذ كان من الممكن استبدال الإعدادات المحفوظة وقائمة المشاريع عندما يفشل التطبيق في قراءة ملف حالته، كما كانت إعدادات الأذونات تراكم نسخًا مكررة تؤدي إلى تضخم ملفات المحادثات.
GitHub Copilot: لوحة Sentry، وسحب ستة نماذج، ومقاييس بحسب التخصيص
ترسم ثلاثة إدخالات في سجل التغييرات خلال يومين الانشغال نفسه: قياس ما تفعله الفرق فعليًا باستخدام Copilot، وتنظيف ما لم تعد تستخدمه.
ملخص 14 سبتمبر يفرد مكوّنين جديدين
18 سبتمبر — نشرت GitHub ملخص Copilot الأسبوعي لأسبوع 14 سبتمبر. يعيد معظم الملخص عرض إدخالات سبق نشرها تباعًا في سجل التغييرات؛ ولم يكن قد أُعلن بصورة منفصلة سوى عنصرين. الأول هو لوحة Sentry في تطبيق Copilot، التي تربط تقرير تعطل في بيئة الإنتاج بإصلاح دون مغادرة التطبيق: فهي تعرض الأخطاء، وتتبع المكدس، والسياق، ثم تتيح التحقيق في السبب، والتحقق من صحة الإصلاح، وإعداد pull request. وهذا أول دمج لأداة لمراقبة الأخطاء في اللوحات، بعد Jira في مطلع سبتمبر.
والثاني هو موجة الوكلاء في VS Code 1.138. يمكن لنافذة Agents تشغيل وكيل داخل Dev Container محلي باستخدام أدوات المشروع وتبعياته؛ ويجري طرح الميزة تدريجيًا، مع اشتراط Docker. ويمكن وسم الجلسات غير النشطة تلقائيًا على أنها مكتملة بمجرد دمج جميع طلبات السحب الخاصة بها، مع إمكانية حذفها بعد فترة سماح، وذلك في إصدار المعاينة ويتطلب تفعيلًا صريحًا. وأخيرًا، يمكن إنشاء pull request مباشرةً من جلسة Agent Host.
ستة نماذج تغادر جميع واجهات Copilot في 19 أكتوبر
18 سبتمبر — أعلنت GitHub سحب ستة نماذج من جميع واجهات Copilot، بما يشمل Copilot Chat، والتعديلات المضمنة، ووضعَي ask وagent، وإكمالات الشيفرة، وذلك في 19 أكتوبر 2026. وهذه ثاني موجة إيقاف أُعلن عنها في سبتمبر.
| النموذج المسحوب | تاريخ السحب | البديل المقترح |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
عند تفعيل النماذج افتراضيًا، تُفعّل البدائل تلقائيًا لعملاء Copilot Enterprise وBusiness، إلا إذا عطّل أحد المسؤولين القيمة الافتراضية العامة أو حظر النموذج المعني صراحةً؛ وفي هذه الحالة، يُعاد فتح الوصول عبر سياسات النماذج في الإعدادات. ولا يلزم اتخاذ أي إجراء لسحب النماذج.
تحصي API المقاييس مهارات CLI ووكلاءه وخوادم MCP وملحقاته
17 سبتمبر — تغطي API مقاييس استخدام Copilot الآن خمس فئات من تخصيصات CLI الوكيلية: المهارات، والوكلاء المخصصين، وخوادم MCP، وأوامر الشرطة المائلة، والملحقات. تسرد الجداول totals_by_skill وtotals_by_custom_agent وtotals_by_mcp وtotals_by_slash_cmd وtotals_by_plugin العناصر الخمسة الأكثر نشاطًا مع interaction_count الخاص بكل منها، بينما تحصي حقول distinct_*_use_count تنوع العناصر المستخدمة خارج هذه الخمسة الأوائل.
تمنع نقطتان دقيقتان إساءة الفهم. بالنسبة إلى خوادم MCP، لا يزداد العداد إلا عندما يحاول CLI الاتصال أو إعادة الاتصال، سواء نجحت المحاولة أم فشلت، وليس عند كل استدعاء لأداة عبر اتصال قائم. ولا تحصي مقاييس الملحقات سوى استدعاءات المهارات المرتبطة بملحق؛ فهي تشكل مجموعة فرعية من إجمالي المهارات ولا ينبغي جمعها معه. ولأسباب تتعلق بالخصوصية، لا تُعرض إلا الأسماء التي توفرها GitHub، بينما تُجمع الأسماء التي يحددها العملاء تحت other.
🔗 تخصيصات CLI الوكيلية في API المقاييس
وكلاء البرمجة في الطرفية: MiniMax تفتح وكيلها، وMistral تثبّت منظومة تشغيلها
إعلانان من جهتين غير مرتبطتين، في اليوم نفسه والسوق نفسه: أصبح وكيل البرمجة الذي يعمل داخل الطرفية أمرًا شائعًا، وانتقل التمايز إلى الترخيص واستقرار منظومة التشغيل.
تنشر MiniMax شيفرة MiniMax Code CLI بترخيص MIT
18 سبتمبر — فتحت MiniMax الشيفرة المصدرية لوكيل البرمجة العامل في الطرفية، بالإصدار 0.4.12. تُثبّت الأداة باسم mcode وتوفر ثلاث نقاط دخول: واجهة طرفية تفاعلية، ووضعًا دون واجهة (mcode exec) مخصصًا لبرامج shell النصية والتكامل المستمر والتقييمات، ووضع ACP للمحررات المتوافقة مع Agent Client Protocol. وهي تقرأ ملفات المشروع، وتفحص الفروقات، وتنفذ أوامر shell والاختبارات ضمن نظام للأذونات والعزل.
يظل اختيار النموذج مفتوحًا: حساب MiniMax وخطة Token Plan من جهة، ومزود خارجي من جهة أخرى ما دام يوفر تنسيق API متوافقًا مع OpenAI أو Anthropic. ويضاف إلى ذلك بحث مدمج، وأدوات متعددة الوسائط، وبروتوكول MCP، ووكلاء فرعيون، ونظام ملحقات. تُنشر الشيفرة الأصلية افتراضيًا بموجب ترخيص MIT. ويغطي المستودع TUI وCLI دون واجهة ووضع ACP، لكنه لا يشمل تطبيق سطح المكتب، مع أنه يستضيف تتبع أعطاله؛ ولا تُقبل مقترحات الشيفرة حاليًا إلا من المتعاونين في المستودع.
يغادر Unified Harness في Vibe CLI الحالة التجريبية
18 سبتمبر — أصدرت Mistral الإصدار Vibe CLI 2.25.5، بعد ستة أيام من الإصدار 2.25.4. يتلخص التغيير البنيوي في سطر واحد من ملاحظات الإصدار: لم يعد Unified Harness يحمل وسم «تجريبي»، وأصبح --legacy-harness الآن وسيلة الرجوع الموثقة إلى منظومة التشغيل القديمة المكتوبة بلغة Python. وبعد سلسلة من الإصدارات التصحيحية التي ركزت على أمن الموافقات على أوامر shell، أصبحت منظومة التشغيل الجديدة الخيار الافتراضي المعتمد؛ وهذه هي المعلومة المهمة، لا رقم الإصدار.
يصاحب الانتقال استدراك لتحقيق التكافؤ: يحقن Unified Harness الآن فرع Git الحالي، وحالة المستودع، وأحدث عمليات الالتزام في تعليمات النظام؛ وتُنفذ الخطافات أخيرًا داخل الوكلاء الفرعيين بدلًا من تجاهلها بصمت؛ كما عادت للعمل الجهات المزودة التي أُعدت دون متغير بيئة لمفتاح API، مثل الخوادم المحلية أو المستضافة ذاتيًا. ويستمر تشديد الأذونات: فلم تعد موافقات shell تتوسع لتشمل برنامجًا أو بيئة أخرى، وأصبحت استدعاءات أدوات MCP تحترم نظام الأذونات بدلًا من تجاوزه، ولم تعد ميزة smart approve تتحايل على قواعد المستخدم.
🔗 ملاحظات إصدار Vibe CLI 2.25.5
تقبل ملحقات ChatGPT عدة حسابات في الوقت نفسه
18 سبتمبر — وصل دعم الحسابات المتعددة إلى معظم ملحقات ChatGPT. وبات من الممكن ربط الحساب الشخصي، والحساب المهني، وحسابات المشاريع الجانبية، ثم جلب سياق كل منها إلى محادثة واحدة. ويجري ربط الحسابات من دليل الملحقات على chatgpt.com/plugins.
يعيد إعلان حساب OpenAI Developers نشر رسالة كتبها Max Stoiber قبل ساعة. أما مطورو الملحقات فلا يتعين عليهم فعل شيء؛ إذ تُفعّل الميزة تلقائيًا دون أي تعديل. ويمكن لمن يريد المضي أبعد إضافة أداة profile إلى خادم MCP الخاص به، كي يتمكن ChatGPT من وضع تسميات على الحسابات المتصلة؛ وهذا هو الإجراء العملي الوحيد المتوقع منهم. ولم يرافق الإعلان، المنشور في الساعة 18:10 بتوقيت باريس، أي تدوينة أو إدخال في سجل التغييرات.
وتستهدف حالة الاستخدام مطورًا يفصل هوياته بحسب جهة العمل أو المشروع، وكان مضطرًا حتى الآن إلى تبديل الاتصال لتغيير السياق.
🔗 إعلان الحسابات المتعددة على X
تضيف Genspark رصيدًا أسبوعيًا من النقاط إلى خطتي Plus وPro
18 سبتمبر — عدّلت Genspark مزايا اشتراكي Plus وPro بإضافة رصيد أسبوعي من النقاط دون تغيير سعر الخطتين. يصل هذا الرصيد كل أسبوع بالإضافة إلى الخطة المشترك فيها بالفعل، ويغطي الاستخدام في الوضع Standard عبر جميع وكلاء المنصة وأدواتها: Super Agent وAI Chat وAI Image وAI Slides وAI Sheets وAI Docs وDeep Research.
تشرح رسالة ثانية في السلسلة نفسها آلية العمل في AI Chat وAI Image. بالنسبة إلى المشتركين الحاليين، يُضاف الرصيد إلى ما لديهم بالفعل، وحتى 31 ديسمبر 2026 يمكن استخدام جميع نماذج AI Chat وAI Image دون تكلفة من النقاط، بما في ذلك النماذج الرائدة مثل Opus؛ أما الأشخاص الذين يشتركون ابتداءً من 18 سبتمبر، فتكون النماذج الأساسية في AI Chat وAI Image مجانية لهم. وتوضح Genspark أن هذه التغييرات لا تنطبق على خطط Team أو Enterprise، وتحيل إلى مركز المساعدة للاطلاع على تفاصيل الشروط.
Google Research: ما أنتجه AlphaGenome Atlas، ومحاكاة تختبر نفسها بنفسها
منشوران بحثيان في اليوم نفسه يشتركان في نقطة واحدة: في كلتا الحالتين، لا يُعرض النموذج نفسه، بل ما استخلصته منه جهات خارجية، أو ما تتحقق منه حلقة التحقق نيابةً عنه.
يقدم AlphaGenome Atlas أولى نتائج شركائه
17 سبتمبر — بعد تسعة أيام من نشر AlphaGenome Atlas، الخريطة التنبؤية لتسعة مليارات من بدائل DNA البشري الممكنة، ثبّتت Google DeepMind سلسلة منشورات تفصّل ثلاثة تعاونات.
| الشريك العلمي | النتيجة المعلنة |
|---|---|
| Stowers Institute | رسم خرائط لأكثر من 2,500 نمط تنظيمي |
| University of Exeter / UK Biobank | تحليل أكثر من 54,000 مشارك، وزيادة اكتشاف الإشارات الجينية النادرة بأكثر من 22% |
| Broad Institute | تحديد طفرة حرجة في جين DNM1، ثم تأكيدها والتحقق منها مخبريًا |
الأنماط التنظيمية هي تسلسلات DNA التي تعمل كمفاتيح ومقابض تحكم في نشاط الجينات. كما حدد العمل المنجز في Exeter متغيرات جديدة تؤثر في وفرة PLA2G7، وهو بروتين مرتبط بصحة الأيض. وتُعد حالة Broad Institute الأكثر واقعية بين الحالات الثلاث: إذ يُستخدم Atlas، أمام قائمة هائلة من الطفرات المحتملة في أمراض نادرة غير مفسرة، لتحديد الطفرة الصحيحة التي يؤكدها المختبر لاحقًا. ومع ذلك، لا يتجاوز الأمر كله سلسلة منشورات على X، دون تدوينة مفصلة أو بحث منشور مصاحب.
🔗 سلسلة AlphaGenome Atlas على X
عمليات محاكاة تعليمية مولَّدة، ثم مختبَرة بواسطة وكيل في Chrome
17 سبتمبر — نشر Gal Elidan وYael Haramaty تجربة تطبّق الواجهة التوليدية (generative UI) على إنشاء عمليات محاكاة تعليمية. ويظل المعلّم صاحب المبادرة: يقترح الموضوع، ثم تنشئ Google مجموعة من أهداف التعلّم القابلة للتعديل والخاضعة لموافقته، لتكون أساسًا لعملية التوليد. ويُقسَّم كل محتوى تفاعلي إلى مستويات متزايدة الصعوبة، مع صندوق أدوات وتلميحات تدريجية وحلول مفصّلة.
العنصر الأكثر إثارة للاهتمام هو حلقة التصحيح الذاتي. تخضع عملية التوليد لمعايير تربوية وميكانيكية وتقديمية، وبعض التقييمات ينفّذها وكلاء: إذ يفتح اختبار قابلية الحل نسخة من Chrome ويتعامل مع المحاكاة كما يفعل المستخدم، ويحاول أيضًا تنفيذ إجراءات مضادّة مثل دفع أشرطة التمرير إلى قيمها القصوى. وتتكرر الحلقة حتى تُستوفى جميع المعايير، على حساب إطالة زمن التوليد. وتنشر Google أكثر من 30 محتوى تفاعليًا في مجالات STEM باللغة الإنجليزية؛ وقد قيّم معلّمون بريطانيون مجموعة تضم 40 منها، كما أسفرت دراسة شملت 12 معلّمًا أمريكيًا عن متوسط تقييم بلغ 8 من 10.
🔗 تدوينة Google Research عن المحتويات التعليمية التفاعلية
Claude يسرّع أكثر من 30 نموذجًا في علم الأحياء ويموّل مسابقة لتصميم البروتينات
17 سبتمبر — نشرت Anthropic تدوينة تصف كيف حسّن Claude استدلال أكثر من 30 نموذجًا مفتوح المصدر يستخدمها علماء الأحياء — للتنبؤ بالبنية، وتصميم البروتينات، ونماذج اللغة البروتينية والجينومية — خلال أقل بقليل من أربعة أسابيع، مع تحسّن بلغ نحو 4x في المتوسط. ونُشرت الشيفرة كاملةً كمصدر مفتوح.
يركّز الجانب التقني على الانتباه المثلثي والضرب المثلثي، اللذين يتطلبان زمنًا وذاكرةً من الرتبة التكعيبية. أنشأ Claude نظام FlashPairformer، وهو مجموعة من kernels تتجاوز معيار المجال بمقدار يتراوح بين 2.7 و2.9x في الانتباه. ويتيح وضع منخفض الذاكرة يُسمّى «Big» طيّ أنظمة تضم أكثر من 10,000 tokens بدقة على عقدة GPU واحدة، في حين كان ريبوسوم 40S الذي تنبأ به AlphaFold3 يضم 7,663 tokens. ولا تقل المنهجية أهميةً عن ذلك: فقد أشرف على العمل عضوان من الطاقم التقني لم تكن لديهما خبرة سابقة في تحسين الاستدلال.
وأخيرًا، تشارك Anthropic مع Adaptyv Bio في رعاية مسابقة لتصميم البروتينات تتناول خمس مسائل صعبة، مع أكثر من 5,000 تصميم مجتمعي جرى التحقق منها تجريبيًا، وما يصل إلى مليون دولار من أرصدة Claude و250,000 دولار من موارد الحوسبة التي تقدمها Modal.
النماذج المفتوحة والمختبرات: وصول Muse إلى Mac وكشف Sakana عن مجموعتها للأبحاث الرائدة
Meta تجلب وكيلها Muse إلى macOS
18 سبتمبر — أطلقت Meta تطبيق Muse على Mac، بعدما أُعلن عنه في ليلة 17 إلى 18 سبتمبر. وأعاد حساب @AIatMeta نشر منشور يصف وكيلًا شخصيًا قادرًا على تنفيذ إجراءات مباشرة على حاسوب المستخدم، بعد الحصول على إذنه الصريح في كل مرة. وذُكرت ثلاثة استخدامات: تنظيم مجلد التنزيلات، والعثور على ملف مفقود، وتلخيص الرسائل والملاحظات.
يمثّل الإعلان امتدادًا لإطلاق Muse في 8 سبتمبر، وهو وكيل مدعوم بـ Muse Spark 1.3 وكان متاحًا حتى الآن على iOS وAndroid والويب وWhatsApp. ويأخذ الانتقال إلى Mac هذا النوع من المنتجات إلى مرحلة جديدة: فلم يعد الوكيل يعمل داخل بيئته المعزولة، بل على ملفات المستخدم الشخصية. ولم تفصح Meta عن السعر أو بلدان الإتاحة أو المتطلبات اللازمة، كما لم يصاحب الإطلاق أي مستند أمني خاص بـ Mac — إذ لم تنشر مدونة ai.meta.com شيئًا منذ 27 يوليو.
Sakana AI تكشف عن Frontier Intelligence Group وموقفها من النموذج السائد
18 سبتمبر — أعلنت Sakana AI عن وجود Frontier Intelligence Group (FIG)، وهي مجموعة داخلية أخذت تنمو منذ بدايات الشركة. وينطلق المشروع من سؤال طرحه Llion Jones، المدير التقني في Sakana AI وأحد مخترعي Transformer: هل يكفي توسيع بنية Transformer باستمرار باستخدام مزيد من البيانات والحوسبة للوصول إلى AGI؟ إجابة المختبر هي لا.
تكمن المعلومة الأساسية هنا، أكثر مما تكمن في قائمة الأبحاث المصاحبة لها. تسرد التدوينة العيوب التي لم يحلّها النموذج السائد حاليًا — نماذج تنتج معلومات خاطئة بثقة، وتنهار عند مواجهة مواقف جديدة حقًا، وتستهلك قدرًا كبيرًا من الطاقة — وتقابلها بالذكاء البيولوجي، الذي يتعلّم باستمرار ويعمّم انطلاقًا من بيانات أقل بكثير. وتتبنى المجموعة خمسة مبادئ، من بينها حرية الفشل من دون ضغط لتحقيق نتائج مرتفعة في benchmarks. ومن بين الأبحاث المعروضة، تنطلق أعمال Transformer المتناثر المنفّذة بالتعاون مع NVIDIA من ملاحظة مقاسة — إذ يظل أكثر من 95% من عصبونات طبقة feed-forward صامتًا أثناء معالجة كلمة — وقد أفضت إلى تنسيق بيانات يحمل اسم TwELL وقُبل في ICML 2026.
🔗 تدوينة Sakana AI عن Frontier Intelligence Group
الفيديو التوليدي: Runway توحّد استخدام أرصدتها وPika تطلق تطبيقها الأول
Runway تجعل أرصدتها قابلة للاستخدام بين تطبيق الويب وRunway Dev
18 سبتمبر — أزالت Runway الحاجز بين منتجيها: فأصبح من الممكن استخدام الأرصدة المشتراة بالتساوي في تطبيق الويب وفي Runway Dev، وهو العرض الموجّه إلى المطورين. وحتى الآن، كان العالمان يعتمدان على احتياطيات منفصلة وعقود مختلفة، من دون مكان موحّد لمتابعة الاستهلاك من مشروع إلى آخر.
يرافق التغيير أربع نقاط: احتياطي موحّد يُشترى مركزيًا ضمن فاتورة واحدة، ومسار متصل بين بناء تسلسل في تطبيق الويب وإتاحته عبر API، ودعم معزّز لـ Runway Dev مع إمكانية الوصول إلى Applied AI Architects، وواجهة تحليلات معاد تصميمها لمساحة العمل تتيح للمسؤولين نقل الأرصدة بين مساحات الويب وDev. ويسري عرضان تجاريان حتى 31 ديسمبر 2026: أرصدة إضافية بنسبة 10% عند التوقيع للشركات الجديدة، بما يعادل 130 دقيقة على الأقل من الفيديو أو 12,000 صورة وفق التحويل الذي أعلنته Runway؛ وللعملاء الحاليين، 5,000 رصيد بالإضافة إلى يوم عمل مع Applied AI Architect، مقابل إحالة إلى مدير منتجات تطبيقات الذكاء الاصطناعي.
🔗 تدوينة Runway عن التسعير الموحّد
Pika تطلق Product Ad لتحويل صورة المنتج إلى إعلان فيديو
18 سبتمبر — في اليوم التالي للكشف عن منصتها الإبداعية الجديدة، أطلقت Pika أول تطبيق عليها: Product Ad. يأخذ التطبيق صورة واحدة أو أكثر للمنتج، ويدمجها مع موجز مكتوب، ثم ينتج منها فيديو يُقدَّم على أنه جاهز للسوق.
| معلمة التوليد | القيمة المقترحة |
|---|---|
| المُدد المتاحة | 6 s، 15 s، 30 s، 60 s، 2 min |
| تنسيق الإخراج | 16:9 |
| المدخلات المطلوبة | صور المنتج وموجز مكتوب |
| الوصول | يلزم إنشاء حساب |
نشرت Pika الإعلان مع الاستشهاد برسالتها المنشورة في اليوم السابق بشأن إعادة تصميم المنصة، ما يضع Product Ad ضمن سلسلة من التطبيقات المنتظرة بدلًا من كونه ميزة منفردة. ولم يُذكر اسم أي نموذج أو يُعلَن عن أي سعر.
NVIDIA تنشر AIPerf، خليفة GenAI-Perf لقياس الاستدلال واسع النطاق
18 سبتمبر — قدّمت NVIDIA أداة AIPerf لقياس أداء الاستدلال التوليدي، بوصفها خليفة GenAI-Perf وقد أُعيدت كتابتها من الصفر. وتنطلق من ملاحظة مألوفة: فبعد نشر نموذج، غالبًا ما يُجاب عن سؤال «هل هو سريع؟» باستخدام أوامر curl أو مولّد أحمال مرتجل، ما ينتج أرقامًا لا يمكن الوثوق بها.
يكمن التحول في البنية. ففي حين تعمل معظم الأدوات ضمن عملية واحدة وتصطدم بالقفل العام لمفسّر Python بمجرد ارتفاع مستوى التزامن، توزّع AIPerf العمل: تولّد عمليات التشغيل الحمل، وتعالج خدمات منفصلة النتائج، مع تنسيق المنظومة بأكملها عبر ZMQ. والهدف واضح — ألا يصبح عميل القياس نفسه عنق الزجاجة أبدًا.
| المؤشر المعروض | ما يقيسه |
|---|---|
| Time to First Token | الزمن بين إرسال الطلب وأول token |
| Inter-Token Latency | الزمن بين tokenين متتاليين أثناء التوليد |
| زمن استجابة الطلب | الزمن الكامل من البداية إلى النهاية للاستجابة |
| معدل نقل tokens في الإخراج | عدد tokens المنتجة في الثانية عبر جميع الطلبات |
| الشرائح المئوية المعروضة | p25، p50، p75، p90، p95، p99 |
| أنواع نقاط النهاية | أكثر من 15 |
وتستطيع الأداة أيضًا إعادة تشغيل سجلات حركة المرور الفعلية بتنسيقات Mooncake وBaseten وWEKA. ويركّز المقال خصوصًا على فائدة التوزيعات: فقد يبدو متوسط زمن الخادم حتى أول token سليمًا، لكن ارتفاع p99 يظل غير ظاهر في القيم الإجمالية ويؤدي إلى الفشل في بيئة الإنتاج.
Mistral تنفي ادعاءً بالوصول غير المصرّح به إلى أنظمتها
18 سبتمبر — نشرت Mistral عند الساعة 05:48 UTC بيانًا موجزًا على حسابها في X، ردًا على ادعاء بالوصول غير المصرّح به إلى أنظمتها. وقالت الشركة إنها أجرت تحقيقًا معمقًا، ولم تجد أي دليل يؤيد هذا الادعاء، وأكدت أن أنظمتها لم تتعرض للاختراق.
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇸🇦 نحن على علم بادعاء يفيد بحدوث وصول غير مصرّح به إلى أنظمتنا. وبعد تحقيق معمق، لم نجد أي دليل يؤيد هذا الادعاء، ويمكننا تأكيد أن أنظمتنا لم تتعرض للاختراق. — @MistralAI على X
لا تذكر الرسالة صاحب الادعاء، ولا تحدد تاريخه أو طبيعته، ولا تقدم أي تفاصيل عن نطاق التحقيق. وما يُنقل هنا هو موقف Mistral وحده، إذ تعذّر الاطلاع على الادعاء الأصلي. وكان البيان أكثر رسائل الحساب مشاهدةً خلال الفترة، ولم يُعثر على أي منشور تكميلي على موقع الشركة.
موجز الأخبار
- Balyasny Asset Management تشرح كيفية تأطيرها لاستخدام Claude Fable 5 — تقلّص الشركة، التي تدير نحو 38 مليار دولار، مدة التحليل الأولي لمراجحة الاندماج من ثلاثة إلى خمسة أيام إلى أقل من يوم، عبر وكيل يعمل لنحو 30 دقيقة ثم يخضع لمراجعة بشرية. 🔗 المصدر
- Codex CLI 0.155.1 يعيد تعطيل ملخصات الاستدلال افتراضيًا — إصلاح وحيد صدر في اليوم التالي للإصدار 0.155.0: إذ كان تفعيلها تلقائيًا يؤدي إلى رفض الطلبات من جانب مزوّدي الخدمة الذين لا يدعمونها. 🔗 المصدر
- Gemini CLI يستأنف سلسلة إصداراته الليلية بعد يوم بلا إصدار — أربعة تغييرات في 18 سبتمبر، منها الاحتفاظ برمز تحديث OAuth عند التجديد وجعل حذف بيانات الاعتماد متسامحًا مع التكرار؛ بينما بقيت قناتا stable وpreview من دون تغيير. 🔗 المصدر
- Kimi Code 2.0.1 يسرّع بدء التشغيل واستئناف الجلسات — إصدار إصلاحي بعد 32 ساعة من الإصدار 2.0.0: ضغط فهرس الجلسات، واستئناف أسرع للسجلات الطويلة، وإمكانية قراءة مفتاح API من متغير بيئة مسمّى، وتقييد مراقبي الملفات. 🔗 المصدر
- Qwen Code ينتقل إلى النسخة التمهيدية v0.24.1 مع SDK للمتصفح قائم على Playwright — ليست هذه نسخة مستقرة؛ إذ تقدم تحكمًا مدمجًا في المتصفح مع وسيط للمراسلة الأصلية في Chrome، وتشغيل الوكلاء الفرعيين داخل حاويات. 🔗 المصدر
- Zed يصدر النسخة المستقرة 1.20.2 بإصلاحين فقط — لم تعد أخطاء الدفع لدى مزوّدي النماذج الخارجيين تعرض دعوة للترقية إلى Zed Pro بدلًا من الرسالة الأصلية، كما لم تعد إضافتان للمقتطفات البرمجية للغة نفسها تلغي إحداهما الأخرى. 🔗 المصدر
- Replit يدّعي أن Free Mode أصبح أكثر سخاءً «30 مرة»، من دون مرجع منشور — تغريدة منفردة بلا رابط أو سجل تغييرات، ولا توضح الأساس الذي تُقارن به هذه النسبة: ينبغي التعامل معها بوصفها ادعاءً من Replit، لا قياسًا. 🔗 المصدر
- لوحة معلومات تأثير Copilot تفصّل التفاعل حسب الميزة — سبع واجهات على مدى 28 يومًا، مع تمييز مراجعة الكود النشطة من السلبية، واحتساب مجموعة مرحلة التبني الآن ضمن نافذة متحركة. 🔗 المصدر
- GitHub يحدد موعد بث مباشر تمهيدي حول SDK الخاص بـCopilot بست لغات — يتناول الجلسات والأدوات وخوادم MCP والأحداث المتدفقة، مع جلسات مخصصة لـ.NET وJava، ومن دون متطلبات مسبقة. 🔗 المصدر
- Runway Ruby يحافظ على قناة alpha عند التحويل إلى HDR — يحافظ تحويل مقطع خام إلى HDR على الشفافية دون تغيير، في خطوة واحدة؛ ولم يُحدَّد السعر أو مستوى الاشتراك. 🔗 المصدر
- MiniMax ينضم إلى Singtel AI Pass ضمن برنامج SkillsFuture السنغافوري — تدخل MiniMax H3 وMiniMax Agent وMiniMax Audio ضمن العرض الموجّه إلى المتعلمين المؤهلين في أكثر من 200 دورة في الذكاء الاصطناعي تدعمها SWDA؛ من دون تحديد مبالغ أو جدول زمني. 🔗 المصدر
- VC-Attention يسرّع آلية الانتباه في MiniMax-H3 من دون إعادة تدريب — تنقل MiniMax أعمال Nunchux AI حول آلية انتباه منخفضة الدقة قابلة للتطبيق على النموذج الحالي؛ وتعلن Nunchux AI تسارعًا بمقدار 1.6x على B200 و1.5x على B300 مقارنةً بـFlashAttention-4. 🔗 المصدر
- Wan3.0 يحتل المركز الثاني في فئة الفيديو ضمن OpenArt Arena — تبرز Alibaba اللقطات التي تبلغ مدتها 30 ثانية والصوت الأصلي ودعم أي مرجع؛ وهو تموضع في تصنيف لطرف ثالث، من دون مستجدات على مستوى المنتج. 🔗 المصدر
- Synthesia تفتتح مقرها الأمريكي في نيويورك — خبر مؤسسي بلا منتج أو عدد موظفين أو جدول زمني للاستثمار، وذلك بعد يومين من الإتاحة العامة لـInteractive Avatar API. 🔗 المصدر
- Grok Imagine يفصّل تكلفة حلقة تجريبية أُنتجت بالكامل بالذكاء الاصطناعي — أعلن استوديو PJaccetturo عن تسعة أيام من العمل، وتوليد 3,627 صورة و3,043 مقطع فيديو، بتكلفة توليد بلغت 2,677 دولارًا، وذلك للحلقة التجريبية من مسابقة Odyssée. 🔗 المصدر
- BananaMind 2 Pro يقترب من SmolLM2 باستخدام رموز أقل بعشرين مرة — حقق نموذج يضم 139 مليون معلمة ودُرّب على 100 مليار رمز وبطاقة RTX 5070 Ti نتيجة 42.78% على HellaSwag، مقابل 43.22 لنموذج SmolLM2-135M المدرّب على 2,000 مليار رمز. 🔗 المصدر
- Optimum-Intel v2.2.0 وOpenVINO GenAI 2026.4.0 يوسّعان التصدير إلى عتاد Intel — أصدرت Hugging Face وIntel نسختين متزامنتين تغطيان معالجات Intel ووحدات معالجة الرسوميات ووحدات NPU، مع إتاحة تصدير Mistral 3 الآن. 🔗 المصدر
- AmberTrace Labs يقيس أمانة استدلال Olmo 3 تحت RL بمكافأة قابلة للتحقق — في مجسات استُبعدت من التدريب، ارتفعت الأمانة من 0.238 إلى 0.262: انحراف إيجابي لا تراجع، مع نشر نقاط التحقق. 🔗 المصدر
- Together AI يدّعي أفضل زمن للوصول إلى أول رمز على DeepSeek V4.1 Flash — تنقل الشركة قياسًا لطرف ثالث لطلبات مسخّنة مسبقًا، من دون نشر المنهجية أو القيمة: إنه ادعاء، لا نتيجة قابلة للتحقق. 🔗 المصدر
- Google Flow يرافق مصممين اثنين في أسبوع الموضة بنيويورك — أدوات مصممة خصيصًا بالتعاون مع Jane Wade وSergio Hudson؛ استعراض لحالة استخدام، من دون نموذج جديد أو ميزة مطروحة. 🔗 المصدر
- سلسلة Google AI Educator تتيح الحصول على أرصدة جامعية — أصبحت دورات البرنامج التدريبي مؤهلة للحصول على أرصدة جامعية أو أرصدة للتعليم المستمر. 🔗 المصدر
ما الذي يعنيه ذلك
يقول هذا اليوم شيئًا واحدًا قبل كل شيء: لم تعد وكلاء البرمجة منتجات مغلقة، وبدأت تتشارك صيغها. يقرأ Claude Code الملف AGENTS.md عندما لا يحتوي المشروع على CLAUDE.md — أي إن Anthropic تقبل ملف تعليمات عرّفه طرف آخر، بحيث يخدم المستودع نفسه أدوات متعددة. وفي اليوم نفسه، يحقن Antigravity في موجّه النظام لوكلائه القائمة على Markdown فهرس الوكلاء الفرعيين المتاحين، ويجعل Vibe CLI أخيرًا الخطافات تعمل داخل الوكلاء الفرعيين، ويفصّل Codex فاتورته بحسب الوكيل الفرعي، بينما يضع Qwen Code وكلاءه في حاويات. كان التفويض بين الوكلاء وعدًا في الإعدادات؛ وهو يتحول الآن إلى آلية يجب توثيقها وعزلها واحتساب تكلفتها. بل إن Claude Code يمضي بمنطق الحذر إلى نهايته، إذ يضع على نتائج الوكلاء الفرعيين ترويسة مخصصة، كي لا يتمكن نص مُعاد من انتحال صفة تعليمة.
أما سوق وكلاء الطرفية، فيتحول بوضوح إلى سلعة شائعة. تنشر MiniMax وكيلها بترخيص MIT، مع TUI ووضع بلا واجهة وACP وحرية اختيار النموذج؛ وتزيل Mistral وسم «تجريبي» عن Unified Harness وتوثق --legacy-harness بوصفه مخرجًا؛ فيما تصدر Kimi Code إصلاحًا للأداء بعد 32 ساعة من نسختها الرئيسية. عندما يقدم أربعة ناشرين الشيء نفسه بنقاط الدخول نفسها، ينتقل موضع التمايز: ليصبح في الترخيص واستقرار إطار التشغيل ونظام الأذونات — وهذه بالضبط محاور تغييرات اليوم لدى Mistral وAnthropic على السواء.
وعلى صعيد النماذج، يتجه الصوت والفيديو إلى أن يصبحا وكيلين بدلًا من أن يظلا وصفيين. لم يعد Qwen3.8-Omni-Flash يسعى إلى وصف فيديو، بل إلى العثور فيه على إجابة: انطلاقًا من السؤال، يكسب 4.4 نقاط على OmniVideoBench مع استهلاك رموز أقل بنسبة 45.7% — أي إن الأداء والاقتصاد يسيران في الاتجاه نفسه، وهو أمر نادر. وفي المقابل، لا يستعرض Grok Voice Transcribe 2.0 تجربة مختبرية، بل حركة استخدام فعلية، مع انخفاض معدل الخطأ في الجمل القصيرة من 20.6% إلى 6.8% وبقاء السعر من دون تغيير. يتلاقى الإعلانان عند خلاصة واحدة: لم تعد القيمة تأتي من نوع الوسائط المدعوم، بل مما يقرر النموذج معالجته.
وتبقى مسألة ما تقبل المختبرات إخضاعه للتحقق. تدفع Anthropic إلى Accenture مقابل وضع مقيّمين داخل شركتها نفسها، مع صلاحيات موظفين — وتعترف في الإعلان ذاته بعدم وجود أي معيار يحدد ما ينبغي لمثل هذا المقيّم الوصول إليه، أو كيفية نشر استنتاجاته، أو الجهة التي ينبغي أن تموله. إنه اعتراف بقدر ما هو آلية. وإلى جانبه، فإن أقوى أدلة اليوم هي تلك التي يستطيع طرف ثالث إعادة إنتاجها: نتائج Exeter وStowers Institute بشأن AlphaGenome Atlas، وشيفرة تحسين الجزيئات الحيوية المنشورة مفتوحة المصدر، ونقاط التحقق الخاصة بـAmberTrace Labs. والعكس ظاهر بالقدر نفسه: تطرح Replit عاملًا مقداره 30 من دون مرجع، وتنقل Together AI تصنيفًا بلا منهجية، وتنفي Mistral ادعاءً لم يتمكن أحد من قراءته. وفي هذا المشهد، يأتي AIPerf في توقيت مناسب — أداة قياس تبدأ بالإقرار بأن القائم بالقياس هو المشكلة في كثير من الأحيان.
المصادر
- Claude Code، ملاحظات الإصدار 2.1.277
- سجل تغييرات Claude Code
- Qwen، تدوينة Qwen3.8-Omni-Flash
- Alibaba Qwen على X، إعلان النموذج
- Codex CLI، ملاحظات الإصدار 0.155.0
- OpenAI Developers على X، الاستهلاك المفصّل في Codex
- SpaceXAI، Grok Voice Transcribe 2.0
- Anthropic، التقييم المدمج مع Accenture
- سجل تغييرات Antigravity
- GitHub، الملخص الأسبوعي لـCopilot بتاريخ 14 سبتمبر
- GitHub، إيقاف ستة نماذج في Copilot
- GitHub، تخصيصات الوكلاء في CLI ضمن API المقاييس
- MiniMax على X، فتح مصدر MiniMax Code CLI
- Vibe CLI، ملاحظات الإصدار 2.25.5
- OpenAI Developers على X، الإضافات متعددة الحسابات
- Max Stoiber على X، الرسالة الأصلية بشأن الحسابات المتعددة
- Genspark على X، الرصيد الأسبوعي لخُطتي Plus وPro
- Google DeepMind على X، نتائج شركاء AlphaGenome Atlas
- Google Research، مواد تفاعلية تعليمية عبر واجهة توليدية
- Anthropic Research، Claude والنمذجة الجزيئية الحيوية
- Meta AI على X، Muse لنظام Mac
- Sakana AI، Frontier Intelligence Group
- Runway، التسعير الموحّد
- Pika على X، إطلاق Product Ad
- NVIDIA، قياس الاستدلال واسع النطاق باستخدام AIPerf
- Mistral AI على X، نفي 18 سبتمبر