ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
În această vineri, instrumentele pentru agenți converg către formate comune: Claude Code citește acum AGENTS.md atunci când un proiect nu are CLAUDE.md, Antigravity injectează catalogul subagenților în promptul de sistem al agenților săi Markdown, Codex își detaliază consumul pentru fiecare subagent, iar MiniMax deschide codul agentului său pentru terminal. Restul zilei se rezumă la două lansări de modele — Qwen3.8-Omni-Flash și Grok Voice Transcribe 2.0 — și la un parteneriat neobișnuit: Anthropic instalează evaluatori Accenture în interiorul propriei companii.
Claude Code citește AGENTS.md, izolează subagenții și elimină TaskOutput
18 septembrie — Trei versiuni Claude Code s-au succedat în douăzeci de ore: 2.1.275 pe 17 septembrie la 22:33 UTC, 2.1.276 pe 18 la 02:12 UTC și 2.1.277 pe 18 la 18:06 UTC.
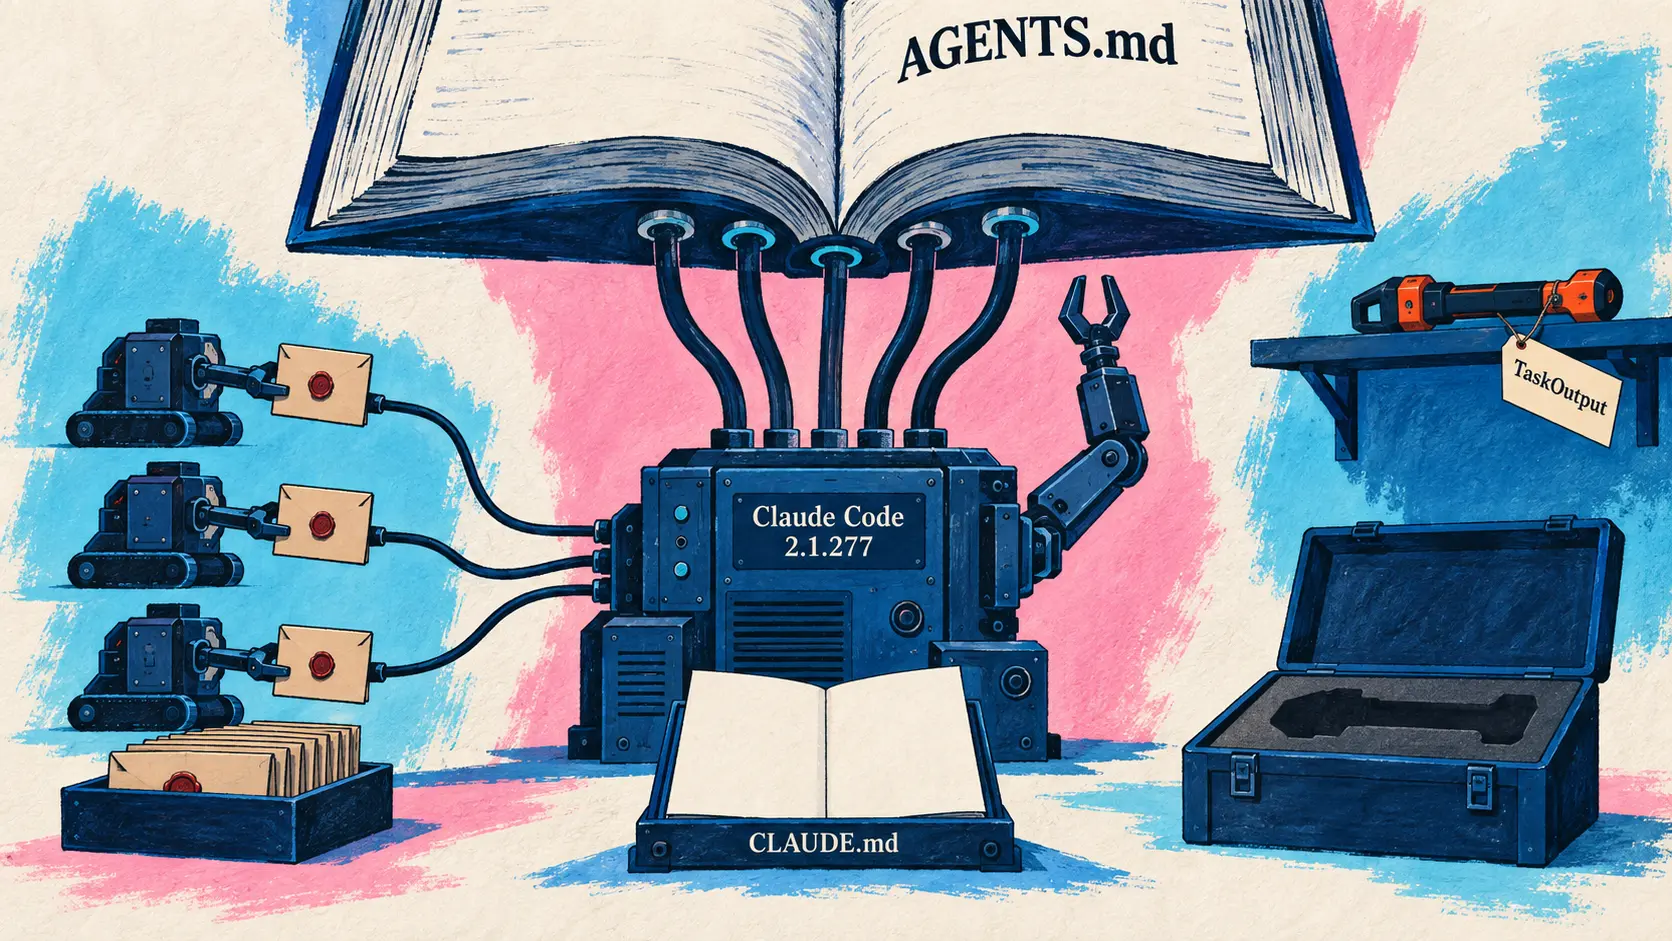
Cea mai importantă noutate structurală se rezumă la o singură linie din versiunea 2.1.277. Într-un proiect fără CLAUDE.md, Claude Code citește AGENTS.md, fișierul de instrucțiuni devenit o convenție comună pentru mai mulți agenți de programare de pe piață. Opțiunea se configurează în /config, la „Project instructions”. Funcția nu este încă disponibilă pe Bedrock, Vertex sau Foundry.
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇷🇴 A fost adăugat suportul pentru AGENTS.md: într-un proiect fără CLAUDE.md, Claude Code citește în schimb AGENTS.md; opțiunea poate fi modificată la „Project instructions” în /config (încă indisponibilă pe Bedrock, Vertex sau Foundry). — CHANGELOG Claude Code, anthropics/claude-code
Alte două modificări din aceeași versiune vizează securitatea contextului. Rezultatele subagenților sunt transmise agentului principal sub un antet care le marchează ca atare, astfel încât un text returnat de un subagent să nu poată fi confundat cu o instrucțiune a sesiunii; iar caracterele Unicode invizibile de formatare sunt eliminate din prompturi, versiunea curățată fiind afișată înainte de trimitere. Versiunea 2.1.277 elimină și instrumentul perimat TaskOutput: Claude citește acum fișierul de ieșire al unei sarcini de fundal folosind Read.
Versiunea 2.1.275 adaugă o tastă pentru trimitere imediată (ctrl+enter), care întrerupe turul în curs și expediază dintr-odată toate mesajele din coadă, precum și sincronizarea în terminal a skill-urilor și pluginurilor activate în contul claude.ai. În ceea ce privește lanțul de aprovizionare, pluginurile provenite din npm sunt preluate prin npm pack --ignore-scripts cu verificarea integrității, ceea ce împiedică executarea scripturilor de instalare ale unui pachet. Versiunea 2.1.276, publicată cu mai puțin de patru ore mai târziu, remediază o singură regresie a acestei versiuni: o eroare 400 care provoca eșecul tuturor solicitărilor din spatele unui proxy.
| Numărul versiunii | Publicare (UTC) | Conținut remarcabil |
|---|---|---|
| 2.1.275 | 17/09 la 22:33 | Trimitere imediată, sincronizarea skill-urilor claude.ai, npm --ignore-scripts |
| 2.1.276 | 18/09 la 02:12 | Remediere unică: eroare 400 în spatele unui proxy |
| 2.1.277 | 18/09 la 18:06 | Suport pentru AGENTS.md, izolarea subagenților, eliminarea TaskOutput |
Qwen3.8-Omni-Flash, primul model omni-modal agentic al Qwen
18 septembrie — Qwen lansează Qwen3.8-Omni-Flash, prezentat drept primul său model omni-modal conceput în jurul capacităților agentice. Schimbarea anunțată nu mai privește înțelegerea conținutului multimodal, ci exploatarea acestuia: înțelegerea conținutului, planificarea sarcinii, executarea ei cu instrumente și livrarea rezultatului. Modelul acceptă text, imagini, audio și video într-o fereastră de context de un milion de tokeni.
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇷🇴 Vă prezentăm Qwen3.8-Omni-Flash, primul model omni-modal Qwen construit în jurul capacităților agentice. — @Alibaba_Qwen pe X
În cele 29 de evaluări selectate de Qwen, scorul mediu crește cu peste 25 % față de Qwen3.5-Omni-Plus, progresele concentrându-se asupra agenților audio-video. Recunoașterea mai multor vorbitori este domeniul cu cea mai mare evoluție.
| Evaluare selectată | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (mai mic înseamnă mai bine) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
Aspectul cel mai original este percepția agentică aplicată videoclipurilor lungi. În loc să proceseze o înregistrare de la început până la sfârșit, modelul pornește de la întrebarea adresată, decide singur ce să privească și ce să asculte și localizează informația prin treceri succesive, de la general la detaliat. Pe OmniVideoBench, acest mod crește precizia de la 63,4 la 67,8, reducând totodată consumul de la 145 736 la 79 117 tokeni per solicitare, adică cu aproximativ 45,7 % mai puțin — cifră menționată chiar de articolul oficial.
Urmează și componenta tarifară: potrivit metodologiei Qwen, prețul per oră de intrare audio scade cu peste 98 % față de Qwen3.5-Omni-Plus. Totodată sunt deschise două componente, Qwen-MM-Plugins, compatibilă cu infrastructurile Codex, Claude Code, Qwen Code și Gemini CLI, și Qwen-Live Harness pentru interacțiunea în timp real. O variantă Realtime este dedicată interacțiunii continue cu latență redusă, primul token fiind livrat în 591–981 de milisecunde.
🔗 Articolul Qwen despre Qwen3.8-Omni-Flash
Codex CLI 0.155.0 introduce experimental conversațiile vocale
17 septembrie — OpenAI lansează Codex CLI 0.155.0, prima versiune stabilă după 0.154.0 din 10 septembrie, care poate fi instalată prin npm install -g @openai/codex@0.155.0. Aceasta este intrarea din changelog care lipsea pentru agentul vocal anunțat cu o zi înainte pe X: funcționalitatea poartă numele /voice, oferă transcriere în direct și comenzi pentru microfon și rămâne experimentală — fiind disponibilă numai în compilările acceptate (supported builds) și necesitând activarea prin /experimental.
Restul versiunii este mai discret, dar mai util imediat. Interfața de terminal primește rezumate în direct ale raționamentului în linia de stare, precum și un marcaj temporal de final după fiecare tur încheiat cu succes. Prezentarea generală a agenților permite ascunderea, arhivarea și ștergerea sarcinilor, afișând detalii despre proprietatea worktree-urilor și solicitând confirmare înainte de ștergerea worktree-urilor gestionate și curate. Pe dispozitivele Mac compatibile, solicitările MCP din sesiunile TUI locale pot fi validate prin Touch ID. Amazon Bedrock își poate obține datele de autentificare AWS din comenzi configurate, cu stocare în cache, reîmprospătare la expirare și reluare după un eșec de autentificare.
Mai multe remedieri țin de securitate: ieșirile proceselor Windows din sandbox-urile WSL restricționate sunt blocate, instantaneele de shell intermediate sunt întărite împotriva expunerii datelor de autentificare, iar schimbarea contului invalidează sesiunile de control de la distanță, starea WebSocket din cache și cataloagele de modele aparținând identității anterioare.
| Noutatea versiunii | Detaliu |
|---|---|
/voice | Transcriere în direct și comenzi pentru microfon, experimental prin /experimental |
| Interfața de terminal | Rezumate ale raționamentului în linia de stare, marcaj temporal la finalul turului |
| Prezentarea agenților | Ascunderea, arhivarea și ștergerea sarcinilor, proprietatea worktree-urilor |
| Touch ID | Validarea solicitărilor MCP în sesiunea locală, pe dispozitive Mac compatibile |
| Amazon Bedrock | Date de autentificare AWS obținute prin comandă, cu cache și reîmprospătare |
🔗 Notele versiunii Codex CLI 0.155.0
Codex își detaliază consumul pentru fiecare sarcină, subagent și conversație
18 septembrie — OpenAI Developers anunță monitorizarea detaliată a consumului în Codex: instrumentul arată cum contribuie sarcinile, subagenții și conversațiile individuale la utilizarea totală. Informația se găsește în aplicația desktop, în Setări, apoi Usage & billing pentru conturile personale și Business sau în Usage pentru conturile Enterprise eligibile; aplicația trebuie să fie actualizată pentru ca opțiunea să fie disponibilă. Anunțul nu este însoțit de niciun articol de blog sau intrare în changelog.
Granularitatea este adevăratul subiect. Până acum, epuizarea unei cote nu indica de unde provenea consumul; o defalcare per subagent permite identificarea delegării costisitoare și rescrierea acesteia. Este contraponderea contabilă a generalizării subagenților în infrastructurile de programare.
🔗 Anunțul OpenAI Developers pe X
Grok Voice Transcribe 2.0, recunoașterea vocală SpaceXAI la același tarif
18 septembrie — SpaceXAI anunță Grok Voice Transcribe 2.0, noul său model de recunoaștere vocală (speech-to-text), descris ca fiind de două ori mai precis decât versiunea 1.0, la același tarif. Modelul se bazează pe fundația audio care alimentează deja Grok Voice, despre care compania afirmă că procesează zilnic zeci de mii de apeluri de asistență pentru clienți și transcrie milioane de ore de narațiune video.
Argumentul central vizează sunetul din lumea reală, nu cel din laborator: linii telefonice instabile, voci care se suprapun, accente locale, numere de telefon și adrese de e-mail dictate cu voce tare. SpaceXAI revendică primul loc la precizie dintre 32 de modele de streaming în clasamentul public Artificial Analysis și se bazează pe patru seturi interne extrase din traficul de producție — telefonie la 8 kHz, conversații cu Grok, identificatori dictați și comenzi vocale scurte în 19 limbi.
Cel mai clar progres privește multilingvismul. În setul de propoziții scurte, cele care oferă cel mai puțin context pentru identificarea limbii, rata de eroare per cuvânt scade de la 20,6 % la 6,8 %. Modelul detectează automat limba și urmărește schimbările produse în timpul înregistrării într-o singură trecere.
| Metrică măsurată | Valoare anunțată |
|---|---|
| Precizie revendicată față de Transcribe 1.0 | de două ori mai mare |
| Clasament Artificial Analysis (streaming) | locul 1 din 32 de modele |
| Rata de eroare pentru propoziții scurte (1.0 → 2.0) | 20,6 % → 6,8 % |
| Tarif pentru procesare în lot | 0,10 dolari per oră de audio |
| Tarif pentru streaming | 0,20 dolari per oră de audio |
| Canale transcrise independent | până la 8 |
| Termeni profesionali per solicitare | până la 100 |
Modelul gestionează procesarea în lot și streamingul, marcajele temporale la nivel de cuvânt cu scor de încredere, separarea vorbitorilor (diarization) fără costuri suplimentare și detectarea finalului unui tur de vorbire. Integrările API existente beneficiază de creșterea preciziei fără modificări de cod. Grok Voice Transcribe 2.0 va deveni în curând modelul implicit al API-ului, iar versiunea 1.0 va fi perimată în săptămânile următoare: pentru a rămâne la aceasta va trebui fixat grok-voice-transcribe-1.0.
🔗 Anunțul Grok Voice Transcribe 2.0
Anthropic instalează evaluatori Accenture în interiorul companiei
18 septembrie — Anthropic anunță un parteneriat cu Accenture privind evaluarea independentă a modelelor de frontieră, prezentat drept un pas important către îndeplinirea angajamentului directorului său general de a găzdui evaluatori integrați (embedded). Activitatea va fi desfășurată de Faculty, filiala Accenture specializată în IA, și va acoperi evaluarea și red-teaming-ul modelelor, evaluările de aliniere și testarea măsurilor de protecție.
Distincția față de evaluatorii externi este explicită: un evaluator integrat lucrează în interiorul companiei de IA, cu un acces comparabil cu cel al unui angajat. Acesta poate observa modelele în timpul antrenării, poate urmări deciziile care le guvernează construirea și implementarea, poate discuta direct cu angajații, verifica respectarea angajamentelor de securitate, semnala incidente și publica o descriere mai bine documentată a beneficiilor și riscurilor. Anthropic precizează că mecanismul nu îi reduce responsabilitatea, ci o face mai ușor de verificat.
Anunțul este neobișnuit de sincer cu privire la ceea ce nu există. Nu există niciun standard referitor la informațiile la care ar trebui să aibă acces un evaluator integrat, nici la modul în care ar trebui să își publice constatările și niciun sistem consacrat pentru finanțarea evaluării independente. Anthropic consideră că, în cele din urmă, această finanțare ar trebui să provină din fonduri comune sau publice; în lipsa unui asemenea mecanism în prezent, compania finanțează direct activitatea Accenture — ceea ce reprezintă cea mai vizibilă limită a aranjamentului.
| Element al parteneriatului | Valoare anunțată |
|---|---|
| Entitate operatoare | Faculty, filiala de IA a Accenture |
| Investiție | Cel puțin 1 miliard de dolari per parte, în cinci ani |
| Domeniu acoperit | Evaluare, red-teaming, aliniere, măsuri de protecție |
| Nivel de acces | Comparabil cu cel al unui angajat |
| Finanțare | Direct de către Anthropic, în lipsa fondurilor comune |
| Exclusivitate | Niciuna, de ambele părți |
Anthropic mai precizează că discută cu METR și cu alți evaluatori nonprofit pentru a experimenta elemente de evaluare integrată din propriile lor fonduri și anunță alți parteneri în săptămânile următoare.
🔗 Anunțul Anthropic despre evaluarea integrată
Antigravity: trei versiuni în două zile despre agenții personalizați
Google a publicat succesiv două versiuni ale CLI-ului său și o versiune a aplicației Antigravity. Toate trei abordează același subiect din trei perspective: ce știe un agent personalizat, ce poate refuza și cât timp poate funcționa fără supraveghere. Ele continuă o serie densă începută pe 11 septembrie, ale cărei versiuni de la 1.2.1 la 1.2.4 nu sunt incluse aici.
CLI 1.2.6 introduce un Remote Control asociat sesiunii și elimină limita de cinci minute
18 septembrie — La opt zile după 1.2.0, care transforma CLI-ul într-un serviciu de sistem persistent, Google adoptă abordarea opusă printr-o a doua formă de Remote Control, mult mai simplă: o conexiune limitată la sesiune (session-scoped), deschisă prin flag-ul --remote-control la pornire sau prin comanda /remote-control pe parcurs. Introducerea comenzii /remote-control off sau închiderea sesiunii desființează tunelul și elimină dispozitivul din listă. În timp ce 1.2.0 viza un daemon care supraviețuiește sesiunii, 1.2.6 urmărește opusul.
A doua schimbare privește modul fără interfață (headless): timpul de expirare implicit al execuțiilor -p / --prompt trece de la cinci minute la nelimitat, cu excepția cazului în care este specificat explicit --print-timeout. A treia schimbare structurează raportarea erorilor — la eșecul agentului sau al API-ului, CLI-ul scrie în fluxul de eroare o linie JSON AGY_ERROR: {...} care conține starea canonică, codul HTTP sau gRPC, caracterul reîncercabil și un identificator de eroare, iar codul de ieșire trece de la 1 la 3. Astfel, un script de orchestrare poate distinge o defecțiune temporară de rețea de o eroare definitivă fără a analiza text liber.
CLI 1.2.5 le oferă în sfârșit agenților Markdown catalogul subagenților lor
17 septembrie — Până acum, un agent personalizat definit în Markdown putea declara invoke_subagent în instrumentele sale fără să știe vreodată ce subagenți existau: avea instrumentul, dar nu și catalogul. CLI-ul adaugă acum automat în promptul său de sistem catalogul subagenților disponibili și instrucțiunile de utilizare a acestora, ceea ce face delegarea efectivă.
Terminologia din changelog necesită o precizare: este vorba despre adăugarea de context de către produsul însuși, nu despre o vulnerabilitate de securitate sau o remediere. A doua îmbunătățire păstrează numele explicit al unei sarcini trimise în fundal, care se pierdea între notificări și listele de sarcini. Cele cinci remedieri vizează eliminarea identificatorilor invalidați, codurile de ieșire ale comenzilor întrerupte și cadrele de reflecție care rămâneau blocate.
Antigravity 2.15.0 le permite agenților personalizați să dezactiveze prompturile și instrumentele implicite
18 septembrie — La trei zile după 2.14.0, aplicația publică 7 îmbunătățiri și 16 remedieri. Principala schimbare le oferă agenților personalizați control asupra propriului context: aceștia pot dezactiva secțiunile implicite ale promptului și instrumentele implicite, apoi pot reintroduce doar elementele de care au nevoie. Pentru un agent specializat, acest lucru reduce în mod corespunzător promptul de sistem impus.
Restul schimbărilor vizează navigarea și persistența: Page Up, Page Down, Home și End derulează o conversație, Esc scoate focalizarea din zona de introducere, iar agentul personalizat selectat este memorat după reîncărcare. Două remedieri privesc integritatea datelor — setările salvate și lista proiectelor puteau fi suprascrise când aplicația nu reușea să citească fișierul de stare, iar setările de permisiuni acumulau duplicate care măreau fișierele conversațiilor.
GitHub Copilot: un canvas Sentry, șase modele retrase și metrici pentru fiecare personalizare
Trei intrări de changelog în două zile conturează aceeași preocupare: măsurarea modului în care echipele folosesc efectiv Copilot și eliminarea elementelor pe care nu le mai utilizează.
Rezumatul din 14 septembrie evidențiază două componente noi
18 septembrie — GitHub publică rezumatul săptămânal Copilot pentru săptămâna din 14 septembrie. Cea mai mare parte a sumarului reia intrări deja publicate de-a lungul changelogului; doar două elemente nu fuseseră anunțate separat până acum. Primul este canvasul Sentry din aplicația Copilot, care leagă un raport de eroare din producție de o remediere fără a părăsi aplicația: afișează erorile, urmele stivei (stack traces) și contextul, apoi permite investigarea cauzei, validarea unei corecții și pregătirea unui pull request. Este prima integrare a unui instrument de monitorizare a erorilor în canvases, după Jira la începutul lunii septembrie.
Al doilea este valul de funcționalități pentru agenți din VS Code 1.138. Fereastra Agents poate executa un agent într-un Dev Container local, cu instrumentele și dependențele proiectului — lansare progresivă, Docker necesar. Sesiunile inactive pot fi marcate automat drept încheiate după ce toate pull request-urile lor au fost îmbinate, cu ștergere opțională după o perioadă de grație, în previzualizare și necesitând activare explicită. În cele din urmă, un pull request poate fi creat direct dintr-o sesiune Agent Host.
Șase modele părăsesc toate suprafețele Copilot pe 19 octombrie
18 septembrie — GitHub anunță retragerea a șase modele de pe toate suprafețele Copilot — Copilot Chat, editări inline, modurile ask și agent, completări de cod — pe 19 octombrie 2026. Este al doilea val de retrageri anunțat în septembrie.
| Model retras | Data retragerii | Alternativă sugerată |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
În cadrul activării implicite a modelelor, alternativele sunt activate automat pentru clienții Copilot Enterprise și Business, cu excepția cazului în care un administrator a dezactivat valoarea implicită globală sau a blocat explicit modelul respectiv; în acest caz, accesul se redeschide prin politicile pentru modele din setări. Nu este necesară nicio acțiune pentru retragerea modelelor.
🔗 Anunț privind retragerea modelelor Copilot
API-ul de metrici numără skills, agenții, serverele MCP și pluginurile CLI-ului
17 septembrie — API-ul pentru metricile de utilizare Copilot acoperă acum cinci familii de personalizări agentice ale CLI-ului: skills, agenți personalizați, servere MCP, slash commands și pluginuri. Tabelele totals_by_skill, totals_by_custom_agent, totals_by_mcp, totals_by_slash_cmd și totals_by_plugin enumeră cele mai active cinci elemente împreună cu interaction_count al acestora, în timp ce câmpurile distinct_*_use_count numără varietatea elementelor utilizate dincolo de acest top cinci.
Două subtilități previn interpretările greșite. Pentru serverele MCP, contorul crește numai când CLI-ul încearcă să se conecteze sau să se reconecteze — indiferent dacă reușește sau nu —, nu la fiecare apel de instrument printr-o conexiune stabilită. Metricile pluginurilor numără numai invocările de skills asociate unui plugin: ele reprezintă un subset al totalurilor pentru skills și nu trebuie adăugate la acestea. Din motive de confidențialitate, sunt afișate numai numele furnizate de GitHub, iar numele definite de clienți sunt grupate sub other.
🔗 Personalizările agentice ale CLI-ului în API-ul de metrici
Agenții de cod din terminal: MiniMax îl deschide pe al său, Mistral își stabilizează infrastructura de execuție
Două anunțuri din partea a doi actori fără legătură între ei, în aceeași zi, pe aceeași piață: agentul de programare care funcționează într-un terminal devine ceva obișnuit, iar diferențierea se mută către licență și stabilitatea infrastructurii de execuție.
MiniMax publică sub licență MIT codul MiniMax Code CLI
18 septembrie — MiniMax deschide codul sursă al agentului său de programare în terminal, în versiunea 0.4.12. Instrumentul se instalează sub numele mcode și oferă trei puncte de intrare: o interfață interactivă în terminal, un mod fără interfață (mcode exec) destinat scripturilor shell, integrării continue și evaluărilor și un mod ACP pentru editoarele compatibile cu Agent Client Protocol. Acesta citește fișierele unui proiect, inspectează diferențele, execută comenzi shell și teste, în cadrul unui sistem de permisiuni și sandboxing.
Alegerea modelului rămâne deschisă: pe de o parte, contul MiniMax și Token Plan, iar pe de altă parte, un furnizor terț, atât timp cât oferă un format API compatibil cu OpenAI sau Anthropic. Se adaugă căutarea integrată, instrumentele multimodale, protocolul MCP, subagenții și un sistem de pluginuri. Codul original este publicat implicit sub licență MIT. Depozitul acoperă TUI, CLI-ul fără interfață și modul ACP, dar nu și aplicația desktop, deși găzduiește urmărirea problemelor acesteia; deocamdată, propunerile de cod sunt acceptate numai din partea colaboratorilor depozitului.
Unified Harness din Vibe CLI părăsește statutul experimental
18 septembrie — Mistral publică Vibe CLI 2.25.5, la șase zile după 2.25.4. Schimbarea structurală încape într-un singur rând din notele de lansare: Unified Harness nu mai este etichetat „experimental”, iar --legacy-harness servește acum drept opțiune documentată de revenire la vechea infrastructură Python. După o serie de versiuni corective axate pe securitatea aprobărilor shell, noua infrastructură devine opțiunea implicită asumată — aceasta este informația importantă, nu numărul versiunii.
Tranziția este însoțită de recuperarea parității: Unified Harness include acum ramura Git curentă, starea depozitului și commiturile recente în instrucțiunile de sistem, hooks se execută în sfârșit în interiorul subagenților în loc să fie ignorate în tăcere, iar furnizorii configurați fără o variabilă de mediu pentru cheia API — servere locale sau auto-găzduite — funcționează din nou. Consolidarea permisiunilor continuă: aprobările shell nu se mai extind la un alt program sau mediu, apelurile instrumentelor MCP respectă acum sistemul de permisiuni în loc să îl eludeze, iar smart approve nu mai ocolește regulile utilizatorului.
🔗 Notele de lansare Vibe CLI 2.25.5
Pluginurile ChatGPT acceptă simultan mai multe conturi
18 septembrie — Compatibilitatea cu mai multe conturi este introdusă pentru majoritatea pluginurilor ChatGPT. Devine posibilă conectarea contului personal, a celui profesional și a conturilor proiectelor secundare, apoi aducerea contextului fiecăruia în aceeași conversație. Conturile se conectează din catalogul de pluginuri, la chatgpt.com/plugins.
Anunțul contului OpenAI Developers reia un mesaj publicat de Max Stoiber cu o oră mai devreme. Dezvoltatorii de pluginuri nu trebuie să facă nimic: funcționalitatea se activează automat, fără modificări. Cei care vor să meargă mai departe pot adăuga un instrument profile la serverul lor MCP, astfel încât ChatGPT să poată eticheta conturile conectate — aceasta este singura acțiune concretă așteptată din partea lor. Anunțul, publicat la ora 18:10, ora Parisului, nu este însoțit de nicio postare pe blog sau intrare de changelog.
Cazul de utilizare vizat este cel al unui dezvoltator care își separă identitățile în funcție de angajator sau proiect și care până acum trebuia să schimbe conexiunea pentru a schimba contextul.
🔗 Anunțul privind conturile multiple pe X
🔗 Mesajul original al lui Max Stoiber
Genspark adaugă un sold săptămânal de credite abonamentelor Plus și Pro
18 septembrie — Genspark modifică beneficiile abonamentelor Plus și Pro prin adăugarea unui sold săptămânal de credite, fără a schimba prețul abonamentelor. Acest sold este acordat în fiecare săptămână în plus față de abonamentul existent și acoperă utilizarea în modul Standard pentru toți agenții și toate instrumentele platformei: Super Agent, AI Chat, AI Image, AI Slides, AI Sheets, AI Docs și Deep Research.
Un al doilea mesaj din același fir detaliază funcționarea pentru AI Chat și AI Image. Pentru abonații existenți, soldul se adaugă la resursele de care dispun deja și, până la 31 decembrie 2026, toate modelele AI Chat și AI Image pot fi utilizate fără costuri în credite, inclusiv modelele de vârf precum Opus; pentru persoanele care se abonează începând cu 18 septembrie, modelele de bază (core models) din AI Chat și AI Image sunt gratuite. Genspark precizează că aceste schimbări nu se aplică nici abonamentelor Team, nici celor Enterprise și recomandă consultarea centrului său de ajutor pentru detaliile condițiilor.
Google Research: ce a produs AlphaGenome Atlas și simulări care se testează singure
Două publicații de cercetare în aceeași zi, cu un punct comun: în ambele cazuri, ceea ce este prezentat nu este modelul, ci ceea ce au obținut terții din el sau ceea ce verifică în locul său bucla de validare.
AlphaGenome Atlas oferă primele rezultate ale partenerilor săi
17 septembrie — La nouă zile după publicarea AlphaGenome Atlas, harta predictivă a celor 9 miliarde de substituții posibile ale ADN-ului uman, Google DeepMind evidențiază un fir care detaliază trei colaborări.
| Partener științific | Rezultat raportat |
|---|---|
| Stowers Institute | Peste 2.500 de motive reglatoare cartografiate |
| Universitatea din Exeter / UK Biobank | Peste 54.000 de participanți analizați, detectare cu peste 22% mai mare a semnalelor genetice rare |
| Broad Institute | Mutația critică a genei DNM1 identificată, apoi confirmată și validată în laborator |
Motivele reglatoare sunt secvențe de ADN care acționează ca întrerupătoare și potențiometre asupra activității genelor. Cercetarea desfășurată la Exeter a identificat, de asemenea, noi variante care influențează abundența PLA2G7, o proteină asociată sănătății metabolice. Cazul Broad Institute este cel mai concret dintre cele trei: în fața unei liste imense de mutații posibile în boli rare neexplicate, Atlas ajută la identificarea celei corecte, confirmată ulterior în laborator. Totul este însă prezentat într-un fir pe X, fără o postare detaliată sau o publicație asociată.
🔗 Firul AlphaGenome Atlas pe X
Simulări educaționale generate, apoi testate de un agent în Chrome
17 septembrie — Gal Elidan și Yael Haramaty publică un experiment care aplică interfața generativă (generative UI) pentru crearea de simulări educaționale. Profesorul păstrează inițiativa: propune subiectul, Google generează un set de obiective de învățare modificabile și supuse aprobării sale, care servesc drept bază pentru generare. Fiecare material interactiv este împărțit în niveluri cu dificultate crescătoare, cu o casetă de instrumente, indicii progresive și soluții detaliate.
Cel mai interesant element este bucla de autocorectare. Generarea este controlată prin criterii pedagogice, mecanice și de prezentare, iar unele evaluări sunt agentice: testul de rezolvare deschide o instanță Chrome și manipulează simularea așa cum ar face-o un utilizator, încercând și acțiuni adverse, precum împingerea glisoarelor la valorile lor extreme. Bucla se repetă până când sunt îndeplinite toate criteriile, cu prețul unui timp de generare mai lung. Google publică peste 30 de materiale interactive STEM în limba engleză; o colecție de 40 a fost evaluată de profesori britanici, iar un studiu realizat cu 12 profesori americani a obținut un scor mediu de 8 din 10.
🔗 Articolul Google Research despre materialele educaționale interactive
Claude accelerează peste 30 de modele de biologie și finanțează o competiție de proteine
17 septembrie — Anthropic publică un articol în care descrie modul în care Claude a optimizat inferența a peste 30 de modele open source utilizate de biologi — predicția structurii, proiectarea proteinelor, modele lingvistice pentru proteine și genomică — în puțin mai puțin de patru săptămâni, cu o îmbunătățire medie de aproximativ 4x. Întregul cod este publicat în regim open source.
Componenta tehnică centrală vizează atenția triunghiulară și multiplicarea triunghiulară, cubice atât în timp, cât și în memorie. Claude a produs FlashPairformer, un set de kernels care depășește standardul domeniului de 2,7 până la 2,9x în privința atenției. Un mod cu memorie redusă, denumit „Big”, permite plierea cu precizie a unor sisteme de peste 10.000 de tokens pe un singur nod GPU, în condițiile în care ribozomul 40S prezis de AlphaFold3 avea 7.663 de tokens. Metoda contează la fel de mult: activitatea a fost supervizată de doi membri ai personalului tehnic fără experiență anterioară în optimizarea inferenței.
În cele din urmă, Anthropic co-sponsorizează împreună cu Adaptyv Bio o competiție de proiectare a proteinelor axată pe cinci probleme dificile, cu peste 5.000 de designuri ale comunității validate experimental, până la 1 milion de dolari în credite Claude și 250.000 de dolari în resurse de calcul oferite de Modal.
🔗 Articolul de cercetare Anthropic
Modele deschise și laboratoare: Muse ajunge pe Mac, Sakana își dezvăluie grupul de frontieră
Meta își aduce agentul Muse pe macOS
18 septembrie — Meta lansează Muse pe Mac, anunțat în noaptea de 17 spre 18 septembrie. Contul @AIatMeta redistribuie o postare care descrie un agent personal capabil să acționeze direct pe computerul utilizatorului, de fiecare dată cu permisiunea explicită a acestuia. Sunt menționate trei utilizări: organizarea dosarului de descărcări, găsirea unui fișier pierdut, rezumarea mesajelor și notițelor.
Anunțul continuă lansarea Muse din 8 septembrie, un agent bazat pe Muse Spark 1.3 și disponibil până acum pe iOS, Android, web și WhatsApp. Trecerea pe Mac marchează o nouă etapă pentru acest tip de produs: agentul nu mai lucrează în propriul sandbox, ci asupra fișierelor personale ale utilizatorului. Meta nu comunică nici prețul, nici țările în care este disponibil, nici configurația necesară, iar lansarea nu este însoțită de niciun document de securitate specific pentru Mac — blogul ai.meta.com nu a mai publicat nimic din 27 iulie.
Sakana AI dezvăluie Frontier Intelligence Group și poziția sa asupra paradigmei
18 septembrie — Sakana AI anunță existența Frontier Intelligence Group (FIG), un colectiv intern care s-a dezvoltat încă de la începuturile companiei. Punctul de plecare este o întrebare formulată de Llion Jones, directorul tehnic al Sakana AI și unul dintre inventatorii Transformer: este suficientă extinderea arhitecturii Transformer cu tot mai multe date și resurse de calcul pentru a ajunge până la AGI? Răspunsul laboratorului este nu.
Aici se află informația esențială, mai mult decât în catalogul de lucrări care o însoțește. Articolul enumeră problemele pe care paradigma actuală nu le-a rezolvat — modele care produc cu încredere informații false, eșuează în fața unor situații cu adevărat noi și consumă multă energie — și le contrapune inteligenței biologice, care învață continuu și generalizează pornind de la mult mai puține date. Grupul își stabilește cinci principii, printre care libertatea de a eșua fără presiunea scorurilor de benchmark. Printre lucrările prezentate, cercetările privind Transformer sparse realizate împreună cu NVIDIA pornesc de la o constatare măsurată — peste 95% dintre neuronii unui strat feed-forward rămân inactivi în timpul procesării unui cuvânt — și au produs un format de date denumit TwELL, acceptat la ICML 2026.
🔗 Articolul Sakana AI despre Frontier Intelligence Group
Video generativ: Runway își unifică utilizarea creditelor, Pika își lansează prima aplicație
Runway face creditele fungibile între aplicația web și Runway Dev
18 septembrie — Runway elimină separarea dintre cele două produse ale sale: creditele achiziționate pot fi utilizate fără deosebire în aplicația web și în Runway Dev, oferta destinată dezvoltatorilor. Până acum, cele două medii funcționau cu rezerve separate, contracte distincte și fără un loc unic pentru urmărirea consumului de la un proiect la altul.
Schimbarea este însoțită de patru elemente: o rezervă unică achiziționată centralizat pe o singură factură, un traseu continuu între construirea unui flux în aplicația web și expunerea sa prin API, asistență consolidată pentru Runway Dev cu acces la Applied AI Architects și o interfață reproiectată de analiză a spațiului de lucru, care le permite administratorilor să transfere creditele între spațiile web și Dev. Două oferte comerciale sunt valabile până la 31 decembrie 2026: 10% credite suplimentare la semnarea contractului pentru companiile noi, adică minimum 130 de minute de video sau 12.000 de imagini potrivit conversiei anunțate de Runway, iar pentru clienții existenți, 5.000 de credite plus o zi cu un Applied AI Architect în schimbul unei recomandări către responsabilul de produs pentru aplicațiile AI.
🔗 Articolul Runway despre tarifarea unificată
Pika lansează Product Ad, de la fotografia produsului la reclama video
18 septembrie — La o zi după prezentarea noii sale platforme creative, Pika lansează prima aplicație a acesteia: Product Ad. Aplicația preia una sau mai multe imagini ale produsului, le combină cu un brief scris și generează un videoclip prezentat ca fiind gata pentru piață.
| Parametru de generare | Valoare propusă |
|---|---|
| Durate disponibile | 6 s, 15 s, 30 s, 60 s, 2 min |
| Format de ieșire | 16:9 |
| Intrare necesară | imagini ale produsului și brief scris |
| Acces | este necesară crearea unui cont |
Pika publică anunțul citând propriul mesaj din ziua precedentă despre reproiectarea platformei, ceea ce încadrează Product Ad într-o serie de aplicații viitoare, nu ca pe o funcționalitate izolată. Nu este menționat niciun model și nu este comunicat niciun tarif.
NVIDIA publică AIPerf, succesorul GenAI-Perf pentru măsurarea inferenței la scară largă
18 septembrie — NVIDIA prezintă AIPerf, instrumentul său de măsurare a performanței inferenței generative, desemnat drept succesorul GenAI-Perf și rescris de la zero. Constatarea inițială este familiară: după implementarea unui model, întrebarea „este rapid?” este adesea soluționată cu comenzi curl sau cu un generator de sarcină improvizat, care produc cifre lipsite de încredere.
Schimbarea este una arhitecturală. În timp ce majoritatea instrumentelor rulează într-un singur proces și se lovesc de blocarea globală a interpretorului Python pe măsură ce concurența crește, AIPerf distribuie sarcina: procesele de lucru generează traficul, servicii distincte procesează rezultatele, iar ansamblul este coordonat prin ZMQ. Obiectivul este explicit — clientul de măsurare să nu devină niciodată el însuși blocajul.
| Indicator raportat | Ce măsoară |
|---|---|
| Time to First Token | Intervalul dintre trimiterea cererii și primul token |
| Inter-Token Latency | Intervalul dintre doi tokens succesivi în timpul generării |
| Latența cererii | Timpul total al răspunsului complet |
| Debitul de tokens la ieșire | Tokens produși pe secundă pentru toate cererile |
| Percentile raportate | p25, p50, p75, p90, p95, p99 |
| Tipuri de endpoint-uri | peste 15 |
Instrumentul poate, de asemenea, să redea trasee de trafic real în formatele Mooncake, Baseten și WEKA. Articolul insistă în special asupra utilității distribuțiilor: un server al cărui timp mediu până la primul token pare sănătos, dar al cărui p99 crește vertiginos, trece neobservat în datele agregate și eșuează în producție.
🔗 Articolul NVIDIA despre AIPerf
Mistral dezminte o revendicare privind accesul neautorizat la sistemele sale
18 septembrie — Mistral publică la ora 05:48 UTC un comunicat scurt pe contul său X, ca răspuns la o revendicare privind accesul neautorizat la sistemele sale. Compania afirmă că a desfășurat o investigație aprofundată, că nu a găsit niciun element care să susțină această revendicare și confirmă că sistemele sale nu au fost compromise.
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇷🇴 Avem cunoștință de o acuzație privind accesul neautorizat la sistemele noastre. În urma unei investigații aprofundate, nu am găsit niciun element care să susțină această acuzație și putem confirma că sistemele noastre nu au fost compromise. — @MistralAI pe X
Mesajul nu îl numește pe autorul revendicării, nu precizează nici data, nici natura acesteia și nu oferă niciun detaliu despre amploarea investigației. Aici este relatată poziția Mistral și numai aceasta: acuzația inițială nu a putut fi consultată. Comunicatul este mesajul contului cu cele mai multe vizualizări din perioada respectivă, iar pe site-ul companiei nu a fost găsită nicio publicație suplimentară.
Știri pe scurt
- Balyasny Asset Management explică modul în care supraveghează Claude Fable 5 — compania, care administrează aproximativ 38 de miliarde de dolari, reduce analiza inițială a unui arbitraj de fuziuni de la trei-cinci zile la mai puțin de o zi, cu un agent care rulează aproximativ 30 de minute și o revizuire umană. 🔗 sursă
- Codex CLI 0.155.1 dezactivează din nou implicit rezumatele raționamentului — o singură remediere, la o zi după 0.155.0: activarea lor implicită determina furnizorii care nu le acceptă să respingă solicitările. 🔗 sursă
- Gemini CLI își reia seria nightly după o zi fără lansări — patru modificări pe 18 septembrie, printre care păstrarea refresh token-ului OAuth la reînnoire și o ștergere a identificatorilor devenită idempotentă; canalele stable și preview rămân neschimbate. 🔗 sursă
- Kimi Code 2.0.1 accelerează pornirea și reluarea sesiunilor — versiune de remediere la 32 de ore după 2.0.0: compactarea indexului sesiunilor, reluare mai rapidă pentru istoricele lungi, cheie API care poate fi citită dintr-o variabilă de mediu denumită și observatoare de fișiere cu limite stabilite. 🔗 sursă
- Qwen Code trece la versiunea preliminară v0.24.1 cu un SDK de browser Playwright — nu este o versiune stabilă; introduce control integrat al browserului cu releu de mesagerie nativă Chrome și executarea subagenților în containere. 🔗 sursă
- Zed publică versiunea stabilă 1.20.2, cu doar două remedieri — erorile de plată ale furnizorilor terți de modele nu mai afișează o invitație de trecere la Zed Pro în locul mesajului original, iar două extensii de snippets pentru același limbaj nu se mai anulează reciproc. 🔗 sursă
- Replit susține că Free Mode este „de 30 de ori” mai generos, fără o referință publicată — un simplu tweet, fără link sau changelog, care nu precizează termenul de comparație al acestui factor: trebuie tratat drept o afirmație a Replit, nu ca o măsurătoare. 🔗 sursă
- Tabloul de bord privind impactul Copilot detaliază implicarea în funcție de funcționalitate — șapte suprafețe pe parcursul a 28 de zile, cu distincție între revizuirea activă și cea pasivă a codului și cu o populație aflată în faza de adopție calculată acum într-o fereastră glisantă. 🔗 sursă
- GitHub programează o transmisiune live introductivă despre SDK-ul Copilot, în șase limbi — sesiuni, instrumente, servere MCP și evenimente în flux, cu sesiuni dedicate pentru .NET și Java, fără cunoștințe preliminare necesare. 🔗 sursă
- Runway Ruby păstrează canalul alpha în timpul conversiei în HDR — conversia unei secvențe brute în HDR păstrează transparența intactă, într-un singur pas; nu sunt precizate nici tariful, nici nivelul de abonament. 🔗 sursă
- MiniMax se alătură Singtel AI Pass pentru programul singaporez SkillsFuture — MiniMax H3, MiniMax Agent și MiniMax Audio intră în ofertă, destinată cursanților eligibili pentru peste 200 de cursuri de AI susținute de SWDA; fără sume sau calendar anunțate. 🔗 sursă
- VC-Attention accelerează mecanismul de atenție al MiniMax-H3 fără reantrenare — MiniMax promovează cercetările Nunchux AI privind un mecanism de atenție de precizie redusă, aplicabil modelului existent; Nunchux AI anunță o accelerare de 1,6x pe B200 și de 1,5x pe B300 față de FlashAttention-4. 🔗 sursă
- Wan3.0 ocupă locul al doilea în categoria video a OpenArt Arena — Alibaba evidențiază secvențele de 30 de secunde, componenta audio nativă și compatibilitatea cu orice referință; este o poziționare într-un clasament terț, fără noutăți despre produs. 🔗 sursă
- Synthesia își deschide sediul american la New York — știre corporativă fără informații despre produs, personal sau calendarul investițiilor, la două zile după disponibilitatea generală a Interactive Avatar API. 🔗 sursă
- Grok Imagine detaliază costul unui episod-pilot realizat integral cu AI — studioul lui PJaccetturo anunță nouă zile de muncă, 3.627 de imagini și 3.043 de videoclipuri generate, la un cost de 2.677 de dolari pentru generări, pentru episodul-pilot al concursului Odyssée. 🔗 sursă
- BananaMind 2 Pro se apropie de SmolLM2 folosind de douăzeci de ori mai puține token-uri — un model cu 139 de milioane de parametri, antrenat pe 100 de miliarde de token-uri și pe un RTX 5070 Ti, obține 42,78% pe HellaSwag, față de 43,22 pentru SmolLM2-135M, antrenat pe 2.000 de miliarde de token-uri. 🔗 sursă
- Optimum-Intel v2.2.0 și OpenVINO GenAI 2026.4.0 extind exportul către hardware-ul Intel — Hugging Face și Intel publică versiuni comune pentru procesoare, plăci grafice și NPU-uri Intel, Mistral 3 putând fi acum exportat. 🔗 sursă
- AmberTrace Labs măsoară fidelitatea raționamentului Olmo 3 în cadrul RL cu recompensă verificabilă — pe probele excluse din antrenare, fidelitatea crește de la 0,238 la 0,262: o evoluție pozitivă, nu o degradare, cu checkpoints publicate. 🔗 sursă
- Together AI revendică cel mai bun timp până la primul token pentru DeepSeek V4.1 Flash — compania retransmite măsurătoarea unui terț pentru solicitările preîncălzite, fără să publice metoda sau valoarea: o afirmație, nu un rezultat verificabil. 🔗 sursă
- Google Flow sprijină doi creatori la Săptămâna Modei de la New York — instrumente personalizate concepute împreună cu Jane Wade și Sergio Hudson; demonstrație de utilizare, fără vreun model nou sau vreo funcționalitate lansată. 🔗 sursă
- Google AI Educator Series oferă acum credite universitare — cursurile programului de formare oferă de acum credite universitare sau de formare continuă. 🔗 sursă
Ce înseamnă acest lucru
Ziua transmite în primul rând un mesaj: agenții de programare încetează să mai fie produse închise și încep să folosească formate comune. Claude Code citește AGENTS.md atunci când un proiect nu are CLAUDE.md — adică Anthropic acceptă un fișier de instrucțiuni definit în altă parte, astfel încât același repository să poată fi folosit de mai multe instrumente. În aceeași zi, Antigravity introduce în promptul de sistem al agenților săi Markdown catalogul subagenților disponibili, Vibe CLI face în sfârșit ca hook-urile să ruleze în interiorul subagenților, Codex își detaliază factura în funcție de subagent, iar Qwen Code îi plasează pe ai săi în containere. Delegarea între agenți era o promisiune de configurare; devine un mecanism care trebuie documentat, izolat și facturat. Claude Code duce, de altfel, până la capăt această logică a neîncrederii, marcând rezultatele subagenților cu un antet dedicat, astfel încât un text transmis înapoi să nu se poată prezenta drept instrucțiune.
Piața agenților pentru terminal se banalizează vizibil. MiniMax îl publică pe al său sub licență MIT, cu TUI, mod fără interfață, ACP și alegerea liberă a modelului; Mistral elimină eticheta „experimental” de pe Unified Harness și documentează --legacy-harness drept portiță de ieșire; Kimi Code lansează o remediere de performanță la 32 de ore după versiunea sa majoră. Când patru furnizori oferă același obiect cu aceleași puncte de intrare, diferențierea se mută către licență, stabilitatea harness-ului și regimul permisiunilor — exact domeniile vizate de modificările zilei, atât la Mistral, cât și la Anthropic.
În privința modelelor, tendința este ca audio-video să devină agentic, nu descriptiv. Qwen3.8-Omni-Flash nu mai încearcă să descrie un videoclip, ci să găsească în el un răspuns: pornind de la întrebare, câștigă 4,4 puncte pe OmniVideoBench și consumă totodată cu 45,7% mai puține token-uri — performanța și economia evoluează în aceeași direcție, ceea ce este rar. De cealaltă parte, Grok Voice Transcribe 2.0 nu mizează pe demonstrația de laborator, ci pe traficul real, cu o rată de eroare pentru frazele scurte care scade de la 20,6% la 6,8% și cu un tarif neschimbat. Cele două anunțuri converg: valoarea nu mai provine din modalitatea acceptată, ci din ceea ce modelul decide să proceseze.
Rămâne întrebarea privind lucrurile pe care laboratoarele acceptă să le supună verificării. Anthropic plătește Accenture pentru a instala evaluatori în interiorul propriei companii, cu acces de angajat — și recunoaște în același anunț că nu există niciun standard privind lucrurile la care un astfel de evaluator ar trebui să aibă acces, modul în care ar trebui să-și publice constatările sau cine ar trebui să-l finanțeze. Este deopotrivă o recunoaștere și un mecanism. În paralel, cele mai solide dovezi ale zilei sunt cele pe care un terț le poate reproduce: rezultatele obținute de Exeter și Stowers Institute pentru AlphaGenome Atlas, codul de optimizare biomoleculară publicat în regim open source, checkpoints publicate de AmberTrace Labs. Iar contrariul se observă la fel de clar: Replit invocă un factor de 30 fără referință, Together AI retransmite un clasament fără metodologie, Mistral dezminte o acuzație pe care nimeni nu a putut-o citi. În acest context, AIPerf sosește la momentul potrivit — un instrument de măsurare care începe prin a admite că, adesea, problema este cel care măsoară.
Surse
- Claude Code, notele versiunii 2.1.277
- CHANGELOG Claude Code
- Qwen, articolul despre Qwen3.8-Omni-Flash
- Alibaba Qwen pe X, anunțul modelului
- Codex CLI, notele versiunii 0.155.0
- OpenAI Developers pe X, consumul detaliat în Codex
- SpaceXAI, Grok Voice Transcribe 2.0
- Anthropic, evaluare integrată împreună cu Accenture
- Changelog Antigravity
- GitHub, sinteza săptămânală Copilot din 14 septembrie
- GitHub, retragerea treptată a șase modele Copilot
- GitHub, personalizările agentice ale CLI-ului în API-ul de metrici
- MiniMax pe X, publicarea codului MiniMax Code CLI
- Vibe CLI, notele versiunii 2.25.5
- OpenAI Developers pe X, pluginurile multi-cont
- Max Stoiber pe X, mesajul original despre conturile multiple
- Genspark pe X, soldul săptămânal Plus și Pro
- Google DeepMind pe X, rezultatele partenerilor AlphaGenome Atlas
- Google Research, materiale educaționale interactive prin interfață generativă
- Anthropic Research, Claude și modelarea biomoleculară
- Meta AI pe X, Muse pentru Mac
- Sakana AI, Frontier Intelligence Group
- Runway, tarificarea unificată
- Pika pe X, lansarea Product Ad
- NVIDIA, măsurarea inferenței la scară largă cu AIPerf
- Mistral AI pe X, dezmințirea din 18 septembrie