ai-powered-markdown-translatorलेख का fr से hi में अनुवाद gpt-5.6-sol के साथ किया गया।
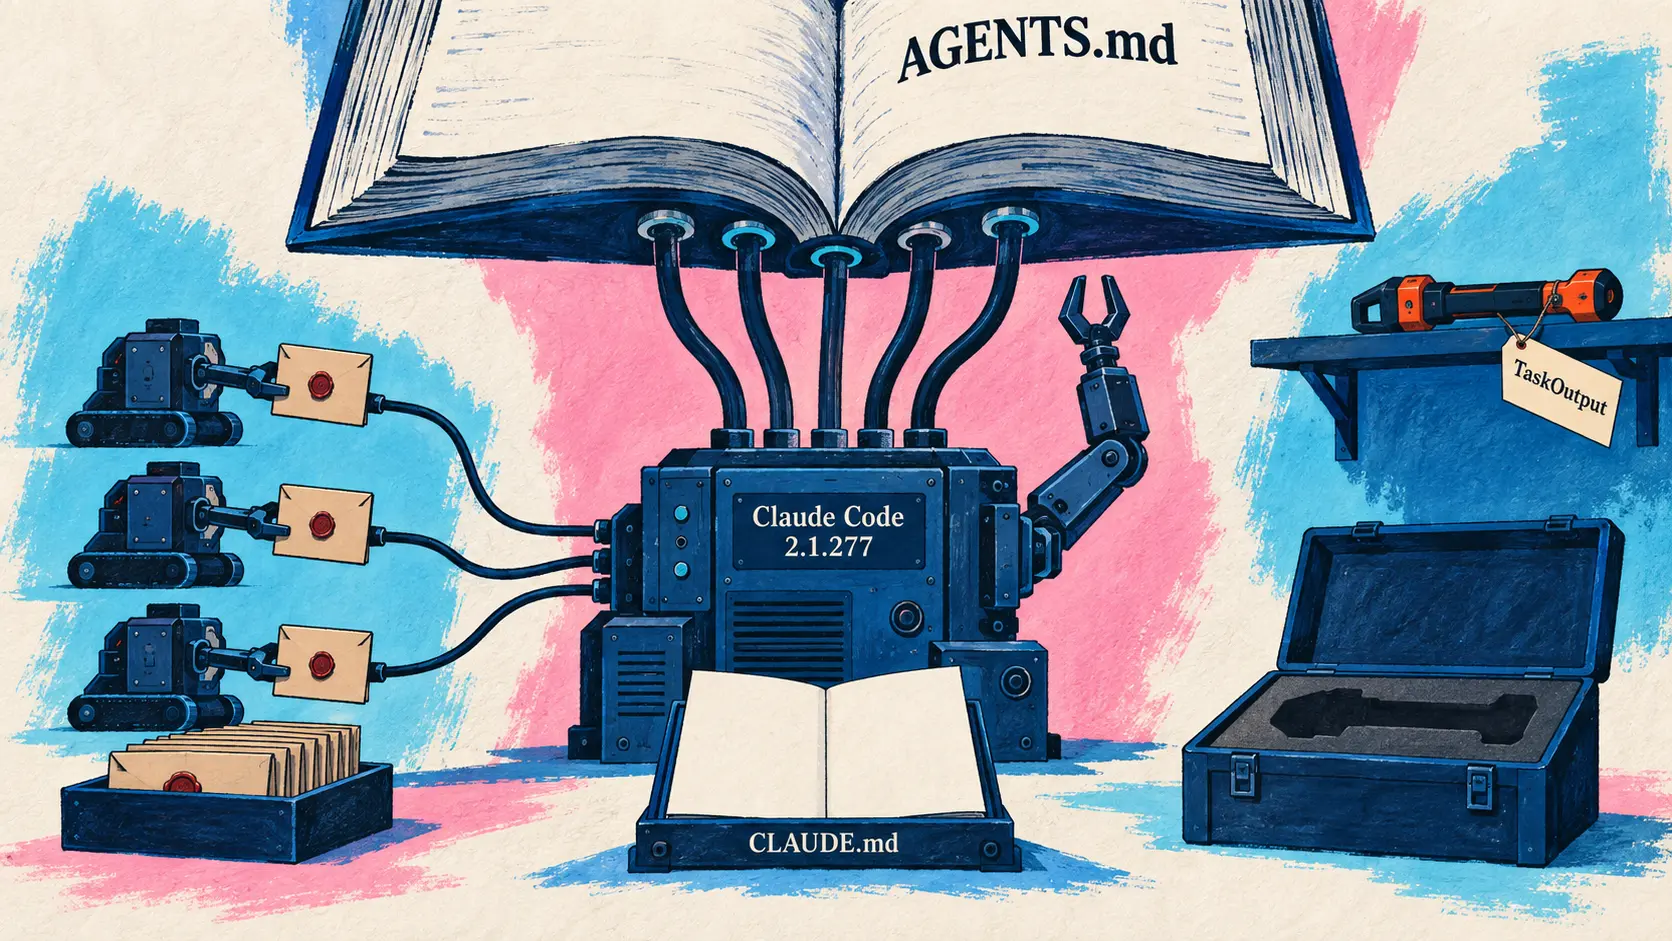
इस शुक्रवार एजेंट उपकरण साझा प्रारूपों की ओर बढ़े: जब किसी प्रोजेक्ट में CLAUDE.md नहीं होता, तो Claude Code अब AGENTS.md पढ़ता है, Antigravity अपने Markdown एजेंटों के सिस्टम प्रॉम्प्ट में उप-एजेंटों की सूची जोड़ता है, Codex प्रत्येक उप-एजेंट के हिसाब से अपनी खपत का विवरण देता है और MiniMax ने अपने टर्मिनल एजेंट का कोड खोल दिया है। दिन की बाकी प्रमुख ख़बरें दो मॉडल रिलीज़—Qwen3.8-Omni-Flash और Grok Voice Transcribe 2.0—और एक असामान्य साझेदारी तक सीमित रहीं: Anthropic अपनी ही कंपनी के भीतर Accenture के मूल्यांकनकर्ताओं को तैनात कर रहा है।
Claude Code अब AGENTS.md पढ़ता है, उप-एजेंटों को अलग करता है और TaskOutput हटाता है
18 सितंबर — बीस घंटों के भीतर Claude Code के तीन संस्करण लगातार जारी हुए: 2.1.275, 17 सितंबर को 22 बजकर 33 मिनट UTC पर; 2.1.276, 18 सितंबर को 02 बजकर 12 मिनट UTC पर; और 2.1.277, 18 सितंबर को 18 बजकर 06 मिनट UTC पर।
सबसे संरचनात्मक नई सुविधा 2.1.277 की एक पंक्ति में है। जिस प्रोजेक्ट में CLAUDE.md नहीं है, वहाँ Claude Code अब AGENTS.md पढ़ता है—यह निर्देश फ़ाइल बाज़ार के कई कोडिंग एजेंटों की साझा परंपरा बन चुकी है। यह विकल्प /config में “प्रोजेक्ट निर्देश” के अंतर्गत बदला जा सकता है। यह सुविधा अभी Bedrock, Vertex या Foundry पर उपलब्ध नहीं है।
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇮🇳 AGENTS.md के लिए समर्थन जोड़ा गया: CLAUDE.md के बिना किसी प्रोजेक्ट में Claude Code उसकी जगह AGENTS.md पढ़ता है; यह सेटिंग /config में “प्रोजेक्ट निर्देश” के अंतर्गत बदली जा सकती है (अभी Bedrock, Vertex या Foundry पर उपलब्ध नहीं)। — Claude Code परिवर्तन-सूची, anthropics/claude-code
इसी संस्करण के दो अन्य बदलाव संदर्भ की सुरक्षा से जुड़े हैं। उप-एजेंटों के परिणाम मुख्य एजेंट तक ऐसे शीर्षलेख के अंतर्गत पहुँचते हैं जो स्पष्ट रूप से उन्हें उप-एजेंट परिणाम बताता है, ताकि उप-एजेंट से लौटा पाठ सत्र का निर्देश बनकर प्रस्तुत न हो सके; और प्रॉम्प्ट से अदृश्य Unicode स्वरूपण वर्ण हटा दिए जाते हैं, जबकि भेजने से पहले साफ़ किया गया संस्करण दिखाया जाता है। 2.1.277 पुराने हो चुके TaskOutput उपकरण को भी हटाता है: Claude अब पृष्ठभूमि कार्य की आउटपुट फ़ाइल Read से पढ़ता है।
2.1.275 में तत्काल भेजने की कुंजी (ctrl+enter) जोड़ी गई है, जो जारी चरण को रोककर कतार में पड़े सभी संदेश एक साथ भेज देती है, साथ ही claude.ai खाते पर सक्रिय skills और plugins को टर्मिनल से समन्वित करती है। आपूर्ति-श्रृंखला के स्तर पर, npm-मूल के plugins को अखंडता सत्यापन के साथ npm pack --ignore-scripts द्वारा प्राप्त किया जाता है, जिससे किसी पैकेज की स्थापना स्क्रिप्ट चल नहीं पाती। चार घंटे से भी कम समय बाद जारी 2.1.276 ने केवल इसी संस्करण की एक प्रतिगमन समस्या ठीक की: proxy के पीछे सभी अनुरोधों को विफल करने वाली 400 त्रुटि।
| संस्करण संख्या | प्रकाशन (UTC) | प्रमुख सामग्री |
|---|---|---|
| 2.1.275 | 17/09 को 22 बजकर 33 मिनट | तत्काल प्रेषण, claude.ai skills का समन्वय, npm --ignore-scripts |
| 2.1.276 | 18/09 को 02 बजकर 12 मिनट | एकमात्र सुधार: proxy के पीछे 400 त्रुटि |
| 2.1.277 | 18/09 को 18 बजकर 06 मिनट | AGENTS.md के लिए समर्थन, उप-एजेंटों का पृथक्करण, TaskOutput को हटाना |
🔗 संस्करण 2.1.277 की रिलीज़ टिप्पणियाँ
Qwen3.8-Omni-Flash, Qwen का पहला एजेंटिक ओम्नी-मोडल मॉडल
18 सितंबर — Qwen ने Qwen3.8-Omni-Flash जारी किया, जिसे एजेंटिक क्षमताओं के आधार पर निर्मित उसका पहला ओम्नी-मोडल मॉडल बताया गया है। घोषित बदलाव अब बहु-मोडल सामग्री को केवल समझने का नहीं, बल्कि उसका उपयोग करने का है: सामग्री समझना, कार्य की योजना बनाना, उपकरणों की मदद से उसे पूरा करना और परिणाम देना। मॉडल 10 लाख टोकन की संदर्भ विंडो में पाठ, छवि, ऑडियो और वीडियो स्वीकार करता है।
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇮🇳 पेश है Qwen3.8-Omni-Flash, एजेंटिक क्षमताओं के आधार पर निर्मित Qwen का पहला ओम्नी-मोडल मॉडल। — X पर @Alibaba_Qwen
Qwen द्वारा चुने गए 29 मूल्यांकनों में औसत स्कोर Qwen3.5-Omni-Plus की तुलना में 25% से अधिक बढ़ा है, और लाभ मुख्यतः ऑडियो-वीडियो एजेंटों में केंद्रित हैं। बहु-वक्ता पहचान में सबसे बड़ा बदलाव हुआ है।
| चयनित मूल्यांकन | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (कम होना बेहतर है) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
सबसे मौलिक पहलू लंबे वीडियो पर लागू एजेंटिक बोध है। किसी रिकॉर्डिंग को शुरू से अंत तक संसाधित करने के बजाय, मॉडल पूछे गए प्रश्न से शुरुआत करता है, स्वयं तय करता है कि क्या देखना और सुनना है, और क्रमिक चरणों में व्यापक से सूक्ष्म स्तर तक जानकारी खोजता है। OmniVideoBench पर यह मोड सटीकता को 63,4 से 67,8 तक बढ़ाता है, जबकि प्रति अनुरोध खपत को 145 736 से घटाकर 79 117 टोकन करता है, यानी लगभग 45,7% कम—यह आँकड़ा आधिकारिक लेख में स्वयं दिया गया है।
मूल्य निर्धारण भी इसी क्रम में है: Qwen की कार्यप्रणाली के अनुसार, Qwen3.5-Omni-Plus की तुलना में प्रति घंटा ऑडियो इनपुट की कीमत 98% से अधिक घटती है। इसके साथ दो घटक खुले किए गए हैं: Qwen-MM-Plugins, जो Codex, Claude Code, Qwen Code और Gemini CLI हार्नेस के अनुकूल है; और वास्तविक-समय संवाद के लिए Qwen-Live Harness। निरंतर कम-विलंबता संवाद के लिए एक Realtime संस्करण समर्पित है, जिसका पहला टोकन 591 से 981 मिलीसेकंड के बीच आता है।
🔗 Qwen3.8-Omni-Flash पर Qwen का लेख
Codex CLI 0.155.0 में ध्वनि वार्तालाप प्रायोगिक रूप से शामिल हुए
17 सितंबर — OpenAI ने Codex CLI 0.155.0 जारी किया, जो 10 सितंबर के 0.154.0 के बाद पहला स्थिर संस्करण है और npm install -g @openai/codex@0.155.0 द्वारा स्थापित किया जा सकता है। यह एक दिन पहले X पर घोषित ध्वनि एजेंट से जुड़ी वह परिवर्तन-सूची प्रविष्टि है जो अब तक अनुपस्थित थी: इस सुविधा का नाम /voice है, यह लाइव प्रतिलेखन और माइक्रोफ़ोन नियंत्रण प्रदान करती है, और अभी प्रायोगिक है—केवल समर्थित बिल्ड पर उपलब्ध तथा /experimental द्वारा सक्रिय की जाने वाली।
संस्करण का शेष भाग कम आकर्षक, पर तुरंत अधिक उपयोगी है। टर्मिनल इंटरफ़ेस की स्थिति पंक्ति में लाइव तर्क-सारांश और प्रत्येक सफल चरण के बाद समाप्ति का समय मिलता है। एजेंट अवलोकन में कार्यों को छिपाया, संग्रहित और हटाया जा सकता है; साथ ही worktrees के स्वामित्व का विवरण और प्रबंधित साफ़ worktrees हटाने से पहले पुष्टि भी मिलती है। संगत Mac पर स्थानीय TUI सत्रों के MCP अनुरोध Touch ID से सत्यापित किए जा सकते हैं। Amazon Bedrock विन्यस्त आदेशों से AWS परिचय-पत्र प्राप्त कर सकता है, जिनमें कैशिंग, समय समाप्त होने पर नवीनीकरण और प्रमाणीकरण विफलता के बाद पुनर्प्राप्ति शामिल है।
कई सुधार सुरक्षा से संबंधित हैं: प्रतिबंधित WSL sandbox से Windows प्रक्रिया पलायन रोके गए हैं, मध्यस्थ shell snapshots को परिचय-पत्र उजागर होने से बचाने के लिए सुदृढ़ किया गया है, और खाता बदलने पर पिछले उपयोगकर्ता की दूरस्थ नियंत्रण सत्रावस्था, कैश किया गया WebSocket state तथा मॉडल सूचियाँ अमान्य हो जाती हैं।
| संस्करण की नई सुविधा | विवरण |
|---|---|
/voice | लाइव प्रतिलेखन और माइक्रोफ़ोन नियंत्रण, /experimental द्वारा प्रायोगिक |
| टर्मिनल इंटरफ़ेस | स्थिति पंक्ति में तर्क-सारांश, चरण समाप्ति का समय |
| एजेंट अवलोकन | कार्यों को छिपाना, संग्रहित करना और हटाना; worktrees का स्वामित्व |
| Touch ID | संगत Mac पर स्थानीय सत्र के MCP अनुरोधों का सत्यापन |
| Amazon Bedrock | आदेश से प्राप्त AWS परिचय-पत्र, कैश और नवीनीकरण सहित |
🔗 Codex CLI 0.155.0 की रिलीज़ टिप्पणियाँ
Codex कार्य, उप-एजेंट और वार्तालाप के अनुसार अपनी खपत का विवरण देता है
18 सितंबर — OpenAI Developers ने Codex में विस्तृत खपत निगरानी की घोषणा की: यह उपकरण दिखाता है कि कार्य, उप-एजेंट और अलग-अलग वार्तालाप कुल उपयोग में कितना योगदान देते हैं। व्यक्तिगत और Business खातों के लिए यह जानकारी डेस्कटॉप अनुप्रयोग में सेटिंग्स, फिर उपयोग और बिलिंग के अंतर्गत मिलती है; पात्र Enterprise खातों के लिए यह उपयोग के अंतर्गत है। इसका लाभ लेने के लिए अनुप्रयोग का अद्यतन होना आवश्यक है। घोषणा के साथ कोई ब्लॉग लेख या परिवर्तन-सूची प्रविष्टि नहीं है।
वास्तविक विषय इसका विस्तृत विभाजन है। अब तक समाप्त हो चुका कोटा यह नहीं बताता था कि खर्च कहाँ हुआ; उप-एजेंट के अनुसार विभाजन से पता चलता है कि कौन-सा प्रत्यायोजन महँगा पड़ रहा है, ताकि उसे दोबारा लिखा जा सके। यह कोडिंग हार्नेस में उप-एजेंटों के सामान्यीकरण का लेखांकन पक्ष है।
🔗 X पर OpenAI Developers की घोषणा
Grok Voice Transcribe 2.0, समान मूल्य पर SpaceXAI की वाक् पहचान
18 सितंबर — SpaceXAI ने अपने नए वाक् पहचान मॉडल Grok Voice Transcribe 2.0 की घोषणा की, जिसे समान मूल्य पर संस्करण 1.0 से दोगुना सटीक बताया गया है। मॉडल उसी ऑडियो आधार पर बना है जो पहले से Grok Voice को संचालित करता है; कंपनी के अनुसार यह प्रतिदिन ग्राहक सहायता की दसियों हज़ार कॉल संभालता और वीडियो कथन के लाखों घंटों का प्रतिलेखन करता है।
मुख्य तर्क प्रयोगशाला ऑडियो के बजाय वास्तविक दुनिया के ऑडियो पर केंद्रित है: अस्थिर टेलीफ़ोन लाइनें, प्रतिस्पर्धी आवाज़ें, स्थानीय उच्चारण, और ऊँची आवाज़ में बोले गए फ़ोन नंबर व ई-मेल पते। SpaceXAI सार्वजनिक Artificial Analysis रैंकिंग में 32 निरंतर-स्ट्रीमिंग मॉडलों के बीच सटीकता में प्रथम स्थान का दावा करता है और उत्पादन ट्रैफ़िक से लिए गए चार आंतरिक डेटासेट पर निर्भर करता है—8 kHz टेलीफ़ोनी, Grok के साथ वार्तालाप, बोले गए पहचानकर्ता और 19 भाषाओं में छोटे ध्वनि आदेश।
सबसे स्पष्ट सुधार बहुभाषी क्षमता में है। छोटे वाक्यों वाले डेटासेट पर, जहाँ भाषा पहचानने के लिए संदर्भ सबसे कम होता है, प्रति शब्द त्रुटि दर 20,6% से घटकर 6,8% हो जाती है। मॉडल भाषा का स्वतः पता लगाता है और एक ही चरण में रिकॉर्डिंग के दौरान होने वाले भाषा परिवर्तनों का अनुसरण करता है।
| मापी गई मापनी | घोषित मान |
|---|---|
| Transcribe 1.0 की तुलना में दावा की गई सटीकता | दोगुनी |
| Artificial Analysis रैंकिंग (निरंतर स्ट्रीमिंग) | 32 मॉडलों में पहला स्थान |
| छोटे वाक्यों पर त्रुटि दर (1.0 → 2.0) | 20,6 % → 6,8 % |
| बैच दर | 0,10 डॉलर प्रति ऑडियो घंटा |
| निरंतर स्ट्रीमिंग दर | 0,20 डॉलर प्रति ऑडियो घंटा |
| स्वतंत्र रूप से प्रतिलिखित चैनल | अधिकतम 8 |
| प्रति अनुरोध व्यावसायिक शब्दावली | अधिकतम 100 |
मॉडल बैच और निरंतर स्ट्रीमिंग प्रसंस्करण, विश्वास स्कोर के साथ शब्द-स्तरीय समय-चिह्न, बिना अतिरिक्त शुल्क के वक्ता पृथक्करण और बोलने के चरण की समाप्ति का पता लगाने की सुविधा देता है। मौजूदा API एकीकरण बिना किसी कोड परिवर्तन के बढ़ी हुई सटीकता प्राप्त करते हैं। Grok Voice Transcribe 2.0 जल्द ही API का डिफ़ॉल्ट मॉडल बन जाएगा और आने वाले हफ़्तों में 1.0 अप्रचलित कर दिया जाएगा: उसी पर बने रहने के लिए grok-voice-transcribe-1.0 को निर्धारित करना होगा।
🔗 Grok Voice Transcribe 2.0 की घोषणा
Anthropic ने कंपनी के भीतर Accenture के मूल्यांकनकर्ताओं को तैनात किया
18 सितंबर — Anthropic ने अग्रणी मॉडलों के स्वतंत्र मूल्यांकन के लिए Accenture के साथ साझेदारी की घोषणा की, जिसे उसके मुख्य कार्यकारी अधिकारी द्वारा एकीकृत मूल्यांकनकर्ताओं को आमंत्रित करने की प्रतिबद्धता की दिशा में महत्वपूर्ण कदम बताया गया है। यह कार्य Accenture की AI-विशेषज्ञ सहायक कंपनी Faculty करेगी और इसमें मॉडलों का मूल्यांकन तथा red-teaming, संरेखण मूल्यांकन और सुरक्षा उपायों का परीक्षण शामिल होगा।
बाहरी मूल्यांकनकर्ताओं से अंतर स्पष्ट है: एक एकीकृत मूल्यांकनकर्ता AI कंपनी के भीतर कर्मचारी के समान पहुँच के साथ काम करता है। वह प्रशिक्षण के दौरान मॉडलों का निरीक्षण कर सकता है, उनके निर्माण और परिनियोजन को नियंत्रित करने वाले निर्णयों का अनुसरण कर सकता है, कर्मचारियों से सीधे बात कर सकता है, सुरक्षा प्रतिबद्धताओं के पालन की पुष्टि कर सकता है, घटनाओं की सूचना दे सकता है और लाभ तथा जोखिमों का अधिक जानकारीपूर्ण विवरण प्रकाशित कर सकता है। Anthropic स्पष्ट करता है कि यह व्यवस्था उसकी जवाबदेही घटाती नहीं, बल्कि उसे अधिक सत्यापन योग्य बनाती है।
घोषणा में उन चीज़ों को लेकर असामान्य स्पष्टता है जो अभी मौजूद नहीं हैं। इस बारे में कोई मानक नहीं है कि एक एकीकृत मूल्यांकनकर्ता को किन सूचनाओं तक पहुँच मिलनी चाहिए, उसे अपने निष्कर्ष कैसे प्रकाशित करने चाहिए, और न ही स्वतंत्र मूल्यांकन के वित्तपोषण की कोई स्थापित प्रणाली है। Anthropic का मानना है कि अंततः यह वित्तपोषण साझा या सार्वजनिक कोष से आना चाहिए; आज ऐसी व्यवस्था न होने के कारण वह Accenture के कार्य को सीधे वित्तपोषित कर रहा है—जो इस व्यवस्था की सबसे स्पष्ट सीमा है।
| साझेदारी का तत्व | घोषित मान |
|---|---|
| संचालन करने वाली इकाई | Faculty, Accenture की AI सहायक कंपनी |
| निवेश | प्रत्येक पक्ष द्वारा पाँच वर्षों में कम से कम 1 अरब डॉलर |
| सम्मिलित दायरा | मूल्यांकन, red-teaming, संरेखण, सुरक्षा उपाय |
| पहुँच का स्तर | कर्मचारी के समान |
| वित्तपोषण | साझा कोष के अभाव में Anthropic द्वारा प्रत्यक्ष |
| विशिष्टता | दोनों पक्षों में कोई नहीं |
Anthropic यह भी बताता है कि वह METR और अन्य गैर-लाभकारी मूल्यांकनकर्ताओं के साथ उनके अपने वित्तपोषण पर एकीकृत मूल्यांकन के तत्वों का प्रयोग करने के लिए चर्चा कर रहा है, और आने वाले हफ़्तों में अन्य साझेदारों की घोषणा करेगा।
🔗 एकीकृत मूल्यांकन पर Anthropic की घोषणा
Antigravity: कस्टम एजेंटों से जुड़े दो दिनों में तीन संस्करण
Google ने लगातार अपनी CLI के दो संस्करण और Antigravity ऐप का एक संस्करण जारी किया। तीनों एक ही विषय को तीन दृष्टिकोणों से देखते हैं: एक कस्टम एजेंट क्या जानता है, वह किस चीज़ से इनकार कर सकता है, और वह बिना निगरानी के कितनी देर तक चल सकता है। ये 11 सितंबर को शुरू हुई एक सघन शृंखला को आगे बढ़ाते हैं, जिसके संस्करण 1.2.1 से 1.2.4 यहाँ शामिल नहीं हैं।
CLI 1.2.6 सत्र से जुड़ा Remote Control खोलता है और पाँच मिनट की सीमा हटाता है
18 सितंबर — 1.2.0 के आठ दिन बाद, जिसने CLI को एक स्थायी सिस्टम सेवा बनाया था, Google Remote Control के एक दूसरे, कहीं हल्के रूप के साथ विपरीत दिशा अपनाता है: सत्र तक सीमित (session-scoped) कनेक्शन, जिसे आरंभ करते समय फ़्लैग --remote-control या संचालन के दौरान कमांड /remote-control से खोला जाता है। /remote-control off टाइप करने या सत्र बंद करने पर टनल हट जाती है और डिवाइस सूची से निकल जाता है। जहाँ 1.2.0 का लक्ष्य ऐसा daemon था जो सत्र के बाद भी चलता रहे, वहीं 1.2.6 का लक्ष्य इसके विपरीत है।
दूसरा बदलाव बिना इंटरफ़ेस वाले (headless) मोड से संबंधित है: -p / --prompt निष्पादनों की डिफ़ॉल्ट समय-सीमा पाँच मिनट से बढ़कर असीमित हो जाती है, जब तक कि --print-timeout स्पष्ट रूप से न दिया गया हो। तीसरा बदलाव त्रुटि रिपोर्टिंग को संरचित करता है—एजेंट या API की विफलता पर CLI मानक स्थिति, HTTP या gRPC कोड, पुनः प्रयास की संभावना और त्रुटि पहचानकर्ता वाली एक JSON पंक्ति AGY_ERROR: {...} को त्रुटि आउटपुट पर लिखता है, और निकास कोड 1 से बदलकर 3 हो जाता है। इस तरह कोई orchestration स्क्रिप्ट मुक्त पाठ का विश्लेषण किए बिना अस्थायी नेटवर्क विफलता को स्थायी त्रुटि से अलग कर सकती है।
CLI 1.2.5 अंततः Markdown एजेंटों को उनके उप-एजेंटों की निर्देशिका देता है
17 सितंबर — अब तक Markdown में परिभाषित कोई कस्टम एजेंट अपने टूल्स में invoke_subagent घोषित कर सकता था, लेकिन उसे कभी पता नहीं चलता था कि कौन-से उप-एजेंट उपलब्ध हैं: उसके पास टूल तो था, पर निर्देशिका नहीं। अब CLI अपने-आप उसके सिस्टम prompt में उपलब्ध उप-एजेंटों की सूची और उनके उपयोग के निर्देश जोड़ता है, जिससे delegation वास्तव में काम करने लगता है।
changelog की शब्दावली को सावधानी से समझना चाहिए: यह स्वयं उत्पाद द्वारा संदर्भ जोड़े जाने का मामला है, न कि कोई सुरक्षा खामी या सुधार। दूसरा सुधार पृष्ठभूमि में भेजे गए कार्य के स्पष्ट नाम को सुरक्षित रखता है, जो सूचनाओं और कार्य सूचियों के बीच खो जाता था। पाँच सुधार निरस्त पहचानकर्ताओं की सफ़ाई, बाधित कमांडों के निकास कोड और जमे रहने वाले विचार-फ़्रेमों से संबंधित हैं।
Antigravity 2.15.0 कस्टम एजेंटों को डिफ़ॉल्ट prompts और टूल्स बंद करने देता है
18 सितंबर — 2.14.0 के तीन दिन बाद, ऐप 7 सुधार और 16 त्रुटि-सुधार जारी करता है। मुख्य बदलाव कस्टम एजेंटों को अपने संदर्भ पर नियंत्रण देता है: वे डिफ़ॉल्ट prompt अनुभागों और डिफ़ॉल्ट टूल्स को निष्क्रिय कर सकते हैं, फिर केवल उन्हीं को वापस जोड़ सकते हैं जिनकी उन्हें आवश्यकता है। किसी विशेषज्ञ एजेंट के लिए इससे थोपा गया सिस्टम prompt उसी अनुपात में कम हो जाता है।
बाकी बदलाव नेविगेशन और स्थायित्व से संबंधित हैं: Page Up, Page Down, Home और End से बातचीत में स्क्रॉल किया जा सकता है, Escape इनपुट क्षेत्र से बाहर निकालता है, और चुना गया कस्टम एजेंट पुनः लोड होने के बाद याद रखा जाता है। दो सुधार डेटा की अखंडता से जुड़े हैं—ऐप द्वारा अपनी स्थिति फ़ाइल पढ़ने में विफल होने पर सहेजी गई सेटिंग्स और प्रोजेक्ट सूची अधिलेखित हो सकती थीं, और अनुमति सेटिंग्स में डुप्लिकेट जमा होते थे, जिससे बातचीत की फ़ाइलें बढ़ती जाती थीं।
GitHub Copilot: एक Sentry canvas, हटाए गए छह मॉडल और प्रत्येक customization के अनुसार metrics
दो दिनों में changelog की तीन प्रविष्टियाँ एक ही चिंता दिखाती हैं: यह मापना कि टीमें वास्तव में Copilot का किस तरह उपयोग करती हैं, और जिन चीज़ों का वे अब उपयोग नहीं करतीं उन्हें हटाना।
14 सितंबर का सारांश दो नई सुविधाओं को अलग से उजागर करता है
18 सितंबर — GitHub ने 14 सितंबर वाले सप्ताह के लिए अपना साप्ताहिक Copilot सारांश प्रकाशित किया। सारांश का अधिकांश भाग changelog में पहले ही प्रकाशित प्रविष्टियों को दोहराता है; केवल दो तत्वों की पहले कभी अलग से घोषणा नहीं हुई थी। पहला Copilot ऐप में Sentry canvas है, जो ऐप छोड़े बिना production crash रिपोर्ट को सुधार से जोड़ता है: यह त्रुटियाँ, stack traces और संदर्भ दिखाता है, फिर कारण की जाँच करने, सुधार सत्यापित करने और pull request तैयार करने देता है। सितंबर की शुरुआत में Jira के बाद, canvases में त्रुटि-निगरानी टूल का यह पहला integration है।
दूसरा VS Code 1.138 में एजेंटों की नई लहर है। Agents विंडो किसी एजेंट को स्थानीय Dev Container में प्रोजेक्ट के टूल्स और dependencies के साथ चला सकती है—rollout क्रमिक है और Docker आवश्यक है। निष्क्रिय सत्रों की सभी pull requests merge हो जाने पर उन्हें अपने-आप पूर्ण चिह्नित किया जा सकता है, और एक मोहलत के बाद वैकल्पिक रूप से हटाया जा सकता है; यह preview में है और इसे स्पष्ट रूप से सक्रिय करना होगा। अंततः, Agent Host सत्र से सीधे pull request बनाई जा सकती है।
छह मॉडल 19 अक्टूबर को Copilot के सभी interfaces से हटेंगे
18 सितंबर — GitHub ने 19 अक्टूबर 2026 को Copilot के सभी interfaces—Copilot Chat, inline edits, ask और agent modes तथा code completions—से छह मॉडल हटाने की घोषणा की। सितंबर में घोषित deprecation की यह दूसरी लहर है।
| हटाया गया मॉडल | हटाने की तारीख | सुझाया गया विकल्प |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
मॉडलों का डिफ़ॉल्ट activation चालू होने पर Copilot Enterprise और Business ग्राहकों के लिए विकल्प अपने-आप सक्रिय हो जाते हैं, जब तक कि किसी administrator ने वैश्विक डिफ़ॉल्ट मान निष्क्रिय न किया हो या संबंधित मॉडल को स्पष्ट रूप से block न किया हो; ऐसी स्थिति में सेटिंग्स में model policies के माध्यम से पहुँच फिर से खोली जा सकती है। मॉडल हटाने के लिए किसी कार्रवाई की आवश्यकता नहीं है।
🔗 Copilot मॉडलों की deprecation घोषणा
Metrics API CLI के skills, agents, MCP servers और plugins की गणना करता है
17 सितंबर — Copilot का उपयोग metrics API अब CLI के agentic customizations की पाँच श्रेणियों को शामिल करता है: skills, कस्टम agents, MCP servers, slash commands और plugins। totals_by_skill, totals_by_custom_agent, totals_by_mcp, totals_by_slash_cmd और totals_by_plugin तालिकाएँ अपने interaction_count सहित पाँच सबसे सक्रिय तत्वों को सूचीबद्ध करती हैं, जबकि distinct_*_use_count फ़ील्ड इस शीर्ष पाँच से आगे उपयोग किए गए तत्वों की विविधता गिनते हैं।
दो बारीकियाँ गलत निष्कर्षों से बचाती हैं। MCP servers के लिए counter केवल तब बढ़ता है जब CLI connect या reconnect करने का प्रयास करता है—चाहे वह सफल हो या विफल—स्थापित कनेक्शन पर प्रत्येक tool call के समय नहीं। Plugin metrics केवल किसी plugin से जुड़े skills के invocation गिनते हैं: वे skills के कुल आँकड़ों का उपसमुच्चय हैं और उनमें अलग से नहीं जोड़े जाने चाहिए। गोपनीयता के लिए केवल GitHub द्वारा दिए गए नाम दिखाए जाते हैं; ग्राहकों द्वारा परिभाषित नाम other के अंतर्गत समूहित होते हैं।
🔗 Metrics API में CLI के agentic customizations
Terminal में code agents: MiniMax ने अपना agent खोला, Mistral ने अपने harness को स्थिर किया
एक-दूसरे से असंबंधित दो कंपनियों की एक ही दिन, एक ही बाज़ार से जुड़ी दो घोषणाएँ: terminal में रहने वाला coding agent आम होता जा रहा है, और भिन्नता अब license तथा harness की स्थिरता की ओर बढ़ रही है।
MiniMax ने MIT license के अंतर्गत MiniMax Code CLI का code जारी किया
18 सितंबर — MiniMax ने अपने terminal coding agent का source code संस्करण 0.4.12 में जारी किया। टूल mcode नाम से install होता है और तीन प्रवेश बिंदु देता है: एक interactive terminal interface, shell scripts, continuous integration और evaluations के लिए बिना इंटरफ़ेस वाला mode (mcode exec), तथा Agent Client Protocol के अनुकूल editors के लिए ACP mode। यह permissions और sandbox व्यवस्था के अंतर्गत किसी प्रोजेक्ट की फ़ाइलें पढ़ता है, diffs की जाँच करता है तथा shell commands और tests चलाता है।
मॉडल का चुनाव खुला रहता है: एक ओर MiniMax खाता और उसका Token Plan, दूसरी ओर ऐसा third-party provider जो OpenAI या Anthropic के अनुकूल API format प्रदान करता हो। इसके अतिरिक्त integrated search, multimodal tools, MCP protocol, उप-एजेंट और plugin system भी उपलब्ध हैं। प्रथम-पक्षीय code डिफ़ॉल्ट रूप से MIT license के अंतर्गत प्रकाशित है। repository में TUI, बिना इंटरफ़ेस वाली CLI और ACP mode शामिल हैं, लेकिन desktop ऐप नहीं; फिर भी उसकी bug tracking वहीं host की जाती है। फ़िलहाल code proposals केवल repository collaborators से स्वीकार किए जाते हैं।
Vibe CLI का Unified Harness experimental स्थिति से बाहर आया
18 सितंबर — Mistral ने 2.25.4 के छह दिन बाद Vibe CLI 2.25.5 जारी किया। संरचनात्मक बदलाव release notes की एक पंक्ति में है: Unified Harness पर अब « experimental » label नहीं है, और पुराने Python harness पर लौटने के लिए अब --legacy-harness प्रलेखित विकल्प है। shell approvals की सुरक्षा पर केंद्रित सुधारात्मक संस्करणों की शृंखला के बाद नया harness अब स्वीकृत डिफ़ॉल्ट बन गया है—महत्त्वपूर्ण सूचना यही है, संस्करण संख्या नहीं।
इस बदलाव के साथ feature parity की भरपाई भी हुई है: Unified Harness अब मौजूदा Git branch, repository की स्थिति और हाल के commits को सिस्टम निर्देशों में inject करता है; hooks अब चुपचाप अनदेखे होने के बजाय उप-एजेंटों के भीतर भी चलते हैं; और API key environment variable के बिना configured providers—स्थानीय या self-hosted servers—फिर से काम करते हैं। permissions को और सख़्त किया गया है: shell approvals अब किसी दूसरे program या environment तक विस्तृत नहीं होते, MCP tool calls अब permissions system को bypass करने के बजाय उसका पालन करते हैं, और smart approve अब उपयोगकर्ता के नियमों को दरकिनार नहीं करता।
🔗 Vibe CLI 2.25.5 के release notes
ChatGPT plugins अब एक साथ कई खाते स्वीकार करते हैं
18 सितंबर — अधिकांश ChatGPT plugins में अब कई खातों का समर्थन उपलब्ध है। अब अपना व्यक्तिगत खाता, पेशेवर खाता और सहायक प्रोजेक्टों के खाते जोड़ना, फिर सभी का संदर्भ एक ही बातचीत में लाना संभव है। खाते chatgpt.com/plugins पर plugin directory से connect किए जाते हैं।
OpenAI Developers खाते की घोषणा एक घंटे पहले प्रकाशित Max Stoiber के संदेश को दोहराती है। Plugin developers को कुछ नहीं करना है: यह सुविधा बिना किसी बदलाव के अपने-आप सक्रिय हो जाती है। जो इससे आगे जाना चाहते हैं, वे अपने MCP server में profile टूल जोड़ सकते हैं, ताकि ChatGPT जुड़े हुए खातों को label करना जान सके—उनसे अपेक्षित यही एकमात्र ठोस कार्रवाई है। इस घोषणा के साथ कोई blog post या changelog entry नहीं है; इसे पेरिस समयानुसार 18 बजकर 10 मिनट पर प्रकाशित किया गया।
लक्षित उपयोग का मामला ऐसे developer का है जो अपनी पहचानों को employer या project के अनुसार अलग रखता है और जिसे अब तक संदर्भ बदलने के लिए connection बदलना पड़ता था।
Genspark ने Plus और Pro plans में साप्ताहिक credits balance जोड़ा
18 सितंबर — Genspark ने Plus और Pro subscriptions के लाभों में साप्ताहिक credits balance जोड़ा है, plans की कीमत बदले बिना। यह balance पहले से लिए गए plan के अतिरिक्त हर सप्ताह मिलता है और platform के सभी agents तथा tools पर Standard mode के उपयोग को शामिल करता है: Super Agent, AI Chat, AI Image, AI Slides, AI Sheets, AI Docs और Deep Research।
उसी thread का दूसरा संदेश AI Chat और AI Image के लिए इसकी कार्यप्रणाली बताता है। मौजूदा subscribers के लिए यह balance उनकी पहले से उपलब्ध राशि में जुड़ता है और 31 दिसंबर 2026 तक AI Chat और AI Image के सभी models बिना credits की लागत के उपयोग किए जा सकते हैं, जिनमें Opus जैसे प्रमुख models भी शामिल हैं; 18 सितंबर या उसके बाद subscription लेने वालों के लिए AI Chat और AI Image के core models निःशुल्क हैं। Genspark स्पष्ट करता है कि ये बदलाव Team या Enterprise plans पर लागू नहीं होते और शर्तों के विवरण के लिए अपने help center की ओर निर्देशित करता है।
Google Research: AlphaGenome Atlas ने क्या उत्पन्न किया, और स्वयं को परखने वाले simulations
एक ही दिन प्रकाशित दो research publications में एक समानता है: दोनों मामलों में मॉडल नहीं दिखाया गया, बल्कि यह दिखाया गया है कि third parties ने उससे क्या निकाला, या validation loop उसकी जगह क्या सत्यापित करता है।
AlphaGenome Atlas ने अपने partners के शुरुआती परिणाम प्रस्तुत किए
17 सितंबर — मानव DNA में संभव 9 अरब substitutions के predictive map AlphaGenome Atlas के प्रकाशन के नौ दिन बाद, Google DeepMind ने तीन collaborations का विवरण देने वाला एक thread pin किया।
| वैज्ञानिक partner | बताया गया परिणाम |
|---|---|
| Stowers Institute | 2 500 से अधिक regulatory motifs का मानचित्रण |
| University of Exeter / UK Biobank | 54 000 से अधिक participants का विश्लेषण, दुर्लभ genetic signals की पहचान में 22% से अधिक वृद्धि |
| Broad Institute | DNM1 gene का critical mutation पहचाना गया, फिर laboratory में उसकी पुष्टि और validation की गई |
Regulatory motifs वे DNA sequences हैं जो genes की activity पर switches और potentiometers की तरह काम करती हैं। Exeter में किए गए कार्य ने PLA2G7 की प्रचुरता को प्रभावित करने वाले नए variants भी पहचाने; यह metabolic health से जुड़ा protein है। Broad Institute का मामला तीनों में सबसे ठोस है: अनसुलझी दुर्लभ बीमारियों में संभावित mutations की विशाल सूची के सामने Atlas सही mutation को चिन्हित करने में मदद करता है, जिसकी बाद में प्रयोगशाला पुष्टि करती है। हालाँकि, यह सब X के एक thread तक सीमित है; इसके साथ कोई विस्तृत post या publication नहीं है।
🔗 X पर AlphaGenome Atlas thread
तैयार किए गए शैक्षिक सिमुलेशन, फिर Chrome में एक एजेंट द्वारा परीक्षण
17 सितंबर — Gal Elidan और Yael Haramaty ने एक प्रयोग प्रकाशित किया है, जिसमें शैक्षिक सिमुलेशन बनाने के लिए जनरेटिव इंटरफ़ेस (generative UI) का उपयोग किया गया है। पहल शिक्षक के हाथ में रहती है: वह विषय सुझाता है, Google संपादन योग्य शिक्षण उद्देश्यों का एक समूह तैयार करता है जिसे उसकी स्वीकृति के लिए प्रस्तुत किया जाता है और जो निर्माण के आधार का काम करता है। प्रत्येक इंटरैक्टिव सामग्री को बढ़ती कठिनाई वाले स्तरों में बाँटा गया है, जिनके साथ टूलबॉक्स, क्रमिक संकेत और विस्तृत समाधान दिए गए हैं।
सबसे रोचक तत्व स्व-सुधार चक्र है। निर्माण को शिक्षाशास्त्र, कार्यविधि और प्रस्तुति के मानदंडों से नियंत्रित किया जाता है, और कुछ मूल्यांकन एजेंट-आधारित होते हैं: हल-क्षमता परीक्षण Chrome का एक इंस्टेंस खोलता है और सिमुलेशन को उसी तरह संचालित करता है जैसे कोई उपयोगकर्ता करता, साथ ही स्लाइडरों को उनके चरम मानों तक ले जाने जैसी प्रतिकूल कार्रवाइयाँ भी आज़माता है। यह चक्र तब तक दोहराया जाता है जब तक सभी मानदंड पूरे नहीं हो जाते, जिसकी कीमत अधिक निर्माण समय के रूप में चुकानी पड़ती है। Google ने अंग्रेज़ी में 30 से अधिक STEM इंटरैक्टिव सामग्रियाँ प्रकाशित की हैं; 40 सामग्रियों के एक संग्रह का ब्रिटिश शिक्षकों ने मूल्यांकन किया, और 12 अमेरिकी शिक्षकों के साथ किए गए एक अध्ययन में औसत अंक 10 में से 8 रहे।
🔗 शैक्षिक इंटरैक्टिव सामग्रियों पर Google Research का लेख
Claude ने जीवविज्ञान के 30 से अधिक मॉडलों को तेज़ किया और प्रोटीन प्रतियोगिता को वित्तपोषित किया
17 सितंबर — Anthropic ने एक लेख प्रकाशित किया है, जिसमें बताया गया है कि Claude ने जीवविज्ञानियों द्वारा उपयोग किए जाने वाले 30 से अधिक open source मॉडलों—संरचना पूर्वानुमान, प्रोटीन डिज़ाइन, प्रोटीन और जीनोमिक भाषा मॉडल—की inference को चार सप्ताह से कुछ कम समय में अनुकूलित किया, जिससे औसतन लगभग 4x सुधार हुआ। पूरा code open source के रूप में प्रकाशित किया गया है।
तकनीकी केंद्र में त्रिकोणीय attention और त्रिकोणीय multiplication हैं, जिनकी समय और memory दोनों की जटिलता घनीय है। Claude ने FlashPairformer तैयार किया, जो kernels का एक समूह है और attention में क्षेत्र के मानक से 2.7 से 2.9x बेहतर प्रदर्शन करता है। « Big » नामक low-memory मोड की सहायता से एक ही GPU node पर 10,000 से अधिक tokens वाले सिस्टम को सटीकता से fold किया जा सकता है, जबकि AlphaFold3 द्वारा पूर्वानुमानित 40S ribosome में 7,663 tokens थे। कार्य-पद्धति भी उतनी ही महत्वपूर्ण है: इस कार्य की निगरानी तकनीकी स्टाफ के दो ऐसे सदस्यों ने की, जिन्हें inference optimization का कोई पूर्व अनुभव नहीं था।
अंत में, Anthropic और Adaptyv Bio पाँच कठिन समस्याओं पर प्रोटीन डिज़ाइन प्रतियोगिता का सह-प्रायोजन कर रहे हैं, जिसमें समुदाय के 5,000 से अधिक डिज़ाइनों को प्रयोगात्मक रूप से सत्यापित किया जाएगा और Claude credits में 1 मिलियन डॉलर तक तथा Modal द्वारा 250,000 डॉलर की compute क्षमता प्रदान की जाएगी।
खुले मॉडल और प्रयोगशालाएँ: Muse Mac पर आया, Sakana ने अपने अग्रणी समूह का खुलासा किया
Meta ने अपना Muse एजेंट macOS पर उपलब्ध कराया
18 सितंबर — Meta ने Mac पर Muse उपलब्ध कराया, जिसकी घोषणा 17 और 18 सितंबर की मध्यरात्रि में की गई। @AIatMeta खाते ने एक प्रकाशन साझा किया, जिसमें ऐसे व्यक्तिगत एजेंट का वर्णन है जो हर बार उपयोगकर्ता की स्पष्ट अनुमति से सीधे उसके कंप्यूटर पर काम कर सकता है। तीन उपयोग बताए गए हैं: downloads folder व्यवस्थित करना, खोई हुई file ढूँढ़ना, तथा messages और notes का सारांश बनाना।
यह घोषणा 8 सितंबर को Muse के आरंभ का विस्तार है। Muse Spark 1.3 द्वारा संचालित यह एजेंट अब तक iOS, Android, web और WhatsApp पर उपलब्ध था। Mac पर आने से इस प्रकार का उत्पाद एक नया चरण पार करता है: अब एजेंट अपने sandbox में नहीं, बल्कि उपयोगकर्ता की व्यक्तिगत files पर काम करता है। Meta ने न तो मूल्य, न उपलब्धता वाले देशों और न ही आवश्यक configuration की जानकारी दी है, और उपलब्धता के साथ Mac के लिए कोई विशिष्ट security document भी जारी नहीं किया गया है—ai.meta.com blog ने 27 जुलाई के बाद से कुछ प्रकाशित नहीं किया है।
Sakana AI ने Frontier Intelligence Group और प्रतिमान पर अपनी स्थिति का खुलासा किया
18 सितंबर — Sakana AI ने Frontier Intelligence Group (FIG) के अस्तित्व की घोषणा की है, जो एक आंतरिक समूह है और कंपनी के आरंभिक दिनों से बढ़ता आ रहा है। इसका प्रारंभिक बिंदु Sakana AI के तकनीकी निदेशक और Transformer के आविष्कारकों में से एक Llion Jones द्वारा पूछा गया प्रश्न है: क्या लगातार अधिक data और compute के साथ Transformer architecture का आकार बढ़ाते रहना AGI तक पहुँचने के लिए पर्याप्त है? प्रयोगशाला का उत्तर है—नहीं।
वास्तविक जानकारी साथ दिए गए कार्यों की सूची से अधिक इसी बात में निहित है। लेख उन कमियों को सूचीबद्ध करता है जिन्हें वर्तमान प्रतिमान हल नहीं कर पाया है—ऐसे मॉडल जो पूरे विश्वास के साथ गलत जानकारी देते हैं, वास्तव में नई परिस्थितियों के सामने विफल हो जाते हैं और बहुत अधिक ऊर्जा का उपभोग करते हैं—और इनके मुकाबले जैविक बुद्धिमत्ता को रखता है, जो लगातार सीखती है और बहुत कम data से सामान्यीकरण करती है। समूह ने अपने लिए पाँच सिद्धांत निर्धारित किए हैं, जिनमें benchmark scores के दबाव के बिना असफल होने की स्वतंत्रता भी शामिल है। प्रस्तुत कार्यों में NVIDIA के साथ विकसित sparse Transformer एक मापे गए निष्कर्ष से शुरू होते हैं—किसी शब्द को संसाधित करते समय feed-forward layer के 95% से अधिक neurons निष्क्रिय रहते हैं—और इनके परिणामस्वरूप TwELL नामक data format तैयार हुआ, जिसे ICML 2026 में स्वीकार किया गया है।
🔗 Frontier Intelligence Group पर Sakana AI का लेख
जनरेटिव वीडियो: Runway ने अपने credits के बीच की सीमाएँ हटाईं, Pika ने अपना पहला application जारी किया
Runway ने अपने credits को web application और Runway Dev के बीच परस्पर उपयोग योग्य बनाया
18 सितंबर — Runway ने अपने दो उत्पादों के बीच की सीमा हटा दी है: खरीदे गए credits अब web application और developers के लिए बनी पेशकश Runway Dev, दोनों में समान रूप से उपयोग किए जा सकते हैं। अब तक दोनों अलग-अलग भंडारों और अलग-अलग contracts पर चलते थे, और एक project से दूसरे project तक खपत पर नज़र रखने के लिए कोई एकल स्थान नहीं था।
इस बदलाव के साथ चार बातें जुड़ी हैं: एक ही invoice पर केंद्रीय रूप से खरीदा गया साझा भंडार, web application में workflow बनाने से लेकर उसे API के रूप में उपलब्ध कराने तक एक निर्बाध मार्ग, Applied AI Architects तक पहुँच के साथ Runway Dev के लिए बेहतर support, और नए सिरे से तैयार किया गया workspace analytics view, जिसकी सहायता से administrators web और Dev spaces के बीच credits स्थानांतरित कर सकते हैं। 31 दिसंबर 2026 तक दो व्यावसायिक प्रस्ताव मान्य हैं: नई कंपनियों को अनुबंध करते समय 10% अतिरिक्त credits, जो Runway द्वारा घोषित रूपांतरण के अनुसार कम-से-कम 130 मिनट के वीडियो या 12,000 images के बराबर हैं; और मौजूदा ग्राहकों को AI applications के product manager से परिचय कराने के बदले 5,000 credits तथा Applied AI Architect के साथ एक दिन।
🔗 एकीकृत pricing पर Runway का लेख
Pika ने Product Ad पेश किया, उत्पाद की तस्वीर से वीडियो विज्ञापन तक
18 सितंबर — अपने नए creative platform के अनावरण के अगले दिन Pika ने उसका पहला application प्रस्तुत किया: Product Ad। यह application उत्पाद की एक या अधिक images को लिखित brief के साथ मिलाता है और उनसे ऐसा वीडियो तैयार करता है जिसे बाज़ार के लिए तैयार बताया गया है।
| निर्माण पैरामीटर | प्रस्तावित मान |
|---|---|
| उपलब्ध अवधियाँ | 6 s, 15 s, 30 s, 60 s, 2 min |
| output format | 16:9 |
| अपेक्षित input | उत्पाद की images और लिखित brief |
| पहुँच | account बनाना आवश्यक |
Pika ने platform के पुनर्निर्माण पर एक दिन पहले जारी अपने ही संदेश का उल्लेख करते हुए घोषणा प्रकाशित की है, जिससे Product Ad किसी अलग-थलग feature के बजाय अपेक्षित applications की एक श्रृंखला का हिस्सा बनता है। किसी मॉडल का नाम नहीं दिया गया है और कोई मूल्य घोषित नहीं किया गया है।
NVIDIA ने बड़े पैमाने पर inference मापने के लिए GenAI-Perf का उत्तराधिकारी AIPerf जारी किया
18 सितंबर — NVIDIA ने जनरेटिव inference के performance को मापने वाला अपना उपकरण AIPerf प्रस्तुत किया है, जिसे GenAI-Perf का उत्तराधिकारी बताया गया है और पूरी तरह नए सिरे से लिखा गया है। प्रारंभिक समस्या जानी-पहचानी है: किसी मॉडल को deploy करने के बाद, « क्या यह तेज़ है? » प्रश्न का उत्तर अक्सर curl commands या तुरंत बनाए गए load generator से खोजा जाता है, जिनसे ऐसे आँकड़े मिलते हैं जिन पर भरोसा नहीं किया जा सकता।
वास्तविक बदलाव architecture में है। जहाँ अधिकांश उपकरण एक ही process में चलते हैं और concurrency बढ़ते ही Python interpreter के global lock से टकराते हैं, वहीं AIPerf कार्य को बाँट देता है: worker processes load उत्पन्न करते हैं, अलग-अलग services परिणामों को संसाधित करती हैं और पूरा तंत्र ZMQ के माध्यम से समन्वित होता है। लक्ष्य स्पष्ट है—मापन करने वाला client स्वयं कभी bottleneck न बने।
| रिपोर्ट किया गया संकेतक | यह क्या मापता है |
|---|---|
| Time to First Token | request भेजने और पहला token मिलने के बीच का विलंब |
| Inter-Token Latency | निर्माण के दौरान लगातार दो tokens के बीच का विलंब |
| request latency | पूरी response का end-to-end समय |
| output token throughput | सभी requests में प्रति सेकंड बने tokens |
| रिपोर्ट किए गए percentiles | p25, p50, p75, p90, p95, p99 |
| endpoint के प्रकार | 15 से अधिक |
यह उपकरण Mooncake, Baseten और WEKA formats में वास्तविक traffic traces को दोबारा चला सकता है। लेख विशेष रूप से distributions की उपयोगिता पर ज़ोर देता है: ऐसा server, जिसका पहले token तक का औसत समय ठीक दिखता है लेकिन जिसका p99 बहुत बढ़ जाता है, समेकित आँकड़ों में पकड़ में नहीं आता और production में विफल हो जाता है।
Mistral ने अपने systems तक अनधिकृत पहुँच के दावे का खंडन किया
18 सितंबर — Mistral ने अपने X खाते पर 05:48 UTC बजे एक संक्षिप्त बयान प्रकाशित किया, जो उसके systems तक अनधिकृत पहुँच के दावे के उत्तर में था। कंपनी ने बताया कि उसने गहन जाँच की, उसे इस दावे की पुष्टि करने वाला कोई प्रमाण नहीं मिला, और उसने पुष्टि की कि उसके systems से समझौता नहीं हुआ है।
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇮🇳 हमें अपने systems तक अनधिकृत पहुँच के एक आरोप की जानकारी है। गहन जाँच के बाद हमें इस आरोप की पुष्टि करने वाला कोई प्रमाण नहीं मिला और हम पुष्टि कर सकते हैं कि हमारे systems से समझौता नहीं हुआ है। — X पर @MistralAI
संदेश में दावा करने वाले का नाम नहीं बताया गया, न उसकी तारीख या प्रकृति स्पष्ट की गई और न जाँच के दायरे के बारे में कोई विवरण दिया गया। यहाँ केवल Mistral का पक्ष बताया गया है: मूल आरोप को देखा नहीं जा सका। यह बयान उस अवधि में खाते का सबसे अधिक देखा गया संदेश है, और कंपनी की website पर कोई पूरक प्रकाशन नहीं मिला।
संक्षिप्त समाचार
- Balyasny Asset Management बताता है कि वह Claude Fable 5 के लिए कैसे रूपरेखा तय करता है — लगभग 38 अरब डॉलर का प्रबंधन करने वाली यह कंपनी विलय मध्यस्थता के शुरुआती विश्लेषण को तीन से पाँच दिनों से घटाकर एक दिन से भी कम कर देती है; इसमें एक agent लगभग 30 मिनट चलता है और फिर मानवीय समीक्षा होती है। 🔗 स्रोत
- Codex CLI 0.155.1 ने reasoning summaries को डिफ़ॉल्ट रूप से फिर निष्क्रिय किया — 0.155.0 के अगले ही दिन आया एकमात्र सुधार: इन्हें स्वतः सक्रिय करने पर वे प्रदाता अनुरोध अस्वीकार कर रहे थे जो इनका समर्थन नहीं करते। 🔗 स्रोत
- Gemini CLI ने एक दिन के अंतराल के बाद अपनी nightly शृंखला फिर शुरू की — 18 सितंबर को चार बदलाव हुए, जिनमें नवीनीकरण के दौरान OAuth refresh token को बनाए रखना और पहचान-संबंधी डेटा हटाने की प्रक्रिया को idempotent बनाना शामिल है; stable और preview चैनल अपरिवर्तित हैं। 🔗 स्रोत
- Kimi Code 2.0.1 ने शुरुआत और session फिर शुरू करने की गति बढ़ाई — 2.0.0 के 32 घंटे बाद आया सुधार संस्करण: session index का compaction, लंबे इतिहास वाले sessions को तेज़ी से फिर शुरू करना, नामित environment variable से API key पढ़ना और सीमित file watchers। 🔗 स्रोत
- Qwen Code, Playwright browser SDK के साथ v0.24.1 preview में पहुँचा — यह stable संस्करण नहीं है; इसमें Chrome native messaging relay के साथ एकीकृत browser नियंत्रण और containers में sub-agents का निष्पादन पेश किया गया है। 🔗 स्रोत
- Zed ने stable संस्करण 1.20.2 जारी किया, जिसमें केवल दो सुधार हैं — तीसरे पक्ष के model providers की भुगतान त्रुटियाँ अब मूल संदेश के स्थान पर Zed Pro में upgrade करने का निमंत्रण नहीं दिखातीं, और एक ही भाषा के दो snippets extensions अब एक-दूसरे को निष्क्रिय नहीं करते। 🔗 स्रोत
- Replit का दावा है कि Free Mode «30 गुना अधिक» उदार है, लेकिन कोई प्रकाशित संदर्भ नहीं है — केवल एक tweet है, बिना link या changelog के, जिसमें यह स्पष्ट नहीं किया गया कि इस गुणक की तुलना किससे है: इसे Replit का दावा समझा जाना चाहिए, माप नहीं। 🔗 स्रोत
- Copilot impact dashboard ने सहभागिता को functionality के अनुसार विभाजित किया — 28 दिनों में सात surfaces, active और passive code review के बीच अंतर के साथ; adoption phase की आबादी अब rolling window में गणना की जाती है। 🔗 स्रोत
- GitHub ने छह भाषाओं में Copilot SDK का परिचयात्मक live session निर्धारित किया — sessions, tools, MCP servers और streaming events, साथ ही .NET और Java के लिए समर्पित sessions; किसी पूर्वापेक्षा की आवश्यकता नहीं। 🔗 स्रोत
- Runway Ruby, HDR में रूपांतरण के दौरान alpha channel को सुरक्षित रखता है — किसी footage को HDR में बदलते समय transparency एक ही चरण में अक्षुण्ण रहती है; न मूल्य बताया गया है, न subscription tier। 🔗 स्रोत
- MiniMax, Singapore के SkillsFuture कार्यक्रम के लिए Singtel AI Pass में शामिल हुआ — MiniMax H3, MiniMax Agent और MiniMax Audio इस पेशकश में शामिल हुए हैं, जो SWDA द्वारा समर्थित 200 से अधिक AI courses के पात्र शिक्षार्थियों के लिए है; किसी राशि या समय-सारणी का उल्लेख नहीं है। 🔗 स्रोत
- VC-Attention ने पुनः प्रशिक्षण के बिना MiniMax-H3 के attention को तेज़ किया — MiniMax ने Nunchux AI के ऐसे low-precision attention संबंधी कार्य को साझा किया है जिसे मौजूदा model पर लागू किया जा सकता है; Nunchux AI ने FlashAttention-4 की तुलना में B200 पर 1.6x और B300 पर 1.5x गति का दावा किया है। 🔗 स्रोत
- Wan3.0, OpenArt Arena की video श्रेणी में दूसरे स्थान पर रहा — Alibaba ने 30-second shots, native audio और किसी भी reference के समर्थन को प्रमुखता दी है; यह किसी तीसरे पक्ष की ranking में स्थिति है, कोई नया product नहीं। 🔗 स्रोत
- Synthesia ने New York में अपना अमेरिकी मुख्यालय खोला — यह कंपनी से जुड़ी खबर है, जिसमें न product, न कर्मचारियों की संख्या और न निवेश की समय-सारणी दी गई है; यह उसके Interactive Avatar API की सामान्य उपलब्धता के दो दिन बाद आई है। 🔗 स्रोत
- Grok Imagine ने पूरी तरह AI से बने pilot की लागत का विवरण दिया — PJaccetturo के studio ने Odyssée प्रतियोगिता के अपने pilot episode के लिए नौ दिनों के काम, 3,627 उत्पन्न images, 3,043 उत्पन्न videos और generation पर 2,677 डॉलर खर्च होने की घोषणा की। 🔗 स्रोत
- BananaMind 2 Pro, बीस गुना कम tokens के साथ SmolLM2 के करीब पहुँचा — 100 अरब tokens और एक RTX 5070 Ti पर प्रशिक्षित 13.9 करोड़ parameters वाला model, HellaSwag पर 42.78% हासिल करता है, जबकि 2,000 अरब tokens पर प्रशिक्षित SmolLM2-135M का परिणाम 43.22 है। 🔗 स्रोत
- Optimum-Intel v2.2.0 और OpenVINO GenAI 2026.4.0 ने Intel hardware के लिए export का विस्तार किया — Hugging Face और Intel ने संयुक्त संस्करण जारी किए हैं, जो Intel processors, graphics cards और NPU को समेटते हैं; अब Mistral 3 को भी export किया जा सकता है। 🔗 स्रोत
- AmberTrace Labs ने सत्यापन योग्य reward वाले RL के अंतर्गत Olmo 3 की reasoning fidelity मापी — प्रशिक्षण से अलग रखे गए probes पर fidelity 0.238 से बढ़कर 0.262 हो गई: यह गिरावट नहीं, बल्कि सकारात्मक बदलाव है; checkpoints प्रकाशित किए गए हैं। 🔗 स्रोत
- Together AI ने DeepSeek V4.1 Flash पर सबसे कम time to first token का दावा किया — कंपनी ने पहले से गर्म किए गए requests के लिए किसी तीसरे पक्ष का माप साझा किया है, लेकिन न विधि प्रकाशित की है, न मान: यह दावा है, सत्यापन योग्य परिणाम नहीं। 🔗 स्रोत
- Google Flow ने New York Fashion Week में दो creators का साथ दिया — Jane Wade और Sergio Hudson के साथ तैयार किए गए custom tools; यह उपयोग का प्रदर्शन है, कोई नया model या परिनियोजित functionality नहीं। 🔗 स्रोत
- Google AI Educator Series से विश्वविद्यालय credits प्राप्त किए जा सकते हैं — इस प्रशिक्षण के courses अब विश्वविद्यालय या continuing education credits के लिए पात्र हैं। 🔗 स्रोत
इसका क्या अर्थ है
यह दिन सबसे बढ़कर एक बात बताता है: code agents बंद products होना छोड़कर अपने formats साझा करने लगे हैं। जब किसी project में CLAUDE.md नहीं होता, तब Claude Code AGENTS.md पढ़ता है — यानी Anthropic कहीं और परिभाषित instructions file को स्वीकार करता है, ताकि एक ही repository कई tools के काम आ सके। उसी दिन Antigravity अपने Markdown agents के system prompt में उपलब्ध sub-agents की सूची डालता है, Vibe CLI अंततः hooks को sub-agents के भीतर चलाता है, Codex अपने bill को sub-agent के अनुसार विभाजित करता है और Qwen Code अपने sub-agents को container में रखता है। agents के बीच delegation एक configuration promise था; अब यह ऐसी कार्यप्रणाली बन रही है जिसे दस्तावेज़ित करना, अलग रखना और bill करना आवश्यक है। Claude Code अविश्वास के इस तर्क को अंत तक ले जाते हुए sub-agents के results पर एक dedicated header भी लगाता है, ताकि ऊपर भेजा गया कोई text स्वयं को instruction के रूप में प्रस्तुत न कर सके।
वहीं terminal agents का बाज़ार देखते-देखते सामान्य होता जा रहा है। MiniMax ने MIT license के तहत अपना agent जारी किया है, जिसमें TUI, headless mode, ACP और model चुनने की स्वतंत्रता है; Mistral ने अपने Unified Harness से «प्रयोगात्मक» label हटा दिया है और --legacy-harness को निकास-द्वार के रूप में दस्तावेज़ित किया है; Kimi Code ने अपने major version के 32 घंटे बाद performance सुधार जारी किया। जब चार vendors समान entry points वाला एक ही प्रकार का product प्रस्तुत करते हैं, तो differentiation दूसरी जगह पहुँच जाता है: वह license, harness की stability और permissions व्यवस्था पर निर्भर करता है — और आज के बदलाव ठीक इन्हीं क्षेत्रों में हैं, चाहे Mistral हो या Anthropic।
models के क्षेत्र में बदलाव audio-video के वर्णनात्मक के बजाय agentic बनने का है। Qwen3.8-Omni-Flash अब किसी video का वर्णन करने के बजाय उसमें उत्तर खोजता है: question से शुरुआत करके वह OmniVideoBench पर 4.4 points बढ़ाता है और साथ ही 45.7% कम tokens खर्च करता है — performance और बचत का एक ही दिशा में जाना दुर्लभ है। दूसरी ओर, Grok Voice Transcribe 2.0 laboratory demonstration के बजाय वास्तविक traffic पर ध्यान देता है, जहाँ short sentences पर error rate 20.6% से घटकर 6.8% हो गया है और कीमत अपरिवर्तित है। दोनों घोषणाएँ एक ही निष्कर्ष पर पहुँचती हैं: value अब supported modality से नहीं, बल्कि इस बात से आती है कि model किसे process करने का निर्णय लेता है।
फिर प्रश्न यह रह जाता है कि laboratories किन चीज़ों का verification स्वीकार करती हैं। Anthropic अपनी ही कंपनी के भीतर evaluators तैनात करने के लिए Accenture को भुगतान कर रहा है और उन्हें employee access दे रहा है — साथ ही उसी घोषणा में यह स्वीकार करता है कि अभी इस बात का कोई standard नहीं है कि ऐसे evaluator को किस तक पहुँच मिलनी चाहिए, उसके findings कैसे प्रकाशित किए जाने चाहिए या उसका वित्तपोषण किसे करना चाहिए। यह व्यवस्था जितनी है, उतनी ही स्वीकारोक्ति भी। इसके बरक्स, दिन के सबसे ठोस प्रमाण वे हैं जिन्हें कोई तीसरा पक्ष दोहरा सकता है: AlphaGenome Atlas पर Exeter और Stowers Institute के results, open source में प्रकाशित biomolecular optimization code और AmberTrace Labs के checkpoints। इसका उलटा भी उतना ही स्पष्ट है: Replit बिना संदर्भ के 30 गुना का दावा करता है, Together AI बिना विधि के ranking साझा करता है और Mistral ऐसे आरोप का खंडन करता है जिसे कोई पढ़ भी नहीं सका। इस परिदृश्य में AIPerf सही समय पर आया है — ऐसा measurement tool, जो शुरुआत ही इस स्वीकारोक्ति से करता है कि अक्सर समस्या मापने वाला होता है।
स्रोत
- Claude Code, संस्करण 2.1.277 के release notes
- Claude Code CHANGELOG
- Qwen, Qwen3.8-Omni-Flash पर लेख
- X पर Alibaba Qwen, model की घोषणा
- Codex CLI, संस्करण 0.155.0 के release notes
- X पर OpenAI Developers, Codex में विस्तृत consumption
- SpaceXAI, Grok Voice Transcribe 2.0
- Anthropic, Accenture के साथ embedded evaluation
- Antigravity changelog
- GitHub, 14 सितंबर का साप्ताहिक Copilot सारांश
- GitHub, छह Copilot models का deprecation
- GitHub, metrics API में CLI की agentic customizations
- X पर MiniMax, MiniMax Code CLI के code को खोलना
- Vibe CLI, संस्करण 2.25.5 के release notes
- X पर OpenAI Developers, multi-account plugins
- X पर Max Stoiber, multiple accounts पर मूल संदेश
- X पर Genspark, Plus और Pro का साप्ताहिक balance
- X पर Google DeepMind, AlphaGenome Atlas partners के results
- Google Research, generative interface के माध्यम से शैक्षणिक interactives
- Anthropic Research, Claude और biomolecular modeling
- X पर Meta AI, Mac के लिए Muse
- Sakana AI, Frontier Intelligence Group
- Runway, unified pricing
- X पर Pika, Product Ad का launch
- NVIDIA, AIPerf के साथ बड़े पैमाने पर inference का measurement
- X पर Mistral AI, 18 सितंबर का खंडन