ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
På lördagen och söndagen var laboratorierna tysta: varken DeepSeek, Meta, Ai2, Sakana, Mistral eller xAI publicerade något, och de officiella kontona inom området för öppna modeller förblev tomma i två dagar. Bara ett verkligt släpp: Qwen-Image-2.1, som publicerades med öppna vikter mitt på söndagseftermiddagen. Det mesta av resten utgörs av fem inlägg på Hugging Faces communityblogg, en version av Antigravity som inte rättar något och två poster i GitHubs ändringslogg från den 18 september — en lugn dag som det inte finns någon anledning att blåsa upp.
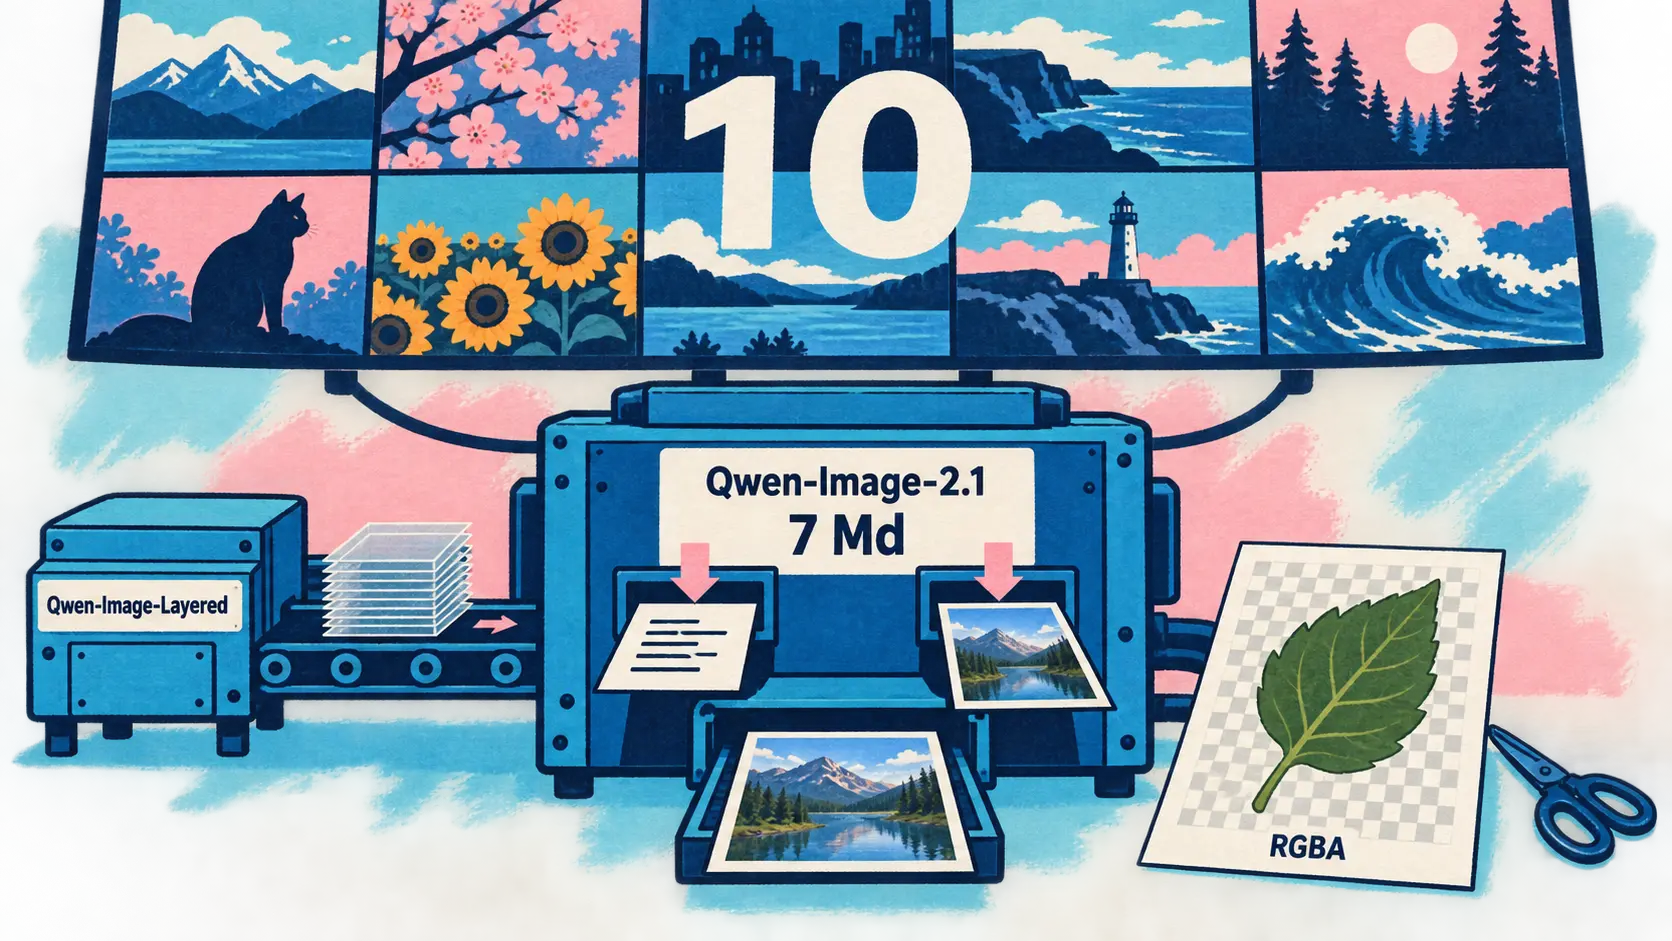
Qwen-Image-2.1, en enda modell för att generera, redigera och leverera transparens
20 september — Qwen har publicerat Qwen-Image-2.1, sin modell för bildgenerering och bildredigering, med öppna vikter på Hugging Face, ModelScope och GitHub. Poängen är inte storleken utan föreningen: en och samma uppsättning vikter omfattar både skapande utifrån en textinstruktion och retuschering av befintliga bilder, där dessa två användningsområden tidigare krävde två modeller.
Den mest konkreta nyheten är inbyggd transparens: modellen producerar och ändrar RGBA-lager direkt, och instruktionen avgör om resultatet ska ha en transparenskanal. Qwen har erbjudit denna funktion sedan december 2025 genom en särskild modell, Qwen-Image-Layered, som nu har införlivats. Ett friläggningssteg försvinner: ett motiv kan extraheras ur ett fotografi som ett återanvändbart lager, eller texten i ett transparent lager kan ersättas.
För redigering tar modellen emot upp till 10 referensbilder för samma komposition, och området som ska retuscheras kan markeras med en färgad cirkel, en målad anteckning eller en separat mask — det tredje alternativet finns eftersom de två första täcker över originalinnehållet. Effektiviteten bygger på uppmärksamhet med blandad granularitet, där redigeringsindatan bildar en statisk kontext som cachelagras redan i det första steget.
| Teknisk komponent | Angivet värde |
|---|---|
| Parametrar för visuell generering | 7 miljarder, över 32 lager Single-Stream DiT |
| Godkända referensbilder | Högst 10 |
| Transparens i resultat | Inbyggda RGBA-lager, både vid generering och redigering |
| Införlivad specialmodell | Qwen-Image-Layered, publicerad i december 2025 |
| Stöd från första dagen | vLLM-Omni och ComfyUI |
Qwen publicerar en jämförelse på Qwen-Image-Bench, men värdena finns bara i en bild i inlägget och återges därför inte här.
Generate, edit, and create transparent images with one model: a 7.1B DiT paired with Qwen3-VL-8B.
🇸🇪 Generera, redigera och skapa transparenta bilder med en enda modell: en DiT med 7,1 miljarder parametrar i kombination med Qwen3-VL-8B. — @vllm_project på X
Qwen Code v0.24.2, fullständig röstfunktion i Web Shell och en utbyggd bwrap-sandlåda
Samma utgivare, samma dag, orelaterad produkt. 20 september — v0.24.2 av Qwens kommandoradsagent för kod publicerades drygt tjugofyra timmar efter v0.24.1 och är den första i serien utan någon brytande ändring, medan de två föregående hade varsin.
Bubblewrap-sandlådan får en fullständig grund för exekvering: strukturerad processstart, övervakning och isolerade workers. På samma område kräver en arbetsyta vars förtroendestatus inte har avgjorts numera ett uttryckligt beslut. I Web Shell blir funktionen Live Voice faktiskt användbar: modell och röst väljs på konfigurationskortet, och mikrofonnivån visas under samtalet. För den som kör flera parallella sessioner utvärderas varje inkommande meddelande nu för den session som det är adresserat till, och prompt-cachen bevaras för uppskjutna verktyg.
Verifiera ett svar utan att skriva en token och en rankning där författaren är part i målet
20 september — Två inlägg, samma dag, om samma uppsättning med 2 018 poster. Det första presenterar Zero-Token Confidence: en sond läser modellens sista dolda tillstånd i en enda framåtpassering och härleder en kalibrerad sannolikhet utan att generera en token. Att fråga modellen om den är säker ger 0,5000 i area under kurvan, alltså slumpnivå; att läsa dess interna tillstånd ger 0,8801 på 0,0615 sekunder, jämfört med 1,631 för att generera ett svar. Det andra testar tretton verifierare: bara tre passerar 0,70, och ZTC ligger 0,0014 före JEV, en skillnad som inte går att skilja statistiskt.
Det mest robusta resultatet finns någon annanstans: en referensmetod som bara tittar på svarets längd och formatering, aldrig dess innehåll, når 0,7036 och slår åtta av de tretton systemen. En reservation: rankningens författare är inte en neutral tredje part — han uppger att han även mäter sitt eget system, utan att säga vilket av de tretton det är, och båda inläggen publicerades samma dag. Siffrorna kan vara korrekta, men rankningens oberoende är inte fastställt.
En LoRA för 54 dollar som både rättar och förstör
20 september — ScalablyAI tränade två LoRA-adaptrar för 53,88 dollar på Qwen3.8-27B utifrån de 143 145 verktygsanvändningsblock som lämnats av företagets agentplattform och utvärderade dem sedan mot en testsvit som frysts före det första träningssteget.
Resultatet är tudelat. För 73 återhämtningslägen efter ett avvisat verktygsanrop går adaptern från 31 till 38 lyckade fall, där sju fall vänder till dess fördel och inget åt motsatt håll. Men för 73 beslut om korrekta förlopp sjunker den från 49 till 45, fem och en halv poäng mot en gräns som satts till två. Eftersom avlastningen av en adapter sker atomärt krävde ett undvikande av försämringen att även vinsten övergavs: båda avvisades. Därav den valda arkitekturen — 433 redigerbara minnesregler på ena sidan och orörda vikter på den andra.
If every useful experience immediately changes the weights, learning and corruption can become the same operation, and at production sample sizes you cannot tell which one you performed.
🇸🇪 Om varje användbar erfarenhet omedelbart ändrar vikterna kan inlärning och korrumpering bli samma operation, och med den mängd data som finns i produktion kan du inte veta vilken av dem du just har utfört. — pavle-scalably på Hugging Faces blogg
🔗 Fullständig rapport och evidensregister
SeamFlow placerar UV-sömmarna där en konstnär skulle ha lagt dem
20 september — Att vika ut en 3D-yta i 2D kräver att den skärs upp; en bra uppdelning placerar sömmarna där de syns minst. SeamFlow, som presenteras av Meshy AI tillsammans med City University of Hong Kong, Bambu Lab och Nanyang Technological University, ändrar representationen före modellen: varje kant i meshen blir en token, och den binära etiketten mjukas upp till ett kontinuerligt värde, vilket gör flödesmatchning (flow matching) tillämpbar.
Fördelarna är strukturella: inget projektionssteg och ingen godtycklig ordning på tokens, samtidigt som varje förutsagt snitt hamnar på en befintlig kant. Modellen har tränats på 350 000 Objaverse-meshar med sömmar skapade av yrkesverksamma och placerar sina snitt i vecken: den genomsnittliga dihedralvinkeln längs sömmarna når 67,59 grader, jämfört med 56,65 för xatlas och 55,97 för PartUV. Den vecklar ut på 5,63 sekunder, jämfört med 11,46 för en autoregressiv referensmetod, och väljs som förstahandsalternativ i 61,0 % av fallen, mot 19,1 % för det näst bästa alternativet.
🔗 SeamFlow
Antigravity 2.15.1 öppnar sandlådan på Windows utan att aktivera den
19 september — Version 2.15.1 av Antigravity ryms på en rad: sandlådeisolering av filer och nätverk kommer till Windows. En enda förbättring, inga rättningar, medan föregående dags 2.15.0 staplade sju respektive sexton — ett riktat tillägg, inte en underhållsversion.
Skillnaden mot resten av produktfamiljen är den egentliga frågan. På Linux bygger sandlådan på kärnans namespaces; på macOS på Seatbelt-profiler från sandbox-exec; i båda fallen är den aktiv som standard. På Windows är den använda primitivtypen inte dokumenterad, aktiveringen måste göras manuellt via kryssrutan ”Aktivera sandlådeläge (förhandsversion)”, och ingen av de tre säkerhetsförinställningarna — Default, Full machine, Turbo mode — aktiverar den: när rutan markeras ändras förinställningen till Custom. Google utlovar likvärdighet i en senare version, utan någon tidsplan.
Kortfattat
- Fem annoterare, samma instruktion, fem olika svar — för 100 turkiska scener och en mänsklig referens med 9 positiva fall ger fem maskinannoterare mellan 0 och 78 positiva fall, medan samtliga Cohens kappa-värden ligger mellan 0,000 och 0,185 trots en rå överensstämmelse på 74,7 till 86,3 %. Författaren, som uppger sig vara skaparen av det utvärderade schemat, påminner om att en konstruktör inte är en neutral domare över sitt schemas överförbarhet. 🔗 källa
- Gemini CLI:s nightly-version den 20 september innehåller inga ändringar — taggen
v0.62.0-nightly.20260920.gcfbcaa8dfpekar på samma commit som föregående dag, med samma hash-suffix, och versionssidan visar inget avsnitt med ”What’s Changed”. Kanalerna stable (v0.60.0) och preview (v0.61.0-preview.0) är också oförändrade. 🔗 källa - Eyeball, Copilot CLI-pluginen som skrivits av en jurist på GitHub, är open source — verktyget bäddar in skärmbilder av källdokumentet vid den analyserade klausulen, så att analysen och dess belägg kan läsas sida vid sida. Repositoriet
dvelton/eyeballär offentligt under MIT-licensen, skrivet i Python, har 35 stjärnor och har inte haft någon commit sedan den 5 april 2026. 🔗 källa - npm-tokens som enbart får lägga versioner i vänteläge, sedan den 18 september — behörigheten ”Read and write (stage only)” låter en CI-kedja lägga in en version via
npm stage publishutan att kunna publicera den; publicering kräver 2FA-godkännande från en ansvarig utvecklare. Blockeringen tillämpas på registersidan, även för en token som konfigurerats för att kringgå 2FA; npm tar bort denna direkta publiceringsmöjlighet i januari 2027. 🔗 källa - Regeln för kodtäckning kan även styras via REST API sedan den 18 september — regeluppsättningsalternativet ”Restrict code coverage”, som kräver en lägsta tröskel eller begränsar den tillåtna minskningen i en pull request, blir allmänt tillgängligt i API:t och därmed i infrastructure as code. Endast för GitHub Enterprise Cloud och GitHub Team, inte GitHub Enterprise Server. 🔗 källa
- Wan lyfter fram sin funktion Peel-Off Sticker — Alibaba Wans konto visar en komponent i wan.video som bäddar in ett personligt fotografi i en scen och animerar det med Wan 3.0. Det är ingen lansering: meddelandet innehåller varken öppningsdatum, pris eller kvalitetsmått. 🔗 källa
- Cohere publicerar fyra fotografier från konferensen ALL IN i Montréal — meddelandet från den 19 september uppmärksammar Aston Martin F1:s och Magnus Carlsens närvaro tillsammans med företaget. Inget produktmeddelande, ingen siffra, ingen länk. 🔗 källa
Vad det innebär
Helgens enda modellsläpp är öppet och konsoliderar i stället för att lägga till. Qwen-Image-2.1 placeras inte bredvid Qwen-Image-Layered som ännu en modell: den införlivar den och låter en nio månader gammal specialmodell försvinna genom att integrera transparens i huvudmodellen. Samma utveckling sker mellan generering och redigering, som förenas i en enda uppsättning vikter. För den som producerar visuellt material innebär det en kortare kedja — en modell att läsa in, ett direkt användbart RGBA-lager, inget friläggningssteg — och ekosystemet följde efter samma dag, med fungerande vLLM-Omni och ComfyUI redan vid publiceringen.
Tre söndagsinlägg behandlar samma problem ur tre perspektiv: om det går att lita på det en modell producerar och till vilket pris. Zero-Token Confidence svarar med kostnaden — 0,0615 sekunder jämfört med 1,631, eftersom en verifierare som genererar tokens konkurrerar med agenten om samma budget. Rankningen av de tretton verifierarna svarar med mätningen, och dess lärdom är obehaglig för branschen: en referensmetod som bara läser svarets längd och formatering slår åtta av tretton. Ribban för att bevisa att en verifierare faktiskt läser innehållet ligger alltså högre än vad de flesta uppvisar — och det faktum att författaren medger att han också mäter sitt eget system talar för att invänta en oberoende upprepning.
ScalablyAI:s rapport tillför den dimension som saknas i de båda andra: reversibilitet. En viktuppdatering för 54 dollar gav i samma artefakt en uppmätt förbättring av återhämtningen efter fel och en möjlig försämring av korrekta beslut, med ett underlag där produktionen inte kan skilja dem åt. Eftersom man inte kan avlasta halva adaptern fick allt kasseras. Den praktiska slutsatsen — billig kunskap som är lätt att återställa hör hemma i textfiler, och vikterna ändras bara bakom en fryst testsvit — är en användbar motvikt till talet om AI som förbättrar sig själv.
På verktygssidan blir isolering genom operativsystemet en grundval snarare än ett alternativ. Qwen Code gör bubblewrap till en intern exekveringsgrund, Antigravity för sin sandlåda till Windows och npm inför en token som kan förbereda en version utan att kunna publicera den: tre utgivare som på tre dagar flyttar säkerheten från retorik till standardvärde. Med en reservation för Windows-fallet: en sandlåda som måste aktiveras manuellt och som ingen av de tre föreslagna förinställningarna slår på är ännu inget standardskydd, och skillnaden mot macOS och Linux kvarstår helt tills Google presenterar en tidsplan.
Källor
- Alibaba Qwen på X, tillkännagivandet av Qwen-Image-2.1
- Qwen, inlägg om Qwen-Image-2.1
- Qwen-Image-2.1 på Hugging Face
- vLLM på X, stöd från första dagen
- Qwen Code, versionsinformation för v0.24.2
- Zero-Token Confidence
- Tretton svarsverifierare på en enda testuppsättning
- ScalablyAI, snabbt minne och långsamma vikter
- ScalablyAI, evidensregister
- SeamFlow, UV-utveckling genom flödesmatchning
- SeamFlow, projektsida
- Antigravity, ändringslogg
- Antigravity, dokumentation för sandlådan
- Överensstämmelse mellan fem LLM-annoterare
- Gemini CLI, nightly-versionen den 20 september
- GitHub på X, Eyeball blir open source
- GitHub, npm-tokens begränsade till vänteläge
- GitHub, regel för kodtäckning via REST API
- Alibaba Wan på X, Peel-Off Sticker
- Cohere på X, konferensen ALL IN