ai-powered-markdown-translatorgpt-5.6-sol로 프랑스어에서 한국어로 번역된 기사.
토요일과 일요일에는 연구소들이 침묵했다. DeepSeek도, Meta도, Ai2도, Sakana도, Mistral도, xAI도 아무것도 발표하지 않았고, 오픈 모델 분야의 공식 계정들은 이틀 내내 비어 있었다. 실질적인 출시는 단 하나였다. 일요일 오후 중반에 오픈 웨이트로 공개된 Qwen-Image-2.1이다. 나머지 대부분은 Hugging Face 커뮤니티 블로그 게시물 5개, 아무것도 수정하지 않은 Antigravity 버전 하나, 그리고 9월 18일 자로 뒤늦게 확인한 GitHub 변경 기록 두 건이었다. 부풀릴 이유가 전혀 없는 조용한 하루였다.
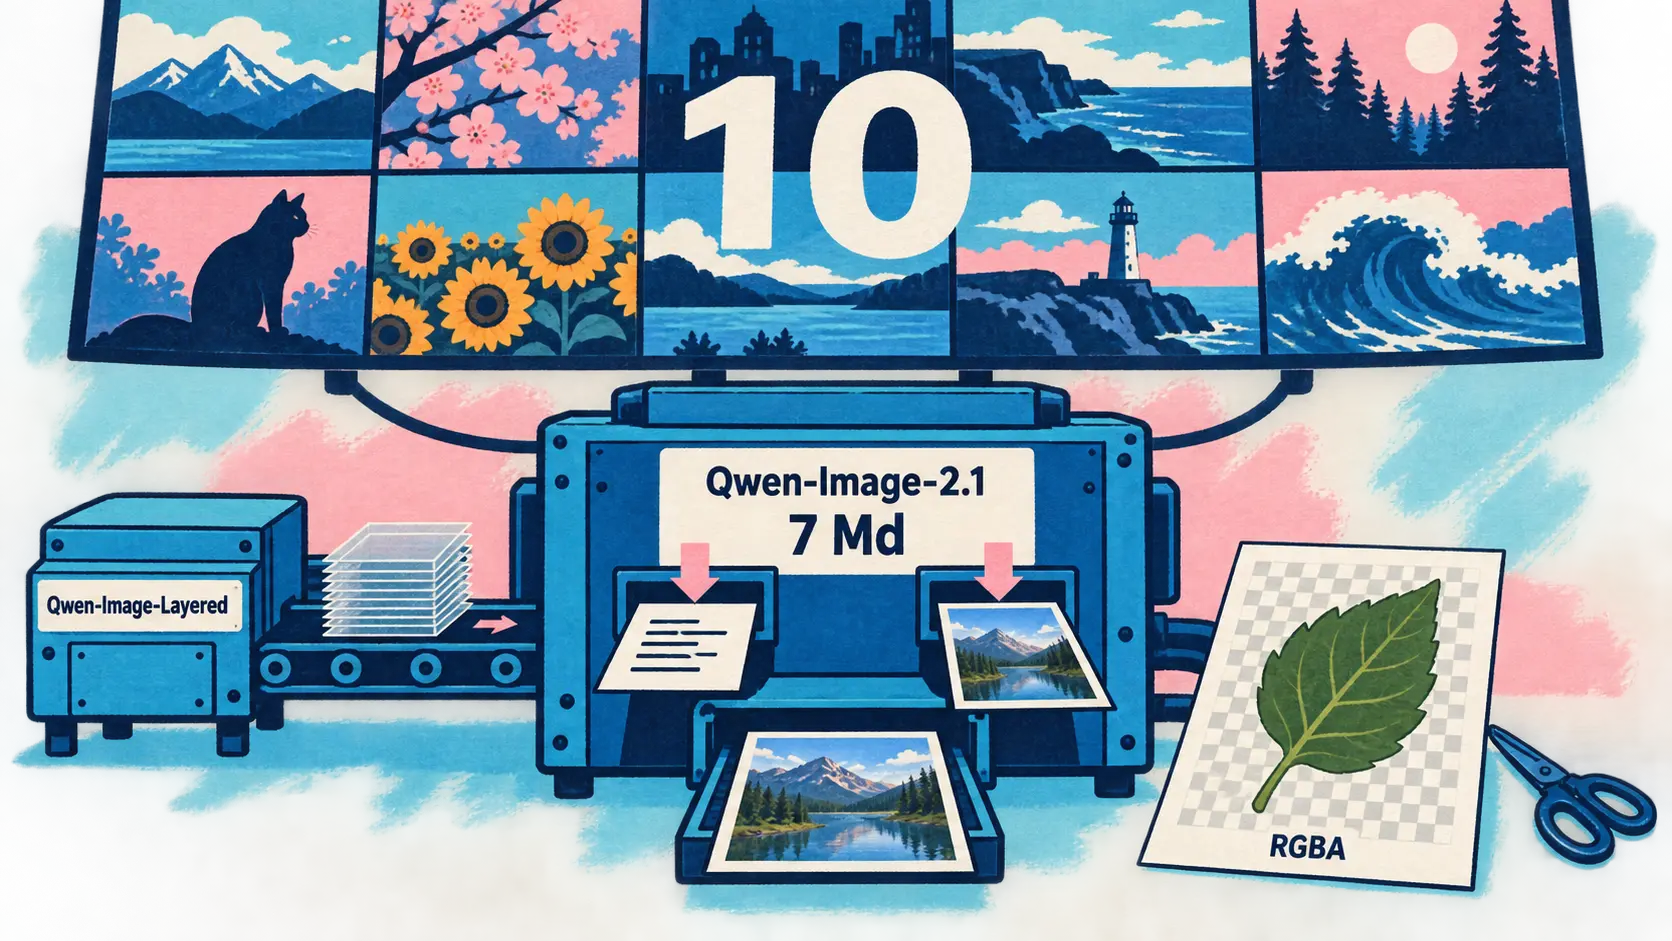
생성과 편집, 투명도 결과물까지 하나의 모델로 제공하는 Qwen-Image-2.1
9월 20일 — Qwen은 이미지 생성·편집 모델 Qwen-Image-2.1을 Hugging Face, ModelScope, GitHub에 오픈 웨이트로 공개했다. 핵심은 크기가 아니라 통합이다. 하나의 동일한 웨이트 계열이 텍스트 지시를 통한 생성과 기존 이미지 편집을 모두 담당하며, 이전에는 이 두 용도에 각각 별도의 모델이 필요했다.
가장 구체적인 신기능은 네이티브 투명도다. 모델이 RGBA 레이어를 직접 생성하고 수정하며, 출력에 투명도 채널을 포함할지는 지시문이 결정한다. Qwen은 2025년 12월부터 전용 모델 Qwen-Image-Layered로 이 기능을 제공해 왔지만, 이제 그 모델이 통합됐다. 사진에서 피사체를 재사용 가능한 레이어로 추출하거나 투명 레이어 안의 텍스트를 교체할 때 누끼 따기 단계 하나가 사라진다.
편집 측면에서 이 모델은 하나의 구성에 최대 10개의 참조 이미지를 받을 수 있다. 수정할 영역은 색이 있는 원, 칠해진 주석 또는 별도로 제공하는 마스크로 지정한다. 세 번째 방식은 앞의 두 방식이 원본 내용을 가리기 때문에 마련됐다. 효율성은 혼합 세분성 어텐션을 기반으로 하며, 편집 입력은 첫 단계부터 캐시되는 정적 컨텍스트를 구성한다.
| 기술 요소 | 발표된 값 |
|---|---|
| 시각 생성 매개변수 | 70억 개, 32개 레이어의 Single-Stream DiT 기반 |
| 허용되는 참조 이미지 | 최대 10개 |
| 출력 투명도 | 생성과 편집 모두 네이티브 RGBA 레이어 |
| 통합된 전용 모델 | 2025년 12월에 공개된 Qwen-Image-Layered |
| 출시 당일부터 지원 | vLLM-Omni 및 ComfyUI |
Qwen은 Qwen-Image-Bench 비교 결과를 공개했지만, 수치는 게시물 속 이미지에만 들어 있어 여기에는 옮기지 않았다.
Generate, edit, and create transparent images with one model: a 7.1B DiT paired with Qwen3-VL-8B.
🇰🇷 하나의 모델로 투명 이미지를 생성하고 편집하고 제작한다. Qwen3-VL-8B와 결합한 71억 매개변수 DiT다. — @vllm_project의 X 게시물
🔗 발표
Web Shell의 완전한 음성 기능과 확장된 bwrap 샌드박스를 제공하는 Qwen Code v0.24.2
같은 개발사, 같은 날이지만 서로 무관한 제품이다. 9월 20일 — v0.24.1 출시 후 24시간이 조금 지나 공개된 Qwen 명령줄 코딩 에이전트 v0.24.2는 해당 버전 계열에서 처음으로 호환성을 깨는 변경이 전혀 없는 버전이다. 앞선 두 버전에는 각각 하나씩 있었다.
bubblewrap 샌드박스에는 구조화된 프로세스 실행, 감독, 격리된 workers를 포함한 완전한 실행 기반이 추가됐다. 같은 맥락에서 신뢰 여부가 결정되지 않은 작업 공간은 이제 명시적인 결정을 요구한다. Web Shell에서는 Live Voice 기능을 실질적으로 사용할 수 있게 됐다. 설정 카드에서 모델과 음성을 선택할 수 있고, 통화 중에는 마이크 음량이 표시된다. 여러 세션을 병렬로 실행하는 사용자를 위해 이제 각 수신 메시지는 해당 메시지가 지정된 세션별로 평가되며, 지연 도구를 위한 프롬프트 캐시도 유지된다.
🔗 릴리스 노트
토큰을 쓰지 않고 응답 검증하기, 그리고 저자가 심판이자 당사자인 순위표
9월 20일 — 같은 날, 동일한 2,018개 항목 데이터 세트를 다룬 게시물 두 편이 나왔다. 첫 번째는 Zero-Token Confidence를 소개한다. 탐침이 한 번의 순전파로 모델의 마지막 은닉 상태를 읽어 보정된 확률을 산출하며, 토큰은 생성하지 않는다. 모델에 확신하는지 물으면 곡선 아래 면적이 무작위 수준인 0.5000이지만, 내부 상태를 읽으면 0.8801에 이른다. 소요 시간도 응답 생성의 1.631초에 비해 0.0615초다. 두 번째 게시물은 검증기 13개를 평가한다. 0.70을 넘은 것은 3개뿐이며 ZTC는 JEV를 0.0014 앞섰지만, 통계적으로 구분할 수 없는 차이다.
더 확실한 사실은 다른 데 있다. 응답 내용은 전혀 보지 않고 길이와 형식만 확인하는 기준선이 0.7036을 기록해 13개 시스템 중 8개를 이겼다. 다만 순위표 작성자는 중립적인 제삼자가 아니다. 자신의 시스템도 평가했다고 밝혔지만 13개 중 어느 것인지는 밝히지 않았고, 두 게시물은 같은 날 게재됐다. 수치는 정확할 수 있지만 순위표의 독립성은 입증되지 않았다.
동시에 개선하고 망가뜨린 54달러짜리 LoRA
9월 20일 — ScalablyAI는 자사 에이전트 플랫폼에 축적된 143,145개의 도구 사용 블록으로 Qwen3.8-27B용 LoRA 어댑터 두 개를 53.88달러에 훈련한 뒤, 첫 훈련 단계 이전에 고정해 둔 평가 모음으로 이를 평가했다.
결과는 양면적이었다. 거부된 도구 호출 이후 복구 상태 73개에서는 어댑터의 성공 건수가 31개에서 38개로 늘었고, 7개 사례가 유리하게 바뀌었으며 불리하게 바뀐 사례는 없었다. 하지만 정상적인 경로 결정 73개에서는 49개에서 45개로 줄어, 2로 설정한 한계를 5.5포인트 넘어섰다. 어댑터 언로드는 전체 단위로만 가능하므로, 성능 저하를 포기하려면 개선도 포기해야 했다. 결국 두 어댑터 모두 폐기됐다. 그래서 한쪽에는 편집 가능한 메모리 규칙 433개를 두고, 다른 쪽의 웨이트는 건드리지 않는 아키텍처를 채택했다.
If every useful experience immediately changes the weights, learning and corruption can become the same operation, and at production sample sizes you cannot tell which one you performed.
🇰🇷 유용한 경험 하나하나가 즉시 웨이트를 바꾼다면 학습과 손상이 같은 작업이 될 수 있으며, 실제 운영 환경의 표본 규모로는 방금 둘 중 어느 작업을 했는지 알 수 없다. — Hugging Face 블로그의 pavle-scalably
예술가가 놓을 법한 곳에 UV 심을 배치하는 SeamFlow
9월 20일 — 3D 표면을 2D로 펼치려면 표면을 잘라야 하며, 좋은 전개 방식은 이런 심을 가장 눈에 띄지 않는 곳에 배치한다. Meshy AI가 City University of Hong Kong, Bambu Lab, Nanyang Technological University와 함께 공개한 SeamFlow는 모델에 넣기 전에 표현 방식을 바꾼다. 메시의 각 엣지가 토큰이 되고 이진 레이블은 연속값으로 완화돼, 플로 매칭(flow matching)을 적용할 수 있게 된다.
장점은 구조적이다. 투영 단계나 임의적인 토큰 순서가 더 이상 필요하지 않으며, 예측된 모든 절단선은 기존 엣지 위에 놓인다. 전문가가 심을 만든 Objaverse 메시 350,000개로 훈련한 이 모델은 접힌 부분에 절단선을 배치한다. 심을 따라 측정한 평균 이면각은 67.59도로, xatlas의 56.65도와 PartUV의 55.97도를 웃돈다. 전개 시간은 5.63초로 자기회귀 기준 모델의 11.46초보다 짧고, 첫 번째 선택으로 선호된 비율은 61.0%로 차순위 모델의 19.1%보다 높다.
🔗 SeamFlow
활성화하지 않은 채 Windows에 샌드박스를 제공하는 Antigravity 2.15.1
9월 19일 — Antigravity 2.15.1의 변경 사항은 한 줄뿐이다. 파일 및 네트워크 샌드박스가 Windows에 도입됐다. 전날 나온 2.15.0에는 개선 사항 7개와 수정 사항 16개가 담겼지만, 이번 버전에는 개선 사항 하나뿐이고 수정 사항은 없다. 유지보수 릴리스가 아니라 특정 기능을 겨냥한 추가다.
다른 플랫폼과의 격차가 진짜 쟁점이다. Linux에서는 샌드박스가 커널 namespaces를 기반으로 하고, macOS에서는 sandbox-exec의 Seatbelt 프로필을 기반으로 하며, 두 경우 모두 기본으로 활성화된다. Windows에서는 사용된 기반 기술이 문서화되지 않았고, « Enable Sandbox Mode (Preview) » 확인란을 통해 수동으로 활성화해야 한다. 제공되는 세 가지 보안 사전 설정인 Default, Full machine, Turbo mode 중 어느 것도 샌드박스를 활성화하지 않으며, 확인란을 선택하면 사전 설정이 Custom으로 바뀐다. Google은 향후 버전에서 동작을 통일하겠다고 밝혔지만 일정은 제시하지 않았다.
단신
- 주석자 5명에게 같은 지시를 줬지만 답은 모두 달랐다 — 튀르키예 장면 100개와 양성 9개인 인간 기준을 대상으로 했을 때, 기계 주석자 5명의 양성 판정 수는 0개에서 78개까지 벌어졌다. 원시 일치율은 74.7
86.3%였지만 모든 Cohen’s kappa는 0.0000.185에 머물렀다. 평가된 스키마를 자신이 설계했다고 밝힌 저자는 설계자가 자기 스키마의 전이 가능성을 판단하는 중립적 심판은 아니라고 상기시킨다. 🔗 출처 - 9월 20일 Gemini CLI nightly에는 변경 사항이 없다 —
v0.62.0-nightly.20260920.gcfbcaa8df태그는 전날과 같은 커밋에 지정됐고 해시 접미사도 동일하며, 버전 페이지에는 « What’s Changed » 섹션이 없다. stable(v0.60.0)과 preview(v0.61.0-preview.0) 채널도 그대로다. 🔗 출처 - GitHub의 법률 전문가가 작성한 Copilot CLI 플러그인 Eyeball이 오픈 소스로 공개됐다 — 이 도구는 분석 대상 조항 위치에 원본 문서의 스크린샷을 삽입해 분석 내용과 근거를 나란히 볼 수 있게 한다.
dvelton/eyeball저장소는 MIT 라이선스의 Python 프로젝트로 공개됐으며 별은 35개이고, 2026년 4월 5일 이후 커밋이 없다. 🔗 출처 - 9월 18일부터 대기 상태로만 제한되는 npm 토큰이 제공된다 — « Read and write (stage only) » 권한은 지속적 통합 파이프라인이
npm stage publish을 통해 버전을 등록하되 게시하지는 못하게 하며, 공개하려면 관리자의 2FA 승인이 필요하다. 2FA 우회로 설정된 토큰을 포함해 레지스트리 측에서 차단이 적용된다. npm은 2027년 1월에 이 직접 게시 방식을 폐지할 예정이다. 🔗 출처 - 역시 9월 18일부터 코드 커버리지 규칙을 REST API로 제어할 수 있다 — 최소 임곗값을 강제하거나 pull request에서 허용되는 감소 폭을 제한하는 규칙 세트 옵션 « Restrict code coverage »가 API에서 정식 출시돼 코드형 인프라에 포함할 수 있게 됐다. GitHub Enterprise Cloud와 GitHub Team에서만 제공되며 GitHub Enterprise Server는 제외된다. 🔗 출처
- Wan이 Peel-Off Sticker 기능을 강조했다 — Alibaba Wan 계정은 wan.video에서 개인 사진을 장면에 삽입한 뒤 Wan 3.0으로 애니메이션화하는 기능을 선보였다. 출시는 아니다. 게시물에는 공개 날짜도, 가격도, 품질 측정치도 없다. 🔗 출처
- Cohere가 몬트리올 ALL IN 콘퍼런스에서 사진 4장을 공개했다 — 9월 19일 게시물은 Aston Martin F1과 Magnus Carlsen이 회사와 함께 참석했다고 전한다. 제품 발표도, 수치도, 링크도 없다. 🔗 출처
이것이 의미하는 것
주말에 출시된 유일한 모델은 오픈 모델이며, 새 모델을 하나 더 보태는 대신 기존 모델을 통합했다. Qwen-Image-2.1은 Qwen-Image-Layered 옆에 또 하나 쌓이는 것이 아니라 이를 흡수하고, 투명도 기능을 주력 모델에 통합해 9개월 된 전용 모델 하나를 없앴다. 생성과 편집도 같은 방향으로 움직여 하나의 웨이트 계열로 합쳐졌다. 시각 자료를 제작하는 사람에게 이는 더 짧은 작업 흐름을 뜻한다. 불러올 모델은 하나이고, RGBA 레이어를 바로 활용할 수 있으며, 누끼 따기 단계가 필요 없다. 생태계도 같은 날 발맞춰 움직여 vLLM-Omni와 ComfyUI가 공개 당일부터 작동했다.
일요일 게시물 세 편은 서로 다른 세 각도에서 같은 우려를 다룬다. 모델이 내놓는 결과를 신뢰할 수 있는지, 그리고 그 비용은 얼마인지에 관한 문제다. Zero-Token Confidence는 비용으로 답한다. 검증기가 토큰을 생성하면 동일한 예산을 두고 에이전트와 경쟁해야 하므로 1.631초가 아니라 0.0615초가 걸린다. 검증기 13개의 순위표는 측정으로 답하며, 그 결과는 업계에 불편한 사실을 보여 준다. 응답의 길이와 형식만 읽는 기준선이 13개 중 8개를 이긴다. 따라서 검증기가 실제로 내용을 읽는다는 사실을 입증하려면 대부분이 제시하는 수준보다 더 높은 기준을 넘어야 한다. 저자가 자신의 시스템도 평가했다고 인정한 만큼, 제삼자의 재검증을 기다릴 필요도 있다.
ScalablyAI의 보고서는 다른 두 게시물에 빠져 있던 차원인 가역성을 추가한다. 54달러짜리 웨이트 업데이트는 하나의 동일한 산출물 안에서 실패 후 복구 성능을 측정 가능한 수준으로 개선하는 동시에, 정상적인 판단 능력에는 손실을 일으킬 가능성을 만들었다. 실제 운영 규모의 표본으로는 둘을 구분할 수 없었다. 어댑터의 절반만 언로드할 수는 없으므로 전부 폐기해야 했다. 여기서 나온 운영상 결론은 되돌리기 쉬운 저렴한 지식은 텍스트 파일에 두고, 웨이트는 고정된 평가 모음을 통과할 때만 변경한다는 것이다. 스스로 개선하는 AI에 관한 담론에 유용한 대조점이다.
도구 측면에서는 운영체제 수준의 격리가 선택 기능이 아니라 기반으로 자리 잡고 있다. Qwen Code는 bubblewrap을 내부 실행 기반으로 만들고, Antigravity는 샌드박스를 Windows로 확장했으며, npm은 버전을 준비할 수는 있지만 게시할 수는 없는 토큰을 만들었다. 세 개발사가 사흘 사이에 보안을 말이 아니라 기본값으로 옮기고 있다. 다만 Windows 사례에는 단서가 붙는다. 직접 확인란을 선택해야 하고 제공되는 세 가지 사전 설정 중 어느 것도 활성화하지 않는 샌드박스는 아직 기본 보호 기능이 아니다. Google이 일정을 제시하기 전까지 macOS 및 Linux와의 격차는 그대로다.
출처
- Alibaba Qwen의 X 게시물, Qwen-Image-2.1 발표
- Qwen, Qwen-Image-2.1 게시물
- Hugging Face의 Qwen-Image-2.1
- vLLM의 X 게시물, 출시 당일부터 지원
- Qwen Code, v0.24.2 릴리스 노트
- Zero-Token Confidence
- 하나의 테스트 세트에서 평가한 응답 검증기 13개
- ScalablyAI, 빠른 메모리와 느린 웨이트
- ScalablyAI, 증거 기록부
- SeamFlow, 플로 매칭을 통한 UV 전개
- SeamFlow, 프로젝트 페이지
- Antigravity, 변경 기록
- Antigravity, 샌드박스 문서
- LLM 주석자 5명 간의 일치도
- Gemini CLI, 9월 20일 nightly
- GitHub의 X 게시물, Eyeball 오픈 소스 공개
- GitHub, 대기 상태로 제한되는 npm 토큰
- GitHub, REST API를 통한 코드 커버리지 규칙
- Alibaba Wan의 X 게시물, Peel-Off Sticker
- Cohere의 X 게시물, ALL IN 콘퍼런스