ai-powered-markdown-translatorArtikel, der mit gpt-5.6-sol aus dem Französischen ins Deutsche übersetzt wurde.
Am Samstag und Sonntag schweigen die Labore: Weder DeepSeek noch Meta, Ai2, Sakana, Mistral oder xAI haben etwas veröffentlicht, und die offiziellen Accounts aus dem Bereich der offenen Modelle blieben zwei Tage lang leer. Es gab nur eine echte Veröffentlichung: Qwen-Image-2.1, das am Sonntagnachmittag mit offenen Gewichten erschien. Der Großteil des Rests beschränkt sich auf fünf Beiträge im Community-Blog von Hugging Face, eine Antigravity-Version, die keine Fehler behebt, und zwei nachgereichte GitHub-Changelog-Einträge vom 18. September – ein ruhiger Tag, den künstlich aufzublähen es keinen Grund gibt.
Qwen-Image-2.1: ein einziges Modell zum Generieren, Bearbeiten und Bereitstellen von Transparenz
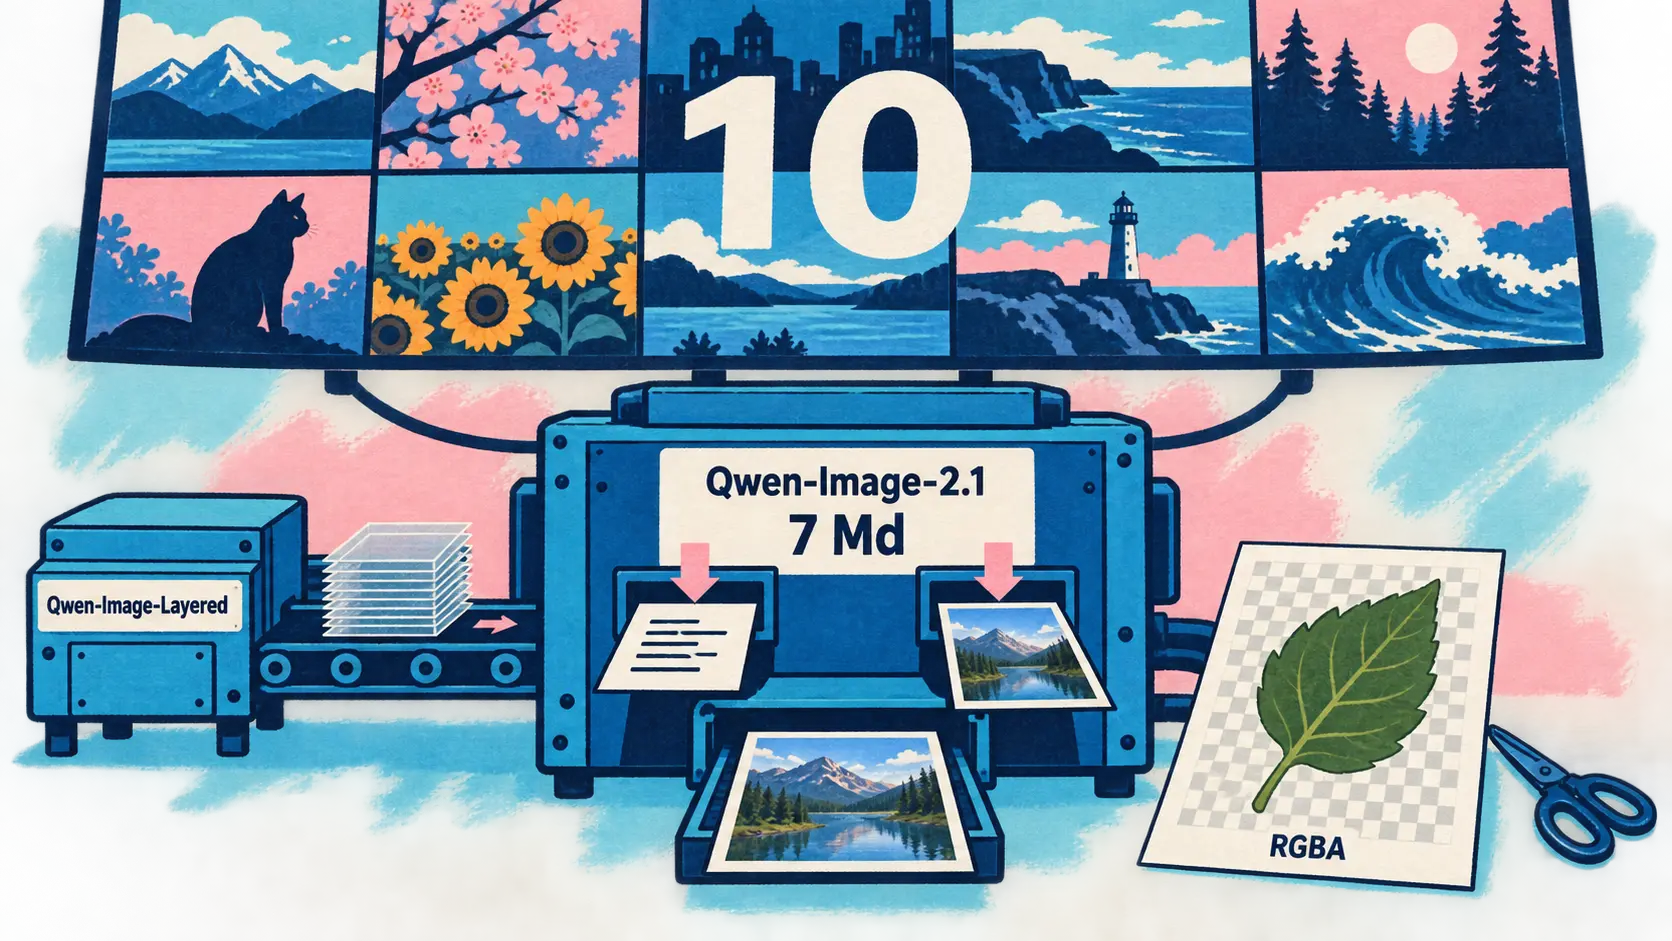
20. September — Qwen hat Qwen-Image-2.1, sein Modell zur Generierung und Bearbeitung von Bildern, mit offenen Gewichten auf Hugging Face, ModelScope und GitHub veröffentlicht. Das Argument ist nicht die Größe, sondern die Vereinheitlichung: Dieselbe Gewichtsreihe deckt sowohl die Erstellung anhand einer Textanweisung als auch die Bearbeitung bestehender Bilder ab, wofür bislang zwei Modelle erforderlich waren.
Die greifbarste Neuerung ist die native Transparenz: Das Modell erzeugt und bearbeitet direkt RGBA-Ebenen, wobei die Anweisung bestimmt, ob die Ausgabe einen Transparenzkanal enthält. Qwen bot diese Fähigkeit seit Dezember 2025 über ein eigenes Modell namens Qwen-Image-Layered an, das nun darin aufgegangen ist. Ein Freistellungsschritt entfällt: So lässt sich ein Motiv aus einem Foto als wiederverwendbare Ebene extrahieren oder der Text in einer transparenten Ebene ersetzen.
Bei der Bearbeitung akzeptiert das Modell bis zu 10 Referenzbilder für dieselbe Komposition. Der zu bearbeitende Bereich lässt sich durch einen farbigen Kreis, eine aufgemalte Markierung oder eine separat bereitgestellte Maske kennzeichnen – die dritte Möglichkeit existiert, weil die ersten beiden den ursprünglichen Inhalt überdecken. Die Effizienz beruht auf Attention mit gemischter Granularität, wobei die Bearbeitungseingaben einen statischen Kontext bilden, der bereits beim ersten Schritt zwischengespeichert wird.
| Technisches Element | Angegebener Wert |
|---|---|
| Parameter für die visuelle Generierung | 7 Milliarden, auf 32 Single-Stream-DiT-Schichten |
| Akzeptierte Referenzbilder | Höchstens 10 |
| Transparenz der Ausgaben | Native RGBA-Ebenen, sowohl bei Generierung als auch Bearbeitung |
| Integriertes Spezialmodell | Qwen-Image-Layered, veröffentlicht im Dezember 2025 |
| Unterstützung ab dem ersten Tag | vLLM-Omni und ComfyUI |
Qwen veröffentlicht einen Vergleich auf Qwen-Image-Bench, dessen Werte jedoch nur in einer Abbildung des Beitrags erscheinen: Sie werden hier nicht wiedergegeben.
Generate, edit, and create transparent images with one model: a 7.1B DiT paired with Qwen3-VL-8B.
🇩🇪 Bilder mit einem einzigen Modell generieren, bearbeiten und mit Transparenz erstellen: ein DiT mit 7,1 Milliarden Parametern in Verbindung mit Qwen3-VL-8B. — @vllm_project auf X
Qwen Code v0.24.2: vollständige Sprachfunktion in der Web Shell und eine ausgebaute bwrap-Sandbox
Derselbe Herausgeber, derselbe Tag, ein Produkt ohne Zusammenhang. 20. September — Die etwas mehr als vierundzwanzig Stunden nach v0.24.1 veröffentlichte Version v0.24.2 des Kommandozeilen-Codeagenten von Qwen ist die erste ihrer Reihe ohne Breaking Change, während die beiden vorherigen jeweils einen enthielten.
Die bubblewrap-Sandbox erhält eine vollständige Ausführungsgrundlage: strukturiertes Starten von Prozessen, Überwachung und abgeschottete Worker. Im selben Zusammenhang erfordert ein Workspace mit ungeklärtem Vertrauensstatus nun eine ausdrückliche Entscheidung. In der Web Shell wird die Funktion Live Voice tatsächlich nutzbar: Modell und Stimme lassen sich über die Konfigurationskarte auswählen, und während des Anrufs wird der Mikrofonpegel angezeigt. Wer mehrere Sitzungen parallel betreibt, profitiert davon, dass jede eingehende Nachricht nun für die Sitzung ausgewertet wird, an die sie gerichtet ist, und dass der Prompt-Cache bei verzögerten Tools erhalten bleibt.
Eine Antwort prüfen, ohne ein Token zu schreiben, und eine Rangliste, deren Autor Richter in eigener Sache ist
20. September — Zwei Beiträge am selben Tag über denselben Satz aus 2.018 Elementen. Der erste stellt Zero-Token Confidence vor: Eine Sonde liest in einem einzigen Forward Pass den letzten verborgenen Zustand des Modells aus und leitet daraus eine kalibrierte Wahrscheinlichkeit ab, ohne ein Token zu generieren. Das Modell zu fragen, ob es sich sicher ist, ergibt eine Fläche unter der Kurve von 0,5000 und entspricht damit dem Zufall; das Auslesen seines internen Zustands erreicht 0,8801 in 0,0615 Sekunden, gegenüber 1,631 Sekunden für die Generierung einer Antwort. Der zweite Beitrag testet dreizehn Prüfer damit: Nur drei überschreiten 0,70, und ZTC liegt 0,0014 vor JEV – ein nicht unterscheidbarer Abstand.
Die belastbarste Erkenntnis liegt anderswo: Eine Baseline, die lediglich Länge und Formatierung der Antwort betrachtet und niemals deren Inhalt, erreicht 0,7036 und schlägt acht der dreizehn Systeme. Einschränkend ist festzuhalten, dass der Autor der Rangliste kein neutraler Dritter ist – er gibt an, auch sein eigenes System zu messen, ohne zu sagen, welches der dreizehn seines ist, und beide Beiträge erscheinen am selben Tag. Die Zahlen können korrekt sein; die Unabhängigkeit der Rangliste ist hingegen nicht belegt.
Ein LoRA für 54 Dollar, das zugleich verbessert und beschädigt
20. September — ScalablyAI hat für 53,88 Dollar zwei LoRA-Adapter auf Qwen3.8-27B trainiert. Grundlage waren 143.145 Blöcke zur Tool-Nutzung, die von seiner Agentenplattform stammten; anschließend wurden die Adapter anhand einer vor dem ersten Trainingsschritt eingefrorenen Suite bewertet.
Das Ergebnis ist zweischneidig. Bei 73 Wiederherstellungszuständen nach einem abgelehnten Tool-Aufruf steigt der Adapter von 31 auf 38 Erfolge, wobei sieben Fälle zu seinen Gunsten kippen und keiner zu seinen Ungunsten. Bei 73 Entscheidungen auf einem fehlerfreien Ablauf sinkt er jedoch von 49 auf 45, also um fünfeinhalb Punkte bei einer festgelegten Grenze von zwei. Da das Entladen eines Adapters atomar erfolgt, hätte man für den Verzicht auf den Rückschritt auch den Fortschritt aufgeben müssen: Beide wurden verworfen. Daher die gewählte Architektur – 433 editierbare Gedächtnisregeln auf der einen Seite, unangetastete Gewichte auf der anderen.
If every useful experience immediately changes the weights, learning and corruption can become the same operation, and at production sample sizes you cannot tell which one you performed.
🇩🇪 Wenn jede nützliche Erfahrung sofort die Gewichte verändert, können Lernen und Beschädigen ein und derselbe Vorgang werden, und bei den in der Produktion verfügbaren Stichprobengrößen lässt sich nicht erkennen, welchen der beiden man gerade ausgeführt hat. — pavle-scalably im Hugging-Face-Blog
🔗 Vollständiger Bericht und Evidenzregister
SeamFlow platziert UV-Nähte dort, wo ein Künstler sie setzen würde
20. September — Um eine 3D-Oberfläche in 2D zu entfalten, muss sie aufgeschnitten werden; eine gute Zerlegung platziert diese Nähte dort, wo sie am wenigsten sichtbar sind. SeamFlow, vorgestellt von Meshy AI gemeinsam mit der City University of Hong Kong, Bambu Lab und der Nanyang Technological University, verändert die Darstellung vor dem Modell: Jede Kante des Meshs wird zu einem Token, und das binäre Label wird zu einem kontinuierlichen Wert gelockert, wodurch Flow Matching anwendbar wird.
Die Vorteile sind struktureller Natur: Es gibt weder einen Projektionsschritt noch eine willkürliche Reihenfolge der Tokens, und jeder vorhergesagte Schnitt liegt auf einer vorhandenen Kante. Das Modell wurde auf 350.000 Objaverse-Meshes mit von Fachleuten erstellten Nähten trainiert und platziert seine Schnitte in Falten: Der mittlere Diederwinkel entlang der Nähte beträgt 67,59 Grad, gegenüber 56,65 bei xatlas und 55,97 bei PartUV. Es entfaltet in 5,63 Sekunden gegenüber 11,46 Sekunden bei einer autoregressiven Referenz und wird in 61,0 % der Fälle als erste Wahl bevorzugt, gegenüber 19,1 % für den nächstplatzierten Ansatz.
🔗 SeamFlow
Antigravity 2.15.1 bringt die Sandbox auf Windows, ohne sie zu aktivieren
19. September — Die Version 2.15.1 von Antigravity lässt sich in einer Zeile zusammenfassen: Das Sandboxing von Dateien und Netzwerkzugriffen kommt auf Windows. Eine einzige Verbesserung, keine Fehlerbehebung, während die Version 2.15.0 vom Vortag sieben beziehungsweise sechzehn davon enthielt – eine gezielte Ergänzung, kein Wartungsrelease.
Der Unterschied zum Rest der Produktfamilie ist das eigentliche Thema. Unter Linux beruht die Sandbox auf Kernel-Namespaces, unter macOS auf den Seatbelt-Profilen von sandbox-exec; in beiden Fällen ist sie standardmäßig aktiv. Unter Windows ist der verwendete Mechanismus nicht dokumentiert, die Aktivierung erfolgt weiterhin manuell über das Kontrollkästchen „Sandbox-Modus aktivieren (Vorschau)“, und keine der drei angebotenen Sicherheitsvoreinstellungen – Default, Full machine, Turbo mode – aktiviert ihn: Das Markieren des Kontrollkästchens stellt die Voreinstellung auf Custom um. Google kündigt eine Angleichung für eine spätere Version an, nennt jedoch keinen Zeitplan.
Kurzmeldungen
- Fünf Annotatoren, dieselbe Anweisung, fünf unterschiedliche Antworten — Bei 100 türkischen Szenen und einer menschlichen Referenz mit 9 positiven Fällen reichen fünf maschinelle Annotatoren von 0 bis 78 positiven Fällen, wobei sämtliche Cohen-Kappa-Werte trotz einer Rohübereinstimmung von 74,7 bis 86,3 % zwischen 0,000 und 0,185 liegen. Der Autor, der angibt, das bewertete Schema selbst entwickelt zu haben, erinnert daran, dass ein Entwickler kein neutraler Beurteiler der Übertragbarkeit seines eigenen Schemas ist. 🔗 Quelle
- Die Gemini-CLI-Nightly vom 20. September enthält keine Änderungen — Das Tag
v0.62.0-nightly.20260920.gcfbcaa8dfverweist auf denselben Commit wie am Vortag, mit demselben Hash-Suffix, und auf der Versionsseite fehlt jeder Abschnitt „Was hat sich geändert?“. Auch die Kanäle stable (v0.60.0) und preview (v0.61.0-preview.0) sind unverändert. 🔗 Quelle - Eyeball, das von einem GitHub-Juristen geschriebene Copilot-CLI-Plugin, ist Open Source — Das Tool bettet Screenshots des Quelldokuments an der Stelle der analysierten Klausel ein, sodass Analyse und Beleg nebeneinander gelesen werden können. Das Repository
dvelton/eyeballist öffentlich, steht unter der MIT-Lizenz, ist in Python geschrieben, hat 35 Sterne und seit dem 5. April 2026 keinen Commit mehr erhalten. 🔗 Quelle - Seit dem 18. September gibt es npm-Tokens, die auf das Bereitstellen zur Freigabe beschränkt sind — Die Berechtigung „Lesen und Schreiben (nur Bereitstellung)“ ermöglicht einer Continuous-Integration-Pipeline, über
npm stage publisheine Version zu hinterlegen, ohne sie veröffentlichen zu können; für die Veröffentlichung ist die 2FA-Genehmigung eines Maintainers erforderlich. Die Sperre wird auf Registry-Seite durchgesetzt, auch bei einem Token, der zur Umgehung von 2FA konfiguriert ist; npm wird diese direkte Veröffentlichung im Januar 2027 abschaffen. 🔗 Quelle - Die Regel zur Codeabdeckung lässt sich ebenfalls seit dem 18. September über eine REST API steuern — Die Regelsatzoption „Codeabdeckung beschränken“, die einen Mindestschwellenwert durchsetzt oder den tolerierten Rückgang bei einem Pull Request begrenzt, wird in der API allgemein verfügbar und damit auch in Infrastructure as Code. Sie ist GitHub Enterprise Cloud und GitHub Team vorbehalten und nicht in GitHub Enterprise Server verfügbar. 🔗 Quelle
- Wan hebt seine Funktion Peel-Off Sticker hervor — Der Account Alibaba Wan zeigt eine Komponente von wan.video, die ein persönliches Foto in eine Szene einfügt und mit Wan 3.0 animiert. Es handelt sich nicht um eine Markteinführung: Die Meldung nennt weder ein Startdatum noch einen Preis oder eine Qualitätsmetrik. 🔗 Quelle
- Cohere veröffentlicht vier Fotos von der ALL-IN-Konferenz in Montreal — Die Meldung vom 19. September verweist auf die Anwesenheit von Aston Martin F1 und Magnus Carlsen an der Seite des Unternehmens. Keine Produktankündigung, keine Zahl, kein Link. 🔗 Quelle
Was das bedeutet
Die einzige Modellveröffentlichung des Wochenendes ist offen und konsolidiert, statt etwas hinzuzufügen. Qwen-Image-2.1 wird nicht neben Qwen-Image-Layered gestellt: Es nimmt dieses Modell in sich auf und lässt ein neun Monate altes Spezialmodell verschwinden, indem es Transparenz in das Hauptmodell integriert. Dieselbe Entwicklung zeigt sich bei Generierung und Bearbeitung, die in einer einzigen Gewichtsreihe zusammengeführt werden. Für die Produktion visueller Inhalte bedeutet das eine kürzere Pipeline – ein zu ladendes Modell, eine direkt nutzbare RGBA-Ebene und kein Freistellungsschritt – und das Ökosystem zog noch am selben Tag nach: vLLM-Omni und ComfyUI waren bereits bei der Veröffentlichung einsatzbereit.
Drei Sonntagsbeiträge behandeln dieselbe Sorge aus drei Blickwinkeln: ob man den Ergebnissen eines Modells vertrauen kann und zu welchem Preis. Zero-Token Confidence antwortet mit den Kosten – 0,0615 Sekunden gegenüber 1,631, denn ein Prüfer, der Tokens generiert, konkurriert mit dem Agenten um dasselbe Budget. Die Rangliste der dreizehn Prüfer antwortet mit Messwerten, und ihre Erkenntnis ist für die Branche unangenehm: Eine Baseline, die nur Länge und Formatierung einer Antwort betrachtet, schlägt acht von dreizehn Prüfern. Die Hürde für den Nachweis, dass ein Prüfer den Inhalt tatsächlich erfasst, liegt somit höher, als es die meisten Ergebnisse vermuten lassen – und die Aussage des Autors, auch sein eigenes System zu messen, spricht dafür, eine Reproduktion durch Dritte abzuwarten.
Der Bericht von ScalablyAI ergänzt die Dimension, die den beiden anderen fehlt: Reversibilität. Eine Aktualisierung der Gewichte für 54 Dollar führte im selben Artefakt zu einer gemessenen Verbesserung bei der Wiederherstellung nach Fehlern und zu einer möglichen Verschlechterung bei fehlerfreien Entscheidungen – bei einer Stichprobengröße, mit der sich beides in der Produktion nicht auseinanderhalten lässt. Da sich nicht die Hälfte eines Adapters entladen lässt, musste alles verworfen werden. Die operative Schlussfolgerung – günstig rückgängig zu machendes Wissen gehört in Textdateien, und die Gewichte werden nur hinter einer eingefrorenen Suite verändert – ist ein nützlicher Kontrapunkt zur Erzählung von einer KI, die sich selbst verbessert.
Bei den Tools wird die Isolation durch das Betriebssystem zu einer Grundlage statt zu einer Option. Qwen Code macht bubblewrap zu einer internen Ausführungsbasis, Antigravity bringt seine Sandbox auf Windows, und npm erfindet einen Token, der eine Version vorbereiten, aber nicht veröffentlichen kann: drei Anbieter, die innerhalb von drei Tagen Sicherheit von einem Versprechen zu einem Standardwert machen. Für Windows gilt jedoch eine Einschränkung: Eine Sandbox, die man manuell aktivieren muss und die keine der drei angebotenen Voreinstellungen einschaltet, ist noch kein standardmäßiger Schutz. Der Abstand zu macOS und Linux bleibt vollständig bestehen, solange Google keinen Zeitplan nennt.
Quellen
- Alibaba Qwen auf X, Ankündigung von Qwen-Image-2.1
- Qwen, Beitrag zu Qwen-Image-2.1
- Qwen-Image-2.1 auf Hugging Face
- vLLM auf X, Unterstützung ab dem ersten Tag
- Qwen Code, Versionshinweise zu v0.24.2
- Zero-Token Confidence
- Dreizehn Antwortprüfer auf einem einzigen Testsatz
- ScalablyAI, schnelles Gedächtnis und langsame Gewichte
- ScalablyAI, Evidenzregister
- SeamFlow, UV-Entfaltung durch Flow Matching
- SeamFlow, Projektseite
- Antigravity, Changelog
- Antigravity, Dokumentation der Sandbox
- Übereinstimmung zwischen fünf LLM-Annotatoren
- Gemini CLI, Nightly vom 20. September
- GitHub auf X, Eyeball wird Open Source
- GitHub, auf das Bereitstellen zur Freigabe beschränkte npm-Tokens
- GitHub, Codeabdeckungsregel über REST API
- Alibaba Wan auf X, Peel-Off Sticker
- Cohere auf X, ALL-IN-Konferenz