ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
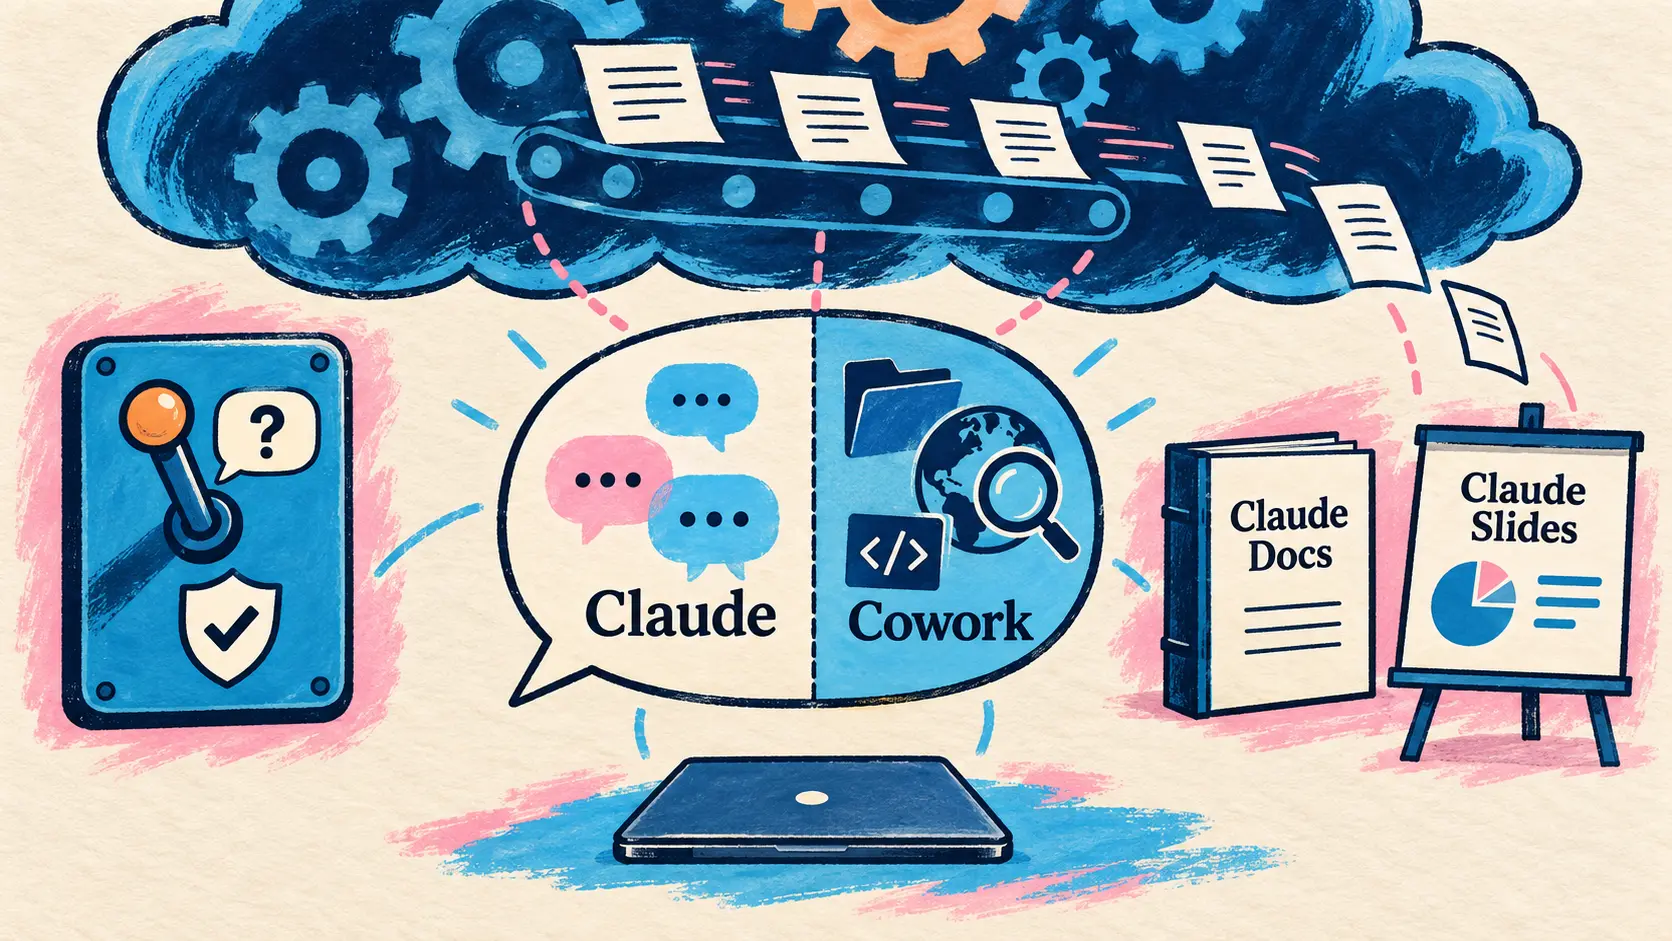
În această miercuri, Anthropic fuzionează chatul și Cowork într-un singur Claude, care își alege singur instrumentele, și lansează Claude Docs și Claude Slides în versiune beta. Zed deschide Delta pentru toți, înlocuind pull request-ul cu o revizuire în firul de discuție, iar NVIDIA introduce Vera Rubin NVL72 în MLPerf Inference v6.1, într-un moment în care electricitatea se impune drept constrângerea principală a fabricilor de AI. Agenții de marcă pătrund și în publicitate, atât în ChatGPT, cât și pe YouTube, în timp ce Cohere semnează acordul definitiv cu Aleph Alpha, iar Mistral ajunge în Firefox.
Un singur Claude: chatul și Cowork fuzionează, iar Claude Docs și Claude Slides sosesc în versiune beta
16 septembrie — Anthropic fuzionează chatul și Claude Cowork: nu mai trebuie ales niciun mod, Claude decide singur dacă trebuie să caute pe web, să citească fișiere sau să execute cod și livrează fișiere finalizate. Sarcinile de lungă durată continuă în cloud chiar și atunci când computerul este oprit, însă fișierele locale, browserul integrat și controlul computerului (computer use, în versiune beta pe Pro și Max) necesită ca Claude Desktop să fie deschis.
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇷🇴 Astăzi, chatul și Cowork încep să fuzioneze într-un singur Claude. Direcția: un singur Claude care păstrează contextul pentru tot ceea ce faci, oriunde te-ai afla. — Boris Cherny (Anthropic) pe X
Noile Claude Docs și Claude Slides produc documente și prezentări, iar Claude Design, lansat în aprilie, funcționează acum în conversații. Toate trei sunt în versiune beta pentru abonamentele plătite, la alegerea administratorilor Enterprise. Fiecare creație poate fi distribuită printr-un link, iar prezentările pot fi exportate în PowerPoint sau PDF. În modul Manual, setarea implicită, Claude solicită permisiunea înainte de fiecare acțiune; în modul Auto, fiecare acțiune este precedată de verificări automate de securitate.
| Abonament sau public vizat | Calendar anunțat |
|---|---|
| Pro și Max (web, desktop, mobil) | „În următoarele săptămâni”, fără să fie necesară vreo activare |
| Team și Free | „În curând”, fără dată |
| Enterprise | Preaviz de cel puțin 30 de zile înaintea oricărei schimbări |
Trecerea este definitivă, însă sarcinile, proiectele, conectorii, skills și artefactele Cowork sunt păstrate. La lansare, centrul de ajutor semnalează anumite limite: nu se poate adăuga conținut din GitHub și nici ramifica o conversație, conversațiile incognito se deschid în experiența veche, sarcinile Cowork mai vechi nu apar în căutare, iar Dispatch este închis pentru utilizatorii noi. Chatul și Cowork aveau deja proiecte și artefacte comune din 7 iulie, iar memoria era comună din 25 august.
🔗 Articolul Anthropic 🔗 Centrul de ajutor
Design, Slides și Docs funcționează și în Claude Code
În aceeași zi, @ClaudeDevs anunță că Claude Design, Claude Slides și Claude Docs funcționează și în Claude Code: i se poate solicita un material pentru revizuirea designului (design review deck) sau o machetă de interfață, îndrumând Claude către fișierele și RFC-urile reale din repository, apoi rezultatul poate fi modificat manual ori în conversație și distribuit prin link. Pentru Design, aceasta nu este o premieră, deoarece comanda /design se află în versiune preliminară de cercetare din 17 august: noutatea o reprezintă Slides și Docs. Tweetul nu precizează nici versiunea minimă, nici abonamentele, nici documentația, iar notele celei mai recente versiuni publicate nu menționează aceste funcții.
Zed deschide Delta în versiune beta publică și înlocuiește pull request-ul cu o revizuire în firul de discuție
16 septembrie — Zed deschide Delta pentru toți. Lansat pe 12 august pe bază de înscriere, apoi pe Windows pe 4 septembrie pentru cei înscriși, instrumentul poate fi acum descărcat liber pe macOS, Linux și Windows, poate fi utilizat pe web fără instalare, iar firele sale de discuție (threads) pot fi urmărite de pe mobil.
Ideea centrală este colaborarea fără commit sau push. Un coleg invitat în conversația cu agentul vede aceleași copii de lucru (worktrees), le poate prelua pe propriul computer, poate întreba agentul despre alegerile sale sau poate continua dacă autorul se deconectează. Revizuirea codului, prezentată în avanpremieră pe 10 septembrie, ține loc de pull request: un fir secundar îl ghidează pe recenzent prin modificările ramurii, cu contextul agentului inițial, într-o copie izolată a worktrees. Comanda /land îi încredințează apoi agentului reunirea într-un singur commit, trecerea CI, fuzionarea după aprobarea echipei și ștergerea ramurii.
În repository-ul Delta, pull request-urile sunt dezactivate din săptămâna anterioară anunțului, iar de atunci 33 de persoane au fuzionat acolo 570 de modificări; repository-ul editorului Zed rămâne pe GitHub „deocamdată”. În culise, DeltaDB completează versionarea Git prin delte incrementale care păstrează, între două commit-uri, modificările și mesajele atât ale oamenilor, cât și ale agenților; commit-ul rămâne punctul de control, astfel încât un coleg care nu deschide niciodată Delta vede un repository Git obișnuit.
Zed afirmă că dorește să înlocuiască GitHub.com și numește acest mod de lucru inginerie continuă (continuous engineering); foaia sa de parcurs, fără dată, prevede stocarea Git în DeltaDB și ia în calcul, în cele din urmă, o verificare de tip CI în firul de discuție. Delta este gratuit pe durata versiunii beta, ofertele cu plată sunt anunțate „în curând”, fără preț sau dată, iar Zed promite să păstreze o versiune gratuită.
🔗 Articolul Zed despre versiunea beta publică a Delta 🔗 Firul Zed despre comanda /land
Vera Rubin NVL72 debutează în MLPerf Inference v6.1 cu un debit de până la 3,7 ori mai mare decât GB300 NVL72
16 septembrie — NVIDIA introduce Vera Rubin NVL72, platforma sa rack de generație următoare, în MLPerf Inference v6.1, ale cărui rezultate sunt publicate de MLCommons, cu rezultate transmise în versiune preliminară (preview). Potrivit comparațiilor realizate de NVIDIA între propriile rezultate transmise, rackul atinge un debit de până la 3,7 ori mai mare decât GB300 NVL72 pe Qwen3-VL, în scenariile offline, server și interactiv, cu vLLM și NVIDIA Dynamo, și de până la 2,5 ori mai mare pe DeepSeek-R1 cu TensorRT-LLM. Nebius a transmis, de asemenea, rezultate Vera Rubin NVL72 în versiune preliminară.
NVIDIA atribuie aceste câștiguri proiectării comune a hardware-ului și software-ului: precizie NVFP4 pentru ponderi, attention și cache-ul KV, servire dezagregată care separă preumplerea (prefill) de decodare, paralelism al experților la scară largă și un domeniu NVLink de generația a șasea, despre care NVIDIA susține că oferă un debit al pachetelor de 10 ori mai mare decât Ethernet standard. Generația actuală își publică, de asemenea, rezultatele:
| Test MLPerf Inference v6.1 | Sistem transmis | Rezultat publicat de NVIDIA |
|---|---|---|
| DeepSeek-R1 offline, de la 72 la 288 GPU | GB300 NVL72, de la 1 la 4 rackuri | Eficiență de scalare de 99 % |
| WAN 2.2, text-to-video | GB300 NVL72 | 0,65 videoclipuri 720p pe secundă, 5,7 s per videoclip |
| Qwen3-VL, v6.1 față de v6.0 | GB300 NVL72 | De până la 1,6 ori, datorită software-ului |
| Edge-Agentic, test nou (Qwen3.6-27B) | Jetson AGX Thor, TensorRT Edge-LLM | Rezultat transmis fără cifre în articol |
NVIDIA raportează și câștiguri obținute după termenul-limită pe GPT-OSS-120B și DLRMv3, pe care MLCommons nu le-a verificat încă. Compania revendică 19 parteneri, dintre care opt folosesc sisteme multi-nod Blackwell NVL72, și menționează viitorul test MLPerf Endpoints al MLCommons, care ar trebui să standardizeze măsurarea inferenței agentice.
🔗 NVIDIA Vera Rubin NVL72 oferă performanțe de vârf la debutul în MLPerf Inference v6.1
Electricitatea în centrul fabricilor de AI: DSX MaxLPS la Lambda și alianța AEMA
15 și 16 septembrie — Două anunțuri NVIDIA plasează rețeaua electrică în centrul implementării AI, ambele implicând Emerald AI: o fabrică de AI controlată de software-ul său și-a redus consumul la cererea unui furnizor de electricitate, apoi Emerald AI, Google și NVIDIA au lansat o alianță pentru data centere flexibile.
AI Infra Summit: Lambda validează DSX MaxLPS, iar o fabrică de AI își reduce consumul la cererea rețelei
15 septembrie — La AI Infra Summit, keynote-ul lui Ian Buck (NVIDIA) s-a concentrat asupra numărului de tokeni produși per megawatt în fabricile de AI (AI factories). Lambda a validat DSX MaxLPS, software-ul NVIDIA care monitorizează consumul GPU-urilor și al rackurilor și redistribuie puterea în funcție de sarcină: 19 noduri HGX B200 au funcționat în limita bugetului electric al unui sistem cu 16 noduri la putere maximă, debitul crescând de la aproximativ 4 la 5 milioane de tokeni pe secundă (+24 %), iar performanța per watt cu 23 %. NVIDIA estimează cu până la 40 % mai multă capacitate GPU pentru Vera Rubin NVL72 în același buget, „în medii adecvate”. Într-o seară din august, un semnal de la Silicon Valley Power a redus automat de la 4 la 3 MW consumul unei fabrici de AI din Santa Clara controlate de Emerald AI Conductor, fără a întrerupe inferența prioritară; de atunci, au fost onorate peste 200 de semnale, cu un timp de răspuns mai mic de un minut. DSX Flex, care gestionează acest tip de semnale, va avea prima sa implementare comercială dedicată într-o fabrică Vera Rubin de 96 MW din Manassas, Virginia.
AEMA, o alianță pentru data centere care se adaptează rețelei
16 septembrie — Emerald AI, Google și NVIDIA lansează AI Energy Management Alliance (AEMA), o coaliție pentru data centere capabile să-și moduleze consumul în funcție de starea rețelei: să mute sarcinile, să folosească energia stocată, să se bazeze pe o producție asociată sau să reacționeze la incidente. Principiile sale: stabilirea înainte de racordare a obligațiilor privind menținerea în funcțiune (ride-through), reducerea consumului (curtailment) și răspunsul la incidente, standardizarea metricilor, deschiderea unor căi de racordare mai rapide pentru angajamente verificabile de flexibilitate și distribuirea costurilor în funcție de impactul real. Alianța vizează Statele Unite, iar partenerii săi de lansare nu sunt numiți. Pe site-ul său, aceasta indică două potențiale: 100 GW care ar putea fi deblocați în rețeaua existentă cu data centere moderat de flexibile și costuri evitate de 733 de milioane de dolari per GW de data centere flexibile noi. NVIDIA și Emerald AI prezentaseră deja fabrici de AI flexibile la CERAWeek, pe 31 martie.
🔗 Articolul NVIDIA despre AEMA 🔗 Site-ul AEMA
Agenții de marcă pătrund în publicitate, în ChatGPT și pe YouTube
16 septembrie — În aceeași zi, OpenAI și Google introduc agentul conversațional al unei mărci în formatul publicitar în Statele Unite: în testare cu agenți de publicitate selectați la OpenAI și în versiune beta pe bază de înscriere pentru comercianți la Google.
ChatGPT Ads testează Sponsored Agents și se conectează la HubSpot și Shopify
OpenAI adaugă AI de ambele părți ale platformei sale ChatGPT Ads. Cu Sponsored Agents, un clic pe o reclamă din ChatGPT poate deschide o conversație semnalată clar cu un agent sponsorizat de marcă, înaintea unui link către site-ul acesteia. OpenAI precizează că acest schimb este distinct de răspunsurile independente ale ChatGPT și separat de conversația inițială.
| Noutate ChatGPT Ads | Stare la 16 septembrie |
|---|---|
| Sponsored Agents | În testare cu agenți de publicitate selectați din Statele Unite |
| Plugin Ads Manager, campanii controlate prin prompts | În curs de lansare |
| Texte și elemente vizuale sugerate în Ads Manager | În curs de lansare |
| Personalizarea și traducerea textului | Lansate, activabile opțional (opt-in) |
| Integrarea HubSpot | Disponibilă |
| Aplicația ChatGPT Ads pentru Shopify | Comercianți americani, alte piețe ChatGPT Ads începând din 23 septembrie |
Articolul nu indică nici tariful, nici numărul agenților de publicitate. Testată în ChatGPT în februarie, publicitatea a primit în mai un Ads Manager în versiune beta și self-service (self-service), iar apoi, pe 31 august, OpenAI a revendicat venituri anualizate de un miliard de dolari prin extinderea acestui serviciu self-service.
🔗 Reimaginarea publicității cu AI
Google introduce Business Agent în reclamele YouTube și extinde comerțul agentic
Google își publică actualizările pentru comerțul agentic (agentic commerce) destinat sezonului sărbătorilor. Business Agent, introdus în Search „mai devreme în acest an”, potrivit Google, intră în versiune beta în reclamele YouTube din Statele Unite, pe bază de înscriere pentru comercianți: spectatorul poate întreba agentul despre produse fără să părăsească YouTube. AI performance insights, care compară cota de voce (share of voice) a unei mărci în AI Mode și AI Overviews, devine disponibil în Merchant Center în Australia, Canada, India, Noua Zeelandă și Statele Unite. În Merchant Center, hubul de integrare UCP (Universal Commerce Protocol), protocolul prezentat de Google pe 11 ianuarie, adaugă transferul coșului către site-ul comerciantului și testarea fluxului de plată, iar analizele vor sosi „în curând”; aceste funcții sunt lansate progresiv în Statele Unite, apoi în Australia și Canada „la începutul anului viitor”. Tapestry (Coach, Kate Spade) vinde deja prin UCP în Search și în aplicația Gemini. Potrivit Google, bunele practici pentru fluxurile de produse generează, în medie, cu 5 % mai multe conversii în luna următoare, iar în testele cu lululemon, atributele conversaționale ale mărcii au fost incluse în 50 % dintre recomandările relevante ale AI Mode.
🔗 Articolul Google despre comerțul agentic
Cohere semnează cu Aleph Alpha și lansează Confidential Computing în Model Vault
16 septembrie — Cohere își intensifică anunțurile, dintre care două se adresează clienților care doresc să păstreze controlul asupra datelor și tehnologiei lor.
Aleph Alpha: acord definitiv și sediu dublu la Berlin și Toronto
Cohere și Aleph Alpha au semnat acordul definitiv de fuziune (definitive business combination agreement), al cărui proiect fusese anunțat pe 24 aprilie. Ansamblul va opera sub numele Cohere, cu peste 1.000 de angajați, un sediu dublu prevăzut la Berlin și Toronto și un centru de cercetare la Heidelberg, în sediul Aleph Alpha. Tranzacția, a cărei valoare nu a fost comunicată, rămâne supusă ultimelor autorizări de reglementare; finalizarea sa este așteptată „mai târziu în acest an”. Ilhan Scheer, co-CEO al Aleph Alpha, va deveni atunci directorul operațional al Cohere, iar Samuel Weinbach, cofondator, director de cercetare. Parteneriatul cu grupul Schwarz continuă pe STACKIT, cloud-ul său suveran.
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇷🇴 Niciun guvern și nicio companie nu ar trebui să fie nevoite să aleagă între o IA performantă și controlul asupra tehnologiei proprii. Tocmai această convingere ne determină să ne unim forțele cu Aleph Alpha. Împreună, vom răspunde cererii globale tot mai mari pentru o IA de frontieră care este atât puternică, cât și sigură. — Aidan Gomez (Cohere), citat de @cohere pe X
🔗 Articolul Cohere despre acord
Confidential Computing în Model Vault, în acces anticipat
Cohere lansează Confidential Computing în Model Vault, platforma sa de inferență dedicată și gestionată integral, pentru a proteja datele în timpul procesării lor, nu doar atunci când sunt stocate și în tranzit. Sunt descrise trei mecanisme: inferență criptată de la un capăt la altul, izolare impusă prin hardware care se extinde până la GPU cu NVIDIA Confidential Computing și un token de atestare semnat, disponibil la cerere și verificabil cu cheile publice ale producătorului hardware-ului. Cohere afirmă că nimeni, „nici măcar noi”, nu poate accesa sarcinile de lucru ale clientului, fără a menționa vreun audit terț. Accesul anticipat este rezervat unui grup limitat de clienți beta, fără tarif, dată de disponibilitate generală sau listă de modele, iar anunțul se limitează la postări pe X și la o pagină de produs. Funcția fusese anunțată pentru o lansare iminentă pe 9 septembrie.
🔗 Anunțul Cohere pe X 🔗 Pagina de produs Model Vault
Mistral propulsează Smart Window, asistentul IA din Firefox
16 septembrie — Într-un articol comun, Mistral AI și Mozilla anunță că Smart Window, asistentul de navigare IA din Firefox aflat încă în versiune beta, funcționează acum cu modele Mistral, fără a preciza care. Asistentul ajută la deslușirea cercetărilor complexe și la reunirea surselor din filele deschise. Mistral îl furnizează mai întâi utilizatorilor din Franța și America de Nord, urmând ca Regatul Unit și Germania să beneficieze de el „mai târziu în acest an”. În mod implicit, conversațiile nu sunt păstrate pe serverele Mozilla, iar partenerii precum Mistral se angajează să nu rețină deloc datele (zero data retention). Pentru Mistral, care spune că deservește „în mod tradițional” companiile, acordul deschide accesul către publicul larg. Arthur Mensch, cofondator și CEO al Mistral, vorbește despre doi susținători ai open source care lucrează împreună, iar Anthony Enzor-DeMeo, CEO al Mozilla Corporation, consideră că un browser nu trebuie să fie o pâlnie cu sens unic.
🔗 Articolul comun al Mistral și Mozilla
Grok Build reține convențiile și deciziile unui proiect de la o sesiune la alta
16 septembrie — SpaceXAI echipează Grok Build, agentul său de cod, cu memorie. După fiecare tur încheiat, Grok îl recitește în fundal, fără a bloca sesiunea, și consemnează într-o notă Markdown ceea ce rămâne valabil: convențiile echipei, deciziile și justificarea acestora, precum și aspecte ale proiectului, cum ar fi comanda care pornește testele. Sunt excluse starea sarcinilor, concluziile provizorii, secretele și ceea ce este deja acoperit de repository sau de documentația acestuia. Notele sunt organizate pe proiecte, cu un set global pentru preferințele valabile pretutindeni. Comanda /dream le grupează în fișiere tematice și se execută și automat, periodic, în timp ce /memory deschide un browser în modul doar pentru citire. La revenirea într-un proiect, Grok citește temele zonei în care urmează să lucreze, dar conversația curentă are prioritate față de note. Memoria este valabilă doar pentru sesiunile noi. Versiunea beta din 25 mai menționa deja persistența deciziilor între sesiuni; articolul detaliază mecanismul.
Qwen Code v0.24.0 izolează agentul la nivelul kernelului în Linux și schimbă hook-urile bash
16 septembrie — La două zile după v0.23.4, Qwen Code v0.24.0 adaugă în Linux un sandbox bazat pe kernel prin bubblewrap (bwrap), fără container, drepturi root, daemon sau imagine. Opțional, acesta repornește CLI-ul în spatele unei vizualizări doar pentru citire a sistemului de fișiere, în care numai spațiul de lucru și câteva directoare (temporare, cache, Qwen, Git) rămân inscriptibile; qwen sandbox afișează configurația, iar --verify testează izolarea. Autorul PR-ului îi enumeră limitele: lipsa unui spațiu de nume PID separat, socket-uri Unix ale gazdei accesibile, setări Git și Qwen modificabile. Schimbare incompatibilă (breaking change): în hook-urile executate în bash, $QWEN_PROJECT_DIR și echivalentele sale Claude și Gemini, citite din mediu în loc să fie substituite, trebuie încadrate între ghilimele duble. web_search este limitat per sesiune (200 în mod implicit, maximum 10.000), un buget precum +500k din mesaj dimensionează un tur întreg, iar mesageria între sesiuni este activată în mod implicit.
Devin lansează Code Scans, audituri ale întregii baze de cod ghidate de un obiectiv
16 septembrie — Cognition lansează Code Scans în Devin: se pornește de la un obiectiv amplu, nu de la o modificare precisă, eventual cu propriile criterii (standardele echipei, grila de accesibilitate, cerințele unei migrări), iar Devin investighează baza de cod, își prioritizează constatările, le discută și apoi deschide pull request-urile solicitate. Pornită prin /scan în aplicația web și menționată deja în notele de versiune din 2 septembrie, scanarea preia arhitectura MapReduce agentică (Agentic MapReduce) din Devin Security Swarm, prezentată în iulie, în patru faze: planificare, împărțire în loturi, explorare în paralel, sinteză. Cognition publică două teste: pe Dioxus, o compilare debug completă a 22 de crates scade de la 58,6 la 21,0 secunde, adică o reducere de 64%; o scanare SEO a devin.ai și cognition.com identifică 44 de constatări, după care scorul Ahrefs al devin.ai crește de la 87 la 92, iar numărul paginilor sale lente scade cu 73%. Nu este precizat niciun tarif.
Claude for Small Business ajunge la 43 de fluxuri de lucru și 27 de integrări noi
15 septembrie — Într-un articol pe care monitorizarea noastră din 15 septembrie nu îl identificase, Anthropic extinde Claude for Small Business, pluginul său pentru întreprinderi mici lansat în mai cu 15 fluxuri de lucru (workflows). Acesta are acum 43, cu 27 de integrări noi, printre care Shopify, Salesforce, TikTok, Atlassian, Zoom, Xero, Gusto, Square, Stripe și Zapier, și revendică peste 900.000 de instalări. Fiecare flux pornește în modul de aprobare, iar autonomia se configurează separat pentru fiecare flux, într-un mod reversibil. Anthropic relansează și programul de instruire: un turneu de toamnă împreună cu Tenex în 10 orașe americane, peste 150 de organizații de formare acreditate pentru mai mult de 750 de ateliere și 14 webinare ale partenerilor. Oferta este disponibilă în toate abonamentele cu plată; bilanțul turneului de primăvară fusese publicat pe 10 septembrie.
🔗 Articolul Anthropic despre Claude for Small Business
ElevenLabs lansează Reception, un recepționer IA pentru întreprinderile mici
16 septembrie — ElevenLabs lansează Reception, un recepționer IA pentru întreprinderile mici, construit pe platforma sa ElevenAgents. Acesta răspunde 24 de ore din 24 la întrebări despre servicii, program sau adresă, în limba apelantului, apoi programează întâlnirea în calendar, fie preluând apelurile când echipa nu răspunde, fie după închidere. Serviciul are propriul site, reception.ai, și poate fi încercat gratuit timp de 14 zile, cu 30 de minute de apeluri.
| Abonament Reception | Preț lunar fără taxe | Minute de apel incluse |
|---|---|---|
| Basic | 29 de dolari | 75 |
| Plus | 79 de dolari | 275 |
| Premium | 199 de dolari | 1 000 |
| Enterprise | La cerere | Personalizat |
Toate abonamentele includ peste 70 de limbi, Google Calendar, Calendly, Zapier, webhook-uri și un server MCP.
🔗 Prezentarea Reception, de ElevenAgents 🔗 Tarifele Reception
Synthesia își deschide Interactive Avatar API, cu avatare în timp real la 0,10 euro pe minut
16 septembrie — Synthesia face disponibil în general Interactive Avatar API, care integrează într-un produs avatare capabile să asculte, să vorbească și să răspundă în timp real. Clientul furnizează propriul LLM, propria bază de cunoștințe și propria logică; Synthesia gestionează chipul, vocea și sincronizarea buzelor. Avatarul se alătură unei săli LiveKit ca participant video printr-un plugin care, potrivit întrebărilor frecvente, acceptă în prezent doar agenți LiveKit scriși în Python. API-ul este facturat în funcție de utilizare, la 0,10 euro pe minut, fără angajament, cu 500 de minute oferite gratuit. Un plugin Pipecat și o ofertă completă, cu LLM, cunoștințe și voce gestionate, sunt anunțate „în curând”, fără o dată precisă. Synthesia publicase în iulie cadrul de cercetare al modelelor sale de avatare interactive.
🔗 Anunțul Synthesia pe X 🔗 Pagina Interactive Avatars a Synthesia
Koa, modelul CRM al Salesforce construit pe Nemotron 3 Super
15 septembrie — La Dreamforce, Salesforce a prezentat Koa, primul său model de raționament dedicat gestionării relațiilor cu clienții (CRM), obținut prin post-antrenarea NVIDIA Nemotron 3 Super cu NeMo RL, NeMo Gym și NeMo AutoModel pe un set de date sintetice. Salesforce controlează ponderile și execută modelul pe propria infrastructură; potrivit Salesforce, nu au fost folosite date ale clienților nici pentru antrenare, nici pentru inferență. Pe CRM Bench, propriul său benchmark (actualizarea unei oportunități, direcționarea unui caz, planificarea unei reveniri), Koa egalează sau depășește modelele de ultimă generație, cu de trei ori mai puține erori, fără ca modelele comparate să fie numite. Folosit deja intern în Slack, acesta intră în octombrie într-un program-pilot ca model selectabil în Agentforce, inclusiv la Formula 1 și Xero, înaintea unei disponibilități generale așteptate în iarna anului 2026 în regiunile americane.
🔗 Articolul NVIDIA despre Jensen Huang la Dreamforce
Runway detaliază moderarea în timp real a viitoarelor sale modele video
16 septembrie — Runway intenționează să lanseze modele de generare video în timp real „în lunile următoare” și explică modul în care le va modera. În difuzare continuă (streaming), utilizatorul vede videoclipul înainte de orice verificare finală. Prin urmare, Runway a conceput și testat un sistem mai rapid: verificarea accelerată a datelor de intrare, moderare sincronă care va analiza imaginile fluxului și va întrerupe difuzarea de îndată ce apare conținut problematic, apoi verificarea videoclipului complet înainte de orice descărcare sau distribuire. Clasificatorul, CoPE-B de la Zentropi, este un adaptor LoRA pe Gemma-4-26B-A4B-it, un mixture of experts cu 25,2 miliarde de parametri, dintre care 3,8 miliarde activi; verificarea durează în medie mai puțin de 0,5 secunde. În teste, unele intrări aflate la limită au permis afișarea pentru scurt timp a unui conținut interzis înainte de întrerupere. Sistemul se va adăuga protecțiilor existente ale Runway, iar videoclipurile în timp real vor include, la fel ca celelalte creații ale sale, semnale de proveniență C2PA.
Pe scurt
- Zed 1.20.1 adaugă Gemini 3.8 Flash — versiunea stabilă săptămânală a editorului aduce și o animație opțională a cursorului, deschiderea fișierelor Markdown în previzualizare randată și binare macOS și Linux cu aproximativ 25 % mai mici; aceasta remediază o defecțiune care putea expune fișiere private colaboratorilor prin căutarea în proiect. 🔗 sursă
- Replit lansează în versiune beta conectorii personalizați (Custom Connectors) — administratorii unui spațiu de lucru pot declara aici un API REST prin HTTPS, autentificat cu o cheie API, pentru ca Agent să îl utilizeze dincolo de conectorii oficiali; documentația menționează clienții Pro și Enterprise, dar un chenar rezervă versiunea beta pentru Enterprise. 🔗 sursă
- NVIDIA încredințează unor agenți portarea TileGym către cuTile Rust — la opt zile după lansarea CUDA Rust, o skill multi-agent livrată în TileGym a portat cei 24 de operatori publici ai bibliotecii, care păstrează în medie 99,5 % din performanțele cuTile Python în 347 de configurații măsurate pe DGX B200. 🔗 sursă
- OpenAI publică un ghid pentru analizele din Admin Console — vizualizările Usage, Insights și Outcomes, ultima măsurând proporția de commit-uri fuzionate cu contribuții de la Codex, trebuie să coreleze utilizarea ChatGPT Work și Codex cu rezultatele; rentabilitatea investiției de 245 % menționată este în mod explicit ipotetică, iar documentația asociată rămânea de negăsit la momentul verificării noastre. 🔗 sursă
- API-ul OpenAI reglementează crearea cheilor — înscrisă în changelog pe 15 septembrie, la cinci zile după introducerea datelor de expirare, secțiunea API Key Governance le permite administratorilor să autorizeze doar cheile conturilor de serviciu, doar cheile de proiect deținute de un utilizator sau să blocheze orice cheie nouă; cheile existente nu se modifică. 🔗 sursă
- Copilot: solicitările de suplimentare a bugetului devin disponibile general — în Copilot Business și Enterprise cu facturare în funcție de utilizare, un membru care și-a epuizat creditele AI poate solicita un buget suplimentar; proprietarii și administratorii de facturare stabilesc suma și o aprobă, ceea ce restabilește imediat accesul. 🔗 sursă
- AI Scan pentru pull request-uri nu mai necesită configurația implicită CodeQL — detectarea vulnerabilităților cu ajutorul AI în pull request-uri se extinde la depozitele eligibile fără această configurație, în previzualizare publică pentru clienții GitHub Advanced Security pe github.com; GitHub Enterprise Server nu este acceptat. 🔗 sursă
- Configurațiile GitHub Advanced Security devin obligatorii pentru organizații — începând cu 15 septembrie, administratorii întreprinderii îi pot împiedica pe administratorii organizației, și nu doar pe proprietarii depozitelor, să modifice configurațiile de securitate stabilite la nivelul întreprinderii. 🔗 sursă
- GitHub dezactivează SHA-1 în HTTPS — așa cum a fost anunțat pe 20 aprilie, changelog-ul din 15 septembrie confirmă încetarea utilizării SHA-1 în conexiunile HTTPS către github.com și CDN-urile sale partenere, inclusiv GitHub Enterprise Cloud; sunt vizate browserele, clienții API și Git prin HTTPS, dar nu și GitHub Enterprise Server. 🔗 sursă
- MiniMax H3 devine disponibil fără server (serverless) pe Together AI — anunțat într-un tweet din 15 septembrie, la ora 16:58, ora Pacificului, modelul video deschis cu 33 de miliarde de parametri, care generează clipuri de 4 până la 15 secunde, cu rezoluție de până la 2K și sunet stereo nativ, este afișat acolo la prețul de 0,1391 dolari per videoclip. 🔗 sursă
- MiniMax prezintă H3 IP Edition — în bilanțul conferinței sale din Tokyo cu KAGAMI AI, MiniMax afirmă că a dezvăluit o ediție H3 asociată unor proprietăți intelectuale japoneze licențiate oficial, fără un catalog de licențe, o dată sau un tarif. 🔗 sursă
- Runway adaugă cinci modele terțe prin colecția sa Fall 2026 — Fish Audio S2.1 Pro, Cartesia Sonic 3.6, MiniMax H3 Max, FLUX Video Upscale și FLUX Video Edit se alătură platformei, fără un tarif anunțat; mai multe erau deja disponibile în altă parte, precum FLUX Video Upscale la Black Forest Labs din 20 august și H3 Max din 27 august. 🔗 sursă
- Luma lansează Camera Angles — publicată pe 15 septembrie, la ora 16:26, ora Pacificului, funcția Luma Agents regenerează subiectul unei singure fotografii din unghiurile alese, păstrând detaliile, fără un model numit sau cifre. 🔗 sursă
- Grok Voice ajunge pe fal — platforma de inferență oferă modelul vocal SpaceXAI în Speech to Speech și în timp real; potrivit fal, acesta răspunde în 0,70 secunde și costă 0,00083 dolari pe secundă, iar un atelier în direct cu SpaceXAI este programat pentru 22 septembrie. 🔗 sursă
- OpenText și Cohere încheie un parteneriat pentru sectoarele reglementate — anunțat la conferința ALL IN AI din Montréal, parteneriatul va integra North și modelele Cohere în agenții OpenText Aviator, care pot fi implementați local sau într-un cloud privat, public ori suveran; oferta comună este așteptată la clienți la începutul anului 2027. 🔗 sursă
- Manus încheie parteneriate de formare în Singapore — agentul este inclus în SkillsFuture AI Subscription, care oferă șase luni de acces gratuit singaporezilor eligibili înscriși la anumite cursuri de AI, și în Singtel AI Pass; o provocare între campusuri a atras peste 1 100 de înscrieri, iar Manus lansează un apel global pentru parteneri de învățare. 🔗 sursă
- Universitatea din Manchester prognozează poluarea aerului cu Earth-2 — reantrenat în două zile pe un nod cu 8 GPU-uri al supercomputerului Isambard-AI, Earth-2 CorrDiff acoperă întregul Regat Unit la o rezoluție de 2 până la 3 km², iar echipa promite să publice datele și workflow-urile în regim open source. 🔗 sursă
- Spitalul de Copii din Philadelphia modelează inimi în câteva secunde — construit pe framework-ul open source MONAI, serviciul CHOP produce modele cardiace care necesitau aproximativ patru ore de muncă, fiind prevăzute circa 200 de cazuri în acest an, iar instrumentele bazate pe Newton, aflate în curs de integrare, pot reduce simulările de amplasare a dispozitivelor la un timp aproape real. 🔗 sursă
- Google publică un studiu despre adolescenții americani și AI — realizat împreună cu RXN pe un eșantion de peste 1 000 de tineri cu vârste între 13 și 17 ani, studiul U.S. Future Report arată că 94 % dintre ei au folosit AI în ultimul an și că 55 % verifică răspunsurile prin confruntarea cu alte surse; nu este anunțat niciun produs. 🔗 sursă
- Perplexity publică un ghid despre detectoarele de text generat de AI — exemplul său, prezentat ca ipotetic, arată că un detector care clasifică greșit 2 % dintre textele scrise de oameni poate semnala 64 de articole din 1 000, dintre care 19 scrise de oameni, adică o rată de eroare de aproape 30 %; ghidul recomandă ca o semnalare să fie tratată drept începutul unei verificări. 🔗 sursă
- GiniGEN AI clasifică 425 de modele OpenRouter — articol comunitar publicat pe blogul Hugging Face: clasamentul adaugă latența până la primul token, măsurată pe 329 de modele, și un scor de calitate pentru limba coreeană; doar 8,5 % dintre modelele evaluate obțin calificativul A pentru formele onorifice și 9,4 % pentru instituțiile coreene. 🔗 sursă
Ce înseamnă acest lucru
Agentul devine interfața, iar alegerea modului dispare. În noul Claude, utilizatorul nu mai alege între o conversație și un spațiu de lucru: Claude alege între căutarea web, fișiere și cod, apoi generează un document sau o prezentare. Delta aplică aceeași logică livrării codului, cu o revizuire în firul conversației și o comandă /land care înlănțuie commit-ul, CI și fuzionarea în locul unui pull request. Devin Code Scans pornește de la un obiectiv, nu de la o modificare, iar Grok Build reține de la o sesiune la alta convențiile și deciziile unui proiect. Controlul uman își schimbă locul fără să dispară: modul Manual este implicit la Claude, echipa trebuie să aprobe înainte de fuzionare la Zed, iar constatările sunt discutate înaintea oricărui pull request la Devin.
Agenții intră și în circuitul comercial. OpenAI testează Sponsored Agents care preiau controlul de la o reclamă, Google integrează Business Agent în reclamele YouTube și facilitează plata prin UCP, iar ambele separă agentul mărcii de restul: conversație semnalată și distinctă de răspunsurile independente ale ChatGPT într-un caz, versiune beta disponibilă comercianților prin înscriere în celălalt. Pentru întreprinderile mici, Claude for Small Business revendică 43 de workflow-uri și peste 900 000 de instalări, iar ElevenLabs vinde, începând de la 29 de dolari pe lună, un recepționer care programează întâlniri. Synthesia percepe 0,10 euro pe minut pentru un avatar care vorbește în produsul clienților săi, iar Salesforce transformă Koa într-un model selectabil în Agentforce: agentul nu se mai limitează la asistarea întreprinderii, ci li se adresează clienților în numele acesteia.
Încrederea devine un argument de vânzare, iar furnizorii caută să o facă verificabilă. Cohere și Aleph Alpha pun accentul pe suveranitate, având un sediu dublu la Berlin și Toronto, iar Model Vault furnizează un token de atestare pe care clientul îl controlează cu ajutorul cheilor publice ale producătorului hardware-ului. Mistral oferă Firefox un angajament de retenție zero, Salesforce păstrează ponderile Koa în propria infrastructură, Runway intenționează să întrerupă un flux video imediat ce apare conținut problematic, OpenAI le permite administratorilor să restricționeze crearea cheilor API, iar Qwen Code își izolează agentul la nivelul kernel-ului și publică lista limitărilor sale. Cele mai solide garanții sunt cele pe care clientul le poate verifica singur; un benchmark intern precum CRM Bench sau o afirmație de tipul „nici măcar noi”, fără menționarea unui audit terț, rămân simple afirmații.
În cele din urmă, calculul se lovește de limitele electricității. Vera Rubin NVL72 afișează un debit de până la 3,7 ori mai mare decât GB300 NVL72, potrivit NVIDIA, însă cele mai concrete anunțuri din aceste două zile se referă la megawați: Lambda găzduiește 19 noduri în bugetul energetic destinat unui număr de 16, o fabrică de AI din Santa Clara își reduce consumul de la 4 la 3 MW la solicitarea furnizorului său, iar AEMA cere conectări mai rapide în schimbul unei flexibilități verificabile. Debitul per rack rămâne argumentul tehnic, dar accesul la rețea determină viteza cu care aceste rack-uri sunt puse în funcțiune.
Surse
- Claude, Claude Cowork și chat-ul sunt acum un singur Claude
- Centrul de ajutor Claude, fuzionarea chat-ului cu Cowork
- Boris Cherny pe X, chat-ul și Cowork încep să fuzioneze
- Claude Devs pe X, Design, Slides și Docs în Claude Code
- Zed, versiunea beta publică Delta
- Zed pe X, comanda /land
- NVIDIA, Vera Rubin NVL72 în MLPerf Inference v6.1
- NVIDIA, blogul în direct de la AI Infra Summit
- NVIDIA, lansarea AI Energy Management Alliance
- AI Energy Management Alliance, site-ul oficial
- OpenAI, Regândirea publicității cu AI
- Google, actualizări privind comerțul agentic pentru perioada sărbătorilor
- Cohere, acord definitiv cu Aleph Alpha
- Cohere pe X, citat de Aidan Gomez
- Cohere pe X, Confidential Computing în Model Vault
- Cohere, pagina produsului Model Vault
- Mistral AI, parteneriat cu Mozilla
- SpaceXAI, Memory în Grok Build
- Qwen Code, notele versiunii v0.24.0
- Cognition, Prezentarea Code Scans
- Claude, noile workflow-uri Claude for Small Business
- ElevenLabs, Prezentarea Reception
- Reception, tarife
- Synthesia pe X, Interactive Avatar API
- Synthesia, pagina Interactive Avatars
- NVIDIA, Jensen Huang la Dreamforce
- Runway, Moderare în timp real
- Zed, notele versiunii 1.20.1
- Replit pe X, Custom Connectors în versiune beta
- NVIDIA, portarea TileGym către cuTile Rust
- OpenAI, corelarea utilizării AI cu valoarea pentru afaceri
- OpenAI, changelog-ul API-ului
- GitHub Changelog, solicitări de suplimentare a bugetului Copilot
- GitHub Changelog, AI Scan fără configurația implicită CodeQL
- GitHub Changelog, configurații GitHub Advanced Security obligatorii
- GitHub Changelog, încetarea utilizării SHA-1 în HTTPS
- Together AI pe X, MiniMax H3 fără server
- MiniMax pe X, H3 IP Edition
- Runway pe X, colecția Fall 2026
- Luma pe X, Camera Angles
- fal pe X, Grok Voice
- OpenText, parteneriat cu Cohere
- Manus pe X, Învățați AI cu Manus
- NVIDIA, Earth-2 și poluarea aerului în Regatul Unit
- NVIDIA, CHOP și modelarea cardiacă
- Google, U.S. Future Report despre adolescenți și AI
- Perplexity, ghid despre detectoarele de text generat de AI
- Hugging Face, clasamentul GiniGEN AI al modelelor OpenRouter