ai-powered-markdown-translatorArtikel mit gpt-5.6-sol aus dem Französischen ins Deutsche übersetzt.
An diesem Mittwoch führt Anthropic Chat und Cowork zu einem einzigen Claude zusammen, der seine Werkzeuge selbst auswählt, und startet Claude Docs und Claude Slides als Beta. Zed öffnet Delta für alle und ersetzt den Pull Request durch eine Review im Thread, während NVIDIA Vera Rubin NVL72 bei MLPerf Inference v6.1 debütieren lässt, zu einem Zeitpunkt, an dem sich Strom als entscheidende Einschränkung für KI-Fabriken erweist. Marken-Agenten halten zudem Einzug in die Werbung, sowohl bei ChatGPT als auch auf YouTube, während Cohere die endgültige Vereinbarung mit Aleph Alpha unterzeichnet und Mistral in Firefox Einzug hält.
Ein einziger Claude: Chat und Cowork verschmelzen, Claude Docs und Claude Slides starten als Beta
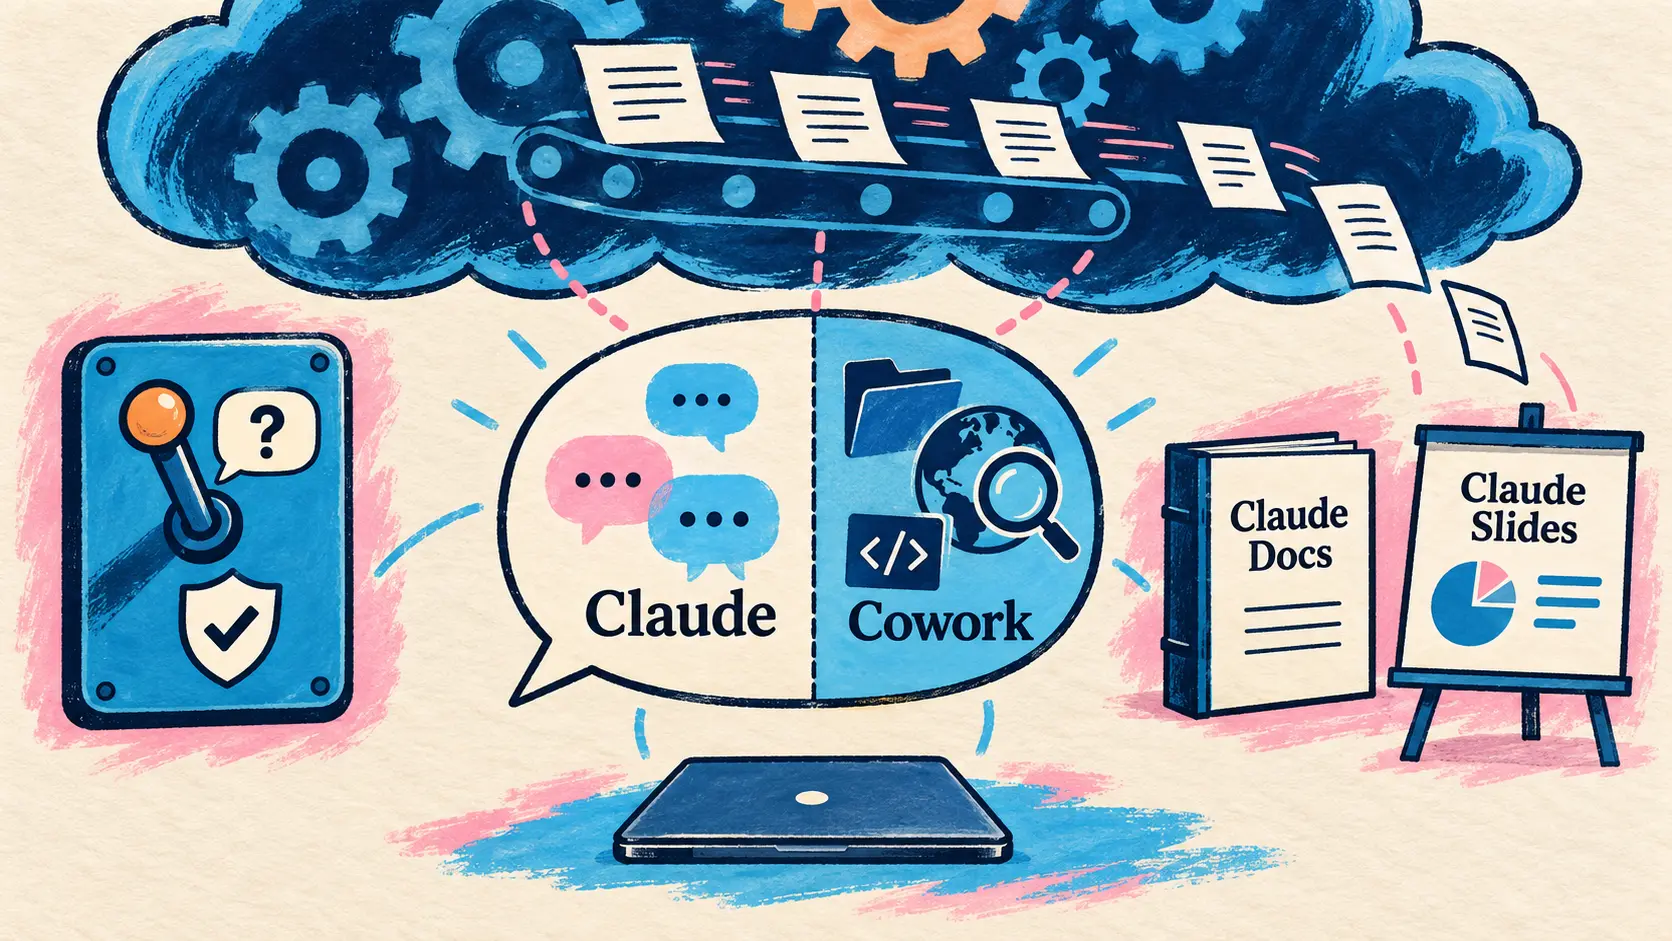
16. September — Anthropic führt Chat und Claude Cowork zusammen: Es muss kein Modus mehr ausgewählt werden, Claude entscheidet selbst, ob er im Web suchen, Dateien lesen oder Code ausführen soll, und liefert fertige Dateien. Lang laufende Aufgaben werden in der Cloud fortgesetzt, selbst wenn der Computer ausgeschaltet ist; lokale Dateien, der integrierte Browser und die Computersteuerung (computer use, als Beta für Pro und Max) erfordern jedoch, dass Claude Desktop geöffnet bleibt.
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇩🇪 Heute beginnen Chat und Cowork, zu einem einzigen Claude zu verschmelzen. Die Richtung: ein einziger Claude, der den Kontext von allem bewahrt, woran Sie arbeiten, ganz gleich, wo Sie sich befinden. — Boris Cherny (Anthropic) auf X
Die neuen Claude Docs und Claude Slides erstellen Dokumente und Präsentationen, und das im April gestartete Claude Design funktioniert nun auch in Unterhaltungen. Alle drei befinden sich in den kostenpflichtigen Tarifen in der Beta, wobei Enterprise-Administratoren über ihre Aktivierung entscheiden. Jede Erstellung lässt sich über einen Link teilen; Präsentationen können als PowerPoint oder PDF exportiert werden. Im standardmäßig eingestellten manuellen Modus fragt Claude vor jeder Aktion nach; im Auto-Modus gehen jeder Aktion automatisierte Sicherheitsprüfungen voraus.
| Tarif oder betroffene Zielgruppe | Angekündigter Zeitplan |
|---|---|
| Pro und Max (Web, Desktop, Mobil) | „Im Laufe der kommenden Wochen“, ohne erforderliche Aktion |
| Team und Free | „Demnächst“, ohne Termin |
| Enterprise | Mindestens 30 Tage Vorankündigung vor jeder Änderung |
Die Umstellung ist endgültig, doch Aufgaben, Projekte, Connectors, Skills und Artefakte aus Cowork bleiben erhalten. Zum Start weist das Hilfe-Center auf Einschränkungen hin: kein Hinzufügen aus GitHub und kein Verzweigen von Unterhaltungen, Inkognito-Unterhaltungen werden in der alten Oberfläche geöffnet, ältere Cowork-Aufgaben fehlen in der Suche und Dispatch ist für neue Nutzer geschlossen. Chat und Cowork teilten bereits seit dem 7. Juli Projekte und Artefakte sowie seit dem 25. August den Speicher.
🔗 Beitrag von Anthropic 🔗 Hilfe-Center
Design, Slides und Docs funktionieren auch in Claude Code
Am selben Tag teilt @ClaudeDevs mit, dass Claude Design, Claude Slides und Claude Docs auch in Claude Code funktionieren: Dort kann man etwa Unterlagen für eine Design-Review (design review deck) oder einen Oberflächenentwurf anfordern, indem man Claude auf die echten Dateien und RFCs des Repositorys verweist, das Ergebnis selbst oder in der Unterhaltung bearbeiten und anschließend den Link teilen. Für Design ist das keine Premiere, da der Befehl /design bereits seit dem 17. August als Research Preview verfügbar ist: Neu sind Slides und Docs. Der Tweet nennt weder eine Mindestversion noch Tarife oder Dokumentation, und die Versionshinweise der jüngsten veröffentlichten Version erwähnen die Funktionen nicht.
🔗 Ankündigung von @ClaudeDevs auf X
Zed öffnet Delta als öffentliche Beta und ersetzt den Pull Request durch eine Review im Thread
16. September — Zed öffnet Delta für alle. Das am 12. August zunächst mit Registrierung und am 4. September für registrierte Nutzer unter Windows gestartete Werkzeug kann nun frei für macOS, Linux und Windows heruntergeladen, ohne Installation im Web verwendet und mit seinen Diskussionsthreads (threads) auf Mobilgeräten verfolgt werden.
Der zentrale Gedanke ist die Zusammenarbeit ohne Commit oder Push. Ein Teammitglied, das in die Unterhaltung mit dem Agenten eingeladen wird, sieht dieselben Arbeitskopien (worktrees), kann sie auf dem eigenen Rechner übernehmen, den Agenten zu seinen Entscheidungen befragen oder die Arbeit fortsetzen, wenn der Autor die Verbindung trennt. Die am 10. September als Vorschau gezeigte Code-Review ersetzt den Pull Request: Ein Unterthread führt den Reviewer durch die Änderungen des Branches, einschließlich des Kontexts des ursprünglichen Agenten, und nutzt dabei eine isolierte Kopie der Worktrees. Der Befehl /land beauftragt den Agenten anschließend damit, alles in einem einzigen Commit zusammenzuführen, die CI zu durchlaufen, nach der Zustimmung des Teams zu mergen und den Branch zu löschen.
Im Delta-Repository sind Pull Requests seit der Woche vor der Ankündigung deaktiviert, und 33 Personen haben dort seitdem 570 Änderungen gemergt; das Repository des Editors Zed bleibt „vorerst“ auf GitHub. Unter der Haube ergänzt DeltaDB die Versionierung von Git um inkrementelle Deltas, die zwischen zwei Commits die Änderungen und Nachrichten von Menschen wie Agenten bewahren; der Commit bleibt der Kontrollpunkt, sodass ein Teammitglied, das Delta nie öffnet, ein gewöhnliches Git-Repository sieht.
Zed erklärt, GitHub.com ersetzen zu wollen, und bezeichnet diese Arbeitsweise als Continuous Engineering (continuous engineering); die undatierte Roadmap sieht Git-Speicherung in DeltaDB vor und erwägt langfristig eine CI-artige Prüfung im Thread. Delta ist während der Beta kostenlos, kostenpflichtige Angebote sind „demnächst“ angekündigt, jedoch ohne Preis oder Termin, und Zed verspricht, eine kostenlose Version beizubehalten.
🔗 Zeds Beitrag zur öffentlichen Beta von Delta 🔗 Zeds Thread zum Befehl /land
Vera Rubin NVL72 debütiert bei MLPerf Inference v6.1 mit bis zum 3,7-Fachen des Durchsatzes von GB300 NVL72
16. September — NVIDIA lässt Vera Rubin NVL72, seine Rack-Plattform der nächsten Generation, bei MLPerf Inference v6.1 debütieren, dessen Ergebnisse MLCommons veröffentlicht, und reicht dabei Vorabresultate (preview) ein. Laut NVIDIAs Vergleichen zwischen den eigenen Einreichungen erreicht das Rack bei Qwen3-VL in Offline-, Server- und interaktiven Szenarien mit vLLM und NVIDIA Dynamo bis zum 3,7-Fachen des Durchsatzes von GB300 NVL72 sowie bei DeepSeek-R1 mit TensorRT-LLM bis zum 2,5-Fachen. Auch Nebius hat Vorabresultate für Vera Rubin NVL72 eingereicht.
NVIDIA führt diese Zuwächse auf die gemeinsame Entwicklung von Hardware und Software zurück: NVFP4-Präzision für Gewichte, Attention und KV-Cache, disaggregiertes Serving, das Prefill (prefill) und Decoding trennt, großskalige Expertenparallelität und eine NVLink-Domäne der sechsten Generation, für die NVIDIA einen zehnmal höheren Paketdurchsatz als bei Standard-Ethernet beansprucht. Auch für die aktuelle Generation werden Zahlen veröffentlicht:
| Test in MLPerf Inference v6.1 | Eingereichtes System | Von NVIDIA veröffentlichtes Ergebnis |
|---|---|---|
| DeepSeek-R1 offline, 72 bis 288 GPU | GB300 NVL72, 1 bis 4 Racks | 99 % Skalierungseffizienz |
| WAN 2.2, Text-zu-Video | GB300 NVL72 | 0,65 720p-Videos pro Sekunde, 5,7 s pro Video |
| Qwen3-VL, v6.1 gegenüber v6.0 | GB300 NVL72 | Bis zum 1,6-Fachen, dank der Software |
| Edge-Agentic, neuer Test (Qwen3.6-27B) | Jetson AGX Thor, TensorRT Edge-LLM | Einreichung ohne Zahlenangabe im Beitrag |
NVIDIA berichtet außerdem über nach Ablauf der Frist erzielte Zuwächse bei GPT-OSS-120B und DLRMv3, die MLCommons noch nicht überprüft hat. Das Unternehmen nennt 19 Partner, darunter acht mit Blackwell-NVL72-Systemen über mehrere Nodes hinweg, und verweist auf den künftigen Test MLPerf Endpoints von MLCommons, der die Messung agentischer Inferenz standardisieren soll.
🔗 NVIDIA Vera Rubin NVL72 liefert bei seinem Debüt in MLPerf Inference v6.1 führende Leistung
Strom im Zentrum der KI-Fabriken: DSX MaxLPS bei Lambda und die AEMA-Allianz
15. und 16. September — Zwei Ankündigungen von NVIDIA rücken das Stromnetz in den Mittelpunkt der KI-Bereitstellung, beide unter Beteiligung von Emerald AI: Eine von dessen Software gesteuerte KI-Fabrik reduzierte auf Anforderung eines Stromversorgers ihre Last, anschließend gründeten Emerald AI, Google und NVIDIA eine Allianz für flexible Data Center.
AI Infra Summit: Lambda validiert DSX MaxLPS, eine KI-Fabrik reduziert auf Anforderung des Netzes ihre Last
15. September — Auf dem AI Infra Summit befasste sich die Keynote von Ian Buck (NVIDIA) mit den pro Megawatt produzierten Tokens in KI-Fabriken (AI factories). Lambda validierte DSX MaxLPS, NVIDIAs Software zur Überwachung des Stromverbrauchs von GPU und Racks sowie zur lastabhängigen Neuverteilung der Leistung: 19 HGX-B200-Nodes liefen innerhalb des Strombudgets von 16 Nodes bei voller Leistung, wobei der Durchsatz von rund 4 auf 5 Millionen Tokens pro Sekunde stieg (+24 %) und die Leistung pro Watt um 23 % zunahm. NVIDIA prognostiziert für Vera Rubin NVL72 innerhalb desselben Budgets bis zu 40 % mehr GPU-Kapazität, „in geeigneten Umgebungen“. An einem Abend im August ließ ein Signal von Silicon Valley Power eine durch Emerald AI Conductor gesteuerte KI-Fabrik in Santa Clara automatisch von 4 auf 3 MW herunterfahren, ohne die priorisierte Inferenz zu unterbrechen; seitdem wurden mehr als 200 Signale mit einer Reaktionszeit von weniger als einer Minute befolgt. DSX Flex, das solche Signale verarbeitet, soll erstmals kommerziell in einer 96-MW-Vera-Rubin-Fabrik in Manassas, Virginia, dediziert eingesetzt werden.
AEMA, eine Allianz für Data Center, die sich an das Stromnetz anpassen
16. September — Emerald AI, Google und NVIDIA gründen die AI Energy Management Alliance (AEMA), eine Koalition für Data Center, die ihren Verbrauch an den Zustand des Stromnetzes anpassen können: Lasten verlagern, Speicher anzapfen, eine zugeordnete Erzeugung nutzen oder auf Störungen reagieren. Ihre Grundsätze: Vor dem Netzanschluss die Anforderungen für das Durchfahren von Störungen (ride-through), die Lastreduzierung (curtailment) und die Störungsreaktion festlegen, Metriken standardisieren, schnellere Anschlusswege für nachprüfbare Flexibilitätszusagen schaffen und Kosten entsprechend den tatsächlichen Auswirkungen verteilen. Die Allianz konzentriert sich auf die Vereinigten Staaten; ihre Startpartner werden nicht genannt. Auf ihrer Website nennt sie zwei Potenziale: 100 GW, die sich mit moderat flexiblen Data Centern im bestehenden Netz erschließen ließen, sowie 733 Millionen Dollar vermiedene Kosten pro GW neuer flexibler Data Center. NVIDIA und Emerald AI hatten bereits am 31. März auf der CERAWeek flexible KI-Fabriken vorgestellt.
🔗 NVIDIAs Beitrag über AEMA 🔗 Website der AEMA
Marken-Agenten halten bei ChatGPT und auf YouTube Einzug in die Werbung
16. September — Am selben Tag integrieren OpenAI und Google in den Vereinigten Staaten den Konversationsagenten einer Marke in Werbeformate: bei OpenAI als Test mit ausgewählten Werbetreibenden, bei Google als Beta mit Registrierung für Händler.
ChatGPT Ads testet Sponsored Agents und bindet HubSpot und Shopify an
OpenAI ergänzt seine Werbeplattform ChatGPT Ads auf beiden Seiten um KI. Bei den Sponsored Agents kann ein Klick auf eine Anzeige in ChatGPT eine deutlich gekennzeichnete Unterhaltung mit einem von der Marke gesponserten Agenten öffnen, bevor ein Link zu deren Website folgt. OpenAI stellt klar, dass dieser Austausch von den unabhängigen Antworten von ChatGPT getrennt und von der ursprünglichen Unterhaltung isoliert ist.
| Neuerung bei ChatGPT Ads | Stand vom 16. September |
|---|---|
| Sponsored Agents | Test mit ausgewählten Werbetreibenden in den Vereinigten Staaten |
| Plugin Ads Manager, promptgesteuerte Kampagnen | Wird eingeführt |
| Vorgeschlagene Texte und Visuals im Ads Manager | Wird eingeführt |
| Personalisierung und Übersetzung von Texten | Gestartet, optional aktivierbar (opt-in) |
| HubSpot-Integration | Verfügbar |
| ChatGPT-Ads-App für Shopify | US-Händler, weitere ChatGPT-Ads-Märkte ab dem 23. September |
Der Beitrag nennt weder Preise noch die Zahl der Werbetreibenden. Die im Februar in ChatGPT getestete Werbung erhielt im Mai einen Ads Manager als Beta und im Self-Service (self-service); anschließend gab OpenAI am 31. August durch die Ausweitung dieses Self-Service einen annualisierten Umsatz von einer Milliarde Dollar an.
Google integriert Business Agent in YouTube-Werbung und baut den agentischen Handel aus
Google veröffentlicht seine Aktualisierungen für den agentischen Handel (agentic commerce) zum Weihnachtsgeschäft. Business Agent, der laut Google „Anfang dieses Jahres“ in Search eingeführt wurde, startet in den Vereinigten Staaten als Beta in YouTube-Werbung und erfordert eine Registrierung der Händler: Zuschauer können den Agenten zu Produkten befragen, ohne YouTube zu verlassen. AI performance insights, das den Share of Voice (share of voice) einer Marke in AI Mode und AI Overviews vergleicht, wird im Merchant Center in Australien, Kanada, Indien, Neuseeland und den Vereinigten Staaten verfügbar. Im Merchant Center ergänzt der Integrations-Hub für UCP (Universal Commerce Protocol), das von Google am 11. Januar vorgestellte Protokoll, die Übertragung des Warenkorbs auf die Website des Händlers und Tests des Bezahlvorgangs; Analysen sollen „demnächst“ folgen. Diese Funktionen werden schrittweise in den Vereinigten Staaten und anschließend „Anfang nächsten Jahres“ in Australien und Kanada eingeführt. Tapestry (Coach, Kate Spade) verkauft bereits über UCP in Search und der Gemini-App. Laut Google führen bewährte Verfahren für Produktfeeds im Folgemonat durchschnittlich zu 5 % mehr Conversions; bei Tests mit lululemon wurden die dialogorientierten Markenattribute in 50 % der relevanten Empfehlungen von AI Mode aufgegriffen.
🔗 Googles Beitrag über agentischen Handel
Cohere unterzeichnet die Vereinbarung mit Aleph Alpha und startet Confidential Computing in Model Vault
16. September — Cohere veröffentlicht mehrere Ankündigungen, darunter zwei für Kunden, die die Kontrolle über ihre Daten und ihre Technologie behalten möchten.
Aleph Alpha: endgültige Vereinbarung und Doppelsitz in Berlin und Toronto
Cohere und Aleph Alpha haben die endgültige Vereinbarung über ihren Zusammenschluss (definitive business combination agreement) unterzeichnet, dessen Vorhaben am 24. April angekündigt worden war. Das Gesamtunternehmen wird unter dem Namen Cohere firmieren, mehr als 1.000 Beschäftigte haben, einen Doppelsitz in Berlin und Toronto sowie ein Forschungszentrum am Standort von Aleph Alpha in Heidelberg unterhalten. Die Transaktion, deren Volumen nicht mitgeteilt wurde, steht noch unter dem Vorbehalt der letzten regulatorischen Genehmigungen; ihr Abschluss wird „im weiteren Verlauf dieses Jahres“ erwartet. Ilhan Scheer, Co-CEO von Aleph Alpha, wird dann Chief Operating Officer von Cohere und Mitgründer Samuel Weinbach Forschungsdirektor. Die Partnerschaft mit der Schwarz Gruppe wird auf deren souveräner Cloud STACKIT fortgesetzt.
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇩🇪 Keine Regierung und kein Unternehmen sollte sich zwischen leistungsfähiger KI und der Kontrolle über die eigene Technologie entscheiden müssen. Genau diese Überzeugung bewegt uns dazu, unsere Kräfte mit Aleph Alpha zu bündeln. Gemeinsam werden wir die weltweit wachsende Nachfrage nach leistungsfähiger und zugleich sicherer Frontier-KI bedienen. — Aidan Gomez (Cohere), zitiert von @cohere auf X
🔗 Cohere-Beitrag zur Vereinbarung
Confidential Computing in Model Vault im Early Access
Cohere führt Confidential Computing in Model Vault ein, seiner dedizierten und vollständig verwalteten Inferenzplattform, um Daten auch während der Verarbeitung und nicht mehr nur im Ruhezustand und bei der Übertragung zu schützen. Drei Mechanismen werden beschrieben: eine durchgängig verschlüsselte Inferenz, eine hardwaregestützte Isolation, die sich mit NVIDIA Confidential Computing bis zur GPU erstreckt, sowie ein signiertes Attestierungs-Token, das auf Anfrage verfügbar ist und sich mit den öffentlichen Schlüsseln des Hardwareherstellers überprüfen lässt. Cohere erklärt, dass niemand, „nicht einmal wir“, auf die Workloads des Kunden zugreifen könne, erwähnt jedoch kein externes Audit. Der Early Access ist einer begrenzten Gruppe von Beta-Kunden vorbehalten; Preise, ein Termin für die allgemeine Verfügbarkeit und eine Modellliste fehlen, und die Ankündigung beschränkt sich auf Tweets und eine Produktseite. Die Funktion war am 9. September als „demnächst verfügbar“ angekündigt worden.
🔗 Ankündigung von Cohere auf X 🔗 Produktseite von Model Vault
Mistral treibt Smart Window, den KI-Assistenten von Firefox, an
16. September — In einem gemeinsamen Beitrag geben Mistral AI und Mozilla bekannt, dass Smart Window, der noch in der Betaphase befindliche KI-Browsing-Assistent von Firefox, nun mit nicht näher bezeichneten Mistral-Modellen arbeitet. Der Assistent hilft dabei, komplexe Recherchen zu entwirren und Quellen aus geöffneten Tabs zusammenzutragen. Mistral stellt ihn zunächst Nutzern in Frankreich und Nordamerika bereit; Großbritannien und Deutschland sollen „im weiteren Verlauf dieses Jahres“ folgen. Standardmäßig werden Gespräche nicht auf den Servern von Mozilla gespeichert, und Partner wie Mistral verpflichten sich zu einer Null-Datenspeicherung (zero data retention). Für Mistral, das nach eigenen Angaben „traditionell“ Unternehmen bedient, eröffnet die Vereinbarung den Zugang zur breiten Öffentlichkeit. Arthur Mensch, Mitgründer und CEO von Mistral, spricht von zwei Verfechtern von Open Source, die zusammenarbeiten, und Anthony Enzor-DeMeo, CEO der Mozilla Corporation, ist der Ansicht, dass ein Browser kein einseitiger Trichter sein dürfe.
🔗 Gemeinsamer Beitrag von Mistral und Mozilla
Grok Build behält die Konventionen und Entscheidungen eines Projekts sitzungsübergreifend im Gedächtnis
16. September — SpaceXAI stattet seinen Coding-Agenten Grok Build mit einem Gedächtnis aus. Nach jedem abgeschlossenen Durchlauf liest Grok ihn im Hintergrund erneut, ohne die Sitzung zu blockieren, und hält in einer Markdown-Notiz fest, was dauerhaft relevant ist: Teamkonventionen, Entscheidungen und deren Begründung sowie Fakten zum Projekt, etwa den Befehl zum Starten der Tests. Ausgeschlossen sind der Aufgabenstatus, vorläufige Schlussfolgerungen, Geheimnisse und Inhalte, die bereits vom Repository oder dessen Dokumentation abgedeckt werden. Die Notizen werden nach Projekt geordnet, ergänzt um einen globalen Satz für überall geltende Präferenzen. Der Befehl /dream fasst sie in thematischen Dateien zusammen und wird zudem regelmäßig selbstständig ausgeführt, während /memory eine schreibgeschützte Browseransicht öffnet. Bei der Rückkehr zu einem Projekt liest Grok die Themen des Bereichs, in dem es arbeiten wird; das aktuelle Gespräch hat jedoch Vorrang vor den Notizen. Das Gedächtnis gilt nur für neue Sitzungen. In der Beta vom 25. Mai wurde bereits die sitzungsübergreifende Speicherung von Entscheidungen aufgeführt; der Beitrag beschreibt nun den Mechanismus im Detail.
Qwen Code v0.24.0 beschränkt den Agenten unter Linux auf Kernel-Ebene und ändert die bash-Hooks
16. September — Zwei Tage nach v0.23.4 fügt Qwen Code v0.24.0 unter Linux eine Kernel-basierte Sandbox über bubblewrap (bwrap) hinzu, ohne Container, Root-Rechte, Daemon oder Image. Optional startet es die CLI hinter einer schreibgeschützten Ansicht des Dateisystems neu, in der nur der Workspace und einige Verzeichnisse für temporäre Dateien, Cache, Qwen und Git beschreibbar bleiben; qwen sandbox zeigt die Konfiguration an und --verify testet die Beschränkung. Der Autor des PR führt die Einschränkungen auf: kein separater PID-Namespace, erreichbare Unix-Sockets des Hosts sowie veränderbare Git- und Qwen-Einstellungen. Inkompatible Änderung (breaking change): In unter bash ausgeführten Hooks müssen $QWEN_PROJECT_DIR und die entsprechenden Claude- und Gemini-Varianten, die aus der Umgebung gelesen statt ersetzt werden, in doppelten Anführungszeichen stehen. web_search ist pro Sitzung begrenzt (standardmäßig 200, maximal 10.000), ein Budget wie +500k in der Nachricht dimensioniert einen gesamten Durchlauf, und die sitzungsübergreifende Nachrichtenübermittlung ist standardmäßig aktiviert.
Devin führt Code Scans ein: zielgerichtete Audits der gesamten Codebasis
16. September — Cognition führt Code Scans in Devin ein: Ausgangspunkt ist ein übergeordnetes Ziel statt einer konkreten Änderung, bei Bedarf ergänzt um eigene Kriterien wie Teamstandards, einen Barrierefreiheitskatalog oder die Anforderungen einer Migration. Devin untersucht daraufhin die Codebasis, priorisiert seine Erkenntnisse, erörtert sie und eröffnet anschließend die angeforderten Pull Requests. Der Scan, der in der Webanwendung über /scan gestartet wird und bereits in den Versionshinweisen vom 2. September erwähnt wurde, übernimmt die im Juli vorgestellte Agentic-MapReduce-Architektur (Agentic MapReduce) von Devin Security Swarm in vier Phasen: Planung, Aufteilung in Stapel, parallele Erkundung und Synthese. Cognition veröffentlicht zwei Versuche: Bei Dioxus sinkt die Dauer eines vollständigen Debug-Builds von 22 Crates von 58,6 auf 21,0 Sekunden, also um 64 %; ein SEO-Scan von devin.ai und cognition.com liefert 44 Befunde, woraufhin der Ahrefs-Score von devin.ai von 87 auf 92 steigt und der Anteil langsamer Seiten um 73 % zurückgeht. Preise werden nicht genannt.
Claude for Small Business wächst auf 43 Workflows und 27 neue Integrationen
15. September — In einem Beitrag, den unsere Übersicht vom 15. September nicht erfasst hatte, erweitert Anthropic Claude for Small Business, sein im Mai mit 15 Workflows (workflows) eingeführtes Plugin für kleine Unternehmen. Es umfasst nun 43 Workflows mit 27 neuen Integrationen, darunter Shopify, Salesforce, TikTok, Atlassian, Zoom, Xero, Gusto, Square, Stripe und Zapier, und verzeichnet nach eigenen Angaben mehr als 900.000 Installationen. Jeder Workflow startet im Genehmigungsmodus, und der Grad der Autonomie lässt sich für jeden Workflow einzeln und reversibel einstellen. Anthropic startet außerdem sein Schulungsprogramm neu: eine Herbsttour mit Tenex durch zehn US-amerikanische Städte, mehr als 150 zugelassene Schulungsorganisationen für über 750 Workshops und 14 Partner-Webinare. Das Angebot ist in allen kostenpflichtigen Tarifen verfügbar; die Bilanz der Frühjahrstour war am 10. September veröffentlicht worden.
🔗 Anthropic-Beitrag zu Claude for Small Business
ElevenLabs führt Reception ein, einen KI-Rezeptionisten für kleine Unternehmen
16. September — ElevenLabs führt Reception ein, einen auf seiner Plattform ElevenAgents basierenden KI-Rezeptionisten für kleine Unternehmen. Er beantwortet rund um die Uhr Fragen zu Dienstleistungen, Öffnungszeiten oder zur Adresse in der Sprache des Anrufers und bucht anschließend einen Termin im Kalender – wahlweise als Überlauf, wenn das Team nicht abnimmt, oder nach Geschäftsschluss. Der Dienst hat eine eigene Website, reception.ai, und kann 14 Tage lang mit 30 Gesprächsminuten kostenlos getestet werden.
| Reception-Tarif | Monatlicher Preis ohne Steuern | Enthaltene Gesprächsminuten |
|---|---|---|
| Basic | 29 Dollar | 75 |
| Plus | 79 Dollar | 275 |
| Premium | 199 Dollar | 1 000 |
| Enterprise | Auf Anfrage | Individuell |
Alle Tarife umfassen mehr als 70 Sprachen, Google Calendar, Calendly, Zapier, Webhooks und einen MCP-Server.
🔗 Einführung von Reception durch ElevenAgents 🔗 Preise von Reception
Synthesia öffnet seine Interactive Avatar API: Echtzeit-Avatare für 0,10 Euro pro Minute
16. September — Synthesia stellt seine Interactive Avatar API allgemein bereit, mit der sich Avatare in ein Produkt integrieren lassen, die in Echtzeit zuhören, sprechen und antworten können. Der Kunde bringt sein LLM, seine Wissensbasis und seine Logik mit; Synthesia übernimmt Gesicht, Stimme und Lippensynchronisation. Der Avatar tritt einem LiveKit-Raum über ein Plugin als Videoteilnehmer bei, das laut FAQ derzeit nur in Python geschriebene LiveKit-Agenten unterstützt. Die API wird nutzungsabhängig mit 0,10 Euro pro Minute ohne Vertragsbindung abgerechnet; 500 Minuten sind kostenlos enthalten. Ein Pipecat-Plugin und ein End-to-End-Angebot mit verwaltetem LLM, Wissen und verwalteter Stimme werden ohne Termin für „demnächst“ angekündigt. Synthesia hatte im Juli den Forschungsrahmen für seine interaktiven Avatar-Modelle veröffentlicht.
🔗 Ankündigung von Synthesia auf X 🔗 Synthesias Seite zu Interactive Avatars
Koa, das auf Nemotron 3 Super basierende CRM-Modell von Salesforce
15. September — Auf der Dreamforce hat Salesforce Koa vorgestellt, sein erstes speziell für Customer Relationship Management (CRM) entwickeltes Reasoning-Modell. Es entstand durch Post-Training von NVIDIA Nemotron 3 Super mit NeMo RL, NeMo Gym und NeMo AutoModel auf einem synthetischen Datensatz. Salesforce kontrolliert die Gewichte und betreibt das Modell auf seiner eigenen Infrastruktur; laut Salesforce wurden weder für das Training Kundendaten verwendet noch werden sie für die Inferenz genutzt. Bei CRM Bench, dem eigenen Benchmark des Unternehmens – Aktualisierung einer Verkaufschance, Weiterleitung eines Vorgangs und Planung einer Nachfassaktion –, erreicht oder übertrifft Koa die führenden Modelle bei dreimal weniger Fehlern, ohne dass die verglichenen Modelle genannt werden. Das bereits intern in Slack eingesetzte Modell startet im Oktober als auswählbares Modell in Agentforce in eine Pilotphase, unter anderem bei Formula 1 und Xero, bevor es voraussichtlich im Winter 2026 in den US-Regionen allgemein verfügbar wird.
🔗 NVIDIA-Beitrag über Jensen Huang auf der Dreamforce
Runway erläutert die Echtzeitmoderation seiner künftigen Videomodelle
16. September — Runway plant, „in den kommenden Monaten“ Modelle für die Echtzeit-Videogenerierung einzuführen, und erläutert, wie diese moderiert werden sollen. Beim kontinuierlichen Streaming (streaming) sieht der Nutzer das Video vor jeder abschließenden Prüfung. Runway hat daher ein schnelleres System entwickelt und getestet: eine beschleunigte Prüfung der Eingaben, eine synchrone Moderation, die die Bilder des Streams analysiert und die Übertragung beendet, sobald problematische Inhalte erscheinen, sowie anschließend eine Prüfung des vollständigen Videos vor jedem Download oder Teilen. Der Klassifikator CoPE-B von Zentropi ist ein LoRA-Adapter auf Gemma-4-26B-A4B-it, einem Mixture-of-Experts-Modell mit 25,2 Milliarden Parametern, von denen 3,8 Milliarden aktiv sind; die Prüfung dauert durchschnittlich weniger als 0,5 Sekunden. In Tests ließen grenzwertige Eingaben kurzzeitig verbotene Inhalte erscheinen, bevor die Übertragung beendet wurde. Das System wird die bestehenden Schutzmaßnahmen von Runway ergänzen, und Echtzeitvideos werden wie die übrigen Kreationen des Unternehmens C2PA-Herkunftssignale tragen.
Kurzmeldungen
- Zed 1.20.1 fügt Gemini 3.8 Flash hinzu — die wöchentliche stabile Version des Editors bringt außerdem eine optionale Cursoranimation, das Öffnen von Markdown-Dateien in der gerenderten Vorschau sowie rund 25 % kleinere macOS- und Linux-Binärdateien; sie behebt einen Fehler, durch den private Dateien über die Projektsuche für Mitwirkende offengelegt werden konnten. 🔗 Quelle
- Replit öffnet benutzerdefinierte Konnektoren (Custom Connectors) als Beta — Administratoren eines Workspace können dort eine per API-Schlüssel authentifizierte REST-API über HTTPS definieren, damit der Agent sie über die offiziellen Konnektoren hinaus nutzt; die Dokumentation nennt Pro- und Enterprise-Kunden, doch ein Hinweis beschränkt die Beta auf Enterprise. 🔗 Quelle
- NVIDIA überträgt Agenten die Portierung von TileGym auf cuTile Rust — acht Tage nach dem Start von CUDA Rust hat eine mit TileGym bereitgestellte Multi-Agent-Skill alle 24 öffentlichen Operatoren der Bibliothek portiert, die bei 347 auf DGX B200 gemessenen Konfigurationen durchschnittlich 99,5 % der Leistung von cuTile Python erreichen. 🔗 Quelle
- OpenAI veröffentlicht einen Leitfaden zu den Analysen der Admin Console — die Ansichten Usage, Insights und Outcomes, wobei Letztere den Anteil zusammengeführter Commits mit einem Beitrag von Codex misst, sollen die Nutzung von ChatGPT Work und Codex mit Ergebnissen verknüpfen; der angeführte Return on Investment von 245 % ist ausdrücklich hypothetisch, und die verlinkte Dokumentation war zum Zeitpunkt unserer Erhebung weiterhin nicht auffindbar. 🔗 Quelle
- Die OpenAI API regelt die Erstellung von Schlüsseln — der Abschnitt API Key Governance, der am 15. September und damit fünf Tage nach Einführung der Ablaufdaten in das Changelog aufgenommen wurde, ermöglicht Administratoren, ausschließlich Schlüssel für Servicekonten oder ausschließlich projektbezogene Schlüssel im Besitz eines Benutzers zuzulassen oder jegliche Erstellung neuer Schlüssel zu blockieren; vorhandene Schlüssel bleiben unverändert. 🔗 Quelle
- Copilot: Anträge auf eine Budgeterhöhung sind allgemein verfügbar — bei Copilot Business und Enterprise mit nutzungsbasierter Abrechnung kann ein Mitglied, dessen KI-Guthaben aufgebraucht ist, ein zusätzliches Budget beantragen; Eigentümer und Abrechnungsmanager legen den Betrag fest und genehmigen ihn, wodurch der Zugriff sofort wiederhergestellt wird. 🔗 Quelle
- AI Scan für Pull Requests erfordert nicht mehr die Standardkonfiguration von CodeQL — die KI-gestützte Erkennung von Schwachstellen in Pull Requests wird in einer öffentlichen Vorschau für Kunden von GitHub Advanced Security auf github.com auf berechtigte Repositorys ohne diese Konfiguration ausgeweitet; GitHub Enterprise Server wird nicht unterstützt. 🔗 Quelle
- Konfigurationen von GitHub Advanced Security werden Organisationen verbindlich vorgegeben — seit dem 15. September können Unternehmensadministratoren nicht mehr nur Repository-Eigentümer, sondern auch Organisationsadministratoren daran hindern, die auf Unternehmensebene festgelegten Sicherheitskonfigurationen zu ändern. 🔗 Quelle
- GitHub deaktiviert SHA-1 für HTTPS — wie am 20. April angekündigt, bestätigt das Changelog vom 15. September das Ende von SHA-1 bei HTTPS-Verbindungen zu github.com und den zugehörigen Partner-CDNs, einschließlich GitHub Enterprise Cloud; Browser, API-Clients und Git über HTTPS sind betroffen, GitHub Enterprise Server hingegen nicht. 🔗 Quelle
- MiniMax H3 ist serverlos (serverless) auf Together AI verfügbar — das in einem Tweet vom 15. September um 16:58 Uhr pazifischer Zeit angekündigte offene Videomodell mit 33 Milliarden Parametern, das Clips von 4 bis 15 Sekunden in bis zu 2K mit nativem Stereoton erzeugt, wird dort mit 0,1391 Dollar pro Video angeboten. 🔗 Quelle
- MiniMax stellt H3 IP Edition vor — in seiner Bilanz zur Konferenz in Tokio mit KAGAMI AI gibt MiniMax an, eine Edition von H3 vorgestellt zu haben, die mit offiziell lizenziertem japanischem geistigem Eigentum verknüpft ist, jedoch ohne Lizenzkatalog, Termin oder Preis. 🔗 Quelle
- Runway ergänzt mit seiner Fall-2026-Kollektion fünf Modelle von Drittanbietern — Fish Audio S2.1 Pro, Cartesia Sonic 3.6, MiniMax H3 Max, FLUX Video Upscale und FLUX Video Edit kommen ohne angekündigte Preise auf die Plattform; mehrere waren bereits anderweitig verfügbar, etwa FLUX Video Upscale seit dem 20. August bei Black Forest Labs und H3 Max seit dem 27. August. 🔗 Quelle
- Luma führt Camera Angles ein — die am 15. September um 16:26 Uhr pazifischer Zeit veröffentlichte Funktion von Luma Agents generiert das Motiv eines einzelnen Fotos aus ausgewählten Blickwinkeln neu und bewahrt dabei die Details, ohne ein Modell zu benennen oder Zahlen anzugeben. 🔗 Quelle
- Grok Voice ist auf fal verfügbar — die Inferenzplattform bietet das Sprachmodell von SpaceXAI für Speech to Speech und in Echtzeit an; laut fal antwortet es in 0,70 Sekunden und kostet 0,00083 Dollar pro Sekunde, außerdem ist für den 22. September ein Live-Workshop mit SpaceXAI geplant. 🔗 Quelle
- OpenText und Cohere schließen sich für regulierte Branchen zusammen — die auf der Konferenz ALL IN AI in Montreal angekündigte Partnerschaft wird North und die Modelle von Cohere in die OpenText-Aviator-Agenten integrieren, die lokal oder in einer privaten, öffentlichen oder souveränen Cloud bereitgestellt werden können; das gemeinsame Angebot soll Anfang 2027 bei Kunden verfügbar sein. 🔗 Quelle
- Manus geht Bildungspartnerschaften in Singapur ein — der Agent ist Teil von SkillsFuture AI Subscription, das berechtigten Singapurern, die an bestimmten KI-Kursen teilnehmen, sechs Monate kostenlosen Zugang bietet, sowie des Singtel AI Pass; eine hochschulübergreifende Challenge verzeichnete mehr als 1.100 Anmeldungen, und Manus ruft weltweit zur Zusammenarbeit mit Bildungspartnern auf. 🔗 Quelle
- Die Universität Manchester prognostiziert die Luftverschmutzung mit Earth-2 — Earth-2 CorrDiff wurde in zwei Tagen auf einem Knoten mit 8 GPUs des Supercomputers Isambard-AI neu trainiert, deckt das gesamte Vereinigte Königreich mit einer Auflösung von 2 bis 3 km² ab, und das Team verspricht, Daten und Workflows als Open Source zu veröffentlichen. 🔗 Quelle
- Das Kinderkrankenhaus von Philadelphia modelliert Herzen in wenigen Sekunden — der auf dem Open-Source-Framework MONAI basierende Dienst des CHOP erstellt Herzmodelle, die zuvor rund vier Arbeitsstunden erforderten; für dieses Jahr sind etwa 200 Fälle geplant, und auf Newton basierende Werkzeuge, die derzeit integriert werden, können Simulationen zur Platzierung von Medizinprodukten nahezu in Echtzeit ermöglichen. 🔗 Quelle
- Google veröffentlicht eine Studie über US-amerikanische Jugendliche und KI — die gemeinsam mit RXN unter mehr als 1.000 Jugendlichen im Alter von 13 bis 17 Jahren durchgeführte Studie U.S. Future Report zeigt, dass 94 % von ihnen im vergangenen Jahr KI genutzt und 55 % die Antworten mit anderen Quellen abgeglichen haben; es wird kein Produkt angekündigt. 🔗 Quelle
- Perplexity veröffentlicht einen Leitfaden zu Detektoren für KI-Texte — das als hypothetisch vorgestellte Beispiel zeigt, dass ein Detektor, der sich bei 2 % der von Menschen verfassten Texte irrt, 64 von 1.000 Artikeln markieren kann, darunter 19 von Menschen geschriebene, was einer Fehlerquote von fast 30 % entspricht; der Leitfaden empfiehlt, eine Markierung als Ausgangspunkt für eine Überprüfung zu behandeln. 🔗 Quelle
- GiniGEN AI bewertet 425 Modelle von OpenRouter — ein im Hugging-Face-Blog veröffentlichter Community-Beitrag: Das Ranking ergänzt eine bei 329 Modellen gemessene Latenz bis zum ersten Token sowie eine Bewertung der Qualität auf Koreanisch; nur 8,5 % der bewerteten Modelle erhalten bei Höflichkeitsformen ein A und 9,4 % bei koreanischen Institutionen. 🔗 Quelle
Was das bedeutet
Der Agent wird zur Benutzeroberfläche, und die Wahl des Modus verschwindet. Im neuen Claude entscheidet man nicht mehr zwischen einer Unterhaltung und einem Arbeitsbereich: Claude wählt zwischen Websuche, Dateien und Code und erstellt anschließend ein Dokument oder eine Präsentation. Delta überträgt dieselbe Logik auf die Codeauslieferung, mit einer Überprüfung direkt im Thread und einem Befehl /land, der Commit, CI und Zusammenführung anstelle eines Pull Requests nacheinander ausführt. Devin Code Scans geht von einem Ziel statt von einer Änderung aus, und Grok Build merkt sich über Sitzungen hinweg die Konventionen und Entscheidungen eines Projekts. Die menschliche Kontrolle verlagert sich, ohne zu verschwinden: bei Claude ist standardmäßig der manuelle Modus aktiv, bei Zed muss das Team vor der Zusammenführung zustimmen, und bei Devin werden die Erkenntnisse vor jedem Pull Request besprochen.
Agenten halten auch Einzug in den Geschäftsprozess. OpenAI testet Sponsored Agents, die eine Werbung übernehmen, Google platziert Business Agent in YouTube-Anzeigen und stellt mit UCP Werkzeuge für die Zahlung bereit; beide grenzen den Markenagenten vom Rest ab: auf der einen Seite eine gekennzeichnete Unterhaltung, die von den unabhängigen Antworten von ChatGPT getrennt ist, auf der anderen eine Beta, für die Händler sich anmelden müssen. Für kleine Unternehmen wirbt Claude for Small Business mit 43 Workflows und mehr als 900.000 Installationen, und ElevenLabs verkauft ab 29 Dollar pro Monat einen Rezeptionisten, der Termine vereinbart. Synthesia berechnet 0,10 Euro pro Minute für einen Avatar, der innerhalb des Produkts seiner Kunden spricht, und Salesforce macht Koa zu einem auswählbaren Modell in Agentforce: Der Agent unterstützt das Unternehmen nicht mehr nur, sondern spricht in dessen Namen mit seinen Kunden.
Vertrauen wird zu einem Verkaufsargument, und die Anbieter bemühen sich, es überprüfbar zu machen. Cohere und Aleph Alpha betonen die Souveränität mit einem Doppelsitz in Berlin und Toronto, und Model Vault stellt ein Attestierungs-Token bereit, das der Kunde anhand der öffentlichen Schlüssel des Hardwareherstellers kontrolliert. Mistral verpflichtet sich bei Firefox zu einer Null-Aufbewahrung, Salesforce behält die Gewichte von Koa auf seiner Infrastruktur, Runway will einen Videostream unterbrechen, sobald problematische Inhalte erscheinen, OpenAI lässt Administratoren die Erstellung von API-Schlüsseln einschränken, und Qwen Code isoliert seinen Agenten auf Kernel-Ebene und veröffentlicht die Liste seiner Einschränkungen. Die stärksten Garantien sind diejenigen, die ein Kunde selbst kontrollieren kann; ein hauseigener Benchmark wie CRM Bench oder ein „nicht einmal wir“ ohne erwähnte Prüfung durch Dritte bleiben bloße Behauptungen.
Schließlich stößt die Rechenleistung an die Grenzen der Stromversorgung. Vera Rubin NVL72 erreicht laut NVIDIA einen bis zu 3,7-mal höheren Durchsatz als GB300 NVL72, doch die konkretesten Ankündigungen dieser beiden Tage betreffen Megawatt: Lambda bringt 19 Knoten im Strombudget von 16 unter, eine KI-Fabrik in Santa Clara senkt auf Wunsch ihres Versorgers den Bedarf von 4 auf 3 MW, und AEMA fordert schnellere Netzanschlüsse im Gegenzug für nachprüfbare Flexibilität. Der Durchsatz pro Rack bleibt das technische Verkaufsargument, doch der Zugang zum Stromnetz bestimmt, wie schnell diese Racks in Betrieb gehen.
Quellen
- Claude, Claude Cowork und Chat sind jetzt ein einziges Claude
- Claude-Hilfezentrum, Zusammenführung von Chat und Cowork
- Boris Cherny auf X, Chat und Cowork beginnen zu verschmelzen
- Claude Devs auf X, Design, Slides und Docs in Claude Code
- Zed, öffentliche Beta von Delta
- Zed auf X, der Befehl /land
- NVIDIA, Vera Rubin NVL72 in MLPerf Inference v6.1
- NVIDIA, Live-Blog zum AI Infra Summit
- NVIDIA, Start der AI Energy Management Alliance
- AI Energy Management Alliance, offizielle Website
- OpenAI, Werbung mit KI neu gedacht
- Google, Aktualisierungen für agentenbasierten Handel zum Weihnachtsgeschäft
- Cohere, endgültige Vereinbarung mit Aleph Alpha
- Cohere auf X, Zitat von Aidan Gomez
- Cohere auf X, Confidential Computing in Model Vault
- Cohere, Produktseite von Model Vault
- Mistral AI, Partnerschaft mit Mozilla
- SpaceXAI, Memory in Grok Build
- Qwen Code, Versionshinweise zu v0.24.0
- Cognition, Vorstellung von Code Scans
- Claude, neue Workflows von Claude for Small Business
- ElevenLabs, Vorstellung von Reception
- Reception, Preise
- Synthesia auf X, Interactive Avatar API
- Synthesia, Seite zu Interactive Avatars
- NVIDIA, Jensen Huang auf der Dreamforce
- Runway, Moderation in Echtzeit
- Zed, Versionshinweise zu 1.20.1
- Replit auf X, Custom Connectors als Beta
- NVIDIA, Portierung von TileGym auf cuTile Rust
- OpenAI, Verknüpfung der KI-Nutzung mit dem geschäftlichen Nutzen
- OpenAI, API-Changelog
- GitHub Changelog, Anträge auf eine Erhöhung des Copilot-Budgets
- GitHub Changelog, AI Scan ohne Standardkonfiguration von CodeQL
- GitHub Changelog, verbindlich vorgegebene Konfigurationen von GitHub Advanced Security
- GitHub Changelog, Ende von SHA-1 für HTTPS
- Together AI auf X, serverloses MiniMax H3
- MiniMax auf X, H3 IP Edition
- Runway auf X, Fall-2026-Kollektion
- Luma auf X, Camera Angles
- fal auf X, Grok Voice
- OpenText, Partnerschaft mit Cohere
- Manus auf X, KI lernen mit Manus
- NVIDIA, Earth-2 und die Luftverschmutzung im Vereinigten Königreich
- NVIDIA, CHOP und Herzmodellierung
- Google, U.S. Future Report über Jugendliche und KI
- Perplexity, Leitfaden zu Detektoren für KI-Texte
- Hugging Face, GiniGEN-AI-Ranking der OpenRouter-Modelle