ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Deze woensdag voegt Anthropic chat en Cowork samen tot één Claude, dat zelf zijn tools kiest, en lanceert het Claude Docs en Claude Slides in bèta. Zed stelt Delta open voor iedereen en vervangt de pull request door een beoordeling in de thread, terwijl NVIDIA Vera Rubin NVL72 laat debuteren in MLPerf Inference v6.1, nu elektriciteit de bepalende beperking voor AI-fabrieken wordt. Ook merkagenten doen hun intrede in advertenties, zowel bij ChatGPT als op YouTube, terwijl Cohere de definitieve overeenkomst met Aleph Alpha ondertekent en Mistral naar Firefox komt.
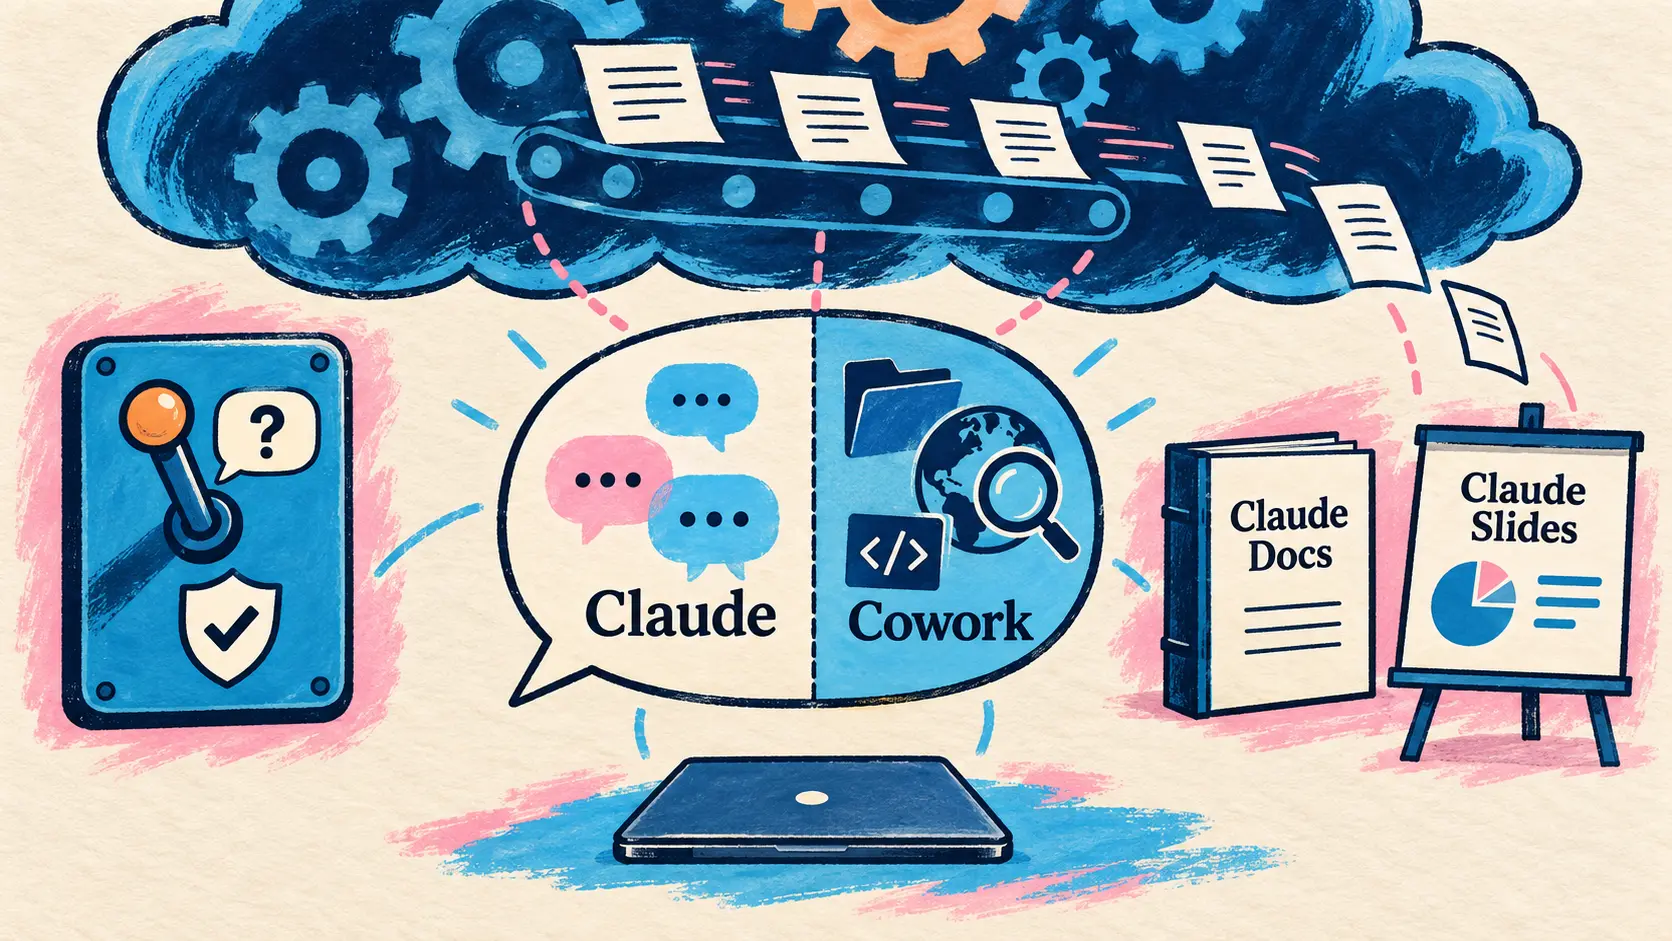
Eén Claude: chat en Cowork worden samengevoegd, Claude Docs en Claude Slides komen in bèta
16 september — Anthropic voegt chat en Claude Cowork samen: er hoeft geen modus meer te worden gekozen, Claude beslist zelf of het op het web moet zoeken, bestanden moet lezen of code moet uitvoeren, en levert voltooide bestanden op. Langdurige taken gaan door in de cloud, zelfs wanneer de computer is uitgeschakeld, maar lokale bestanden, de ingebouwde browser en computerbesturing (computer use, in bèta voor Pro en Max) vereisen dat Claude Desktop geopend blijft.
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇳🇱 Vandaag beginnen chat en Cowork samen te smelten tot één Claude. De richting: één Claude dat de context bewaart van alles waaraan je werkt, waar je ook bent. — Boris Cherny (Anthropic) op X
De nieuwe Claude Docs en Claude Slides maken documenten en presentaties, en Claude Design, dat in april werd gelanceerd, werkt voortaan ook in gesprekken. Alle drie zijn in bèta bij de betaalde abonnementen, waarbij Enterprise-beheerders zelf kunnen kiezen. Elke creatie kan via een link worden gedeeld en presentaties kunnen naar PowerPoint of PDF worden geëxporteerd. In de standaard ingestelde handmatige modus vraagt Claude vóór elke actie om toestemming; in de automatische modus vinden vóór elke actie geautomatiseerde veiligheidscontroles plaats.
| Abonnement of betrokken doelgroep | Aangekondigde planning |
|---|---|
| Pro en Max (web, desktop, mobiel) | „In de komende weken”, zonder iets te hoeven activeren |
| Team en Free | „Binnenkort”, zonder datum |
| Enterprise | Minstens 30 dagen voorafgaande kennisgeving vóór elke wijziging |
De overstap is definitief, maar taken, projecten, connectors, skills en artefacten van Cowork blijven behouden. Bij de lancering vermeldt het helpcentrum enkele beperkingen: toevoegen vanuit GitHub en het vertakken van gesprekken zijn niet mogelijk, incognitogesprekken worden in de oude ervaring geopend, oudere Cowork-taken ontbreken in de zoekresultaten en Dispatch is gesloten voor nieuwe gebruikers. Chat en Cowork deelden sinds 7 juli al projecten en artefacten, en sinds 25 augustus ook het geheugen.
🔗 Blogbericht van Anthropic 🔗 Helpcentrum
Design, Slides en Docs werken ook in Claude Code
Diezelfde dag meldt @ClaudeDevs dat Claude Design, Claude Slides en Claude Docs ook in Claude Code werken: gebruikers kunnen er vragen om materiaal voor een ontwerpbeoordeling (design review deck) of een interfaceprototype door Claude naar de echte bestanden en RFC’s van de repository te verwijzen, het resultaat zelf of in het gesprek aanpassen en vervolgens de link delen. Voor Design is dit niet nieuw, aangezien de opdracht /design sinds 17 augustus als voorlopig onderzoek beschikbaar is: de vernieuwing betreft Slides en Docs. De tweet vermeldt geen minimale versie, abonnementen of documentatie, en ook de release notes van de laatst gepubliceerde versie zeggen er niets over.
🔗 Aankondiging van @ClaudeDevs op X
Zed stelt Delta open in publieke bèta en vervangt de pull request door een beoordeling in de thread
16 september — Zed stelt Delta open voor iedereen. De tool werd op 12 augustus op basis van inschrijving gelanceerd en kwam op 4 september voor ingeschreven gebruikers naar Windows, maar kan nu vrij worden gedownload voor macOS, Linux en Windows, zonder installatie op het web worden gebruikt en biedt de mogelijkheid om de discussiethreads (threads) vanaf een mobiel apparaat te volgen.
Het centrale idee is samenwerken zonder commit of push. Een teamgenoot die wordt uitgenodigd voor het gesprek met de agent ziet dezelfde werkkopieën (worktrees), kan deze op de eigen computer overnemen, de agent vragen stellen over diens keuzes of verdergaan wanneer de auteur de verbinding verbreekt. De codebeoordeling, waarvan op 10 september een preview werd getoond, neemt de plaats in van de pull request: een subthread leidt de beoordelaar door de wijzigingen in de branch, met de context van de oorspronkelijke agent, op een geïsoleerde kopie van de worktrees. Met de opdracht /land krijgt de agent vervolgens de taak om alles in één commit samen te voegen, de CI te doorlopen, na goedkeuring door het team te mergen en de branch te verwijderen.
In de repository van Delta zijn pull requests sinds de week vóór de aankondiging uitgeschakeld, en sindsdien hebben 33 mensen er 570 wijzigingen gemerged; de repository van de Zed-editor blijft „voorlopig” op GitHub. Onder de motorkap vult DeltaDB het versiebeheer van Git aan met incrementele delta’s die tussen twee commits de wijzigingen en berichten van zowel mensen als agenten bewaren; de commit blijft het controlepunt, zodat een teamgenoot die Delta nooit opent een gewone Git-repository ziet.
Zed zegt GitHub.com te willen vervangen en noemt deze werkwijze continue engineering (continuous engineering); de roadmap voorziet zonder datum in Git-opslag binnen DeltaDB en overweegt op termijn CI-achtige verificatie in de thread. Delta is tijdens de bèta gratis, betaalde abonnementen worden „binnenkort” aangekondigd zonder prijs of datum, en Zed belooft een gratis versie te behouden.
🔗 Blogbericht van Zed over de publieke bèta van Delta 🔗 Thread van Zed over de opdracht /land
Vera Rubin NVL72 debuteert in MLPerf Inference v6.1 met maximaal 3,7 keer de doorvoer van GB300 NVL72
16 september — NVIDIA laat Vera Rubin NVL72, zijn rackplatform van de volgende generatie, debuteren in MLPerf Inference v6.1, waarvan MLCommons de resultaten publiceert, met inzendingen in preview (preview). Volgens NVIDIA’s vergelijkingen tussen zijn eigen inzendingen behaalt het rack met vLLM en NVIDIA Dynamo maximaal 3,7 keer de doorvoer van GB300 NVL72 op Qwen3-VL in offline-, server- en interactieve scenario’s, en met TensorRT-LLM maximaal 2,5 keer op DeepSeek-R1. Nebius heeft eveneens Vera Rubin NVL72-resultaten in preview ingediend.
NVIDIA schrijft deze winst toe aan het gezamenlijke ontwerp van hardware en software: NVFP4-precisie voor gewichten, attention en de KV-cache, gedesaggregeerde dienstverlening die prefill (prefill) en decodering scheidt, grootschalig expertparallelisme en een NVLink-domein van de zesde generatie, waarvoor NVIDIA een pakketdoorvoer claimt die 10 keer hoger ligt dan bij standaard-Ethernet. Ook de huidige generatie publiceert haar cijfers:
| MLPerf Inference v6.1-test | Ingediend systeem | Door NVIDIA gepubliceerd resultaat |
|---|---|---|
| DeepSeek-R1 offline, van 72 tot 288 GPU’s | GB300 NVL72, van 1 tot 4 racks | 99% schaalefficiëntie |
| WAN 2.2, tekst naar video | GB300 NVL72 | 0,65 720p-video per seconde, 5,7 s per video |
| Qwen3-VL, v6.1 tegenover v6.0 | GB300 NVL72 | Tot 1,6 keer, dankzij de software |
| Edge-Agentic, nieuwe test (Qwen3.6-27B) | Jetson AGX Thor, TensorRT Edge-LLM | Inzending zonder cijfer in het blogbericht |
NVIDIA meldt ook winst die na de deadline is behaald op GPT-OSS-120B en DLRMv3 en die MLCommons nog niet heeft geverifieerd. Het bedrijf claimt 19 partners, waaronder acht met Blackwell NVL72-systemen met meerdere nodes, en noemt de toekomstige MLPerf Endpoints-test van MLCommons, die de meting van agentische inference moet standaardiseren.
🔗 NVIDIA Vera Rubin NVL72 levert toonaangevende prestaties bij zijn debuut in MLPerf Inference v6.1
Elektriciteit centraal in AI-fabrieken: DSX MaxLPS bij Lambda en de AEMA-alliantie
15 en 16 september — Twee aankondigingen van NVIDIA plaatsen het elektriciteitsnet centraal bij de implementatie van AI, beide met Emerald AI: een door zijn software bestuurde AI-fabriek verminderde haar verbruik op verzoek van een elektriciteitsleverancier, waarna Emerald AI, Google en NVIDIA een alliantie voor flexibele datacenters lanceerden.
AI Infra Summit: Lambda valideert DSX MaxLPS, een AI-fabriek vermindert haar verbruik op verzoek van het net
15 september — Tijdens de AI Infra Summit ging de keynote van Ian Buck (NVIDIA) over het aantal tokens dat AI-fabrieken (AI factories) per megawatt produceren. Lambda heeft DSX MaxLPS gevalideerd, de software van NVIDIA die het verbruik van GPU’s en racks bewaakt en het vermogen op basis van de workloads herverdeelt: 19 HGX B200-nodes werkten binnen het elektriciteitsbudget van 16 nodes op vol vermogen, waarbij de doorvoer steeg van ongeveer 4 naar 5 miljoen tokens per seconde (+24%) en de prestaties per watt met 23% toenamen. NVIDIA voorziet voor Vera Rubin NVL72 binnen hetzelfde budget tot 40% meer GPU-capaciteit, „in geschikte omgevingen”. Op een avond in augustus liet een signaal van Silicon Valley Power het verbruik van een door Emerald AI Conductor bestuurde AI-fabriek in Santa Clara automatisch dalen van 4 naar 3 MW, zonder de prioritaire inference te onderbreken; sindsdien zijn meer dan 200 signalen opgevolgd, met een reactietijd van minder dan een minuut. DSX Flex, dat dit soort signalen verwerkt, krijgt zijn eerste specifieke commerciële implementatie in een Vera Rubin-fabriek van 96 MW in Manassas, Virginia.
AEMA, een alliantie voor datacenters die zich aan het elektriciteitsnet aanpassen
16 september — Emerald AI, Google en NVIDIA lanceren de AI Energy Management Alliance (AEMA), een coalitie voor datacenters die hun verbruik kunnen aanpassen aan de toestand van het elektriciteitsnet: workloads verplaatsen, opslag aanspreken, gebruikmaken van gekoppelde productie of reageren op incidenten. De uitgangspunten zijn: vóór de aansluiting verplichtingen vastleggen voor het operationeel blijven (ride-through), verbruiksbeperking (curtailment) en incidentrespons, meetwaarden standaardiseren, snellere aansluittrajecten openen voor verifieerbare flexibiliteitstoezeggingen en de kosten verdelen op basis van de werkelijke impact. De alliantie richt zich op de Verenigde Staten en noemt haar lanceringspartners niet. Op haar website noemt ze twee potentiële voordelen: 100 GW die op het bestaande net kan worden vrijgemaakt met matig flexibele datacenters, en 733 miljoen dollar aan vermeden kosten per GW aan nieuwe flexibele datacenters. NVIDIA en Emerald AI presenteerden op 31 maart tijdens CERAWeek al flexibele AI-fabrieken.
🔗 Blogbericht van NVIDIA over AEMA 🔗 Website van AEMA
Merkagenten doen hun intrede in advertenties, bij ChatGPT en op YouTube
16 september — Op dezelfde dag integreren OpenAI en Google in de Verenigde Staten de gespreksagent van een merk in het advertentieformaat: bij OpenAI als test met geselecteerde adverteerders en bij Google als bèta waarvoor verkopers zich kunnen inschrijven.
ChatGPT Ads test Sponsored Agents en maakt verbinding met HubSpot en Shopify
OpenAI voegt AI toe aan beide kanten van zijn ChatGPT Ads-advertentieplatform. Met Sponsored Agents kan een klik op een advertentie in ChatGPT een duidelijk aangeduid gesprek openen met een door het merk gesponsorde agent, gevolgd door een link naar de website van het merk. OpenAI benadrukt dat deze uitwisseling losstaat van de onafhankelijke antwoorden van ChatGPT en gescheiden blijft van het oorspronkelijke gesprek.
| Vernieuwing in ChatGPT Ads | Status op 16 september |
|---|---|
| Sponsored Agents | In test met geselecteerde adverteerders in de Verenigde Staten |
| Plugin Ads Manager, door prompts aangestuurde campagnes | Wordt uitgerold |
| Voorgestelde teksten en beelden in Ads Manager | Wordt uitgerold |
| Personalisatie en vertaling van tekst | Gelanceerd, optioneel te activeren (opt-in) |
| HubSpot-integratie | Beschikbaar |
| ChatGPT Ads-app voor Shopify | Amerikaanse verkopers, andere ChatGPT Ads-markten vanaf 23 september |
Het blogbericht vermeldt geen prijs of aantal adverteerders. Advertenties werden in februari in ChatGPT getest, kregen in mei een Ads Manager in bèta en met zelfbediening (self-service), waarna OpenAI op 31 augustus na uitbreiding van deze zelfbediening een geannualiseerde omzet van één miljard dollar claimde.
🔗 Advertenties opnieuw vormgeven met AI
Google plaatst Business Agent in YouTube-advertenties en breidt agentische handel uit
Google publiceert zijn updates voor agentische handel (agentic commerce) rond de feestdagen. Business Agent, dat volgens Google „eerder dit jaar” in Search verscheen, komt in de Verenigde Staten als bèta beschikbaar in YouTube-advertenties voor ingeschreven verkopers: kijkers kunnen de agent vragen stellen over producten zonder YouTube te verlaten. AI performance insights, dat het aandeel in de zichtbaarheid (share of voice) van een merk in AI Mode en AI Overviews vergelijkt, wordt in Merchant Center beschikbaar in Australië, Canada, India, Nieuw-Zeeland en de Verenigde Staten. In Merchant Center voegt de integratiehub voor UCP (Universal Commerce Protocol), het protocol dat Google op 11 januari presenteerde, de overdracht van het winkelmandje naar de website van de verkoper en tests van het betaalproces toe; analyses volgen „binnenkort”. Deze functies worden geleidelijk uitgerold in de Verenigde Staten en daarna „begin volgend jaar” in Australië en Canada. Tapestry (Coach, Kate Spade) verkoopt al via UCP in Search en de Gemini-app. Volgens Google leveren goede werkwijzen voor productfeeds in de daaropvolgende maand gemiddeld 5% meer conversies op, en werden bij tests met lululemon de conversationele kenmerken van het merk opgenomen in 50% van de relevante aanbevelingen van AI Mode.
🔗 Blogbericht van Google over agentische handel
Cohere tekent met Aleph Alpha en lanceert Confidential Computing in Model Vault
16 september — Cohere doet meerdere aankondigingen, waaronder twee die zijn gericht op klanten die de controle over hun gegevens en technologie willen behouden.
Aleph Alpha: definitieve overeenkomst en dubbel hoofdkantoor in Berlijn en Toronto
Cohere en Aleph Alpha hebben de definitieve fusieovereenkomst (definitive business combination agreement) ondertekend, waarvan het plan op 24 april was aangekondigd. Het geheel zal onder de naam Cohere opereren, met meer dan 1.000 werknemers, een gepland dubbel hoofdkantoor in Berlijn en Toronto en een onderzoekscentrum in Heidelberg, op de locatie van Aleph Alpha. De transactie, waarvan geen bedrag bekend is gemaakt, moet nog de laatste goedkeuringen van toezichthouders krijgen; de afronding wordt „later dit jaar” verwacht. Ilhan Scheer, co-CEO van Aleph Alpha, wordt dan operationeel directeur van Cohere en medeoprichter Samuel Weinbach onderzoeksdirecteur. De samenwerking met de Schwarz-groep rond zijn soevereine cloud STACKIT wordt voortgezet.
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇳🇱 Geen enkele overheid of onderneming zou moeten hoeven kiezen tussen krachtige AI en controle over haar technologie. Precies die overtuiging brengt ons ertoe onze krachten met Aleph Alpha te bundelen. Samen zullen we tegemoetkomen aan de groeiende wereldwijde vraag naar krachtige én veilige frontier-AI. — Aidan Gomez (Cohere), geciteerd door @cohere op X
🔗 Bericht van Cohere over de overeenkomst
Confidential Computing in Model Vault, in vroege toegang
Cohere introduceert Confidential Computing in Model Vault, zijn speciale, volledig beheerde inferentieplatform, om gegevens tijdens de verwerking te beschermen en niet langer alleen wanneer ze zijn opgeslagen of worden verzonden. Er worden drie mechanismen beschreven: end-to-end versleutelde inferentie, hardwarematig afgedwongen isolatie die zich met NVIDIA Confidential Computing tot de GPU uitstrekt, en een ondertekend attestatietoken dat op verzoek beschikbaar is en met de publieke sleutels van de hardwarefabrikant kan worden geverifieerd. Cohere stelt dat niemand, „zelfs wij niet”, toegang kan krijgen tot de workloads van de klant, zonder melding te maken van een externe audit. De vroege toegang is voorbehouden aan een beperkte groep bètaklanten, zonder prijs, datum voor algemene beschikbaarheid of modellenlijst, en de aankondiging beperkt zich tot tweets en een productpagina. Op 9 september was aangekondigd dat de functie binnenkort beschikbaar zou komen.
🔗 Aankondiging van Cohere op X 🔗 Productpagina van Model Vault
Mistral drijft Smart Window aan, de AI-assistent van Firefox
16 september — In een gezamenlijk bericht kondigen Mistral AI en Mozilla aan dat Smart Window, de nog in bèta verkerende AI-navigatieassistent van Firefox, voortaan met Mistral-modellen werkt, zonder te specificeren welke. De assistent helpt complexe zoekopdrachten te ontwarren en bronnen uit geopende tabbladen bijeen te brengen. Mistral stelt de dienst eerst beschikbaar voor gebruikers in Frankrijk en Noord-Amerika; het Verenigd Koninkrijk en Duitsland volgen naar verwachting „later dit jaar”. Standaard worden gesprekken niet op de servers van Mozilla bewaard en verbinden partners zoals Mistral zich tot het niet bewaren van gegevens (zero data retention). Voor Mistral, dat naar eigen zeggen „traditioneel” bedrijven bedient, opent de overeenkomst de deur naar het grote publiek. Arthur Mensch, medeoprichter en CEO van Mistral, spreekt over twee voorvechters van open source die samenwerken, en Anthony Enzor-DeMeo, CEO van Mozilla Corporation, vindt dat een browser geen eenrichtingstrechter mag zijn.
🔗 Gezamenlijk bericht van Mistral en Mozilla
Grok Build onthoudt de conventies en beslissingen van een project van de ene sessie op de andere
16 september — SpaceXAI rust zijn codeagent Grok Build uit met een geheugen. Na elke voltooide beurt leest Grok deze op de achtergrond opnieuw, zonder de sessie te blokkeren, en legt in een Markdown-notitie vast wat blijvend is: teamconventies, beslissingen en de motivering ervan, en projectfeiten zoals de opdracht waarmee de tests worden gestart. De taakstatus, voorlopige conclusies, geheimen en wat al door de repository of de documentatie ervan wordt behandeld, worden uitgesloten. De notities worden per project gerangschikt, met een globale verzameling voor voorkeuren die overal gelden. De opdracht /dream groepeert ze in thematische bestanden en wordt ook periodiek automatisch uitgevoerd, terwijl /memory een alleen-lezen browser opent. Bij terugkeer naar een project leest Grok de thema’s van het gebied waarin het gaat werken, maar het lopende gesprek heeft voorrang op de notities. Het geheugen geldt alleen voor nieuwe sessies. In de bèta van 25 mei werd al vermeld dat beslissingen tussen sessies behouden bleven; het bericht beschrijft het mechanisme nader.
Qwen Code v0.24.0 sluit de agent op Linux af op kernelniveau en wijzigt de bash-hooks
16 september — Twee dagen na v0.23.4 voegt Qwen Code v0.24.0 op Linux een op de kernel gebaseerde sandbox via bubblewrap (bwrap) toe, zonder container, rootrechten, daemon of image. Indien ingeschakeld, start deze de CLI opnieuw achter een alleen-lezen weergave van het bestandssysteem, waarin alleen de werkruimte en enkele mappen (tijdelijke bestanden, cache, Qwen, Git) beschrijfbaar blijven; qwen sandbox toont de configuratie en --verify test de isolatie. De auteur van de PR somt de beperkingen op: geen afzonderlijke PID-namespace, Unix-sockets van de host blijven bereikbaar en Git- en Qwen-instellingen kunnen worden gewijzigd. Niet-compatibele wijziging (breaking change): in hooks die onder bash worden uitgevoerd, moeten $QWEN_PROJECT_DIR en de equivalenten voor Claude en Gemini, die uit de omgeving worden gelezen in plaats van vervangen, tussen dubbele aanhalingstekens staan. web_search is per sessie begrensd (standaard 200, maximaal 10.000), een budget zoals +500k in het bericht bepaalt de omvang van een volledige beurt, en berichtenuitwisseling tussen sessies is standaard ingeschakeld.
Devin introduceert Code Scans, doelgerichte audits van de volledige codebase
16 september — Cognition introduceert Code Scans in Devin: het uitgangspunt is een breed doel in plaats van een specifieke wijziging, indien nodig aangevuld met eigen criteria (teamnormen, toegankelijkheidschecklist, vereisten voor een migratie), waarna Devin de codebase onderzoekt, zijn bevindingen prioriteert, ze bespreekt en vervolgens de gevraagde pull requests opent. De scan wordt gestart met /scan in de webapp en werd al genoemd in de releaseopmerkingen van 2 september. Hij gebruikt de agentische MapReduce-architectuur (Agentic MapReduce) van Devin Security Swarm, die in juli werd gepresenteerd, in vier fasen: planning, opsplitsing in batches, parallelle verkenning en synthese. Cognition publiceert twee proeven: bij Dioxus daalt de tijd voor een volledige debugcompilatie van 22 crates van 58,6 naar 21,0 seconden, een afname van 64%; een SEO-scan van devin.ai en cognition.com levert 44 bevindingen op, waarna de Ahrefs-score van devin.ai stijgt van 87 naar 92 en het aandeel trage pagina’s met 73% afneemt. Er wordt geen prijs vermeld.
Claude for Small Business breidt uit naar 43 workflows en 27 nieuwe integraties
15 september — In een bericht dat in ons overzicht van 15 september onopgemerkt bleef, breidt Anthropic Claude for Small Business uit, zijn in mei gelanceerde plugin voor kleine bedrijven met 15 workflows (workflows). Deze telt er nu 43, met 27 nieuwe integraties, waaronder Shopify, Salesforce, TikTok, Atlassian, Zoom, Xero, Gusto, Square, Stripe en Zapier, en Anthropic meldt meer dan 900.000 installaties. Elke workflow start in goedkeuringsmodus en de autonomie kan per workflow op omkeerbare wijze worden ingesteld. Anthropic geeft ook een nieuwe impuls aan opleidingen: een najaarstournee met Tenex in 10 Amerikaanse steden, meer dan 150 erkende opleidingsorganisaties voor ruim 750 workshops en 14 partnerwebinars. Het aanbod is beschikbaar bij alle betaalde abonnementen; de balans van de voorjaarstournee werd op 10 september gepubliceerd.
🔗 Bericht van Anthropic over Claude for Small Business
ElevenLabs introduceert Reception, een AI-receptionist voor kleine bedrijven
16 september — ElevenLabs introduceert Reception, een AI-receptionist voor kleine bedrijven die is gebouwd op zijn ElevenAgents-platform. De dienst beantwoordt 24 uur per dag vragen over diensten, openingstijden of het adres, in de taal van de beller, en boekt vervolgens de afspraak in de agenda, naar keuze als overloop wanneer het team niet opneemt of na sluitingstijd. De dienst heeft een eigen website, reception.ai, en kan 14 dagen gratis worden uitgeprobeerd met 30 belminuten.
| Reception-abonnement | Maandprijs exclusief belastingen | Inbegrepen belminuten |
|---|---|---|
| Basic | 29 dollar | 75 |
| Plus | 79 dollar | 275 |
| Premium | 199 dollar | 1.000 |
| Enterprise | Op aanvraag | Op maat |
Alle abonnementen omvatten meer dan 70 talen, Google Calendar, Calendly, Zapier, webhooks en een MCP-server.
🔗 Introductie van Reception, door ElevenAgents 🔗 Prijzen van Reception
Synthesia stelt zijn Interactive Avatar API open, realtime avatars voor 0,10 euro per minuut
16 september — Synthesia maakt zijn Interactive Avatar API algemeen beschikbaar, waarmee avatars die in realtime kunnen luisteren, spreken en antwoorden in een product kunnen worden geïntegreerd. De klant levert zijn LLM, kennisbank en logica; Synthesia beheert het gezicht, de stem en de lipsynchronisatie. De avatar neemt dankzij een plugin als videodeelnemer deel aan een LiveKit-ruimte. Volgens de FAQ ondersteunt die momenteel alleen LiveKit-agents die in Python zijn geschreven. De API wordt naar gebruik afgerekend voor 0,10 euro per minuut, zonder verplichtingen en met 500 gratis minuten. Een Pipecat-plugin en een end-to-endaanbod met beheerde LLM, kennis en stem worden „binnenkort” aangekondigd, zonder datum. Synthesia publiceerde in juli het onderzoekskader voor zijn interactieve avatarmodellen.
🔗 Aankondiging van Synthesia op X 🔗 Pagina over Interactive Avatars van Synthesia
Koa, het CRM-model van Salesforce dat op Nemotron 3 Super is gebouwd
15 september — Op Dreamforce presenteerde Salesforce Koa, zijn eerste redeneermodel dat specifiek is bedoeld voor customer relationship management (CRM), verkregen door NVIDIA Nemotron 3 Super na te trainen met NeMo RL, NeMo Gym en NeMo AutoModel op een synthetische dataset. Salesforce beheert de gewichten en voert het model uit op zijn eigen infrastructuur; volgens Salesforce zijn geen klantgegevens gebruikt voor de training of de inferentie. Op CRM Bench, zijn eigen benchmark (een opportunity bijwerken, een case routeren, een follow-up plannen), evenaart of overtreft Koa toonaangevende modellen met drie keer minder fouten, zonder dat de vergeleken modellen worden genoemd. Het model wordt al intern in Slack gebruikt en gaat in oktober als selecteerbaar model in Agentforce een pilotfase in, onder meer bij Formula 1 en Xero, vóór de verwachte algemene beschikbaarheid in de winter van 2026 in Amerikaanse regio’s.
🔗 Bericht van NVIDIA over Jensen Huang op Dreamforce
Runway licht de realtime moderatie van zijn toekomstige videomodellen toe
16 september — Runway is van plan „in de komende maanden” modellen voor realtime videogeneratie te lanceren en legt uit hoe het die zal modereren. Bij continue streaming (streaming) ziet de gebruiker de video vóór een definitieve controle. Runway heeft daarom een sneller systeem ontworpen en getest: versnelde controle van invoer, synchrone moderatie die de beelden van de stream analyseert en de uitzending onderbreekt zodra problematische inhoud verschijnt, gevolgd door controle van de volledige video voordat deze kan worden gedownload of gedeeld. De classifier, CoPE-B van Zentropi, is een LoRA-adapter op Gemma-4-26B-A4B-it, een mixture-of-experts met 25,2 miljard parameters, waarvan er 3,8 miljard actief zijn; de controle duurt gemiddeld minder dan 0,5 seconde. Tijdens tests liet grensoverschrijdende invoer kort verboden inhoud zien voordat de stream werd onderbroken. Het systeem vormt een aanvulling op de bestaande beveiligingen van Runway en realtime video’s zullen, net als zijn andere creaties, C2PA-herkomstsignalen bevatten.
Kort nieuws
- Zed 1.20.1 voegt Gemini 3.8 Flash toe — de wekelijkse stabiele versie van de editor biedt ook een optionele cursoranimatie, opent Markdown-bestanden in gerenderde voorvertoning en bevat ongeveer 25% kleinere macOS- en Linux-binaries; daarnaast verhelpt ze een fout waardoor privébestanden via de projectzoekfunctie zichtbaar konden worden voor medewerkers. 🔗 bron
- Replit stelt aangepaste connectors open als bèta (Custom Connectors) — beheerders van een werkruimte kunnen er een via HTTPS bereikbare REST API definiëren, die met een API-sleutel wordt geverifieerd, zodat de Agent deze naast de officiële connectors kan gebruiken; de documentatie noemt Pro- en Enterprise-klanten, maar een kader reserveert de bèta voor Enterprise. 🔗 bron
- NVIDIA laat agents TileGym naar cuTile Rust porteren — acht dagen na de lancering van CUDA Rust heeft een met TileGym meegeleverde multi-agent-skill alle 24 openbare operators van de bibliotheek geporteerd. Ze behouden gemiddeld 99,5% van de prestaties van cuTile Python in 347 configuraties die op DGX B200 zijn gemeten. 🔗 bron
- OpenAI publiceert een gids voor analyses in de Admin Console — de weergaven Usage, Insights en Outcomes, waarvan de laatste het aandeel gemergede commits met een bijdrage van Codex meet, moeten het gebruik van ChatGPT Work en Codex koppelen aan resultaten; het genoemde rendement op investering van 245% is uitdrukkelijk hypothetisch en de gekoppelde documentatie was tijdens onze inventarisatie nog steeds onvindbaar. 🔗 bron
- De OpenAI API stelt regels in voor het aanmaken van sleutels — de sectie API Key Governance, die op 15 september aan het changelog werd toegevoegd, vijf dagen na de komst van vervaldatums, laat beheerders uitsluitend sleutels voor serviceaccounts of uitsluitend projectsleutels van een gebruiker toestaan, of alle nieuwe sleutels blokkeren; bestaande sleutels veranderen niet. 🔗 bron
- Copilot: aanvragen voor extra budget zijn algemeen beschikbaar — bij Copilot Business en Enterprise met facturering op basis van gebruik kan een lid dat zijn AI-credits heeft opgebruikt om extra budget vragen; eigenaren en factureringsbeheerders stellen het bedrag vast en keuren het goed, waarna de toegang onmiddellijk wordt hersteld. 🔗 bron
- AI Scan voor pull requests vereist niet langer de standaardconfiguratie van CodeQL — de AI-detectie van kwetsbaarheden in pull requests wordt uitgebreid naar in aanmerking komende repositories zonder deze configuratie, als openbare preview voor GitHub Advanced Security-klanten op github.com; GitHub Enterprise Server wordt niet ondersteund. 🔗 bron
- GitHub Advanced Security-configuraties worden afgedwongen voor organisaties — sinds 15 september kunnen enterprise-beheerders voorkomen dat organisatiebeheerders, en niet langer alleen repository-eigenaren, beveiligingsconfiguraties wijzigen die op enterprise-niveau zijn vastgelegd. 🔗 bron
- GitHub schakelt SHA-1 uit voor HTTPS — zoals op 20 april aangekondigd, bevestigt het changelog van 15 september het einde van SHA-1 voor HTTPS-verbindingen met github.com en de CDN’s van zijn partners, inclusief GitHub Enterprise Cloud; browsers, API-clients en Git via HTTPS vallen hieronder, GitHub Enterprise Server niet. 🔗 bron
- MiniMax H3 komt serverless beschikbaar op Together AI — het open videomodel met 33 miljard parameters, aangekondigd in een tweet van 15 september om 16.58 uur Pacific Time, genereert clips van 4 tot 15 seconden in maximaal 2K met native stereogeluid en staat er geprijsd op 0,1391 dollar per video. 🔗 bron
- MiniMax presenteert H3 IP Edition — in een terugblik op zijn conferentie in Tokio met KAGAMI AI zegt MiniMax een editie van H3 te hebben onthuld die is gekoppeld aan officieel gelicentieerde Japanse intellectuele eigendommen, zonder licentiecatalogus, datum of prijs. 🔗 bron
- Runway voegt met zijn Fall 2026-collectie vijf modellen van derden toe — Fish Audio S2.1 Pro, Cartesia Sonic 3.6, MiniMax H3 Max, FLUX Video Upscale en FLUX Video Edit komen naar het platform, zonder bekendgemaakte prijzen; verscheidene waren elders al beschikbaar, zoals FLUX Video Upscale sinds 20 augustus bij Black Forest Labs en H3 Max sinds 27 augustus. 🔗 bron
- Luma lanceert Camera Angles — de op 15 september om 16.26 uur Pacific Time gepubliceerde functie van Luma Agents genereert het onderwerp van één foto opnieuw vanuit gekozen hoeken, met behoud van details, zonder een modelnaam of cijfers te noemen. 🔗 bron
- Grok Voice komt naar fal — het inferentieplatform biedt het spraakmodel van SpaceXAI aan voor Speech to Speech en in realtime; volgens fal reageert het binnen 0,70 seconde en kost het 0,00083 dollar per seconde. Op 22 september staat een liveworkshop met SpaceXAI gepland. 🔗 bron
- OpenText en Cohere gaan samenwerken voor gereguleerde sectoren — het tijdens de ALL IN AI-conferentie in Montréal aangekondigde partnerschap integreert North en de modellen van Cohere in OpenText Aviator-agents, die on-premises of in een private, publieke of soevereine cloud kunnen worden ingezet; het gezamenlijke aanbod wordt begin 2027 bij klanten verwacht. 🔗 bron
- Manus sluit opleidingspartnerschappen in Singapore — de agent maakt deel uit van SkillsFuture AI Subscription, dat in aanmerking komende Singaporezen die bepaalde AI-cursussen volgen zes maanden gratis toegang biedt, en van Singtel AI Pass; een uitdaging tussen campussen trok meer dan 1.100 inschrijvingen en Manus doet een wereldwijde oproep voor leerpartners. 🔗 bron
- De Universiteit van Manchester voorspelt luchtvervuiling met Earth-2 — Earth-2 CorrDiff werd in twee dagen opnieuw getraind op een node met 8 GPU’s van de Isambard-AI-supercomputer, bestrijkt het hele Verenigd Koninkrijk met een resolutie van 2 tot 3 km² en het team belooft de gegevens en workflows als open source te publiceren. 🔗 bron
- Het kinderziekenhuis van Philadelphia modelleert harten in enkele seconden — de dienst van CHOP is gebouwd op het open-sourceframework MONAI en produceert hartmodellen waarvoor voorheen ongeveer vier uur werk nodig was. Voor dit jaar zijn circa 200 gevallen gepland en tools die op Newton zijn gebouwd en momenteel worden geïntegreerd, kunnen simulaties voor het plaatsen van hulpmiddelen bijna in realtime uitvoeren. 🔗 bron
- Google publiceert een onderzoek naar Amerikaanse tieners en AI — het U.S. Future Report, dat samen met RXN werd uitgevoerd onder meer dan 1.000 jongeren van 13 tot 17 jaar, stelt dat 94% van hen het afgelopen jaar AI heeft gebruikt en dat 55% de antwoorden aan andere bronnen toetst; er wordt geen product aangekondigd. 🔗 bron
- Perplexity publiceert een gids over detectoren van AI-tekst — het als hypothetisch gepresenteerde voorbeeld laat zien dat een detector die bij 2% van de menselijke teksten een fout maakt, 64 van de 1.000 artikelen kan markeren, waarvan er 19 door mensen zijn geschreven, oftewel bijna 30% fouten; de gids adviseert een signalering als het begin van een beoordeling te beschouwen. 🔗 bron
- GiniGEN AI rangschikt 425 modellen van OpenRouter — een communityartikel op de Hugging Face-blog: de ranglijst voegt voor 329 modellen een gemeten latentie tot het eerste token en een Koreaanse kwaliteitsscore toe; slechts 8,5% van de beoordeelde modellen krijgt een A voor beleefdheidsvormen en 9,4% voor Koreaanse instellingen. 🔗 bron
Wat dit betekent
De agent wordt de interface en de keuze van een modus verdwijnt. In de nieuwe Claude kiest men niet langer tussen een gesprek en een werkruimte: Claude kiest tussen webonderzoek, bestanden en code en levert vervolgens een document of presentatie op. Delta past dezelfde logica toe op het opleveren van code, met een beoordeling in de thread en een opdracht /land die commit, CI en merge achter elkaar uitvoert in plaats van een pull request. Devin Code Scans vertrekt vanuit een doel in plaats van een wijziging, en Grok Build onthoudt van de ene sessie op de andere de conventies en beslissingen van een project. Menselijke controle verschuift zonder te verdwijnen: standaard de modus Manuel bij Claude, goedkeuring van het team vóór de merge bij Zed en bespreking van de bevindingen vóór iedere pull request bij Devin.
Agents maken ook hun intrede in het commerciële proces. OpenAI test Sponsored Agents die het van een advertentie overnemen, Google plaatst Business Agent in YouTube-advertenties en ondersteunt betalingen met UCP, en beide scheiden de merkagent van de rest: aan de ene kant een als zodanig aangeduid gesprek dat losstaat van de onafhankelijke antwoorden van ChatGPT, aan de andere kant een bèta waarvoor verkopers zich moeten aanmelden. Voor kleine ondernemingen claimt Claude for Small Business 43 workflows en meer dan 900.000 installaties, terwijl ElevenLabs vanaf 29 dollar per maand een receptionist verkoopt die afspraken vastlegt. Synthesia rekent 0,10 euro per minuut voor een avatar die spreekt in het product van zijn klanten, en Salesforce maakt van Koa een selecteerbaar model in Agentforce: de agent ondersteunt de onderneming niet langer alleen, maar spreekt haar klanten namens haar aan.
Vertrouwen wordt een verkoopargument en aanbieders proberen het verifieerbaar te maken. Cohere en Aleph Alpha benadrukken soevereiniteit, met een dubbel hoofdkantoor in Berlijn en Toronto, en Model Vault verstrekt een attestatietoken dat de klant controleert met de openbare sleutels van de hardwarefabrikant. Mistral biedt Firefox een toezegging van nulretentie, Salesforce houdt de gewichten van Koa op zijn eigen infrastructuur, Runway is van plan een videostream te onderbreken zodra problematische inhoud verschijnt, OpenAI laat beheerders het aanmaken van API-sleutels beperken en Qwen Code isoleert zijn agent op kernelniveau en publiceert een lijst met zijn beperkingen. De sterkste garanties zijn de garanties die een klant zelf kan controleren; een interne benchmark zoals CRM Bench of een claim als „zelfs wij niet” zonder vermelde audit door een derde blijft slechts een bewering.
Ten slotte stuit rekenkracht op de elektriciteitsvoorziening. Vera Rubin NVL72 haalt volgens NVIDIA tot 3,7 keer de doorvoer van GB300 NVL72, maar de concreetste aankondigingen van deze twee dagen gaan over megawatts: Lambda plaatst 19 nodes binnen het stroombudget van 16, een AI-fabriek in Santa Clara verlaagt op verzoek van haar leverancier het verbruik van 4 naar 3 MW en AEMA vraagt om snellere netaansluitingen in ruil voor verifieerbare flexibiliteit. Doorvoer per rack blijft het technische verkoopargument, maar toegang tot het elektriciteitsnet bepaalt hoe snel deze racks in gebruik kunnen worden genomen.
Bronnen
- Claude, Claude Cowork en chat zijn nu één Claude
- Claude-helpcentrum, samenvoeging van chat en Cowork
- Boris Cherny op X, chat en Cowork beginnen samen te smelten
- Claude Devs op X, Design, Slides en Docs in Claude Code
- Zed, openbare bèta van Delta
- Zed op X, de opdracht /land
- NVIDIA, Vera Rubin NVL72 in MLPerf Inference v6.1
- NVIDIA, liveblog van de AI Infra Summit
- NVIDIA, lancering van de AI Energy Management Alliance
- AI Energy Management Alliance, officiële website
- OpenAI, Reimagining advertising with AI
- Google, updates voor agentic commerce tijdens de feestdagen
- Cohere, definitieve overeenkomst met Aleph Alpha
- Cohere op X, citaat van Aidan Gomez
- Cohere op X, Confidential Computing in Model Vault
- Cohere, productpagina van Model Vault
- Mistral AI, partnerschap met Mozilla
- SpaceXAI, Memory in Grok Build
- Qwen Code, release notes voor v0.24.0
- Cognition, Introducing Code Scans
- Claude, nieuwe workflows van Claude for Small Business
- ElevenLabs, Introducing Reception
- Reception, prijzen
- Synthesia op X, Interactive Avatar API
- Synthesia, pagina Interactive Avatars
- NVIDIA, Jensen Huang op Dreamforce
- Runway, Moderation in Real Time
- Zed, release notes voor 1.20.1
- Replit op X, Custom Connectors als bèta
- NVIDIA, portering van TileGym naar cuTile Rust
- OpenAI, AI-gebruik koppelen aan bedrijfswaarde
- OpenAI, changelog van de API
- GitHub Changelog, aanvragen voor extra Copilot-budget
- GitHub Changelog, AI Scan zonder standaardconfiguratie van CodeQL
- GitHub Changelog, afgedwongen GitHub Advanced Security-configuraties
- GitHub Changelog, einde van SHA-1 voor HTTPS
- Together AI op X, serverless MiniMax H3
- MiniMax op X, H3 IP Edition
- Runway op X, Fall 2026-collectie
- Luma op X, Camera Angles
- fal op X, Grok Voice
- OpenText, partnerschap met Cohere
- Manus op X, Learn AI with Manus
- NVIDIA, Earth-2 en luchtvervuiling in het Verenigd Koninkrijk
- NVIDIA, CHOP en hartmodellering
- Google, U.S. Future Report over tieners en AI
- Perplexity, gids over detectoren van AI-tekst
- Hugging Face, GiniGEN AI-ranglijst van OpenRouter-modellen