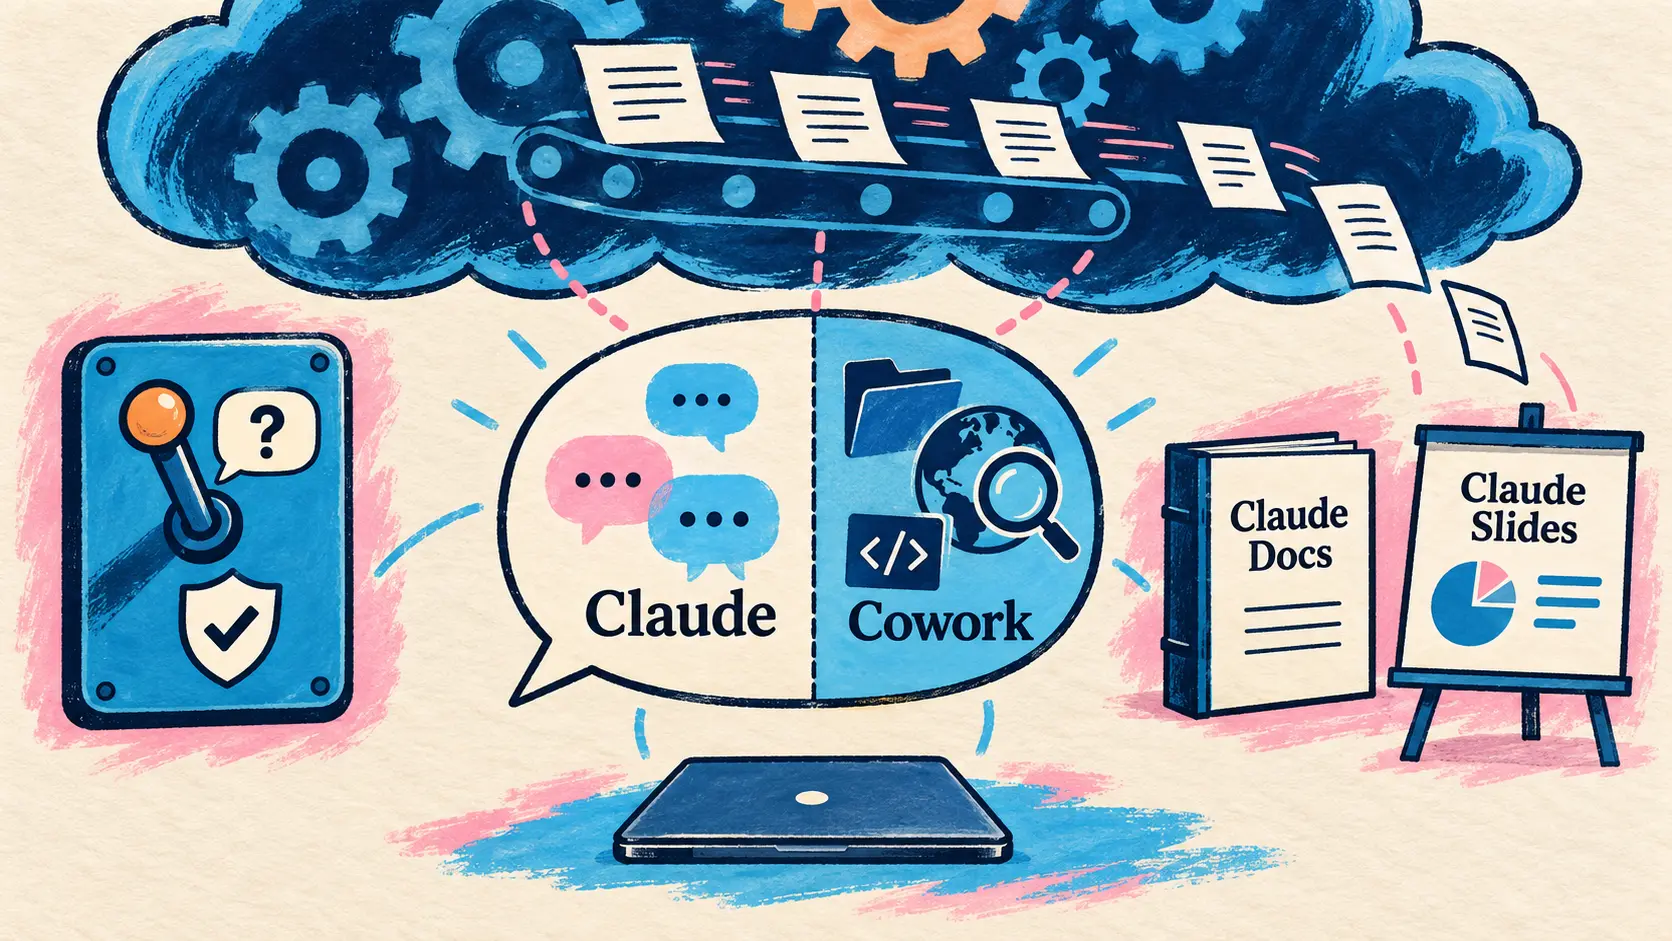
Ce mercredi, Anthropic fusionne le chat et Cowork en un seul Claude, qui choisit lui-même ses outils, et lance Claude Docs et Claude Slides en bêta. Zed ouvre Delta à tous en remplaçant la pull request par une revue dans le fil, et NVIDIA fait débuter Vera Rubin NVL72 dans MLPerf Inference v6.1 au moment où l’électricité s’impose comme la contrainte des usines d’IA. Les agents de marque entrent aussi dans la publicité, chez ChatGPT comme sur YouTube, tandis que Cohere signe l’accord définitif avec Aleph Alpha et que Mistral arrive dans Firefox.
Un seul Claude : le chat et Cowork fusionnent, Claude Docs et Claude Slides arrivent en bêta
16 septembre — Anthropic fusionne le chat et Claude Cowork : plus de mode à choisir, Claude décide lui-même s’il faut chercher sur le web, lire des fichiers ou exécuter du code, et rend des fichiers finis. Les tâches longues continuent dans le cloud même ordinateur fermé, mais fichiers locaux, navigateur intégré et contrôle de l’ordinateur (computer use, en bêta sur Pro et Max) exigent Claude Desktop ouvert.
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇫🇷 Aujourd’hui, le chat et Cowork commencent à fusionner en un seul Claude. La direction : un seul Claude qui garde le contexte de tout ce sur quoi vous travaillez, où que vous soyez. — Boris Cherny (Anthropic) sur X
Nouveaux, Claude Docs et Claude Slides produisent documents et présentations, et Claude Design, lancé en avril, fonctionne désormais dans les conversations. Les trois sont en bêta sur les forfaits payants, au choix des administrateurs Enterprise. Chaque création se partage par lien, les présentations s’exportant en PowerPoint ou PDF. En mode Manuel, réglage par défaut, Claude demande avant chaque action ; en mode Auto, des vérifications de sécurité automatisées précèdent chaque action.
| Forfait ou public concerné | Calendrier annoncé |
|---|---|
| Pro et Max (web, desktop, mobile) | « Au cours des prochaines semaines », sans rien à activer |
| Team et Free | « Bientôt », sans date |
| Enterprise | Préavis d’au moins 30 jours avant tout changement |
La bascule est définitive, mais tâches, projets, connecteurs, skills et artefacts de Cowork sont conservés. Au lancement, le centre d’aide signale des limites : pas d’ajout depuis GitHub ni de branchement de conversation, des conversations incognito ouvertes dans l’ancienne expérience, d’anciennes tâches Cowork absentes de la recherche et Dispatch fermé aux nouveaux utilisateurs. Chat et Cowork partageaient déjà projets et artefacts depuis le 7 juillet, et la mémoire depuis le 25 août.
🔗 Billet d’Anthropic 🔗 Centre d’aide
Design, Slides et Docs fonctionnent aussi dans Claude Code
Le même jour, @ClaudeDevs indique que Claude Design, Claude Slides et Claude Docs fonctionnent aussi dans Claude Code : on peut y demander un support de revue de conception (design review deck) ou une maquette d’interface en pointant Claude vers les vrais fichiers et RFC du dépôt, modifier le résultat soi-même ou dans la conversation, puis partager le lien. Pour Design, ce n’est pas une première, puisque la commande /design existe en recherche préliminaire depuis le 17 août : la nouveauté tient à Slides et Docs. Le tweet ne précise ni version minimale, ni forfaits, ni documentation, et les notes de la dernière version publiée n’en parlent pas.
🔗 Annonce de @ClaudeDevs sur X
Zed ouvre Delta en bêta publique et remplace la pull request par une revue dans le fil
16 septembre — Zed ouvre Delta à tous. Lancé le 12 août sur inscription, puis sous Windows le 4 septembre pour les inscrits, l’outil se télécharge désormais librement sur macOS, Linux et Windows, s’utilise sur le web sans installation, et ses fils de discussion (threads) se suivent depuis un mobile.
L’idée centrale est de collaborer sans commit ni push. Un coéquipier invité dans la conversation avec l’agent voit les mêmes copies de travail (worktrees), peut les reprendre sur sa machine, interroger l’agent sur ses choix ou poursuivre si l’auteur se déconnecte. La revue de code, montrée en aperçu le 10 septembre, tient lieu de pull request : un sous-fil guide le relecteur dans les changements de la branche, avec le contexte de l’agent d’origine, sur une copie isolée des worktrees. La commande /land confie ensuite à l’agent le regroupement en un seul commit, le passage de la CI, la fusion après approbation de l’équipe et la suppression de la branche.
Sur le dépôt de Delta, les pull requests sont coupées depuis la semaine précédant l’annonce, et 33 personnes y ont fusionné 570 changements depuis ; le dépôt de l’éditeur Zed reste sur GitHub « pour l’instant ». Sous le capot, DeltaDB complète le versionnage de Git par des deltas incrémentaux qui conservent, entre deux commits, les modifications et les messages des humains comme des agents ; le commit reste le point de contrôle, si bien qu’un coéquipier qui n’ouvre jamais Delta voit un dépôt Git ordinaire.
Zed dit vouloir remplacer GitHub.com et nomme cette façon de travailler l’ingénierie continue (continuous engineering) ; sa feuille de route, sans date, prévoit un stockage Git dans DeltaDB et envisage à terme une vérification de type CI dans le fil. Delta est gratuit pendant la bêta, des offres payantes sont annoncées « bientôt », sans prix ni date, et Zed promet de garder une version gratuite.
🔗 Billet de Zed sur la bêta publique de Delta 🔗 Fil de Zed sur la commande /land
Vera Rubin NVL72 débute dans MLPerf Inference v6.1 avec jusqu’à 3,7 fois le débit de GB300 NVL72
16 septembre — NVIDIA fait débuter Vera Rubin NVL72, sa plateforme rack de prochaine génération, dans MLPerf Inference v6.1, dont MLCommons publie les résultats, avec des soumissions en préversion (preview). Selon les comparaisons de NVIDIA entre ses propres soumissions, le rack atteint jusqu’à 3,7 fois le débit de GB300 NVL72 sur Qwen3-VL, dans les scénarios hors ligne, serveur et interactif, avec vLLM et NVIDIA Dynamo, et jusqu’à 2,5 fois sur DeepSeek-R1 avec TensorRT-LLM. Nebius a aussi soumis des résultats Vera Rubin NVL72 en préversion.
NVIDIA attribue ces gains à la conception conjointe du matériel et du logiciel : précision NVFP4 pour les poids, l’attention et le cache KV, service désagrégé qui sépare préremplissage (prefill) et décodage, parallélisme d’experts à grande échelle et domaine NVLink de sixième génération, dont NVIDIA revendique un débit de paquets 10 fois supérieur à l’Ethernet standard. La génération actuelle publie aussi ses chiffres :
| Test MLPerf Inference v6.1 | Système soumis | Résultat publié par NVIDIA |
|---|---|---|
| DeepSeek-R1 hors ligne, de 72 à 288 GPU | GB300 NVL72, de 1 à 4 racks | 99 % d’efficacité de mise à l’échelle |
| WAN 2.2, texte vers vidéo | GB300 NVL72 | 0,65 vidéo 720p par seconde, 5,7 s par vidéo |
| Qwen3-VL, v6.1 face à v6.0 | GB300 NVL72 | Jusqu’à 1,6 fois, grâce au logiciel |
| Edge-Agentic, nouveau test (Qwen3.6-27B) | Jetson AGX Thor, TensorRT Edge-LLM | Soumission sans chiffre dans le billet |
NVIDIA fait aussi état de gains obtenus après la date limite sur GPT-OSS-120B et DLRMv3, que MLCommons n’a pas encore vérifiés. Elle revendique 19 partenaires, dont huit sur des systèmes multi-nœuds Blackwell NVL72, et évoque le futur test MLPerf Endpoints de MLCommons, qui doit standardiser la mesure de l’inférence agentique.
🔗 NVIDIA Vera Rubin NVL72 Delivers Leading Performance in MLPerf Inference v6.1 Debut
L’électricité au cœur des usines d’IA : DSX MaxLPS chez Lambda et l’alliance AEMA
15 et 16 septembre — Deux annonces de NVIDIA placent le réseau électrique au centre du déploiement de l’IA, avec Emerald AI dans les deux : une usine d’IA pilotée par son logiciel s’est effacée à la demande d’un fournisseur d’électricité, puis Emerald AI, Google et NVIDIA ont lancé une alliance pour des data centers flexibles.
AI Infra Summit : Lambda valide DSX MaxLPS, une usine d’IA s’efface à la demande du réseau
15 septembre — À l’AI Infra Summit, la keynote d’Ian Buck (NVIDIA) portait sur les tokens produits par mégawatt dans les usines d’IA (AI factories). Lambda a validé DSX MaxLPS, le logiciel de NVIDIA qui surveille la consommation des GPU et des racks et redistribue la puissance selon les charges : 19 nœuds HGX B200 ont tourné dans le budget électrique de 16 nœuds à pleine puissance, pour un débit passé d’environ 4 à 5 millions de tokens par seconde (+24 %) et une performance par watt en hausse de 23 %. NVIDIA projette jusqu’à 40 % de capacité GPU en plus pour Vera Rubin NVL72 dans le même budget, « dans des environnements adaptés ». Un soir d’août, un signal de Silicon Valley Power a fait descendre automatiquement de 4 à 3 MW une usine d’IA de Santa Clara pilotée par Emerald AI Conductor, sans interrompre l’inférence prioritaire ; plus de 200 signaux ont été honorés depuis, avec une réponse en moins d’une minute. DSX Flex, qui traite ce type de signaux, aura son premier déploiement commercial dédié dans une usine Vera Rubin de 96 MW à Manassas, en Virginie.
AEMA, une alliance pour des data centers qui s’adaptent au réseau
16 septembre — Emerald AI, Google et NVIDIA lancent l’AI Energy Management Alliance (AEMA), une coalition pour des data centers capables de moduler leur consommation selon l’état du réseau : déplacer des charges, puiser dans un stockage, s’appuyer sur une production associée ou réagir aux incidents. Ses principes : fixer avant le raccordement les obligations de maintien en service (ride-through), d’effacement (curtailment) et de réponse aux incidents, standardiser les métriques, ouvrir des voies de raccordement plus rapides aux engagements de flexibilité vérifiables et répartir les coûts selon les impacts réels. L’alliance vise les États-Unis, et ses partenaires de lancement ne sont pas nommés. Sur son site, elle avance deux potentiels : 100 GW débloquables sur le réseau existant avec des data centers modérément flexibles, et 733 millions de dollars de coûts évités par GW de nouveaux data centers flexibles. NVIDIA et Emerald AI présentaient déjà des usines d’IA flexibles à la CERAWeek, le 31 mars.
🔗 Billet de NVIDIA sur AEMA 🔗 Site d’AEMA
Les agents de marque entrent dans la publicité, chez ChatGPT et sur YouTube
16 septembre — Le même jour, OpenAI et Google placent l’agent conversationnel d’une marque dans le format publicitaire, aux États-Unis : en test avec des annonceurs sélectionnés chez OpenAI, en bêta sur inscription des marchands chez Google.
ChatGPT Ads teste les Sponsored Agents et se branche sur HubSpot et Shopify
OpenAI ajoute de l’IA des deux côtés de sa régie ChatGPT Ads. Avec les Sponsored Agents, un clic sur une publicité dans ChatGPT peut ouvrir une conversation clairement signalée avec un agent sponsorisé par la marque, avant un lien vers son site. OpenAI précise que cet échange est distinct des réponses indépendantes de ChatGPT et séparé de la conversation d’origine.
| Nouveauté de ChatGPT Ads | Statut au 16 septembre |
|---|---|
| Sponsored Agents | En test avec des annonceurs sélectionnés aux États-Unis |
| Plugin Ads Manager, campagnes pilotées par prompts | En déploiement |
| Textes et visuels suggérés dans Ads Manager | En déploiement |
| Personnalisation et traduction du texte | Lancées, activables sur option (opt-in) |
| Intégration HubSpot | Disponible |
| Application ChatGPT Ads pour Shopify | Marchands américains, autres marchés de ChatGPT Ads à partir du 23 septembre |
Le billet ne donne ni tarif ni nombre d’annonceurs. Testée dans ChatGPT en février, la publicité a gagné en mai un Ads Manager en bêta et en libre-service (self-service), puis OpenAI a revendiqué le 31 août un milliard de dollars de revenu annualisé en élargissant ce libre-service.
🔗 Reimagining advertising with AI
Google place Business Agent dans les publicités YouTube et étoffe le commerce agentique
Google publie ses mises à jour de commerce agentique (agentic commerce) pour les fêtes. Business Agent, arrivé dans Search « plus tôt cette année » selon Google, entre en bêta dans les publicités YouTube aux États-Unis, sur inscription des marchands : le spectateur interroge l’agent sur les produits sans quitter YouTube. AI performance insights, qui compare la part de voix (share of voice) d’une marque dans AI Mode et AI Overviews, devient disponible dans Merchant Center en Australie, au Canada, en Inde, en Nouvelle-Zélande et aux États-Unis. Dans Merchant Center, le hub d’intégration d’UCP (Universal Commerce Protocol), le protocole présenté par Google le 11 janvier, ajoute le transfert du panier vers le site du marchand et des tests du parcours de paiement, des analyses arrivant « bientôt » ; ces fonctions se déploient progressivement aux États-Unis, puis en Australie et au Canada « au début de l’année prochaine ». Tapestry (Coach, Kate Spade) vend déjà via UCP dans Search et l’application Gemini. Selon Google, les bonnes pratiques de flux produits apportent en moyenne 5 % de conversions en plus le mois suivant, et, lors de tests avec lululemon, les attributs conversationnels de la marque ont été repris dans 50 % des recommandations pertinentes d’AI Mode.
🔗 Billet de Google sur le commerce agentique
Cohere signe avec Aleph Alpha et lance Confidential Computing dans Model Vault
16 septembre — Cohere multiplie les annonces, dont deux tournées vers les clients qui veulent garder le contrôle de leurs données et de leur technologie.
Aleph Alpha : accord définitif et double siège à Berlin et à Toronto
Cohere et Aleph Alpha ont signé l’accord définitif de rapprochement (definitive business combination agreement), dont le projet avait été annoncé le 24 avril. L’ensemble opérera sous le nom Cohere, avec plus de 1 000 salariés, un double siège prévu à Berlin et à Toronto et un centre de recherche à Heidelberg, sur le site d’Aleph Alpha. La transaction, dont aucun montant n’est communiqué, reste soumise aux dernières autorisations réglementaires ; sa clôture est attendue « plus tard cette année ». Ilhan Scheer, co-PDG d’Aleph Alpha, deviendra alors directeur des opérations de Cohere, et Samuel Weinbach, cofondateur, directeur de la recherche. Le partenariat avec le groupe Schwarz se poursuit sur STACKIT, son cloud souverain.
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇫🇷 Aucun gouvernement ni aucune entreprise ne devrait avoir à choisir entre une IA performante et le contrôle de sa technologie. C’est précisément cette conviction qui nous pousse à unir nos forces avec Aleph Alpha. Ensemble, nous répondrons à la demande mondiale croissante d’une IA de frontière à la fois puissante et sûre. — Aidan Gomez (Cohere), cité par @cohere sur X
🔗 Billet de Cohere sur l’accord
Confidential Computing dans Model Vault, en accès anticipé
Cohere lance Confidential Computing dans Model Vault, sa plateforme d’inférence dédiée et entièrement gérée, pour protéger les données pendant leur traitement, et plus seulement au repos et en transit. Trois mécanismes sont décrits : une inférence chiffrée de bout en bout, une isolation imposée par le matériel qui s’étend jusqu’au GPU avec NVIDIA Confidential Computing, et un jeton d’attestation signé, disponible à la demande et vérifiable avec les clés publiques du fabricant du matériel. Cohere affirme que personne, « pas même nous », ne peut accéder aux charges de travail du client, sans mentionner d’audit tiers. L’accès anticipé est réservé à un groupe limité de clients bêta, sans tarif, date de disponibilité générale ni liste de modèles, et l’annonce se limite à des tweets et à une page produit. La fonction avait été annoncée pour bientôt le 9 septembre.
🔗 Annonce de Cohere sur X 🔗 Page produit de Model Vault
Mistral propulse Smart Window, l’assistant IA de Firefox
16 septembre — Dans un billet commun, Mistral AI et Mozilla annoncent que Smart Window, l’assistant de navigation IA de Firefox encore en bêta, fonctionne désormais avec des modèles Mistral, sans préciser lesquels. L’assistant aide à démêler des recherches complexes et à rassembler des sources à partir des onglets ouverts. Mistral l’alimente d’abord pour les utilisateurs en France et en Amérique du Nord, le Royaume-Uni et l’Allemagne étant attendus « plus tard cette année ». Par défaut, les conversations ne sont pas conservées sur les serveurs de Mozilla, et les partenaires comme Mistral s’engagent à une rétention nulle des données (zero data retention). Pour Mistral, qui dit servir « traditionnellement » les entreprises, l’accord ouvre un accès au grand public. Arthur Mensch, cofondateur et CEO de Mistral, parle de deux défenseurs de l’open source qui travaillent ensemble, et Anthony Enzor-DeMeo, CEO de Mozilla Corporation, estime qu’un navigateur ne doit pas être un entonnoir à sens unique.
🔗 Billet commun de Mistral et Mozilla
Grok Build retient les conventions et les décisions d’un projet d’une session à l’autre
16 septembre — SpaceXAI dote Grok Build, son agent de code, d’une mémoire. Après chaque tour terminé, Grok le relit en arrière-plan, sans bloquer la session, et consigne dans une note Markdown ce qui dure : conventions de l’équipe, décisions et leur justification, faits du projet comme la commande qui lance les tests. L’état des tâches, les conclusions provisoires, les secrets et ce que couvrent déjà le dépôt ou sa documentation sont exclus. Les notes sont rangées par projet, avec un ensemble global pour les préférences valables partout. La commande /dream les regroupe en fichiers thématiques et s’exécute aussi d’elle-même périodiquement, tandis que /memory ouvre un navigateur en lecture seule. En revenant sur un projet, Grok lit les thèmes de la zone où il va travailler, mais la conversation en cours l’emporte sur les notes. La mémoire ne vaut que pour les nouvelles sessions. La bêta du 25 mai listait déjà une persistance des décisions entre sessions ; le billet en détaille le mécanisme.
Qwen Code v0.24.0 confine l’agent au niveau du noyau sous Linux et change les hooks bash
16 septembre — Deux jours après la v0.23.4, Qwen Code v0.24.0 ajoute sous Linux un bac à sable fondé sur le noyau via bubblewrap (bwrap), sans conteneur, droits root, démon ni image. Sur option, il relance la CLI derrière une vue en lecture seule du système de fichiers, où seuls l’espace de travail et quelques répertoires (temporaires, cache, Qwen, Git) restent inscriptibles ; qwen sandbox affiche la configuration et --verify teste le confinement. L’auteur de la PR en liste les limites : pas d’espace de noms PID séparé, sockets Unix de l’hôte joignables, réglages Git et Qwen modifiables. Changement incompatible (breaking change) : dans les hooks exécutés sous bash, $QWEN_PROJECT_DIR et ses équivalents Claude et Gemini, lus dans l’environnement au lieu d’être substitués, doivent figurer entre guillemets doubles. web_search est plafonné par session (200 par défaut, 10 000 au maximum), un budget comme +500k dans le message dimensionne tout un tour, et la messagerie entre sessions est activée par défaut.
Devin lance Code Scans, des audits de toute la base de code guidés par un objectif
16 septembre — Cognition lance Code Scans dans Devin : on part d’un objectif large plutôt que d’une modification précise, avec au besoin ses propres critères (normes de l’équipe, grille d’accessibilité, exigences d’une migration), et Devin enquête sur la base de code, hiérarchise ses constats, en discute puis ouvre les pull requests demandées. Lancé par /scan dans l’application web, déjà mentionné dans les notes de version du 2 septembre, le scan reprend l’architecture MapReduce agentique (Agentic MapReduce) de Devin Security Swarm, présentée en juillet, en quatre phases : planification, découpage en lots, exploration en parallèle, synthèse. Cognition publie deux essais : sur Dioxus, une compilation debug complète de 22 crates passe de 58,6 à 21,0 secondes, soit 64 % de moins ; un scan SEO de devin.ai et de cognition.com relève 44 constats, après quoi le score Ahrefs de devin.ai passe de 87 à 92 et ses pages lentes reculent de 73 %. Aucun tarif n’est précisé.
Claude for Small Business passe à 43 flux de travail et 27 nouvelles intégrations
15 septembre — Dans un billet que notre relevé du 15 septembre n’avait pas repéré, Anthropic étend Claude for Small Business, son plugin pour petites entreprises lancé en mai avec 15 flux de travail (workflows). Il en compte désormais 43, avec 27 nouvelles intégrations dont Shopify, Salesforce, TikTok, Atlassian, Zoom, Xero, Gusto, Square, Stripe et Zapier, et revendique plus de 900 000 installations. Chaque flux démarre en mode approbation, et l’autonomie se règle flux par flux, de façon réversible. Anthropic relance aussi la formation : tournée d’automne avec Tenex dans 10 villes américaines, plus de 150 organisations formatrices agréées pour plus de 750 ateliers, et 14 webinaires partenaires. L’offre est disponible sur tous les forfaits payants ; le bilan de la tournée de printemps avait été publié le 10 septembre.
🔗 Billet d’Anthropic sur Claude for Small Business
ElevenLabs lance Reception, un réceptionniste IA pour les petites entreprises
16 septembre — ElevenLabs lance Reception, un réceptionniste IA pour petites entreprises bâti sur sa plateforme ElevenAgents. Il répond 24 h/24 aux questions sur les services, les horaires ou l’adresse, dans la langue de l’appelant, puis réserve le rendez-vous dans le calendrier, au choix en débordement quand l’équipe ne décroche pas ou après la fermeture. Le service a son propre site, reception.ai, et s’essaie gratuitement pendant 14 jours avec 30 minutes d’appel.
| Formule Reception | Prix mensuel hors taxes | Minutes d’appel incluses |
|---|---|---|
| Basic | 29 dollars | 75 |
| Plus | 79 dollars | 275 |
| Premium | 199 dollars | 1 000 |
| Enterprise | Sur devis | Sur mesure |
Toutes les formules incluent plus de 70 langues, Google Calendar, Calendly, Zapier, des webhooks et un serveur MCP.
🔗 Introducing Reception, by ElevenAgents 🔗 Tarifs de Reception
Synthesia ouvre son Interactive Avatar API, des avatars temps réel à 0,10 euro la minute
16 septembre — Synthesia met en disponibilité générale son Interactive Avatar API, qui intègre à un produit des avatars capables d’écouter, de parler et de répondre en temps réel. Le client apporte son LLM, sa base de connaissances et sa logique ; Synthesia gère le visage, la voix et la synchronisation labiale. L’avatar rejoint une salle LiveKit comme participant vidéo grâce à un plugin qui, selon la FAQ, ne prend en charge pour l’instant que les agents LiveKit écrits en Python. L’API se facture à l’usage, 0,10 euro la minute, sans engagement, avec 500 minutes offertes. Un plugin Pipecat et une offre de bout en bout, avec LLM, connaissances et voix gérés, sont annoncés « bientôt », sans date. Synthesia avait publié en juillet le cadre de recherche de ses modèles d’avatars interactifs.
🔗 Annonce de Synthesia sur X 🔗 Page Interactive Avatars de Synthesia
Koa, le modèle CRM de Salesforce construit sur Nemotron 3 Super
15 septembre — À Dreamforce, Salesforce a présenté Koa, son premier modèle de raisonnement dédié à la gestion de la relation client (CRM), obtenu par post-entraînement de NVIDIA Nemotron 3 Super avec NeMo RL, NeMo Gym et NeMo AutoModel sur un jeu de données synthétique. Salesforce contrôle les poids et exécute le modèle sur sa propre infrastructure ; selon Salesforce, aucune donnée client n’a servi à l’entraînement ni ne sert à l’inférence. Sur CRM Bench, son propre benchmark (mise à jour d’une opportunité, routage d’un dossier, planification d’une relance), Koa égale ou dépasse les modèles de pointe avec trois fois moins d’erreurs, sans que les modèles comparés soient nommés. Déjà utilisé en interne dans Slack, il entre en octobre en pilote comme modèle sélectionnable dans Agentforce, notamment chez Formula 1 et Xero, avant une disponibilité générale attendue à l’hiver 2026 dans les régions américaines.
🔗 Billet de NVIDIA sur Jensen Huang à Dreamforce
Runway détaille la modération en temps réel de ses futurs modèles vidéo
16 septembre — Runway prévoit de lancer des modèles de génération vidéo en temps réel « dans les prochains mois » et explique comment elle les modérera. En diffusion continue (streaming), l’utilisateur voit la vidéo avant tout contrôle final. Runway a donc conçu et testé un dispositif plus rapide : vérification accélérée des entrées, modération synchrone qui analysera les images du flux et coupera la diffusion dès qu’un contenu problématique apparaît, puis contrôle de la vidéo complète avant tout téléchargement ou partage. Le classifieur, CoPE-B de Zentropi, est un adaptateur LoRA sur Gemma-4-26B-A4B-it, un mélange d’experts de 25,2 milliards de paramètres dont 3,8 milliards actifs ; la vérification prend en moyenne moins de 0,5 seconde. En test, des entrées limites ont brièvement laissé apparaître du contenu interdit avant la coupure. Le dispositif s’ajoutera aux protections existantes de Runway, et les vidéos temps réel porteront, comme ses autres créations, des signaux de provenance C2PA.
Brèves
- Zed 1.20.1 ajoute Gemini 3.8 Flash — la version stable hebdomadaire de l’éditeur apporte aussi une animation optionnelle du curseur, l’ouverture des fichiers Markdown en aperçu rendu et des binaires macOS et Linux environ 25 % plus petits ; elle corrige un défaut qui pouvait exposer des fichiers privés aux collaborateurs via la recherche dans le projet. 🔗 source
- Replit ouvre en bêta les connecteurs personnalisés (Custom Connectors) — les administrateurs d’un espace de travail y déclarent une API REST en HTTPS, authentifiée par clé d’API, pour que l’Agent l’utilise au-delà des connecteurs officiels ; la documentation cite les clients Pro et Enterprise, mais un encadré réserve la bêta à Enterprise. 🔗 source
- NVIDIA confie à des agents le portage de TileGym vers cuTile Rust — huit jours après le lancement de CUDA Rust, une skill multi-agents livrée dans TileGym a porté les 24 opérateurs publics de la bibliothèque, qui conservent en moyenne 99,5 % des performances de cuTile Python sur 347 configurations mesurées sur DGX B200. 🔗 source
- OpenAI publie un guide des analyses de l’Admin Console — les vues Usage, Insights et Outcomes, cette dernière mesurant la part des commits fusionnés avec contribution de Codex, doivent relier l’usage de ChatGPT Work et de Codex à des résultats ; le retour sur investissement de 245 % cité est explicitement hypothétique, et la documentation liée restait introuvable lors de notre relevé. 🔗 source
- L’API OpenAI encadre la création des clés — inscrite au changelog le 15 septembre, cinq jours après l’arrivée des dates d’expiration, la section API Key Governance permet aux administrateurs de n’autoriser que les clés de compte de service, ou que les clés de projet détenues par un utilisateur, ou de bloquer toute nouvelle clé ; les clés existantes ne changent pas. 🔗 source
- Copilot : les demandes de rallonge de budget passent en disponibilité générale — sur Copilot Business et Enterprise en facturation à l’usage, un membre qui a épuisé ses crédits IA peut demander un budget supplémentaire ; propriétaires et gestionnaires de facturation fixent le montant et valident, ce qui rétablit l’accès immédiatement. 🔗 source
- L’AI Scan des pull requests n’exige plus la configuration par défaut de CodeQL — la détection de vulnérabilités par IA sur les pull requests s’étend aux dépôts éligibles sans cette configuration, en préversion publique pour les clients GitHub Advanced Security sur github.com ; GitHub Enterprise Server n’est pas pris en charge. 🔗 source
- Les configurations GitHub Advanced Security s’imposent aux organisations — depuis le 15 septembre, les administrateurs d’entreprise peuvent empêcher les administrateurs d’organisation, et plus seulement les propriétaires de dépôt, de modifier les configurations de sécurité fixées au niveau de l’entreprise. 🔗 source
- GitHub désactive SHA-1 en HTTPS — comme annoncé le 20 avril, le changelog du 15 septembre confirme la fin de SHA-1 dans les connexions HTTPS vers github.com et ses CDN partenaires, GitHub Enterprise Cloud compris ; navigateurs, clients de l’API et Git en HTTPS sont concernés, GitHub Enterprise Server ne l’est pas. 🔗 source
- MiniMax H3 arrive sans serveur (serverless) sur Together AI — annoncé dans un tweet du 15 septembre à 16 h 58, heure du Pacifique, le modèle vidéo ouvert de 33 milliards de paramètres, qui génère des clips de 4 à 15 secondes jusqu’en 2K avec son stéréo natif, y est affiché à 0,1391 dollar par vidéo. 🔗 source
- MiniMax présente H3 IP Edition — en dressant le bilan de sa conférence de Tokyo avec KAGAMI AI, MiniMax dit avoir dévoilé une édition de H3 associée à des propriétés intellectuelles japonaises sous licence officielle, sans catalogue de licences, date ni tarif. 🔗 source
- Runway ajoute cinq modèles tiers avec sa collection Fall 2026 — Fish Audio S2.1 Pro, Cartesia Sonic 3.6, MiniMax H3 Max, FLUX Video Upscale et FLUX Video Edit rejoignent la plateforme, sans tarif annoncé ; plusieurs étaient déjà disponibles ailleurs, comme FLUX Video Upscale chez Black Forest Labs depuis le 20 août et H3 Max depuis le 27 août. 🔗 source
- Luma lance Camera Angles — publiée le 15 septembre à 16 h 26 heure du Pacifique, la fonction de Luma Agents régénère le sujet d’une seule photo sous les angles choisis, détails conservés, sans modèle nommé ni chiffre. 🔗 source
- Grok Voice arrive sur fal — la plateforme d’inférence propose le modèle vocal de SpaceXAI en Speech to Speech et en temps réel ; selon fal, il répond en 0,70 seconde et coûte 0,00083 dollar par seconde, et un atelier en direct avec SpaceXAI est prévu le 22 septembre. 🔗 source
- OpenText et Cohere s’allient pour les secteurs réglementés — annoncé à la conférence ALL IN AI de Montréal, le partenariat intégrera North et les modèles Cohere aux agents OpenText Aviator, déployables sur site ou en cloud privé, public ou souverain ; l’offre commune est attendue chez les clients début 2027. 🔗 source
- Manus noue des partenariats de formation à Singapour — l’agent figure dans SkillsFuture AI Subscription, qui offre six mois d’accès gratuit aux Singapouriens éligibles inscrits à certains cours d’IA, et dans le Singtel AI Pass ; un défi inter-campus a réuni plus de 1 100 inscriptions, et Manus lance un appel mondial à partenaires d’apprentissage. 🔗 source
- L’université de Manchester prévoit la pollution de l’air avec Earth-2 — réentraîné en deux jours sur un nœud de 8 GPU du supercalculateur Isambard-AI, Earth-2 CorrDiff couvre tout le Royaume-Uni à une résolution de 2 à 3 km², et l’équipe promet de publier données et workflows en open source. 🔗 source
- L’hôpital pour enfants de Philadelphie modélise les cœurs en quelques secondes — bâti sur le framework open source MONAI, le service du CHOP produit des modèles cardiaques qui demandaient environ quatre heures de travail, avec environ 200 cas prévus cette année, et des outils bâtis sur Newton, en cours d’intégration, peuvent ramener les simulations de pose de dispositifs à un temps quasi réel. 🔗 source
- Google publie une étude sur les adolescents américains et l’IA — menée avec RXN auprès de plus de 1 000 jeunes de 13 à 17 ans, l’étude U.S. Future Report indique que 94 % d’entre eux ont utilisé l’IA dans l’année écoulée et que 55 % recoupent les réponses avec d’autres sources ; aucun produit n’est annoncé. 🔗 source
- Perplexity publie un guide sur les détecteurs de texte IA — son exemple, présenté comme hypothétique, montre qu’un détecteur qui se trompe sur 2 % des textes humains peut signaler 64 articles sur 1 000, dont 19 écrits par des humains, soit près de 30 % d’erreurs ; le guide conseille de traiter un signalement comme le début d’un examen. 🔗 source
- GiniGEN AI classe 425 modèles d’OpenRouter — billet communautaire publié sur le blog Hugging Face : le classement ajoute une latence au premier token mesurée sur 329 modèles et une note de qualité en coréen ; seuls 8,5 % des modèles notés obtiennent un A sur les formes honorifiques et 9,4 % sur les institutions coréennes. 🔗 source
Ce que ça signifie
L’agent devient l’interface, et le choix du mode disparaît. Dans le nouveau Claude, on ne décide plus entre une conversation et un espace de travail : Claude choisit entre recherche web, fichiers et code, puis rend un document ou une présentation. Delta applique la même logique à la livraison du code, avec une revue dans le fil et une commande /land qui enchaîne commit, CI et fusion à la place de la pull request. Devin Code Scans part d’un objectif plutôt que d’une modification, et Grok Build retient d’une session à l’autre les conventions et les décisions d’un projet. Le contrôle humain change de place sans disparaître : mode Manuel par défaut chez Claude, approbation de l’équipe avant la fusion chez Zed, discussion des constats avant toute pull request chez Devin.
Les agents entrent aussi dans le circuit commercial. OpenAI teste des Sponsored Agents qui prennent le relais d’une publicité, Google place Business Agent dans les publicités YouTube et outille le paiement avec UCP, et les deux séparent l’agent de marque du reste : conversation signalée et distincte des réponses indépendantes de ChatGPT d’un côté, bêta sur inscription des marchands de l’autre. Pour les petites entreprises, Claude for Small Business revendique 43 flux de travail et plus de 900 000 installations, et ElevenLabs vend dès 29 dollars par mois un réceptionniste qui prend les rendez-vous. Synthesia facture 0,10 euro la minute un avatar qui parle dans le produit de ses clients, et Salesforce fait de Koa un modèle sélectionnable dans Agentforce : l’agent ne se contente plus d’assister l’entreprise, il s’adresse en son nom à ses clients.
La confiance devient un argument de vente, et les éditeurs cherchent à la rendre vérifiable. Cohere et Aleph Alpha mettent en avant la souveraineté, avec un double siège à Berlin et à Toronto, et Model Vault délivre un jeton d’attestation que le client contrôle avec les clés publiques du fabricant du matériel. Mistral apporte à Firefox un engagement de rétention nulle, Salesforce garde les poids de Koa sur son infrastructure, Runway prévoit de couper un flux vidéo dès qu’un contenu problématique apparaît, OpenAI laisse les administrateurs restreindre la création de clés API, et Qwen Code confine son agent au niveau du noyau en publiant la liste de ses limites. Les garanties les plus solides sont celles qu’un client peut contrôler lui-même ; un benchmark maison comme CRM Bench ou un « pas même nous » sans audit tiers mentionné restent des affirmations.
Enfin, le calcul bute sur l’électricité. Vera Rubin NVL72 affiche jusqu’à 3,7 fois le débit de GB300 NVL72 selon NVIDIA, mais les annonces les plus concrètes de ces deux jours portent sur le mégawatt : Lambda loge 19 nœuds dans le budget électrique de 16, une usine d’IA de Santa Clara descend de 4 à 3 MW à la demande de son fournisseur, et AEMA réclame des raccordements plus rapides en échange d’une flexibilité vérifiable. Le débit par rack reste l’argument technique, mais l’accès au réseau conditionne la vitesse à laquelle ces racks entrent en service.
Sources
- Claude, Claude Cowork and chat are now one Claude
- Centre d’aide Claude, fusion du chat et de Cowork
- Boris Cherny sur X, le chat et Cowork commencent à fusionner
- Claude Devs sur X, Design, Slides et Docs dans Claude Code
- Zed, bêta publique de Delta
- Zed sur X, la commande /land
- NVIDIA, Vera Rubin NVL72 dans MLPerf Inference v6.1
- NVIDIA, blog en direct de l’AI Infra Summit
- NVIDIA, lancement de l’AI Energy Management Alliance
- AI Energy Management Alliance, site officiel
- OpenAI, Reimagining advertising with AI
- Google, mises à jour de commerce agentique pour les fêtes
- Cohere, accord définitif avec Aleph Alpha
- Cohere sur X, citation d’Aidan Gomez
- Cohere sur X, Confidential Computing dans Model Vault
- Cohere, page produit de Model Vault
- Mistral AI, partenariat avec Mozilla
- SpaceXAI, Memory in Grok Build
- Qwen Code, notes de version v0.24.0
- Cognition, Introducing Code Scans
- Claude, nouveaux flux de travail de Claude for Small Business
- ElevenLabs, Introducing Reception
- Reception, tarifs
- Synthesia sur X, Interactive Avatar API
- Synthesia, page Interactive Avatars
- NVIDIA, Jensen Huang à Dreamforce
- Runway, Moderation in Real Time
- Zed, notes de version 1.20.1
- Replit sur X, Custom Connectors en bêta
- NVIDIA, portage de TileGym vers cuTile Rust
- OpenAI, relier l’usage de l’IA à la valeur métier
- OpenAI, changelog de l’API
- GitHub Changelog, demandes de rallonge de budget Copilot
- GitHub Changelog, AI Scan sans configuration par défaut de CodeQL
- GitHub Changelog, configurations GitHub Advanced Security imposées
- GitHub Changelog, fin de SHA-1 en HTTPS
- Together AI sur X, MiniMax H3 sans serveur
- MiniMax sur X, H3 IP Edition
- Runway sur X, collection Fall 2026
- Luma sur X, Camera Angles
- fal sur X, Grok Voice
- OpenText, partenariat avec Cohere
- Manus sur X, Learn AI with Manus
- NVIDIA, Earth-2 et la pollution de l’air au Royaume-Uni
- NVIDIA, le CHOP et la modélisation cardiaque
- Google, U.S. Future Report sur les adolescents et l’IA
- Perplexity, guide des détecteurs de texte IA
- Hugging Face, classement GiniGEN AI des modèles OpenRouter