ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
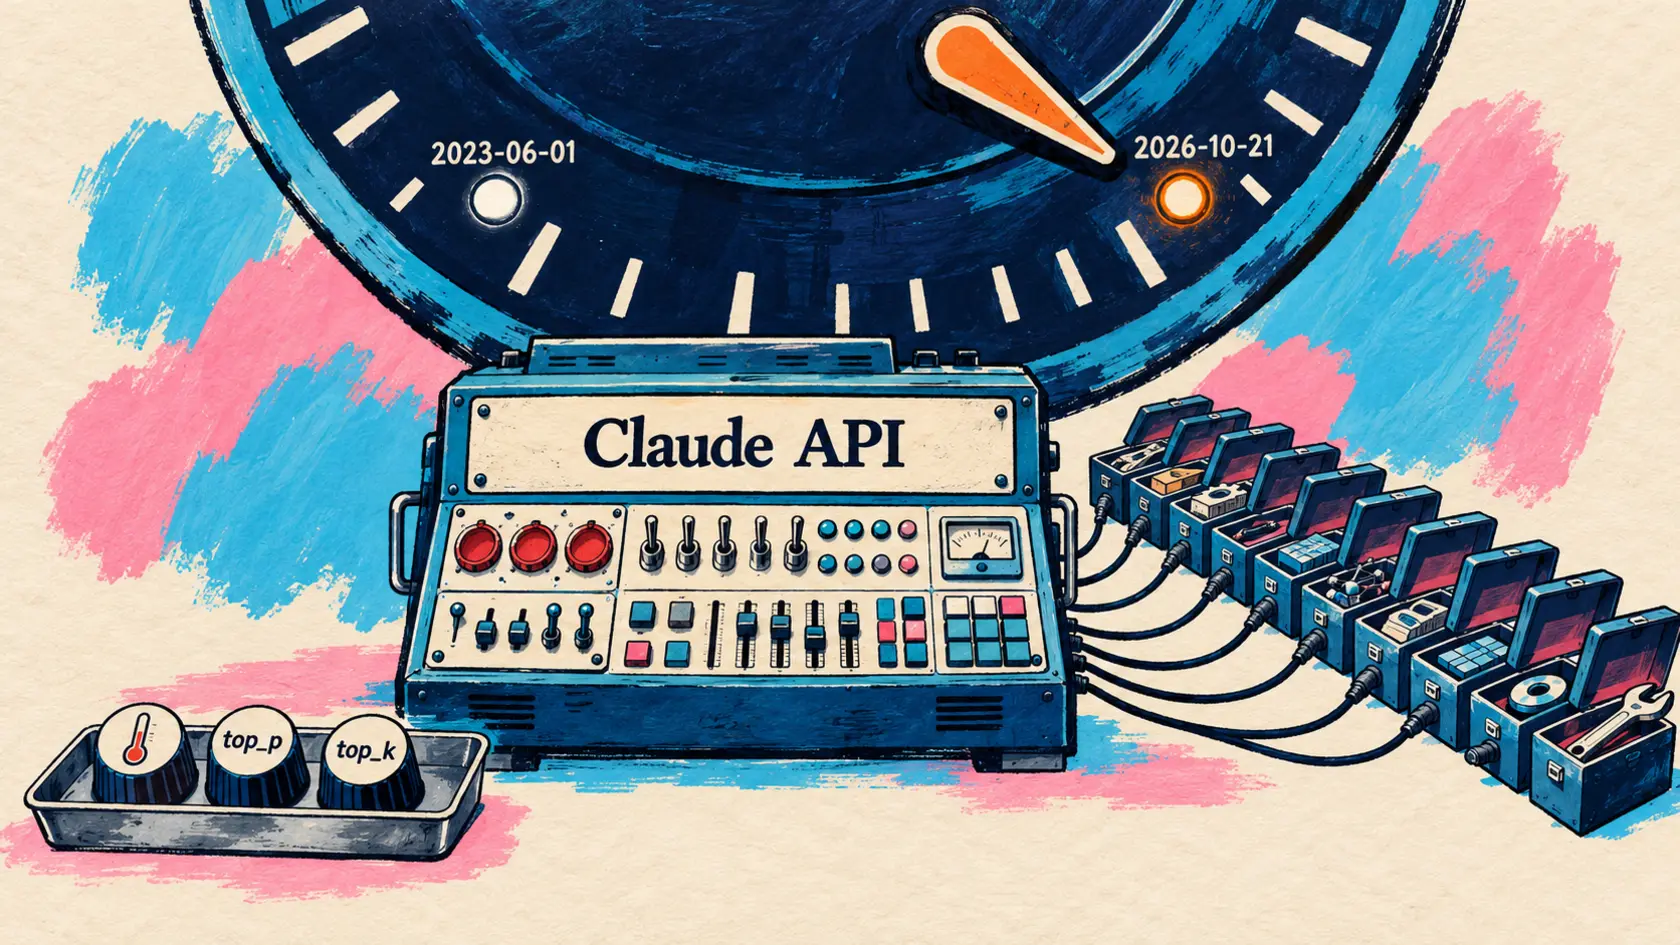
Anthropic ने Claude API का 2026-10-21 संस्करण जारी किया है, जो 2023 के बाद इसका पहला संस्करण है: इसमें temperature, top_p और top_k स्वीकार नहीं किए जाते, और सभी SDK के नए प्रमुख संस्करण Apache 2.0 लाइसेंस के अंतर्गत आए हैं। Hugging Face ने Carbon-X पेश किया है, जो 14 अरब पैरामीटर वाला खुला मॉडल है और लगभग GPT-6.1 Sol के स्तर पर डीएनए पढ़ता और तैयार करता है। METR ने Redwood Research के साथ OpenAI के आंतरिक एजेंटों की निगरानी प्रणाली पर हमले करने में बिताए गए तीन सप्ताह का लेखा-जोखा प्रकाशित किया है। Agent Skills और OpenEnv, Agentic AI Foundation में MCP के साथ शामिल हुए हैं, OpenAI का Decisions API सामान्य उपलब्धता में आ गया है, और NVIDIA ने GTC Berlin का दूसरा दिन Cosmos और Minerva को समर्पित किया है।
Claude API 2026-10-21: 2023 के बाद पहला संस्करण temperature, top_p और top_k को अस्वीकार करता है
21 अक्टूबर — Anthropic ने Claude API का 2026-10-21 संस्करण जारी किया है, जिसे anthropic-version हेडर में मान के रूप में देना होगा। इसके साथ उसके सभी SDK और उसके CLI ant के नए प्रमुख संस्करण भी जारी हुए हैं।
API version 2026-10-21 is now available. The Claude API has evolved a lot, but this is our first official version release since 2023. We plan to release versions more often so you can handle breaking changes before a new model requires them. 2023-06-01 is not deprecated.
🇮🇳 API का संस्करण 2026-10-21 उपलब्ध है। Claude API में काफ़ी बदलाव हुए हैं, लेकिन 2023 के बाद यह हमारा पहला आधिकारिक संस्करण प्रकाशन है। हमारी योजना अधिक बार संस्करण जारी करने की है, ताकि किसी नए मॉडल द्वारा इन बदलावों को अनिवार्य बनाए जाने से पहले आप संगतता तोड़ने वाले बदलावों को संभाल सकें। 2023-06-01 को अप्रचलित घोषित नहीं किया गया है। — X पर @ClaudeDevs
सबसे स्पष्ट बदलाव सैंपलिंग में हुआ है। 2026-10-21 के साथ, temperature, top_p और top_k के कारण Messages API में, टोकन गिनती में और बैच (Message Batch) की हर रिक्वेस्ट में 400 त्रुटि आती है, यहाँ तक कि उनके डिफ़ॉल्ट मान पर भी; इनके बिना रिक्वेस्ट 1.0 तापमान पर सैंपलिंग करती है। Claude 4.7 और उसके बाद के मॉडल पहले से ही केवल इन मानों को स्वीकार करते थे। हालाँकि, Claude Sonnet 4.6 जैसे पुराने मॉडल पर अधिक एकरूप आउटपुट पाने के लिए कम किया गया तापमान अपना असर खो देता है, और उसकी जगह कोई दूसरी सेटिंग उपलब्ध नहीं है: ऐसे में दस्तावेज़ उस रिक्वेस्ट के लिए 2023-06-01 का उपयोग जारी रखने की सलाह देते हैं।
| रिक्वेस्ट का तत्व | 2026-10-21 के साथ प्रभाव |
|---|---|
temperature, top_p, top_k | 400 त्रुटि, डिफ़ॉल्ट मान पर भी |
| असिस्टेंट के संदेश में सीधे रखा गया दस्तावेज़ ब्लॉक | 400 त्रुटि (वेब फ़ेच के परिणाम जैसा नेस्टेड दस्तावेज़ अब भी स्वीकार किया जाता है) |
| उपयोगकर्ता के संदेश के टेक्स्ट ब्लॉक पर गैर-रिक्त उद्धरण | 400 त्रुटि, search_result सहित |
API कुंजियों का workspace_id | हटाया गया, उसकी जगह scope |
| Admin API और Enterprise Analytics API के बदले हुए नाम वाले फ़ील्ड | पुराने नाम हटा दिए गए |
Python 2.0.0, TypeScript 1.0.0, C# 13.0.0, Go 2.0.0, Java 3.0.0, PHP 1.0.0, Ruby 2.0.0 और ant CLI 2.0.0 डिफ़ॉल्ट रूप से नया संस्करण भेजते हैं। ये SDK, MIT की जगह Apache 2.0 लाइसेंस अपनाते हैं, जबकि पुराने संस्करण MIT के अंतर्गत बने रहते हैं। इनमें अपने स्तर पर भी संगतता तोड़ने वाले बदलाव हैं: हर भूमिका के लिए अलग संदेश प्रकार, API कुंजी को X-Api-Key के बजाय Authorization: Bearer में भेजना (API अब भी दोनों को स्वीकार करता है), पुराने Text Completions API को हटाना (TypeScript, Go, Java, Ruby और CLI में) और टूल रनर के क्लाइंट पर होने वाले कॉम्पैक्शन को हटाकर सर्वर पर होने वाले कॉम्पैक्शन को अपनाना।
माइग्रेशन के लिए Anthropic ने चरण-दर-चरण मार्गदर्शिका प्रकाशित की है और Claude Code के /claude-api स्किल की ओर निर्देशित किया है, जिसके संस्करण 2.1.307 में /claude-api api-version कमांड जोड़ा गया है। Amazon Bedrock पर 2026-10-21 केवल Claude 4.7 और उसके बाद के मॉडलों के लिए उपलब्ध है। उसी दिन, रिलीज़ नोट्स में उपयोगकर्ता प्रोफ़ाइल (यूज़र प्रोफ़ाइल) में enforcement_status और enforcement_actions फ़ील्ड जोड़े गए, जो बताते हैं कि Anthropic ने किसी संगठन के किसी अंतिम ग्राहक पर प्रतिबंध लगाया है या उसे पूरी तरह प्रतिबंधित किया है।
🔗 2026-10-21 पर माइग्रेशन की मार्गदर्शिका · Claude Platform के रिलीज़ नोट्स
Carbon-X: Hugging Face ने डीएनए पढ़ने और तैयार करने वाला 14 अरब पैरामीटर का खुला मॉडल जारी किया
22 अक्टूबर — Hugging Face ने Carbon-X जारी किया है, जो 14 अरब पैरामीटर वाला खुला मॉडल है और डीएनए तथा प्राकृतिक भाषा को एक ही टोकन प्रवाह में संसाधित करता है: इससे किसी अनुक्रम के बारे में पूछा जा सकता है, किसी उत्परिवर्तन का प्रभाव जाना जा सकता है या डीएनए तैयार करवाया जा सकता है। Qwen3-14B से निकला यह मॉडल HuggingFaceBio संगठन ने Apache 2.0 लाइसेंस के अंतर्गत जारी किया है, जिसने 8 अक्टूबर को जीन एनोटेटर Carbon-A जारी किया था।
लुबना बेन अल्लाल, लुईस टनस्टॉल और लिआंड्रो फ़ॉन वेरा की टीम ने डीएनए, अंग्रेज़ी और आपस में गुंथे हुए डेटा के मिश्रण वाले 300 अरब टोकन पर Qwen3-14B का प्रशिक्षण आगे बढ़ाया (मिडट्रेनिंग), फिर पर्यवेक्षित फ़ाइन-ट्यूनिंग और पुनर्बलन अधिगम के ज़रिए उसका प्रशिक्षण किया। एक हाइब्रिड टोकनाइज़र पाठ के लिए Qwen3 का BPE बनाए रखता है और डीएनए को एक-दूसरे पर न चढ़ने वाले 6-mers में बाँटता है, जहाँ एक टोकन छह क्षारक-युग्मों को समेटता है। अलग डीएनए एनकोडर के बिना, पाठ और अनुक्रम एक ही एम्बेडिंग मैट्रिक्स साझा करते हैं, और किसी उत्तर में दोनों मिल सकते हैं।
पाँच बेंचमार्क पर (वैरिएंट का प्रभाव, अनुक्रमों की समझ, अगले क्षारक की भविष्यवाणी), Carbon-X बिना विचार-विमर्श के 66,7 % औसत हासिल करता है: Qwen3-14B से 27 अंक अधिक और मूल्यांकन किए गए अन्य सभी खुले मॉडलों से बेहतर। GPT-6.1 Sol, 67,5 % के साथ थोड़ा ही बेहतर करता है, लेकिन कोडिंग वैरिएंट के प्रभाव (BioReason Coding) और अगले क्षारक की भविष्यवाणी में Carbon-X परीक्षण किए गए सभी खुले और बंद मॉडलों से आगे है।
| मूल्यांकन किया गया मॉडल | लेख का डीएनए सूचकांक (पूर्णांकित) |
|---|---|
| GPT-6.1 Sol | 68 % |
| Carbon-X | 67 % |
| Kimi K3 | 50 % |
| DeepSeek V4.1 Flash | 47 % |
| Qwen3-14B | 40 % |
| GLM-5.3 | 40 % |
Introducing Carbon-X: The best open DNA model. We midtrained a 14B model on DNA and text, and it beats every open language model and matches GPT-6.1 Sol at 1,000x lower cost.
🇮🇳 पेश है Carbon-X, डीएनए के लिए सर्वश्रेष्ठ खुला मॉडल। हमने डीएनए और पाठ पर 14B मॉडल का प्रशिक्षण आगे बढ़ाया है: यह सभी खुले भाषा मॉडलों को पीछे छोड़ता है और 1 000 गुना कम लागत पर GPT-6.1 Sol की बराबरी करता है। — X पर @LoubnaBenAllal1
लागत के बारे में दो आँकड़े सामने आए हैं: मॉडल कार्ड प्रति समस्या इसकी लागत GPT-6.1 Sol की लागत का लगभग 1/1 800 बताता है, जबकि घोषणा इसे पूर्णांकित करके 1 000 गुना सस्ता कहती है। यह गणना तुलना किए गए मॉडलों की मानक API दरों पर आधारित है, जिसमें हर मॉडल के लिए विचार-विमर्श का वह स्तर लिया गया है जो उसका सर्वोत्तम औसत देता है। Carbon-X के लिए यह 5 डॉलर प्रति घंटे की दर वाले H200 पर एक घंटे में मापी गई प्रोसेसिंग दर पर आधारित है; मॉडल विस्तृत तर्क-विचार के बिना सीधे उत्तर देता है। Hugging Face के मुख्य कार्यकारी अधिकारी क्लेमेंट डेलांग, Carbon-X को अग्रणी प्रयोगशालाओं की जीवविज्ञान संबंधी सुरक्षा सीमाओं के जवाब के रूप में पेश करते हैं। उनके अनुसार, ये सीमाएँ वैज्ञानिकों, विश्वविद्यालयों, संगठनों और स्वास्थ्य एजेंसियों के काम में बाधा डालती हैं, लेकिन दुर्भावनापूर्ण गतिविधियाँ करने वालों को नहीं रोकतीं।
🔗 Carbon-X का मॉडल कार्ड · रिलीज़ का लेख · क्लेमेंट डेलांग का ट्वीट
METR और Redwood Research ने OpenAI के आंतरिक एजेंटों की निगरानी को परखा
22 अक्टूबर — METR ने इस गर्मी में Redwood Research के साथ OpenAI में किए गए एक अभ्यास का विवरण प्रकाशित किया है। 21 जुलाई से 11 अगस्त तक, दोनों संगठनों के एक-एक कर्मचारी ने वहाँ तीन सप्ताह बिताकर उस असिंक्रोनस प्रणाली पर हमले किए (रेड-टीमिंग) जो OpenAI के आंतरिक एजेंटों के उद्देश्यों से भटकने की निगरानी करती है। ये एजेंट उसके शोधकर्ताओं के लिए कोड लिखते हैं या प्रयोग करते हैं। उन्हें व्यापक पहुँच मिली थी: OpenAI द्वारा दिए गए उपकरण, जो कभी परिसर से बाहर नहीं गए, आंतरिक कोड, मॉनिटर के प्रॉम्प्ट और कॉन्फ़िगरेशन, तथा लगभग एक दर्जन शोधकर्ताओं और इंजीनियरों से बातचीत।
| METR द्वारा रिपोर्ट किया गया माप | अनुमानित मान |
|---|---|
| Responses API का पात्र आंतरिक एजेंट ट्रैफ़िक (कम-से-कम GPT-5.5 स्तर के मॉडल) | लगभग 75 से 94 % |
| आंतरिक Codex एजेंटों का पात्र ट्रैफ़िक | 99,2 % |
| मई से जुलाई 2026 तक निगरानी से बाहर रहा पात्र आंतरिक Codex ट्रैफ़िक | करीब 10 % (कॉम्पैक्शन) |
| मॉनिटर की त्रुटि वाली रिक्वेस्ट | 0,2 % से कम |
| आंतरिक रिपोर्ट, फिर संवेदनशील अंश हटाकर जारी किया गया संस्करण | 61 पृष्ठ, फिर 38 पृष्ठ |
METR के अनुसार, इन अनुमानों में काफ़ी अनिश्चितता है और ये 21 जुलाई को मौजूद प्रणाली से संबंधित हैं। मुख्य कमी कॉन्टेक्स्ट कॉम्पैक्शन की घटनाओं से आती थी, जिन्हें मॉनिटर देख नहीं पाते थे:
Because of this coverage gap, we estimated that on the order of 10% of internal Codex traffic was unmonitored from May to July. OpenAI had independently identified this issue shortly before the exercise began.
🇮🇳 निगरानी के दायरे में इस कमी के कारण, हमने अनुमान लगाया कि मई से जुलाई तक आंतरिक Codex ट्रैफ़िक का लगभग 10 % निगरानी में नहीं था। अभ्यास शुरू होने से कुछ ही समय पहले OpenAI ने अपने स्तर पर इस समस्या की पहचान कर ली थी। — X पर @METR_Evals
OpenAI ने अभ्यास के दौरान इसे ठीक कर दिया। चूँकि मॉनिटर तभी सक्रिय होता था जब एजेंट नियंत्रण उपयोगकर्ता को लौटाता था, इसलिए जब तक कॉम्पैक्शन निगरानी से बाहर था, एजेंट लगातार काम करते रहकर निगरानी को अनिश्चित काल तक टाल सकता था। अभ्यास की शुरुआत में पुनर्बलन प्रशिक्षण निगरानी के दायरे में नहीं था।
टीम ने दूसरी कमियाँ भी बताई हैं: Codex और Auto-Review के सैंडबॉक्स को पार करने का एक तरीका, जो एजेंट को होस्ट उपयोगकर्ता के सभी अधिकार दे देता था; हाल की सैकड़ों कार्रवाइयों को निगरानी से छिपाने की एक तकनीक (जिसका विवरण OpenAI ने हटा दिया); सीरियलाइज़ेशन के अंतर का उपयोग करके मॉनिटर को विफल कर सकने वाले इनपुट; क्लाइंट द्वारा नियंत्रित किए जा सकने वाले दो हेडर, जो नए एजेंटों की निगरानी बंद कर देते थे, हालाँकि उनके इस्तेमाल का पता लगाया जा सकता था; और निगरानी से बाहर दो आंतरिक टूल, जिन्हें केवल पढ़ने के लिए माना जाता था, लेकिन एक साधारण एक्सप्लॉइट से उनका दुरुपयोग किया जा सकता था, हालाँकि इसे व्यावहारिक रूप से सत्यापित नहीं किया गया। दूसरी ओर, कुछ अपवादों को छोड़कर मॉनिटर एजेंट की पूरी कार्ययात्रा देखता है, और उसके प्रॉम्प्ट साज़िशपूर्ण व्यवहार (षड्यंत्र रचना), तोड़फोड़, डेटा बाहर भेजने, धोखे और प्रॉम्प्ट इंजेक्शन की तलाश करते हैं।
OpenAI का कहना है कि उसने उत्पादन में इस्तेमाल हो रही अपनी सुरक्षा व्यवस्था को प्रभावित करने वाली सभी कमजोरियाँ ठीक कर दी हैं; METR स्पष्ट करता है कि उसने इस दावे का मूल्यांकन नहीं किया। पक्षों ने पहले ही सहमति कर ली थी कि केवल एक संक्षिप्त लेख प्रकाशित किया जाएगा और OpenAI रिपोर्ट के संवेदनशील अंश हटा सकेगा। METR इससे डिज़ाइन के पाँच सिद्धांत निकालता है, जिनमें निगरानी से बचना कठिन बनाना (उदाहरण के लिए हर N मिनट या हर N संदेश पर निगरानी), प्रणाली पर नियमित रूप से हमले करके उसे परखना और एजेंटों को उनके मॉनिटर से अलग रखना शामिल है। OpenAI के अनुसार, इन निष्कर्षों ने प्रणाली के विस्तार के दौरान उसकी सुरक्षा मज़बूत करने में मदद की और बाहरी मूल्यांकनकर्ताओं के साथ उसके भावी सहयोग को दिशा देंगे। 15 अक्टूबर को Anthropic ने METR की एक टीम को दी गई इसी तरह की पहुँच का विवरण दिया था।
🔗 OpenAI की आंतरिक एजेंट निगरानी प्रणालियों की रेड-टीमिंग (METR) · @OpenAI का ट्वीट
Agentic AI Foundation: Agent Skills, Open Responses, OpenEnv और OpenSandbox, MCP के साथ शामिल हुए
22 अक्टूबर — Agentic AI Foundation (AAIF), Linux Foundation की वह फ़ाउंडेशन जिसे पिछले साल Anthropic, Block और OpenAI ने मिलकर स्थापित किया था और जो पहले से MCP की मेज़बानी करती है, एक साथ चार नई परियोजनाओं का स्वागत कर रही है: Anthropic की ओर से Agent Skills, OpenAI की ओर से Open Responses, Hugging Face की ओर से OpenEnv और Alibaba की ओर से OpenSandbox। इस तरह अपने पहले ही वर्ष में इसकी परियोजनाओं की संख्या 10 हो गई है; इसके मुख्य प्रौद्योगिकी अधिकारी और सह-संस्थापक मानिक सुरतानी के अनुसार, हर परियोजना तकनीकी ढाँचे के एक हिस्से को समेटती है, एजेंट क्षमताएँ कैसे हासिल करते हैं से लेकर वे कहाँ चलते हैं तक।
Anthropic, Agent Skills का नाम और लोगो, GitHub संगठन और agentskills.io डोमेन दान कर रहा है। Claude Code पर काम के दौरान विकसित हुआ यह फ़ोल्डर प्रारूप एजेंट को कोई कार्य सिखाता है (एक SKILL.md फ़ाइल, स्क्रिप्ट और संदर्भ दस्तावेज़)। इसे दिसंबर 2025 में खुले मानक के रूप में प्रकाशित किया गया था; Anthropic के अनुसार, तब से ChatGPT, Cursor, GitHub Copilot और VS Code सहित 70 से अधिक एजेंट प्लेटफ़ॉर्म इसे अपना चुके हैं, और लगभग 280 मिलियन इंस्टॉलेशन वाले 1 मिलियन स्किल प्रकाशित हो चुके हैं। Anthropic, Google, OpenAI और अन्य कंपनियों के इंजीनियर व्यक्तिगत हैसियत से इसका रखरखाव करेंगे, जिनमें डेविड सोरिया पारा और महेश मुराग जिम्मेदार (मुख्य अनुरक्षक) होंगे। @ClaudeDevs की पोस्ट शृंखला में तकनीकी संचालन समिति के सदस्यों के रूप में Earendil, Microsoft और OpenCode का भी उल्लेख है। मौजूदा स्किल काम करते रहेंगे और लाइसेंस नहीं बदलेंगे; प्रस्तावित पहला कदम है: क्रमांकित संस्करण, प्रस्तावों की औपचारिक प्रक्रिया और सुरक्षा संबंधी सुझाव।
वहीं Hugging Face, एजेंटों को प्रशिक्षित करने के लिए परिवेशों का अपना खुला फ़्रेमवर्क OpenEnv तटस्थ संचालन के अधीन सौंप रहा है। इसकी समिति में विशेष रूप से Microsoft, Reflection, Meta-PyTorch, Fleet, Mercor, Nebius, Modal, Prime Intellect और Unsloth शामिल हैं। पुराने पते meta-pytorch/OpenEnv और huggingface/OpenEnv अब github.com/openenv/OpenEnv पर रीडायरेक्ट होते हैं।
🔗 Linux Foundation की प्रेस विज्ञप्ति · Anthropic का लेख · बेन बर्टनशॉ (Hugging Face) की घोषणा · @ClaudeDevs की पोस्ट शृंखला
एजेंटों की रूपरेखा और संचालन: समेटे गए उप-एजेंट, डिफ़ॉल्ट रूप से ऑटो मोड, एजेंट अपनाने की तुलना
तीन घोषणाएँ एजेंट क्या कर सकते हैं, इसकी अपेक्षा इस बात पर अधिक केंद्रित हैं कि उन्हें कैसे व्यवस्थित किया जाए, उन्हें नियंत्रण कैसे सौंपा जाए और उनके उपयोग को कैसे मापा जाए।
Anthropic ने उप-एजेंटों को मुख्य लूप में समाहित करने की सलाह दी और ओपन सोर्स माइग्रेशन किट जारी की
22 अक्टूबर — दियान सार्किस द्वारा लिखी गई Claude Platform की सर्वोत्तम कार्यप्रणालियों की मार्गदर्शिका में Anthropic की Applied AI टीम बताती है कि उद्यमों में कई तैनातियों के दौरान स्किल से लैस एक अकेले एजेंट ने अक्सर गुणवत्ता के मामले में एक सर्वसमावेशी प्रॉम्प्ट या उप-एजेंटों वाली संरचना से बेहतर प्रदर्शन किया, और अक्सर प्रति कार्य लागत और विलंबता भी कम रही; एक ग्राहक ने अपनी बहु-एजेंट संचालन व्यवस्था की तुलना में लगभग दोगुना तेज़ निष्पादन मापा। Anthropic का कहना है कि उसने अपने सबसे उन्नत मॉडलों के लिए Claude Code के सिस्टम प्रॉम्प्ट को 80 % से अधिक घटाया है, जिसमें स्किल और टूल को क्रमिक रूप से उपलब्ध कराने की भूमिका रही है। उसने यह भी देखा कि टूल की परिभाषाएँ 30 से 50 से अधिक होने पर सही टूल चुनने की क्षमता घटती है। जब संदर्भ भर जाता है, समानांतर कार्य पूरे होने के बाद उनका संदर्भ छोड़ा जा सकता है, या एजेंट को अपने टूल चुनने में कठिनाई होती है, तब उप-एजेंट उपयोगी बने रहते हैं। single-agent-loop-kit किट (Apache-2.0) एकल लूप पर जाने के लिए क्रमशः /claude-api build-eval, prompt-audit, hillclimb और cost-optimize चलाती है।
🔗 उप-एजेंटों पर Anthropic की मार्गदर्शिका · anthropics/single-agent-loop-kit (GitHub)
Pro, Max और Team पर Claude अनुप्रयोगों के सत्र डिफ़ॉल्ट रूप से ऑटो मोड में चलेंगे
22 अक्टूबर — @claudeai के अनुसार, अगले सप्ताह से Pro, Max और Team योजनाओं पर वेब, कंप्यूटर और मोबाइल के Claude अनुप्रयोगों के सत्र डिफ़ॉल्ट रूप से ऑटो मोड में चलेंगे: हर चरण के लिए स्वीकृति माँगने के बजाय एक स्वचालित जाँच जोखिम भरी कार्रवाइयों को रोकती है, और किसी भी समय मैनुअल मोड पर लौटा जा सकता है। इन योजनाओं पर Claude Code में ऑटो मोड 14 अगस्त से ही डिफ़ॉल्ट है, जबकि सभी योजनाओं पर टर्मिनल और VS Code सत्रों में यह 28 सितंबर के संस्करण 2.1.284 से डिफ़ॉल्ट है; ट्वीट में अगस्त की घोषणा का भी हवाला दिया गया है, जिसके अनुसार परीक्षणों में वर्गीकरण मॉडल ने 89 % खतरनाक कमांड पहचाने थे, जबकि मैनुअल स्वीकृति में यह आँकड़ा 14 % था। घोषणा केवल एक ट्वीट तक सीमित है, जिसमें न कोई निश्चित तारीख है, न संबंधित सत्रों का विवरण और न ही Enterprise का उल्लेख।
Copilot impact dashboard किसी उद्यम में एजेंटों के अपनाए जाने की तुलना समकक्ष उद्यमों से करता है
22 अक्टूबर — Copilot का प्रभाव डैशबोर्ड (Copilot impact dashboard) उद्योग के आधार पर तुलना (Industry comparison) जोड़ रहा है, जो वैकल्पिक है और डिफ़ॉल्ट रूप से बंद रहती है। उद्यम और किसी उद्यम के अधीन न आने वाले संगठन इसमें भाग लेने वाले समकक्षों के समेकित मानकों के मुकाबले अपने दो संकेतक देख सकते हैं: मुख्यतः एजेंटों के साथ (agent-first) या कई एजेंटों के साथ (multi-agent) काम करने वाले उपयोगकर्ताओं का अनुपात, और इन एजेंट उपयोगकर्ताओं के पुल अनुरोधों के मर्ज होने की दर की अन्य उपयोगकर्ताओं से तुलना। हर स्कोर को 28 दिनों में समकक्षों की माध्यिका के मुकाबले स्थान दिया जाता है, और समूह बढ़ने पर शीर्ष दशमक के मुकाबले भी; तुलना उद्यम के आकार और दस उद्योगों के आधार पर होती है। तुलनाएँ रोज़ अपडेट होती हैं, समेकित आँकड़े 30 दिनों बाद मिटा दिए जाते हैं, डेटा निवास की शर्तों वाले ग्राहकों की तुलना केवल उनके क्षेत्र से की जाती है, और इनमें से कुछ भी मेट्रिक्स API या निर्यात के माध्यम से उपलब्ध नहीं होता। शुरुआत में प्रतिभागियों की कमी के कारण केवल माध्यिका दिखाई दे सकती है, या कोई रैंकिंग भी नहीं दिख सकती।
🔗 Copilot impact dashboard में उद्योग के आधार पर तुलनाएँ
निर्णय मॉडल: OpenAI की Decisions API सामान्य रूप से उपलब्ध, GLiDE v1.2 Decision Index में शीर्ष पर
निर्णय मॉडल पाठ उत्पन्न किए बिना सीमित विकल्पों वाले प्रश्नों के उत्तर देते हैं, जैसे वर्गीकरण करना, मार्ग चुनना या अगली कार्रवाई तय करना। एक ही दिन OpenAI अपनी समर्पित API सभी के लिए खोल रहा है, और Fastino ऐसे वेट जारी कर रहा है जिन्हें वह Hugging Face के संदर्भ सूचकांक में पहले स्थान पर बताता है।
OpenAI ने Decisions API को सामान्य रूप से उपलब्ध कराया, प्रति अनुरोध 400 प्रश्नों की सुविधा
22 अक्टूबर — सार्वजनिक बीटा के सोलह दिन बाद Decisions API सामान्य रूप से उपलब्ध (generally available) हो गई है। GPT-6 Luna पर बनी यह API एक प्रायिकता (predicate), दिए गए मानों में से एक विकल्प (choice) या किसी पैमाने पर एक स्कोर (score) लौटाती है। OpenAI के अनुसार, यह Responses API के माध्यम से GPT-6 Luna का उपयोग करने की तुलना में 10 गुना तक तेज़ है। अब यह सीधे JSON इनपुट, हर प्रश्न के निर्देशों में छवियाँ और प्रति अनुरोध 400 प्रश्न स्वीकार करती है, जबकि बीटा में यह सीमा 200 थी। इसमें दोबारा उपयोग किए गए संदर्भ की कैशिंग, अमेरिका और यूरोपीय संघ में ही इन्फ़रेंस चलाने की सुविधा और GPT-Live के साथ मूल एकीकरण भी जुड़ता है। इनपुट की कीमत प्रति मिलियन टोकन 0,10 डॉलर बनी हुई है, कैश किए गए इनपुट की कीमत 0,01 डॉलर है और आउटपुट का शुल्क नहीं लिया जाता।
| उल्लिखित ग्राहक | OpenAI को बताया गया लाभ |
|---|---|
| Box | मार्ग का चयन लगभग 5 गुना तेज़, सटीकता Responses API के समान |
| Datadog | एजेंटों के कमांड का जोखिम स्कोर p95 पर 40 गुना तेज़ |
| Ramp | GPT-6 Luna से 4 गुना तेज़ और 30 % सस्ता |
| Sierra | p95 पर 280 ms से कम, पिछली विधि की तुलना में प्रति कॉल 90 % सस्ता |
| Speak | अगली कार्रवाई से पहले का विलंब 1,4 s से घटकर 0,13 s हुआ |
उसी शाम जारी हुआ openai-python 3.37.0 SDK, टाइपिंग में पिछली संगतता तोड़ने वाले बदलाव के साथ Decisions के प्रकारों का विस्तार करता है।
🔗 Decisions API से अधिक तेज़ी से प्रतिक्रिया देने वाले अनुप्रयोग बनाएँ
Fastino ने GLiDE v1.2 जारी किया, जिसे वह Decision Index v0.4.1 में पहले स्थान पर बताता है
22 अक्टूबर — Fastino अपने निर्णय मॉडल का नया संस्करण GLiDE v1.2 जारी कर रहा है, जिसके वेट Hugging Face पर उपलब्ध हैं और जिसे उसकी API से भी इस्तेमाल किया जा सकता है। Fastino के अनुसार, यह Hugging Face के Decision Index v0.4.1 में पहले स्थान पर है और सूचकांक में इसकी कैलिब्रेशन त्रुटि सबसे कम त्रुटियों में से एक है; 21 अक्टूबर को Base Labs ने mammoth-1 को 71,24 के साथ पहले स्थान पर बताया था, लेकिन वह संस्करण 0.4 पर था: दोनों स्कोर की तुलना नहीं की जा सकती। मॉडल पाठ, JSON और अब छवियाँ भी पढ़ता है, और एक ही पास में हर विकल्प की प्रायिकता लौटाता है: अधिकतम 255 विकल्पों में से एक चयन, हाँ या नहीं, या किसी पैमाने पर एक स्तर; विलंबता घटाने के लिए Fastino ने चिंतन टोकन हटा दिए हैं।
| GLiDE v1.2 की विशेषता | घोषित मान |
|---|---|
| मॉडल का आकार | 26 अरब पैरामीटर |
| न्यूनतम हार्डवेयर | कम से कम 80 Go वाला एक GPU |
| Fastino के अनुसार स्कोर | Decision Index v0.4.1 में 71,5, अगले मॉडल से 1,7 अंक आगे |
| Fastino API की कीमत | प्रति मिलियन इनपुट टोकन 0,04 डॉलर |
| वेट का लाइसेंस | fastino-community: निःशुल्क, वार्षिक राजस्व 10 मिलियन डॉलर से अधिक होने पर वाणिज्यिक समझौता आवश्यक |
🔗 Fastino का लेख · fastino/GLiDE (Hugging Face)
मॉडलों तक पहुँच: राउटर के लिए OpenAI की स्वीकृति, Perplexity में Batch API और Cohere में गोपनीय कंप्यूटिंग
तीन बदलाव स्वयं मॉडलों के बजाय उन तक पहुँचने के तरीके से संबंधित हैं: मध्यस्थ, बड़े पैमाने पर प्रसंस्करण और अनुरोधों की गोपनीयता।
OpenAI 20 नवंबर से मॉडल राउटर और AI गेटवे के लिए अपनी स्वीकृति अनिवार्य करेगा
21 अक्टूबर — अपने Safety अनुभाग के एक लेख में OpenAI का कहना है कि उसने ग्राहकों और साझेदारों के साथ उन सेवाओं की सुरक्षा नीतियों में एकरूपता स्थापित की है जो उसके मॉडलों तक सीधे, उन्हें होस्ट करने वाले साझेदार के माध्यम से या पुनर्विक्रेता के माध्यम से पहुँच देती हैं: उसके अपने सुरक्षा उपायों के अनुरूप सुरक्षा, संभावित उल्लंघनों की जाँच, समस्या पहचाने जाने पर कार्रवाई और अलग-अलग सेवाओं में प्रतिबंधों का समन्वित अनुपालन। सबसे ठोस बदलाव 20 नवंबर 2026 से लागू होने वाली अद्यतन उपयोग नीतियों (Usage Policies) में है: मॉडल राउटर (model routers) या AI गेटवे (AI gateways) जैसी सेवाओं को मॉडलों तक सीधी पहुँच देने से पहले OpenAI की समीक्षा से गुजरना होगा और उसकी स्वीकृति लेनी होगी। OpenAI SafetyIDs भी शुरू कर रहा है, जिन्हें ग्राहक जाँच के दौरान अंतिम उपयोगकर्ताओं की पहचान उजागर किए बिना उनमें अंतर करने के लिए दे सकते हैं। लेख में किसी प्रभावित सेवा का नाम नहीं दिया गया है और स्वीकृति प्रक्रिया का विवरण भी नहीं है।
🔗 सुसंगत मानकों से व्यापक पहुँच (OpenAI)
Perplexity ने अपनी Agent API के लिए Batch API खोली, प्रति फ़ाइल अधिकतम 50 000 अनुरोध
22 अक्टूबर — Perplexity अपनी Agent API में Batch API जोड़ रहा है, जो ऐसे कार्यों के लिए है जिन्हें तत्काल उत्तर नहीं चाहिए, जैसे मूल्यांकन, वर्गीकरण और डेटा संवर्धन: अनुरोधों की एक JSONL फ़ाइल अपलोड की जाती है, एक बैच बनाया जाता है, फिर परिणामों की फ़ाइल और त्रुटियों की फ़ाइल प्राप्त की जाती है। इसके एंडपॉइंट OpenAI की Batch API के स्वरूप का अनुसरण करते हैं। हर अनुरोध Agent API का पूरा लूप चलाता है: इसलिए वेब खोज (web_search) और पृष्ठ पढ़ना (fetch_url) भी बाद में किए जाने वाले प्रसंस्करण में काम करते हैं।
| Batch API की सीमा | प्रकाशित मान |
|---|---|
| प्रति फ़ाइल अनुरोध | 50 000, अधिकतम 200 Mo के लिए |
| समर्थित मॉडल | हर फ़ाइल में केवल एक, Agent API के मॉडलों में से |
| प्रसंस्करण का समय | बिना गारंटी 24 h का लक्ष्य, 48 h पर निश्चित अंतिम समयसीमा |
| फ़ाइलों का प्रतिधारण | 30 दिन |
| प्रसंस्करण की कीमत | बैच के लिए अलग कीमत नहीं; जिन OpenAI मॉडलों में उपलब्ध है, उनके लिए flex स्तर |
किसी बैच के अनुरोध Agent API की अनुरोध सीमा में नहीं गिने जाते, और अंतिम समयसीमा तक शुरू न हुए अनुरोध बिना शुल्क लिए समाप्त हो जाते हैं। शून्य डेटा प्रतिधारण वाले संगठनों के लिए यह सेवा उपलब्ध नहीं है।
🔗 @perplexitydevs की पोस्ट शृंखला · Batch API का दस्तावेज़ीकरण
Cohere ने Azure में NVIDIA H100 GPU पर Model Vault के Confidential Computing का सार्वजनिक बीटा खोला
22 अक्टूबर — 16 सितंबर को प्रारंभिक पहुँच में शुरू हुआ Cohere के समर्पित और प्रबंधित इन्फ़रेंस प्लेटफ़ॉर्म Model Vault का Confidential Computing अब सार्वजनिक बीटा में आ गया है: ग्राहक अभी से एन्क्रिप्टेड वॉल्ट बना सकते हैं और उन्हीं API के साथ उनमें अपने कार्यभार तैनात कर सकते हैं। बीटा Microsoft Azure में NVIDIA H100 GPU पर चलता है। Azure गोपनीय कंप्यूटिंग का बुनियादी ढाँचा प्रदान करता है, जबकि NVIDIA Confidential Computing GPU की मेमोरी की रक्षा करता है और CPU तथा GPU के बीच संचार को एन्क्रिप्ट करता है। अनुरोधों की सामग्री Oblivious HTTP (OHTTP) द्वारा सत्यापित परिवेश तक शुरू से अंत तक एन्क्रिप्ट की जाती है, और कुछ भी भेजने से पहले ग्राहक का सॉफ़्टवेयर हार्डवेयर, फ़र्मवेयर (firmware) और सॉफ़्टवेयर के हस्ताक्षरित प्रमाण की जाँच करता है; Cohere के अनुसार, उसके संचालक और क्लाउड प्रदाता भी संरक्षित मेमोरी नहीं पढ़ सकते। कुछ भौतिक या साइड-चैनल हमले, उपलब्धता, प्रॉम्प्ट इंजेक्शन जैसी अनुप्रयोग संबंधी कमज़ोरियाँ, मेटाडेटा और API तथा मॉडल के पहचानकर्ता इसके दायरे से बाहर हैं। Blackwell B200 GPU, सामान्य उपलब्धता और ओपन सोर्स स्टैक की घोषणा बिना तारीख के की गई है, और कोई कीमत नहीं बताई गई है।
🔗 Cohere Model Vault पर Confidential Computing · Cohere का तकनीकी लेख
पृथ्वी का अवलोकन और पूर्वानुमान: ForTy, OlmoEarth v1.3 और StormScope EU
आज के तीन प्रकाशन उपग्रह छवियों से पृथ्वी के मानचित्र या पूर्वानुमान तैयार करते हैं, जिनमें से दो ऐसे एम्बेडिंग पर आधारित हैं जो हर 10 मीटर के पिक्सेल का सार प्रस्तुत करते हैं।
Google DeepMind ने ForTy जारी किया, 10 मीटर का वैश्विक मानचित्र जो प्राकृतिक वनों, वृक्षारोपण क्षेत्रों और वृक्ष फ़सलों में अंतर करता है
22 अक्टूबर — Google DeepMind और Google Research ने World Resources Institute (WRI) तथा IIASA के साथ Forest Typology (ForTy) 2020 जारी किया है। यह मानचित्र पृथ्वी की स्थलीय सतह के हर 10 मीटर गुणा 10 मीटर के भूखंड को FAO की परिभाषाओं पर आधारित छह श्रेणियों में से एक में रखता है: प्राथमिक वन, प्राकृतिक रूप से पुनर्जीवित वन, रोपित वन, वानिकी वृक्षारोपण, वृक्ष फ़सलें और कृषि वानिकी, तथा अन्य भूमि। जहाँ अधिकांश मानचित्र केवल पेड़ों की मौजूदगी दिखाते हैं, वहीं ForTy प्राथमिक वन और तेल-ताड़ के बागान में अंतर करता है, जिससे यह वनों की कटाई से मुक्त उत्पादों के यूरोपीय विनियमन (EUDR) के लिए एक संदर्भ बनता है। मॉडल AlphaEarth Foundations के एम्बेडिंग और लगभग 1,7 मिलियन एनोटेट किए गए बिंदुओं पर आधारित है; यादृच्छिक रूप से चुने गए 9 000 से अधिक स्थलों पर सत्यापन में यह 90 % मामलों में वन के सही प्रकार की पहचान करता है, 95 % मामलों में वन और गैर-वन में अंतर करता है, और एक लेबल के बजाय हर श्रेणी की प्रायिकता देता है। 2017-2025 की एक प्रारंभिक वार्षिक शृंखला यह भी दिखाती है कि गायब हुए वन की जगह क्या आया। मानचित्र और शृंखला खुले लाइसेंस के अंतर्गत Google Earth Engine पर निःशुल्क उपलब्ध हैं।
🔗 Google DeepMind का लेख · Scientific Data का लेख
Ai2 ने OlmoEarth v1.3 और पूरी पृथ्वी के लिए पहले से गणना किए गए उपग्रह एम्बेडिंग जारी किए
22 अक्टूबर — Ai2 ने OlmoEarth v1.3 जारी किया है, जो एक वर्ष की रडार (Sentinel-1) और बहुवर्णक्रमीय (Sentinel-2, Landsat) छवियाँ पढ़ता है और हर 10 मीटर के पिक्सेल को एक वेक्टर में समेटता है। Ai2 ने इन एम्बेडिंग की गणना कर उन्हें Source Cooperative पर साझा किया है: 2023 से 2025 के लिए पूरी पृथ्वी, और 2017 से 2022 के लिए केवल कुछ देश। अब इन पर प्रशिक्षित एक छोटा वर्गीकरण मॉडल ही फ़सलों, भूमि उपयोग या बदलावों का मानचित्र बनाने के लिए पर्याप्त है, और हर कार्य के लिए मॉडल को अलग से फ़ाइन-ट्यून करने की ज़रूरत नहीं पड़ती। ब्राउज़र में बिना खाते के उपलब्ध एक एक्सप्लोरर अलग-अलग वर्षों की तुलना करता है, समान स्थान खोजता है और GeoTIFF में मानचित्र निर्यात करता है।
| OlmoEarth v1.3 का माप | प्रकाशित मान |
|---|---|
| हर 10 m पिक्सेल का एम्बेडिंग | 128 आयाम, या हल्के संस्करण में पहले 64 आयाम |
| AlphaEarth Foundations और Tessera v2 के मुकाबले जीते गए मूल्यांकन | 27 में से 20 (128 आयाम), 27 में से 18 (64 आयाम) |
| v1.2 की तुलना में प्रशिक्षण की गणना | 53 % |
| पहले से गणना किए गए एम्बेडिंग का संग्रह | प्रति वर्ष लगभग 150 To |
वेट, डेटा और कोड OlmoEarth Artifact License के अंतर्गत प्रकाशित किए गए हैं। साथ ही Ai2 ने PLANTEUR भी प्रस्तुत किया है, जो फ़्रांस के छह समुद्रपारीय क्षेत्रों में फ़सलों के मानचित्रण का एक बेंचमार्क है।
GTC Berlin के दूसरे दिन StormScope EU, Earth-2 में शामिल हुआ
22 अक्टूबर — NVIDIA ने मौसम और जलवायु पूर्वानुमान के अपने मॉडल परिवार Earth-2 में StormScope EU जोड़ा है: यह यूरोपीय डेटा पर प्रशिक्षित StormScope का क्षेत्रीय संस्करण है, जो EUMETSAT के अवलोकनों से Meteosat के 16 चैनलों पर बादलों में होने वाले बदलावों का 10 मिनट के अंतराल पर अति अल्पकालिक पूर्वानुमान लगाता है। Earth-2 के कई यूरोपीय उपयोगकर्ताओं का उल्लेख किया गया है: AXA ने FourCastNet 3 से चक्रवातों के 1 000 से अधिक मौसमों का सिमुलेशन किया, Vaisala Xweather बिजली गिरने के डेटा से StormScope को समृद्ध कर रहा है, TotalEnergies दो स्थलों पर सौर विकिरण का पूर्वानुमान लगाता है, और मैनचेस्टर विश्वविद्यालय Isambard-AI सुपरकंप्यूटर पर प्रशिक्षित वायु गुणवत्ता के CorrDiff मॉडल को DGX Spark पर चला रहा है।
🔗 यूरोप में Earth-2 (NVIDIA ब्लॉग)
GTC Berlin का दूसरा दिन: NVIDIA ने Cosmos का विस्तार किया, Minerva पेश किया और अपने यूरोपीय ग्राहकों के आँकड़े दिए
22 अक्टूबर — GTC Berlin के दूसरे दिन NVIDIA ने अपने यूरोपीय ग्राहकों पर केंद्रित ब्लॉग लेखों की एक शृंखला प्रकाशित की, जिनमें मुख्य रूप से आँकड़ों सहित उपयोग के उदाहरण दिए गए हैं। Shopify ने अपने सहायक Sidekick के GraphQL उप-एजेंट के लिए Nemotron 3.5 Lightning का पश्च-प्रशिक्षण किया है; यह उसके आंतरिक परीक्षण में एक अत्याधुनिक मॉडल से अधिक सटीक है, सेवा देने की लागत 90 % कम करता है और 7 गुना तेज़ उत्तर देता है; bunq अपने सहायक Finn को खुले मॉडलों पर चला रहा है, जो सर्वश्रेष्ठ बंद मॉडलों के स्तर का प्रदर्शन प्रति उत्तर उनकी लागत के 60 % में करते हैं; Stripe ने ऑफ़लाइन परीक्षण में अपने धोखाधड़ी निरोधक उपकरण Radar की डेटा पाइपलाइनों को 42 गुना तेज़ किया है। ऊर्जा के क्षेत्र में Hitachi Energy की बैटरियों को DSX Ready योग्य घोषित किया गया है, Schneider Electric ने Vera Rubin की संदर्भ आर्किटेक्चर मान्य की हैं और Siemens Energy ने एक संदर्भ डिज़ाइन प्रकाशित किया है। उत्पादों के मोर्चे पर NVIDIA ने Cosmos का विस्तार किया है और Minerva पेश किया है।
🔗 यूरोपीय वाणिज्य (NVIDIA ब्लॉग) · यूरोपीय वित्तीय सेवाएँ · एआई कारखानों की ऊर्जा
Cosmos: पाँच Data Factory ब्लूप्रिंट, अन्य मॉडलों के लिए खुला Framework और दोगुने तक तेज़ NIM
22 अक्टूबर — NVIDIA अपने विश्व मॉडल (world models) प्लेटफ़ॉर्म Cosmos को हर चरण में विस्तार दे रहा है। डेटा के लिए, पिछले दिन भी उल्लिखित Cosmos Data Factory अब पाँच क्लाउड नेटिव ब्लूप्रिंट के रूप में GitHub, Microsoft Azure, Nebius और CoreWeave के ज़रिए उपलब्ध है: स्वायत्त वाहनों के लिए डेटासेट, चित्रों की विशेषताओं का संवर्धन, दुर्लभ या खतरनाक घटनाओं के वीडियो, दोषों के चित्र (प्रिंटेड सर्किट बोर्ड, धातु, काँच) और वीडियो का संवर्धन (मौसम, रोशनी)। प्रशिक्षण के लिए Cosmos Framework परिशोधन (fine-tuning), पुनर्बलन अधिगम, डिस्टिलेशन और क्वांटाइज़ेशन की अपनी विधियों को एजेंट कौशलों के रूप में GR00T, Alpamayo, Qwen या Pi0.5 जैसे अन्य खुले मॉडलों तक बढ़ा रहा है। परिनियोजन के लिए Cosmos 3 Nano के नए संस्करण सिमुलेशन में स्वायत्त ड्राइविंग और दोनों हाथों से काम करने वाले रोबोटों की नीतियों का मूल्यांकन करते हैं, Cosmos 3 के NIM माइक्रोसर्विस मान्य कॉन्फ़िगरेशन में इन्फ़रेंस की गति को दोगुने तक बढ़ाते हैं, और Metropolis VSS 3.3 ब्लूप्रिंट उसी GPU पर 40 % अधिक वीडियो स्ट्रीम की निगरानी करता है। MicroAGI ने इसी तरह अपने 32B Cosmos 3 तर्क मॉडल को डिस्टिल करके 8B Nano बनाया है, जिसमें सटीकता की कोई हानि नहीं हुई; और पिछले दिन उल्लिखित Porsche ने अपने बार-बार किए जाने वाले भौतिक परीक्षणों में अधिकतम 90 % कमी बताई है।
🔗 Cosmos पर ब्लॉग लेख (NVIDIA ब्लॉग)
Minerva, एआई कारखानों को उत्पादक बनाए रखने वाला AIOps प्लेटफ़ॉर्म
22 अक्टूबर — NVIDIA ने एआई कारखानों के लिए एआई संचालित परिचालन (AIOps) प्लेटफ़ॉर्म Minerva पेश किया है, जहाँ एक ही घटक का प्रदर्शन गिरने से पूरा प्रशिक्षण धीमा पड़ सकता है। यह GPU, नेटवर्क, स्टोरेज, शेड्यूलर और कार्यभार की टेलीमेट्री को एक ज्ञान ग्राफ़ में जोड़ता है, जो हार्डवेयर (GPU, SuperNIC, स्विच, केबल) को चल रहे कार्यों से संबद्ध करता है। इससे धीमे हुए प्रशिक्षण से समस्या के लिए ज़िम्मेदार घटक तक पहुँचा जा सकता है, और NVIDIA के अनुसार यह लाखों GPU के पैमाने पर भी संभव है। पर्यवेक्षित और अपर्यवेक्षित मॉडल हर घंटे अरबों डेटा बिंदुओं का विश्लेषण करते हैं, पहले कभी न दिखी विसंगतियाँ पहचानते हैं, खराबियों का पूर्वानुमान लगाते हैं और चेतावनियों की बाढ़ को उसके संभावित कारण सहित एक ही घटना में समेटते हैं; प्राकृतिक भाषा में काम करने वाला सहायक सुधार सुझाता है, जिन्हें हाथ से या स्वचालित रूप से लागू किया जा सकता है। IREN पहले से इसका उपयोग कर रहा है; Aolani, Bitdeer AI, IBM, Jio, Lambda, Quake AI और Tesla इसे लागू करने की योजना बना रहे हैं, और Dell Technologies के अलावा Lenovo तथा Supermicro भी इसे उपलब्ध कराएँगे। NVIDIA ने न तो कीमत प्रकाशित की है, न लाभ का कोई आँकड़ा।
संस्कृतियों और आबादियों का प्रतिनिधित्व: CulturalRiddles और Nemotron-Personas-UK
एक ही दिन प्रकाशित दो डेटासेट यह मापते हैं या सुधारते हैं कि मॉडल वास्तविक संस्कृतियों और आबादियों का कितना सही प्रतिनिधित्व करते हैं।
Cohere Labs ने CulturalRiddles प्रकाशित किया: 62 संस्कृतियों की 6 200 पहेलियाँ, जो LLM की सांस्कृतिक समझ की कमियाँ उजागर करती हैं
22 अक्टूबर — Cohere Labs ने CulturalRiddles प्रकाशित किया है, जो पहेलियों के ज़रिए भाषा मॉडलों की सांस्कृतिक समझ मापने वाला परीक्षण है। छह महीनों में 194 स्वयंसेवकों ने अपनी भाषाओं में लगभग 6 200 मौलिक पहेलियाँ लिखीं, जो 62 सांस्कृतिक समुदायों, 45 देशों और 51 भाषाओं से संबंधित हैं; इनमें बुगिस या मोंगोंडो जैसी कुछ भाषाएँ भी हैं, जो मौजूदा परीक्षणों में शामिल नहीं हैं। 28 मालिकाना, खुले या क्षेत्रीय मॉडलों के लगभग 68 000 उत्तरों की समीक्षा मातृभाषियों ने की। सर्वश्रेष्ठ मॉडल 79 % पहेलियाँ हल करता है, लेकिन लुमासाबा (युगांडा) या मोंगोंडो (इंडोनेशिया) में कोई भी 22 % से आगे नहीं जाता। इस अंतर का केवल छोटा हिस्सा भाषा से समझाया जा सकता है: पाँच सबसे कठिन समुदायों की पहेलियों का अंग्रेज़ी में अनुवाद करने पर पाँच मॉडलों की सफलता दर केवल 22 % से 32 % तक बढ़ती है। «मुझे नहीं पता» कहने की अनुमति होने के बावजूद मॉडलों ने केवल 0,7 % मामलों में ऐसा किया, जबकि समीक्षा किए गए लगभग 31 % उत्तर गढ़े हुए थे; 28 में से 18 मॉडल एक जर्मन पहेली का उत्तर वॉटर पोलो देते हैं, जबकि सही उत्तर पानी के भीतर खेला जाने वाला रग्बी है। पहेलियाँ, कोड और डैशबोर्ड सार्वजनिक हैं, और Cohere के किसी मॉडल को विशेष रूप से आगे नहीं रखा गया है।
🔗 CulturalRiddles (Cohere Labs) · Hugging Face पर डेटासेट
Nemotron-Personas-UK: ब्रिटिश जनगणनाओं के अनुरूप दस लाख कृत्रिम व्यक्तित्व
22 अक्टूबर — संप्रभु एआई पर काम करने वाली लंदन की प्रयोगशाला Locai Labs ने NVIDIA के साथ Nemotron-Personas-UK प्रकाशित किया है, जिसमें CC BY 4.0 लाइसेंस के तहत दस लाख कृत्रिम व्यक्तित्व हैं। हर व्यक्तित्व इंग्लैंड और वेल्स, स्कॉटलैंड तथा उत्तरी आयरलैंड की जनगणनाओं के जनसांख्यिकीय, भौगोलिक, सामाजिक-आर्थिक और पेशागत वितरणों के अनुरूप है, और इसमें कोई वास्तविक व्यक्ति शामिल नहीं है। NeMo Data Designer से एक संभाव्य मॉडल पहले यथार्थवादी संयोजन चुनता है, फिर Gemma 4 31B, 18 NVIDIA GPU पर हर व्यक्तित्व की विशेषताएँ लिखता है (सांस्कृतिक पृष्ठभूमि, कौशल, करियर के लक्ष्य, शौक)। इन डेटासेट का उपयोग ऐसे मॉडलों को प्रशिक्षित करने और परखने के लिए किया जाता है, जिन्हें निजी डेटा उजागर किए बिना किसी विशेष आबादी का प्रतिनिधित्व करना हो। GTC Berlin के दूसरे दिन NVIDIA ने साथ ही Nemotron-Personas-Germany पेश किया, जिसमें 2022 की जनगणना पर आधारित दस लाख रिकॉर्ड हैं (16 राज्य, 400 ज़िले)। इन्हें खुला स्रोत लाइब्रेरी NeMo User Sim के साथ इस्तेमाल करके जाँचा जा सकता है कि सार्वजनिक सेवा का कोई मॉडल अलग-अलग क्षेत्रों या आयु वर्गों में एक जैसा व्यवहार करता है या नहीं; पोलैंड में SpeakLeash और ल्युब्ल्याना विश्वविद्यालय के साथ भी संस्करणों की योजना है। Nemotron-Personas संग्रह अब फ़्रांस सहित 12 देशों को कवर करता है।
🔗 Locai Labs का ब्लॉग लेख · यूरोपीय सार्वजनिक क्षेत्र (NVIDIA ब्लॉग)
जनरेटिव चित्र और वीडियो: Ideogram Vector 1.0, HeyGen Video 1 और FLUX Video Upscale
Ideogram ने अपना पहला वेक्टर मॉडल Ideogram Vector 1.0 पेश किया, जो संपादन योग्य SVG बनाता है
22 अक्टूबर — Ideogram, Ideogram Vector 1.0 के साथ पिक्सेल आधारित चित्रों से आगे बढ़ रहा है। एक प्रॉम्प्ट से, और चाहें तो संदर्भ चित्रों की मदद से, यह मॉडल सीधे SVG फ़ाइल बनाता है; यह बिना प्रॉम्प्ट के किसी मौजूदा चित्र को वेक्टर में भी बदल सकता है। हर रचना एक ही SVG होती है, जिसकी आकृतियाँ, रंग और ग्रेडिएंट Illustrator, Figma या कोड में संपादित किए जा सकते हैं। Ideogram का लक्ष्य लोगो, अक्षरांकन, लेबल, मुद्रण और चित्रांकन (उत्कीर्णन, पॉप आर्ट, सपाट रंग, रेखाचित्र) है, और वह अपनी पुरानी ताकत, पठनीय पाठ, पर भरोसा कर रहा है। यह मॉडल Ideogram में, API के ज़रिए और कुछ अनाम साझेदारों के यहाँ उपलब्ध है; कोई बेंचमार्क प्रकाशित नहीं किया गया है।
| निर्माण मोड | प्रति SVG मूल्य |
|---|---|
| पाठ से वेक्टर, Low गुणवत्ता | 0,13 डॉलर |
| पाठ से वेक्टर, Medium गुणवत्ता | 0,16 डॉलर |
| पाठ से वेक्टर, High गुणवत्ता | 0,20 डॉलर, संदर्भों के साथ 0,32 डॉलर |
| चित्र से वेक्टर | प्रति चित्र 0,10 डॉलर |
🔗 Ideogram की घोषणा · मॉडल का पृष्ठ
Artificial Analysis पर बिना ऑडियो वाले पाठ से वीडियो में HeyGen Video 1 पहले स्थान पर, ऑडियो के साथ तीसरे स्थान पर
22 अक्टूबर — HeyGen का कहना है कि उसका पहला सामान्य प्रयोजन वीडियो मॉडल HeyGen Video 1, Artificial Analysis के एक गुप्त पहचान वाले परीक्षण में पाठ से वीडियो बनाने में पहले स्थान पर आया है। AA-Video-T2V v2.1 रैंकिंग इस दावे को अधिक स्पष्ट करती है: सूचीबद्ध संस्करण HeyGen Video (ultraquality) बिना ऑडियो वाले दृश्य में वास्तव में पहले स्थान पर है, हालाँकि उसका विश्वास अंतराल Wan 3.0 के विश्वास अंतराल से ओवरलैप करता है; लेकिन डिफ़ॉल्ट रूप से दिखने वाले ऑडियो सहित दृश्य में वह केवल तीसरे स्थान पर है।
| रैंकिंग का दृश्य | HeyGen Video (ultraquality) का स्थान | रैंकिंग में पास के मॉडल |
|---|---|---|
| बिना ऑडियो | स्थान 1, 1 144 Elo (रैंक 1 से 2) | Wan 3.0 का 1 134, MiniMax H3 768p का 1 120 |
| ऑडियो सहित, डिफ़ॉल्ट दृश्य | स्थान 3, 1 160 Elo (रैंक 2 से 7) | Wan 3.0 का 1 175, Utopai X का 1 167 |
MiniMax H3 पर पश्च-प्रशिक्षित यह मॉडल बिना ऑडियो के अपने आधार मॉडल से स्पष्ट रूप से आगे है (1 144 बनाम 1 120), लेकिन ऑडियो के साथ केवल दो अंक आगे है (1 160 बनाम 1 158)। Artificial Analysis इस संस्करण के लिए API को «जल्द आने वाला» बताता है, जबकि HeyGen के अनुसार HeyGen Video 1, HeyGen में और API के ज़रिए उपलब्ध है, जिसकी प्रचार अवधि की कीमत 0,01 डॉलर प्रति सेकंड है।
🔗 Artificial Analysis की पाठ से वीडियो रैंकिंग · @HeyGen का ट्वीट
Black Forest Labs ने FLUX Video Upscale को पूरी तरह नया बनाया; उसका दावा है कि यह Topaz Astra 2 से सस्ता और दोगुना तेज़ है
22 अक्टूबर — Black Forest Labs ने 20 अगस्त को पेश किए गए अपने वीडियो सुपर-रिज़ॉल्यूशन उपकरण FLUX Video Upscale को पूरी तरह नया बनाने की घोषणा की है। वह इसे बाज़ार में सर्वश्रेष्ठ, Topaz Astra 2 से सस्ता और दोगुना तेज़ बताता है, लेकिन कोई संख्यात्मक तुलना प्रकाशित नहीं की है। उत्पाद पृष्ठ के अनुसार FLUX 3 से संचालित यह उपकरण पिक्सेल का इंटरपोलेशन करने के बजाय हर फ़्रेम को नए रिज़ॉल्यूशन पर दोबारा बनाता है। एक पैरामीटर इसके व्यवहार को नियंत्रित करता है: सटीक मोड चेहरों और उत्पादों के लिए स्रोत को बदले बिना उसे अधिक स्पष्ट करता है, जबकि डिफ़ॉल्ट रचनात्मक मोड नए ब्योरे गढ़ता है, जिससे चेहरे का रूप बदलने का जोखिम रहता है।
| FLUX Video Upscale का पैरामीटर | प्रकाशित मान |
|---|---|
| आवर्धन गुणक | 480p से 1,5 से 3 गुना, अधिकतम 4K तक |
| प्रति क्लिप अवधि | अधिकतम 20 सेकंड, मूल ध्वनि बनी रहती है |
| सटीक मोड का मूल्य | तैयार आउटपुट के प्रति मेगापिक्सेल-सेकंड 0,035 डॉलर |
| रचनात्मक मोड का मूल्य (डिफ़ॉल्ट) | तैयार आउटपुट के प्रति मेगापिक्सेल-सेकंड 0,05 डॉलर |
🔗 Black Forest Labs की घोषणा · अपस्केलर का पृष्ठ
कोड एजेंट: Claude Code 2.1.307, VS Code 1.143, Replit Monitoring Agent, Amp के orbs और Cognition का प्लगइन
Claude Code, API के नए संस्करण के साथ तालमेल बिठाता है, VS Code डेवलपर की मशीन पर कोड मॉडल चलाता है, Replit और Amp एजेंटों को बुनियादी ढाँचे की अधिक ज़िम्मेदारी सौंपते हैं, और Cognition किसी भी एजेंट को तीन गंभीर सुरक्षा खामियों से निपटने के उपकरण देता है। Copilot CLI 1.0.103, Vibe CLI 3.0.2, Qwen Code v0.26.0, Zed 1.25 और दिन के अन्य संस्करण संक्षिप्त समाचारों में हैं।
Claude Code 2.1.307 में /claude-api api-version और OpenTelemetry का safety_event इवेंट जोड़ा गया
21 अक्टूबर — Claude Code 2.1.307 (43 प्रविष्टियाँ, जिनमें 26 सुधार हैं) API के नए संस्करण के साथ आया है: /claude-api api-version किसी Claude API अनुप्रयोग के कोड को संस्करण 2026-10-21 पर ले जाता है। प्रेक्षणीयता के लिए OpenTelemetry का claude_code.safety_event इवेंट हर उस टूल कॉल पर जारी होता है, जिसे अनुमति के किसी नियम, auto मोड, सुरक्षा जाँच, हुक या सैंडबॉक्स ने रोका हो, पुष्टि के लिए भेजा हो या Claude को वापस भेजा हो; यह 15 अक्टूबर को tool_decision इवेंट में जोड़े गए वर्गीकारक फ़ील्डों का पूरक है। Code Review में @claude review stop (या off, pause) जोड़ा गया है, जो किसी पुल रिक्वेस्ट पर @claude review always सदस्यता समाप्त करता है। सुधारों में, कॉल के दौरान कनेक्शन बंद होने पर MCP HTTP टूल कॉल अब दो बार नहीं भेजे जाते; केवल पढ़ने वाले या बार-बार चलाने पर समान परिणाम देने वाले टूल ही दोबारा आज़माए जाते हैं। किसी अपठनीय टूल कॉल को टर्न रोकने से पहले अधिकतम दो बार फिर आज़माया जाता है, और स्वयं होस्ट किया गया रनर डिफ़ॉल्ट रूप से अपने चेकआउट हुक 30 मिनट बाद रोक देता है। 22 अक्टूबर का संस्करण 2.1.308 केवल बग सुधारों और विश्वसनीयता संबंधी सुधारों तक सीमित है।
🔗 GitHub पर Claude Code 2.1.307
VS Code 1.143, Copilot के साथ MAI Code 1.1 Flash को स्थानीय रूप से चलाता है और Copilot हार्नेस को डिफ़ॉल्ट विकल्प बनाता है
22 अक्टूबर — VS Code 1.143 में 7 अक्टूबर को घोषित स्थानीय रूटिंग प्रयोगात्मक रूप से उपलब्ध है: मॉडल चयनकर्ता का नया On This Device टैब MAI Code 1.1 Flash डाउनलोड करता है, जिससे Copilot हार्नेस के सत्रों में सवाल किए जा सकते हैं। डिवाइस पर गणना किए गए और On-device चिह्नित उत्तर एआई क्रेडिट खर्च नहीं करते, और Use in Auto विकल्प Auto मोड को उपयुक्त अनुरोध वहाँ भेजने देता है, ज़रूरत पड़ने पर क्लाउड का सहारा लिया जाता है। हार्डवेयर की माँग अब भी ऊँची है: llama.cpp का संगत संस्करण, GitHub कनेक्शन और कम से कम 96 Go मेमोरी वाला NVIDIA GPU। Copilot SDK पर बना Copilot हार्नेस नए सत्रों का डिफ़ॉल्ट विकल्प बन गया है, और Agents विंडो में पूर्वावलोकन के रूप में Compare Models जोड़ा गया है, जो एक ही निर्देश कई मॉडलों और हार्नेस (Copilot, Claude, Codex) को समानांतर रूप से देता है, साथ में वैकल्पिक निर्णायक मॉडल भी हो सकता है। इंस्टॉलर Copilot CLI भी उपलब्ध कराता है, Voice Mode निजी OpenAI कुंजी स्वीकार करता है, और कंपनियाँ अपने डिफ़ॉल्ट मॉडल अनिवार्य कर सकती हैं तथा आवश्यक प्लगइन अपने-आप इंस्टॉल करवा सकती हैं।
🔗 Visual Studio Code 1.143 के रिलीज़ नोट्स
Replit ने Monitoring Agent लॉन्च किया, जो प्रोडक्शन अलर्ट की जाँच करता है, सुधार करता है और अपने आप फिर से पब्लिश कर सकता है
22 अक्टूबर — Replit ने Monitoring Agent जारी किया है, जिसे उसके प्लेटफ़ॉर्म पर पब्लिश किए गए ऐप्लिकेशन के लिए एक स्वायत्त ऑन-कॉल इंजीनियर के रूप में पेश किया गया है: प्रोडक्शन में कोई घटना होने पर यह अलर्ट की जाँच करता है, लॉग, मेट्रिक और कोड में कारण खोजता है, सुधार तैयार करके उसकी पुष्टि करता है, उसे डिप्लॉय कर सकता है और फिर बताता है कि क्या बदला है। हर ऐप्लिकेशन के लिए तीन अलग सेटिंग तय की जाती हैं: त्रुटि लॉग, HTTP त्रुटियों और विलंबता के अलर्ट; स्वचालित सुधार (Auto-fix), जो पृष्ठभूमि में जाँच करके ईमेल से सारांश भेजता है; और स्वचालित पुनर्प्रकाशन (Auto-republish), जो अभी प्रायोगिक है और केवल उन ऐप्लिकेशन के लिए उपलब्ध है जिनमें Auto-fix सक्रिय है। Replit चेतावनी देता है कि अलर्ट आने से सुधार की गारंटी नहीं मिलती और माइग्रेशन तथा इंडेक्स से जुड़ी कार्रवाइयाँ अब भी जोखिम भरी हैं; स्वचालित पुनर्प्रकाशन के बिना सुधार एजेंट की चैट में समीक्षा का इंतज़ार करता है। इसके लिए कोई अलग शुल्क नहीं है: इसे चलाने पर Agent के उपयोग का शुल्क लग सकता है। Replit इसे « अपनी तरह का पहला » एजेंट बताता है, लेकिन Cognition ने 15 अक्टूबर को Devin Oncall लॉन्च किया था, जो प्रोडक्शन की घटनाओं की जाँच भी करता है।
🔗 Replit का लेख · Monitoring Agent का दस्तावेज़ीकरण
Amp अब अपने बुनियादी ढाँचे पर orbs होस्ट करने देता है, 29 अक्टूबर तक सभी के लिए मुफ़्त
22 अक्टूबर — Amp अब अपने orbs को स्वयं होस्ट करने देता है। ये वे दूरस्थ मशीनें हैं जिन पर उसके एजेंट चलते हैं: ग्राहक कंप्यूटिंग संसाधन देता है और Amp उन्हें orbs में बदलता है, बशर्ते बुनियादी ढाँचा नई मशीनों को तेज़ी से शुरू कर सके, उन्हें स्लीप मोड में डालकर दोबारा चालू कर सके, लंबे समय तक बनाए रख सके और संसाधनों को घटाकर शून्य तक ला सके। amp orb provider ग्राहक के यहाँ चलता है, Amp से जुड़ता है और मशीन बनाने, रोकने तथा हटाने के अनुरोध ग्राहक के लिखे प्रोग्राम को भेजता है; Amp, Docker, E2B, Kubernetes, Apple Containers, Modal, Vercel, Daytona और exe.dev के लिए उदाहरण देता है। फिर भी Amp अपने अधिकांश उपयोगकर्ताओं को यह विकल्प अपनाने की सलाह नहीं देता: यह उन कंपनियों के लिए है जिन्हें नियम, आंतरिक नेटवर्क या विशेष हार्डवेयर होस्ट किए गए orbs इस्तेमाल करने से रोकते हैं। स्वयं होस्ट किए गए orbs व्यक्तिगत उपयोगकर्ताओं और टीमों के लिए मुफ़्त रहेंगे; Enterprise ग्राहकों को 29 अक्टूबर से orbs की मानक दर चुकानी होगी और तब तक यह विकल्प सभी के लिए मुफ़्त है। अब तक केवल Amp के रनर ही ग्राहक के यहाँ एजेंट चलाते थे, लेकिन वे स्थायी मशीनों पर काम करते थे।
Cognition ने PHP, Node.js और GitLab की गंभीर सुरक्षा खामियाँ ठीक करने के लिए एजेंट प्लगइन ओपन सोर्स किया
22 अक्टूबर — PHP2Shell के अगले दिन Cognition ने Vulnerability Fixes जारी किया, जो MIT लाइसेंस वाला एक मुफ़्त और ओपन सोर्स प्लगइन है और तीन गंभीर सुरक्षा खामियों को ठीक करने का काम एक कोड एजेंट को सौंपता है। इसे Devin के मार्केटप्लेस से इंस्टॉल किया जा सकता है, लेकिन यह Agent Skills प्रारूप के स्किल्स से बना है: npx skills add इसे Claude Code, Codex, Cursor, Factory Droid, GitHub Copilot, Gemini CLI या OpenCode में भी जोड़ता है। एजेंट पहले बिना कोई बदलाव किए उन सभी चीज़ों की सूची बनाता है जिनमें PHP या Node.js शामिल है (Docker इमेज, वितरण पैकेज, CI, Helm, Terraform, AWS Lambda रनटाइम…); फिर सुधारी जाने वाली रिपॉज़िटरी चुने जाने का इंतज़ार करता है, आधिकारिक स्रोतों से सत्यापित सुधारयुक्त संस्करण पर अपडेट करता है, बदलाव से पहले और बाद में परीक्षण चलाता है और हर रिपॉज़िटरी के लिए जोखिम लेबल तथा बदलाव वापस लेने की योजना के साथ एक पुल रिक्वेस्ट खोलता है।
| लक्षित घटक | ठीक की जाने वाली सुरक्षा खामी | सुधारयुक्त संस्करण |
|---|---|---|
| PHP (PHP2Shell, 21 अक्टूबर को चर्चा की गई) | CVE-2026-109618 और CVE-2026-109619, CVSS v4 9,2 | 8.2.35, 8.3.36, 8.4.27, 8.5.12 |
| Node.js (21 अक्टूबर का अपडेट) | 10 CVE, जिनमें CVE-2026-111497 (Brotli डिकोडर) शामिल है | 22.23.4, 24.22.1, 26.12.1 |
| स्वयं होस्ट किया गया GitLab | CVE-2026-110264, CVSS 10.0 | 19.5.1, 19.4.3, 19.3.6, 19.2.9, 19.1.9, 19.0.10, 18.11.13 |
Cognition के अनुसार, PHP और Node.js की खामियों का सक्रिय रूप से स्वचालित ढंग से फ़ायदा उठाया जा रहा है और लेख पहले अपने PHP वेब ऐप्लिकेशन ऑफ़लाइन करने की सलाह देता है। Devin Enterprise ग्राहकों को क्रेडिट और सहायता देने का वादा किया गया है, लेकिन कोई राशि नहीं बताई गई है।
🔗 Cognition का लेख · CognitionAI/devin-vuln-fixes रिपॉज़िटरी · @cognition की घोषणा
संक्षिप्त समाचार
एजेंट और कोडिंग टूल
- Copilot CLI 1.0.103 — 1.0.102 के अगले दिन आए GitHub के इस स्थिर संस्करण में मुख्य रूप से सुधार हैं: ACP सत्र अब सैंडबॉक्स की सेटिंग का पालन करते हैं, Gemini के टूल कॉल अब स्कीमा सत्यापन में विफल नहीं होते और पुराने स्टार्टअप विकल्प
--remoteतथा--no-remoteहटा दिए गए हैं। 🔗 स्रोत - Vibe CLI 3.0.2 — Mistral ने सक्रिय उप-एजेंटों और समानांतर चलने वाले उप-एजेंटों की डिफ़ॉल्ट सीमा बढ़ाकर 32 कर दी है, जो अब तक क्रमशः 8 और 4 थी। इन्हें
max_subagentsतथाmax_concurrent_subagentsसे बदला जा सकता है और कस्टम उप-एजेंटों की अनुमतियाँ, टूल सूचियाँ तथा स्किल्स भी अब लागू होते हैं। 🔗 स्रोत - Qwen Code v0.26.0 — यह स्थिर संस्करण पिछले दिन चर्चा में आए v0.25.4 पूर्वावलोकन संस्करणों के बाद आया है; v0.25.4 का कोई स्थिर संस्करण नहीं आया। इसकी 237 प्रविष्टियों में से 64 नई हैं, जिनमें 21 सुविधाएँ शामिल हैं, जैसे Managed Agent की एक बारी के दौरान मंज़ूरियाँ बदलना और डेमन को फिर से शुरू करने का विकल्प
qwen serve। 🔗 स्रोत - Zed 1.25 का स्थिर संस्करण — v1.25.2 ने 14 अक्टूबर को चर्चा में आए पूर्वावलोकन को स्थिर संस्करण बना दिया है। इसमें ACP एजेंटों के लिए कॉन्टेक्स्ट संक्षेपण, Amazon Bedrock प्रदाता में GPT-6 Astra, Claude Fable 5.1 और Claude Opus 5.5 तथा 1.23 की तुलना में लगभग 30 % हल्की बाइनरी शामिल है। 🔗 स्रोत
- Gemini CLI, 22 अक्टूबर का नाइटली संस्करण — CLI के docker, podman या runsc सैंडबॉक्स में चलने पर भी IDE इंटीग्रेशन अब काम करता है और कंपैनियन का टोकन सैंडबॉक्स में नहीं जाता। साथ ही, शेल कमांड की एक मंज़ूरी उन्हीं विकल्पों के लिए सत्र के अंत तक मान्य रहती है। 🔗 स्रोत
- Antigravity 2.25.0 और VS Code एक्सटेंशन 1.9.0 — 19 और 18 अक्टूबर के छूटे हुए अपडेट: ऐप्लिकेशन प्लगइन से प्रबंधित प्रोजेक्ट को बैज से दिखाता है और स्किल्स के YAML फ़्रंट मैटर को ठीक करता है; एक्सटेंशन में डिफ़ के एक ब्लॉक को स्वीकार या अस्वीकार करने के शॉर्टकट और भाषा सर्वर को वैकल्पिक रूप से अपने आप फिर से शुरू करने की सुविधा जुड़ी है। 🔗 स्रोत
- Devin के 21 अक्टूबर के रिलीज़ नोट्स — Devin Review अब Bitbucket Cloud के लिए उपलब्ध है, Devin Oncall में Lite मोड जुड़ा है और Enterprise प्रशासक अब तक कनेक्ट न की गई रिपॉज़िटरी के पास पहुँच का अनुरोध करने वाला लिंक दिखा सकते हैं। 🔗 स्रोत
- GenCode से बना एक स्कूली टूल — Genspark ने जेसन हिल का अनुभव साझा किया है, जिन्होंने तीन दिनों में लगभग 600 क्रेडिट खर्च करके अपने स्कूल ज़िले की समय-सारिणियों में खाली सीटों और क्षमता से अधिक नामांकन के लिए एक टूल बनाया; उत्पाद में कोई नई सुविधा नहीं आई है। 🔗 स्रोत
कंपनियाँ और परिनियोजन
- Uber और ChatGPT Work — 1 000 कर्मचारियों के साथ पायलट के बाद Uber अब ChatGPT Enterprise के एजेंट को 30 000 से अधिक कर्मचारियों तक पहुँचा रहा है। इसमें GPT-6.1 Sol डिफ़ॉल्ट है और Google Drive, Gmail, Google Calendar तथा Slack से कनेक्शन हैं; कोई संख्यात्मक परिणाम नहीं बताया गया है। 🔗 स्रोत
- OpenAI के फ़ॉरवर्ड डिप्लॉयड इंजीनियर — कॉलिन जार्विस ग्राहकों के आँकड़ों के साथ उनकी कार्यपद्धति बताते हैं: सेमीकंडक्टर क्षेत्र के एक ग्राहक के यहाँ Codex आधारित ढाँचा अपनाने से लगभग 90 % विशेष रूप से लिखा गया कोड हट गया और दूरसंचार के एक वॉइस मॉडल का प्रदर्शन प्रमुख मूल्यांकनों में छह महीनों में लगभग 60 % से बढ़कर 90 % से अधिक हो गया। 🔗 स्रोत
- Replit for Government — अमेरिका और अन्य देशों में हर स्तर के सरकारी निकायों के लिए एक पेशकश, जिसका 25 अमेरिकी राज्यों और 20 से अधिक देशों में इस्तेमाल होने का दावा है; किसी ग्राहक का नाम, FedRAMP या शुल्क नहीं बताया गया है। 🔗 स्रोत
- लंदन में Cognition — फ़िन्सबरी स्क्वायर में नया कार्यालय, छह महीनों में ब्रिटिश टीम में 200 % से अधिक वृद्धि और तीन नए सदस्य, जिनमें Mercedes-Benz की पूर्व वैश्विक मुख्य सूचना अधिकारी कैट्रिन लेहमन भी शामिल हैं। 🔗 स्रोत
- SpaceXSI का Partner Network — Grok के साथ निर्माण करने वाले इंटीग्रेटर और सॉफ़्टवेयर प्रकाशकों का यह कार्यक्रम शुरुआती पहुँच से बाहर आ गया है। इसे 130 से अधिक कंपनियाँ फ़ॉलो कर रही हैं और इसके 45 लॉन्च साझेदारों में Bain & Company, Databricks, NVIDIA तथा Snowflake शामिल हैं; न कीमत बताई गई है, न समय-सारिणी। 🔗 स्रोत
- Synthesia और Hays — भर्ती फ़र्म में Roleplay Sessions के पायलट में बिक्री कौशल में औसतन 29 % सुधार मापा गया और स्वैच्छिक भागीदारी 70 % से अधिक रही। 🔗 स्रोत
- Trinity Logistics और ElevenAgents — 20 अक्टूबर को प्रकाशित एक मामले में वॉइस एजेंट हर महीने 30 000 कॉल के दौरान लगभग 1 000 माल ढुलाई की दरें तय करके बुकिंग करते हैं, जिससे मार्जिन 25 % अधिक है और प्लेटफ़ॉर्म की लागत 40 % कम हुई है। 🔗 स्रोत
- Eleven Realtime Translation पर आगे की जानकारी — पिछले दिन चर्चा में आए लाइव वॉइस अनुवाद के लेख में पहले ग्राहक के रूप में Deutsche Telekom के Magenta AI Call Assistant का उल्लेख है और स्पष्ट किया गया है कि Eleven v4 Turbo इसका डिफ़ॉल्ट आधार है; एंटरप्राइज़ अल्फ़ा का शुल्क अब भी नहीं बताया गया है। 🔗 स्रोत
सुरक्षा
- OpenAI और सामुदायिक बैंक — ICBA के साथ गठबंधन पात्र सदस्य बैंकों को प्रशिक्षण के साथ Daybreak for Frontline Defenders तक सब्सिडी वाली पहुँच देता है; न राशि बताई गई है, न बैंकों की संख्या। 🔗 स्रोत
- Cloudflare, Daybreak और Codex — 21 अक्टूबर के एक केस अध्ययन में Cloudflare, OpenAI के मॉडलों की मदद से सुधार और WAF नियम सुझाता है, जिनकी साझा करने से पहले समीक्षा होती है। चार लोगों की एक टीम ने Codex के साथ टोकन पर 1 100 डॉलर खर्च करके तीन दिनों में एक उत्पाद दोबारा बनाया। 🔗 स्रोत
- Grok Bot और 1Password — आने वाले दिनों में Grok Bot, 1Password for Agents के तहत, पासवर्ड देखे बिना उपयोगकर्ता द्वारा मंज़ूर किए गए 1Password क्रेडेंशियल इस्तेमाल करेगा। 1Password for Agents का उपयोग Meta के Muse, Claude Duet और ChatGPT Work में भी होना है। 🔗 स्रोत · 🔗 1Password for Agents
- डेटा रेज़िडेंसी के साथ सार्वजनिक निगरानी — GitHub की सीक्रेट स्कैनिंग अब डेटा रेज़िडेंसी वाले GitHub Enterprise Cloud ग्राहकों के लिए सार्वजनिक कमिट की निगरानी करती है। यह सार्वजनिक पूर्वावलोकन में है और संबद्धता केवल सत्यापित डोमेन के आधार पर तय होती है। 🔗 स्रोत
सहायक
- Gemini, Google Maps और Google Agenda — उपयोगकर्ता की सहमति से Gemini ऐप्लिकेशन, Personal Intelligence के ज़रिए, Google Maps की उसकी खोजों और सहेजे गए स्थानों का मिलान उसके कैलेंडर से करके दिन के सुझाव देता है। यह यूरोपीय आर्थिक क्षेत्र में उपलब्ध नहीं है। 🔗 स्रोत
- Gemini ऐप्लिकेशन से Google Sites तक — 19 अक्टूबर से निर्यात > Google Sites विकल्प, Gemini में बनाए गए इंटरैक्टिव वेब ऐप्लिकेशन को एक निजी साइट के ड्राफ़्ट में खोलता है, जहाँ वह इंटरैक्टिव बना रहता है। यह Workspace और व्यक्तिगत खातों के लिए उपलब्ध है। 🔗 स्रोत
- Kimi Work 3.2.19 — 3.2.18 के अगले दिन आए Moonshot AI के ऐप्लिकेशन में, किसी कंपनी की IP अनुमति सूची से कनेक्शन अवरुद्ध होने पर सीमित पहुँच वाला पृष्ठ दिखता है और नेटवर्क जाँच का एक टूल भी जुड़ा है। 🔗 स्रोत
विकास प्लेटफ़ॉर्म
- पुल रिक्वेस्ट में रिक्त स्थान और विभाजित दृश्य — रिक्त स्थानों के बदलाव दिखाने की प्राथमिकता सभी पुल रिक्वेस्ट के लिए सहेजी जाती है और नई या हटाई गई फ़ाइलें विभाजित दृश्य में पूरी चौड़ाई लेती हैं। 🔗 स्रोत
- GitHub Actions के लिए नए ब्लॉब होस्ट — meta API में प्रकाशित blob.core.windows.net की productionresultssa30 से 49 और 100 से 199 तक की श्रेणियों को अनुमति देनी होगी, जब तक पहले से वाइल्डकार्ड लागू न हो; अन्यथा जॉब सारांश और लॉग में रुकावट आ सकती है। 🔗 स्रोत
- huggingface_hub 2.3.0 का रिलीज़ कैंडिडेट — समानांतर सूचीकरण से objaverse की 798 924 फ़ाइलें खोजने का समय 776 से घटकर 19,7 सेकंड हो जाता है और Buckets की निगरानी रीयल टाइम में की जा सकती है। 🔗 स्रोत
- Hub पर OpenUSD — SimReady Central के अगले दिन .usd, .usda, .usdc और .usdz फ़ाइलें अब एक इंटरैक्टिव 3D व्यूअर में खुलती हैं, जिसे ओपन सोर्स के रूप में जारी किया गया है। 🔗 स्रोत
शोध, खुले मॉडल और विधियाँ
- PLANTEUR — Ai2 द्वारा OlmoEarth v1.3 के साथ प्रकाशित, फ़्रांस के छह समुद्रपारीय क्षेत्रों में फ़सल मानचित्रण का यह बेंचमार्क (2 750 समय शृंखलाएँ, 4 506 km² कृषि भूखंड) दिखाता है कि पहले कभी न देखे गए द्वीप पर हर मॉडल की सटीकता लगभग आधी रह जाती है। 🔗 स्रोत
- Seb-9B-v2 — Apache 2.0 के तहत उपलब्ध, 9 अरब पैरामीटर वाला यह स्थानीय निर्णय मॉडल अपने लेखक के अनुसार Decision Index पर 59,16 अंक हासिल करता है, जबकि होस्ट किए गए Jev 1.13 को 57,96 अंक मिलते हैं। लेखक इंडेक्स का संस्करण नहीं बताता; RTX PRO 6000 पर हर निर्णय में 22 ms लगते हैं। 🔗 स्रोत
- Laghu — UDGAM LABS ने 146 डॉलर में शुरू से 152 मिलियन पैरामीटर वाला संवाद मॉडल प्रशिक्षित किया है। ब्राउज़र में इसका आकार 163 Mo है और इसके लेखकों के अनुसार बातचीत में यह SmolLM2-135M-Instruct के बराबर है। 🔗 स्रोत
- BaseQuant V1 — basecompute ने Qwen3.8-27B के क्वांटाइज़्ड संस्करण (10,93, 16,41 और 20,82 Go) जारी किए हैं, जिनका KL विचलन उनके लेखकों के अनुसार 3 और 4 बिट पर Unsloth की तुलना में 15 % कम है। 🔗 स्रोत
- रीरैंकर के रूप में एक VLM — एक सामुदायिक लेख के अनुसार, रीरैंकिंग का प्रशिक्षण पाए बिना Qwen3.8-27B तीन बेंचमार्क पर पर्यवेक्षित Qwen3-VL-Reranker-2B को पीछे छोड़ता है और MMEB-V2 के दृश्य दस्तावेज़ों पर 8B संस्करण के बराबर प्रदर्शन करता है। 🔗 स्रोत
- Perplexity के अनुसार एजेंट का मूल्यांकन — सफलता के मानदंडों से लेकर रिग्रेशन परीक्षण और प्रोडक्शन निगरानी तक की छह चरणों वाली मार्गदर्शिका लगभग सौ वास्तविक ट्रेस पर त्रुटियों का विश्लेषण करने और मूल्यांकनकर्ता LLM का अंशांकन करने की सलाह देती है; यह Perplexity का कोई उत्पाद नहीं है। 🔗 स्रोत
- Project Chrysalis — Google Cloud ने Gemini Enterprise के एजेंट प्लेटफ़ॉर्म पर स्वयं विकसित होने वाले संचालन एजेंटों की एक संदर्भ संरचना बताई है: नकली व्यवधानों में असर कम करने का पहला उपाय (मिटिगेशन) करने तक का समय 15 से 45 मिनट से घटकर 1,8 सेकंड हो जाता है; यह कोई उत्पाद नहीं है। 🔗 स्रोत
इसका क्या अर्थ है
प्लेटफ़ॉर्म पहुँच संबंधी अपने अनुबंधों को फिर से लिख रहे हैं। Anthropic अब Claude API को तारीख वाले संस्करणों के अनुसार स्थिर रखता है और वे सेटिंग हटा रहा है जिन्हें उसके हालिया मॉडल पहले ही बदलने नहीं देते थे: जो डेवलपर किसी पुराने मॉडल का तापमान घटाता था, उसे 2023-06-01 पर बने रहने और डिफ़ॉल्ट सैंपलिंग स्वीकार करने में से एक विकल्प चुनना होगा, और सभी SDK उसी दिन अपना प्रमुख संस्करण और लाइसेंस बदलते हैं। OpenAI मध्यस्थों की छँटाई करेगा: 20 नवंबर से, उसके मॉडलों तक सीधी पहुँच देने वाले राउटर या गेटवे को उसकी मंज़ूरी लेनी होगी, और SafetyIDs उसे किसी अंतिम उपयोगकर्ता की पहचान जाने बिना उसे लक्षित करने देंगे। Perplexity, OpenAI की Batch API का प्रारूप अपना रहा है, और Cohere हर अनुरोध भेजे जाने से पहले क्लाइंट से उस परिवेश का सत्यापन करवाता है जो अनुरोध को संसाधित करेगा।
एजेंटों के बुनियादी घटक तटस्थ प्रशासन के अधीन आ रहे हैं। Agent Skills, Open Responses, OpenEnv और OpenSandbox के साथ AAIF एक साल में दस परियोजनाओं को एक साथ लाया है, जिनमें हाल में जुड़ी चार परियोजनाएँ Anthropic, OpenAI, Hugging Face और Alibaba से आई हैं। एक साझा प्रारूप का लाभ उसी दिन दिखाई देता है: PHP2Shell तथा Node.js और GitLab की कमजोरियों से बचाव के लिए Cognition का प्लगइन सात प्रतिस्पर्धी कोडिंग एजेंटों में स्किल्स के रूप में स्थापित होता है। हालाँकि, आर्किटेक्चर के मामले में संकेत अलग-अलग हैं: Anthropic उप-एजेंटों को स्किल्स से लैस एक ही लूप में समेटने की सलाह देता है और उन्हें केवल संदर्भ भर जाने या अस्थायी समानांतर कार्यों के लिए रखता है, जबकि Vibe CLI 3.0.2 उसी दिन डिफ़ॉल्ट रूप से एक साथ चलने वाले उप-एजेंटों की संख्या बढ़ाकर 32 कर देता है।
एजेंट जितना अधिक अपने आप काम करते हैं, उनकी निगरानी उतनी ही ऐसी बुनियादी संरचना बनती जाती है जिसे परखना ज़रूरी है। METR और Redwood Research का अभ्यास दिखाता है कि एक मॉनिटर किसी एजेंट की पूरी कार्य-यात्रा देख सकता है, फिर भी कुछ ट्रैफ़िक को जाँच से बचकर निकलने दे सकता है: जब तक संदर्भ संपीड़न उसकी नज़र से बाहर था, कभी नियंत्रण वापस न सौंपने वाला एजेंट अपनी जाँच को अनिश्चित काल तक टाल सकता था। उसी दिन, Claude ऐप डिफ़ॉल्ट रूप से स्वचालित मोड की घोषणा करते हैं, जहाँ हर चरण की मंज़ूरी की जगह स्वचालित जाँच होती है, Claude Code टूल के हर रोके गए कॉल के लिए एक घटना जारी करता है, Replit किसी एजेंट को उत्पादन परिवेश में सुधार अपने आप दोबारा तैनात करने देता है, और GitHub कंपनियों को एजेंटों का इस्तेमाल करने वाले अपने उपयोगकर्ताओं के अनुपात की तुलना समकक्ष कंपनियों से करने की सुविधा देता है।
किसी विशिष्ट क्षेत्र में एक विशेषज्ञ मॉडल अत्याधुनिक मॉडल की बराबरी उसकी लागत के एक छोटे से हिस्से में कर लेता है। 14 अरब पैरामीटर वाला Carbon-X डीएनए संबंधी कार्यों में GPT-6.1 Sol से एक अंक से भी कम अंतर पर है, जबकि प्रति समस्या उसकी लागत लगभग 1/1 800 है; Decisions API और GLiDE पाठ उत्पन्न किए बिना उत्तर देते हैं; OlmoEarth v1.3 पूरी पृथ्वी के लिए एम्बेडिंग की पहले से गणना करता है, जिनके आधार पर एक छोटा वर्गीकारक ही नक्शा बनाने के लिए पर्याप्त है, और ForTy अपना नक्शा AlphaEarth Foundations की एम्बेडिंग पर बनाता है। बेंचमार्क इसका दूसरा पहलू सामने लाते हैं: CulturalRiddles पर कुछ समुदायों के लिए परखे गए 28 मॉडलों में से कोई भी 22 % से अधिक हासिल नहीं करता, और मॉडल केवल 0,7 % मामलों में « मुझे नहीं पता » कहते हैं।
स्रोत
- संस्करण 2026-10-21 की घोषणा (@ClaudeDevs)
- 2026-10-21 पर माइग्रेशन की मार्गदर्शिका (Claude Platform)
- Claude Platform के संस्करण नोट्स
- HuggingFaceBio/Carbon-X (Hugging Face)
- Carbon-X के जारी होने पर लेख (Hugging Face)
- Carbon-X की घोषणा (@LoubnaBenAllal1)
- Carbon-X और जीवविज्ञान में सुरक्षा उपाय (@ClementDelangue)
- OpenAI की आंतरिक एजेंट निगरानी प्रणालियों का रेड-टीम परीक्षण (METR)
- @METR_Evals का थ्रेड
- METR के अभ्यास पर @OpenAI का ट्वीट
- AAIF की चार नई परियोजनाएँ (Linux Foundation)
- Agentic AI Foundation को Agent Skills का दान (Anthropic)
- Agent Skills का AAIF में शामिल होना (@ClaudeDevs)
- OpenEnv का AAIF में शामिल होना (@ben_burtenshaw)
- उप-एजेंटों को मुख्य लूप में समेटना (Claude)
- anthropics/single-agent-loop-kit (GitHub)
- Claude ऐप में डिफ़ॉल्ट स्वचालित मोड (@claudeai)
- Copilot प्रभाव डैशबोर्ड में उद्योग की अन्य कंपनियों से तुलना (GitHub)
- Decisions API से तेज़ प्रतिक्रिया देने वाले ऐप बनाएँ (OpenAI)
- GLiDE का प्रशिक्षण (Fastino)
- fastino/GLiDE (Hugging Face)
- एकसमान मानकों से व्यापक पहुँच (OpenAI)
- Agent API की Batch API (@perplexitydevs)
- Batch API (Perplexity का दस्तावेज़ीकरण)
- Cohere Model Vault पर गोपनीय कंप्यूटिंग (Cohere)
- Cohere Model Vault के अंदर (Cohere)
- दुनिया के वन प्रकारों का मानचित्रण (Google DeepMind)
- Scientific Data में ForTy
- OlmoEarth v1.3 (Ai2)
- Earth-2 और StormScope EU (NVIDIA ब्लॉग)
- यूरोपीय वाणिज्य और खुले मॉडल (NVIDIA ब्लॉग)
- यूरोप की वित्तीय सेवाएँ (NVIDIA ब्लॉग)
- DSX और ऊर्जा (NVIDIA ब्लॉग)
- Cosmos (NVIDIA ब्लॉग)
- Minerva (NVIDIA ब्लॉग)
- CulturalRiddles (Cohere Labs)
- CohereLabsCommunity/CulturalRiddles (Hugging Face)
- Nemotron-Personas-UK (Locai Labs)
- यूरोप का सार्वजनिक क्षेत्र और खुले मॉडल (NVIDIA ब्लॉग)
- Ideogram Vector 1.0 (@ideogram_ai)
- Ideogram Vector का पृष्ठ
- पाठ से वीडियो की रैंकिंग (Artificial Analysis)
- Artificial Analysis पर HeyGen Video 1 (@HeyGen)
- FLUX Video Upscale का नया रूप (@bfl_ai)
- FLUX Video Upscaler (Black Forest Labs)
- Claude Code 2.1.307 (GitHub)
- Visual Studio Code 1.143
- Replit Monitoring Agent (Replit)
- Monitoring Agent का दस्तावेज़ीकरण (Replit)
- स्वयं होस्ट किए गए orbs (Amp)
- Vulnerability Fixes प्लगइन (Cognition)
- CognitionAI/devin-vuln-fixes (GitHub)
- Vulnerability Fixes (@cognition)
- Copilot CLI 1.0.103 (GitHub)
- Vibe CLI 3.0.2 (GitHub)
- Qwen Code v0.26.0 (GitHub)
- Zed v1.25.2 (GitHub)
- Gemini CLI v0.67.0-nightly.20261022 (GitHub)
- Antigravity का परिवर्तन विवरण
- Devin के 21 अक्टूबर के संस्करण नोट्स
- GenCode से बनाया गया एक शैक्षिक टूल (Genspark)
- Uber अपने सभी कर्मचारियों तक ChatGPT Work पहुँचाता है (OpenAI)
- OpenAI में FDE का क्या अर्थ है (OpenAI)
- Replit for Government
- लंदन में निर्माण (Cognition)
- SpaceX Super Intelligence Partner Network (x.ai)
- Synthesia और Hays (Synthesia)
- Trinity Logistics और ElevenAgents (ElevenLabs)
- Eleven Realtime Translation (ElevenLabs)
- ICBA और OpenAI ने रणनीतिक गठबंधन की घोषणा की (ICBA)
- Cloudflare और OpenAI Daybreak (OpenAI)
- Grok Bot और 1Password (@bot)
- 1Password for Agents का परिचय (1Password)
- डेटा रेज़िडेंसी के साथ सार्वजनिक निगरानी अब उपलब्ध (GitHub)
- Gemini, Google Maps और Google Agenda (@GeminiApp)
- Gemini ऐप से Google Sites पर इंटरैक्टिव ऐप प्रकाशित करें (Google Workspace Updates)
- Kimi Work के संस्करण नोट्स
- सहेजी गई व्हाइटस्पेस प्राथमिकताएँ और बेहतर विभाजित दृश्य (GitHub)
- Actions ब्लॉब संग्रहण के लिए Meta API एंडपॉइंट अद्यतन किए गए (GitHub)
- huggingface_hub v2.3.0.rc0 (GitHub)
- OpenUSD व्यूअर और SimReady एसेट के पूर्वावलोकन (Hugging Face)
- PLANTEUR (Ai2)
- Seb-9B-v2 (Hugging Face ब्लॉग)
- Laghu (Hugging Face ब्लॉग)
- BaseQuant V1 (Hugging Face ब्लॉग)
- मल्टीमोडल री-रैंकर के रूप में एक VLM (Hugging Face ब्लॉग)
- एआई एजेंटों का मूल्यांकन कैसे करें (Perplexity)
- Project Chrysalis (Google Developers)